Le GLM-5.3 Flash est le modèle à privilégier si vous accordez de l'importance aux performances de codage, mais que vous ne souhaitez pas payer le prix d'un modèle haut de gamme à chaque appel d'API. Z.AI le présente comme un modèle natif multimodal de la série GLM-5, et l'écart de prix officiel est flagrant : le tarif promotionnel actuel est de $0,075 par million de tokens en entrée et de $0,25 par million de tokens en sortie, alors que les modèles GLM-5.3 et GLM-5.2 sont proposés à $1,40 en entrée et $4,40 en sortie par million de jetons sur la même page de tarification de Z.AI.
Cela ne signifie pas pour autant que GLM-5.3 Flash soit la solution idéale pour toutes les tâches. Lors de nos tests contrôlés via l’API, il s’est révélé peu coûteux, mais il s’est également montré sensible aux paramètres de raisonnement et de sortie. Plusieurs requêtes par défaut compatibles avec OpenAI ont renvoyé un code HTTP 200 tout en consommant la plupart des jetons d’achèvement pour le raisonnement, sans produire de réponse visible, ou très peu. Après être passé à des paramètres de raisonnement de type GLM et à un plafond de sortie plus élevé, la tâche de débogage de code est devenue utilisable.
Ce guide détaille GLM-5.3 Prix flash, l'accès à l'API, les spécifications officielles, les indicateurs de performance et les résultats des tests pratiques. Si votre objectif est de comparer différents modèles avant de vous décider pour une pile technologique, GLBGPT C'est le moyen le plus simple de comparer les résultats obtenus avec plusieurs modèles, tandis que la documentation et la page de tarification de Z.AI restent la référence incontournable pour les détails officiels concernant l'API Flash GLM-5.3.
Réponse rapide : Qu'est-ce que le « GLM-5.3 Flash » ?
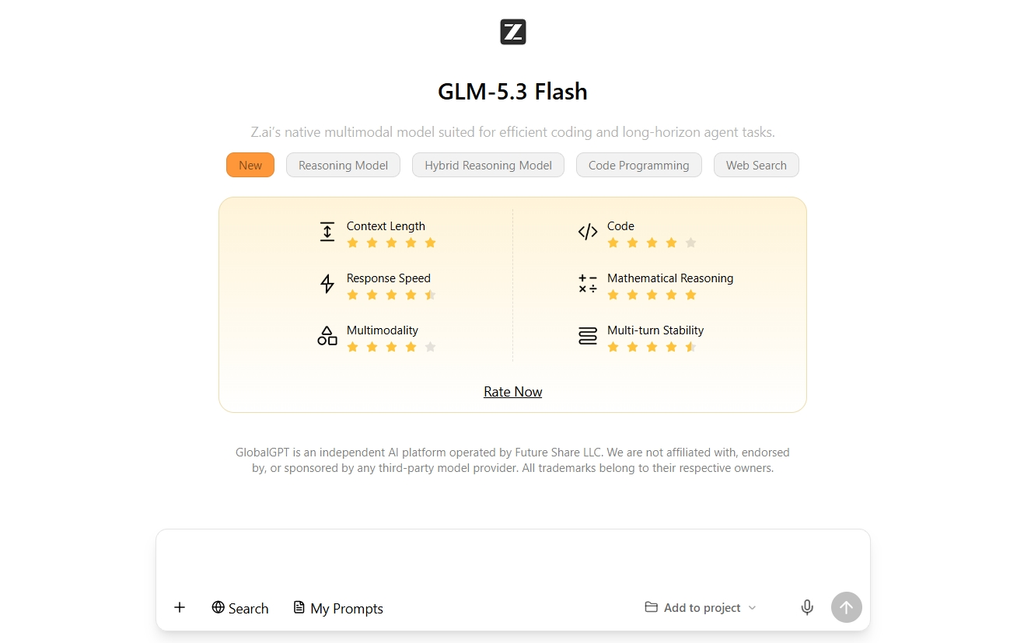
GLM-5.3 Flash est le modèle GLM-5 économique de Z.AI, destiné au codage, aux tâches d'agent, au traitement de contextes longs et aux entrées multimodales. L'officiel Documentation GLM-5.3-Flash présente le code du modèle API comme suit : glm-5.3-flash, prend en charge une fenêtre de contexte de 1 million de tokens et décrit l'entrée d'images via url_de_l'image blocs de contenu.
Ce qui importe, c’est le compromis. GLM-5.3 Flash n’est pas simplement une petite étiquette apposée sur la même page de modèle. Z.AI le décrit comme le premier modèle multimodal natif de la série GLM-5, avec un total de 320 milliards de paramètres et 18 milliards de paramètres activés. Il s’articule autour d’une architecture hybride destinée à réduire les coûts de service tout en conservant les avantages liés à la gestion de contextes longs.
Mon avis pratique : GLM-5.3 Flash est particulièrement intéressant pour les tâches de codage où le coût est un facteur déterminant et les charges de travail impliquant des agents, dans lesquelles on peut être amené à appeler le modèle à de nombreuses reprises. Il est moins convaincant en tant que modèle d'écriture informelle, à moins que votre route API et vos paramètres de raisonnement ne soient optimisés, car la sortie visible peut être masquée par l'utilisation de jetons de raisonnement lorsque le plafond de sortie est trop bas.
GLM-5.3 Prix flash
L'officiel Page des tarifs de Z.AI est la source la plus fiable pour GLM-5.3 Prix flash. D'après les informations vérifiées le 27 août 2026, Z.AI propose le GLM-5.3-Flash avec une remise promotionnelle de 50%. Les prix réduits s’élèvent à $0,075 par million de jetons d’entrée et à $0,25 par million de jetons de sortie. Les prix catalogue barrés s’élèvent à 1 TP41T0,15 pour les jetons d’entrée et à 1 TP41T0,50 pour les jetons de sortie par million de jetons.
Z.AI précise également que la promotion prend fin le 9 septembre 2026 à 24 h 00, heure de Singapour (UTC+8). Ce détail est important pour les lecteurs qui comparent les coûts à long terme : la remise de lancement est bien réelle, mais elle ne doit pas être considérée comme un tarif de référence permanent, à moins que Z.AI ne la prolonge.
| Modèle | Données d'entrée / 1 million de jetons | Entrée mise en cache | Résultat / 1 million de jetons | Remarque concernant les tarifs |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (prix promotionnel) ; $0.15 (prix catalogue) | $0.015 (prix promotionnel) ; $0.03 (prix catalogue) | $0.25 (prix promotionnel) ; $0.50 (prix catalogue) | Promotion sur le modèle 50% jusqu'au 9 septembre 2026 (UTC+8) |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | Ligne phare GLM-5.3 concernant les tarifs de Z.AI |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Ligne précédente du modèle GLM concernant la tarification de Z.AI |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | Répertorié dans la catégorie des modèles textuels Z.AI |
Comparaison officielle des prix de vente de Z.AI
Source : page officielle des tarifs de Z.AI, consultée le 27 août 2026. Les prix promotionnels sont valables pour une durée limitée.
Donc oui, GLM-5.3 Flash est bon marché par rapport à GLM-5.3 et GLM-5.2 si l'on se base sur les tarifs officiels des jetons. La question la plus pertinente est de savoir s'il reste abordable une fois pris en compte vos prompts, vos paramètres de raisonnement, vos appels d'outils et vos nouvelles tentatives. Notre section pratique aborde ce sujet.
Si vous souhaitez connaître les tarifs de la génération précédente, consultez notre article dédié Prix du GLM-5.2 guide. Je conserverais cette page consacrée au GLM-5.2 et je laisserais cet article traiter du prix, de l'API et des objectifs de benchmark du GLM-5.3 Flash.
GLM-5.3 : Accès à l'API Flash
Le code officiel du modèle d'API est le suivant : glm-5.3-flash. Selon Z.AI, les paramètres textuels sont conformes à la version GLM-5.3, le modèle prend en charge une fenêtre de contexte de 1 million de tokens et permet l'entrée d'images via url_de_l'image blocs à l'intérieur messages[].content[]. Cela fait de GLM-5.3 Flash bien plus qu'un simple modèle de codage en texte brut.
La note relative aux paramètres n'est pas un détail sans importance. La documentation recommande température : 1, top_p : 0,95, et effort_de_raisonnement : max. Ils ajoutent également que thinking.type prend en charge activé, et je recommande thinking.clear_thinking : false. Lors de nos propres tests, ce type de configuration s'est avéré déterminant.
| Élément API | Quoi utiliser | Pourquoi c'est important |
|---|---|---|
| Code type | glm-5.3-flash |
Utilisez l'identifiant exact du modèle plutôt que d'essayer de deviner le nom d'une variante. |
| Contexte | 1 million de jetons | Utile pour les bases de code volumineuses, les documents longs et la mémoire des agents, mais reste sensible en termes de coût. |
| Saisie d'images | url_de_l'image blocs de contenu |
Prend en charge les workflows de conversion de captures d'écran en code et de débogage visuel. |
| Réflexion | thinking.type : activé |
Le raisonnement ne peut pas être considéré comme un simple détail insignifiant ; il peut jouer un rôle prépondérant dans l'utilisation des signifiants. |
Pour les non-développeurs, c'est là qu'une plateforme multimodèle peut s'avérer utile. Vous pouvez utiliser GLBGPT pour comparer le comportement des modèles avant de consacrer du temps à la configuration de l'API d'un fournisseur. Pour connaître les tarifs officiels des jetons et les paramètres des modèles, consultez toujours la tarification et la documentation de Z.AI.
GLM-5.3 : Tests de performance Flash et indicateurs de capacité
Les tests de performance sont utiles dans ce contexte, mais uniquement si vous citez la source. La documentation de Z.AI fournit les performances officielles du modèle ainsi que des détails sur son architecture. Analyse artificielle fournit des données de référence provenant de sources tierces. OpenRouter fournit des données sur les plateformes de mise en relation avec les prestataires. Il s'agit là de trois types de données différents.
Artificial Analysis indique pour le modèle GLM-5.3-Flash un indice d’intelligence de 57, un classement #3 sur 110 dans le groupe affiché, une fenêtre contextuelle de 1M et un débit de 50,2 tokens par seconde. Il précise également que les modalités d’entrée sont le texte et l’image, avec une sortie sous forme de texte. Il s'agit là d'un indicateur de performances solide pour un modèle proposé à la tarification Flash, mais il s'agit tout de même d'un benchmark tiers, et non d'une garantie officielle de vitesse de la part de Z.AI.
Aperçu des prix et des fonctionnalités
| Modèle | Prix officiel | Signal de référence | Contexte | Limite de la source |
|---|---|---|---|---|
| GLM-5.3-Flash | Offre promotionnelle : $0.075 à l'entrée / $0.25 à la sortie pour 1 million de jetons | Indice d'intelligence : 57 ; 50,2 jetons de sortie/s | 1 million de jetons | Prix fourni par Z.AI ; référence fournie par Artificial Analysis |
OpenRouter est utile pour vérifier la disponibilité sur les places de marché et les chiffres propres à chaque opérateur, mais je ne ferais pas figurer ces valeurs dans un tableau des tarifs officiels. Si un opérateur répertorié sur OpenRouter affiche un débit différent ou un tarif temporaire différent, précisez qu’il s’agit de données provenant de la place de marché de cet opérateur.
Test pratique de l'API : invites, utilisation des jetons et résultats
Nous avons effectué un test contrôlé de l'API sur cinq modèles disponibles : glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, et kimi-k3. Il ne s'agissait pas d'un test de performance officiel et il ne faut pas y voir un classement mondial des modèles. L'objectif était plus restreint et plus pertinent pour cet article : avec les mêmes prompts, le modèle GLM-5.3 Flash a-t-il fourni des résultats exploitables, comment ses tokens de raisonnement se sont-ils comportés, et quels champs de coût ont été renvoyés par la réponse de l'API ?
La conception du test était volontairement simple. Nous avons utilisé une tâche de programmation, une tâche nécessitant un format de sortie strictement structuré et une courte tâche de rédaction. Ce mélange est important, car un modèle peut afficher d'excellents résultats en programmation tout en s'avérant décevant pour les formats JSON strictement structurés ou les textes courts si l'algorithme épuise le budget de sortie en raison d'un raisonnement caché.
Comment lire les cartes de test
- Passer signifie que le modèle a généré une sortie visible qui répondait à la tâche.
- Erreur de formatage signifie que le contenu était utile, mais qu'il ne s'agissait pas d'un résultat strictement lisible par une machine.
- Non concluant signifie que la requête a abouti sur le plan technique, mais que la route testée n'a renvoyé que peu ou pas de réponse visible.
- Champs relatifs aux coûts Il s'agit de valeurs communiquées dans les réponses issues de cette interrogation contrôlée de l'API, et non d'engagements tarifaires officiels de la part du prestataire.
Exécution par défaut utilisée température : 0,2 et un plafond de production au niveau de la tâche. Chaque modèle/tâche a été exécuté une seule fois, sans nouvelle tentative automatique. Nous avons ensuite effectué un test complémentaire uniquement pour GLM-5.3 Flash sur les tâches de codage et de rédaction avec des paramètres de réflexion de type GLM, car les réponses par défaut de Flash montraient une utilisation intensive de jetons de raisonnement et nécessitaient une vérification plus équitable de la configuration.
Exercice A
Débogage du code : le modèle a-t-il détecté le bug lié au regroupement des clients ?
Tâche : Identifiez le bogue dans une fonction TypeScript, expliquez pourquoi il se produit et proposez une implémentation corrigée.
Consigne exacte
Vous examinez une fonction TypeScript qui doit regrouper les commandes par identifiant client et calculer le montant total des dépenses de chaque client. Trouvez le bug, expliquez pourquoi il se produit et proposez une implémentation corrigée. Code : type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const order of orders) { if (!result[order.id]) result[order.id] = { count: 0, total: 0 }; result[order.id].count += 1; result[order.id].total += order.total; } return result; }
| Modèle | Aperçu des résultats | Jeton / note sur le coût | Résultat |
|---|---|---|---|
glm-5.3-flash |
L'exécution par défaut a renvoyé un code HTTP 200, mais aucune réponse de l'assistant n'était visible, car le raisonnement avait utilisé 1 196 des 1 200 jetons de complétion. Dans la suite de la procédure recommandée, il a correctement identifié que order.id devrait être commande.identifiantClient et a proposé une implémentation corrigée. |
Par défaut : 1 348 jetons au total, champ de coût $0.0003111. Suivi : 2 584 jetons au total, champ de coût $0.00124007598. | Passer après une nouvelle exécution |
glm-5.3 |
J'ai identifié le bug lié à la clé de regroupement et expliqué pourquoi les identifiants de commande uniques empêchent l'agrégation au niveau des clients. Le code corrigé utilisé customerId comme clé de l'objet. |
1 348 jetons au total, champ « coût » : $0.00534128. | Passer |
glm-5.2 |
J'ai également trouvé le order.id par rapport à customerId a identifié le problème et a mis au point une implémentation corrigée et fonctionnelle. |
1 304 jetons au total. Le coût en USD n'a pas été renvoyé dans le même champ de réponse. | Passer |
gpt-5.6-luna |
Il a fourni l'explication la plus claire et la plus concise : l'accumulateur était indexé par ID de commande, de sorte que chaque commande constituait son propre compartiment. Il a fourni le code TypeScript corrigé. | 509 jetons au total. Coût en USD en attente / non remboursé. | Passer |
kimi-k3 |
J'ai repéré le même bug et j'ai fourni une explication détaillée ainsi qu'une implémentation corrigée. La réponse était utile, mais plus longue que celle de GPT. | 1 423 jetons au total. Coût en dollars américains en attente / non remboursé. | Passer |
À emporter : Pour le débogage du code, GLM-5.3 Flash n’a donné de bons résultats qu’après avoir appliqué des paramètres conformes à la philosophie GLM et augmenté le plafond de sortie. GLM-5.3, GLM-5.2, GPT-5.6 Luna et Kimi K3 ont tous fourni des réponses exploitables dès le premier essai.
Exercice B
JSON strict : le modèle respectait-il un format lisible par machine ?
Tâche : Renvoyer uniquement du JSON strict, avec des clés fixes et sans balisage Markdown.
Consigne exacte
Ne renvoyez que du JSON strict. Comparez les modèles phares GLM-5.3-Flash, GLM-5.3 et de type GPT pour un développeur qui cherche à choisir un assistant de codage. Utilisez les clés suivantes : best_for, tradeoffs, cost_warning, recommendation. N'utilisez pas le format Markdown.
| Modèle | Aperçu des résultats | Jeton / note sur le coût | Résultat |
|---|---|---|---|
glm-5.3-flash |
Le contenu renvoyé ressemblait en partie à du JSON, mais il ne s'agissait pas de JSON strictement analysable sans traitement préalable. Ce contenu est lisible par un humain, mais ne convient pas à une automatisation directe. | 1 267 jetons au total, champ « coût » : $0,000305025. | Erreur de formatage |
glm-5.3 |
Aucun contenu d'assistance visible n'a été renvoyé en dessous du seuil de sortie testé, la quasi-totalité des jetons de finalisation ayant été consommés par le raisonnement. | 1 267 jetons au total, champ « coût » : $0,00530084. | Non concluant |
glm-5.2 |
La réponse renvoyée ressemblait à un JSON, mais elle était incomplète et impossible à analyser sans être nettoyée. | 1 268 jetons au total. Le coût en dollars américains n'a pas été renvoyé dans le même champ de réponse. | Erreur de formatage |
gpt-5.6-luna |
Renvoie un JSON analysable contenant les clés demandées et sans balise Markdown. | 541 jetons au total. Coût en USD en attente / non remboursé. | Passer |
kimi-k3 |
Le contenu renvoyé ressemblait à du JSON et comportait des informations utiles, mais il ne s'agissait pas de JSON strictement analysable sans être nettoyé. | 1 339 jetons au total. Coût en USD en attente / non remboursé. | Erreur de formatage |
À emporter : En ce qui concerne les résultats strictement structurés, GPT-5.6 Luna s'est révélé le plus précis de cette petite série de tests. GLM-5.3 Flash pourrait encore fonctionner avec des contrôles plus stricts sur le format des réponses, mais cette requête par défaut n'était pas compatible avec l'automatisation.
Exercice C
Brève note sur le produit : le modèle a-t-il produit un texte exploitable ?
Tâche : Rédigez une note de 120 mots, précise et sans caractère promotionnel, expliquant dans quels cas le GLM-5.3 Flash est préférable à un modèle phare plus lourd.
Consigne exacte
Rédigez une fiche produit de 120 mots expliquant dans quels cas le GLM-5.3-Flash constitue un meilleur choix qu'un modèle haut de gamme plus lourd. Soyez précis et évitez tout ton promotionnel.
| Modèle | Aperçu des résultats | Jeton / note sur le coût | Résultat |
|---|---|---|---|
glm-5.3-flash |
L'exécution par défaut n'a renvoyé aucun contenu visible après que le raisonnement a utilisé 895 des 900 jetons de complétion. Le suivi des paramètres recommandés n'a pas non plus renvoyé de contenu visible après que le raisonnement a utilisé 1 798 des 1 800 jetons de complétion. | Par défaut : 946 jetons au total, champ de coût $0.00022845. Suivi : 1 846 jetons au total, champ de coût $0.00045345. | Non concluant |
glm-5.3 |
N'a renvoyé aucun contenu visible en dessous du seuil de sortie testé. | 946 jetons au total, champ « coût » : $0,0040244. | Non concluant |
glm-5.2 |
A renvoyé aucun contenu visible sous la route testée. | 947 jetons au total. Le coût en dollars américains n'a pas été renvoyé dans le même champ de réponse. | Non concluant |
gpt-5.6-luna |
J'ai rendu une note pratique illustrée d'exemples concrets, tels que la génération à haut débit, la latence prévisible, les résumés d'assistance, l'extraction, la classification et le routage. Le nombre de mots était proche des 120 demandés. | 983 jetons au total. Coût en dollars américains en attente / non remboursé. | Passer |
kimi-k3 |
A renvoyé aucun contenu visible sous la route testée. | 1 019 jetons au total. Coût en USD en attente / non remboursé. | Non concluant |
À emporter : Pour les écritures courtes dans ce scénario, GLM-5.3 Flash n'a pas produit de copie visible exploitable, même si le coût affiché était minime. Je ne le choisirais pas pour l'écriture en me basant uniquement sur le tableau des prix ; je testerais d'abord les paramètres exacts.
Ce que les tests ont réellement révélé
- GLM-5.3 Flash présente un réel intérêt en termes de coût de développement. La tâche de codage a fonctionné après avoir appliqué des paramètres inspirés du modèle GLM, et le coût enregistré est resté minime pour cette exécution.
- La route par défaut n'était pas de type « plug-and-play ». Plusieurs réponses Flash ont renvoyé un code HTTP 200 tout en utilisant la quasi-totalité du budget de complétion pour les jetons de raisonnement.
- Le format JSON strict nécessite une validation supplémentaire. Une réponse qui ressemble à du JSON n'est pas nécessairement du JSON analysable, surtout si le résultat doit alimenter un processus d'automatisation.
- Ce n'est pas à travers ses textes courts que je jugerais Flash en premier lieu. Dans ce test, la consigne d'écriture n'a pas donné lieu à une réponse Flash visible, même après la configuration des paramètres de suivi.
Mon avis est simple : GLM-5.3 Flash est prometteur pour le traitement des données où le coût est un facteur déterminant, mais il ne faut pas le considérer comme une solution « prête à l'emploi » sur toutes les routes compatibles OpenAI. Définissez un budget de sortie suffisant, examinez le comportement des jetons de raisonnement et testez précisément le type de tâche que vous prévoyez d'exécuter avant d'y transférer un volume réel de données.
Meilleurs cas d'utilisation du flash GLM-5.3
Le modèle GLM-5.3 Flash est particulièrement adapté lorsque la tâche tire parti d'une entrée multimodale, d'un contexte étendu et de nombreux appels répétés. Ce n'est pas le modèle que je choisirais simplement parce que le tableau des prix semble intéressant. Je le choisirais lorsque la nature de la tâche correspond au modèle.
- Agents de codage comportant de nombreux appels d'outils : Un prix plus bas par jeton facilite le processus itératif de planification, d'édition, de test et de correction.
- Travail sur l'interface utilisateur à partir de captures d'écran : Grâce à ses fonctionnalités de saisie d'images et de codage, cet outil est tout indiqué pour le débogage d'interfaces utilisateur et la conversion de captures d'écran en code.
- Révision de code à long terme : La fenêtre de contexte 1M est utile lorsque vous avez besoin d'inclure davantage d'informations contextuelles sur le projet dans une seule requête.
- Activités professionnelles impliquant un volume important de documents : Z.AI présente des cas d'utilisation dans les domaines des fichiers Office, de la recherche financière et du traitement de documents professionnels.
- Expériences API adaptées à un budget limité : Compte tenu de la différence de prix officielle, le Flash constitue un premier modèle judicieux à tester avant de passer à un modèle plus lourd.
Si vous rédigez principalement de courts textes marketing, ne partez pas du principe que Flash est la meilleure option par défaut simplement parce qu'il est moins cher. Notre test de rédaction n'a pas été concluant, que ce soit avec les paramètres par défaut ou avec les paramètres recommandés de Flash, car le contenu visible ne s'affichait pas correctement dans la limite de sortie choisie. Je vous conseille de tester d'abord des tâches de codage et d'ingénierie structurée, puis de décider si Flash mérite également une place dans votre pile d'outils de rédaction.
Seuils de coût et paramètres API à surveiller
Le principal risque lié au GLM-5.3 Flash ne réside pas dans le prix officiel du jeton. Ce prix est en effet bas. Le risque réside dans l'écart entre une requête peu coûteuse et une réponse exploitable.
- Jetons de raisonnement : Lors de nos tests, les jetons de raisonnement ont consommé la majeure partie du budget d'achèvement lors de plusieurs exécutions.
- Plafond de production : un plafond bas peut empêcher l'affichage de tout contenu visible, même lorsque la requête HTTP aboutit.
- Boucles d'agent : Chaque cycle « planification-modification-test » peut multiplier les jetons de contexte et de sortie.
- Contexte général : 1 million de jetons, c'est utile, mais envoyer plus d'informations que nécessaire a tout de même un impact sur le coût et la latence.
- Nouvelles tentatives : Le fait de réessayer une configuration qui a échoué ou qui n'a produit aucun résultat modifie le coût réel par résultat exploitable.
Pour les tâches de codage, je commencerais par : utiliser le code modèle officiel, adopter une approche de type GLM, laisser suffisamment d'espace au modèle pour afficher ses résultats, et enregistrer les tokens de raisonnement séparément des tokens de réponse finale. Si vous comparez différentes méthodes, mesurez le coût par tâche accomplie plutôt que le coût par requête.
Le GLM-5.3 Flash en vaut-il la peine ?
GLM-5.3 Flash mérite d'être testé si votre charge de travail implique beaucoup de codage, si le coût est un facteur déterminant et si elle repose sur des API. Son prix officiel est attractif, les résultats des tests de performance réalisés par des tiers sont convaincants et le modèle présente des caractéristiques techniques utiles : entrée multimodale native, contexte de 1 M et une architecture de la série GLM-5 conçue pour un déploiement efficace.
Je ferais preuve d'une plus grande prudence si votre utilisation principale concerne la rédaction générale, la production de résultats strictement structurés ou un flux de travail dans lequel la production de raisonnements invisibles constituerait un problème majeur. Dans ces cas-là, testez minutieusement le parcours et les paramètres avant de transférer le volume vers la mémoire Flash. Un modèle peut être peu coûteux tout en nécessitant une configuration rigoureuse.
Pour les lecteurs qui souhaitent se familiariser avec le comportement des modèles avant de choisir une pile d'API, GLBGPT Cela vous offre un espace pratique pour comparer les résultats des différents modèles sans avoir à ouvrir un onglet distinct pour chaque fournisseur. Une fois que vous savez quel modèle convient à votre tâche, il devient plus facile d'évaluer la documentation officielle relative à l'API et aux tarifs.
FAQ
Qu'est-ce que GLM-5.3 Flash ?
GLM-5.3 Flash est un modèle de la série GLM-5 de Z.AI dont le code API est glm-5.3-flash. Z.AI le décrit comme un modèle multimodal natif prenant en charge un contexte de 1 million de tokens et doté d'une architecture économique.
Combien coûte le GLM-5.3 Flash ?
Selon les informations vérifiées le 27 août 2026, Z.AI propose le GLM-5.3 Flash au tarif de $0,075 par million de jetons d’entrée et de $0,25 par million de jetons de sortie dans le cadre d’une promotion à 50%. Les prix normaux indiqués sont de 1 TP41T0,15 pour les jetons d'entrée et de 1 TP41T0,50 pour les jetons de sortie par million de jetons.
GLM-5.3 Flash est-il gratuit ?
La page officielle consacrée aux tarifs présente les prix des jetons d'API payants. Elle mentionne également une réduction à durée limitée, et non un modèle gratuit permanent. Certaines routes ou certains forfaits peuvent être soumis à des règles de quota distinctes, mais celles-ci doivent être vérifiées sur l'interface d'accès que vous utilisez effectivement.
Quel est le code du modèle de l'API Flash GLM-5.3 ?
Le code officiel du modèle est le suivant : glm-5.3-flash.
Le logiciel GLM-5.3 Flash prend-il en charge l'importation d'images ?
Oui. La documentation de Z.AI décrit la saisie d'images via url_de_l'image blocs de contenu dans le tableau de contenu des messages de chat.
Qu'est-ce que la fenêtre de contexte de GLM-5.3 Flash ?
La documentation de Z.AI mentionne la prise en charge d'une fenêtre de contexte d'un million de tokens. OpenRouter et Artificial Analysis affichent également un contexte d'environ un million de tokens, mais il s'agit de pages tierces distinctes.
Le GLM-5.3 Flash est-il meilleur que le GLM-5.3 ?
Ce n'est pas toujours le cas. Le GLM-5.3 est le modèle le plus performant pour le codage complexe et les tâches à long terme, tandis que le GLM-5.3 Flash est nettement moins cher et intègre une fonctionnalité de positionnement multimodal native. Faites votre choix en fonction du type de tâche et de votre budget.
Le GLM-5.3 Flash est-il adapté à la programmation ?
Cette approche semble prometteuse pour le codage, en particulier pour le codage où le coût est un facteur déterminant. Lors de notre test de suivi contrôlé de l’API, réalisé avec des paramètres inspirés du modèle GLM et un plafond de tokens plus élevé, elle a correctement corrigé un bug de regroupement dans TypeScript. Avec des limites de sortie par défaut plus basses, plusieurs exécutions n’ont pas permis de tirer de conclusions, car la réponse ne comportait que peu ou pas de contenu visible.
En quoi le modèle GLM-5.3 Flash se distingue-t-il des modèles GPT ?
GLM-5.3 Flash est nettement moins cher que de nombreuses solutions de codage phares si l'on se base sur le prix officiel de son token, mais le prix n'est pas le seul facteur à prendre en compte. Lors de notre petit test réalisé avec les paramètres par défaut, GPT-5.6 Luna a fourni des résultats exploitables pour les trois tâches, tandis que GLM-5.3 Flash a nécessité une nouvelle exécution avec les paramètres recommandés pour la tâche de codage.
En quoi le GLM-5.3 Flash se distingue-t-il du Kimi ?
Kimi K3 a réussi l'épreuve de codage et de débogage lors de notre test, mais n'a pas satisfait aux critères stricts du format JSON sans nettoyage et n'a renvoyé aucun contenu visible pour l'épreuve de rédaction courte sur la route testée. Cela ne signifie pas que Kimi soit globalement moins performant ; cela ne concerne que cet ensemble d'épreuves et cette configuration.
Où puis-je tester GLM-5.3 Flash ?
Pour accéder à l'API officielle, consultez la documentation et les pages tarifaires de GLM-5.3 Flash de Z.AI. Si vous souhaitez comparer plus largement les différents modèles avant de faire votre choix, vous pouvez utiliser une plateforme multi-modèles telle que GLBGPT afin de comparer les résultats de tous les modèles en un seul endroit.
Dois-je utiliser GLM-5.3 Flash pour la production ?
Ne l'utilisez en production qu'après avoir testé votre tâche précise, votre itinéraire, vos paramètres, vos limites de sortie et l'enregistrement des coûts. Son prix est attractif, mais nos tests ont montré que les détails de configuration peuvent déterminer si le résultat est exploitable.
Conclusion finale
GLM-5.3 Flash n'est pas simplement un simple complément bon marché à GLM-5.3. Il s'agit d'une nouvelle option sérieuse pour le codage à coût maîtrisé, la saisie multimodale et le travail avec des API à contexte étendu. Son prix officiel est très attractif, et les résultats des tests de performance sont suffisamment convaincants pour justifier de l'essayer.
Ma principale mise en garde est d'ordre pratique : ne vous fiez pas uniquement au code d'état HTTP 200. Vérifiez le résultat affiché, l'utilisation des jetons de raisonnement et le coût par réponse exploitable. Si ces éléments s'avèrent satisfaisants pour vos tâches concrètes, GLM-5.3 Flash pourrait bien être l'un des modèles offrant le meilleur rapport qualité-prix parmi ceux actuellement disponibles dans la pile de codage.