
Claude Sonnet 5.5 vs Opus 5.5 : prix, benchmarks et tests en conditions réelles
Les modèles Sonnet 5.5 et Opus 5.5 appartiennent tous deux à la génération Claude 5.5, mais leur prix et leur positionnement diffèrent. Cette comparaison soumet les deux modèles aux cinq mêmes requêtes et présente les résultats effectivement fournis par chacun d'entre eux.
La différence constatée tient principalement au coût et à la rapidité. Dans ce pack de cinq consignes, le modèle Sonnet 5.5 a terminé plus rapidement, a utilisé moins de jetons de sortie et a produit l'estimation la plus faible du coût arithmétique des requêtes. Opus 5.5 a utilisé davantage de jetons et de temps, tandis que ses réponses étaient souvent plus détaillées. Les fiches de tâches indiquent dans quels cas ce texte supplémentaire a modifié le résultat utile et dans quels cas les deux modèles ont simplement réussi la tâche.
Les invites, le plafond des requêtes, le paramètre d’effort, le point final et la conception « une exécution par modèle » ont été conservés conformément à la version précédente Avis sur le Claude Opus 5.5.
Réponse rapide
- Vitesse lors de cette course en duo : Sonnet 5.5 a traité cinq requêtes consécutives en 31,930 secondes en local ; Opus 5.5 a mis 47,725 secondes.
- Jetons de sortie signalés par la route : Sonnet 5.5 en a utilisé 2 686 ; Opus 5.5 en a utilisé 3 952. Les « champs de réflexion » s'élevaient respectivement à 987 et 2 214.
- Estimation arithmétique du prix catalogue : Les cinq demandes « Sonnet » ont représenté environ $0,02826 ; les cinq demandes « Opus » ont représenté environ $0,08184, en utilisant les tarifs officiels standard par jeton et en excluant le cache, les crédits, les taxes et la marge.
- Résultat de la tâche : Les deux modèles ont réussi les tests portant sur l'extraction, le format JSON et les opérations mathématiques. Sonnet a mieux respecté le format demandé de deux paragraphes en chinois ; les résultats de codage étaient tous deux exploitables, mais différaient en termes de profondeur et d'explications concernant les cas limites.
- Migration de l'API : La réflexion ne peut pas être désactivée ; le choix imposé d'un outil est rejeté, et les budgets symboliques incluent la réflexion. Consultez le points à prendre en compte lors de la migration avant de changer.
- Front de décision : Il s'agit d'une exécution par tâche via un itinéraire tiers. Ce test mesure les temps de réponse observés, le temps réel local et l'utilisation indiquée par l'itinéraire ; il ne s'agit pas d'un score global de performance.
Prix officiel et caractéristiques techniques du modèle
Les fiches techniques actuelles du modèle Anthropic mentionnent à la fois des modèles dotés d'une fenêtre contextuelle de 1 million de tokens et d'un débit maximal de 128 Ko. Le modèle Sonnet 5.5 est désigné sous le nom de Rapide avec un niveau d'effort par défaut élevé ; Opus 5.5 est étiqueté Modéré avec un effort par défaut moyen. Les taux de jetons standard font que le Sonnet 5.5 représente la moitié du prix d'entrée et de sortie de l'Opus 5.5.
| Modèle | ID de l'API | Indication officielle de la latence | Entrée / sortie | Contexte / puissance maximale | Effort par défaut | Lecture du cache |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-sonnet-5-5 | Actif · Rapide | $2 / $10 par MTok | 1 Mo / 128 Ko | Haut | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Actif · Modéré | $4 / $20 par MTok | 1 Mo / 128 Ko | Moyen | $0.20 / MTok |
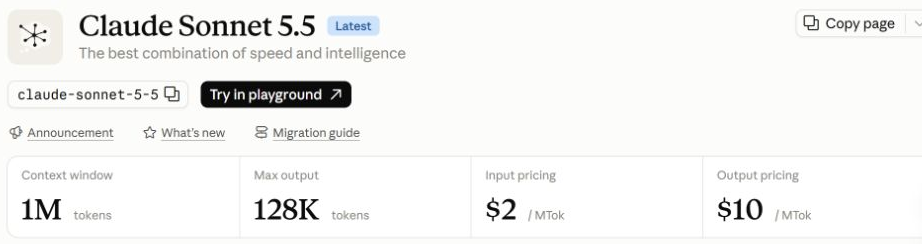
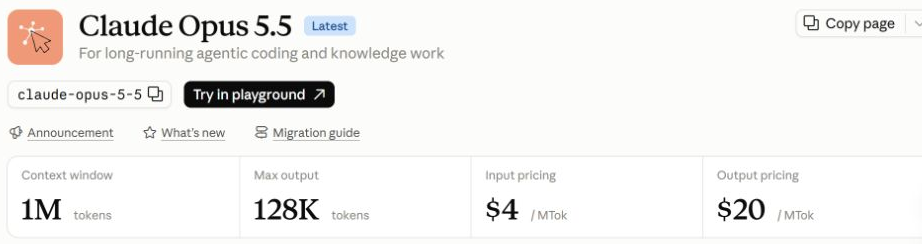
Pour un exemple simple sans mise en cache comprenant 100 000 tokens d'entrée et 20 000 tokens de sortie, les taux de tokens indiqués s'élèvent à environ $0,40 sur Sonnet 5,5 et à $0,80 sur Opus 5,5. Voir le Guide des tarifs et des limites du Claude pour le contexte du plan.
Contexte officiel de référence
Anthropic’s Annonce Sonnet 5.5 regroupe les deux modèles dans un même tableau fourni par le prestataire. La structure des lignes varie selon le critère de référence et le niveau d'effort.
| Indice de référence publié par Anthropic | Sonnet 5.5 | Opus 5.5 | Mesure |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,41 TP40T¹ | Codage des terminaux agentiques |
| FrontierCode v1.1 (version principale) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Si les modifications du code seraient intégrées |
| CursorBench 4.0 | 55.5% | 57.8% | Tâches de codage ambiguës portant sur plusieurs fichiers |
| GDPval-AA v2.1 | 1844 | 1846 | Le travail intellectuel dans les différentes professions |
| Le dernier examen de l'humanité | 64.5% avec outillage | 67,71 TP40T avec outillage | Raisonnement multidisciplinaire |
| OSWorld 2.1 | 80.1% partiel | 81,81 TP40T partiel | Tâches impliquant l'utilisation d'un ordinateur |
| Cartographie | 61,61 TP40T sans outils | 64,41 TP40T sans outils | Reconnaissance de graphiques visuels |
¹ Opus 5.5 Terminal-Bench utilise le niveau d'effort « xhigh » ; ² Sonnet 5.5 FrontierCode affiche 46,21 TP40T en mode « Max » et 52,11 TP40T en mode « Xhigh ». Les valeurs OSWorld sont indiquées comme partielles. Il s'agit de données propres au fournisseur, et non d'une nouvelle exécution indépendante à effort égal.
Méthode API avec la même invite
Chaque modèle a reçu les cinq mêmes consignes via ARTICLE https://anywhere.broly.ai/v1/messages. Le client a envoyé un message à un utilisateur, max_tokens : 8192, output_config.effort : élevé, et sans aucun outil. Chaque requête renvoyait un code HTTP 200 et fin_tour.
L'approche en matière de tests s'inscrit dans le cadre plus large de Flux de travail de test du modèle GlobalGPT. Un autre Guide de l'API Claude couvre la configuration des demandes et la gestion des jetons.
Durée, jetons et coût estimé
| Itinéraire | Heure locale : cinq points | Jetons d'entrée | Jetons de sortie | Pensée rapportée | Coût estimé de la demande* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Estimation basée sur les jetons signalés par l'itinéraire et les taux standard officiels. Le Sonnet 5.5 affichait un écart de 33,11 TP40T en moins sur le temps écoulé local et de 32,01 TP40T en moins sur le nombre de jetons de sortie dans ce groupe.
Cinq fiches d'activité assorties
Chaque fiche regroupe la tâche, les observations, l'heure locale, les jetons indiquant l'itinéraire, le statut et les limites.
Ces modèles permettent-ils de corriger une fonction de déduplication de type mixte ?
Configuration de la tâche : La consigne exacte a été copiée depuis le précédent Avis sur le Claude Opus 5.5 kit d'essai.
| Modèle | Durée / utilisation de l'itinéraire | Libellé abrégé du résultat |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 entrées / 830 sorties 0 réflexion HTTP 200 · fin de tour | Fonction corrigée et deux exercices ; explication plus succincte. |
| Claude Opus 5,5 | 15,844 s 145 entrées / 1 478 sorties 700 réflexions HTTP 200 · fin de tour | Fonction corrigée et deux tests supplémentaires ; analyse plus approfondie des cas limites. |
Comparaison observée : Les deux ont renvoyé une fonction corrigée et deux tests. Sonnet 5.5 utilisait des clés avec balise de type, casefold(), et une solution de repli sous forme de liste dans une réponse plus concise ; Opus 5.5 a consacré davantage de jetons de sortie à expliquer des cas limites supplémentaires. Aucune des deux exécutions ne permet de désigner un gagnant général en matière de codage.
Limite : Une simple petite correction en Python permet de vérifier des cas limites concrets, mais ne garantit pas la fiabilité d'un référentiel à l'autre ni celle du codage automatisé.
Les modèles peuvent-ils conserver les cinq faits fournis sans ajouter d'affirmations ?
Configuration de la tâche : La consigne exacte a été copiée depuis le précédent Avis sur le Claude Opus 5.5 kit d'essai.
| Modèle | Durée / utilisation de l'itinéraire | Libellé abrégé du résultat |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 entrées / 209 sorties 0 réflexion HTTP 200 · fin de tour | Cinq puces numérotées ; les informations fournies ont été conservées. |
| Claude Opus 5,5 | 4,374 s 210 entrées / 312 sorties 101 façons de penser HTTP 200 · fin de tour | Cinq puces numérotées ; les informations fournies ont été conservées. |
Comparaison observée : Les deux ont généré exactement cinq puces numérotées et sont restés fidèles aux informations fournies. Sonnet 5.5 a utilisé 209 jetons de sortie contre 312 pour Opus 5.5, mais la consigne était une brève note plutôt qu’une entrée à contexte étendu.
Limite : Il s'agit d'un test d'extraction et de mise en forme en conditions réelles ; cela ne constitue pas une preuve des performances en contexte portant sur un million de tokens.
Les modèles peuvent-ils renvoyer exactement la structure demandée ?
Configuration de la tâche : La consigne exacte a été copiée depuis le précédent Avis sur le Claude Opus 5.5 kit d'essai.
| Modèle | Durée / utilisation de l'itinéraire | Libellé abrégé du résultat |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 entrées / 260 sorties 0 réflexion HTTP 200 · fin de tour | JSON analysable ; clés demandées et nombre d'éléments. |
| Claude Opus 5,5 | 8,276 s 128 entrées / 622 sorties 390 réflexions HTTP 200 · fin de tour | JSON analysable ; clés demandées et nombre d'éléments. |
Comparaison observée : Les deux ont renvoyé un JSON analysable contenant les clés demandées, ainsi que deux avantages et deux inconvénients. La version Sonnet 5.5 était plus concise, avec 260 tokens en sortie ; les chaînes de caractères décrivent un scénario fictif d'avis client et ne constituent pas des informations sur le produit.
Limite : Le fait de valider ce schéma une seule fois ne permet pas d'évaluer la fiabilité des résultats structurés lors de l'appel d'outils ou de longues conversations.
Les modèles sont-ils capables de conserver la séquence arrondie des lots jusqu'à la réponse finale ?
Configuration de la tâche : La consigne exacte a été copiée depuis le précédent Avis sur le Claude Opus 5.5 kit d'essai.
| Modèle | Durée / utilisation de l'itinéraire | Libellé abrégé du résultat |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 entrées / 163 sorties 0 réflexion HTTP 200 · fin de tour | Résultat correct : 67 ; indiquer la réponse finale sur une ligne à part. |
| Claude Opus 5,5 | 3,830 s 89 entrées / 257 sorties 74 réflexions HTTP 200 · fin de tour | Résultat correct : 67 ; indiquer la réponse finale sur une ligne à part. |
Comparaison observée : Les deux ont calculé 67 et ont affiché la réponse finale sur une ligne distincte. Sonnet 5.5 a utilisé 163 tokens de sortie contre 257 pour Opus 5.5, sans qu’aucune différence de justesse n’ait été observée pour cette consigne.
Limite : Une suite arithmétique ne permet pas d'évaluer la fiabilité d'un raisonnement général.
L'itinéraire peut-il conserver la structure en deux paragraphes demandée ?
Configuration de la tâche : La consigne exacte a été copiée depuis le précédent Avis sur le Claude Opus 5.5 kit d'essai.
| Modèle | Durée / utilisation de l'itinéraire | Libellé abrégé du résultat |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 entrées / 1 224 sorties 987 réflexions HTTP 200 · fin de tour | Deux paragraphes en chinois ; pas de mise en forme supplémentaire. |
| Claude Opus 5,5 | 15,401 s 128 entrées / 1 283 sorties 949 réflexions HTTP 200 · fin de tour | J'ai abordé les différents points ; j'ai ajouté le Markdown et une note en anglais. |
Comparaison observée : Sonnet 5.5 a fourni les deux paragraphes en chinois demandés sans mise en forme supplémentaire. Opus 5.5 a également couvert les points demandés, mais a ajouté une mise en forme Markdown et une note en anglais. Ce rapport porte sur le respect du format au cours d’un cycle de traitement, et non sur la qualité globale du chinois.
Limite : La consigne demande une introduction sur Opus 5.5 ; le texte en lui-même ne constitue donc pas une référence en matière de langage neutre.
Précautions concernant l'API et la migration
Sonnet 5.5 utilise par défaut le mode de réflexion adaptatif ; la commande « thinking: disabled » renvoie une erreur 400, et le paramètre « max_tokens » englobe à la fois la réflexion et le texte de réponse. La commande « tool_choice any/tool » forcée est rejetée. Analysez les blocs de contenu par type et réajustez les budgets de tokens avant de changer de mode.
Ce que les données factuelles confirment
Verdict au niveau de la tâche
Sonnet 5.5 : coût et temps mesurés inférieurs sur cet itinéraire, avec une conformité parfaite au format requis pour la tâche chinoise.
Opus 5.5 : plus chers et plus coûteux ici ; les résultats des tests de performance officiels restent supérieurs pour plusieurs tâches ouvertes.
Appuyez-vous sur les données relatives aux tâches pour choisir un point de départ, puis évaluez la charge de travail qui vous importe.
Pour le contexte connexe, voir la Comparaison de la gamme Claude, Critique d'Opus 5, et Critique de Fable 5.1.
FAQ
Quel modèle s'est révélé le plus rapide lors du test comparatif ?
Sonnet 5.5 a enregistré le temps total local le plus faible : 31,930 secondes contre 47,725 secondes pour Opus 5.5, sur cinq requêtes consécutives. Ce résultat tient compte de l'itinéraire et du chemin réseau utilisés ici ; il ne s'agit donc pas d'une latence liée au fournisseur d'accès.
Quel modèle a utilisé le moins de jetons de sortie ?
Sonnet 5.5 a utilisé 2 686 tokens de sortie signalés par l'itinéraire pour les cinq tâches, contre 3 952 pour Opus 5.5. Le nombre de tokens ne suffit pas à lui seul à attester de la qualité des réponses.
Quel modèle était le moins cher lors de cette série de tests ?
En se basant sur les taux officiels standard de l'API et sur les nombres d'entrées/sorties renvoyés, les cinq requêtes Sonnet 5.5 sont estimées à $0,02826, contre $0,08184 pour Opus 5.5. Ce calcul ne tient pas compte des frais de cache, des crédits de plateforme, des taxes et des marges.
Le Sonnet 5.5 surpasse-t-il l'Opus 5.5 dans tous les tests de performance ?
Le tableau propre à Anthropic présente des résultats hétérogènes selon les benchmarks et les paramètres de test : le Sonnet 5.5 obtient de meilleurs résultats sur Terminal-Bench 4.0, tandis que l’Opus 5.5 obtient de meilleurs résultats sur FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld et Chartography. Il s’agit de résultats communiqués par les fournisseurs, et non d’une nouvelle exécution indépendante.
L'API Sonnet 5.5 constitue-t-elle un remplacement direct ?
Non. Le guide de migration indique que la fonction « thinking » s'exécute par défaut, que la commande « thinking: disabled » renvoie une erreur 400, que le choix forcé de l'outil « any/tool » est rejeté, et que les clients doivent analyser les blocs de contenu par type. Réajustez les budgets de jetons et les boucles d'outils avant de procéder à la migration.
S'agissait-il d'un test de performance à long terme ?
Non. L'invite d'extraction contient un court passage. Elle vérifie la cohérence factuelle et le formatage exact ; elle n'évalue pas le comportement à proximité de la fenêtre de contexte documentée de 1 million de tokens.



