Claude Sonnet 4.5 est un modèle ancien doté d’une identité bien définie : Anthropic l’a lancé le 29 septembre 2025 pour la programmation, les flux de travail agentiques, l’utilisation de l’ordinateur et les tâches longues comportant plusieurs étapes. Si une application existante en dépend, la décision repose sur trois éléments : ses atouts en matière de programmation, le coût de son exploitation et le travail nécessaire pour passer à un autre modèle.
Pour les développeurs qui jonglent entre la recherche, la rédaction, l'assistance au codage et des tâches spécifiques à un modèle, GlobalGPT offre un espace de travail connecté unique. Un seul abonnement donne accès à un vaste catalogue de modèles et à de nombreuses fonctionnalités d'IA, ce qui en fait une solution économique pour couvrir l'ensemble d'un workflow de développement. L'interface en ligne de commande (CLI) de GlobalGPT relie ce workflow à votre terminal et à vos outils de développement existants.
Qu'est-ce que le Claude Sonnet 4.5 ?
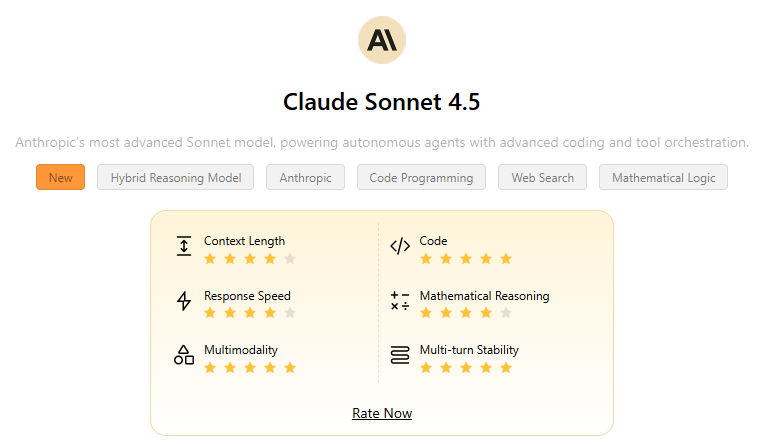
Le Sonnet 4.5 constituait, lors de son lancement, le modèle intermédiaire polyvalent de la gamme Anthropic : plus performant qu’un modèle d’entrée de gamme pour les tâches logicielles complexes, tout en étant proposé à un prix inférieur à celui de la gamme Opus. La gamme Anthropic annonce de lancement a mis l'accent sur la programmation, l'utilisation de l'ordinateur, la création d'agents, le raisonnement et les mathématiques.
Ces déclarations concernent la version prévue pour septembre 2025. Elles ne font pas de Sonnet 4.5 la toute dernière option Claude disponible en 2026, et les résultats des tests de performance d'un fournisseur ne constituent pas une garantie pour toutes les bases de code. La décision à prendre aujourd'hui est de savoir si vous avez besoin du comportement connu de ce modèle ou si vous pouvez passer à une nouvelle configuration par défaut.
État actuel des API et suivi des API en voie de retrait
claude-sonnet-4-5Le tableau de fin de vie des modèles de Anthropic présentait un instantané obsolète claude-sonnet-4-5-20250929 comme Actif lorsqu'on vérifie le 30 septembre 2026. La même ligne indique Au plus tôt le 29 septembre 2026. Cette formulation correspond à une limite inférieure, et non à une date de fermeture prévue. Consultez le tableau du cycle de vie en temps réel avant toute migration en production.
Ce que révèlent les données de lancement
Ces éléments probants sont précis et datés. Ils montrent pourquoi le Sonnet 4.5 est devenu une référence en matière de codage, tandis que les conditions de test expliquent jusqu'où chaque nombre peut aller.
Résultats relatifs à l'utilisation des ordinateurs lors du lancement
Taux de réussite d'OSWorld, sur une échelle de 0 à 100%. Plus le chiffre est élevé, mieux c'est.
Source : Annonce du lancement du Anthropic, 29 septembre 2025 ; consulté le 28 septembre 2026. Une progression de 19,2 points de pourcentage dans l'évaluation communiquée ; cela ne garantit pas pour autant la réussite générale des tâches sur ordinateur.
| Preuves | Résultat de la période de lancement | Comment le lire |
|---|---|---|
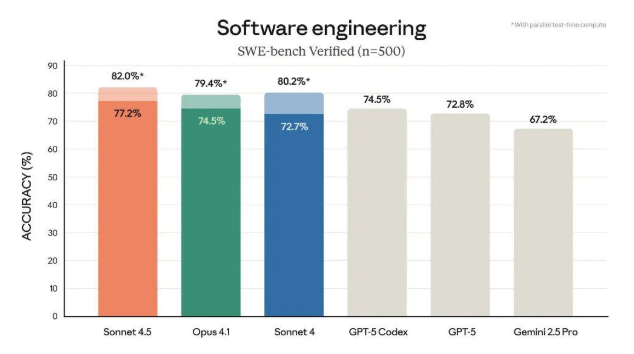
| Banc SWE Vérifié | Résultat préliminaire 77.2% | 500 problèmes, moyenne calculée sur 10 essais, pas de temps de calcul supplémentaire pendant le test, budget de réflexion de 200 000 |
| Variante haute performance de calcul de SWE-bench | 82.0% | Tentatives parallèles, filtrage par régression visible et sélection interne des candidats |
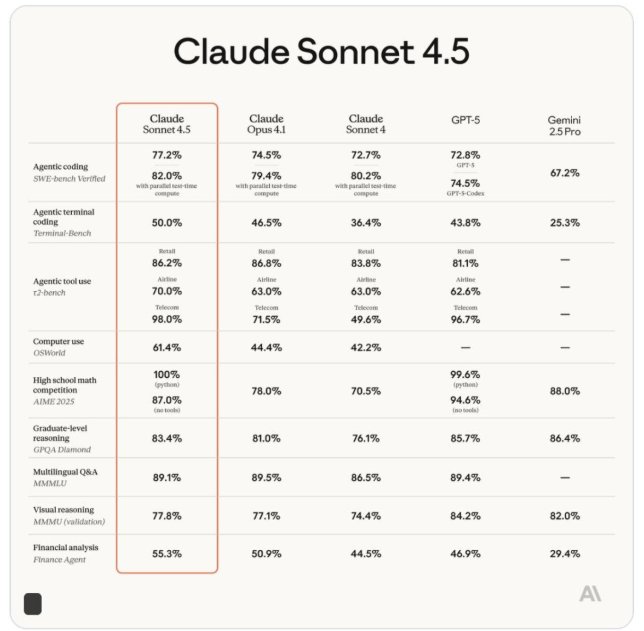
| OSWorld | 61,41 TP40T contre Sonnet 4 à 42,21 TP40T | Comparaison des performances de l'ordinateur Anthropic selon les tests de référence publiés |
Le résultat principal de Anthropic, validé par SWE-bench (77,2%), couvrait l’ensemble des 500 problèmes, avec une moyenne de 10 essais, sans recours à des ressources de calcul supplémentaires pendant la phase de test, et en utilisant un budget de réflexion de 200 000. Le chiffre de 82,01 TP40T provient d’une configuration distincte à forte intensité de calcul, avec des tentatives parallèles, un filtrage des régressions visibles et une sélection interne des candidats. Il s’agit là de conditions d’évaluation différentes.
Anthropic a également enregistré un score de 61,41 TP40T sur OSWorld, contre 42,21 TP40T pour le Sonnet 4 quatre mois plus tôt. Les tests OSWorld évaluent des tâches informatiques ; ce résultat reflète donc l'interaction avec des environnements logiciels, mais ne garantit pas la réussite dans tous les flux de travail sur ordinateur de bureau.
Anthropic a indiqué avoir constaté que le Sonnet 4.5 restait concentré pendant plus de 30 heures sur des tâches complexes comportant plusieurs étapes. Il s'agit là d'une observation du fabricant, et non d'une garantie que chaque tâche de l'utilisateur s'exécutera pendant 30 heures, ni que l'autonomie ininterrompue soit toujours souhaitable.
Mises à jour du code et des agents dès le lancement
Cette version regroupait des modifications apportées aux modèles et aux outils. La version Anthropic mettait en avant des points de contrôle permettant de sauvegarder et de revenir en arrière, un terminal remanié, une extension native pour VS Code, des outils d’édition contextuelle et de gestion de la mémoire, l’exécution de code et la création de fichiers, ainsi que le SDK de l’agent Claude.
- Points de contrôle aider à se remettre d'un mauvais passage lors d'une longue session de programmation sans perdre toute la session.
- Le SDK de l'agent Claude présente le fondement Anthropic utilisé pour le code Claude, afin que les équipes puissent développer des agents adaptés à des tâches spécifiques.
- L'utilisation simultanée d'outils et les tâches à plus long terme faisaient partie du récit de lancement ; il convient de consulter la documentation en ligne pour connaître les commandes et les menus actuels.
- Le code Claude, l'API et l'application web constituent des voies d'accès distinctes. Choisissez celle qui correspond à vos autorisations, à votre mode de facturation et à votre processus de validation.
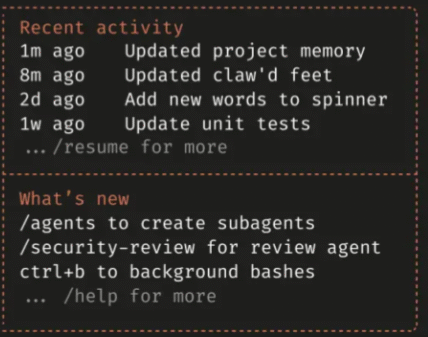
Pour plus de détails sur la mise en œuvre, consultez la documentation pour développeurs en ligne de Anthropic plutôt que de reproduire les instructions de lancement de 2025. L’identifiant du modèle constitue un point de départ fiable ; il convient de vérifier la conformité des outils et du comportement des clients par rapport à l’API actuelle et à la documentation relative au code Claude.
Le communiqué de lancement cite également Michael Truell, PDG de Cursor, qui évoque une meilleure performance en matière de codage et une exécution des tâches à plus long terme. Cette évaluation des clients contribue à expliquer l'attrait de cette version auprès des développeurs, tandis que les méthodes de benchmarking mentionnées ci-dessus fournissent une base de comparaison plus précise.
Tarification et accès à l'API
Le Tableau des tarifs Anthropic indique que le Sonnet 4.5 coûte $3 par million de jetons d'entrée et $15 par million de jetons de sortie. Son tableau tarifaire mentionne également des taux de traitement par lot et des taux d'écriture/lecture du cache de prompts inférieurs pour les charges de travail réutilisant un contexte long ; la page tarifaire a été consultée le 28 septembre 2026.
| Route API | Entrée | Sortie | Quand ça convient |
|---|---|---|---|
| API standard | $3 / MTok | $15 / MTok | Demandes interactives et appels de production courants |
| API par lots | $1.50 / MTok | $7.50 / MTok | Tâches asynchrones en masse ; le code Anthropic correspond à une remise de 50% sur un jeton |
| Cache de prompt | $3,75 / MTok (écriture toutes les 5 minutes) ou $6 / MTok (écriture toutes les heures) | - | Instructions longues répétées ; les lectures en cache sont de $0,30 / MTok |
Même charge de travail : mode standard vs mode par lots
100 000 jetons d'entrée non mis en cache + 10 000 jetons de sortie. USD ; évolutivité à partir de zéro jusqu'à $0,45.
Calcul à partir de Tarifs de Anthropic, consulté le 28 septembre 2026. Le traitement par lots réduit le coût de ce jeton de 50% lorsque le traitement asynchrone est adapté. Ne tient pas compte de la mise en cache, des modificateurs régionaux et d'autres frais ; il s'agit d'un exemple et non d'une facture réelle.
Une requête comportant 100 000 jetons d'entrée non mis en cache et 10 000 jetons de sortie correspondrait à environ $0,45 aux tarifs standard, avant prise en compte du cache, de la résidence des données ou d'autres modificateurs. Avec le même nombre de jetons en mode Batch, le coût serait d’environ $0,225. Il s’agit d’exemples arithmétiques et non d’un devis de facturation.
Pour l'application grand public, le code Claude, GlobalGPT et l'API, les modalités d'accès et de facturation peuvent varier. Si vous souhaitez utiliser Sonnet 4.5 au sein d'un espace de travail multimodèle, ouvrir la page actuelle « Sonnet 4.5 » de GlobalGPT. Pour les appels API en production, utilisez la console Anthropic et la documentation relative à l'API.
Comment utiliser le Sonnet 4.5 aujourd'hui
Il existe trois approches judicieuses, chacune répondant à un besoin différent :
- Espace de travail GlobalGPT : Ouvrir le Sonnet 4.5 avec d'autres modèles et fonctions lorsque vous souhaitez travailler de manière intégrée sur le chat, la recherche, la rédaction ou l'aide au codage sans avoir à gérer plusieurs interfaces distinctes.
- API Anthropic : utiliser
claude-sonnet-4-5dans l'API Messages lorsque vous êtes propriétaire de l'application, que vous avez besoin d'une facturation directe ou que vous souhaitez épingler un instantané. - Code Claude ou intégration à un éditeur : Utilisez cette approche lorsque la gestion du référentiel, l'accès à la ligne de commande et les autorisations de révision sont tout aussi importants que le modèle lui-même.
Données relatives à la sécurité
L'annonce du lancement de Anthropic décrivait Sonnet 4.5 comme son modèle de pointe le plus abouti à l'époque et faisait état d'une réduction de comportements tels que la flagornerie, la tromperie, la soif de pouvoir et l'encouragement à la pensée délirante. Elle mentionnait également des progrès réalisés en matière d'injection de prompts pour les systèmes agentiels et les systèmes d'utilisation informatique.
Le graphique de l'auditeur comportemental ci-joint ne constitue pas une garantie générale de sécurité. Il est présenté comme un scénario simulé et utilise des intervalles de confiance de type « bootstrap » 95% ; les scores les plus bas sont les meilleurs. Le résultat fournit des indications sur la configuration testée, mais ne prouve pas que chaque déploiement soit sûr ni que l'injection de messages d'alerte disparaisse.
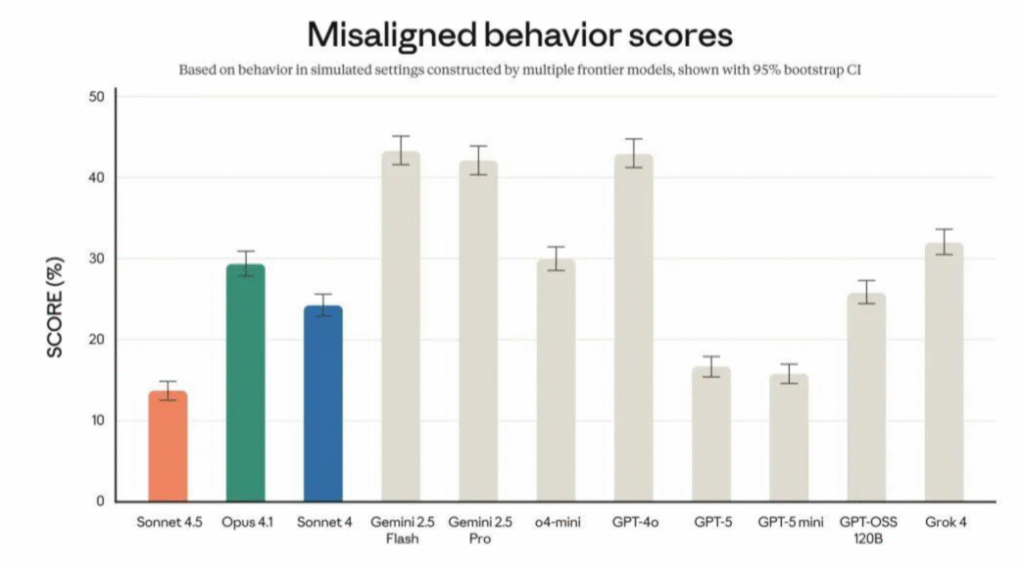
Lire l' Carte système Claude Sonnet 4.5 pour connaître les détails de l'évaluation et les limites du modèle avant de l'utiliser dans un processus à fort impact.
Alternatives actuelles et recommandations en matière de compatibilité
Anthropic’s Présentation des modèles actuels répertorie les familles les plus récentes aux côtés de la version 4.5. Le choix dépend de la tâche à effectuer :
Conserver le Sonnet 4.5
Sélectionnez cette option lorsque votre intégration, votre ensemble de messages ou votre historique de régression dépendent du comportement prévu pour 2025 et que la ligne de cycle de vie prend toujours en charge votre déploiement.
Passer à une version plus récente de Sonnet
Optez pour la gamme Sonnet actuelle si vous souhaitez bénéficier d'un paramètre par défaut pris en charge et si vous pouvez vous permettre de passer par une étape de mise en conformité avant de modifier l'identifiant du modèle.
Choisissez une autre famille
Optez pour un modèle de type « Opus » si vous recherchez une analyse plus approfondie, ou pour un modèle de type « Haiku » si vous privilégiez la rapidité et des charges de travail moins lourdes ; vérifiez le résultat en fonction de la tâche que vous exécutez réellement.
Pour un chemin de comparaison spécifique au modèle Claude, voir Guide des alternatives au Claude Sonnet 4.5 de GlobalGPT. Pour plus d'informations sur l'API et le contexte du forfait, le guide tarifaire actuel Claude explique comment s'articulent les abonnements, les frais liés aux API et les limites d'utilisation.
Le Sonnet 4.5 vaut-il toujours la peine d'être utilisé ?
Oui, lorsqu'il s'agit d'un travail de codage nécessitant une compatibilité particulière, d'un workflow de code Claude connu, ou d'un test de performance et de régression de référence. Les preuves de lancement restent utiles, l'identifiant de l'API est clair, et la page du cycle de vie indiquait que l'instantané était « Actif » lors de la dernière vérification enregistrée.
En l'absence de contrainte de compatibilité, il est moins intéressant d’adopter ce nouveau modèle par défaut. Un modèle plus récent pris en charge peut offrir de meilleurs outils ou un meilleur raisonnement, et la date limite de retrait fixée au 29 septembre 2026 justifie la mise en place d’un plan de migration. Comparez vos propres invites et appels d’outils, puis choisissez le modèle qui répond le mieux à vos besoins en matière de flux de travail.
FAQ
Qu'est-ce que Claude Sonnet 4.5 ?
Il s'agit du modèle de codage et d'agent de Anthropic datant de septembre 2025. L'identifiant de son modèle API est claude-sonnet-4-5, avec l'instantané daté claude-sonnet-4-5-20250929.
Le Claude Sonnet 4.5 est-il toujours actif ?
Le tableau du cycle de vie de Anthropic indiquait que l'instantané daté était “ Actif ” lors de la vérification effectuée le 30 septembre 2026. La ligne précise également « Pas avant le 29 septembre 2026 », ce qui correspond à une limite inférieure plutôt qu'à une date de retrait définitive. Vérifiez à nouveau le tableau en temps réel avant tout déploiement à long terme.
Combien coûte l'API Sonnet 4.5 ?
Les tarifs standard sont de $3 par million de jetons d'entrée et de $15 par million de jetons de sortie. Les tarifs par lot sont respectivement de $1,50 et de $7,50. Les écritures et les lectures en cache sont facturées selon des tarifs distincts.
Claude Sonnet 4.5 est-il gratuit ?
L'utilisation directe de l'API est facturée au jeton. L'accès via Claude ou GlobalGPT est soumis à la formule et aux limites d'utilisation du service ; vérifiez les caractéristiques du service sélectionné avant de lancer une charge de travail importante.
Cette affirmation concernant les 30 heures constituait-elle une garantie pour l'utilisateur ?
No. Anthropic a indiqué avoir observé plus de 30 heures d'exécution pour des tâches complexes comportant plusieurs étapes. Il s'agit d'une observation ancienne du fournisseur, et non d'une garantie valable pour tous les utilisateurs ou toutes les charges de travail.
Le Sonnet 4.5 est-il meilleur que le ChatGPT 5 ?
Il ne peut y avoir de vainqueur sans tâche, sans ensemble de consignes, sans outils et sans règle de notation. Comparez les modèles en fonction de votre processus de codage, de raisonnement et d'utilisation des outils, plutôt que de considérer un extrait de recherche comme une référence.
Pour utiliser Sonnet 4.5 en parallèle de vos autres outils d'IA, ouvrir la page du modèle GlobalGPT actuel. Commencez par une véritable question de programmation ou une tâche de débogage, puis transposez ce même contexte de projet dans la recherche et la documentation.