
La version Grok 4.7 constitue une avancée majeure en matière de programmation et de travail intellectuel, mais il est encore trop tôt pour tirer des conclusions définitives : les annonces officielles concernant le lancement et les tests de performance indépendants indiquent certes une amélioration, mais pas une réussite universelle.
Réponse rapide
Grok 4.7 est la mise à jour de xAI prévue pour le 21 septembre 2026, destinée au codage et aux tâches complexes de travail intellectuel. xAI affirme que cette version consacre plus de temps aux problèmes complexes, vérifie son travail avec plus de rigueur et intègre une nouvelle pile de mesures de sécurité, tout en conservant le même prix et la même vitesse que la version Grok 4.6. La page de lancement la présente également comme deux fois plus rapide et deux fois moins chère que les modèles comparables, une comparaison entre fournisseurs qu’il convient de replacer dans le contexte des tâches et des parcours sous-jacents. Les données indépendantes d’Artificial Analysis lui attribuent une légère amélioration globale par rapport à Grok 4.6 et font état d’une fenêtre de contexte de 500 000. Lors de notre test API à trois tâches, le Grok 4.7 s’est montré le plus performant en matière de débogage et de respect des limites de la source ; son plan de projet a bien pris en compte l’incertitude, mais s’est avéré moins exploitable que demandé. Il s’agit là d’une preuve pratique utile, et non d’une démonstration qu’il surpasse tous les modèles concurrents.
Qu'est-ce que le Grok 4.7 ?
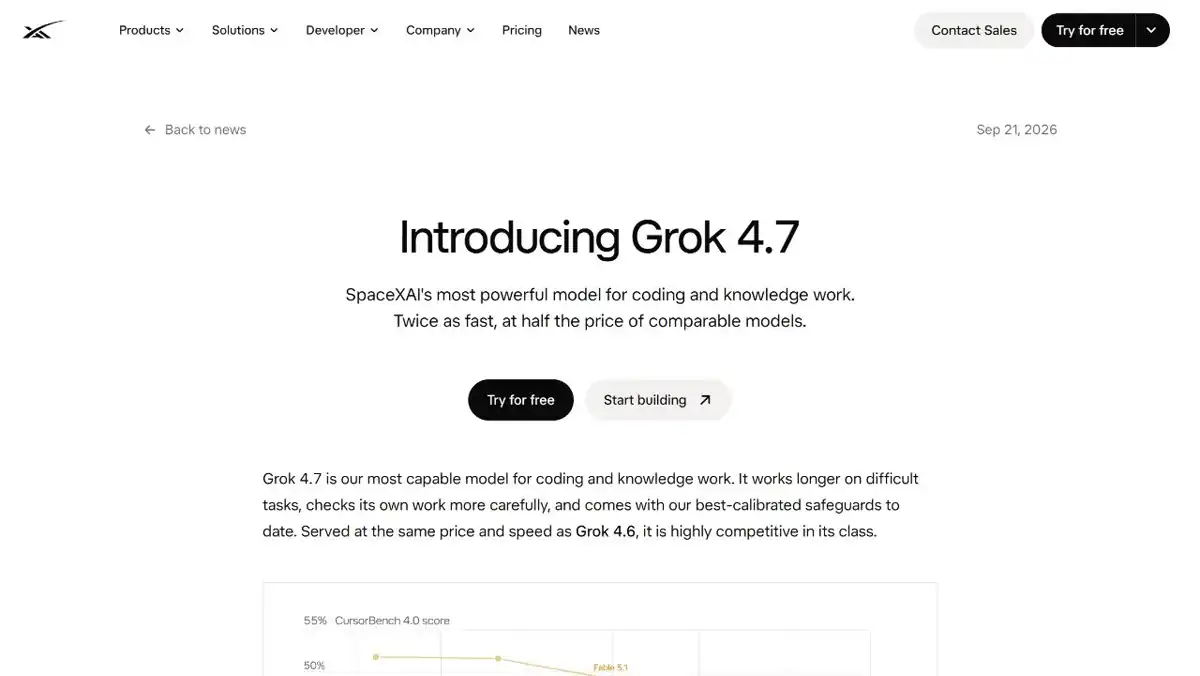
Le Grok 4.7 est le dernier modèle de la gamme Grok de xAI, annoncé le 21 septembre 2026. Le Communiqué officiel de xAI ce qui en fait le modèle le plus performant de l'entreprise pour le codage et le travail intellectuel. Le véritable changement ne réside pas dans une nouvelle liste de fonctionnalités destinées aux consommateurs. Il s'agit plutôt d'une évolution dans la manière dont le modèle est censé répartir ses efforts : davantage de temps consacré aux tâches complexes, davantage d'autocontrôle, ainsi qu'un niveau de sécurité supplémentaire visant à rendre ces capacités accrues plus faciles à maîtriser.
Ce positionnement est important, car il décrit un modèle de flux de travail plutôt qu’une personnalité de chatbot. Le modèle Grok 4.7 est présenté comme un outil destiné aux tâches qui nécessitent une analyse approfondie : débogage, planification, rédaction technique, synthèse de recherches et requêtes longues exigeant que le modèle tienne compte de plusieurs contraintes.
La distinction est tout aussi importante. L’annonce de xAI est une déclaration du fournisseur concernant le comportement escompté. Il ne s’agit pas d’une preuve indépendante que Grok 4.7 surpasse tous les modèles concurrents, toutes les invites ou tous les dépôts de code. Considérez la page de lancement comme la source des affirmations de xAI, puis utilisez des mesures indépendantes et votre propre tâche pour déterminer si ces affirmations sont pertinentes.
Grok 4.7 vs Grok 4.6 : qu'est-ce qui a réellement changé ?
La synthèse la plus défendable est celle d'une amélioration en termes d'effort et de fiabilité, et non d'un produit totalement différent.
| Zone | Grok 4,7 | Ce que les données factuelles confirment |
|---|---|---|
| Sortie | 21 septembre 2026 | Date indiquée sur la page officielle de lancement de xAI |
| Positionnement principal | Programmation et travail intellectuel | Positionnement officiel de xAI |
| Tâches difficiles | Un effort plus long et une auto-évaluation plus rigoureuse | Description officielle de xAI ; notre test de l'API sur trois tâches constitue un petit essai pratique, et non une comparaison à part entière. |
| Sécurité | Nouvelle pile de sauvegarde | Description officielle de xAI |
| Prix et rapidité | Identique au modèle Grok 4.6, selon xAI | Une affirmation liée au lancement, et non un audit de prix réalisé par un tiers |
| Contexte | 500 000 jetons dans le profil « Analyse artificielle » | Profil de mannequin indépendant ; vérifiez l'itinéraire que vous empruntez |
| Contrôles de raisonnement | De ’ Low » à « xhigh » dans le classement d'Artificial Analysis | Métadonnées indépendantes relatives aux itinéraires/modèles |
Il s'agit là d'une distinction utile pour les acheteurs. Si la version Grok 4.6 correspondait déjà à votre flux de travail, la version 4.7 constitue une mise à niveau sans difficulté particulière qui mérite d'être envisagée. Si la version 4.6 ne convenait pas en raison de contraintes liées à l'écosystème, à la latence, à la fiabilité ou à l'accès, un score de benchmark plus élevé ne suffira pas à lui seul à résoudre ces problèmes.
Pour un cadre plus large d'achat de modèles, le Guide des tarifs GPT-5.6 et Comparaison GPT-5.6 constituent des rappels utiles pour distinguer la qualité du modèle des aspects économiques du projet et de l'adéquation avec le flux de travail.
Fonctionnalités : les avantages du modèle Grok 4.7
Codage et débogage
Le principal argument de vente de xAI réside dans le codage. La promesse ne se limite pas au fait que Grok 4.7 écrive davantage de code ; elle réside dans sa capacité à se pencher plus longtemps sur un problème technique complexe, à analyser sa propre réponse et à fournir un correctif ou une explication plus mûrement réfléchie. C’est le comportement que l’on attend d’un véritable référentiel : préserve-t-il la conception existante, identifie-t-il la cause première, ajoute-t-il des tests utiles et précise-t-il ce qu’il ne peut toujours pas savoir ?
N’évaluez pas le modèle à partir d’une consigne de type “ créer une application de liste de tâches ” partant de zéro. Donnez-lui un bug bien délimité accompagné d’un test qui échoue, d’un petit ensemble de fichiers et de contraintes explicites. Demandez un diagnostic avant un correctif. Cela permet de voir plus facilement si le raisonnement plus long réduit réellement le travail de révision ou s’il ne fait que produire un texte plus long.
La même règle s'applique aux équipes qui comparent différentes méthodes de codage. A Test du DeepSeek V4 Pro et le Examen du plan de codage GLM fournissent un cadre de comparaison utile, mais aucune de ces deux sources ne doit être considérée comme un substitut aux tests que vous effectuez sur le référentiel et la chaîne d'outils que vous utilisez réellement.
Travail intellectuel s'inscrivant dans un contexte à long terme
Artificial Analysis indique une fenêtre de contexte de 500 000 tokens pour la version Grok 4.7. Cette taille est suffisamment importante pour changer votre façon d’aborder les tâches nécessitant beaucoup de contenu source : un long cahier des charges technique, un ensemble de comptes-rendus de réunion, un extrait de base de code ou un dossier de recherche peuvent ainsi rester au sein d’une même conversation, au lieu d’être résumés à plusieurs reprises.
La capacité contextuelle ne doit pas être confondue avec la qualité contextuelle. Un modèle peut accepter un texte volumineux tout en omettant une contrainte située vers le milieu, en accordant trop d’importance au dernier paragraphe ou en produisant un résumé qui semble fiable mais dont il faut vérifier les sources. Le test pratique consiste à évaluer la capacité de recherche sous pression : placez quelques faits déterminants à différents endroits d’un long document, demandez une décision soumise à des contraintes, puis vérifiez si la réponse cite les passages appropriés.
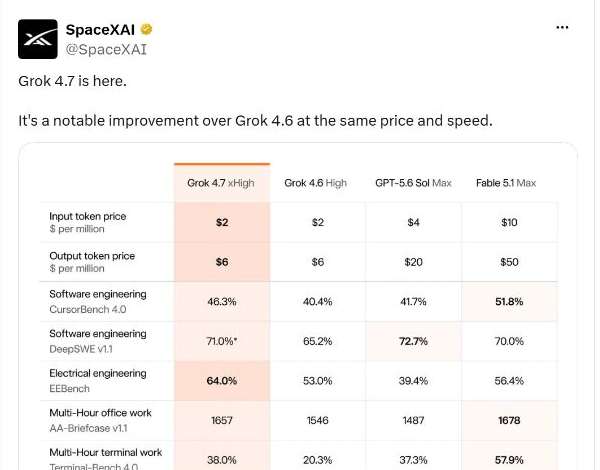
Le compte X officiel de SpaceXAI a repris ce 22 septembre le message promotionnel concernant le lancement, qualifiant le Grok 4.7 d’amélioration notable par rapport au Grok 4.6, à prix et vitesse égaux, et partageant le graphique comparatif des modèles. Cette publication constitue une preuve utile du positionnement public de l’entreprise, mais ne constitue ni une validation indépendante ni un consensus de la communauté.
Si le modèle est utilisé à des fins de recherche, veillez à ce que la boucle de preuve reste visible. Notre Comparaison entre Gemini et Perplexity et Guide des alternatives à Perplexity soulignent tous deux le même aspect pratique : une réponse bien formulée ne remplace pas un audit des sources.
Autocontrôle et sécurité
Selon xAI, la version Grok 4.7 vérifie son travail avec plus de rigueur et intègre une nouvelle pile de mesures de sécurité. Il s'agit là d'objectifs louables, en particulier lorsque le modèle est amené à prendre une longue série de décisions. Ils ne garantissent toutefois pas que le résultat soit correct ou sûr pour une exécution automatique.
En environnement de production, veillez à maintenir les contrôles habituels autour du modèle : tests, autorisations, vérification humaine, contrôle des citations et condition d’arrêt claire. L’autocontrôle du modèle constitue un signal supplémentaire à prendre en compte, mais ne remplace en aucun cas les contrôles qui l’entourent.
Tests de performance du Grok 4.7 : ce que révèlent les chiffres
Un résultat de codage solide : selon le classement officiel, la version Grok 4.7 devance la version Grok 4.6.
La comparaison avec le modèle de plus grande taille révèle un gain significatif sur ce test de performance dédié au travail intellectuel.
Un indicateur utile pour les processus impliquant l'utilisation d'outils, mais qui reste une évaluation ponctuelle plutôt qu'une note universelle.
Cet indice indépendant va dans le même sens : il témoigne d'une amélioration, mais ne constitue pas la preuve d'une victoire générale.
Considérez ces fiches comme des indications. La composition de l'ensemble de données, l'accès aux outils, l'échantillonnage et les paramètres du modèle peuvent modifier le classement.
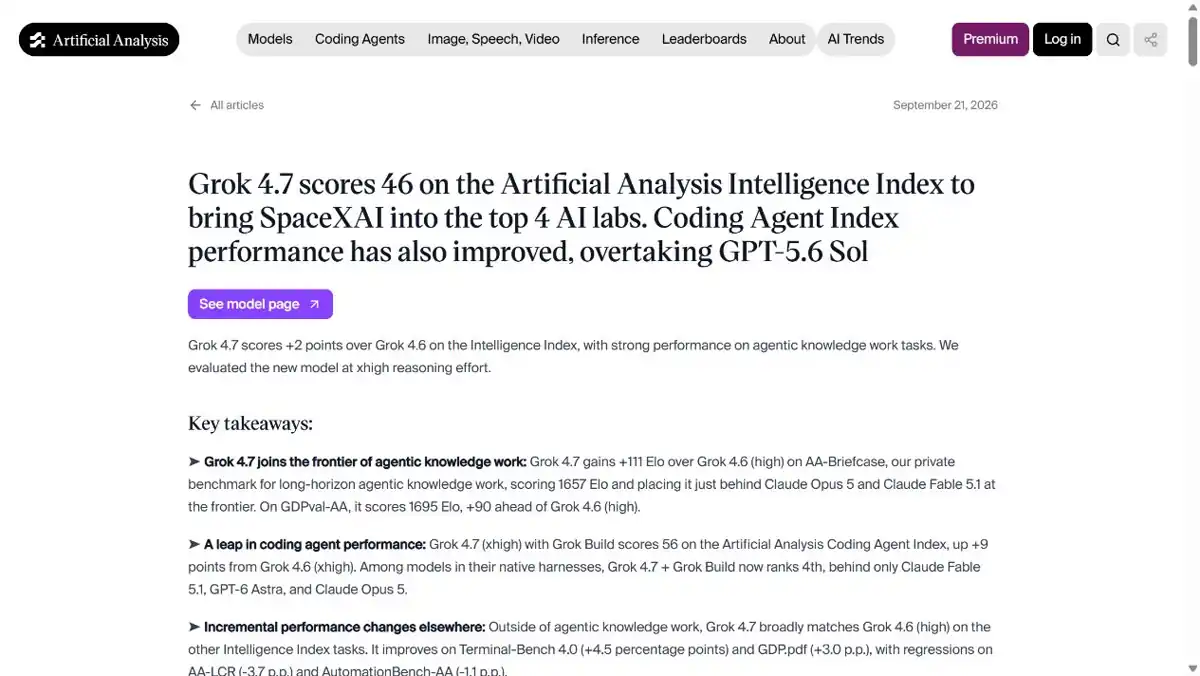
L'aperçu indépendant le plus utile provient actuellement de Article d’« Artificial Analysis » sur l'évaluation comparative du Grok 4.7, en date du 21 septembre 2026.
| Mesure | Résultat publié | Comment le lire |
|---|---|---|
| Indice d'analyse par intelligence artificielle | 46 | Deux points de plus que le Grok 4,6 dans le même indice |
| AA-Porte-documents | 1 657 Elo | 111 Elo au-dessus de Grok 4,6 dans cette évaluation |
| Fenêtre de contexte | 500 000 jetons | Un champ de profil de modèle, et non la preuve d'une récupération parfaite dans un contexte étendu |
| Effort de raisonnement | Faible à très élevé | Un contrôle au niveau de l'itinéraire répertorié par Artificial Analysis |
La tendance est encourageante : l'indice indépendant montre une amélioration par rapport à la version précédente, et l'écart Elo plus important observé dans AA-Briefcase suggère un gain plus marqué pour cette évaluation en particulier. Cependant, le tableau présente toujours deux ensembles de données, et non un classement universel. La composition des benchmarks, l'accès aux outils, l'échantillonnage et les paramètres des modèles peuvent influencer le résultat.
La page officielle de lancement de xAI indique Grok 4,7 à 46,31 TP40T sur CursorBench 4.0 dans son tableau comparatif, aux côtés du Grok 4,6 à 40,41 TP40T, du GPT-5.6 Sol à 41,71 TP40T et du Fable 5.1 à 51,81 TP40T. La page indique également 71,01 TP40T sur DeepSWE v1.1 avec un niveau d’effort élevé, 64,01 TP40T sur EEBench et 1 657 sur AA-Briefcase v1.1. Il s’agit de chiffres comparatifs présentés par le fournisseur ; il convient donc de les considérer comme des résultats officiels plutôt que comme un substitut à une validation indépendante. La conclusion la plus prudente est que xAI cible les tâches de codage complexes et le travail intellectuel spécialisé, tandis que les mesures indépendantes montrent une amélioration significative sur certaines tâches et des résultats plus mitigés sur d’autres.
Évaluation pratique du Grok 4.7 : trois exercices pratiques
Nous avons testé trois invites fixes sur le grok-4.7 Identifiant du modèle via une API de test compatible avec OpenAI, le 23 septembre 2026. Il s’agissait d’une évaluation à voie unique, et non de l’API xAI directe ni d’un test comparatif avec un concurrent. La réponse visible de chaque exécution est conservée ci-dessous ; les traces de raisonnement privées sont exclues.
| Tâche | Heure observée | Résultat |
|---|---|---|
| Bug de concurrence dans TypeScript | 333,7 secondes, en streaming | Résultat très satisfaisant : diagnostic correct concernant les « shared promises », correctif minimal, deux tests utiles et une limitation rigoureuse de ce que l'extrait de code pouvait prouver |
| Notes de recherche contradictoires | 68,7 secondes | Réussite : attribution conservée, calcul des deux scénarios d'allocation et refus de validation jusqu'à ce que le conflit de sources soit vérifié |
| Programme hebdomadaire un peu brouillon | 50,6 secondes | Réussite partielle : respect des délais, contradictions, propriétaires inconnus et cinq risques, mais le travail n'a pas été transformé en un calendrier quotidien clair. |
Les chiffres relatifs à la latence ne concernent que cet itinéraire et ces requêtes. La tâche de codage a d'abord rencontré un délai d'expiration au niveau d'une passerelle ne prenant pas en charge le streaming, puis s'est achevée avec le streaming activé. Il s'agit d'un avertissement pratique concernant le déploiement, portant sur le transport et la gestion des délais d'expiration, et non d'un score général de vitesse de 4,7 pour Grok.
Test 1 : débogage de la concurrence en TypeScript
Tâche 1 — Débogage de la concurrence dans un gestionnaire d’API TypeScript

Un petit gestionnaire TypeScript renvoie par intermittence un code d’état HTTP 200 avec un corps vide lorsque deux requêtes arrivent à peu près en même temps.

Fichiers fournis :

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

Le symptôme en production est intermittent et ne se produit que lorsque deux requêtes se chevauchent. Le chargeur lui-même peut être appelé en parallèle en toute sécurité et renvoie une charge utile différente pour chaque requête. Aucun autre fichier n’est disponible.

Indiquez précisément les éléments suivants :
1. Cause première
2. Patch minimal sûr (présentez un diff unifié)
3. Deux tests de régression (code au format TypeScript ou Jest)
4. Hypothèses et limites
Ne prétendez pas avoir exécuté le code.1. Cause première
`current` est un état au niveau du module partagé par chaque appel. Lors d’un cycle JavaScript, la vérification de null et l’affectation sont atomiques ; ainsi, deux appels qui se chevauchent n’exécutent pas tous les deux `load()`. Le premier appel stocke sa promesse ; un deuxième appel qui arrive avant que cette promesse ne soit résolue ignore son propre `load()` et attend la même promesse. `handler` renvoie alors un code HTTP 200 dont le `body` correspond à la chaîne de caractères du premier appel, et non à la charge utile de la deuxième requête. Cette fenêtre n’existe que tant qu’un appel est en cours ; l’échec n’apparaît donc que lorsque les requêtes se chevauchent.
`current = null` s’exécute dans chaque continuation après que `await` a déjà capturé la promesse. Cela n’oblige pas l’autre attendante à relire la variable ; par conséquent, ces fichiers ne suffisent pas à eux seuls à résoudre cette attendante en `null` ou `""`. Ce qu’ils produisent en cas de chevauchement, c’est une résolution partagée et un chargement par requête ignoré. Cette suppression fait également de l’emplacement un mauvais cache à passage unique : la première continuation à reprendre abandonne `current`, et un appelant ultérieur peut lancer un `load()` différent alors qu’un autre appelant est encore en cours de déroulement.
2. Correctif minimal sûr (afficher un diff unifié)
Chaque requête doit appeler `load()` elle-même. Les appels `load()` simultanés sont autorisés, et chacun renvoie une charge utile différente ; la déduplication sur une seule promesse partagée n’est donc pas sûre. Le fichier `handler.ts` ne nécessite aucune modification.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Deux tests de régression (code TypeScript ou de style Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('les requêtes qui se chevauchent chargent et conservent chacune leur propre corps à chaque exécution', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('un chargement chevauchant rejeté ne modifie pas l'autre réponse', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('échec en amont'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('échec en amont');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Hypothèses et limites
Je n’ai pas exécuté ce code ni les tests. Les tests supposent l’utilisation d’un exécuteur de type Jest et la présence d’un fichier dans un répertoire au même niveau que `src/` (par exemple `test/cache.test.ts`).
J’ai considéré que le fait d’avoir “ une charge utile différente pour chaque requête ” impliquait que les appels `getPayload` qui se chevauchent ne devaient pas partager un même résultat de `load()`. Une réécriture correcte en « single-flight » (`load().finally(() => { current = null; }); return current`) couplerait tout de même ces requêtes, je ne l’ai donc pas utilisée. Aucune clé de cache n’est présente, et aucune exigence de déduplication n’est stipulée.
Les instructions présentées n’écrivent pas de corps HTTP littéralement vide si `load` renvoie une chaîne non vide. Si ce symptôme provient d’un adaptateur extérieur à ces fichiers, il n’est pas visible ici. Le correctif supprime uniquement le couplage par chevauchement que ces fichiers implémentent effectivement. Il n’ajoute ni verrouillage, ni tentatives de réessai, ni cache à clé.Grok 4.7 a correctement constaté que, au niveau du module, actuel La promesse entraîne le partage d'un même résultat de chargement entre plusieurs requêtes qui se chevauchent, alors que chaque requête a besoin de sa propre charge utile. La proposition consistait à apporter la modification la plus minimale possible sans compromettre la sécurité : supprimer la promesse partagée et appeler load() sur demande. Les deux tests de régression portaient sur des charges utiles concurrentes distinctes et sur l’isolation en cas de rejet par l’un des chargeurs. Le point fort de cette réponse résidait dans sa modération : elle indiquait explicitement que le code présenté démontrait un couplage entre requêtes, mais n’expliquait pas à lui seul la présence d’un corps littéralement vide si le chargeur renvoyait toujours une chaîne non vide.
Verdict : Résultat très satisfaisant en matière de précision de l'analyse des causes profondes, de portée des correctifs, de couverture des tests de régression et de gestion des incertitudes.
Test n° 2 : Note de recherche sur des sources contradictoires
Tâche 2 — Harmonisez les notes de recherche contradictoires pour en faire une note de décision.

Utilisez uniquement ces six notes et indiquez le nom de la source à côté de chaque affirmation factuelle :

- Fournisseur A, page des tarifs, 20/09/2026 : Le forfait « Team » coûte $40 par poste et par mois et comprend 100 000 actions incluses.
- Fournisseur B, article comparatif, 21/09/2026 : Le forfait « Team » du fournisseur A comprend 120 000 actions par poste et par mois.
- Entretien avec un client, 18/09/2026 : Notre équipe compte 8 postes et a utilisé 710 000 actions le mois dernier.
- Feuille de calcul financière, 19/09/2026 : Le plafond budgétaire actuel est de $360 par mois.
- Fournisseur A, page des limites, 20/09/2026 : Tout dépassement est facturé à $0,004 par action au-delà du quota inclus.
- Note des achats, 22/09/2026 : un changement de fournisseur n’est acceptable que si le total mensuel reste dans les limites du budget et si le forfait est vérifié.

Restituez exactement ces sections :
1. Faits vérifiés
2. Allégations attribuées
3. Tableau des divergences
4. Calculs indépendants (calculez les scénarios 8 x 100 000 et 8 x 120 000, ainsi que tout dépassement)
5. Recommandation
6. Une seule question de clarification si le conflit modifie la recommandation
Ne résolvez pas le conflit entre 100 000 et 120 000 en silence.
1. Faits vérifiés
- Le forfait “ Team ” coûte $40 par poste et par mois (Fournisseur A, page des tarifs, 20 septembre 2026).
- L'équipe compte 8 postes et a utilisé 710 000 actions le mois dernier (entretien avec le client, 18/09/2026).
- Le plafond budgétaire actuel est de $360 par mois (feuille de calcul du service financier, 19/09/2026).
- Tout dépassement est facturé à $0,004 par action au-delà du forfait inclus (fournisseur A, page des limites, 20/09/2026).
- Un changement de fournisseur n’est acceptable que si le total mensuel reste dans les limites du budget et si le quota est vérifié (note des achats, 22/09/2026).

2. Réclamations attribuées
- L’équipe inclut 100 000 actions incluses (Fournisseur A, page des tarifs, 20/09/2026). Cette note ne précise pas explicitement “ par poste ”.
- L’équipe du fournisseur A inclut 120 000 actions par poste par mois (fournisseur B, article comparatif, 21/09/2026).

3. Tableau des divergences
| Élément | Allégation | Source | Statut |
| --- | --- | --- | --- |
| Actions incluses | 100 000 actions incluses ; la mention « par poste » n’est pas précisée | Fournisseur A, page des tarifs, 20/09/2026 | Non résolue |
| Actions incluses | 120 000 actions par poste et par mois | Fournisseur B, article comparatif, 21/09/2026 | Non résolu |

Le conflit entre les chiffres de 100 000 et 120 000 n’est pas résolu. Ces notes ne précisent pas quel chiffre est correct.

4. Calculs indépendants
Coût de base par poste, identique dans les deux scénarios : 8 postes (entretien avec le client, 18/09/2026) × $40 par poste et par mois (Fournisseur A, page des tarifs, 20/09/2026) = $320 par mois.

Les deux multiplicateurs ci-dessous sont calculés conformément à la demande. Ils ne constituent pas une conclusion selon laquelle le fournisseur A aurait indiqué une allocation par siège.

- 8 × 100 000 = 800 000 actions incluses, en utilisant le chiffre de 100 000 (fournisseur A, page des tarifs, 20 septembre 2026).
- L’utilisation de 710 000 (entretien avec le client, 18/09/2026) est inférieure de 90 000 à 800 000 ; le nombre d’actions en dépassement est donc égal à 0.
- Frais de dépassement = 0 × $0,004 = $0 (Fournisseur A, page des limites, 20/09/2026).
- Total mensuel = $320 + $0 = $320, ce qui reste dans la limite maximale de $360 (feuille de calcul du service financier, 19/09/2026).

- 8 × 120 000 = 960 000 actions incluses, en utilisant le chiffre de 120 000 (fournisseur B, publication comparative, 21/09/2026).
- L'utilisation de 710 000 (entretien avec le client, 18/09/2026) est inférieure de 250 000 à 960 000 ; le nombre d'actions en dépassement est donc égal à 0.
- Frais de dépassement = 0 × $0,004 = $0 (Fournisseur A, page des limites, 20/09/2026).
- Total mensuel = $320 + $0 = $320, ce qui reste dans la limite maximale de $360 (feuille de calcul du service financier, 19/09/2026).

5. Recommandation
Ne pas encore approuver le changement. Selon les deux plafonds calculés, les 710 000 actions du mois dernier (Entretien client, 18/09/2026) n’entraînent aucun dépassement et donnent un total mensuel de $320, qui reste dans les limites du plafond de $360 (tableur des finances, 19/09/2026). Ce résultat en termes de coût ne dépend pas du choix entre 100 000 et 120 000. Le changement ne remplit toujours pas la deuxième condition : le quota doit être vérifié (note des achats, 22/09/2026), et ces notes indiquent 100 000 (fournisseur A, page des tarifs, 20/09/2026) en conflit avec 120 000 (fournisseur B, publication comparative, 21/09/2026).

6. Une seule question de clarification si le conflit modifie la recommandation
Aucune question de clarification. Le conflit entre 100 000 et 120 000 ne modifie pas la recommandation.
Le dossier de recherche présentait délibérément des informations contradictoires quant à savoir si le quota était de 100 000 ou de 120 000 actions par siège. Le document Grok 4.7 a distingué les deux sources, a relevé que la première ne mentionnait pas explicitement “ par poste ”, a calculé les deux scénarios à huit postes et a montré que les deux restaient dans les limites de $320, sans dépassement pour l’utilisation prévue. Il recommandait néanmoins de suspendre l’approbation, car le service des achats exigeait que le quota soit vérifié. C’est là la distinction pertinente entre une recommandation numériquement stable et un fait contractuel non résolu.
Verdict : Très bonne note en matière d'attribution, d'arithmétique, de gestion des conflits et de rigueur décisionnelle.
Test 3 : Notes désordonnées dans le plan d'exécution
Tâche n° 3 — Transformer ces notes de projet désordonnées en un plan d’exécution d’une semaine ne dépassant pas 700 mots.

Remarques :
- Lancement de la page d’accueil vendredi à 17 h ; le chef de produit indique “ jeudi matin ” dans une note ultérieure.
- Mina : rédiger le titre et le tableau des tarifs. Mina précise également qu'elle ne pourra relire le texte que mercredi après-midi.
- Arjun : événements analytiques ; une note en double indique que le responsable de l'analyse reste à déterminer.
- L'équipe de conception a deux tâches en double : “ recadrage de l'image principale pour mobile ” et « recadrage final de l'image principale pour mobile ».
- La validation juridique doit avoir lieu avant tout lancement public.
- L’assurance qualité a besoin d’une journée complète une fois que les événements analytiques seront disponibles.
- Omar sera absent mardi après-midi.
- L’e-mail d’annonce du lancement est prévu pour vendredi à 16 h.
- Inconnu : qui est responsable de la décision finale de lancement ou d’abandon ?

Exigences : regrouper les tâches en double, indiquer « à déterminer » pour les responsables inconnus, conserver les deux échéances strictes, signaler les contradictions au lieu de les résoudre en silence, et conclure par une liste de cinq risques.

Restituez exactement ces sections :
1. Plan sur une semaine
2. Contradictions et inconnues
3. Cinq risques
N’inventez pas de responsables ni de dates.
1. Plan hebdomadaire

Les notes ne comportant aucune date, aucune n’est ajoutée. Seuls les repères et les dépendances indiqués sont pris en compte. Le travail de conception en double constitue une seule tâche. Les responsables inconnus restent “ à déterminer ”. Les dates de lancement conflictuelles sont toutes deux conservées.

- Rédaction : Mina rédige le titre et le tableau des tarifs. La relecture de son texte n’est prévue que mercredi après-midi.
- Conception : une seule tâche, le recadrage de l’image principale pour mobile, y compris la “ dernière ” révision. Aucun responsable n’est désigné.
- Événements analytiques : doivent être en place avant l’assurance qualité. Le responsable n’est pas défini (Arjun dans une note ; « À déterminer » dans une autre).
- Assurance qualité : une journée complète, uniquement une fois les événements analytiques disponibles. Responsable : à déterminer. Aucune date n’est attribuée ici pour l’assurance qualité.
- Révision juridique : obligatoire avant tout lancement public. Responsable : à déterminer. Non programmée dans les notes.
- Feu vert/feu rouge : responsable : à déterminer. N’est pas considéré comme décidé.
- Les dates clés du lancement public sont toutes deux maintenues : jeudi matin (responsable produit) et vendredi à 17 h (page d’accueil).
- E-mail de lancement : vendredi à 16 h. Responsable à déterminer.
- Omar est absent mardi après-midi. Aucune tâche de ces notes n’étant attribuée à Omar, aucune n’est déplacée.

Ordre des opérations, sans nouvelles dates : le brouillon de Mina doit être prêt pour la révision de mercredi après-midi ; l’équipe de conception termine le recadrage de l’image principale ; les événements analytiques sont fournis par le responsable non désigné ; l’assurance qualité dispose ensuite d’une journée complète ; la révision juridique s’achève avant tout lancement public ; la décision « feu vert/feu rouge » (à déterminer) n’a toujours pas de responsable. Ne pas supprimer : jeudi matin, vendredi 17 h ou vendredi 16 h.

2. Contradictions et inconnues

Contradictions (non résolues) :
- Le lancement de la page d’accueil est prévu vendredi à 17 h, alors qu’une note ultérieure du responsable produit indique jeudi matin.
- Le responsable de l’analyse est Arjun dans une note, et « à déterminer » dans une note en double.

Inconnues, marquées « à déterminer » :
- Responsable final de la décision de lancement ou non.
- Responsable définitif de l’analyse.
- Responsable de la revue juridique.
- Responsable de l’assurance qualité.
- Responsable de l’e-mail de lancement.
- Responsable de la conception désigné au-delà de la mention « Conception ».
- Le rôle d’Omar ; seule son absence du mardi après-midi est mentionnée.
- Quelle heure de lancement fait autorité, et si l'e-mail de vendredi 16 h correspond à l'une ou l'autre de ces heures. Aucune date au-delà de ces horaires en semaine n'est indiquée.

3. Cinq risques

1. Le lancement de la page d'accueil ne peut pas avoir lieu à la fois jeudi matin et vendredi 17 h ; choisir l'une de ces deux options sans décision préalable peut entraîner un lancement prématuré ou le non-respect de l'autre échéance.
2. L’e-mail de lancement est fixé à vendredi 16 h, avant vendredi 17 h, et n’est pas aligné dans les notes avec jeudi matin ; il risque donc d’être envoyé alors que la page n’est pas encore ou n’est plus dans l’état prévu.
3. La responsabilité des analyses est contestée, ce qui peut entraîner des retards ; le contrôle qualité nécessite encore une journée complète après les événements et pourrait ne pas pouvoir s’insérer avant l’une ou l’autre des dates butoirs de lancement.
4. L’examen juridique doit précéder tout lancement public, mais aucun responsable ni créneau n’est défini ; le lancement pourrait donc être bloqué ou avoir lieu sans cet examen.
5. Aucun responsable chargé de la décision « feu vert/feu rouge » n’est désigné ; aucune des deux dates butoirs strictes ne dispose donc d’une personne désignée pour approuver ou bloquer le lancement.
La version Grok 4.7 a fusionné la tâche « mobile-hero » en double, a conservé le conflit de lancement du jeudi matin et du vendredi à 17 h, a maintenu la date limite d’envoi des e-mails du vendredi à 16 h, a indiqué « à déterminer » pour les responsables non attribués et a abouti à exactement cinq risques. Elle n’a pas inventé de dates ni de responsables. Le point faible résidait dans la faisabilité : au lieu de répartir le travail sur une séquence du lundi au vendredi, il a renvoyé une liste ordonnée de dépendances et a indiqué qu’aucune journée de contrôle qualité ne pouvait être attribuée. Cette prudence est justifiable, mais la consigne demandait un plan d’exécution sur une semaine ; la réponse ne respectait donc que partiellement le format demandé.
Verdict : Résultat partiel : excellente préservation des contraintes, utilité moindre en matière de planification.
Quels sont les changements apportés par la version Grok 4.7 dans les flux de travail réels ?
La meilleure façon d'aborder cette mise en service est de la considérer comme une question relative au flux de travail : dans quels cas un raisonnement approfondi réduit-il le travail de révision, et dans quels cas aboutit-il simplement à une réponse plus longue ? Les trois tâches liées à l’API suggèrent un schéma pratique. Grok 4.7 n’a aucun mal à garder plusieurs contraintes visibles à la fois, en particulier lorsque la consigne lui demande de distinguer les faits des hypothèses. Il est moins convaincant lorsque la tâche nécessite un calendrier concret ou une séquence d’exécution que les notes sources ne précisent pas entièrement.
Codage et débogage
Pour les travaux liés au référentiel, ce modèle est plus adapté à un diagnostic ciblé qu’à une demande ouverte du type “ créer une application ”. Fournissez-lui le plus petit ensemble de fichiers utile, décrivez le symptôme de la défaillance et exigez une cause première avant tout correctif. Demandez des tests qui échoueraient avant la modification et réussiraient après celle-ci. Dans notre test de gestionnaire, la réponse est restée proche du code fourni et n’a pas cherché à inventer une cause externe pour le symptôme du corps vide.
Ce comportement est important car la qualité du codage ne se résume pas à la simple génération de code. Une réponse de codage utile doit préserver la conception locale, limiter les différences (diff), identifier les hypothèses et faciliter la vérification. La tâche Grok 4.7 a rempli ces critères dans le cadre d’une seule petite tâche, mais une tâche isolée ne suffit pas à garantir la fiabilité à l’échelle du dépôt. Les équipes doivent appliquer la même grille d’évaluation à un bug réel, à une refactorisation, à une modification impliquant plusieurs fichiers et à un chemin sensible en matière de sécurité avant de passer à la production.
Recherche et synthèse des sources
Ce travail de recherche a mis en évidence un autre point fort : la rigueur en matière de délimitation des sources. Grok 4.7 n’a pas fusionné sans autre forme de procès l’affirmation du fournisseur, qui faisait état de 100 000 actions, avec le chiffre de 120 000 mentionné dans l’article de comparaison. Il a également su distinguer un calcul stable dans les deux scénarios d’une condition d’approvisionnement qui nécessite encore une vérification.
C'est la méthode idéale pour les travaux nécessitant beaucoup de recherche. Demandez au modèle d'étiqueter séparément les faits vérifiés, les affirmations attribuées, les conflits non résolus, les calculs et les recommandations. Une note bien rédigée peut tout de même être erronée si elle fait passer une affirmation secondaire pour un fait non cité. La réponse de Grok 4.7 était utile car elle a permis de maintenir le conflit visible, même si le résultat arithmétique n’a pas changé.
Planification et opérations
C'est au stade de la planification que les limites sont apparues plus clairement. Le modèle a conservé toutes les échéances et tous les responsables inconnus, mais il n'est pas allé jusqu'à établir un calendrier du lundi au vendredi. C'est plus prudent que d'inventer des dates, mais cela signifie que l'utilisateur doit tout de même convertir les dépendances en affectations calendaires.
Pour les instructions opérationnelles, précisez l’horizon de planification, les jours ouvrables disponibles, la disponibilité du propriétaire et le décideur. Si ces champs sont manquants, demandez d’abord une carte des dépendances, puis un calendrier. Ce processus en deux étapes permet de tirer parti de la prudence du modèle, au lieu de la considérer comme un manque de prise de décision.
Récupération de contextes longs
Une fenêtre de contexte de 500 000 modifie ce qui peut tenir dans une seule requête, mais pas ce qui peut être considéré comme fiable sans vérification. Le travail sur des contextes longs doit recourir à des « sondes de récupération » : placez les faits déterminants au début, au milieu et à la fin d’un paquet ; ajoutez un conflit délibéré ; puis demandez une décision en précisant les emplacements des sources. Évaluez à la fois le rappel et le respect des limites.
Ne jugez pas un parcours à contexte long uniquement sur sa capacité à accepter une requête volumineuse. Notez les informations manquantes dans le modèle, vérifiez s'il accorde une importance excessive à la section finale, observez l'augmentation de la latence en fonction de la taille des données d'entrée et déterminez si le fournisseur tronque ou transforme la requête. Une fenêtre annoncée comme étant grande constitue une déclaration de capacité, et non une garantie de raisonnement stable à la limite.
Comment évaluer soi-même le modèle Grok 4.7
Utilisez un petit ensemble de tests reproductibles avant de modifier un paramètre par défaut en production. L'objectif n'est pas de recréer un classement, mais de comparer le modèle avec le processus de validation et de révision pour lequel vous payez déjà.
- Figez les données d'entrée. Enregistrez exactement la consigne, les fichiers, le paquet source, l'identifiant du modèle, la température, les paramètres de raisonnement et les autorisations d'accès aux outils. Ne comparez pas un itinéraire direct à un itinéraire proposé par un fournisseur tout en modifiant simultanément la consigne.
- Évaluez l'œuvre, pas le style. Pour le codage, évaluez la précision de l'identification des causes profondes, la portée du correctif, les tests et les hypothèses. Pour la recherche, évaluez les limites des citations, les calculs, les conflits et la qualité des recommandations. Pour la planification, évaluez le respect des délais, la responsabilité, les dépendances et la faisabilité.
- Enregistrez les transports séparément. Consignez dans un journal de route le délai avant l'obtention du premier jeton, la durée totale, le mode « stream » ou « non-stream », le statut HTTP et le comportement en cas de nouvelle tentative. Un délai d'expiration de la passerelle ne constitue pas automatiquement un défaut de qualité du modèle, mais il représente néanmoins un coût de production.
- Vérifier le comportement en cas de défaillance. Incluez une entrée ambiguë, une source contradictoire et un ensemble de fichiers délibérément incomplet. La question pertinente est de savoir si le modèle signale l'incertitude ou s'il comble cette lacune par une estimation sûre.
- Examinez ensemble les coûts et les efforts nécessaires. Suivre les jetons d'entrée, les jetons de sortie, les données d'entrée mises en cache, les jetons de raisonnement lorsqu'ils sont exposés, ainsi que la durée des révisions humaines. Une réponse moins coûteuse mais dont la vérification prend deux fois plus de temps peut ne pas s'avérer plus économique dans la pratique.
- Répétez l'opération avant de changer de canal. Effectuez chaque tâche au moins deux fois ou sur plusieurs exemples représentatifs avant de modifier un paramètre par défaut de l'équipe. Conservez la réponse brute visible et les notes d'évaluation afin qu'un autre évaluateur puisse reproduire la décision.
Les trois exécutions présentées dans cette analyse constituent un échantillon préliminaire et ne remplacent en aucun cas l’ensemble des tests d’évaluation d’une équipe. Elles montrent comment Grok 4.7 se comporte sur une tâche de codage, une note relative à un conflit de sources et un dossier de planification ; elles n’établissent pas de classement universel.
Tarification et accès à l'API pour Grok 4.7
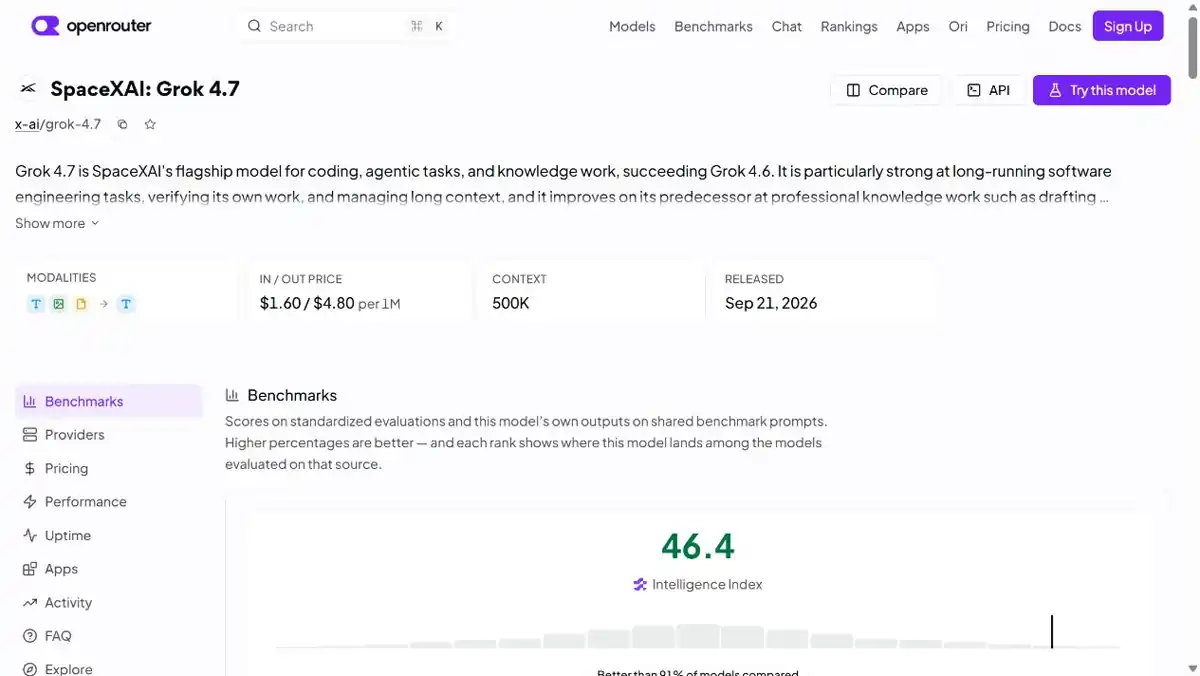
C'est souvent au niveau des tarifs que les analyses de modèles deviennent trompeuses. Le lecteur peut en effet se retrouver face à au moins trois montants différents : le prix direct de l'API xAI, le prix de l'itinéraire proposé par un agrégateur et le prix de l'abonnement pour le consommateur. Ces montants ne sont pas interchangeables.
Selon l'annonce de xAI, le modèle Grok 4.7 est proposé au même prix et avec la même vitesse que le Grok 4.6. La page de lancement indique que le modèle standard est disponible à partir de $2 par million de jetons d'entrée et $6 par million de jetons émis; « Artificial Analysis » présente séparément les mêmes chiffres relatifs à la route directe et $0,50 par million de jetons d'entrée mis en cache. xAI précise également qu’une variante « rapide » double la vitesse de production, pour un prix deux fois plus élevé. Utilisez le documentation officielle destinée aux développeurs pour vérifier les conditions du contrat API en vigueur et la disponibilité spécifique au compte avant d'envoyer du trafic de production.
Page 4.7 du Grok d'OpenRouter présente $1,60 par million de jetons d'entrée et 1 TP41T4,80 par million de jetons émis pour son itinéraire. Il s'agit d'un tarif OpenRouter/fournisseur, et non d'une correction du prix catalogue direct de xAI. Le routage, la marge, la mise en cache, les limites et la disponibilité peuvent varier selon le fournisseur.
Il n'existe pas de réponse unique et fiable à la question “ Combien coûte le Grok 4.7 ? ” sans préciser l'itinéraire. Pour un acheteur d'API, comparez :
- taux de jetons d'entrée et de sortie ;
- traitement « cached-input » ;
- contexte et limites de sortie ;
- limites tarifaires et disponibilité régionale ;
- si le fournisseur met à disposition des commandes de raisonnement ;
- conditions relatives à la collecte, à la conservation et au traitement des données.
En ce qui concerne l'accès des consommateurs, ne partez pas du principe que le prix indiqué par l'API correspond au prix d'un abonnement X ou Grok. Le forfait grand public, la voie d'accès via l'API et l'agrégateur tiers peuvent être soumis à des règles d'accès différentes.
Quelle route API choisir ?
| Itinéraire | Meilleur pour | Ce qu'il faut vérifier avant utilisation | Principal compromis |
|---|---|---|---|
| API Direct xAI | Systèmes de production nécessitant un contrat propre au fournisseur | Référence officielle du modèle, limites de débit, conditions d'utilisation des données, zones de couverture, streaming et prix actuel | Une provenance irréprochable, mais c'est vous qui gérez directement la facturation et la disponibilité |
| OpenRouter | Comparaison rapide des fournisseurs et simulation d'itinéraires | Fournisseur en amont réel, prix de la route, mise en cache, confidentialité, contexte et comportement de repli | Le changement est plus facile, mais l'itinéraire n'est pas le même que celui du service xAI direct |
| API de test compatible avec OpenAI | Évaluation interne ou client existant qui utilise déjà le schéma OpenAI | Mappage des modèles, délais d'expiration, prise en charge du streaming, champs d'utilisation, durée de conservation et sémantique des erreurs | Une intégration pratique, mais la compatibilité ne garantit pas un comportement identique de la part des fournisseurs |
L'itinéraire compatible utilisé pour la partie pratique a renvoyé grok-4.7 et prenait en charge la diffusion en continu. Sa requête de codage hors flux a dépassé la fenêtre d'attente de la passerelle avant que la nouvelle tentative de diffusion en continu ne soit terminée. Cette observation est utile lors de la conception d'un client, mais elle ne doit pas être reprise pour étayer une affirmation concernant la latence de DirectX AI.
Comment accéder à Grok 4.7
La méthode la plus simple consiste à commencer par le Annonce concernant xAI et Page des développeurs xAI, puis vérifiez si vous avez besoin de Grok Build, de Cursor, de l'API directe ou d'un agrégateur. xAI indique que la version Grok 4.7 est disponible dans Cursor et Grok Build, via l’API Grok, ainsi que via des harnais de codage tiers, des routeurs de modèles et des plateformes cloud. Cette distinction détermine la facturation, les contrôles des modèles, les conditions de confidentialité et les outils disponibles.
Si vous utilisez un agrégateur, ouvrez la page du modèle correspondant et vérifiez l'itinéraire du fournisseur, les tarifs des jetons, la limite de contexte et l'identifiant du modèle avant de développer une application en vous appuyant sur celui-ci. OpenRouter est un itinéraire documenté, mais ses tarifs ne doivent pas être repris dans un tableau de facturation xAI.
Pour les lecteurs qui souhaitent comparer plusieurs familles de modèles dans un même espace de travail, L'espace de travail multimodèle de GlobalGPT peut s'avérer utile pour une évaluation comparative des invites. Cet article présente pas affirment qu'un itinéraire Grok 4.7 y est déjà disponible. La disponibilité de l'itinéraire figurant dans le catalogue, qui a été vérifiée, est une question distincte et doit être vérifiée dans l'interface utilisateur du produit avant l'achat.
Grok 4,7 par rapport à ChatGPT, Claude et Gemini
Cette analyse inclut les résultats de trois tâches “ Grok 4.7 ”, mais ne comporte aucune comparaison avec les modèles ChatGPT, Claude ou Gemini. Une conclusion générale du type « le Grok 4.7 l’emporte » relèverait toujours du marketing, et non d’une analyse. Un meilleur choix dépend des travaux menés autour du modèle :
| Si votre priorité est... | Commencez par évaluer… | Pourquoi |
|---|---|---|
| Longs paquets techniques | Grok 4.7 et autres routes à large contexte | Vérifiez la précision des résultats, et pas seulement la fenêtre annoncée |
| Débogage du référentiel | Grok 4.7, un modèle axé sur le codage, et votre boucle de test habituelle | Comparer la qualité de l'analyse des causes profondes et le temps consacré à l'examen |
| Recherche axée sur les sources | Un processus axé sur la recherche associé à un modèle de raisonnement général | Vérifiez les références avant d'accepter les conclusions |
| Intégrations existantes en matière de productivité | Le modèle déjà intégré à vos outils | Les coûts de changement peuvent l'emporter sur le gain par rapport à l'indice de référence |
| Facture API la plus basse | Itinéraires directs et via des agrégateurs, côte à côte | Les prix varient selon le fournisseur et le comportement du cache |
Le “Guide ” Quelle IA vaut-elle la peine d'être achetée ? » pose la bonne question avant d'acheter : quelle tâche récurrente offre un gain suffisant pour rentabiliser l'abonnement ou la facture de l'API ? C'est une règle de décision plus durable que de courir après la dernière nouveauté du classement.
Limites et questions en suspens
La norme Grok 4.7 est trop récente pour faire l'objet d'un large consensus indépendant. Les données disponibles laissent plusieurs questions en suspens :
- Dans quelle mesure cette amélioration est-elle constante dans les domaines du codage, de la recherche, de la rédaction et des tâches multimodales ?
- Le contexte de 500K reste-t-il fiable à proximité de la limite, ou la récupération se dégrade-t-elle plus tôt ?
- Quelle latence supplémentaire entraîne l'effort de raisonnement le plus intense ?
- Quels sont les forfaits grand public, les régions, les outils et les limites de débit qui exposent le modèle ?
- Comment ces nouvelles mesures de protection s'appliquent-elles aux travaux techniques légitimes mais sensibles ?
- Est-ce que direct xAI, OpenRouter et d'autres fournisseurs fournissent des résultats ou des limites sensiblement différents ?
Ces questions ne constituent pas des raisons de rejeter le modèle. Elles justifient au contraire la réalisation d'une évaluation à petite échelle et représentative avant de migrer un processus ou de promettre des économies.
À qui s'adresse le modèle Grok 4.7 ?
Il vaut la peine de tester d'abord la version Grok 4.7 si :
- déboguer du code ou analyser des documents techniques pendant de longues périodes ;
- travailler avec des paquets source dont la taille dépasse celle des fenêtres de discussion habituelles ;
- apprécier un modèle qui est prêt à consacrer davantage d'efforts à une consigne difficile ;
- peut vérifier les résultats avant de les envoyer directement en production ;
- comparent les aspects économiques des API directes et des agrégateurs.
Cette solution est moins adaptée si vous avez besoin d'une intégration aboutie, d'un plan d'utilisation clairement documenté ou d'un avantage avéré pour une tâche donnée par rapport au modèle déjà présent dans votre pile technologique. Dans ces cas-là, la couche d'accès et de workflow peut s'avérer plus importante qu'un gain de deux points sur l'indice.
FAQ
Qu'est-ce que le Grok 4.7 ?
Grok 4.7 est la nouvelle version du modèle d’xAI, lancée le 21 septembre 2026, destinée au codage et aux tâches intellectuelles. xAI indique qu’elle consacre davantage de temps aux tâches complexes, vérifie son travail avec plus de minutie et intègre un nouvel ensemble de mesures de sécurité, tout en conservant le même prix et la même vitesse que la version Grok 4.6.
Quand la version Grok 4.7 est-elle sortie ?
xAI a annoncé la version Grok 4.7 le 21 septembre 2026. La page officielle de lancement et la documentation destinée aux développeurs constituent les meilleures sources d'informations concernant l'état d'avancement de la version, la disponibilité des modèles et les modifications apportées à l'API.
Le modèle Grok 4.7 est-il meilleur que le modèle Grok 4.6 ?
Artificial Analysis fait état d'un indice d'intelligence de 46, soit deux points de plus que le Grok 4.6, et d'un Elo AA-Briefcase de 1 657, soit 111 points de plus que le 4.6. Il s'agit là d'indicateurs utiles, mais pas d'un résultat universel applicable à tous les flux de travail.
Qu'est-ce que la fenêtre contextuelle de Grok 4.7 ?
Artificial Analysis indique une fenêtre de contexte de 500 000 tokens pour la version Grok 4.7. Une fenêtre de grande taille ne garantit pas une récupération parfaite ; il est donc recommandé de tester le modèle avec des faits placés à différents endroits d'un long document avant de s'en servir pour des tâches nécessitant un volume important de sources.
Combien coûte l'API Grok 4.7 ?
Selon Artificial Analysis, le débit direct via l'API est de $2 par million de tokens d'entrée et de $6 par million de tokens de sortie, tandis que le débit avec mise en cache des données d'entrée est de $0,50 par million de tokens. Veuillez consulter la documentation xAI en ligne avant toute utilisation en production.
Le prix du modèle Grok 4.7 d'OpenRouter est-il identique à celui de xAI ?
Non. OpenRouter indique un coût de $1,60 par million de jetons d’entrée et de $4,80 par million de jetons de sortie pour son itinéraire. Il s'agit d'un tarif propre au fournisseur qui doit être comparé séparément des tarifs de l'API directe de xAI. OpenRouter affiche également des champs spécifiques au fournisseur concernant le cache, la latence, le débit et la confidentialité, qui peuvent modifier le coût réel d'une route.
Comment puis-je accéder à la version 4.7 de Grok ?
Commencez par consulter l’annonce officielle d’xAI et la documentation destinée aux développeurs, puis choisissez le produit grand public Grok, l’API xAI directe ou un agrégateur tel qu’OpenRouter. Vérifiez l’identifiant du modèle, la région, les limites de débit, le contexte et la facturation pour l’itinéraire que vous comptez réellement utiliser.
La version Grok 4.7 est-elle disponible sur GlobalGPT ?
Cet avis ne prétend pas confirmer l'existence d'un itinéraire Grok 4.7 sur la ligne GlobalGPT. La ligne GlobalGPT peut servir à comparer les gammes de modèles disponibles, mais il convient de vérifier le catalogue actuel et la disponibilité exacte des modèles dans l'interface utilisateur du produit avant tout achat.
Le modèle Grok 4.7 est-il adapté à la codification des agents ?
Cet exercice est utile pour évaluer le débogage restreint, la révision de code et le raisonnement sur plusieurs fichiers, où l'agent doit expliquer ses hypothèses et générer des tests. L'exercice pratique de programmation était de bonne qualité, mais il ne permettait pas d'évaluer l'exécution des outils, la modification du référentiel, les autorisations ni le cycle complet d'un agent.
Pourquoi le test de programmation nécessitait-il un streaming ?
La première requête sans streaming a dépassé la fenêtre d'attente de la passerelle de la route de test. La même requête s'est déroulée sans problème lorsque le streaming était activé. Cela montre pourquoi les clients en production doivent prendre en charge le streaming et les délais d'expiration explicites ; cela ne prouve toutefois pas que toutes les routes Grok 4.7 présentent le même comportement en termes de latence.
Comment dois-je tester la fenêtre de contexte de 500 000 ?
Utilisez un ensemble de données fixe comportant des faits déterminants placés au début, au milieu et à la fin, ainsi qu’un conflit intentionnel. Demandez les emplacements des sources et évaluez la capacité de mémorisation, la gestion des conflits et la latence pour plusieurs tailles d’entrée, plutôt que de vous fier uniquement au maximum annoncé.
Vaut-il la peine de passer de la version Grok 4.6 à la version Grok 4.7 ?
Les premiers résultats indiquent une amélioration significative mais progressive : les mesures indépendantes s'améliorent, et la session pratique s'est avérée très concluante en matière de débogage et de synthèse de code source. Ne procédez à la mise à niveau qu'une fois que vos propres tâches auront montré une réduction de l'effort de révision ou une meilleure précision, pour un coût spécifique au tracé que vous pouvez justifier.
Verdict final
La version Grok 4.7 semble constituer une mise à jour importante et progressive du modèle, avec un objectif clair : le codage et le travail intellectuel qui récompensent un effort soutenu. Le communiqué officiel fournit une explication crédible de ce changement, les premiers chiffres d’Artificial Analysis montrent une amélioration par rapport à la version Grok 4.6 plutôt qu’une régression, et nos tests sur l’API apportent un signal pratique, bien que modeste. Le modèle a particulièrement bien géré un bug de concurrence et un mémo provenant de sources conflictuelles ; sa réponse en matière de planification était prudente, mais pas aussi opérationnelle que demandé.
Le verdict définitif reste pour l'instant provisoire. Il s'agissait de trois passages sur un seul parcours de test ; la tâche la plus lente a nécessité un streaming après un délai d'expiration de la passerelle sans streaming, et il n'existe ni résultat comparable chez un concurrent ni consensus indépendant général. Commencez par une tâche complexe issue de votre flux de travail réel, comparez les résultats et le temps d’analyse à ceux du modèle que vous utilisez déjà, puis déterminez si la mise à niveau justifie le coût spécifique à ce parcours.









