Muse Spark 1.2 combina un precio por token excepcionalmente bajo con una ventana de contexto de 1 millón de tokens, y superó las tres tareas de codificación del modelo base en nuestro conjunto de pruebas de API de primer intento. Meta lanzó el modelo el 5 de agosto de 2026, con una ventana de contexto de 1 millón de tokens, dos niveles de precios de la API y un agente de terminal independiente llamado Muse Code. Los resultados de las pruebas de rendimiento de Meta son prometedores; las clasificaciones públicas independientes de programación aún no han verificado las mismas combinaciones de modelo y agente.
Esta revisión distingue entre el modelo y el agente, entre las puntuaciones oficiales y las pruebas independientes, y entre los precios estándar y la relación entre uso de datos y nivel de colaborador. En nuestras pruebas, el modelo completó una corrección de idempotencia en Python, una refactorización de TypeScript que preservaba la compatibilidad y una función JSONL en todo el repositorio sin necesidad de reintentos. No se probó la ejecución del agente de Muse Code ni la fiabilidad de las llamadas a las herramientas. Si primero quieres comparar el panorama general, nuestra guía sobre el mejores modelos de IA para codificación ofrece una visión más amplia del contexto competitivo.
Reseña de Muse Spark 1.2: Respuesta rápida
En resumen: Muse Spark 1.2 es un modelo de Meta centrado en la programación que cuenta con una ventana de 1 millón de tokens, acceso a una API compatible con el SDK OpenAI y un nivel «Contributor» que llama la atención. Su principal ventaja pública es la relación calidad-precio: $0,10 de entrada y $0,20 de salida por cada millón de tokens en el modelo «Contributor». Este nivel puede utilizarse para mejorar los productos de Meta, mientras que el modelo estándar, más caro, no se utiliza para ese fin.
Los datos de rendimiento deben interpretarse con mayor cautela. Meta informa de un resultado de 82,91 TP40T en Terminal-Bench 2.1 para Muse Spark 1.2 con Muse Code y de 59,31 TP40T en DeepSWE. Se trata de resultados obtenidos por Meta. Las tablas públicas de Terminal-Bench y DeepSWE aún no incluían Muse Spark 1.2 cuando se consultaron el 26 de agosto de 2026. Análisis artificial ofrece una verificación independiente: su Índice de Inteligencia se mantiene en 57, por encima de la mediana de los modelos comparables, que es de 35.
- La mejor razón para probarlo ahora: Precios reducidos para colaboradores, un contexto amplio y una API que sigue el conocido patrón de cliente OpenAI.
- La mejor razón para mantener la cautela: Las tres tareas controladas del modelo básico no permiten determinar la fiabilidad del agente Muse Code, la calidad de las llamadas a las herramientas ni el rendimiento en un repositorio de producción de gran tamaño.
- Opción importante relativa a la privacidad: Utiliza el modelo estándar para el código o las indicaciones que no desees que se utilicen para mejorar los productos de Meta.
Muse Spark 1.2 de un vistazo
Especificaciones verificadas
Meta describe Muse Spark 1.2 como un modelo con una mayor precisión en la programación desde el primer intento y una selección de herramientas más fiable que Muse Spark 1.1. Se trata de afirmaciones del proveedor procedentes del página oficial del modelo Muse Spark, y no conclusiones extraídas de nuestra propia sesión de codificación.
Muse Spark 1.2 frente a Muse Code
Muse Spark 1.2 es el modelo. Muse Code es un agente de terminal en fase beta independiente que funciona con ese modelo. Esta distinción es importante porque un agente puede incorporar funciones de planificación, coordinación de herramientas, navegación por el repositorio, aislamiento del árbol de trabajo, registro de eventos y comportamiento de reintentos en torno al modelo subyacente.
Mantén las capas separadas
Muse Spark 1.2
Contexto, razonamiento, comportamiento de la API, facturación de tokens, resultados y decisiones sobre las llamadas a herramientas.
Números de identificación de los modelosContexto 1MPrecios API
Código Muse
Experiencia de usuario en la terminal, subagentes, árboles de trabajo de Git, registro de eventos, reanudación del flujo, habilidades agrupadas y orquestación.
Flujo de trabajo de los agentesResultados del sistema Meta-run
En página oficial de Muse Code denomina al producto «agente de codificación beta». Esto hace que las comparaciones con productos como Claude Code y Codex resulten más útiles que dar por sentado que todas las diferencias observadas en el flujo de trabajo se deben únicamente a una simple llamada al modelo. Nuestro Comparación entre el código «Codex» y el código «Claude» explica por qué el entorno puede influir en la experiencia del desarrollador tanto como el modelo.
Pruebas de rendimiento de Muse Spark 1.2: lo que realmente revelan las puntuaciones
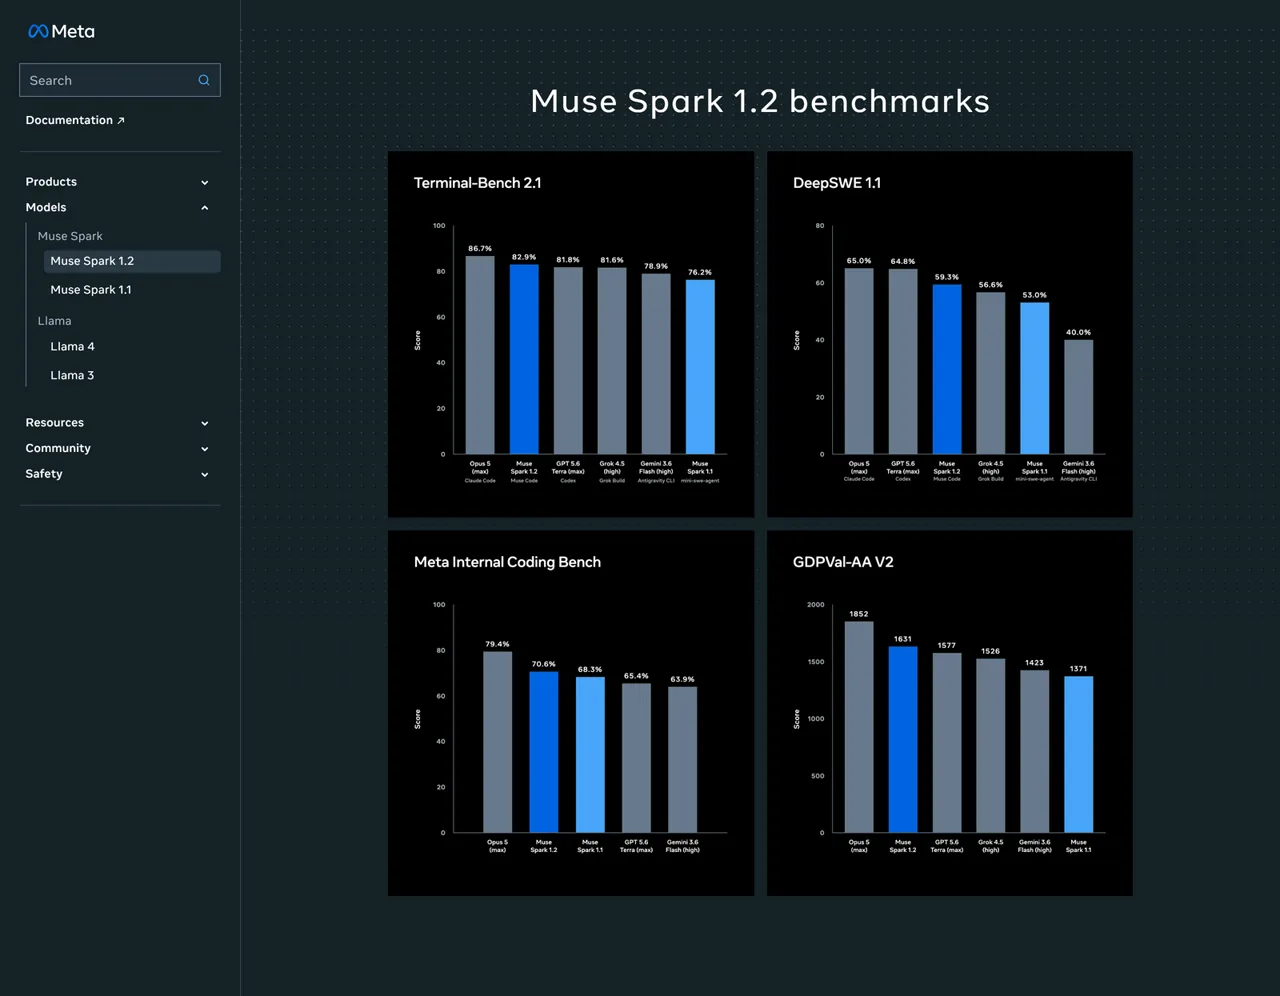
El gráfico comparativo de Meta sitúa a Muse Spark 1.2 cerca de los primeros puestos en varias evaluaciones de programación. Merece la pena analizar las cifras, pero no constituyen una clasificación única y clara de la calidad bruta del modelo. El modelo, el agente, el conjunto de pruebas, la capacidad de razonamiento y el protocolo de la tarea pueden variar todos a la vez.
Meta-reported Terminal-Bench 2.1
Panel de referencia de Meta
Terminal-Bench 2.1
Las 89 tareas · superadas en el primer intento tras cinco intentos · combinaciones seleccionadas de modelo y agente
La cifra 82,9% es un Resultado del código Muse de Meta-run. El Clasificación pública de Terminal-Bench 2.1 no incluyó Muse Spark 1.2 en la lista del 26 de agosto de 2026, por lo que es No es una entrada verificada en la clasificación pública. La tabla pública sí que incluía el Muse Spark 1.1 con mini-SWE-agent en 76,21 TP40T ±1,21 TP40T.
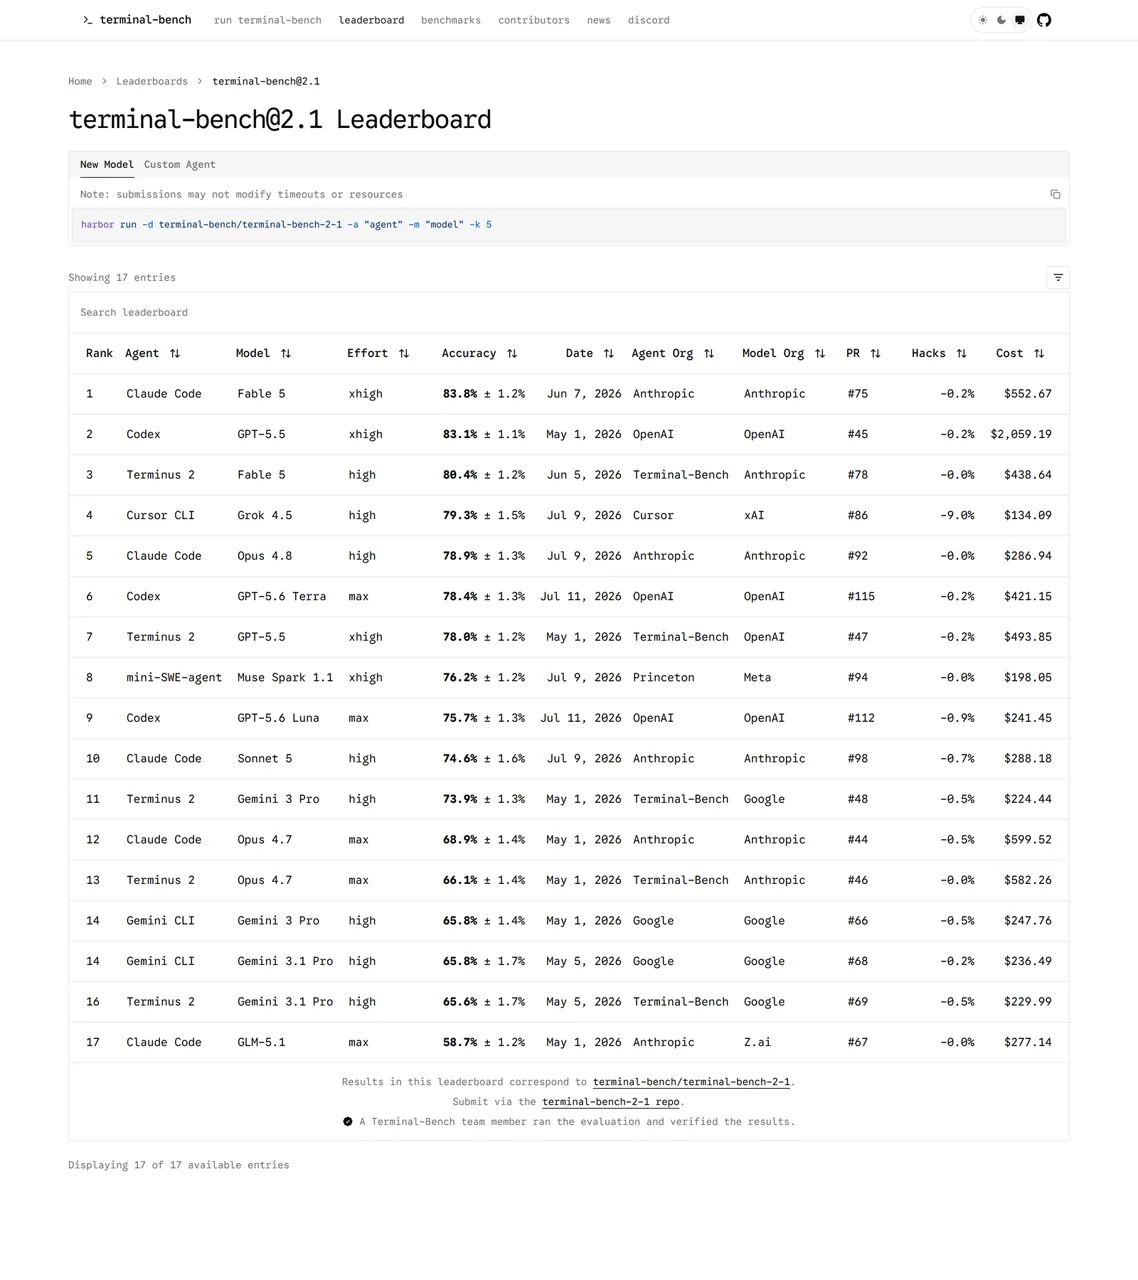
DeepSWE 1.1, según se recoge en Meta
Panel de referencia de Meta
DeepSWE 1.1
113 tareas · 91 repositorios · cinco idiomas · pass@1 tras cinco intentos
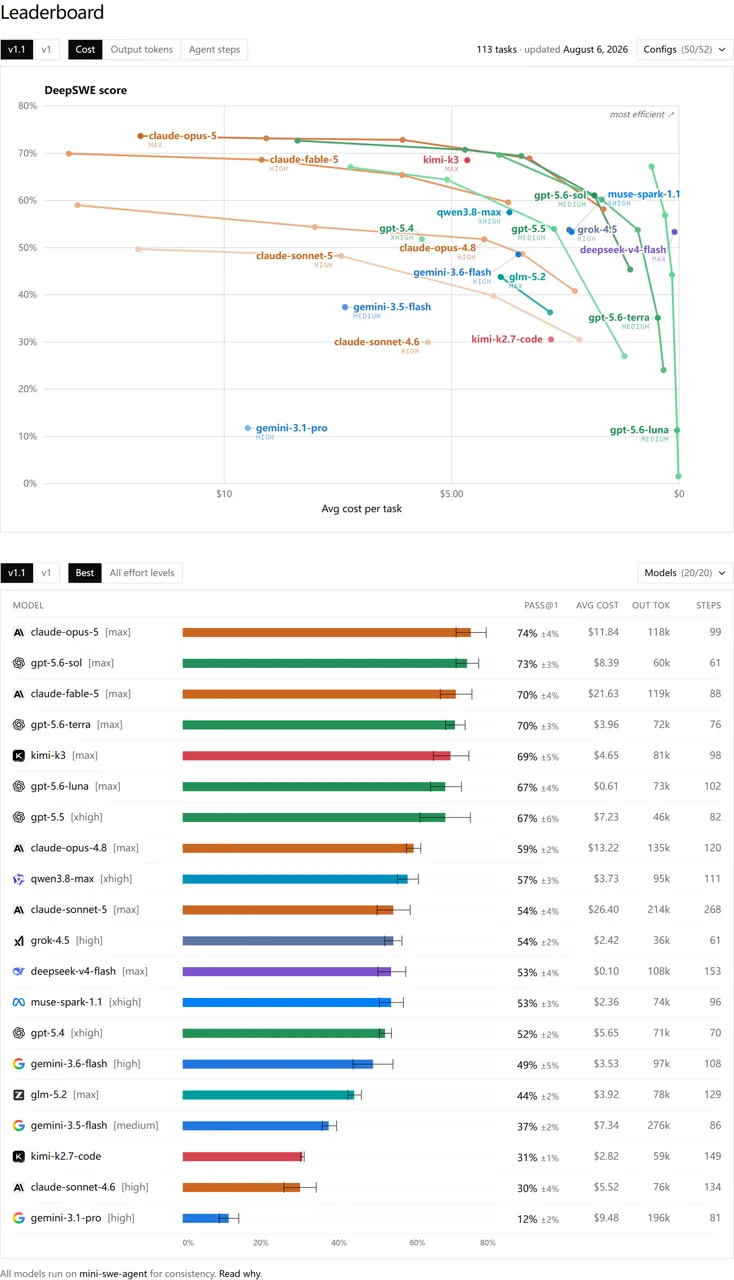
En Clasificación pública de DeepSWE v1.1 Utiliza mini-swe-agent en todos los modelos de su lista para garantizar la coherencia. En el momento de la comprobación, aún no había añadido el Muse Spark 1.2; el Muse Spark 1.1 figuraba con un valor de 53%. El resultado de Meta, 59,3%, utiliza Muse Code, por lo que las dos cifras no son idénticas en cuanto al banco de pruebas.
Las evaluaciones internas y de agentes generales de Meta
Dos escalas de evaluación diferentes
Banco de codificación interno de Meta
440 tareas internas · dos intentos por tarea
| Modelo | Puntuación |
|---|---|
| Obra n.º 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3,6 Flash | 63.9% |
| Grok 4,5 | No se muestra |
GDPVal-AA v2
Evaluación general de tareas agentales · Valores al estilo Elo
| Modelo | Puntuación |
|---|---|
| Obra n.º 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3,6 Flash | 1423 |
Meta’s metodología de evaluación Según la información facilitada, Terminal-Bench utiliza las 89 tareas y obtiene un «pass@1» en cinco intentos. DeepSWE abarca 113 tareas repartidas en 91 repositorios y cinco lenguajes, y también obtiene un «pass@1» en cinco intentos. Meta también señala que es posible que su configuración no esté optimizada para modelos de terceros. Para ver una comparación actual con la competencia basada en decisiones reales sobre productos, consulta Claude Opus 5 contra GPT-5.6.
La metodología cambia el significado
Modelo + agente seleccionado
89 tareas, cinco intentos, los parámetros máximos de razonamiento varían, y es posible que el entorno de pruebas de Meta no esté ajustado de la misma manera para los sistemas de terceros.
Entradas verificadas
Al comprobarlo, se constató que faltaba el Muse Spark 1.2. Las configuraciones de la placa y el estado de verificación deben consultarse por separado en la tabla de Meta.
Agente «mini-swe» común
113 tareas repartidas en 91 repositorios y cinco idiomas. Muse Spark 1.2 no aparecía; Muse Spark 1.1 figuraba con 53%.
Análisis artificial: un contexto independiente y útil
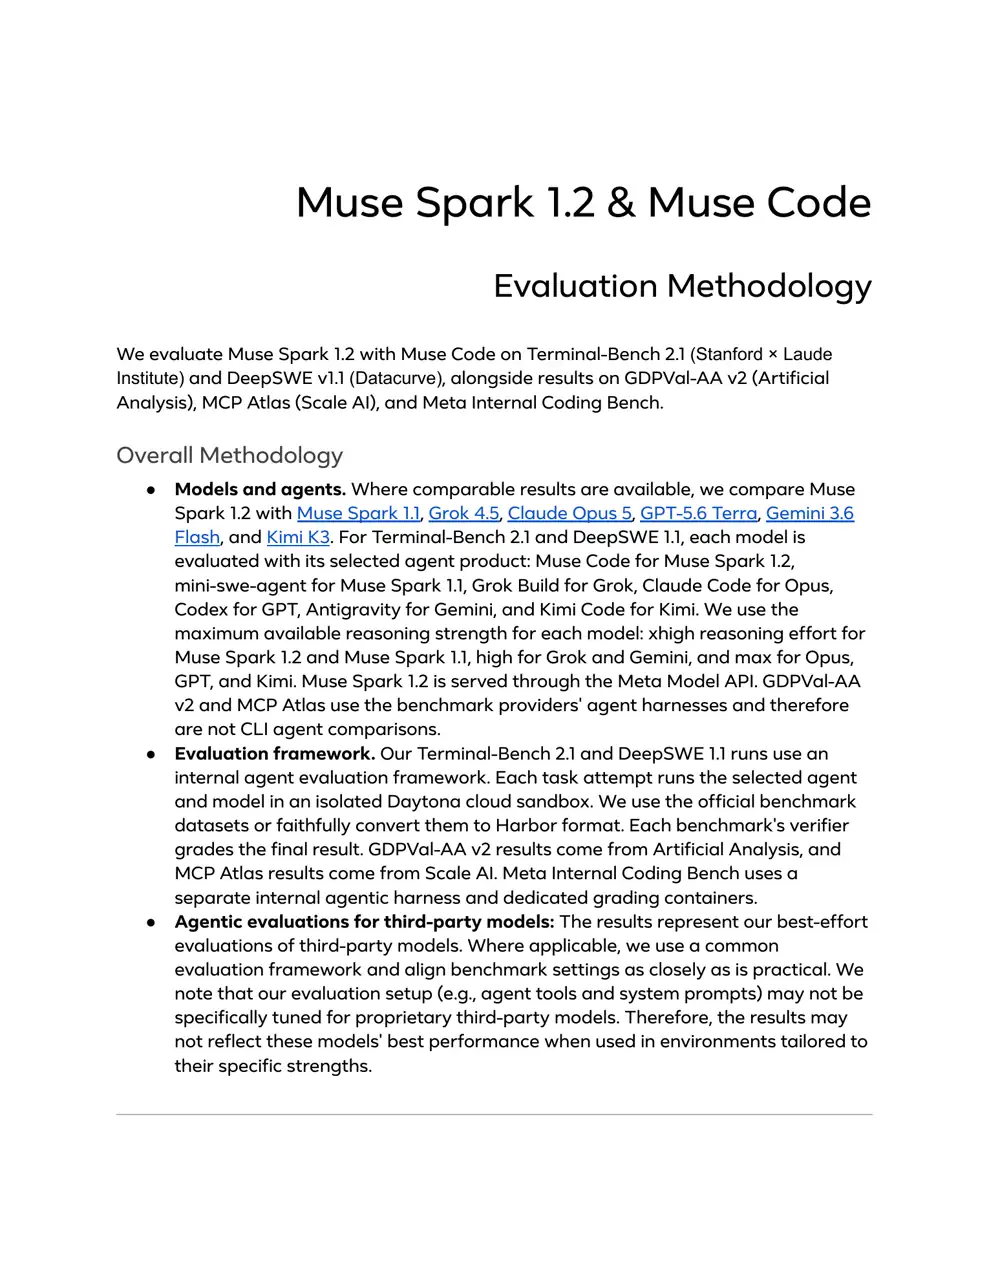
En Página del modelo de análisis artificial otorga a Muse Spark 1.2 un índice de inteligencia de 57, por encima de la mediana de los modelos comparables, que era de 35 según los datos consultados el 26 de agosto de 2026. Su conjunto de pruebas registra 80% en Terminal-Bench v2.1, 57% normalizados en GDPVal-AA v2, 56% en SciCode y 83% en la evaluación de contexto largo AA-LCR.
Desviación de la versión del análisis artificial
La lección práctica es sencilla: Muse Spark 1.2 parece competitivo, pero ninguna puntuación por sí sola permite evaluar el modelo de forma aislada. Considera el gráfico de Meta como una prueba del sistema Muse Code, las clasificaciones públicas como una verificación cruzada independiente y Artificial Analysis como una evaluación independiente, aunque configurada de forma diferente.
Muse Spark 1.2: Precios y compensaciones en materia de privacidad
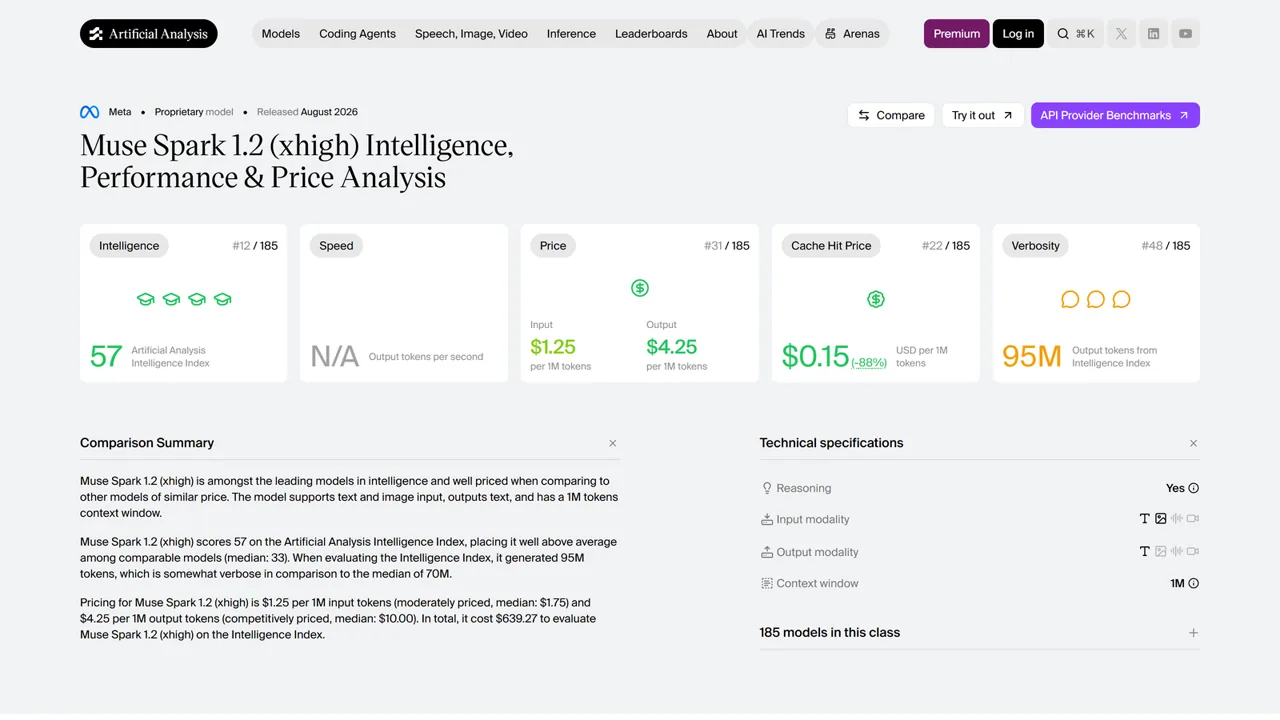
Meta ofrece dos identificadores de modelo de API con precios muy diferentes. La opción más económica no es simplemente un descuento: cambia la forma en que se pueden utilizar los datos enviados.
USD por cada millón de tokens · Contexto de 1M
No se utiliza para la mejora del producto
No se utiliza para mejorar los productos de Meta
Más barato, pero con una limitación en el uso de datos
Datos puede utilizarse para mejorar los productos de Meta
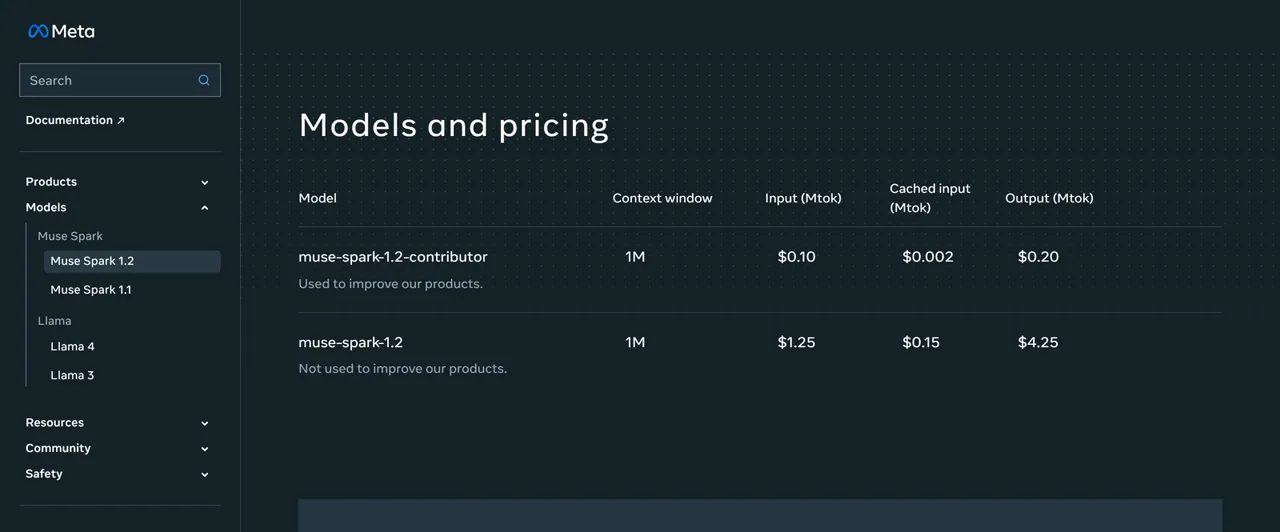
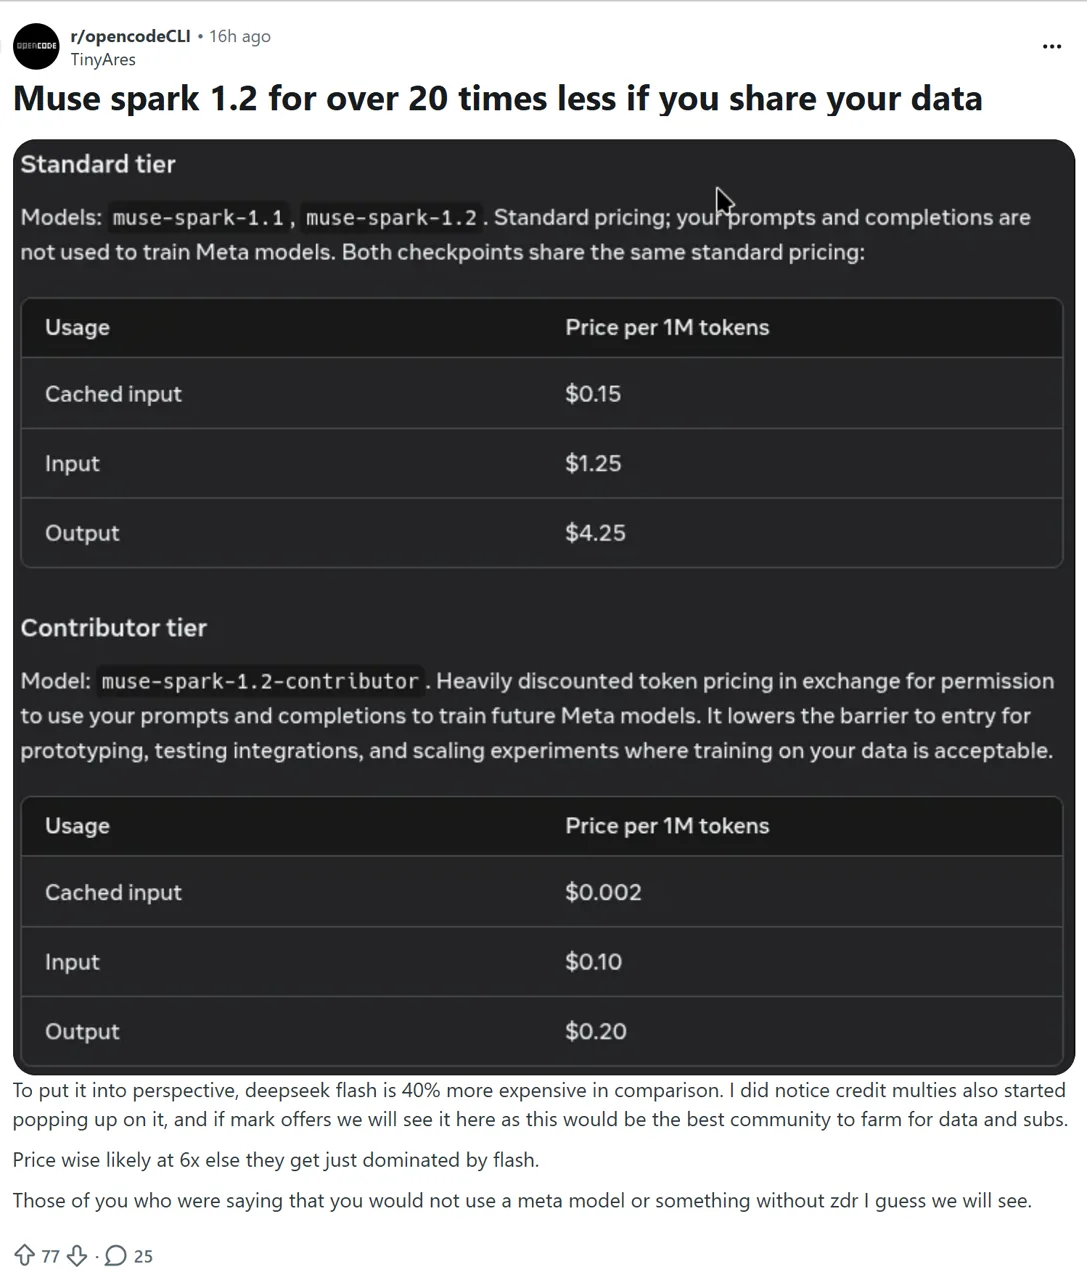
El precio del plan «Contributor» es 12,5 veces más barato para las entradas, 75 veces más barato para las entradas en caché y 21,25 veces más barato para las salidas que el plan estándar. No existe un único porcentaje de descuento que describa con precisión todos los tipos de tokens.
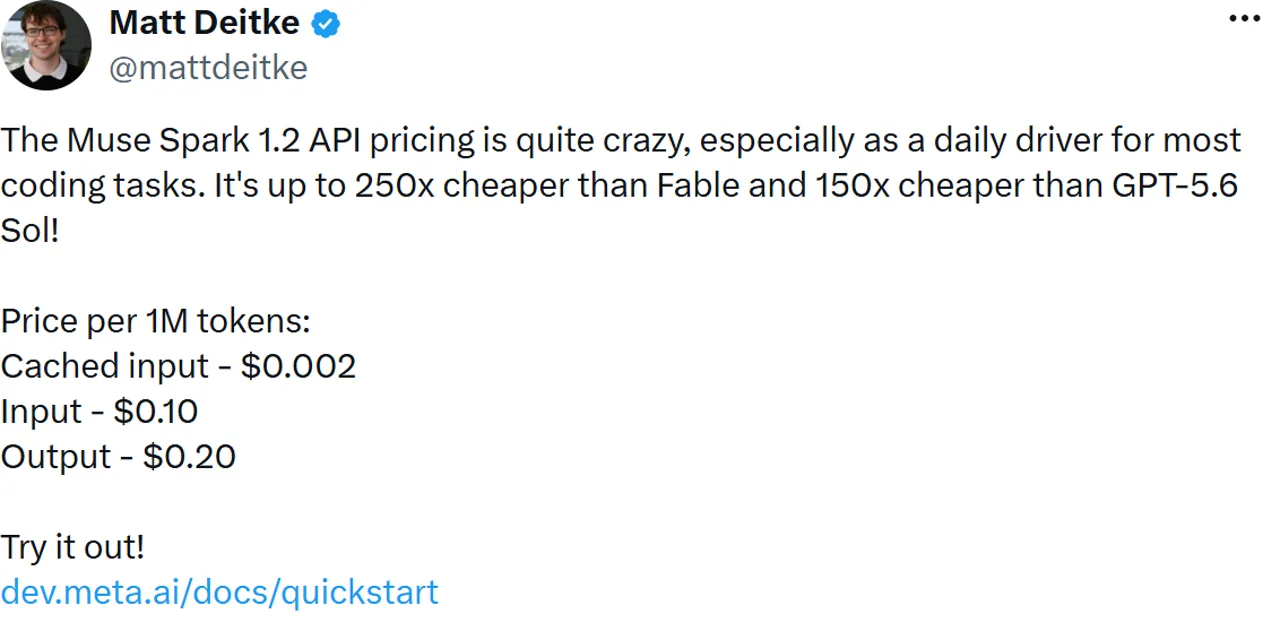
Un investigador de Meta promocionó el nivel “Contributor” como “hasta 250 veces más barato” que Fable y «150 veces más barato» que GPT-5.6 Sol. Eso comparación social utiliza los precios para colaboradores, no el modelo estándar, y siempre debe incluir la salvedad relativa al uso de datos. Los lectores que deseen comparar los costes actuales de la competencia pueden consultar nuestra sección separada Guía de precios de GPT-5.6 y Desglose de precios del código Claude.
En el caso de repositorios públicos, tareas sintéticas o entornos de evaluación desechables, el nivel «Contributor» puede resultar atractivo. Para código privado, datos de clientes, credenciales o arquitectura propia, el nivel «Standard» es la opción predeterminada más segura. Meta también afirma que está empezando a aceptar solicitudes de retención cero de datos a través del departamento de ventas, lo que constituye una vía de acceso independiente, distinta de la configuración predeterminada de autoservicio.
Acceso a la API de Muse Spark 1.2 y ejemplo
Tres vías de acceso oficiales
URL oficial del libro de recetas: https://api.meta.ai/v1 · 1.2 Solicitud en esta revisión: no ejecutada
En API del metamodelo es compatible con un flujo de trabajo compatible con el SDK OpenAI. El manual oficial de Meta utiliza la URL base https://api.meta.ai/v1 y lee la clave desde MODEL_API_KEY. La página del producto también describe la «search grounding», mientras que el manual de recetas aborda la autocompletación en el chat, la transmisión en tiempo real, la invocación de herramientas, la salida estructurada, el almacenamiento en caché de las indicaciones, los controles de razonamiento, la visión, el contexto extenso, los reintentos y las recetas de búsqueda.
Ejemplo de libro de recetas oficial — versión capturada: En Libro de recetas oficial de GitHub sigue utilizando muse-spark-1.1. Esto demuestra la estructura del cliente y la URL base, no que el ejemplo se haya actualizado para la versión 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "¡Hola, mundo!"}],
)

print(response.choices[0].message.content)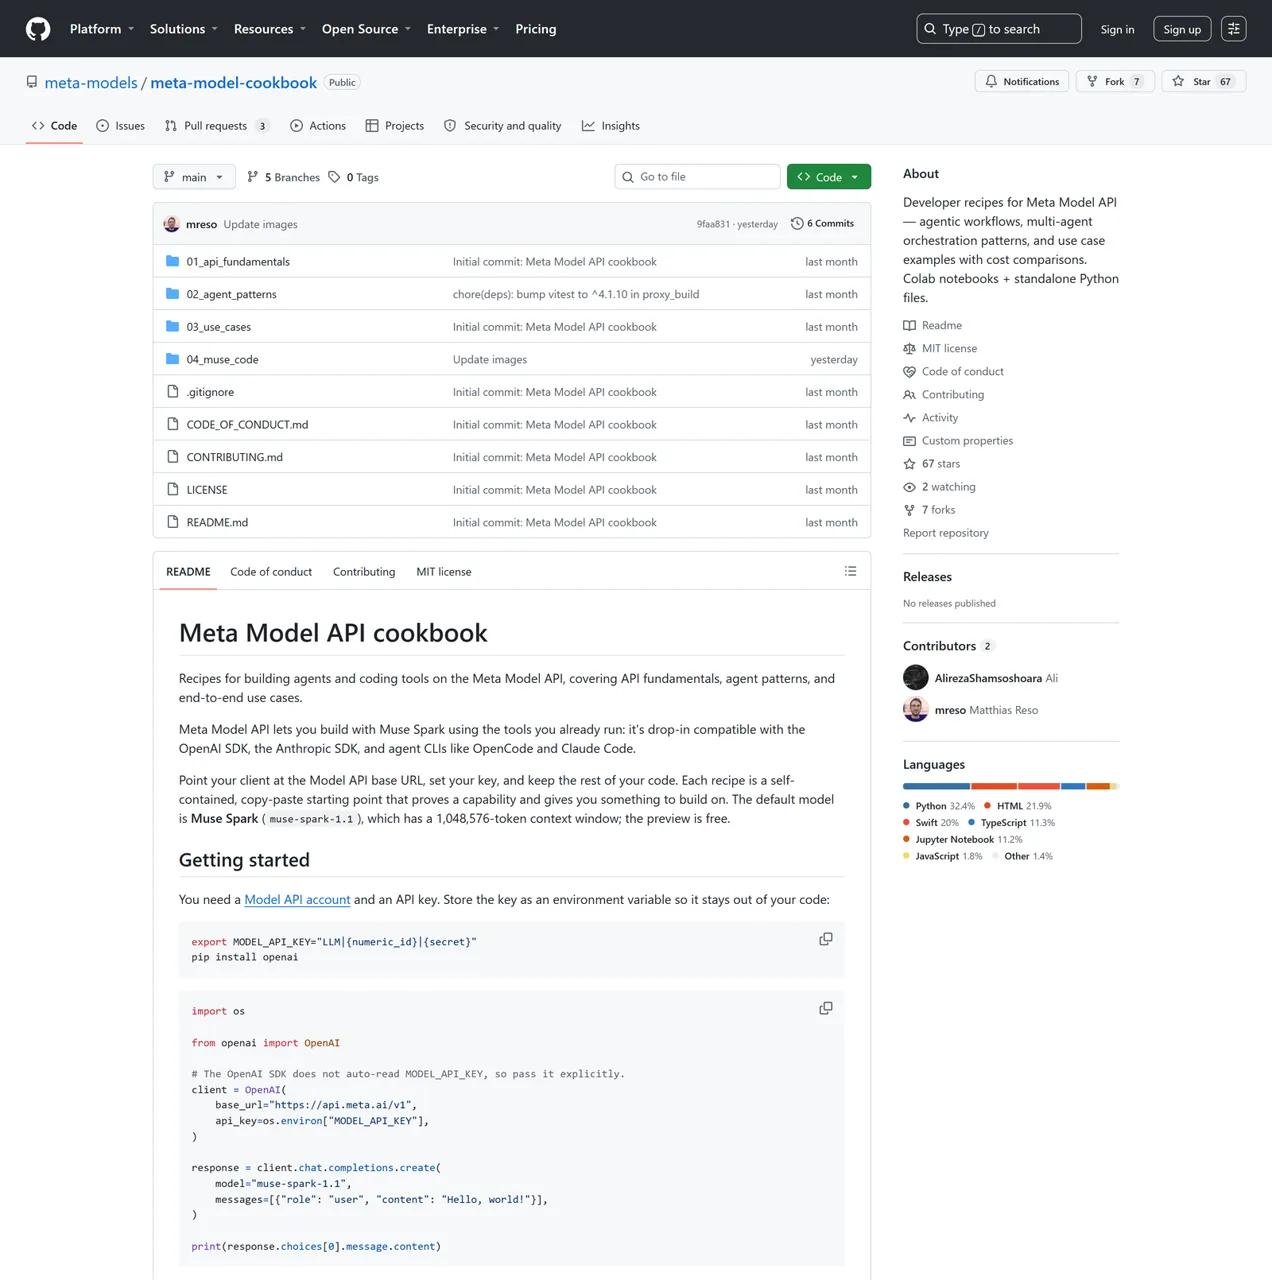
Adaptación documentada — no ejecutada: Meta los enumera por separado muse-spark-1.2 como el ID del modelo estándar 1.2. La sustitución mínima que figura a continuación combina dos datos oficiales, pero no se envió ninguna solicitud de pago durante esta revisión.
respuesta = client.chat.completions.create(
    model="muse-spark-1.2",
    mensajes=[{"rol": "usuario", "contenido": "¡Hola, mundo!"}],
)
Muse Spark es un modelo de razonamiento, y Los tokens de razonamiento se facturan como salida. Esto hace que la tasa de salida estándar $4.25 sea más importante de lo que parece a primera vista: una respuesta aparentemente breve puede ocultar un razonamiento sustancial. La latencia real, el tiempo hasta el primer token, la tasa de reintentos y el coste por tarea siguen sin medirse en este caso.
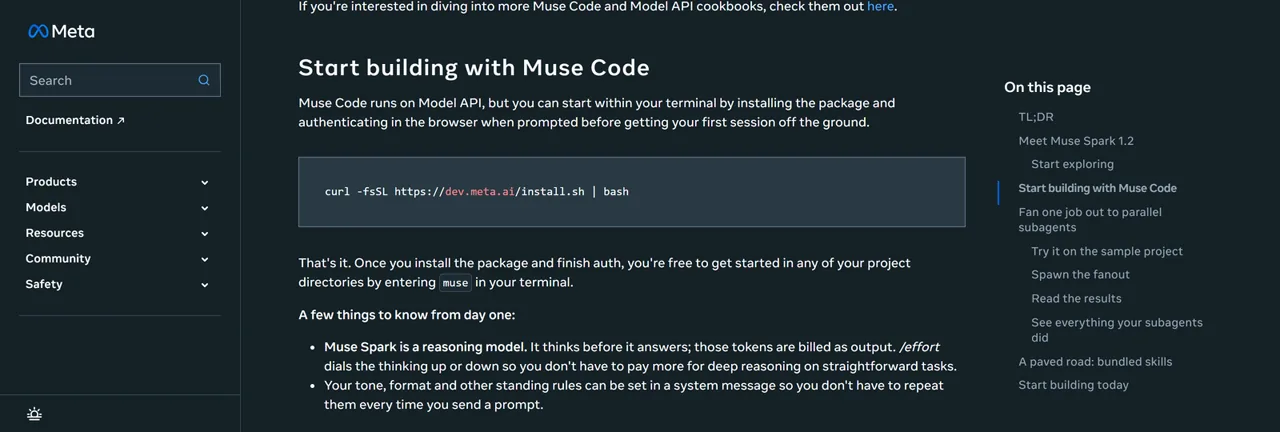
/esfuerzo El comando modifica la profundidad del razonamiento. Fuente: Guía para desarrolladores de Meta.Qué aporta Muse Code
Muse Code se instala desde el terminal e integra Muse Spark 1.2 en un flujo de trabajo de agente. Meta’s Análisis en profundidad para desarrolladores describe varios comportamientos que no forman parte de una llamada a la API sin más:
- Agentes paralelos: Las tareas pueden ejecutarse en árboles de trabajo de Git aislados.
- Registro de eventos de solo adición: Las sesiones y las acciones se guardan en un archivo JSONL local con fines de auditoría y reproducción.
- Reanudar el proceso:
currículum de Musepuede reanudar las sesiones interrumpidas. - Control del razonamiento: el
/esfuerzoEste comando ajusta la intensidad del razonamiento. - Competencias explícitas: Nombres de Meta
/sabor,/a la parrilla,/parrilla-con-documentación, y/plan.
Características del producto «Agent»
Subagentes
Las tareas independientes pueden ramificarse.
Árboles de trabajo
Las ramas permanecen separadas durante el trabajo en paralelo.
Registro JSONL
Los eventos locales de solo adición admiten la reproducción.
Currículum
currículum de Muse continúa con las sesiones interrumpidas.
Habilidades
/sabor, /a la parrilla, /parrilla-con-documentación, /plan.
Ese conjunto de características hace que Muse Code sea relevante para el mercado más amplio de los agentes de programación, en el que la planificación, el aislamiento, la reproducción y la disciplina en el uso de herramientas son tan importantes como la inteligencia de los modelos. El Guía comparativa entre OpenClaw, Claude, Code y OpenCode es un contexto útil para comprender esas diferencias a nivel de producto.
Afirmaciones sobre el lanzamiento y primeras reacciones de la comunidad
Una reacción no es una validación
Formación + perspectiva a largo plazo
Más recursos de programación, diversidad de entornos, formación conjunta y una prueba de estrés con más de 1.000 llamadas a herramientas.
Precio y OpenCode
Un usuario de Reddit destacó lo positivo de haber tenido una experiencia temprana con la programación y el valor que le aportó.
Privacidad + fiabilidad
Otros usuarios expresaron sus preocupaciones respecto al consumo de datos, el precio estándar, la disponibilidad y la fiabilidad inicial.
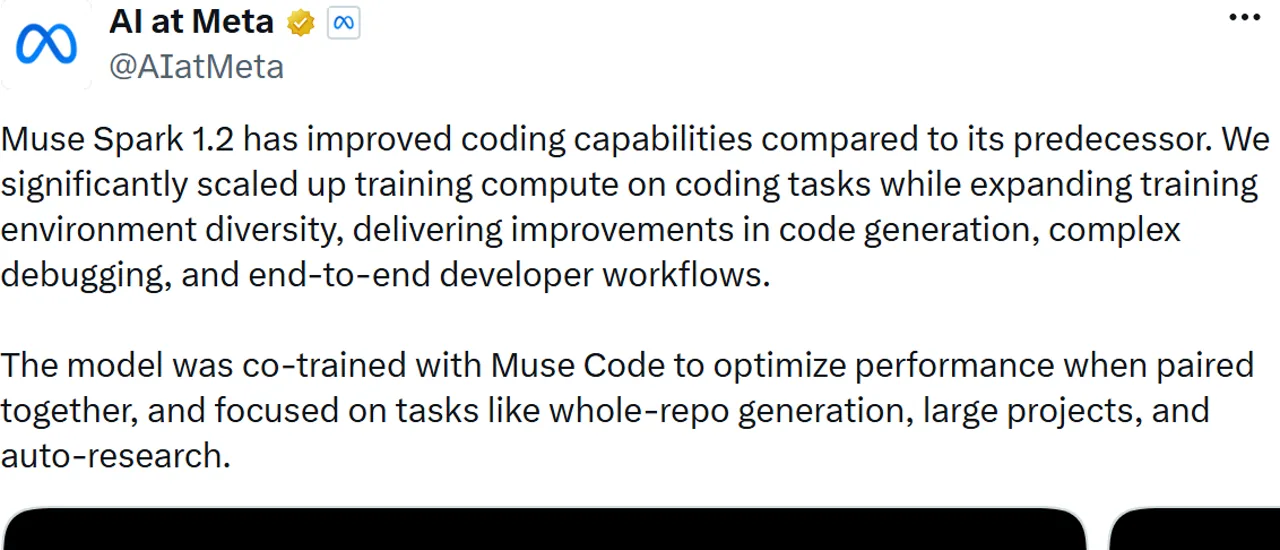
El departamento de IA de Meta afirma que Muse Spark 1.2 ha recibido más recursos computacionales para el entrenamiento en programación, entornos más variados, un mayor énfasis en la generación y depuración de repositorios completos, y un entrenamiento conjunto con Muse Code. Otro hilo de lanzamiento describe una prueba de estrés de hasta 24 horas de duración con más de 1.000 llamadas a herramientas en las GPU NVIDIA Hopper.
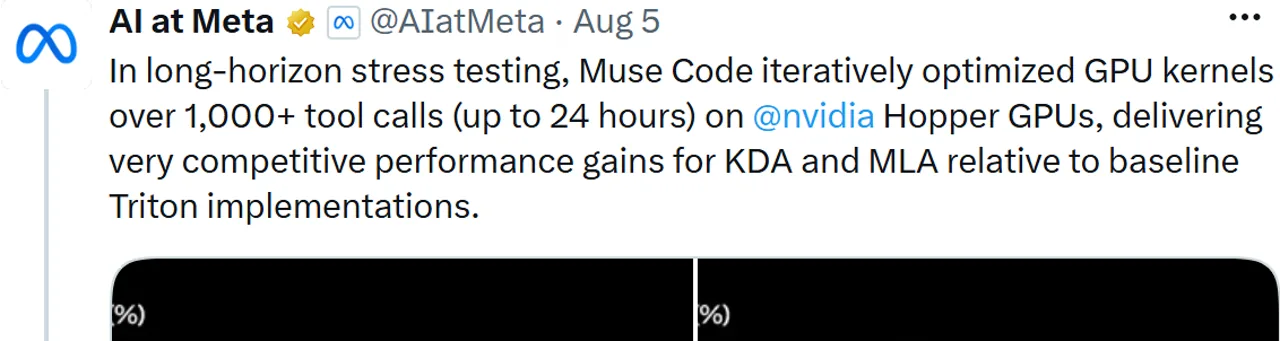
Es una demostración impresionante, pero no constituye una tasa de éxito general cuantificada. No nos indica con qué frecuencia el agente eligió la herramienta adecuada, se recuperó de los errores, evitó llamadas duplicadas o completó una tarea habitual del repositorio sin necesidad de intervención.
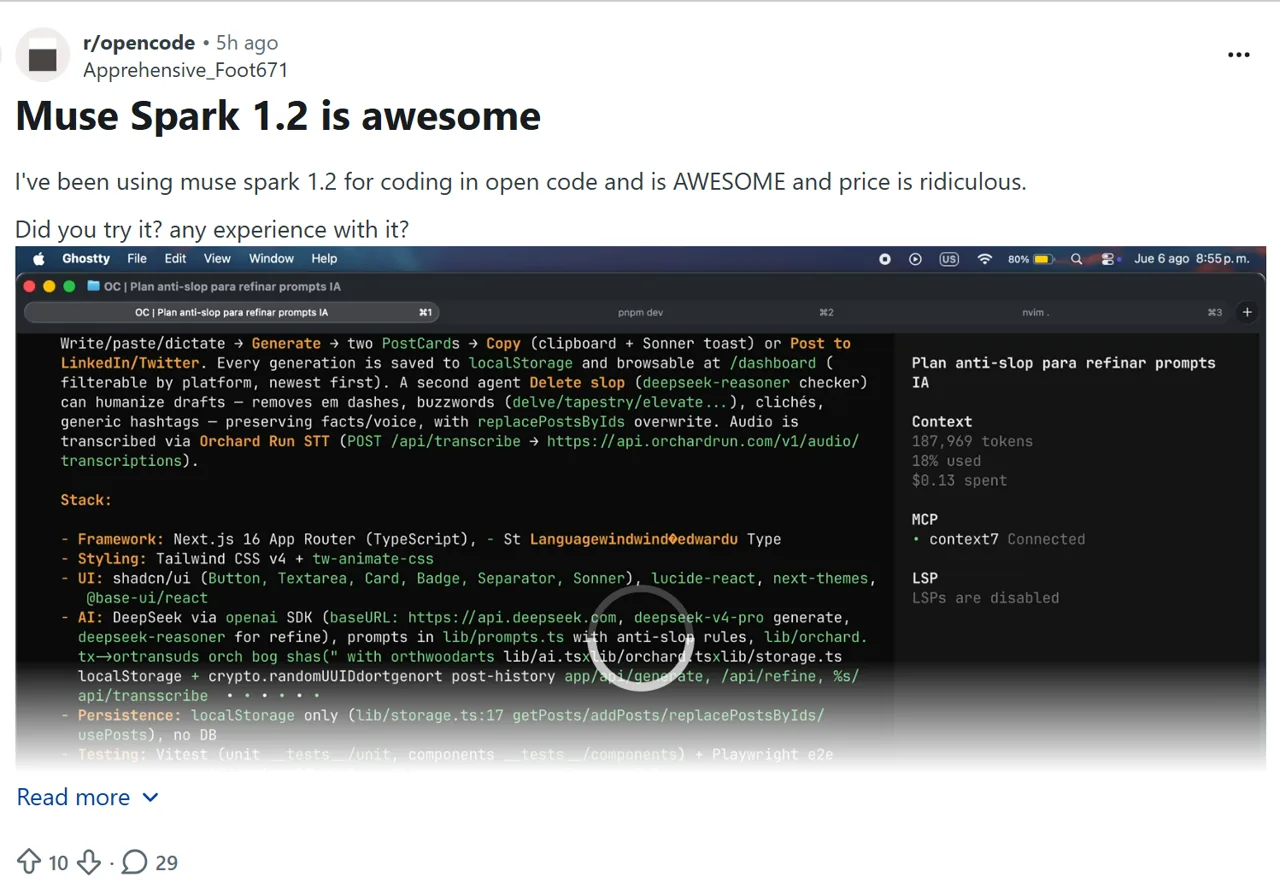
Las primeras publicaciones en Reddit también recogen opiniones dispares. Una de ellas Un usuario de r/opencode ha compartido una experiencia positiva con OpenCode y elogió el precio. Otro Debate sobre los precios de los colaboradores Han surgido dudas sobre el consumo de datos, el coste del plan básico, la disponibilidad y la fiabilidad. Se trata de reacciones individuales, no de un consenso de la comunidad.
Pruebas de programación de Muse Spark 1.2: 3 de 3 tareas superadas
En nuestras pruebas, el modelo básico Muse Spark 1.2 completó tres tareas de programación controladas a través de una API de autocompletado de chat compatible con OpenAI. Cada tarea se realizó en un único intento, sin reintentos y sin intervención humana. Evaluamos los archivos devueltos en repositorios desechables comparándolos con comprobaciones públicas y ocultas. No se probó la ejecución del agente Muse Code ni la fiabilidad de las llamadas a las herramientas, por lo que estos resultados no deben interpretarse como una evaluación comparativa del agente.
Resultado de un único intento
Las respuestas utilizaron 6.618 tokens de razonamiento. Las tres razones finales fueron: basta, y en el campo «proveedor» se indicó «Meta».
Prueba 1: Corrección del error de idempotencia en Python — Superada
Evita las transferencias duplicadas sin modificar la API pública
El modelo identificó la falta del filtro de ID de solicitud, añadió la corrección mínima necesaria y proporcionó una prueba de regresión, al tiempo que preservaba las actualizaciones atómicas del saldo.
El evaluador oculto original exigía, erróneamente, una llamada duplicada para devolver el resultado. Falso, aunque la tarea solo exigía que no se cobrara dos veces al remitente. Tras corregir ese requisito inventado sobre el valor de retorno, la primera respuesta, sin modificaciones, superó las seis pruebas. No volvimos a intentar la tarea ni modificamos el resultado del modelo.
Prueba 2: Reestructuración de varios archivos en TypeScript — Aprobada
Separación de la validación, la persistencia y el registro de auditoría
Los archivos devueltos mantuvieron el contrato de ruta pública, el uso estricto de TypeScript y la transacción única que abarcaba tanto las escrituras de pedidos como las de auditoría. Además, se añadieron pruebas de validación específicas sin dependencia de tiempo de ejecución.
El primer evaluador comparó los objetos con datos sin procesar JSON.stringify, por lo que los objetos equivalentes con un orden de inserción de claves diferente parecían distintos; su versión para Windows npx El lanzamiento también falló antes de la comprobación de tipos. Con un comparador que no distingue el orden y una ejecución del comando compatible con Windows, la respuesta original superó todas las comprobaciones. Una vez más, no se produjo ningún reintento del modelo.
Prueba 3: Funcionalidad del repositorio JSONL — Superada
Cumplimiento de las instrucciones aplicables a todo el repositorio
Añadir JSONL sin afectar al CSV
El modelo incorporaba detección de extensiones, errores de líneas mal formadas a partir de 1, salida atómica, seguridad en la ejecución en modo de prueba, pruebas específicas, texto de ayuda y un ejemplo en el archivo README.
Lo que revelan las pruebas: Muse Spark 1.2 puede generar parches útiles para varios archivos, respetar las restricciones de compatibilidad, añadir pruebas y gestionar una funcionalidad de alcance moderado en todo el repositorio de una sola vez. El coste medio registrado fue de aproximadamente $0,0151 por tarea, pero estos casos de prueba eran pequeños y no deberían utilizarse para estimar el coste de una base de código de gran tamaño.
¿Quién debería utilizar Muse Spark 1.2?
Guía para la toma de decisiones
Evaluación controlada
Código público o sintético, tareas cuantificables, necesidades en contextos amplios y un prometedor resultado de 3/3 en el modelo base.
Se requiere justificante del agente
El comportamiento de Muse Code, los límites de frecuencia estables, las llamadas repetidas a las herramientas o las pruebas de rendimiento a gran escala del repositorio son criterios decisivos.
Código sensible o alto rendimiento
Utiliza el nivel estándar o compara otras opciones cuando la privacidad y el coste de los tokens de razonamiento sean factores determinantes.
Utiliza el modelo estándar para el código sensible, a menos que tu organización haya aprobado por separado las condiciones de los colaboradores. Si el precio de salida estándar modifica el cálculo del valor, compáralo con el actual Precios de Codex, el código Claude y otros costes relacionados con los agentes de codificación antes de comprometerse con un flujo de trabajo.
Veredicto de la reseña de Muse Spark 1.2
Muse Spark 1.2 se ha ganado un puesto en la lista de finalistas de la evaluación, pero no supone una recomendación automática para su producción. El contexto del token 1M, el formato familiar de la API, los bajos precios para los colaboradores, las tres oportunidades de programación en el primer intento y las excelentes puntuaciones de Muse Code en las pruebas de Meta hacen que sea difícil pasarlo por alto. Además, Meta ha hecho un mejor trabajo que muchos otros lanzamientos a la hora de publicar los detalles de la metodología.
Las salvedades son igualmente concretas. La tarificación para colaboradores conlleva una compensación en cuanto al uso de datos. Los tokens estándar de salida y de razonamiento pueden elevar el coste real. Las cifras más destacadas de Meta en materia de programación no se han reproducido como entradas equivalentes en los tableros públicos de Terminal-Bench o DeepSWE, y nuestra muestra práctica abarca tres tareas de modelos básicos en lugar de la ejecución del agente Muse Code.
Lo más sensato es realizar una prueba controlada con código no sensible, guardando los datos de uso sin procesar y la verificación local. Considera el coste y la latencia medidos como una muestra basada en tareas pequeñas y, a continuación, comprueba el tamaño de tu propio repositorio, la recuperación ante fallos y el flujo de trabajo del agente antes de optar por utilizarlo en producción.
Preguntas frecuentes sobre Muse Spark 1.2
¿Qué es Muse Spark 1.2?
Muse Spark 1.2 es el modelo de Meta centrado en la programación, lanzado el 5 de agosto de 2026, con una ventana de contexto de 1 millón de tokens y acceso a través de Muse Code, la API de Meta Model y OpenRouter.
¿Muse Spark 1.2 es lo mismo que Muse Code?
No. Muse Spark 1.2 es el modelo; Muse Code es un agente de terminal beta independiente que funciona con tecnología de este. Muse Code añade características al producto, como subagentes, árboles de trabajo de Git aislados, registro de eventos, reanudación y habilidades integradas.
¿Cuánto cuesta la API de Muse Spark 1.2?
El modelo estándar tiene un coste de $1,25 de entrada, $0,15 de entrada en caché y $4,25 de salida por cada millón de tokens. El modelo «Contributor» cuesta $0,10 de entrada, $0,002 de entrada en caché y $0,20 de salida.
¿Utiliza Meta los datos de la API de Muse Spark para el entrenamiento?
Meta afirma que los datos del nivel «estándar» no se utilizan para mejorar los productos de Meta. Los datos del nivel «colaborador» pueden utilizarse para mejorar los productos de Meta, por lo que el código privado o propietario debe seguir la vía estándar, salvo que una organización apruebe lo contrario.
¿Aparece Muse Spark 1.2 en las clasificaciones públicas de Terminal-Bench o DeepSWE?
No aparecía en ninguno de los dos foros públicos cuando se comprobó el 7 de agosto de 2026. Meta indica 82,91 TP40T en Terminal-Bench 2.1 con Muse Code y 59,31 TP40T en DeepSWE, pero esos son resultados obtenidos por Meta.
¿Se ha probado Muse Spark 1.2 de forma práctica en esta reseña?
Sí. En tres pruebas del modelo básico con un único intento, Muse Spark 1.2 superó la corrección de un error en Python, una refactorización en TypeScript y una función de repositorio JSONL. La latencia media fue de 12,98 segundos y el coste total registrado fue de $0,045362. No se comprobaron la fiabilidad del agente Muse Code ni la de las llamadas a herramientas.
¿Cómo pueden los desarrolladores acceder a Muse Spark 1.2?
Meta enumera tres vías: el agente de terminal de la versión beta de Muse Code, la API de Meta Model y OpenRouter. La guía oficial utiliza un cliente compatible con el SDK OpenAI cuya URL base es https://api.meta.ai/v1.