Las pruebas se realizaron los días 7 y 11 de septiembre de 2026; las fuentes se volvieron a comprobar el 16 de septiembre de 2026.
Hay que aclarar algo sobre el nombre. La gente sigue buscando “Grok 4”, pero el modelo que probamos fue Grok 4,6, y no la fecha de lanzamiento original de julio de 2025. La actual Catálogo de modelos xAI recomienda Grok 4.6 para el código, mientras que el original grok-4-0709 El nombre de la API ha dejado de utilizarse. Mantendré separados esos productos y fechas a lo largo de esta reseña.
Si estás comparando varios asistentes antes de elegir uno, empieza por el más general El mejor modelo de IA para comparar códigos. En este caso, la cuestión más concreta es si Grok es capaz de convertir unas instrucciones de programación precisas en un trabajo que realmente se pueda verificar.
Respuesta rápida: ¿Es el Grok 4 adecuado para la programación?
La versión Grok 4.6 es lo suficientemente buena como para resultar útil a la hora de depurar una función contenida, generar una primera implementación, explicar código desconocido y redactar pruebas. No es lo suficientemente fiable como para aceptarla sin ejecutarla. Los errores detectados en nuestro pequeño conjunto de pruebas no eran simples discrepancias de estilo: una refactorización eliminó neto de cada resultado no vacío, y una suite de pruebas generada no logró distinguir entre un retraso y una marca de tiempo absoluta.
La norma práctica es sencilla: establece un contrato estricto, solicita un cambio y realiza comprobaciones independientes. Un modelo que genere código plausible rápidamente puede, aun así, borrar un campo, debilitar una invariante o cumplir el requisito del código sin tener en cuenta el requisito del formato de respuesta.
Puede Prueba con Grok 4,6 en GlobalGPT para indicaciones limitadas y comparaciones en paralelo. GlobalGPT es una plataforma independiente; no sustituye a Grok Build, a un IDE, al acceso al repositorio, a la consola de la API nativa de xAI ni a tu canalización de integración continua (CI).
Lo que probamos realmente
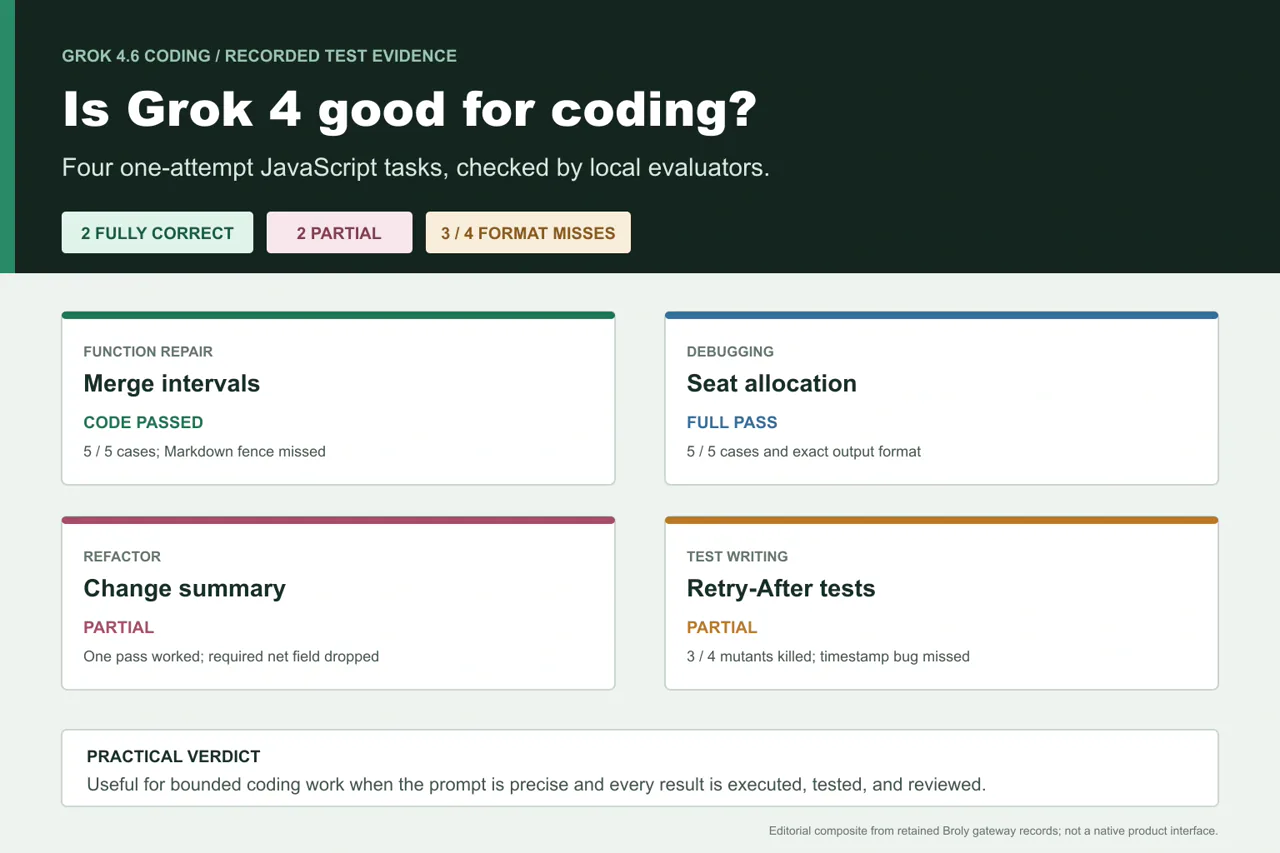
Hemos evaluado cuatro pequeñas tareas en JavaScript: corregir la fusión de intervalos, depurar la asignación de asientos basada en prioridades, refactorizar una función de resumen de cambios y escribir pruebas para un Retry-After analizador sintáctico. Cada tarea contaba con una indicación fija y un evaluador local determinista. Se ejecutaron tres el 11 de septiembre de 2026; la tarea de intervalo reutilizó una ejecución del 7 de septiembre que volvimos a comprobar con su indicación almacenada, la respuesta sin procesar y el evaluador.
- Lugar: API de agregación de Broly autorizada por el usuario, «Chat Completions».
- Modelo solicitado y devuelto:
grok-4.6. - Intentos: una solicitud por tarea, sin reintentos.
- Ejecución: El código JavaScript devuelto se aislaba y se ejecutaba localmente con fixtures o mutantes predeclarados.
- No disponible para el modelo: un IDE, un repositorio, acceso a Internet, ejecución de herramientas xAI y sistemas de producción.
La etiqueta de la pasarela es una información útil sobre el origen, pero no prueba por sí sola la implementación en la fase anterior. El tiempo transcurrido incluye la sobrecarga de la red y de la pasarela, y los recuentos de tokens indicados no constituyen una facturación oficial de xAI. Para obtener una visión más amplia a nivel de producto, consulta el documento independiente Reseña y pruebas reales del Grok 4.6.
Resumen de los resultados de las pruebas de codificación
neto.El mejor resultado no fue la respuesta más extensa. Fue la corrección de la asignación de asientos: concisa, con el formato correcto y completa desde el punto de vista del comportamiento. El error más instructivo fue la refactorización, ya que la implementación parecía limpia y cumplía el requisito de una sola pasada, al tiempo que modificaba de forma implícita el contrato de salida.
Prueba 1: reparación de una función de intervalo de fusión
La primera función modificaba su entrada, se bloqueaba al encontrar un array vacío, no conseguía fusionar los extremos contiguos y podía reducir un intervalo más amplio cuando aparecía posteriormente un intervalo anidado. La indicación dejó claras esas invariantes.
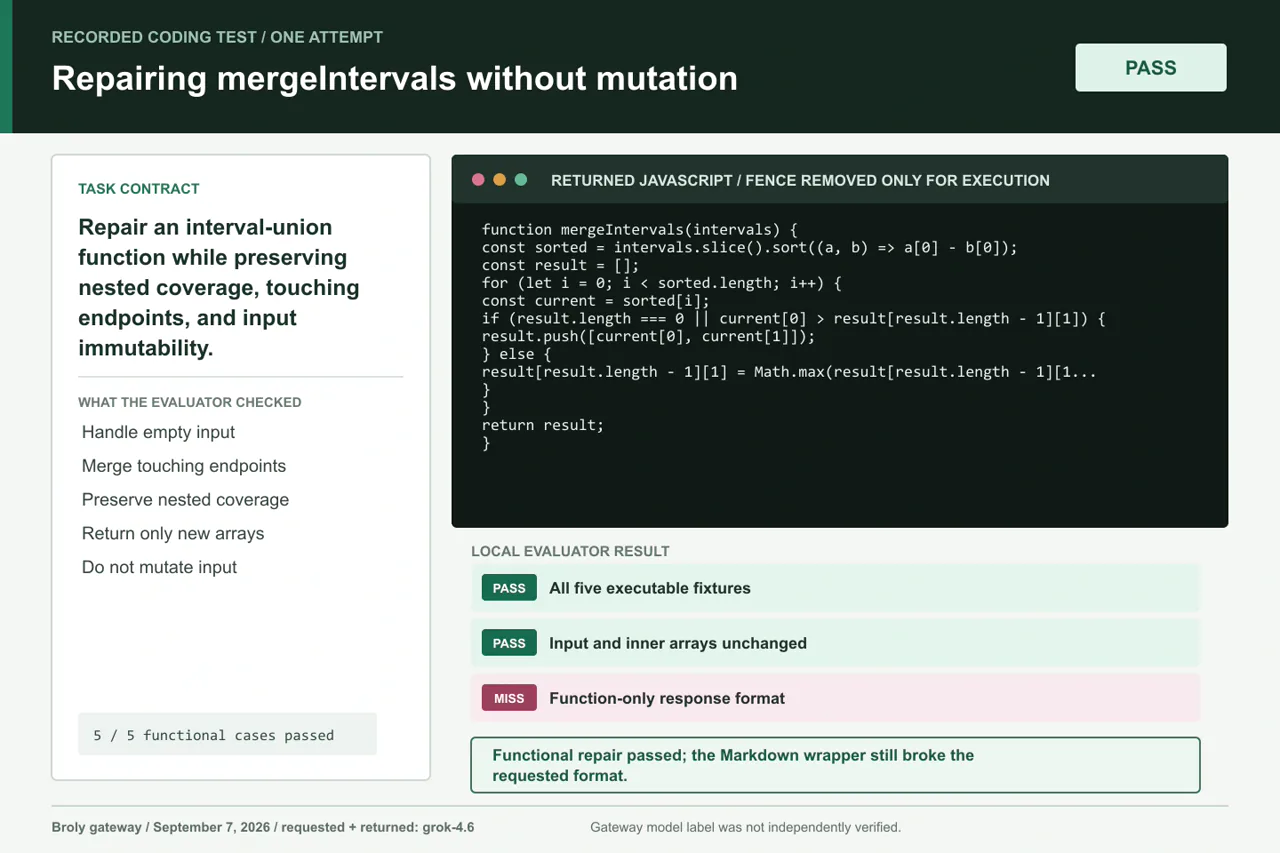
Límite clave: La reparación funcional se superó tras eliminar únicamente la valla exterior de Markdown para la ejecución.
Resultado: Los cinco casos ejecutables se superaron. La función devolvió nuevos matrices, no modificó los datos de entrada, conservó la cobertura anidada y fusionó los puntos finales contiguos. Sin embargo, siguió fallando en una instrucción explícita al envolver el código en Markdown. Tras eliminar únicamente esa barrera exterior de ejecución, el resultado funcional fue correcto.
Conclusión práctica: Grok gestionó bien una reparación compacta cuando el indicador señaló los casos extremos ocultos. El error de formato es insignificante para una persona, pero puede interrumpir un proceso que espera texto directamente ejecutable.
Prueba 2: depuración de la asignación de asientos basada en prioridades
Esta tarea combinaba el manejo estable de empates, la prioridad descendente, la ausencia de mutaciones, la capacidad exacta y una regla de “saltar y continuar”. El código original ordenaba en la dirección incorrecta, modificaba la matriz de entrada y se detenía demasiado pronto cuando una solicitud superaba el límite de tamaño.
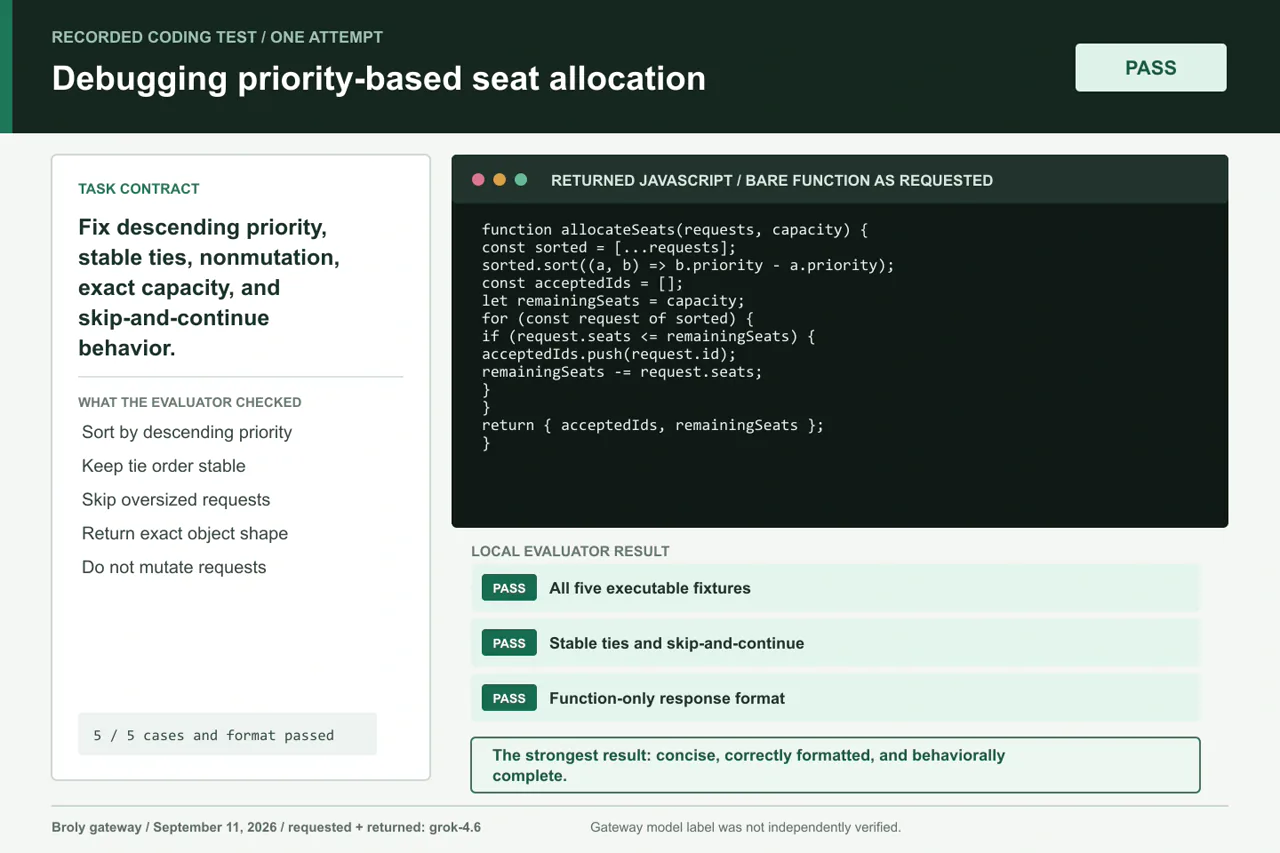
Límite clave: Esta fue la única respuesta que cumplía tanto con el contrato de comportamiento como con el formato exacto de salida.
Resultado: Los cinco casos se superaron, incluyendo el orden de prioridad igual, una solicitud principal de tamaño excesivo, capacidad exacta, capacidad nula y una lista vacía. La entrada se mantuvo sin cambios, identificadores aceptados era una nueva matriz, y el modelo solo devolvió la función solicitada.
Conclusión práctica: Este es el tipo de trabajo para el que Grok resulta ideal: una única función, un contrato claro y casos límite que se pueden ejecutar de inmediato.
Prueba 3: refactorización sin alterar el comportamiento
La tercera indicación pedía a Grok que sustituyera los escaneos repetidos por una única pasada de agregación, conservando al mismo tiempo el orden, los nombres de archivo inusuales y la estructura exacta de la salida. Se trata de un riesgo realista de refactorización: el código puede volverse más rápido y limpio, pero a cambio se puede perder parte de su comportamiento.
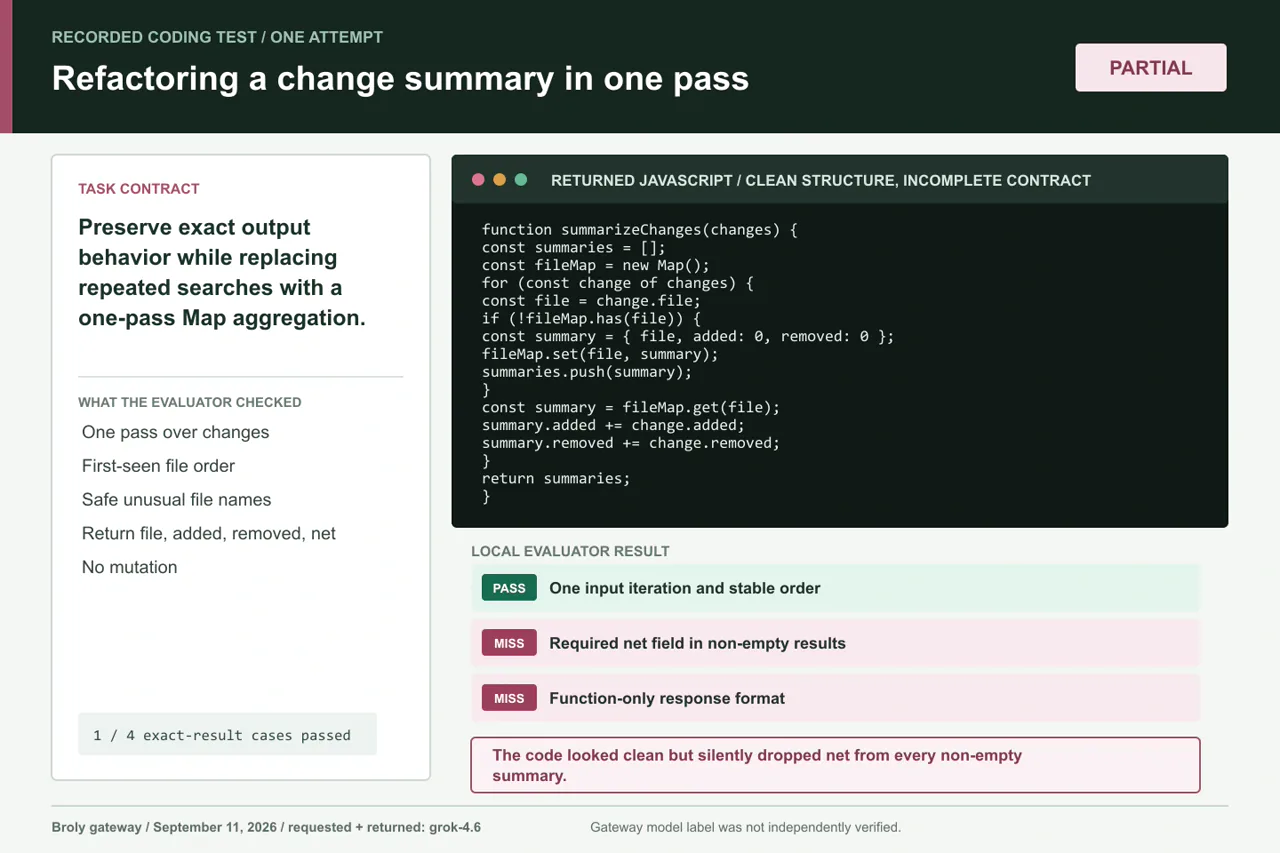
Límite clave: El método «Map» de una sola pasada parecía correcto, pero omitía sin avisar el campo «net» requerido.
Resultado: La respuesta se realizó en una sola pasada, una Mapa, orden correcto según la primera aparición, manejo seguro de __proto__ y constructor, y sin mutaciones en la entrada. Pero nunca calculó ni devolvió neto. El caso vacío se superó porque no contenía objetos de resultado; los tres casos no vacíos fallaron en la comparación exacta.
Conclusión práctica: Nunca evalúes una refactorización basándote únicamente en la complejidad algorítmica o en la limpieza del código. Haz una captura de las salidas antiguas, comprueba todos los campos obligatorios y compara el comportamiento antes de aceptar la nueva versión.
Prueba 4: escribir pruebas que detecten errores plausibles
La tarea final invirtió el procedimiento habitual: Grok escribió las pruebas y nuestro entorno de pruebas las ejecutó con una implementación de referencia estricta y otras cuatro implementaciones deliberadamente erróneas. El objetivo no era la cobertura de líneas, sino comprobar si las entradas elegidas podían distinguir entre semánticas aparentemente similares.
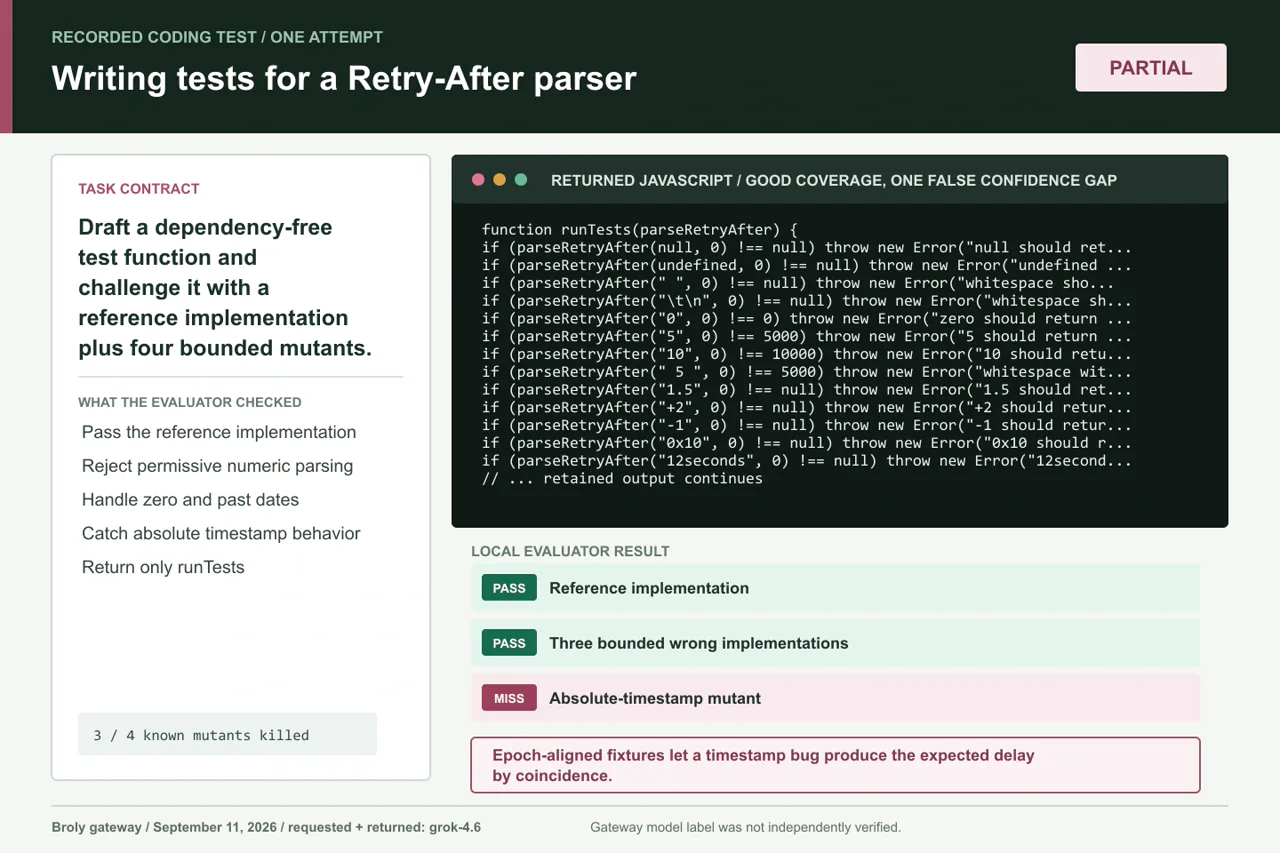
Límite clave: Los formateadores de fecha alineados con la época permiten que, por casualidad, un error relacionado con una marca de tiempo absoluta pase desapercibido.
Resultado: La suite superó la prueba de referencia y detectó el análisis numérico permisivo, el tratamiento del cero como valor falso y un retraso negativo para una fecha pasada. Sin embargo, no detectó el caso anómalo que devolvía la marca de tiempo absoluta de la fecha analizada. Ambas pruebas de fecha utilizaban valores alineados con la época, por lo que el retraso esperado coincidió con la marca de tiempo.
Conclusión práctica: Las pruebas escritas por IA son un primer paso útil, pero no una garantía de que todo sea correcto. Pregúntate qué distingue cada caso de prueba. Las pruebas de mutación, las pruebas de propiedades y los valores deliberadamente desajustados pueden poner al descubierto un conjunto de pruebas que solo parece exhaustivo.
Grok 4, Grok 4.6 y Grok Build no son lo mismo
Contexto del lanzamiento de julio de 2025. El antiguo slug de la API se retiró posteriormente.
La etiqueta devuelta por la pasarela en estas cuatro tareas aisladas.
Un agente independiente que puede funcionar a través de un flujo de trabajo de repositorio interactivo o sin interfaz gráfica.
Una herramienta de Python en entorno aislado que debe activarse en una solicitud compatible.
En Anuncio original Grok 4 Se trata del contexto histórico del lanzamiento. No describe el modelo utilizado en nuestras pruebas de 2026.
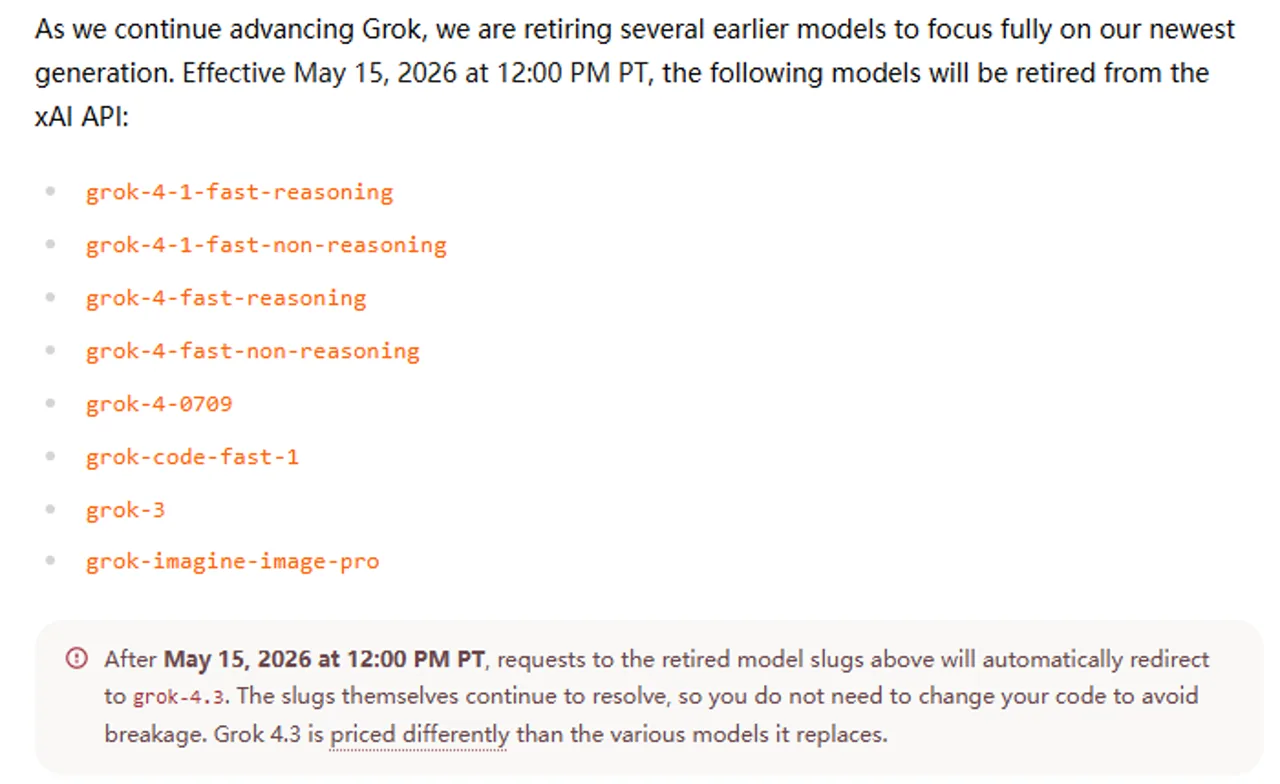
de xAI Aviso de migración del 15 de mayo de 2026 dice grok-4-0709 Ahora redirige a Grok 4.3 con un nivel de razonamiento bajo. Eso no significa que hayan desaparecido todos los productos que llevan el nombre de la familia Grok 4; significa que lo que importa es el identificador exacto del modelo.
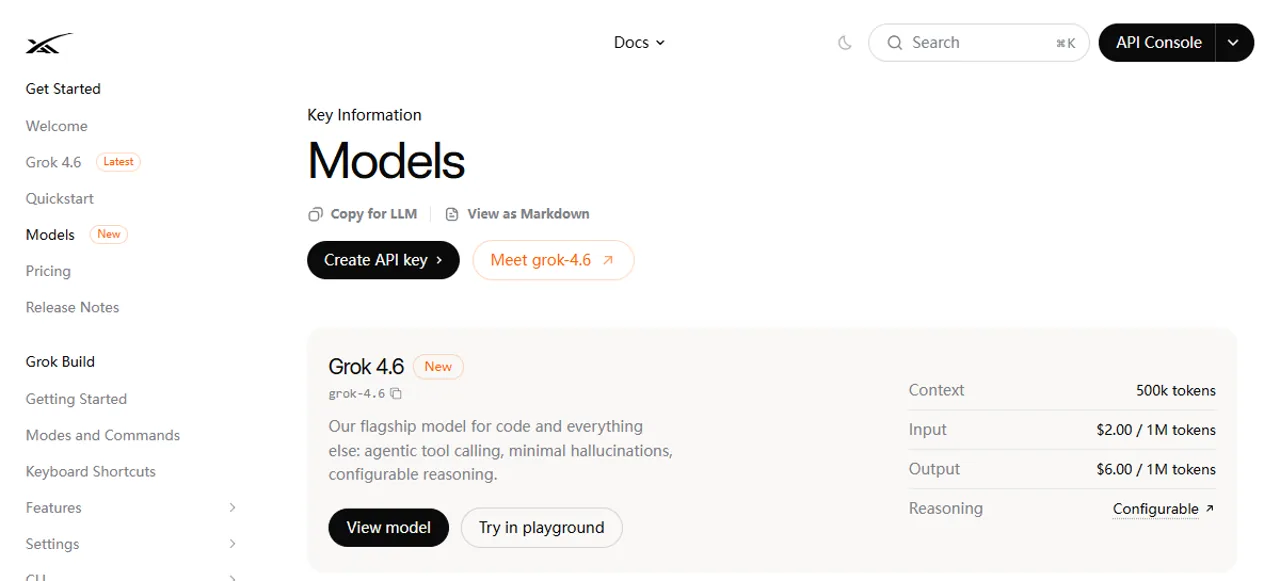
El Grok 4.6 es el modelo actual que xAI recomienda para la programación. El modelo oficial Especificaciones del Grok 4.6 Entre las herramientas compatibles se incluyen la llamada a funciones, la búsqueda en la web, la búsqueda en X y la ejecución de código. La compatibilidad no equivale a la activación automática: el producto que realiza la llamada o la solicitud de la API sigue determinando lo que el modelo puede ver y hacer.
En Anuncio sobre Grok 4.6 sitúa al modelo como la opción ideal para agentes que se ejecutan durante largos periodos de tiempo y para el trabajo con el código fuente. Se trata de una afirmación oficial del producto, no de algo que hayan medido de forma independiente nuestras cuatro tareas aisladas de JavaScript.
Versión Grok es el agente de codificación independiente. Su interfaz de terminal interactiva y su modo sin interfaz gráfica permiten su integración en un flujo de trabajo de repositorio. Si estás eligiendo entre nombres de modelos en lugar de productos de codificación, el El mejor modelo Grok según la tarea La guía explica la estructura familiar actual.
En Herramienta de ejecución de código xAI Es un entorno Python opcional en modo sandbox. No estaba activo en nuestras pruebas de Broly, por lo que el modelo no ejecutó su propio código JavaScript ni examinó la respuesta del evaluador antes de dar una respuesta.
Los mejores casos de uso de codificación para Grok
Depuración de un fallo aislado
Grok resulta más útil cuando el fallo puede reducirse a una función, un rastro de pila, un fixture defectuoso o un diff breve. Incluye lo que debería ocurrir, lo que ha ocurrido realmente y los límites que no quieres que se modifiquen. El resultado de la asignación de asientos muestra cómo un caso límite concreto puede convertir una solicitud vaga del tipo “arréglalo” en un parche verificable.
Creación de una primera implementación
En cuanto a adaptadores, analizadores sintácticos, funciones de transformación y ejemplos de API, Grok puede eliminar las dificultades iniciales. Solicita la unidad completa más pequeña, las versiones de la biblioteca de pines y ejecuta el fragmento de código. El Guía de integración de API Grok 4 es el siguiente paso cuando el trabajo tiene que ver con la API, en lugar de con una solución de código aislada.
Revisar o elaborar exámenes
Solicita a Grok los casos límite que faltan, los invariantes y los mutantes candidatos. A continuación, comprueba si cada entrada distingue el comportamiento que pretende probar. La suite Retry-After era amplia sobre el papel, pero un par de marcas de tiempo alineadas permitió que se pasara por alto un error semántico.
Comparación de enfoques alternativos
Grok también resulta útil como segunda opinión sobre un algoritmo, una estructura de datos o una hipótesis de depuración. Cuando la decisión se centra en la idoneidad del asistente más que en un único parche, el Comparación de la codificación entre Grok y ChatGPT añade una vista que abarca varios modelos.
Cuando la codificación Grok requiere supervisión
Reestructuraciones que conservan el comportamiento: El modelo puede cumplir con el algoritmo solicitado aunque falte un campo de salida. Ejecuta pruebas de regresión y compara las salidas serializadas, los errores, el orden, las mutaciones y los efectos secundarios.
Cambios en el repositorio de varios archivos: Nuestras pruebas no abarcan la detección de dependencias, los sistemas de compilación, la búsqueda de código, los archivos generados, las migraciones ni las ediciones coordinadas. Utiliza un agente de programación real con acceso limitado al repositorio y, a continuación, revisa sus comandos y las diferencias. El Comparación entre Codex y el código Claude muestra por qué el flujo de trabajo que lo rodea es tan importante como el modelo.
Tareas de seguridad y producción: No consideres una respuesta afirmativa como un modelo de amenazas, una auditoría de dependencias o una aprobación de implementación. Mantén en el proceso la integración continua (CI), el análisis estático, el escaneo de secretos, el entorno de prueba, la reversión y la revisión humana.
Formatos estrictos de máquina a máquina: Tres de las cuatro respuestas sin procesar utilizaban una valla de Markdown a pesar de las instrucciones explícitas de no utilizar Markdown. Valida y analiza la salida en el límite; nunca pases el texto del modelo directamente a la ejecución por el hecho de que parezca código.
Costes y rastros de razonamiento extensos: Nuestra pasarela ha registrado 4.260 tokens de finalización para una solicitud con max_tokens: 4096, principalmente como tokens de razonamiento. Esa observación no demuestra el comportamiento de facturación o de límite de xAI. Consulta el sitio web oficial actual y compáralo con el Grok 4: Guía de precios y configuración de la API antes de calcular el presupuesto de producción.
Un flujo de trabajo práctico para utilizar Grok en el código
1. Reducir el problema
Proporciona a Grok la reproducción más sencilla que siga dando error. Incluye el error, el código relevante y un resultado esperado. Elimina el historial del proyecto que no esté relacionado y los datos confidenciales.
2. Redacta un contrato, no una lista de deseos
Indica el nombre de la función, los datos de entrada aceptados, la estructura exacta de los resultados, el orden, las reglas de mutación, los límites de dependencia y el formato de salida. El Guía de uso del Grok 4 abarca el proceso general de contabilidad y el flujo de trabajo de generación de avisos.
3. Pide un poco de cambio
Es preferible optar por una función o una modificación concreta en lugar de una reescritura general. Pídele que mantenga el comportamiento público y que indique cualquier suposición que haya tenido que hacer.
4. Realizar comprobaciones independientes
Ejecuta el código fuera de la respuesta del modelo. Añade casos extremos que distingan entre significados similares, comprueba las mutaciones en las entradas, compara todos los campos de salida y prueba los fallos esperados. En el caso de los conjuntos de pruebas generados, ejecuta mutantes conocidos cuando el riesgo lo justifique.
5. Revisa las diferencias y asume la responsabilidad de la decisión
Lee el diff final como si lo hubiera elaborado un colaborador humano. Confirma los cambios en las dependencias, los límites de seguridad, la observabilidad y la reversión. La persona encargada de la fusión o la implementación sigue siendo responsable del resultado.
Lo que los desarrolladores hacen público
La experiencia del público es variada y depende en gran medida de la tarea, el producto, el mensaje y la fecha. Dos comentarios de Hacker News ilustran esta variedad, pero ninguno de ellos constituye un punto de referencia ni una encuesta representativa.
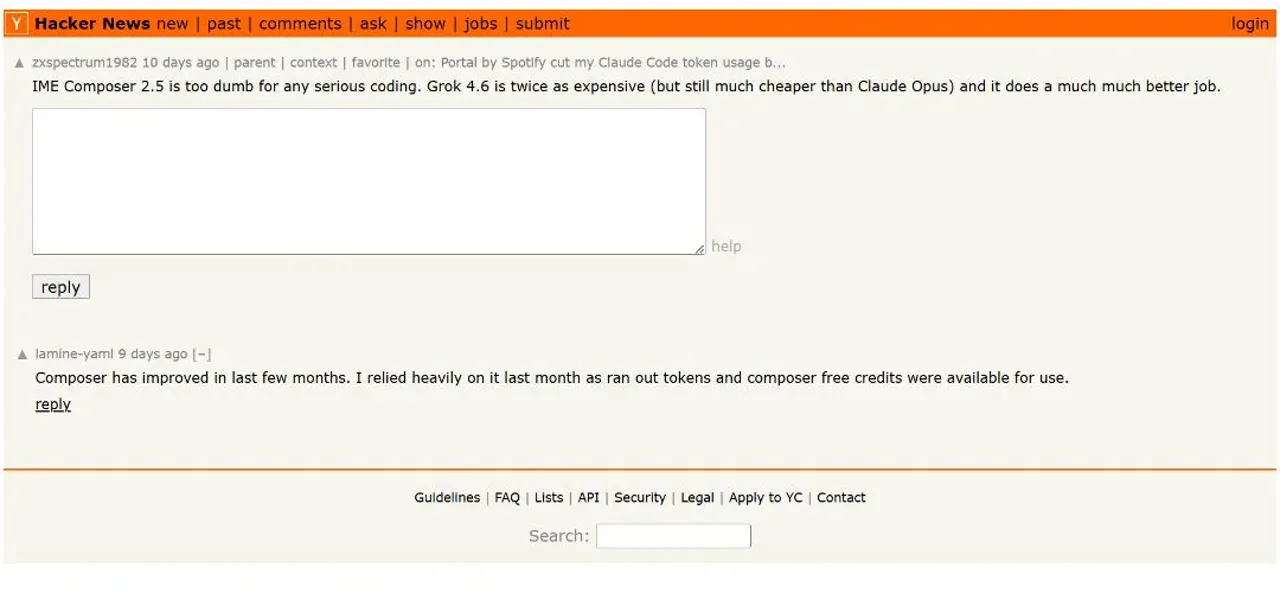
El 5 de septiembre de 2026, un usuario de Hacker News zxspectrum1982 Describió que Grok 4.6 funcionaba mucho mejor que Composer 2.5 en tareas de programación exigentes, aunque también señaló que era más caro. Se trata de la comparación de un usuario, no de una afirmación general sobre el rendimiento.
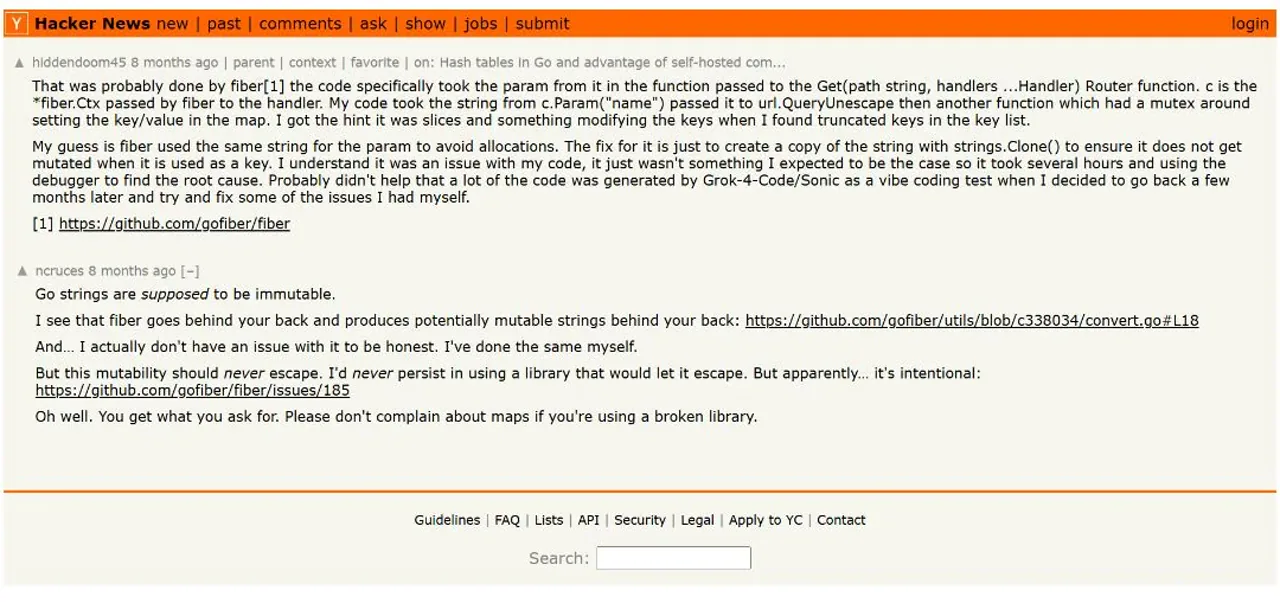
El 20 de diciembre de 2025, un usuario de Hacker News hiddendoom45 describió cómo, más tarde, había detectado un error sutil relacionado con la duración de las cadenas en Go/Fiber mediante un depurador, una vez que se había generado el código durante un experimento Grok-4-Code/Sonic. Ese relato histórico respalda la depuración manual y la revisión que tenga en cuenta la duración de las cadenas; no establece una tasa de fallos del Grok 4.6.
El denominador común no es que Grok siempre tenga éxito o fracase. Es que la calidad del código solo se hace evidente una vez que la respuesta se enfrenta a una tarea concreta, una cadena de herramientas y un revisor. Lo mismo ocurre en el caso de… Análisis realista de la codificación ChatGPT: La calidad de los asistentes es inseparable de la verificación.
Preguntas frecuentes
¿Es el Grok 4 adecuado para principiantes en programación?
Sí, para obtener explicaciones, ver ejemplos breves y realizar una depuración guiada. No obstante, los principiantes deberían ejecutar todos los fragmentos de código, preguntar qué cambia en cada línea y evitar pegar información confidencial o implementar código con el que no estén familiarizados sin revisarlo previamente.
¿Qué modelo Grok debería utilizar para la codificación?
Según la información consultada el 11 de septiembre de 2026, xAI recomienda Grok 4.6 para el código. Confirma el ID exacto del modelo en tu producto, ya que el slug original de la API «grok-4-0709» ha sido retirado.
¿Puede Grok 4.6 editar un repositorio completo?
El modelo puede facilitar el trabajo con repositorios cuando se utiliza dentro de un agente con acceso limitado a archivos y comandos. Nuestras pruebas consistieron en solicitudes aisladas, por lo que no demuestran su capacidad autónoma para trabajar con múltiples archivos ni su idoneidad para entornos de producción.
¿«Grok Build» es lo mismo que utilizar «Grok» en el chat?
No. Grok Build es un agente de programación independiente, ya sea interactivo o sin interfaz gráfica. Una finalización normal en el chat o mediante la API no recibe automáticamente el contexto de su repositorio, la terminal, los permisos ni el ciclo de herramientas.
¿Puedo utilizar el Grok 4.6 para programar el GlobalGPT?
Sí. GlobalGPT ofrece una ruta Grok 4.6 verificada para indicaciones de codificación acotadas y comparaciones de modelos. Se trata de una plataforma independiente y no sustituye a Grok Build, a un IDE ni a las herramientas de la API nativa de xAI.
¿Debería confiar en el código generado por Grok sin probarlo?
No. Ejecuta el código, añade casos límite, revisa las diferencias y ejecuta tus comprobaciones habituales de lint, tipos, seguridad e integración continua. Nuestra refactorización parecía correcta, pero se había omitido un campo obligatorio en todos los resultados no vacíos.
Veredicto final
¿Es el Grok 4 adecuado para la programación? El modelo actual Grok 4.6 es un asistente de programación eficaz para correcciones limitadas, funciones pequeñas, explicaciones y pruebas de primera pasada. En nuestro conjunto de cuatro tareas, generó dos soluciones totalmente correctas, una refactorización que alteraba el comportamiento y un conjunto de pruebas incompleto. Además, ignoró una instrucción estricta de no utilizar Markdown en tres respuestas.
Úsalo en contextos en los que detectar un fallo resulte sencillo: ámbito limitado, contratos explícitos, fixtures ejecutables y revisión humana. No consideres estas pruebas como un permiso para realizar cambios en el repositorio sin supervisión, para obtener la aprobación de seguridad o para el despliegue en producción.
Para realizar una prueba práctica, abrir Grok 4,6 en GlobalGPT, ejecuta una de las instrucciones completas anteriores y compara el resultado con tus propias pruebas antes de decidir si la puedes incorporar a tu flujo de trabajo.