El GLM-5.3 Flash es el modelo al que yo prestaría atención si te importa el rendimiento de la codificación, pero no quieres pagar el precio de un modelo de gama alta en cada llamada a la API. Z.AI lo presenta como un modelo nativo multimodal de la serie GLM-5, y la diferencia de precio oficial no pasa desapercibida: la tarifa promocional actual es de $0,075 por cada millón de tokens de entrada y de $0,25 por cada millón de tokens de salida, mientras que GLM-5.3 y GLM-5.2 figuran a $1,40 de entrada y $4,40 de salida por cada millón de tokens en la misma página de precios de Z.AI.
Eso no significa que GLM-5.3 Flash sea la opción más obvia para todas las tareas. En nuestras pruebas controladas de la API, parecía económico, pero también resultaba sensible a los ajustes de razonamiento y de salida. Varias solicitudes predeterminadas compatibles con OpenAI devolvieron un código de estado HTTP 200, al tiempo que gastaban la mayor parte de los tokens de finalización en el razonamiento y generaban una respuesta poco o nada visible. Tras cambiar a ajustes de razonamiento al estilo GLM y a un límite máximo de salida mayor, la tarea de depuración de código pasó a ser viable.
Esta guía desglosa GLM-5.3 Precio de oferta, acceso a la API, especificaciones oficiales, señales de referencia y resultados de pruebas prácticas. Si tu objetivo es comparar modelos antes de decidirte por una solución, GLBGPT es la forma más sencilla de comparar los resultados de varios modelos, mientras que la documentación y la página de precios de Z.AI siguen siendo la fuente de referencia para los detalles oficiales de la API Flash de GLM-5.3.
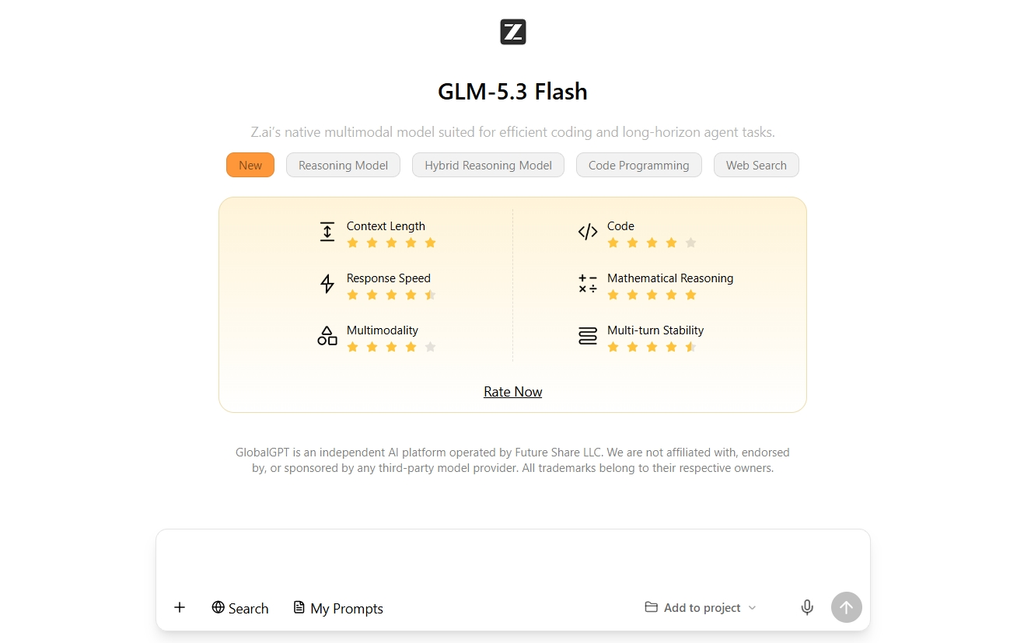
Respuesta rápida: ¿Qué es el GLM-5.3 Flash?
GLM-5.3 Flash es el modelo GLM-5 de Z.AI, que ofrece una excelente relación calidad-precio, diseñado para la codificación, las tareas de agentes, el trabajo con contextos largos y las entradas multimodales. El funcionario Documentación de GLM-5.3-Flash muestra el código del modelo de la API como glm-5.3-flash, admite una ventana de contexto de 1 millón de tokens y describe la entrada de imágenes a través de url_de_la_imagen bloques de contenido.
Lo importante es la relación calidad-precio. GLM-5.3 Flash no es simplemente una etiqueta más pequeña en la misma página del modelo. Z.AI lo describe como el primer modelo multimodal nativo de la serie GLM-5, con un total de 320 000 millones de parámetros y 18 000 millones de parámetros activados. Se basa en una arquitectura híbrida diseñada para reducir el coste de ejecución, al tiempo que mantiene el comportamiento útil en contextos largos.
Mi opinión práctica: GLM-5.3 Flash resulta especialmente interesante para tareas de codificación en las que el coste es un factor importante y para cargas de trabajo de agentes en las que es posible que se tenga que invocar el modelo muchas veces. Resulta menos convincente como modelo de escritura informal, a menos que se ajusten la ruta de la API y la configuración del razonamiento, ya que la salida visible puede quedar oculta tras el uso de tokens de razonamiento cuando el límite máximo de salida es demasiado bajo.
GLM-5.3 Precio de oferta
El funcionario Página de precios de Z.AI es la fuente más fiable de GLM-5.3 Precio de oferta. Según se ha comprobado el 27 de agosto de 2026, Z.AI ofrece el GLM-5.3-Flash con un descuento promocional 50%. Los precios con descuento son de $0,075 por cada millón de tokens de entrada y de $0,25 por cada millón de tokens de salida. Los precios de catálogo tachados son de 1 TP41T 0,15 de entrada y 1 TP41T 0,50 de salida por cada millón de tokens.
Z.AI también indica que la promoción finaliza a las 24:00 horas del 9 de septiembre de 2026, hora de Singapur (UTC+8). Esto es importante para los lectores que comparan los costes a largo plazo: el descuento de lanzamiento es real, pero no debe considerarse una referencia permanente a menos que Z.AI lo prorrogue.
| Modelo | Entrada / 1 millón de tokens | Entrada almacenada en caché | Salida / 1 millón de tokens | Nota sobre los precios |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (promocional); $0.15 (de catálogo) | $0.015 (oferta); $0.03 (precio de catálogo) | $0.25 (promocional); $0.50 (de catálogo) | Descuento en el 50% hasta el 9 de septiembre de 2026 (UTC+8) |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | Ficha del modelo insignia GLM-5.3 en la tabla de precios de Z.AI |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Fila anterior del modelo GLM sobre los precios de Z.AI |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | Incluido en la lista de modelos de texto de Z.AI |
Comparación oficial de precios de venta de Z.AI
Fuente: Página oficial de precios de Z.AI, consultada el 27 de agosto de 2026. Los precios promocionales tienen una duración limitada.
Así que sí, GLM-5.3 Flash es barato en comparación con GLM-5.3 y GLM-5.2 según los precios oficiales de los tokens. La pregunta más relevante es si sigue siendo barato una vez que se incluyen tus indicaciones, ajustes de razonamiento, llamadas a herramientas y reintentos. En nuestra sección práctica abordamos este tema.
Si quieres conocer los precios de la generación anterior, consulta nuestro artículo específico sobre Precio del GLM-5.2 Guía. Yo mantendría esa página centrada en el GLM-5.2 y dejaría que este artículo se ocupara del precio, la API y los objetivos de rendimiento del GLM-5.3 Flash.
GLM-5.3 Acceso a la API de Flash
El código oficial del modelo de la API es glm-5.3-flash. Z.AI afirma que los parámetros de texto son compatibles con GLM-5.3, admite una ventana de contexto de 1 millón de tokens y admite la entrada de imágenes a través de url_de_la_imagen bloques en el interior mensajes[].contenido[]. Esto hace que GLM-5.3 Flash sea algo más que un simple modelo de codificación basado únicamente en texto.
La nota sobre la configuración no es un detalle sin importancia. La documentación recomienda temperatura: 1, top_p: 0,95, y esfuerzo_de_razonamiento: máximo. También dicen que thinking.type admite activado, y recomiendo thinking.clear_thinking: false. En nuestras propias pruebas, este tipo de configuración resultó determinante.
| Elemento de la API | Qué utilizar | Por qué es importante |
|---|---|---|
| Código modelo | glm-5.3-flash |
Utiliza el ID exacto del modelo en lugar de adivinar el nombre de una variante. |
| Contexto | 1 millón de tokens | Resulta útil para bases de código extensas, documentos largos y la memoria de los agentes, aunque sigue siendo una opción con un coste considerable. |
| Entrada de imágenes | url_de_la_imagen bloques de contenido |
Admite flujos de trabajo de «captura de pantalla a código» y de depuración visual. |
| Pensar | thinking.type: activado |
El razonamiento no puede considerarse un pequeño detalle oculto; puede determinar el uso de los tokens. |
Para quienes no son desarrolladores, aquí es donde una plataforma multimodelo puede resultar de ayuda. Puedes utilizar GLBGPT para comparar el comportamiento de los modelos antes de dedicar tiempo a la configuración de la API de un proveedor concreto. Para conocer los parámetros oficiales de facturación de tokens y de los modelos, consulta siempre la política de precios y la documentación de Z.AI.
GLM-5.3: Pruebas de rendimiento de Flash y señales de capacidad
Las pruebas comparativas resultan útiles en este caso, pero solo si se cita la fuente. La documentación de Z.AI ofrece información oficial sobre el modelo y detalles de su arquitectura. Análisis artificial ofrece datos de pruebas comparativas de terceros. OpenRouter ofrece datos sobre el mercado de proveedores. Se trata de tres tipos distintos de datos empíricos.
Artificial Analysis presenta el GLM-5.3-Flash con un índice de inteligencia de 57, en el puesto #3 de 110 en el grupo mostrado, una ventana de contexto de 1M y 50,2 tokens de salida por segundo. También indica que la modalidad de entrada es texto e imagen, con salida de texto. Se trata de una señal de gran capacidad para un modelo con tarifa Flash, pero sigue siendo una prueba de rendimiento de terceros, no una garantía oficial de velocidad por parte de Z.AI.
Resumen de precios y prestaciones
| Modelo | Precio oficial | Señal de referencia | Contexto | Límite de la fuente |
|---|---|---|---|---|
| GLM-5.3-Flash | Promoción de $0.075 de entrada / $0.25 de salida por cada millón de tokens | Índice de inteligencia 57; 50,2 tokens de salida por segundo | 1 millón de tokens | Precio según Z.AI; referencia según Artificial Analysis |
OpenRouter resulta útil para comprobar la disponibilidad en el mercado y las tarifas específicas de cada proveedor, pero yo no incluiría esos valores en una tabla de precios oficiales. Si un proveedor de OpenRouter muestra un caudal diferente o una tarifa temporal distinta, indícalo como «datos del mercado del proveedor».
Prueba práctica de la API: indicaciones, uso de tokens y resultados
Hemos realizado una prueba controlada de la API en los cinco modelos disponibles: glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, y kimi-k3. No se trataba de una prueba de rendimiento oficial y no debe interpretarse como una clasificación global de modelos. El objetivo era más concreto y más útil para este artículo: con las mismas indicaciones, ¿ofrecía GLM-5.3 Flash resultados útiles?, ¿cómo se comportaban sus tokens de razonamiento? y ¿qué campos de coste se obtenían en la respuesta de la API?
El diseño de la prueba fue sencillo a propósito. Utilizamos una tarea de programación, una tarea de salida estructurada estricta y una tarea breve de redacción. Esa combinación es importante porque un modelo puede dar excelentes resultados en programación y, aun así, resultar problemático con JSON estricto o textos breves si la ruta agota el presupuesto de salida en razonamientos ocultos.
Cómo interpretar las tarjetas de prueba
- Pasar significa que el modelo devolvió un resultado visible que respondía a la tarea.
- Error de formato significa que el contenido era útil, pero no se trataba de un resultado estrictamente legible por máquina.
- No concluyente significa que la solicitud se ha realizado correctamente desde el punto de vista técnico, pero que la ruta probada ha devuelto una respuesta poco o nada visible.
- Campos de costes Son valores facilitados en la respuesta de esta prueba controlada de la API, no compromisos oficiales de precios por parte del proveedor.
Se utilizó la ejecución predeterminada temperatura: 0,2 y un límite máximo de salida a nivel de tarea. Cada modelo/tarea se ejecutó una sola vez, sin reintentos automáticos. A continuación, realizamos una prueba de seguimiento únicamente con GLM-5.3 Flash en las tareas de programación y redacción, con ajustes de pensamiento al estilo GLM, ya que las respuestas predeterminadas de Flash mostraban un uso intensivo de tokens de razonamiento y requerían una comprobación más justa de la configuración.
Tarea A
Depuración del código: ¿ha detectado el modelo el error en la agrupación de clientes?
Tarea: Encuentra el error en una función de TypeScript, explica por qué se produce y proporciona una implementación corregida.
Texto de la pregunta exacto
Estás revisando una función de TypeScript que debe agrupar los pedidos por ID de cliente y calcular el gasto total de cada cliente. Encuentra el error, explica por qué se produce y proporciona una implementación corregida. Código: type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const pedido of pedidos) { if (!resultado[pedido.id]) resultado[pedido.id] = { count: 0, total: 0 }; resultado[pedido.id].count += 1; resultado[pedido.id].total += pedido.total; } return resultado; }
| Modelo | Resumen de resultados | Nota sobre el token y el coste | Resultado |
|---|---|---|---|
glm-5.3-flash |
La ejecución predeterminada devolvió un código HTTP 200, pero no se mostró ninguna respuesta del asistente, ya que el razonamiento utilizó 1196 de los 1200 tokens de finalización. En la continuación de la configuración recomendada, identificó correctamente que order.id debería ser order.customerId y proporcionó una implementación corregida. |
Valor por defecto: 1348 tokens en total, campo de coste $0,0003111. Seguimiento: 2584 tokens en total, campo de coste $0,00124007598. | Pase tras la repetición |
glm-5.3 |
Se identificó el error relacionado con la clave de agrupación y se explicó por qué los ID de pedido únicos impiden la agregación a nivel de cliente. Se utilizó el código corregido idDeCliente como clave del objeto. |
1348 tokens en total, campo de coste $0,00534128. | Pasar |
glm-5.2 |
También encontré el order.id frente a idDeCliente solucionó el problema y creó una implementación corregida y funcional. |
1304 tokens en total. El coste en USD no se incluyó en el mismo campo de respuesta. | Pasar |
gpt-5.6-luna |
Ofreció la explicación más clara y concisa: el acumulador estaba indexado por ID de pedido, por lo que cada pedido constituía su propio «bucket». Devolvió el código TypeScript corregido. | 509 tokens en total. Coste en USD pendiente/no devuelto. | Pasar |
kimi-k3 |
Encontré el mismo error y ofrecí una explicación detallada, además de una implementación corregida. La respuesta era útil, pero más extensa que la de GPT. | 1423 tokens en total. Coste en USD pendiente/no devuelto. | Pasar |
Para llevar: En cuanto a la depuración del código, GLM-5.3 Flash solo funcionó correctamente tras ajustar la configuración al estilo GLM y ampliar el límite máximo de salida. GLM-5.3, GLM-5.2, GPT-5.6 Luna y Kimi K3 ofrecieron respuestas visibles y útiles ya en la primera ejecución.
Tarea B
JSON estricto: ¿el modelo seguía un formato legible por máquina?
Tarea: Devuelve únicamente JSON estricto, con claves fijas y sin formato Markdown.
Texto de la pregunta exacto
Devuelve únicamente JSON estricto. Compara los modelos insignia GLM-5.3-Flash, GLM-5.3 y de tipo GPT para un desarrollador que esté eligiendo un asistente de programación. Utiliza las claves: best_for, tradeoffs, cost_warning, recommendation. No utilices Markdown.
| Modelo | Resumen de resultados | Nota sobre el token y el coste | Resultado |
|---|---|---|---|
glm-5.3-flash |
Devolvía contenido parcial similar a JSON, pero no se trataba de un JSON estrictamente analizable sin una limpieza previa. Es apto para un lector humano, pero no para la automatización directa. | 1267 tokens en total, campo de coste $0,000305025. | Error de formato |
glm-5.3 |
No se mostró ningún contenido del asistente por debajo del límite de salida analizado, y casi todos los tokens de finalización fueron consumidos por el razonamiento. | 1267 tokens en total, campo de coste $0,00530084. | No concluyente |
glm-5.2 |
Devolvió una respuesta similar a JSON, pero estaba incompleta o no se podía analizar sin depurarla. | 1268 tokens en total. El coste en USD no se incluyó en el mismo campo de respuesta. | Error de formato |
gpt-5.6-luna |
Devuelve un JSON analizable con las claves solicitadas y sin delimitador de Markdown. | 541 tokens en total. Coste en USD pendiente/no reembolsado. | Pasar |
kimi-k3 |
Devolvía contenido similar a JSON con información útil, pero no se trataba de un JSON estrictamente analizable sin un proceso de limpieza previa. | 1339 tokens en total. Coste en USD pendiente/no devuelto. | Error de formato |
Para llevar: En cuanto a una salida estrictamente estructurada, GPT-5.6 Luna fue la que ofreció un resultado más limpio en esta pequeña prueba. Es posible que GLM-5.3 Flash funcione con controles más estrictos del formato de respuesta, pero esta solicitud predeterminada no estaba preparada para la automatización.
Tarea C
Breve nota sobre el producto: ¿el modelo generó texto utilizable?
Tarea: Escribe una nota específica y no promocional de 120 palabras en la que expliques en qué casos el GLM-5.3 Flash es mejor que un modelo insignia más pesado.
Texto de la pregunta exacto
Redacta una ficha de producto de 120 palabras en la que se explique en qué casos el GLM-5.3-Flash es una mejor opción que un modelo insignia más pesado. Sé concreto, sin caer en el tono promocional.
| Modelo | Resumen de resultados | Nota sobre el token y el coste | Resultado |
|---|---|---|---|
glm-5.3-flash |
La ejecución predeterminada no mostró ningún contenido visible después de que el razonamiento utilizara 895 de los 900 tokens de finalización. La ejecución posterior con la configuración recomendada tampoco mostró ningún contenido visible después de que el razonamiento utilizara 1798 de los 1800 tokens de finalización. | Valor por defecto: 946 tokens en total, campo de coste $0.00022845. Seguimiento: 1846 tokens en total, campo de coste $0.00045345. | No concluyente |
glm-5.3 |
No se ha devuelto ningún contenido visible por debajo del límite de salida probado. | 946 tokens en total, campo de coste $0,0040244. | No concluyente |
glm-5.2 |
No se ha devuelto ningún contenido visible en la ruta probada. | 947 tokens en total. El coste en USD no se incluyó en el mismo campo de respuesta. | No concluyente |
gpt-5.6-luna |
Se entregó una nota práctica con ejemplos concretos, como la generación de alto rendimiento, la latencia predecible, los resúmenes de asistencia, la extracción, la clasificación y el enrutamiento. Se acercaba a la extensión solicitada de 120 palabras. | 983 tokens en total. Coste en USD pendiente/no reembolsado. | Pasar |
kimi-k3 |
No se ha devuelto ningún contenido visible en la ruta probada. | 1019 tokens en total. Coste en USD pendiente/no devuelto. | No concluyente |
Para llevar: En el caso de escrituras breves en esta ruta, GLM-5.3 Flash no generó un texto visible utilizable, aunque el coste obtenido fue mínimo. No lo elegiría para escribir basándome únicamente en la tabla de precios; primero probaría la configuración exacta.
Lo que realmente revelaron las pruebas
- GLM-5.3 Flash resulta realmente interesante por su coste de programación. La tarea de codificación funcionó tras aplicar los ajustes basados en el enfoque GLM, y el coste registrado siguió siendo mínimo para la ejecución.
- La ruta predeterminada no era «plug-and-play». Varias respuestas de Flash devolvieron un código HTTP 200 tras utilizar casi la totalidad del presupuesto de finalización en tokens de razonamiento.
- El JSON estricto requiere una validación adicional. Una respuesta con aspecto de JSON no es lo mismo que un JSON que se pueda analizar, sobre todo si los datos resultantes se van a utilizar en un proceso de automatización.
- Los textos breves no son lo primero en lo que me fijaría para evaluar a Flash. En esta prueba, la pregunta de redacción no obtuvo una respuesta visible en Flash, ni siquiera tras aplicar la configuración de seguimiento.
Mi conclusión es sencilla: GLM-5.3 Flash es prometedor para la codificación en la que el coste es un factor determinante, pero no debes considerarlo una solución «plug-and-play» para todas las rutas compatibles con OpenAI. Establece un presupuesto de salida suficiente, comprueba el comportamiento de los tokens de razonamiento y prueba el tipo exacto de tarea que tienes previsto ejecutar antes de transferirle un volumen real.
Mejores casos de uso del flash GLM-5.3
GLM-5.3 Flash resulta más adecuado cuando la tarea se beneficia de entradas multimodales, un contexto extenso y numerosas llamadas repetidas. No es el modelo que elegiría solo porque la tabla de precios parezca atractiva. Lo elegiría cuando la naturaleza de la tarea se ajuste al modelo.
- Agentes de codificación con numerosas llamadas a herramientas: Un precio más bajo por token resulta útil cuando el modelo pasa por las fases de planificación, edición, pruebas y corrección.
- Trabajo de front-end a partir de capturas de pantalla: Su enfoque en la entrada de imágenes y la codificación lo convierten en una opción ideal para la depuración de interfaces de usuario y las tareas de conversión de capturas de pantalla en código.
- Revisión de código con contexto extenso: La ventana de contexto de 1M resulta útil cuando necesitas incluir más información sobre el contexto del proyecto en una sola solicitud.
- Trabajo profesional con gran volumen de documentación: Z.AI describe casos de uso relacionados con archivos de Office, análisis financiero y procesamiento de documentos profesionales.
- Experimentos con API que tienen en cuenta el presupuesto: La diferencia de precio oficial hace que el Flash sea un primer modelo adecuado para probar antes de pasar a uno más pesado.
Si sueles redactar principalmente textos breves de marketing, no des por sentado que Flash es la mejor opción por defecto solo porque sea más barato. Nuestra prueba de redacción no arrojó resultados concluyentes ni con la configuración predeterminada ni con la recomendada de Flash, ya que el contenido visible no se mostraba correctamente dentro del límite de salida elegido. Yo probaría primero con tareas de programación e ingeniería estructurada y, después, decidiría si Flash también merece un hueco en tu conjunto de herramientas de redacción.
Factores que influyen en los costes y ajustes de la API a tener en cuenta
El mayor riesgo relacionado con el coste de GLM-5.3 Flash no es el precio oficial del token. El precio oficial es bajo. El riesgo radica en la diferencia entre una solicitud barata y una respuesta útil.
- Fichas de razonamiento: En nuestras pruebas, los tokens de razonamiento consumieron la mayor parte del presupuesto de finalización en varias ejecuciones.
- Límite máximo de producción: Un límite bajo puede hacer que no se devuelva ningún contenido visible, incluso cuando la solicitud HTTP se haya realizado correctamente.
- Bucles de agente: Cada ciclo de planificación-edición-prueba puede multiplicar los tokens de contexto y de salida.
- Contexto general: 1 millón de tokens es útil, pero enviar más contexto del necesario sigue afectando al coste y a la latencia.
- Reintentos: Volver a intentar aplicar un cambio de configuración que haya fallado o no haya generado ningún resultado modifica el coste real por resultado útil.
Para las tareas de codificación, mi punto de partida sería: utilizar el código modelo oficial, seguir los parámetros de razonamiento propios del estilo GLM, dejar al modelo suficiente espacio para mostrar los resultados y registrar los tokens de razonamiento por separado de los tokens de respuesta final. Si comparas diferentes enfoques, mide el coste por tarea completada en lugar del coste por solicitud.
¿Merece la pena el GLM-5.3 Flash?
Merece la pena probar GLM-5.3 Flash si tu carga de trabajo implica un uso intensivo de código, es sensible a los costes y se basa en API. El precio oficial es atractivo, los resultados de las pruebas comparativas realizadas por terceros son muy buenos y el modelo cuenta con características útiles: entrada multimodal nativa, contexto de 1 millón y una arquitectura de la serie GLM-5 diseñada para un servicio eficiente.
Yo tendría más cuidado si tu uso principal es la redacción en general, la generación de resultados estrictamente estructurados o un flujo de trabajo en el que la generación de razonamientos invisibles suponga un problema grave. En esos casos, comprueba la ruta y los ajustes exactos antes de transferir el volumen a la memoria Flash. Un modelo puede ser barato y, aun así, requerir una configuración rigurosa.
Para aquellos lectores que deseen analizar el comportamiento de los modelos antes de elegir una pila de API, GLBGPT Te ofrece un espacio práctico para comparar los resultados de los modelos sin tener que abrir una pestaña aparte para cada proveedor. Una vez que sepas qué modelo se adapta mejor a tu tarea, te resultará más fácil evaluar la API oficial y la documentación sobre precios.
PREGUNTAS FRECUENTES
¿Qué es GLM-5.3 Flash?
GLM-5.3 Flash es un modelo de la serie GLM-5 de Z.AI con el código de modelo de la API glm-5.3-flash. Z.AI lo describe como un modelo multimodal nativo con capacidad para un contexto de 1 millón de tokens y una arquitectura eficiente en términos de costes.
¿Cuánto cuesta el GLM-5.3 Flash?
Según la información consultada el 27 de agosto de 2026, Z.AI ofrece GLM-5.3 Flash a $0,075 por cada millón de tokens de entrada y a $0,25 por cada millón de tokens de salida durante una promoción de 50%. Los precios habituales indicados son $0,15 de entrada y $0,50 de salida por cada millón de tokens.
¿GLM-5.3 Flash es gratuito?
En la página oficial de precios se indican los precios de los tokens de API de pago. También se muestra un descuento por tiempo limitado, no un modelo gratuito permanente. Es posible que algunas rutas o planes ofrezcan normas de cuota distintas, pero estas deben consultarse en la interfaz de acceso que utilices realmente.
¿Cuál es el código del modelo de la API Flash GLM-5.3?
El código oficial del modelo es glm-5.3-flash.
¿Admite GLM-5.3 Flash la importación de imágenes?
Sí. La documentación de Z.AI describe la introducción de imágenes a través de url_de_la_imagen bloques de contenido dentro de la matriz de contenido de los mensajes de chat.
¿Qué es la ventana de contexto de GLM-5.3 Flash?
La documentación de Z.AI describe la compatibilidad con una ventana de contexto de 1 millón de tokens. OpenRouter y Artificial Analysis también muestran aproximadamente 1 millón de tokens de contexto, pero se trata de páginas independientes de terceros.
¿Es GLM-5.3 Flash mejor que GLM-5.3?
No en todos los casos. El GLM-5.3 es el modelo más potente para tareas de codificación compleja y de largo plazo, mientras que el GLM-5.3 Flash es mucho más económico e incorpora posicionamiento multimodal nativo. Elige en función del tipo de tarea y tu presupuesto.
¿Es el GLM-5.3 Flash adecuado para programar?
Parece prometedor para la codificación, especialmente para la codificación en la que el coste es un factor importante. En nuestro seguimiento controlado de la API, con configuraciones basadas en el enfoque GLM y un límite máximo de tokens más amplio, corrigió correctamente un error de agrupación en TypeScript. Con límites de salida predeterminados más bajos, varias ejecuciones no fueron concluyentes porque la respuesta tenía poco o ningún contenido visible.
¿En qué se diferencia GLM-5.3 Flash de los modelos GPT?
GLM-5.3 Flash es mucho más barato que muchas rutas de codificación emblemáticas según el precio oficial de su token, pero el precio no es el único factor. En nuestra pequeña prueba con los ajustes predeterminados, GPT-5.6 Luna ofreció resultados útiles en las tres tareas, mientras que GLM-5.3 Flash necesitó una prueba adicional con los ajustes recomendados para la tarea de codificación.
¿En qué se diferencia el GLM-5.3 Flash del Kimi?
Kimi K3 superó la tarea de depuración de código en nuestra prueba, pero no superó el criterio «JSON estricto sin limpieza» y no devolvió ningún contenido visible para la tarea de redacción breve en la ruta evaluada. Esto no significa que Kimi sea peor en general; solo describe este conjunto de tareas y esta configuración.
¿Dónde puedo probar GLM-5.3 Flash?
Para acceder a la API oficial, consulta la documentación y las páginas de precios de GLM-5.3 Flash de Z.AI. Si deseas realizar una comparación más amplia de los modelos antes de tomar una decisión, puedes utilizar una plataforma multimodelo como GLBGPT para comparar los resultados de los distintos modelos en un mismo lugar.
¿Debería utilizar GLM-5.3 Flash para la producción?
Úsalo en entorno de producción solo después de haber probado tu tarea concreta, la ruta, la configuración, los límites de salida y el registro de costes. Tiene un precio atractivo, pero nuestras pruebas han demostrado que los detalles de la configuración pueden determinar si la respuesta es útil.
Conclusión final
GLM-5.3 Flash no es solo una opción secundaria y barata de GLM-5.3. Se trata de una nueva opción seria para la codificación con restricciones presupuestarias, la entrada multimodal y el trabajo con API de contexto extenso. Su precio oficial es muy atractivo y los resultados de las pruebas de rendimiento son lo suficientemente sólidos como para justificar su evaluación.
Mi principal advertencia es de carácter práctico: no lo juzgues únicamente por el código de estado HTTP 200. Comprueba el resultado visible, el uso de tokens de razonamiento y el coste por respuesta útil. Si estos aspectos te parecen adecuados para tus tareas reales, GLM-5.3 Flash podría ser uno de los modelos con mejor relación calidad-precio de la pila de programación actual.