DeepSeek V4.1 Flash es la versión de DeepSeek lanzada el 10 de septiembre de 2026, que incorpora la entrada nativa de imágenes, un menor consumo de memoria caché, puntuaciones más altas de los agentes según los datos facilitados por los proveedores y tarifas de API más bajas. Es ideal para desarrolladores que ejecutan agentes con un gran volumen de trabajo o con gran cantidad de datos de entrada. La principal salvedad: DeepSeek ha ejecutado las pruebas de rendimiento publicadas, y V4 Pro sigue liderando determinadas pruebas de razonamiento de vanguardia.

¿Qué es el firmware DeepSeek V4.1?
DeepSeek V4.1 Flash es un modelo multimodal de peso abierto diseñado para la codificación, el uso de herramientas, la comprensión visual y los flujos de trabajo de agentes con contextos extensos. DeepSeek lo lanzó el 10 de septiembre de 2026 y publica los pesos como DeepSeek-V4.1-Flash, y expone el modelo alojado a través del deepseek-flash Nombre de la API.
Esta versión es importante porque supone algo más que una simple mejora en las puntuaciones de los benchmarks. Flash admite texto e imágenes, ofrece una ventana de contexto de un millón de tokens y reduce considerablemente la memoria necesaria para su caché de clave-valor. Además, DeepSeek ha rebajado las tarifas de su API alojada en comparación con la tarifa V4 Pro anterior. Esta combinación aborda un cuello de botella práctico: mantener asequibles los agentes de ejecución prolongada cuando se acumulan las indicaciones, el contexto del repositorio, las capturas de pantalla y el historial de herramientas.
deepseek-flashEl modo «Thinking» está activado por defecto, aunque también está disponible el modo «non-thinking». Se admiten la salida en formato JSON y las llamadas a herramientas. DeepSeek también ofrece compatibilidad con las API «Responses» y «Anthropic», lo que reduce el trabajo de migración para las aplicaciones que ya están estructuradas en torno a esas interfaces.
¿Qué novedades presenta la versión 4.1 de DeepSeek Flash?
Una infraestructura central 552B MoE con capacidad de cálculo asimétrica
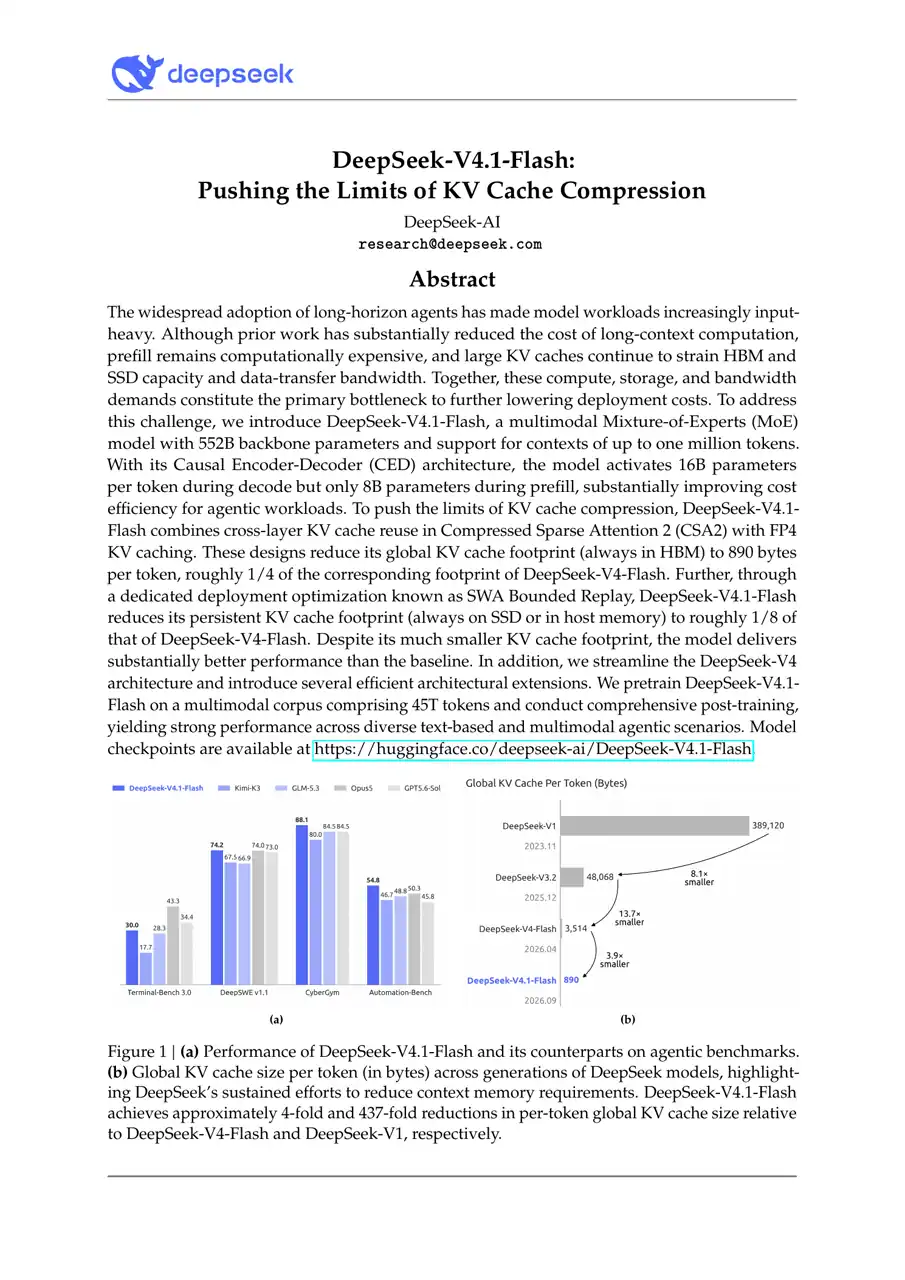
Según la Informe técnico DeepSeek V4.1, el modelo utiliza una estructura base de «mezcla de expertos» con 552 000 millones de parámetros, que incluye un codificador causal de 20 capas y un decodificador de 20 capas. El recuento total de parámetros no corresponde a la cantidad utilizada para cada token: DeepSeek registra aproximadamente 8 000 millones de parámetros activos durante el rellenado previo y 16 000 millones durante la decodificación.
Ese diseño asimétrico asigna diferentes presupuestos de computación a las fases de «prefill» y «generación». El «prefill» es la etapa en la que se procesan la indicación, los documentos, las imágenes y la conversación previa; la decodificación genera la respuesta token a token. El menor consumo de computación activa durante el «prefill» resulta especialmente relevante para las cargas de trabajo a escala de repositorio y de agentes de investigación, que dedican una gran parte de sus recursos a la lectura antes de escribir.
Una caché KV mucho más pequeña
El informe indica que el tamaño global de la caché KV es de 890 bytes por token, aproximadamente una cuarta parte de la caché de V4 Flash en memoria de gran ancho de banda. Según DeepSeek, el requisito de caché persistente es aproximadamente una octava parte del de la generación anterior. En un contexto de un millón de tokens, se trata de una característica de implementación más que de un detalle abstracto de la arquitectura: el tamaño de la caché influye en el número de sesiones prolongadas que un servidor puede mantener y en la cantidad de memoria que consume cada una de ellas.
Entrada de imágenes nativas y preentrenamiento multimodal
La versión 4.1 de Flash admite imágenes de forma nativa, en lugar de utilizar un punto final independiente de la marca Vision. DeepSeek afirma que el modelo se entrenó previamente con un corpus multimodal de 45 billones de tokens. En la práctica, esto hace que las capturas de pantalla, los gráficos, las tablas escaneadas, los estados de la interfaz y las entradas de depuración visual formen parte de la misma conversación del agente que el código y el texto.
Un contexto de 1 millón de tokens puede albergar grandes repositorios, conjuntos de documentos extensos y un historial ampliado del agente, siempre que no se supere el límite combinado de entrada y salida.
Los archivos de entrada en formato JPEG, PNG, GIF y WebP se pueden combinar con texto para la extracción de tablas, el análisis de capturas de pantalla y la respuesta visual a preguntas.
La llamada a herramientas, la salida estructurada en formato JSON y el entrenamiento orientado a agentes hacen que el modelo sea adecuado para flujos de trabajo que deben inspeccionar, tomar decisiones y cambiar de estado.
Pruebas de rendimiento de DeepSeek V4.1: lo que revelan los resultados oficiales
Los principales argumentos a favor de V4.1 Flash de DeepSeek se centran en las pruebas de rendimiento de codificación y de agentes. El proveedor evaluó el modelo de instrucciones con un esfuerzo experimental de 100, presentado públicamente como el esfuerzo máximo de razonamiento, utilizando temperatura=1,0 y top_p=0,95. Las pruebas del agente de código utilizaron entornos de prueba específicos y un contexto de un millón de tokens; las pruebas del agente visual utilizaron el código Claude con un contexto de 512 000 tokens.
| Punto de referencia | V4.1 Flash | V4 Pro | V4 Flash | Líder |
|---|---|---|---|---|
| Codeforces valoración | 3471 | 3348 | 3289 | V4.1 Flash |
| Terminal-Bench 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 resuelto | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Banco de automatización Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| GPQA Diamante Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE solo texto Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Fuente: Informe técnico DeepSeek V4.1, tabla 3. Cuanto mayor sea el valor, mejor, dentro de cada fila. Codeforces es una puntuación; los demás valores mostrados utilizan las métricas denominadas del informe, expresadas en porcentajes. No se deben comparar magnitudes entre filas.

Este patrón resulta útil, pero es más limitado que una afirmación generalizada de que se trata de un “mejor modelo”. V4.1 Flash supera a V4 Pro en las cinco filas de programación, terminales, seguridad y automatización que se muestran arriba. V4 Pro sigue por delante en GPQA Diamond y en el subconjunto de solo texto de «Humanity’s Last Exam». Los desarrolladores que comparen una lista más amplia de candidatos para programación pueden utilizar nuestro Guía sobre el mejor modelo de IA para la programación, pero la evaluación a nivel de aplicación sigue siendo más importante que una sola tabla.
El esfuerzo de razonamiento también influye en el coste y el resultado. En el informe de DeepSeek, al aumentar el esfuerzo experimental de 25 a 100, la puntuación de DeepSWE v1.1 pasó de 66,0 a 74,2 y la de Terminal-Bench 2.1, de 82,4 a 90,6, mientras que se consumían aproximadamente 2,5 veces más tokens de salida. Las ocho configuraciones de agentes del informe también produjeron resultados sustancialmente diferentes a partir del mismo punto de control, por lo que la elección del marco forma parte del sistema medido.
DeepSeek señala que la robustez ante entradas extremas no está totalmente caracterizada. El informe señala que los errores de selección de CSA2 y la reconstrucción aproximada del estado mediante atención de ventana deslizante pueden reducir la capacidad en casos límite fuera del conjunto de pruebas. También reconoce que sigue habiendo una brecha en el razonamiento de vanguardia más complejo y en las tareas de casos extremos. Estas salvedades deben tenerse en cuenta al interpretar las puntuaciones principales.
Dos tareas reproducibles para evaluar Flash V4.1
Las siguientes tareas evalúan comportamientos concretos sin presentar como evidencia una indicación no ejecutada. Utiliza la indicación exacta, conserva en tu registro la configuración del modelo y del esfuerzo, y puntúa la respuesta según los criterios indicados. Los resultados de una ejecución deben registrarse como una observación con fecha, no como un punto de referencia general.
Precios de la actualización de firmware DeepSeek V4.1
La estructura de precios de la API DeepSeek se basa en dos baremos, y todas las cifras que figuran a continuación están expresadas en dólares estadounidenses por cada millón de tokens. Los periodos de mayor demanda son De 01:00 a 04:00 UTC y de 06:00 a 10:00 UTC, de lunes a viernes. El resto del tiempo se considera fuera de horas punta. Las entradas almacenadas en caché, las entradas no almacenadas en caché y las salidas se facturan a tarifas diferentes.
Las tarifas más bajas para API alojadas
- Entrada almacenada en caché
- $0.003
- Entrada sin almacenar en caché
- $0.15
- Salida
- $0.60
Por cada millón de tokens; fuera de las franjas horarias de mayor afluencia de los días laborables.
El doble de la tarifa fuera de horas punta
- Entrada almacenada en caché
- $0.006
- Entrada sin almacenar en caché
- $0.30
- Salida
- $1.20
Por cada 1 millón de tokens; de 01:00 a 04:00 y de 06:00 a 10:00 UTC, días laborables.
A modo de ejemplo aritmético sencillo, una solicitud fuera de horas punta con 800 000 tokens de entrada no almacenados en caché y 20 000 tokens de salida costaría aproximadamente $0.132: $0,12 para la entrada más $0,012 para la salida. El mismo recuento de tokens a tarifas máximas costaría aproximadamente $0,264. Este cálculo es ilustrativo, no una factura de carga de trabajo real; las aciertos en la caché, los reintentos, los turnos de herramientas y la longitud del razonamiento modifican el total.
La entrada almacenada en caché resulta cincuenta veces más económica que la entrada sin almacenar en caché en ambos planes, lo que confiere una importancia económica a los prefijos de prompt estables y al contexto reutilizable. La tarifa pública de la API de DeepSeek es independiente del acceso y la facturación de GlobalGPT. No se deben interpretar estos precios por token como precios de suscripción o de crédito de GlobalGPT.
API, visión y límites de DeepSeek V4.1
La API directa DeepSeek utiliza deepseek-flash. Los desarrolladores pueden acceder al punto final estándar en https://api.deepseek.com, la API de respuestas en la misma base, o la base compatible con Anthropic en https://api.deepseek.com/anthropic. Las herramientas de funciones son compatibles con Responses. DeepSeek también documenta el aplicar_parche herramienta personalizada; los demás tipos de herramientas integradas de «Respuestas» se ignoran en lugar de ejecutarse.
deepseek-flashEl modo de pensamiento está activado; hay disponibles los ajustes preestablecidos de esfuerzo bajo, alto y máximo.
Elige la capa de compatibilidad que se ajuste a la aplicación existente.
Mantén el total de entradas y salidas dentro de la ventana de contexto de 1 millón de tokens.
Formatos de imágenes y normas de colocación
DeepSeek admite imágenes en formato JPEG, PNG, GIF y WebP. Una imagen incrustada puede tener un tamaño máximo de 32 MiB, mientras que una imagen en archivo puede alcanzar los 64 MiB. El límite compartido documentado permite incluir hasta 600 imágenes en una sola solicitud. Ese límite máximo no es una recomendación: los lotes grandes aumentan el tamaño de la solicitud, la latencia y la dificultad para rastrear qué imagen sirvió de base para una respuesta.
En la API de respuestas, el contenido de las imágenes debe incluirse en los mensajes de los usuarios. Las imágenes colocadas en sistema o asistente Los mensajes devuelven un código HTTP 400. La capa de compatibilidad no acepta archivos generales como elementos de entrada, por lo que las aplicaciones deben seguir los formatos de entrada de imágenes documentados, en lugar de dar por sentada una compatibilidad total con las respuestas OpenAI.
Límites de contexto, salida y concurrencia
El contexto máximo es de un millón de tokens, y la salida máxima es de 384 000 tokens. La entrada y la salida, en conjunto, deben caber en la ventana de contexto. Flash permite 2 500 conexiones simultáneas por cuenta; las solicitudes que superen ese límite de cuenta reciben un código de error HTTP 429. Por lo tanto, la planificación de la capacidad debe tener en cuenta la ocupación de las conexiones activas y el comportamiento de los reintentos.
DeepSeek V4.1 Flash frente a V4 Pro
V4.1 Flash es la opción predeterminada más práctica para agentes de codificación de gran volumen, entradas visuales y aplicaciones de contexto extenso. V4 Pro sigue siendo relevante como referencia de razonamiento durante el breve periodo de transición, pero no admite visión y presenta una concurrencia documentada menor. Nuestra versión anterior Reseña del DeepSeek V4 Pro aborda ese punto de control según sus propios criterios; sus resultados prácticos no deberían reclasificarse como pruebas de la versión 4.1.
| Factor decisivo | V4.1 Flash | V4 Pro antes del cambio de ruta |
|---|---|---|
| Mejor ajuste | Agentes, programación, entradas largas, visión | Tareas seleccionadas de razonamiento de vanguardia |
| Entrada de imágenes | Compatible | No se admite |
| Concurrencia/cuenta | 2.500 conexiones | 500 conexiones |
| Entrada no almacenada en caché fuera de las horas punta | $0,15 / 1M | $0,66 / 1M |
| Producción fuera de las horas punta | $0,60 / 1M | $1,98 / 1M |
| Modelo oficial de puntuación | Clientes potenciales mostrados por agente/filas de codificación | Leads GPQA Diamond y HLE (solo texto) |
Los precios corresponden a las tarifas API de DeepSeek, no a los precios de GlobalGPT. Se aplican las tarifas «Pro» antes del cambio de ruta anunciado para el 14 de septiembre.
En las tarifas fuera de horas punta, la entrada sin caché de Flash resulta aproximadamente un 77% más barata que la tarifa Pro indicada, y la salida de Flash resulta aproximadamente un 70% más barata. Estos porcentajes se calculan a partir de la tarifa oficial, no son ahorros medidos. El ahorro real depende de la reutilización de la caché, la longitud de la salida, los reintentos y de si la carga de trabajo requiere los resultados más sólidos de Pro en las filas de razonamiento seleccionadas.
La distinción más urgente es de carácter operativo. DeepSeek mantiene el deepseek-v4-pro nombre, al tiempo que se modifica temporalmente el modelo subyacente. Un nombre de API estable no garantiza un comportamiento estable en los resultados. Conserva las respuestas representativas de V4 Pro, los registros de las herramientas, la latencia y los casos de fallo anteriores al 14 de septiembre; a continuación, ejecuta el mismo conjunto de pruebas de aceptación tras los cambios de enrutamiento. Para obtener información sobre el marco de comparación de puntos de control anterior, consulta DeepSeek V4 Pro frente a Flash.
Lo que dicen los desarrolladores
Las primeras reacciones son positivas en cuanto al rendimiento, la eficiencia de la caché y las puntuaciones de los agentes, pero los datos son dispares. Algunos comentarios se refieren a un punto de referencia preliminar en lugar de al punto de control definitivo de producción, y algunos informes resumen demostraciones en lugar de pruebas controladas. Por lo tanto, el debate público más útil gira en torno a dónde realizar las pruebas, y no a si una cifra del día del lanzamiento zanja la decisión.
Su análisis de lanzamiento recomienda mantener una configuración de referencia V4 Pro y probar el modelo Flash ya publicado antes del cambio de enrutamiento del 14 de septiembre. Asimismo, destaca que las mejoras varían en función de la prueba de rendimiento, el marco de trabajo y la configuración del esfuerzo.
Lee el análisisAl resumir las demostraciones previas de «World of AI», la publicación destacó una velocidad máxima observada de 427 tokens por segundo y señaló un exceso de reflexión, así como un comportamiento más débil en la simulación física. Esto no constituye una garantía oficial de velocidad.
Lee el artículo de avanceEn el hilo de presentación, el autor del comentario se opuso a que los flujos de trabajo Pro validados se redirigieran de forma silenciosa a otro modelo y abogó por establecer un plazo de obsolescencia definido. Se trata de una opinión concreta de la comunidad, no de un consenso.
Abrir el comentarioEl responsable de pruebas de penetración con IA de Aikido informó de mejoras en la recuperación en una sola ejecución, la recuperación «pass@3», la precisión y la tasa de aciertos en caché en una prueba de rendimiento de ciberseguridad. En su publicación se menciona un punto final de vista previa que está a punto de caducar, por lo que no sirve como prueba para el punto de control final.
Ver el informe preliminarEstas reacciones apuntan a tres comprobaciones que conviene realizar en cualquier implementación real: comparar la calidad de la salida con un nivel de esfuerzo fijo, observar si un razonamiento prolongado aumenta el coste de la salida y volver a ejecutar los casos de regresión cuando un alias modifica el modelo subyacente a un punto final. Los resultados preliminares sobre rendimiento y seguridad pueden orientar el diseño de las pruebas, pero no deben combinarse con la Tabla 3 de DeepSeek como si procedieran de una prueba de rendimiento controlada.
Cómo acceder al firmware DeepSeek V4.1
Existen tres vías de acceso distintas. Elige en función de si necesitas control directo de la API, pesos autohospedados o un espacio de trabajo en el navegador que facilite el cambio de modelos. Las condiciones, los precios y la responsabilidad operativa varían según la vía elegida.
API DeepSeek
Utiliza la página web oficial deepseek-flash modelo para integraciones nativas, de «Responses» o compatibles con Anthropic.
Categorías de peso abiertas
Descarga la ficha del modelo y los pesos con licencia MIT. Comprueba la compatibilidad con Serving Stack y los requisitos de infraestructura antes de comprometerte.
Abrir el repositorio de modelosGlobalGPT
Utiliza la entrada dedicada de V4.1 Flash dentro de un espacio de trabajo multimodelo. La facturación de GlobalGPT es independiente de la tarifa de la API de DeepSeek.
Prueba DeepSeek V4.1 Flash
La API directa es la opción más clara cuando se necesitan controles programáticos, contabilidad de uso y acceso a las interfaces documentadas de DeepSeek. Los pesos abiertos están destinados a equipos capaces de validar la compatibilidad con la inferencia y de manejar un modelo MoE de gran tamaño. GlobalGPT es la vía más sencilla para el uso interactivo y las comparaciones dentro de un flujo de trabajo con un modelo de IA «todo en uno».
En la publicación oficial sobre el lanzamiento de DeepSeek se indica que la empresa colaborará con la comunidad de código abierto en el soporte para la inferencia y explorará más opciones de implementación. Hay que tomarlo como una declaración de planes de futuro, no como una prueba de que todas las pilas de servidores locales ya sean compatibles con V4.1 Flash de forma eficiente.
¿Quién debería utilizar el firmware DeepSeek V4.1?
Da prioridad a V4.1 Flash cuando predominen las tareas en la terminal, la navegación por el repositorio, la automatización, el uso de herramientas y las indicaciones largas. Las puntuaciones oficiales del agente y las menores tasas de entrada justifican una prueba piloto específica para esta carga de trabajo.
La importación de imágenes en formato nativo convierte a Flash en la opción más práctica frente a V4 Pro para capturas de pantalla, gráficos, tablas y pruebas de interfaz. Comprueba la precisión de la extracción comparándola con las respuestas correctas.
V4 Pro encabeza las filas de solo texto «GPQA Diamond» y «HLE» que se muestran. Compara las indicaciones fijas y los ajustes de esfuerzo antes de sustituir un flujo de trabajo de razonamiento validado.
La licencia MIT es permisiva, pero una infraestructura central 552B MoE no es un modelo local ligero. Comprueba el hardware, la estrategia de caché, la cuantificación y la compatibilidad con el servicio.
Para ampliar la selección de modelos, el Comparación entre GPT-5.5 y DeepSeek V4 compara el contexto de un millón de tokens y la posición de precio con otra opción de vanguardia. Los equipos centrados en el estilo de generación de código también pueden consultar el Prueba de código en Python: DeepSeek frente a ChatGPT. Esos artículos responden a preguntas relacionadas; ninguno de ellos sustituye a la comprobación del punto final exacto de Flash V4.1 que se utiliza en producción.
Los usuarios en general que estén dudando entre distintos ecosistemas pueden encontrar que el más amplio Comparación entre DeepSeek y ChatGPT más útil que una revisión a nivel de arquitectura. Flash V4.1 resulta más atractivo cuando sus ventajas específicas —entrada larga, comprensión de imágenes, herramientas y bajo coste por token— se adaptan a un flujo de trabajo real.
Veredicto
Sus tarifas de API más bajas, su contexto de 1 millón, la entrada nativa de imágenes, el límite de 2.500 conexiones y las mejoras en el rendimiento de los agentes señaladas por DeepSeek constituyen argumentos de peso para su evaluación. No es un sustituto universal del Pro: el V4 Pro sigue liderando determinadas líneas de razonamiento, las puntuaciones de esfuerzo máximo conllevan un mayor uso de tokens de salida y los cambios en el enrutamiento de los puntos finales pueden alterar el comportamiento validado.
Instalar la memoria flash DeepSeek V4.1 en el GlobalGPTEmpieza con un conjunto de pruebas de aceptación reducido: una tarea representativa de codificación, una tarea de extracción basada en imágenes, un caso de contexto extenso y un flujo de trabajo con herramientas. Establece los parámetros de razonamiento, registra el recorrido del modelo y compara los modos de fallo, así como la calidad media. De este modo, obtendrás una decisión que podrás defender sin considerar las pruebas de rendimiento de los proveedores ni las reacciones del día del lanzamiento como una garantía del rendimiento de la aplicación.
Preguntas frecuentes
¿Qué es el firmware DeepSeek V4.1?
DeepSeek V4.1 Flash es un modelo multimodal de «mezcla de expertos» con pesos abiertos, lanzado el 10 de septiembre de 2026. Admite entradas de texto e imágenes, salidas de texto, una ventana de contexto de un millón de tokens, modos de «reflexión» y «sin reflexión», salida en formato JSON y llamadas a herramientas.
¿Cuánto cuesta la API Flash DeepSeek V4.1?
Las tarifas de la API DeepSeek en horas valle son de $0,003 por cada millón de tokens de entrada almacenados en caché, $0,15 por cada millón de tokens de entrada no almacenados en caché y $0,60 por cada millón de tokens de salida. Las tarifas en horas punta son de $0,006, $0,30 y $1,20, respectivamente. Se trata de precios de la API DeepSeek, no de la GlobalGPT.
¿Qué nombre de modelo de API debo utilizar para la memoria Flash DeepSeek V4.1?
Utilice deepseek-flash con la API oficial de DeepSeek. DeepSeek también admite llamadas a la API de respuestas en https://api.deepseek.com y llamadas compatibles con Anthropic en https://api.deepseek.com/anthropic.
¿Cuáles son los límites de contexto, de salida y de concurrencia?
DeepSeek V4.1 Flash tiene una ventana de contexto de un millón de tokens y una salida máxima de 384 000 tokens; la entrada y la salida deben caber dentro del contexto. DeepSeek admite 2 500 conexiones simultáneas por cuenta; si se supera este límite, se devuelve el código de error HTTP 429.
¿Es mejor el flash DeepSeek V4.1 que el V4 Pro?
Depende de la tarea. En la tabla elaborada por el proveedor de DeepSeek, V4.1 Flash supera a V4 Pro en los parámetros de referencia mostrados en cuanto a codificación, terminal, seguridad y automatización, mientras que V4 Pro supera a GPQA Diamond y a HLE (solo texto). Además, Flash es más económico, es compatible con la visión artificial y permite un mayor número de conexiones simultáneas.
¿Es compatible la versión DeepSeek V4.1 de Flash con imágenes?
Sí. Acepta archivos de entrada en formato JPEG, PNG, GIF y WebP, y genera texto. DeepSeek admite hasta 32 MiB para imágenes incrustadas, 64 MiB para imágenes en archivo y 600 imágenes por solicitud, dentro de los límites compartidos. Las imágenes de la API de respuestas deben incluirse en los mensajes de los usuarios.
¿Se pueden descargar los pesos Flash de DeepSeek V4.1?
Sí. DeepSeek publica los pesos del modelo DeepSeek-V4.1-Flash en Hugging Face bajo la licencia MIT. Esta licencia permisiva no elimina el requisito de infraestructura: los equipos siguen necesitando un software de servicio compatible y hardware suficiente para la red troncal MoE de 552 mil millones.
¿Puedo utilizar la versión 4.1 del firmware DeepSeek en el GlobalGPT?
Sí. GlobalGPT cuenta con una entrada Flash específica para DeepSeek V4.1 destinada al uso a través del navegador. Su acceso y facturación son independientes de la tarifa de la API directa de DeepSeek, y la disponibilidad de la plataforma no verifica de forma independiente los resultados de las pruebas de rendimiento publicados por DeepSeek.