Kurze Antwort: Investieren Sie in KI, die die Arbeit, die Sie jede Woche wiederholen, zuverlässig verbessert. Forschung im Stil von Perplexity ist ihr Geld wert, wenn die Quellen eine Rolle spielen. Ein leistungsfähiges allgemeines Modell ist sein Geld wert, wenn Sie den ganzen Tag lang Strategien, Analysen und Texte überarbeiten. Ein Programmiermodell ist sein Geld wert, wenn es sich in den Zyklus aus Bearbeiten, Testen und Überprüfen einfügt. Bild- und Videomodelle sind ihr Geld wert, wenn ihre Ergebnisse Produktionszeit einsparen.
Dieser Leitfaden vereint offizielle Produktangaben, eine namentlich genannte Beobachtung durch unabhängige Entwicklermedien sowie kleine praktische Vergleiche, die am 1. September 2026 durchgeführt wurden. Die Tests sind bewusst eng gefasst: jeweils eine gemeinsame Eingabeaufforderung und eine Ausgabe pro Modell. Dadurch werden zwar nützliche Unterschiede im Arbeitsablauf aufgezeigt, aber sie nicht eine allgemeine Rangfolge nachweisen. Offenlegung: GlobalGPT betreibt diese Publikation.
Kaufen Sie Literaturangaben und aktuelle Quellen.
Kaufen Sie Überarbeitungen, die Sie anfechten können.
Kaufen Sie Feedback in Ihrer aktuellen Schleife.
Kaufen Sie Leistungen, die die Produktion ersetzen.

Wofür Sie beim Kauf von KI tatsächlich bezahlen
Der kostenlose Zugang reicht für gelegentliche Arbeiten aus. Ein kostenpflichtiger Tarif bringt Geld ein, wenn er die Betriebskosten Vorteile: weniger Browser-Tabs, weniger manuelle Erstentwürfe, eine schnellere Feedbackschleife, besserer Zugriff auf aktuelle Informationen oder ein Ergebnis, das bereits näher an der endgültigen Qualitätsvorgabe liegt. Der teure Fehler besteht darin, für den Zugang zu bezahlen und den Dienst dann wie ein neuartiges Suchfeld zu nutzen.
Wie man entscheidet, für welche KI es sich lohnt, Geld auszugeben
Die falsche Frage lautet: “Welches Modell ist das intelligenteste?” Die sinnvolle Frage lautet: “Welches Abonnement beseitigt meinen wiederkehrenden Engpass mit dem geringsten Prüfungsaufwand?” Ein Gründer, der fundierte Wettbewerbsanalysen benötigt, hat andere Kaufkriterien als ein Entwickler, der ein Repository debuggt, oder ein Marketingmitarbeiter, der wöchentliche Produktinhalte erstellt. Beginnen Sie damit, Ihre drei sich wiederholenden Aufgaben aufzulisten, und prüfen Sie dann jede Option anhand desselben realistischen Anforderungsprofils.
Es löst mindestens einmal pro Woche eine Aufgabe.
Man kann ein besseres Ergebnis von einem schlechteren unterscheiden.
Die eingesparte Zeit übersteigt die Zeit für das Umschalten und die Überprüfung.
Studie: Lohnt es sich, für Perplexity zu bezahlen?
Bei Fragen zum aktuellen Marktgeschehen sollten Sie Recherchekapazitäten vor ansprechender Formulierung priorisieren. Perplexity ist ein Service, bei dem die Recherche an erster Stelle steht: Sein Wert liegt in einer nachvollziehbaren Antwort mit Quellen, die Sie überprüfen können, und nicht in einer selbstbewussten Zusammenfassung ohne Quellenangaben. Das macht ihn zu einer glaubwürdigen kostenpflichtigen Wahl für Analysten, Einkäufer, Autoren und Teams, die quellengestützte Berichte erstellen. Vergleichen Sie seine Rolle mit der von Gemini in diesem Funktionsvergleich zwischen Gemini und Perplexity, und nutze diese Liste von Alternativen zur Perplexität wenn Sie einen anderen Forschungsablauf benötigen.
Kaufen Sie kein Recherchetool, nur um E-Mails zu schreiben oder Notizen zusammenzufassen, die Sie ohnehin schon auf Ihrem Laptop haben. Der Nutzen steigt erst mit den Kosten, die durch eine veraltete oder unbegründete Behauptung entstehen. Nutzen Sie die Recherche in der Praxis dazu, Quellen zu sammeln und zu überprüfen, und übergeben Sie die Belege anschließend an ein Schlussfolgermodell, das daraus ein Entscheidungsmemorandum erstellt. Durch diese Aufteilung lassen sich Fehler leichter erkennen.
GPT, Claude und Gemini: Was der Strategietest tatsächlich gezeigt hat
Wir haben GPT-5.6 Sol, Claude Sonnet 5 und Gemini 3.6 Flash dieselbe Aufgabe mit festen Rahmenbedingungen gestellt: die Einführung einer B2B-Analysefunktion innerhalb von sechs Wochen mit zwei Entwicklern, einem festen Budget, einer Vertriebsanforderung für SSO und einem mangelhaften Onboarding. Jede Antwort musste Annahmen aufzeigen, einen Sechs-Wochen-Plan erstellen, versteckte Risiken benennen und einen Bericht für die Geschäftsleitung verfassen. Es handelte sich um eine einmalige Arbeitsprobe, nicht um einen Benchmark.
“Definieren Sie den kleinsten nutzbaren Analyse-Workflow” und entscheiden Sie, ob SSO im Umfang enthalten ist, nur im Pilotprojekt zum Einsatz kommt oder zurückgestellt wird, bevor Sie das Team einbinden.
“Man kann nicht gleichzeitig eine neue Analysefunktion entwickeln, ein noch nicht identifiziertes Onboarding-Problem beheben und ein unternehmensweites SSO in voller Qualität einrichten.”
Teilen Sie die beiden Entwickler auf: einen für die Stabilisierung des Onboardings und einen für die Analytik-Datenbasis, und integrieren Sie sie dann in den folgenden Wochen.
Es wurde eine umfassende Liste von Annahmen erstellt, die Compliance-Anforderungen, Einführungskriterien und Erfolgskennzahlen umfasste. Leistungskennzahlen wurden dabei nicht neu entwickelt.
Hat den deutlichsten Kompromiss hinsichtlich der Kapazitäten getroffen: Man sollte benutzerdefiniertes SSO, Analysen und noch nicht geklärte Onboarding-Fragen nicht in einen Launch mit nur zwei Entwicklern zwängen.
Lieferte zwar die übersichtlichste Aufschlüsselung der Entwicklerarbeit nach Wochen, ging dabei jedoch von vorgefertigten Dashboards und einer Datenisolierung aus, die in der Aufgabenstellung nicht vorgesehen waren.
Kaufempfehlung: GPT ist eine gute erste Wahl, wenn Sie Wert auf umfassende Annahmenprüfungen legen; Claude, wenn es auf ein präzises redaktionelles Urteilsvermögen ankommt; Gemini, wenn strukturierte Umsetzungspläne wichtig sind. Überprüfen Sie Ihre eigenen Briefings noch einmal, bevor Sie sich festlegen. Informationen zum GPT-Zugang und zum Plan-Kontext finden Sie unter GPT-5.6-Preisliste und die Modellvergleich GPT-5.6.
Die offiziellen Produktseiten sind nach wie vor die beste Anlaufstelle, um aktuelle Informationen zu Tarifen und Funktionen zu erhalten: ChatGPT, Claude, und Zwillinge. Auf den Produktseiten wird erläutert, was die einzelnen Anbieter derzeit anbieten; der obige Test erfasst lediglich, wie diese drei Programme mit dieser speziellen, eingeschränkten Eingabeumgebung zurechtkamen.
Wie sich die wichtigsten Modellfamilien für verschiedene Arten von Arbeit eignen
Der beste erste Ansatz für Personen, die zwischen Analyse, Entwurf, Datenauswertung, Planung und Problemlösung hin- und herwechseln. Prüfen Sie, ob dadurch Annahmen sichtbar werden und sich der Ansatz nach einer direkten Kritik verbessert.
Achten Sie auf: ausgefeilte Antworten, deren Quellenangaben überprüft oder deren Fachgebiet überprüft werden müssen.
Dies ist oft besonders gut geeignet, wenn es um Argumente, Kurzdarstellungen, Überarbeitungen, Richtlinien oder redaktionelle Entscheidungen geht, bei denen Nuancen und klare Abwägungen wichtiger sind als eine möglichst umfangreiche Aufgabenliste.
Achten Sie auf: eloquente Prosa als sachliche Recherche zu betrachten, ohne die Quellen zu überprüfen.
Eine sinnvolle Lösung für alle, die Pläne, Tabellen und eine Aufgabenaufteilung benötigen – insbesondere, wenn die Arbeit ohnehin bereits auf Google-Diensten basiert. Testen Sie, wie das System mit fehlenden Informationen umgeht, anstatt von bestimmten Implementierungsdetails auszugehen.
Achten Sie auf: ein klarer Plan, der auf unbestätigten Annahmen beruht.
Ein Vergleich lohnt sich in Bezug auf technische Arbeit, Programmierung, zweisprachige Nutzung und wertorientierte Experimente. Der richtige Weg hängt von Ihrer Sprache, Ihrer Benutzeroberfläche und davon ab, ob die Antwort Ihre Testsuite bestehen kann.
Achten Sie auf: Man spart zwar Abonnementkosten, verliert aber Zeit durch zusätzliche Überprüfungen oder eine schlechte Eignung des Tools.
Zahlen Sie, sobald die Aufgabe mit einer aktuellen, mit Quellenangaben versehenen Antwort beginnt. Ihr Vorteil besteht nicht darin, dass sie das eigene Nachdenken ersetzen, sondern darin, dass sie die Sammlung von Belegen und die Überprüfung von Quellen beschleunigen.
Achten Sie auf: ein Zitat übernehmen, ohne die zugrunde liegende Quelle zu öffnen.
Spezialisten lohnen sich erst dann, wenn wiederkehrende Aufgabenstellungen, Markenvorgaben und ein Überarbeitungsprozess vorhanden sind. Ihr erstes Ergebnis ist in der Regel eine Orientierungshilfe und kein zur Freigabe bereitendes Kreativkonzept.
Achten Sie auf: die Kosten für ein Modell zu tragen, wenn einmalige Projekte die Kosten für die Iteration nicht rechtfertigen.
Für technische Arbeiten gilt eine ähnliche Regel. Führen Sie vor einer großen autonomen Aufgabe eine kleine, repräsentative Aufgabe durch: Fordern Sie eine Diagnose, eine minimale Änderung, einen Testplan und die noch ungelösten Risiken an. Ein starkes Modellverhalten bedeutet nicht nur, Code zu generieren, sondern auch aufzudecken, wo noch Produktrichtlinien oder der Repository-Kontext erforderlich sind. Deshalb ist die Testbericht zum DeepSeek V4 Pro und Überprüfung des GLM-Kodierungsplans sind eher als weiterführende Lektüre zu empfehlen als eine einzige pauschale Behauptung wie “die beste Programmier-KI”.
Programmierung: Bezahlen Sie für das Modell, das den Überprüfungszyklus verbessert
Beim Programmieren ist die Schnittstelle fast genauso wichtig wie das Modell. Wir haben GPT-5.6 Sol und DeepSeek V4 Pro gebeten, einen JavaScript-Code zu analysieren und minimal zu korrigieren. Gesamtzahl (Artikel) Funktion mit eindeutigen Fehlermeldungen bei fehlenden, ungültigen oder nicht-positiven Preisen und Mengen, drei Prüfungen und einem Risikohinweis. GPT-5.6 Sol lieferte eine kompakte Implementierung unter Verwendung von Number.isFinite, indizierte Fehlermeldungen, Node-Assertions und einen sinnvollen Hinweis zu Bruchzahlen. DeepSeek V4 Pro hat den NaN trap, korrigierte seine eigene, anfangs schwächere Verteidigung, um Number.isFinite, und wies zudem auf die fehlende Array-Validierung hin.
GPT-5.6 Sol: Validierungskorrektur mit lauffähigen Tests
Aufgabe für die Gruppenarbeit
Zurückgegebene Implementierung
Beobachtet bei GlobalGPT: Die Ausgabe behielt Bruchzahlen ausdrücklich bei, was weiterhin eine politische Entscheidung ist. Testen Sie dies in Ihrem eigenen Repository, bevor Sie die Version veröffentlichen.
Das macht noch keinen zum universellen Sieger im Bereich der Programmierung. Es deutet darauf hin, dass ein guter, bezahlter Programmierassistent die Validierungsgrenzen erläutern, lauffähige Tests bereitstellen und die verbleibenden Richtlinienentscheidungen aufzeigen sollte, anstatt sie zu verschleiern. Lesen Sie den Testbericht zum DeepSeek V4 Pro und Überprüfung des GLM-Kodierungsplans für streckenspezifische Zusammenhänge. Kimi Code’s offizielle Programmier-Seite ist ein weiterer Arbeitsablauf, der in Betracht gezogen werden sollte, wenn die Nutzung der Befehlszeile im Mittelpunkt steht.
Wie Entwickler eine kostenpflichtige KI zum Programmieren bewerten sollten
Beurteilen Sie eine programmierende KI nicht anhand einer “Greenfield”-Aufgabe wie „Entwickeln Sie eine To-Do-App“. Verwenden Sie eine klar abgegrenzte Aufgabe aus einem Repository, das Sie kennen: einen fehlgeschlagenen Test, einen spezifischen Fehler, eine unvollständige Validierungsregel oder eine Aktualisierung der Dokumentation, die mit echtem Code verknüpft ist. Bitten Sie den Assistenten, das Verhalten, das seiner Meinung nach erforderlich ist, noch einmal zu formulieren, bevor er Änderungen vornimmt. So lässt sich erkennen, ob er die Aufgabe sorgfältig gelesen hat oder lediglich eine ihm vertraute Vorlage anwendet.
Prüfen Sie als Nächstes vier Punkte. Erstens: Wird zwischen einem Symptom und der eigentlichen Ursache unterschieden? Zweitens: Wird der kleinste sinnvolle Patch vorgeschlagen, anstatt nicht betroffene Module zu überarbeiten? Drittens: Erzeugt der Code Tests, die bei dem ursprünglichen Fehler fehlschlagen und bei der Korrektur erfolgreich sind? Viertens: Werden darin die noch nicht getroffenen Produktentscheidungen dargelegt, wie beispielsweise Rundung, Autorisierung, Abwärtskompatibilität oder Richtlinien für Fehlermeldungen? Diese Fragen sind aussagekräftiger als eine allgemeine Bewertung nach dem Motto “Kann der Code funktionieren?”, da sie sich direkt auf die Dauer der Codeüberprüfung auswirken.
Die Darstellungsform verändert die wirtschaftlichen Rahmenbedingungen. Ein Chat-Fenster eignet sich gut für Diagnosen, Code-Erläuterungen und kleine Codeausschnitte. Ein Editor, eine Befehlszeilenschnittstelle (CLI) oder ein MCP-verbundener Workflow gewinnt an Bedeutung, wenn Kontextinformationen sicher zwischen Dateien, Befehlen und Tests ausgetauscht werden müssen. Ein tieferer Zugriff erhöht jedoch auch die Anforderungen an die Überprüfung: Schalten Sie niemals normale Tests, Berechtigungen oder Code-Reviews aus, nur weil ein Assistent die richtigen Begriffe verwendet hat. Für viele Teams ist die beste Lösung ein Modell, das Entwürfe erstellt und gut erklärt, ergänzt durch die bestehenden technischen Kontrollmechanismen, die darüber entscheiden, ob eine Änderung veröffentlicht wird.
GPT Image 2 vs. Nano Banana 2: Ein Test mit Produktbildern
Wir haben für beide Modelle denselben Auftrag verwendet: “Schlichter E-Commerce-Hero für eine wiederverwendbare Edelstahlflasche in mattem Marineblau, helles Gestein, Tageslicht, dezente Kondenswasserbildung, kein Text und keine Logos.” GPT Image 2 behielt die marineblaue Flasche, die Anforderung „ohne Logo“ und die Kondenswasserbildung bei, tendierte jedoch eher zu einem Hintergrund im Outdoor- oder Meeres-Lifestyle-Stil als zu einer klaren Katalogszene. Nano Banana 2 behielt ebenfalls die marineblaue Flasche und die Anforderung „ohne Logo“ bei, wählte jedoch eine eher für Produktfotos im Innenbereich typische Bildkomposition; allerdings lieferte keines der beiden Ergebnisse die gewünschte blasse Steinoberfläche.
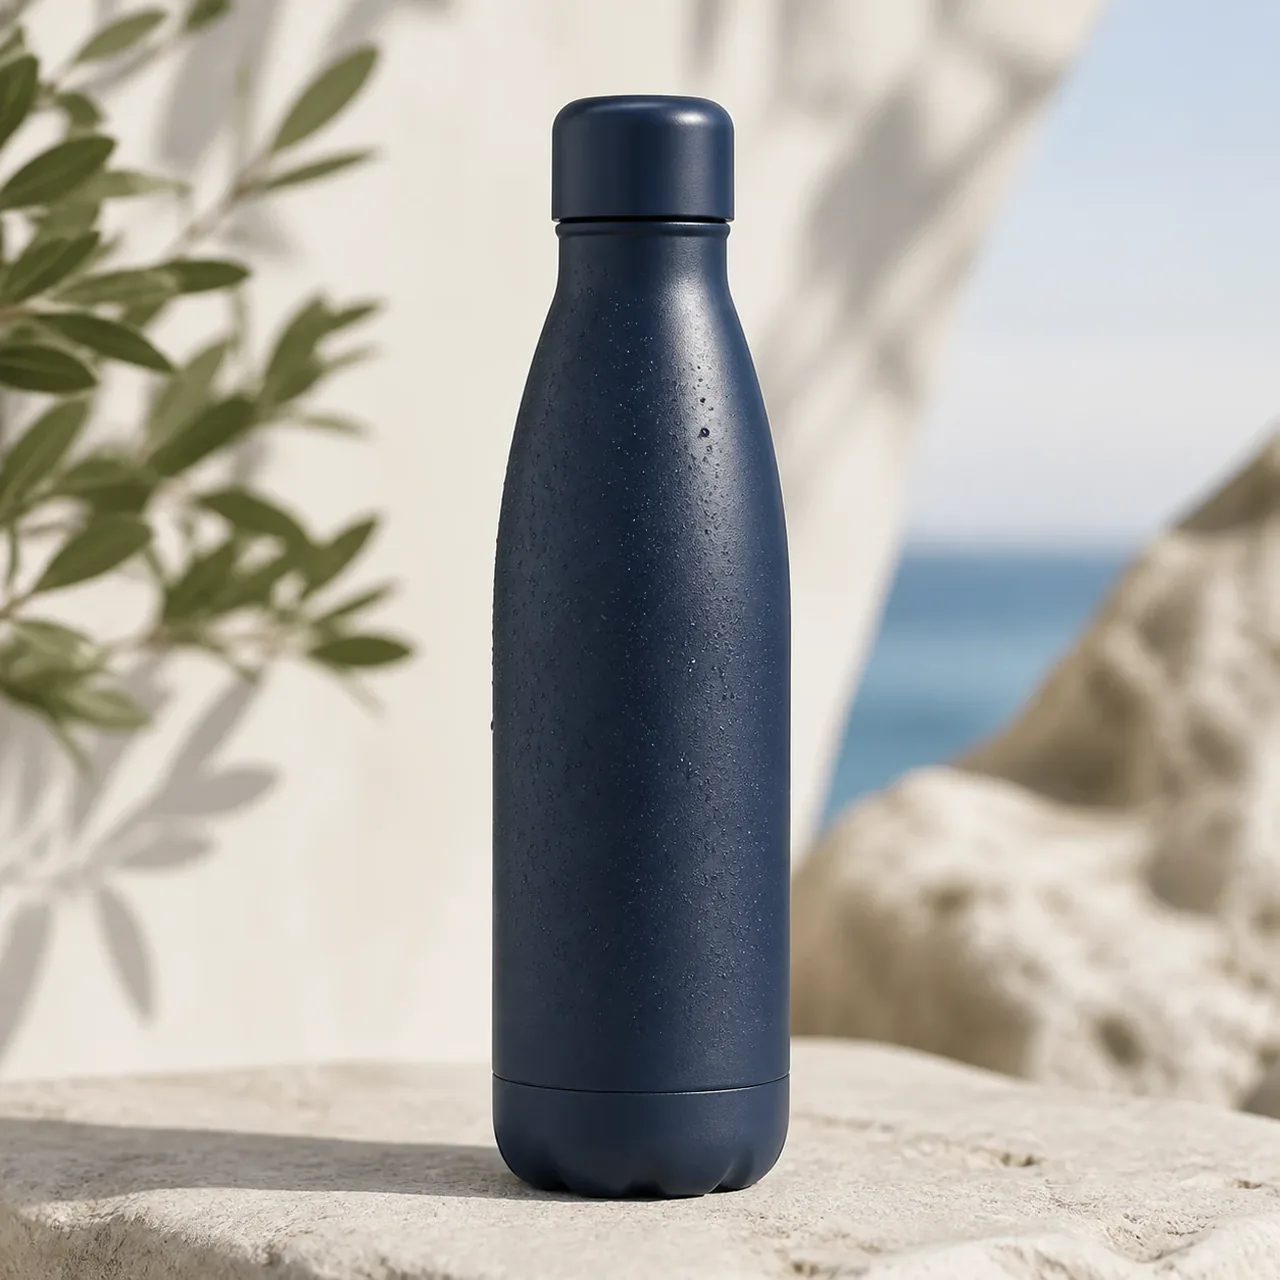
Bessere Darstellung der Kondensationsdetails; die Szene wirkte eher wie aus dem Alltag als aus einem Katalog.
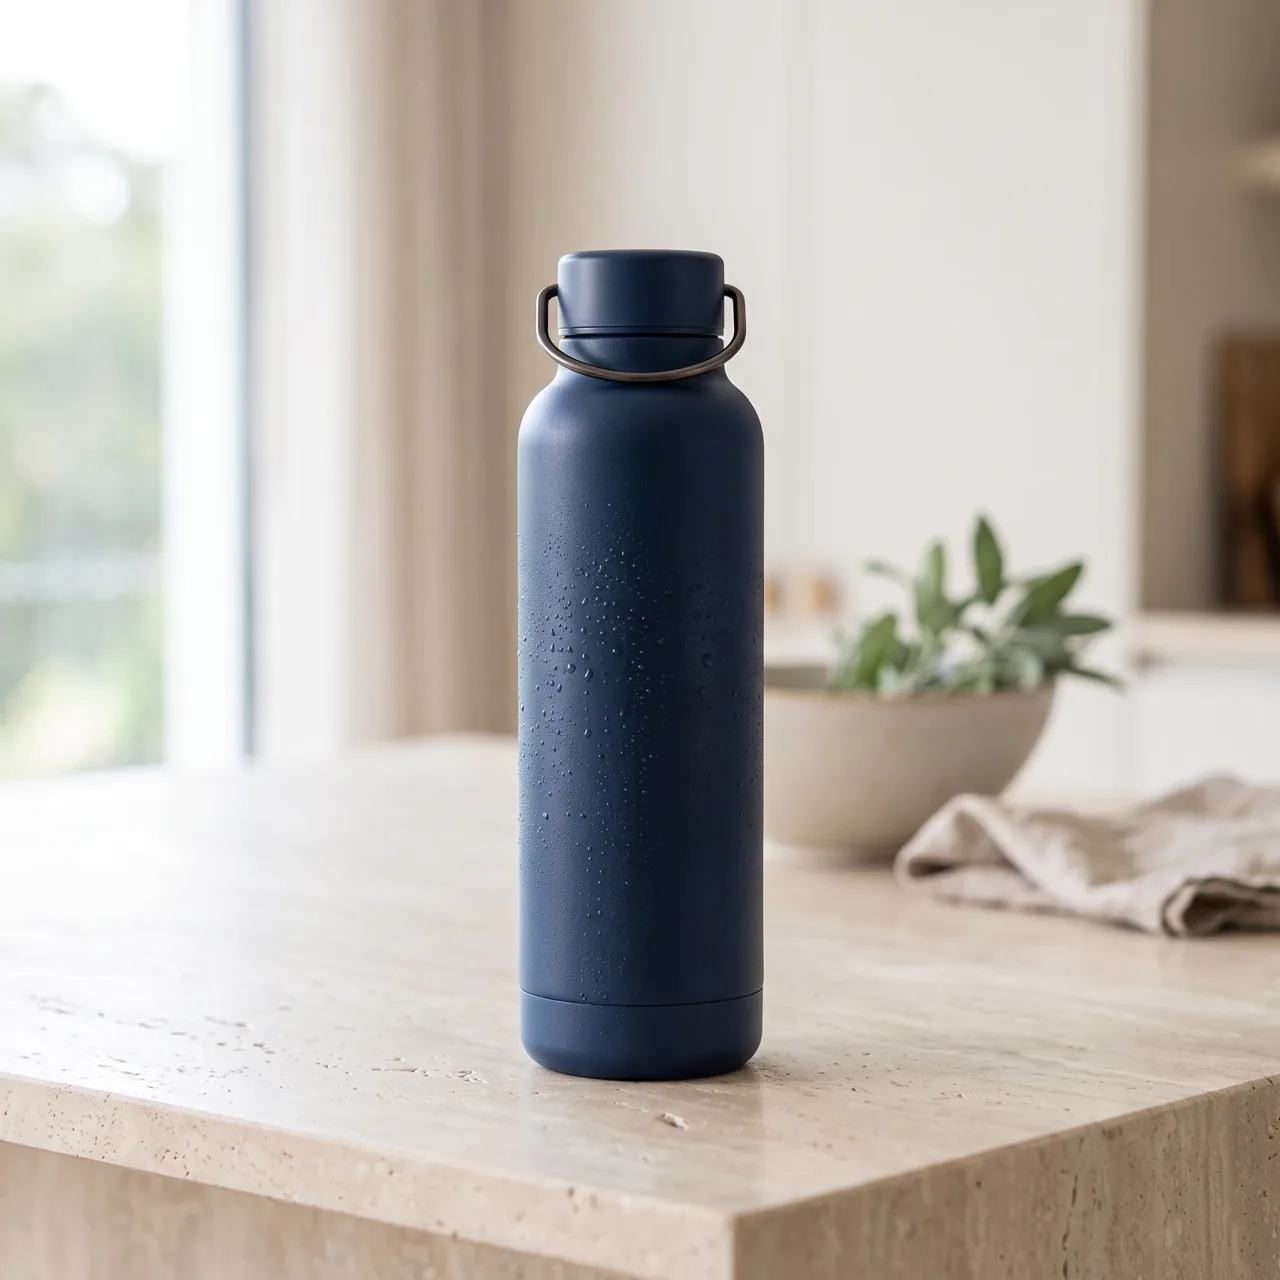
Noch mehr Produktfotos; die Anweisung mit dem hellen Stein habe ich immer noch übersehen.
Die praktische Erkenntnis lautet: Entscheiden Sie sich für das Bildmodell, dessen Fehler Sie schnell beheben können. Bei dieser einzelnen Eingabe war keine der beiden Ausgaben ohne Überarbeitung veröffentlichungsreif. Testen Sie Ihre eigenen Markenfarben, Texte, Referenzbilder und Bearbeitungsanweisungen, bevor Sie sich für ein Abonnement entscheiden.
Was Sie prüfen sollten, bevor Sie ein Bildmodell bezahlen
Die kreative Bewertung sollte über die einfache Frage hinausgehen, ob das Bild für sich genommen gut aussieht. Ein Werbebild unterliegt Anforderungen, die in einem Feed leicht übersehen werden: die Produktsilhouette, die Genauigkeit der Beschriftung, die Markenfarben, die Lichtrichtung, der Freiraum für den Text, das Seitenverhältnis der Kampagne sowie die Möglichkeit, kontrollierte Änderungen vorzunehmen, ohne alles zu zerstören, was bereits gut funktioniert hat. Stellen Sie ein kleines Testpaket zusammen, das ein klares Produktfoto, eine Lifestyle-Szene, ein Bild mit typografischen oder verpackungstechnischen Vorgaben sowie eine Bearbeitung eines bestehenden Bildmaterials enthält.
Veo 3.1 vs. Seedance 2.0: Ein Produktvideo-Test
Als Nächstes baten wir um einen fünfsekündigen Werbespot für ein Premiumprodukt: eine matt-marineblaue Flasche, zentriert auf hellem Stein, langsame Nahaufnahme, Kondenswasser und ohne Logo, Text oder Personen. Das Ergebnis von Veo 3.1 dauerte acht Sekunden; bereits in der zweiten Sekunde zeigte es überzeugende Produktnahaufnahmen und Kondenswasser, doch die Kamera war zu nah herangefahren, um die gewünschte Komposition mit der vollständig zentrierten Flasche zu erfüllen. Seedance 2.0 lieferte eine Dauer von 5,04 Sekunden und zeigte eine vollere, aufrecht stehende Flasche auf einer steinartigen Oberfläche, allerdings war der Flaschenhals abgeschnitten und der Kondenswasser-Effekt deutlich weniger sichtbar.
Gemeinsame Eingabeaufforderung, die für beide generierten Ergebnisse verwendet wird
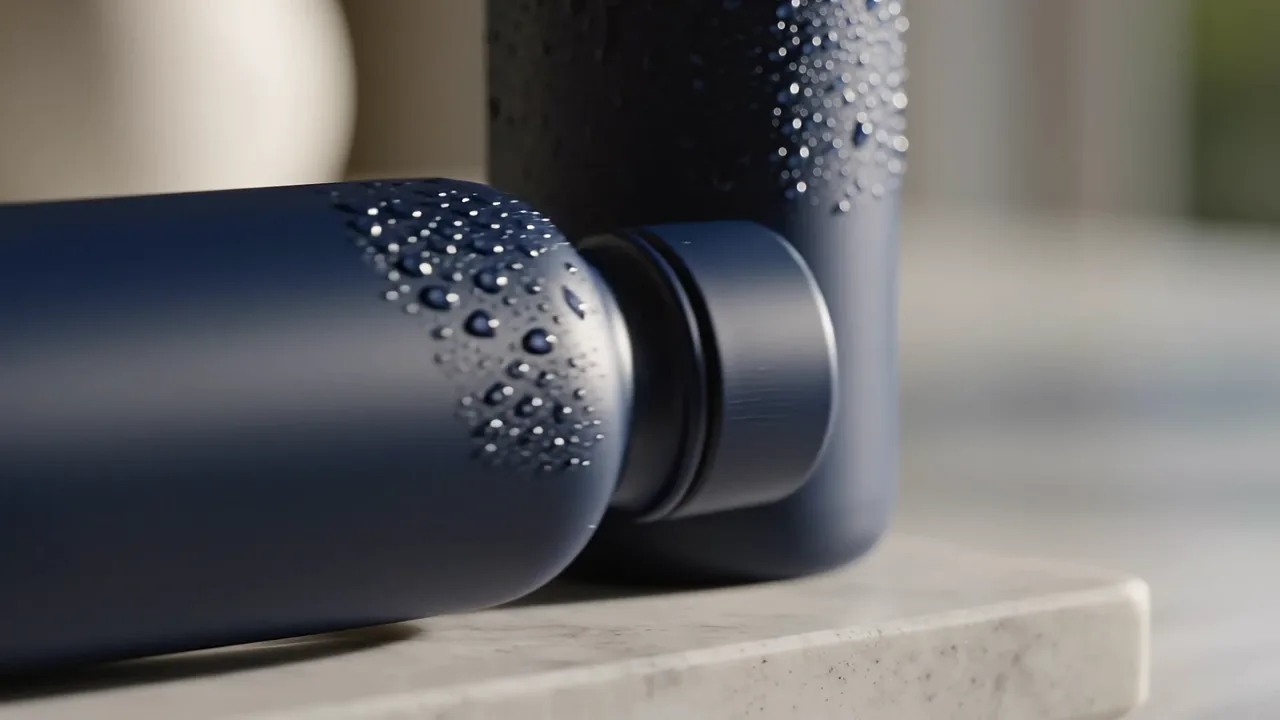
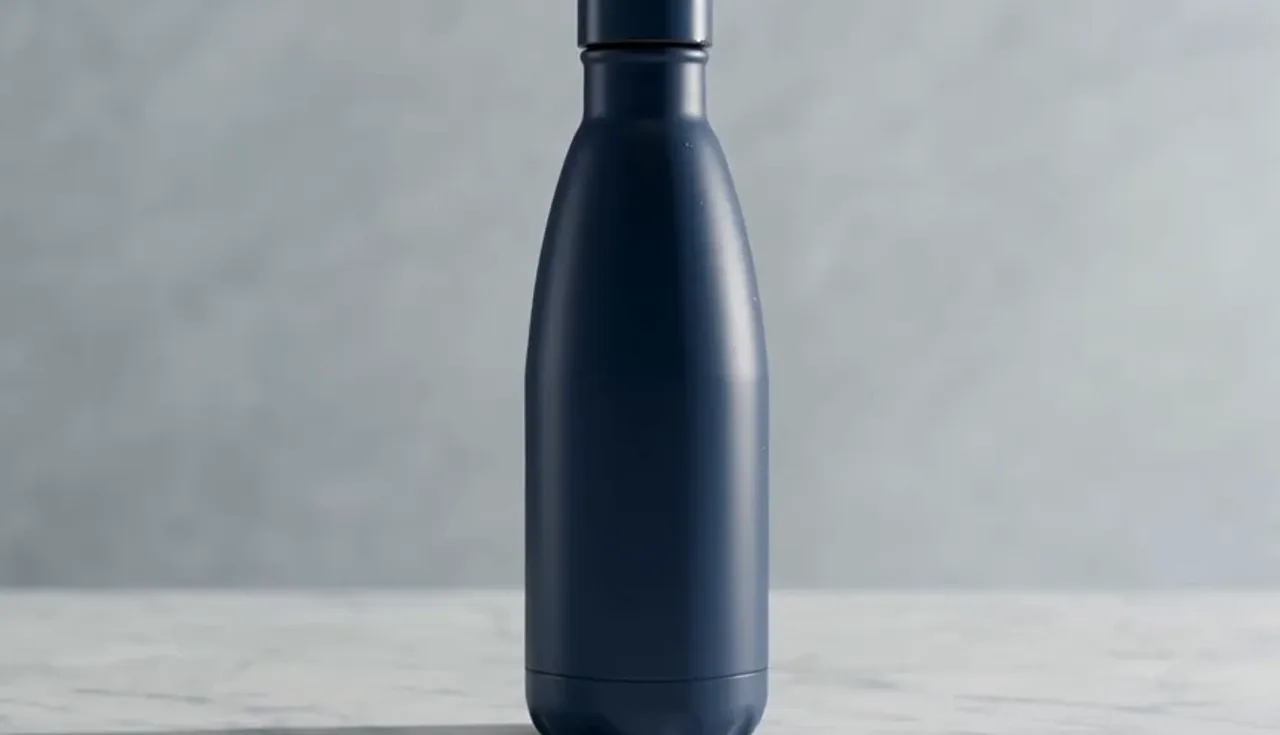
Entscheiden Sie sich für eine Video-KI danach, wie schnell sie die von Ihnen benötigten Einstellungen hinsichtlich Bildausschnitt, Bewegung und Überarbeitungskontrolle erreicht, und nicht aufgrund eines einzelnen ansprechenden Bildausschnitts. Prüfen Sie die aktuellen Rechte und Zugangsvoraussetzungen in der Veo 3.1 Leitfaden für die gewerbliche Nutzung und die Seedance 2.0 – Leitfaden für den Zugriff. Agnes Video bietet außerdem offizielle Produktdokumentation; überprüfen Sie die Vertragsbedingungen unmittelbar vor dem Kauf.
So erstellen Sie ein KI-Budget, ohne denselben Auftrag doppelt zu bezahlen
Die meisten Menschen benötigen nicht für jede Modellkategorie ein Abonnement. Ein vernünftiges Budget beginnt mit der einzelnen Aufgabe, die die teuerste Arbeitszeit in Anspruch nimmt. Für einen Berater können das Recherche und das Verfassen von Texten sein. Für einen Entwickler sind es möglicherweise die Überprüfung im Repository und das Debugging. Für ein Kreativteam ist es vielleicht die Fähigkeit, Kampagneninhalte zu erstellen und zu überarbeiten. Investieren Sie zunächst in diesen primären Engpass und fügen Sie erst dann einen zweiten Ansatz hinzu, wenn eine konkrete Aufgabe eine Lücke aufzeigt.
Denken Sie in Stufen. Die erste Stufe ist ein Kernassistent, den Sie häufig nutzen. Die zweite Stufe ist ein Spezialist für eine ganz andere Aufgabe, wie beispielsweise quellenbasierte Recherche oder die Erstellung von Videos. Die dritte Stufe ist ein flexibler Zugang für Experimente, Überlastungen und Zweitmeinungen. Was Sie vermeiden sollten, sind drei allgemeine Chat-Abonnements, die alle in etwa denselben ersten Entwurf erstellen. Die zusätzlichen monatlichen Kosten liegen auf der Hand; weitaus schädlicher ist jedoch, dass niemand weiß, welcher Antwort man vertrauen soll oder wo die endgültige Version zu finden ist.
Ein solider Ansatz auf der Ebene der allgemeinen Argumentation sowie Zugang zu Forschungsmaterialien, wenn für die Arbeit Quellen benötigt werden. Fügen Sie Bilder oder Videos nur bei aktiven Produktionszyklen hinzu.
Am besten geeignet für: Autoren, Analysten, Gründer, Berater.
Ein Programmierweg, der sich für den Editor oder die Befehlszeile eignet, ein zweites Modell für schwierige Prüfungsfragen und bestehende Tests als letzte Hürde.
Am besten geeignet für: Einzelentwickler und kleine Produktteams.
Ein Bild-/Videokonzept mit ausreichender Flexibilität für Überarbeitungen, ein allgemeines Modell für Konzepte und Briefings sowie eine wiederverwendbare Checkliste für die Freigabe.
Am besten geeignet für: Marketingfachleute, E-Commerce-Teams und Agenturen.
Legen Sie für Teams vor dem Kauf von Lizenzen die Zuständigkeiten fest. Wer darf die Live-Webrecherche für einen Kundenantrag nutzen? Wer überprüft den generierten Code? Wer genehmigt visuelle Inhalte? Wo werden die Eingabeaufforderungen und genehmigten Ergebnisse gespeichert? Das sind keine bürokratischen Fragen. Sie entscheiden darüber, ob die KI das Team schneller macht oder lediglich mehr nicht nachvollziehbare Entwürfe erzeugt. Ein bescheidener Plan mit einem definierten Arbeitsablauf ist wertvoller als ein Premium-Zugang ohne Überprüfungsstandard.
Fragen, die man sich stellen sollte, bevor KI bei wichtigen Aufgaben zum Einsatz kommt
“Es lohnt sich, dafür zu bezahlen” ist nicht nur eine Frage des Preises. Je schwerwiegender die Folgen eines Fehlers sind, desto wichtiger ist es, dass das Abonnement klare Anwendungsgrenzen hat. Ein Entwurf einer Produktbeschreibung und eine finanzielle Empfehlung für den Kunden sollten nicht denselben, ungeprüften Prozess durchlaufen. Bevor Sie ein Modell in einen ernstzunehmenden Arbeitsablauf integrieren, legen Sie fest, welche Informationen es erhalten darf, wer die Ergebnisse überprüft, welche Daten beschafft werden müssen und was niemals ohne einen menschlichen Verantwortlichen veröffentlicht werden darf.
- Welche konkrete Aufgabe wird dieser Dienst übernehmen oder wesentlich beschleunigen?
- Welche Quelle, welcher Test oder welcher Prüfer belegt, dass das Ergebnis sicher genug für die Verwendung ist?
- Was muss das Modell wissen, und ist es angemessen, diese Informationen weiterzugeben?
- Kann ein anderes Teammitglied den Arbeitsablauf nachstellen, ohne den privaten Chatverlauf zu kopieren?
- Was würde uns dazu bewegen, dieses Abonnement in 30 Tagen zu kündigen?
Wenn ein einziger Arbeitsbereich für mehrere Modelle mehr wert ist als separate Abonnements
Ein Direktabonnement kann von Vorteil sein, wenn Sie die neuesten First-Party-Funktionen, Unternehmenskontrollen oder tief integrierte Workflows eines Anbieters benötigen. Separate Abonnements werden jedoch teuer und lästig, wenn sich Ihre Aufgaben innerhalb derselben Woche von der Literaturrecherche über die Codeüberprüfung bis hin zur Produktbildbearbeitung ändern. Laut der aktuellen Homepage von GlobalGPT bietet ein Konto über 100 KI-Modelle ab $5,80/Monat sowie Perplexity, Deep Research, Yukie, Web- und CLI-Zugriff sowie einen MCP-Server für Claude Code, Codex und Cursor.
Eine praktische Abfolge verschiedener Modelle sieht wie folgt aus: Beginnen Sie mit Perplexity oder Deep Research, um aktuelle Erkenntnisse zu gewinnen; nutzen Sie ein allgemeines Modell, um das Memo zu gestalten; lassen Sie ein zweites Modell die Annahmen hinterfragen; leiten Sie spezifische Fragen zur Umsetzung über CLI oder MCP weiter, sofern dies Ihrem bestehenden Entwicklungs-Workflow entspricht; gehen Sie erst dann zu Bild- oder Videomaterial über, wenn die Kampagne visuelle Inhalte erfordert. Diese Abfolge macht die Wahl der Tools transparent. Sie ist zudem kostengünstiger, als reflexartig das Top-Paket jedes Anbieters zu kaufen, bevor man weiß, welcher Schritt das Budget verdient.
Zahlen Sie nicht mehr separat, wenn sich der Arbeitsumfang ständig ändert
Recherchieren Sie vor dem Verfassen eines Entwurfs, wechseln Sie das Modell, wenn eine strategische Antwort eine zweite Meinung erfordert, leiten Sie die Programmierarbeit über CLI oder MCP weiter und erstellen Sie anschließend Bilder und Videos über dasselbe Konto.
Probieren Sie den Multi-Modell-Arbeitsbereich von GlobalGPT ausDer wichtigste Grund für die Zahlung ist nicht der Zugang zu einem bekannten Modellnamen. Es geht vielmehr darum, in dem Moment, in dem sich die Aufgabe ändert, über die richtige Route zu verfügen, ohne den Abonnement-Stack neu aufbauen zu müssen. Als allgemeiner Einstiegspunkt für Modelle dient die von GlobalGPT verifizierte GPT-5.6-Sol-Route, die hier erhältlich.
FAQ
Für welche KI lohnt es sich am meisten, Geld auszugeben?
Die rentabelste KI ist diejenige, die Ihnen bei Ihrer Kernarbeit immer wieder Zeit spart. Bei forschungsintensiven Aufgaben ist eine zitatsbasierte Suche von Vorteil; bei der Analyse ist ein leistungsstarkes allgemeines Modell von Vorteil; bei der Entwicklung sind ein Modell und eine Schnittstelle von Vorteil, die den Überprüfungszyklus verbessern; Bild- und Videotools müssen echte Produktionszeit einsparen.
Lohnt es sich, für ChatGPT zu bezahlen?
ChatGPT kann sich lohnen, wenn es Ihre Hauptumgebung für die Entwurfserstellung, Analyse und iterative Problemlösung ist. Führen Sie Ihre eigenen wiederkehrenden Aufgaben sowohl mit diesem als auch mit einem zweiten Modell durch und vergleichen Sie dann die Bearbeitungszeit sowie die erste Antwort.
Lohnt es sich, für Perplexity zu bezahlen?
Perplexity ist dann besonders sinnvoll, wenn Quellenangaben und überprüfbare Zitate die Qualität Ihrer Forschung maßgeblich beeinflussen. Es ist weniger wichtig, wenn Ihre Arbeit hauptsächlich aus Offline-Tätigkeiten wie Schreiben, Programmieren oder der Erstellung von Inhalten besteht.
Welche KI eignet sich am besten für das Programmieren?
Die beste KI zum Erstellen von Code ist diejenige, die den Kontext des Repositorys versteht, eine überprüfbare Änderung vorschlägt, ausführbare Tests erstellt und zu Ihrem Editor oder Ihrer CLI passt. Behandeln Sie autonom erstellten Code so lange als Entwurf, bis Ihre üblichen Tests und die Überprüfung erfolgreich abgeschlossen sind.
Sollte ich für eine KI zur Bild- oder Videogenerierung bezahlen?
Bezahlen Sie nur dann, wenn das Model regelmäßig Entwürfe erstellt, die den Aufwand für Fotoshootings, Design, Bearbeitung oder Agenturarbeit ersetzen. Vergleichen Sie dieselbe markenspezifische Vorgabe bei mehreren Anbietern und planen Sie Kosten für Überarbeitungen ein, da bei den ersten Ergebnissen möglicherweise die Bildkomposition oder Details des Materials nicht berücksichtigt wurden.
Lohnt sich ein Abonnement für eine Multi-Modell-KI?
Ein Abonnement mit mehreren Modellen ist sinnvoll, wenn Sie zwischen Recherche, Texterstellung, Programmierung, Bildbearbeitung und Videobearbeitung wechseln oder ein zweites Modell benötigen, um eine wichtige Antwort zu überprüfen. Ein Direktabonnement beim Anbieter kann dennoch die bessere Wahl sein, wenn eine bestimmte Kontrolle durch den Anbieter selbst unverzichtbar ist.
Kann ich GPT-5.6 Sol auf GlobalGPT verwenden?
GlobalGPT führt GPT-5.6 Sol in seinem aktuellen Modellkatalog auf. Nutzen Sie die in diesem Artikel beschriebene GlobalGPT-Route, um die derzeit verfügbare Schnittstelle zu überprüfen und die Zugangsoption auszuwählen, die am besten zu Ihrem Arbeitsablauf passt.