Muse Spark 1.3 ist die bislang leistungsstärkste Muse-Spark-Version von Meta: Das öffentlich zugängliche „xhigh“-Modell erreicht einen Wert von 61 auf dem Artificial Analysis Intelligence Index, verfügt über ein Kontextfenster von 1 Million Token und hat alle drei Programmieraufgaben mittlerer Schwierigkeitsstufe in unserem API-Test für Erstantworten bestanden. Ein wichtiger Vorbehalt ist, dass das Leitdiagramm von Meta „Max Reasoning“ verwendet, während „Max“ zum Zeitpunkt der Erstellung dieses Berichts noch auf eine breitere Veröffentlichung nach weiteren Sicherheitstests wartete.

Muse Spark 1.3 Testbericht: Kurzfazit
Unser Fazit
Muse Spark 1.3 ist einen Test wert, wenn es um die Programmierung von Agenten, Arbeiten mit langem Kontext und kostenbewusste Automatisierung geht. Das öffentliche „xhigh“-Ergebnis ist bereits auf dem neuesten Stand der Technik, aber man sollte die Maximalwerte von Meta nicht so zitieren, als ob jeder API-Nutzer diese heute reproduzieren könnte.
Meta hat am 2. September 2026 Muse Spark 1.3 veröffentlicht, wodurch es sich für agentische Arbeitsabläufe mit langfristiger Ausrichtung, übersichtlichere Programmierergebnisse und eine zuverlässigere Zusammenarbeit eignet. Damit setzt sich der Wandel hin zu KI-Agenten, die auf Modellen zum Einsatz von Werkzeugen basieren. Laut Meta stellt das System bei unklaren Anforderungen klärende Fragen, meldet, wenn es nicht weiterkommt, und holt vor folgenreichen Aktionen eine Bestätigung ein. Bei internen Vergleichen mit Version 1.2 stellten die Meta-Entwickler fest, dass etwa 20% weniger Tool-Aufrufe und 25% weniger Tokens erforderlich waren. Dabei handelt es sich um Angaben des Anbieters, nicht um Ergebnisse unseres Tests.
Was hat sich gegenüber Muse Spark 1.2 geändert?
Künstliche Analyse: 57 bis 61 auf xhigh.
Meta gibt für DeepSWE Werte von 75,4 gegenüber 55,0 an, vergleicht dabei jedoch 1,3 (max) mit 1,2 (xhigh).
Das 1M-Fenster bleibt bestehen; die MRCR-Werte im oberen Bereich steigen in Metas Chart stark an.
Die Token-Raten bleiben unverändert, während AA pro bewerteter Aufgabe einen Wert von $0,55 gegenüber $0,40 verzeichnete.
Muse Spark 1.3-Benchmarks: „Max“ und „Xhigh“ sind nicht dasselbe
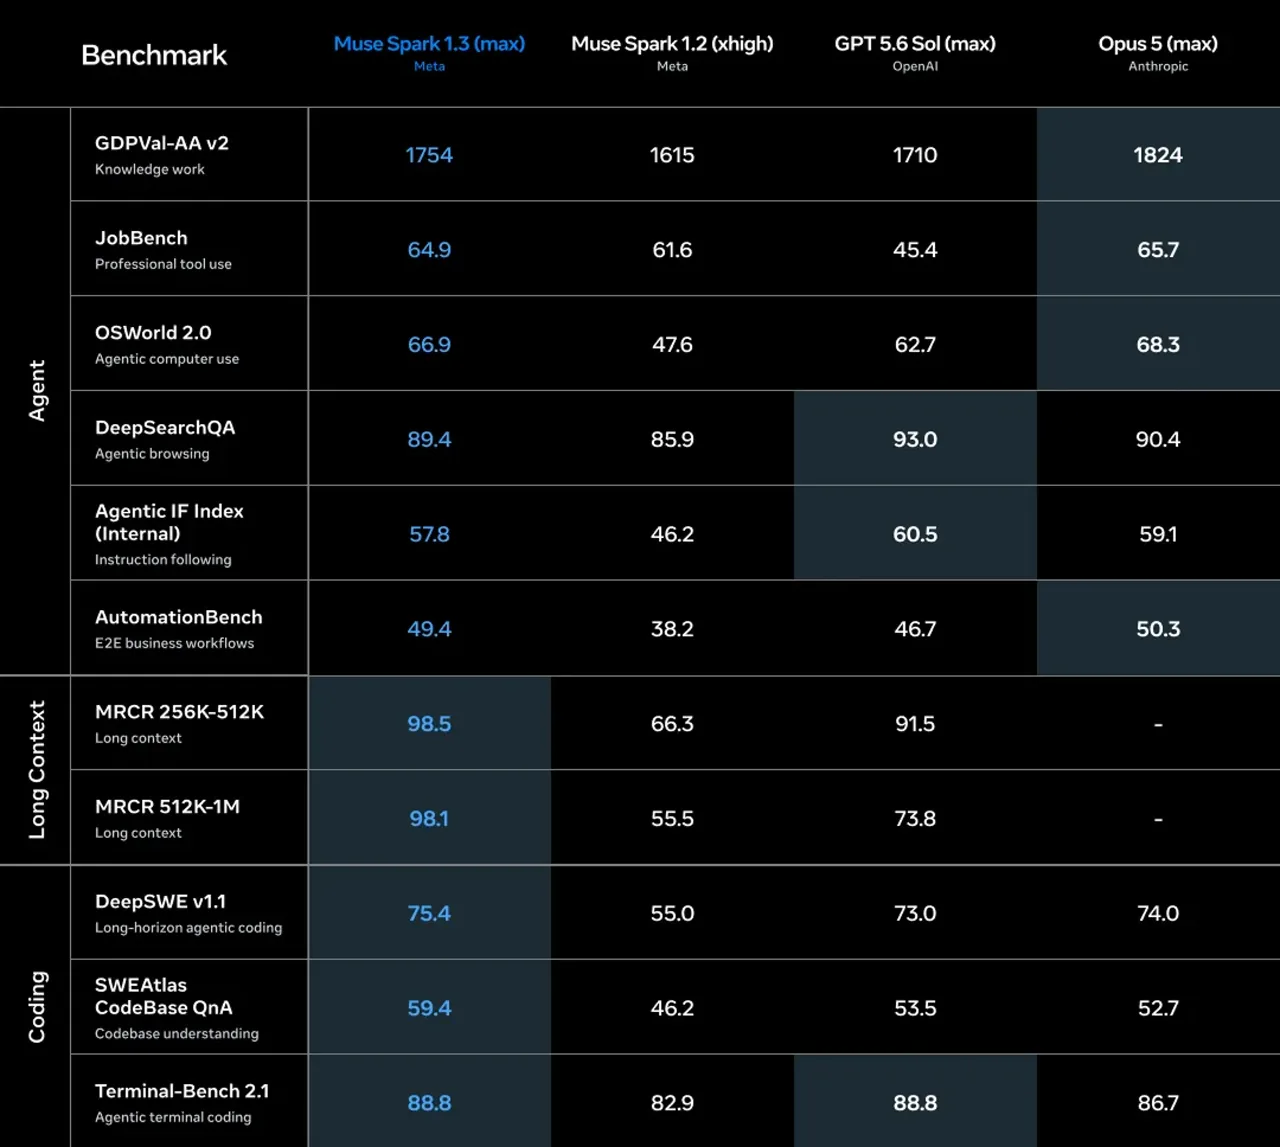
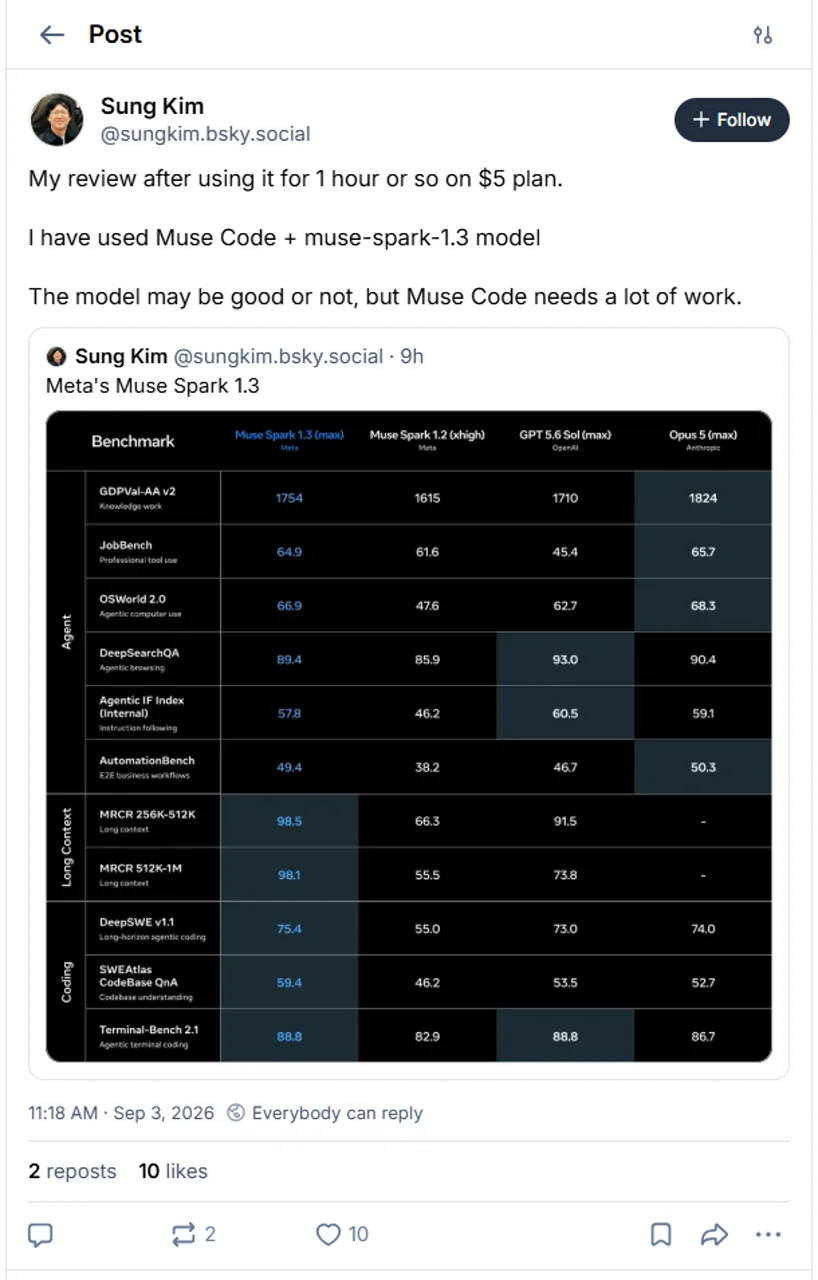
Die offizielle Tabelle von Meta ist beeindruckend. Muse Spark 1.3 erreicht bei Terminal-Bench 2.1 eine Höchstpunktzahl von 88,8, bei DeepSWE v1.1 von 75,4, bei MRCR 512K-1M von 98,1 und bei OSWorld 2.0 von 66,9. Bei Terminal-Bench liegt es gleichauf mit GPT-5.6 Sol und übertrifft die aufgeführten Konkurrenten in den beiden MRCR-Bereichen mit langem Kontext. Entwickler, die einen Vergleich mit dem breiteren Markt anstellen möchten, können unsere Übersicht über Coding-Agent als zusätzlichen Kontext.
META-BERICHT, MAX-ARGUMENTATION
| Benchmark | 1,3 max. | 1,2 × hoch | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | K.A. |
Unterschiedliche Aufwandsstufen, Agenten-Harnesse und OSWorld-Versionen schränken die direkte Vergleichbarkeit ein. Meta beschreibt den „Agentic IF Index“ zudem als internen zusammengesetzten Index.
So lesen Sie die Tabelle
1.3, GPT-5.6 Sol und Opus 5 verwenden „max“; 1.2 verwendet „xhigh“.
Die benannten Agenten und festen Kabelbäume variieren je nach Bewertung.
Die Versionen 1.3 und 1.2 verwenden unterschiedliche Umgebungsversionen.
Der „Agentic IF Index“ ist ein von Meta erstellter zusammengesetzter Index und kein einzelner öffentlicher Referenzindex.
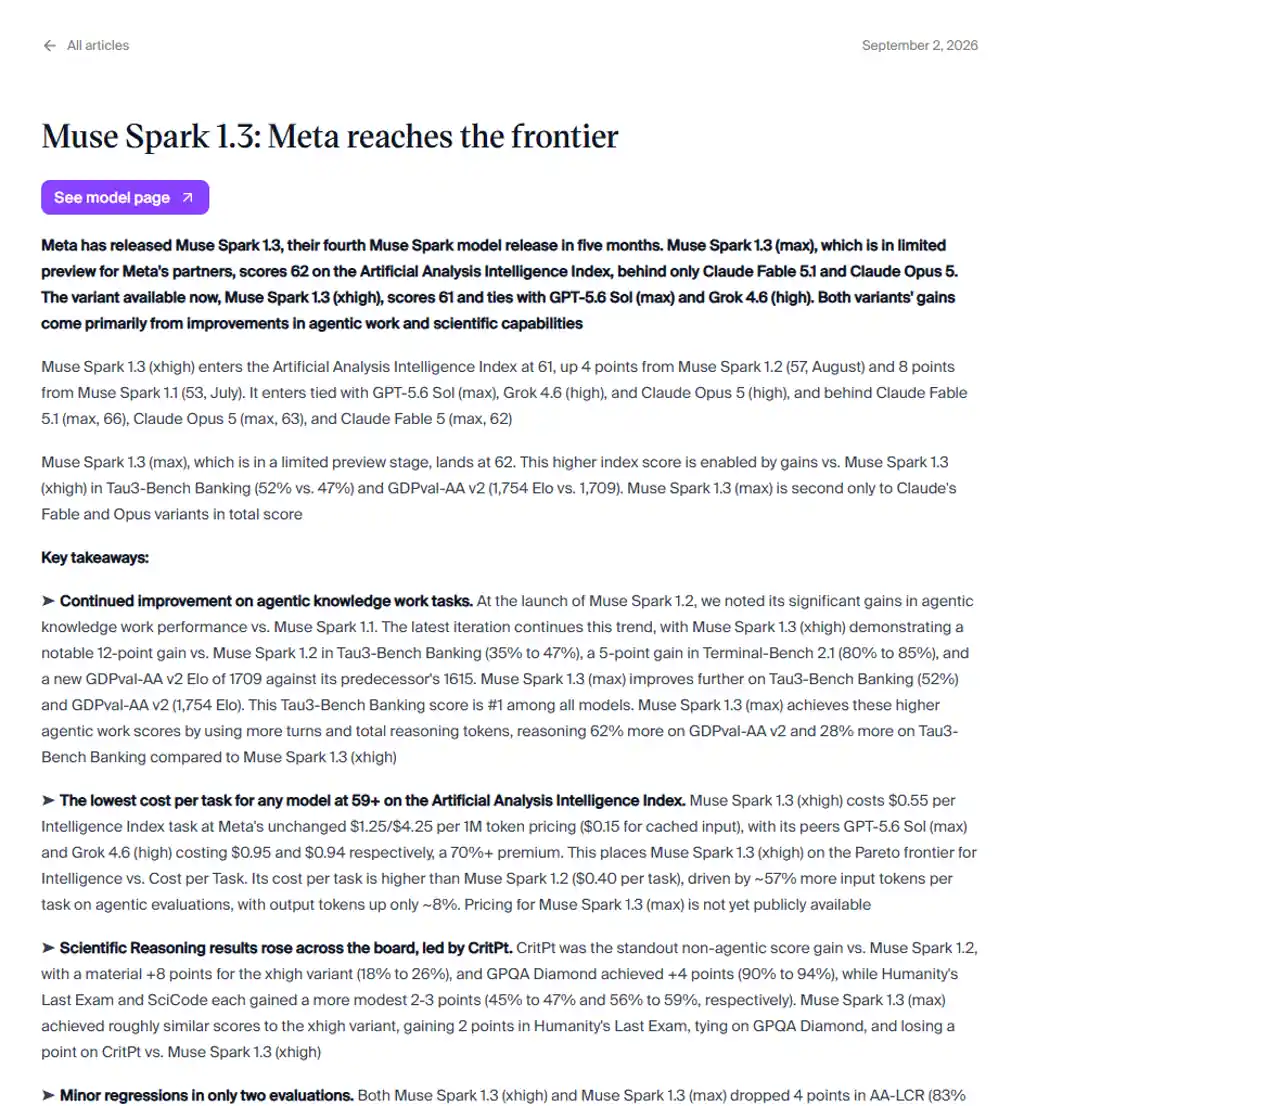
„Artificial Analysis“ bietet einen übersichtlicheren Überblick was Nutzer derzeit nutzen können. Muse Spark 1.3 xhigh erreicht 61 Punkte, gegenüber 57 bei Version 1.2. Das Terminal-Bench-Ergebnis liegt bei 85%, GDPval-AA v2 bei 1709 Elo und Tau3-Bench Banking bei 47%. Die „Limited Preview“-Max-Variante erreicht insgesamt 62. Es gibt jedoch auch Rückschritte: AA-LCR fällt von 831 TP40T auf 791 TP40T, während die AA-Omniscience-Genauigkeit bei xhigh von 451 TP40T auf 421 TP40T sinkt.
Preise für Muse Spark 1.3
Mitwirkender
muse-spark-1.3-Mitwirkender
$0.10 Eingabe / $0.002 Zwischenspeicher / $0.20 Ausgabe pro Million Token.
Die Eingabeaufforderungen können zur Verbesserung der Meta-Produkte verwendet werden.
Standard
muse-spark-1.3
$1,25 Eingabe / $0,15 Zwischenspeicher / $4,25 Ausgabe pro Million Token.
Meta gibt an, dass diese Stufe nicht zur Verbesserung seiner Produkte genutzt wird.
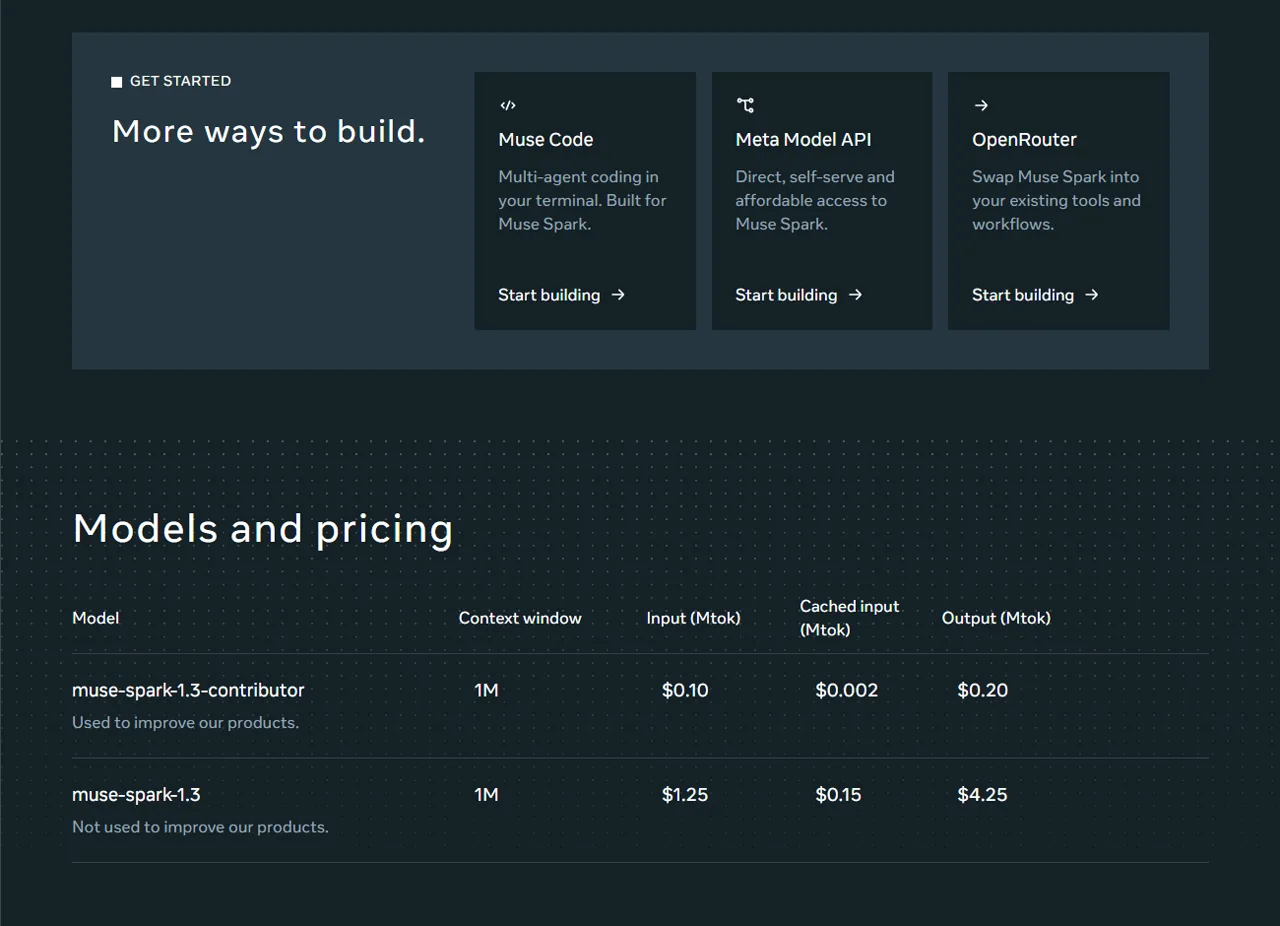
Die offizielle Token-Preise sind gegenüber Version 1.2 unverändert, die Kosten pro Aufgabe jedoch nicht. Unsere Testbericht zur All-in-One-KI-Plattform erläutert, warum der Zugriffspreis und die Workflow-Kosten getrennt bewertet werden sollten. Artificial Analysis ermittelte $0,55 pro „Intelligence Index“-Aufgabe für 1,3 xhigh gegenüber $0,40 für 1,2, was hauptsächlich auf etwa 57% mehr Eingabetoken bei agentischen Bewertungen zurückzuführen ist. Die „Contributor“-Stufe ist außergewöhnlich günstig, doch ihre Datenutzungsklausel ist eine echte Produktentscheidung und keine bloße Fußnote.
Zugriff auf die Muse Spark 1.3-API
Meta’s offizielles Kochbuch verwendet nun muse-spark-1.3 als Standardwert und dokumentiert ein Kontextfenster mit 1.048.576 Token. Die API ist mit dem OpenAI-SDK kompatibel. Muse Code und die Meta Model API sind derzeit bestätigte Zugriffsmöglichkeiten. Auf der Modellseite von Meta wird auch OpenRouter angezeigt, allerdings verwies dessen Schaltfläche beim Anklicken noch auf eine 1.2-URL; überprüfen Sie daher den Zugriffspfad vor der Bereitstellung. Hintergrundinformationen zur Interoperabilität von Agenten finden Sie in unserem Leitfaden zu MCP- und KI-Tools.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Überprüfe diesen Patch auf Regressionen."}],
)

print(response.choices[0].message.content)
Praktische Programmiertests: 3 von 3 bestanden
Wir haben drei Repository-Aufgaben mittleren Schwierigkeitsgrades über eine API bei einer Temperatur von null getestet, wobei wir pro Aufgabe eine Antwort verwendet haben. Jede Antwort musste vollständige Dateien im strukturierten JSON-Format zurückgeben. Anschließend haben wir diese Dateien in temporären Verzeichnissen abgelegt und sowohl öffentliche als auch versteckte Prüfungen durchgeführt. Hierbei handelt es sich um kleine, kontrollierte Tests, die weder Terminal-Bench noch einen Test im Produktions-Repository ersetzen.
5/5 Tests; 18,4 s; 2.473 Tokens; $0,00905. Das Modell hat die Menge der ungenutzten verarbeiteten IDs ermittelt, eine frühzeitige Duplikatsprüfung hinzugefügt und einen Regressionstest geschrieben.
Typprüfung und zwei Laufzeitzuprüfungen bestanden; 47,6 s; 4.945 Token; $0.01661. Validierung, Persistenz und Audit-Protokollierung wurden getrennt, ohne die Transaktionsgrenze zu überschreiten.
9 von 9 Tests; 20,3 s; 3.789 Tokens; $0,01446. CSV-Kompatibilität, Fehler mit Zeilennummerierung, atomare Ausgabe, Sicherheit bei Trockenläufen, Hilfe und Dokumentation – alles bestanden.
Insgesamt: 11.207 Tokens und $0,04013. Bei den Zeitangaben handelt es sich um die End-to-End-Anfragezeiten, nicht um die native Latenz der Meta-API oder TTFT.
Das Ergebnis war besser, als es ein bloßes “3/3” vermuten lässt: Alle drei ersten Antworten waren überprüfbar und berücksichtigten die Rahmenbedingungen. Dieselbe Methodik ist auch beim Lesen unserer GPT-5-Testbericht. Allerdings werden in diesem Test weder die Zuverlässigkeit bei wiederholten Tool-Aufrufen noch die Navigation in großen Repositories noch die Orchestrierungsschicht von Muse Code berücksichtigt. Leser, die kostengünstige Alternativen in Betracht ziehen, könnten auch unseren Vergleich von Budgetierungsmodellen nützlich.
Erste Reaktionen der Entwickler
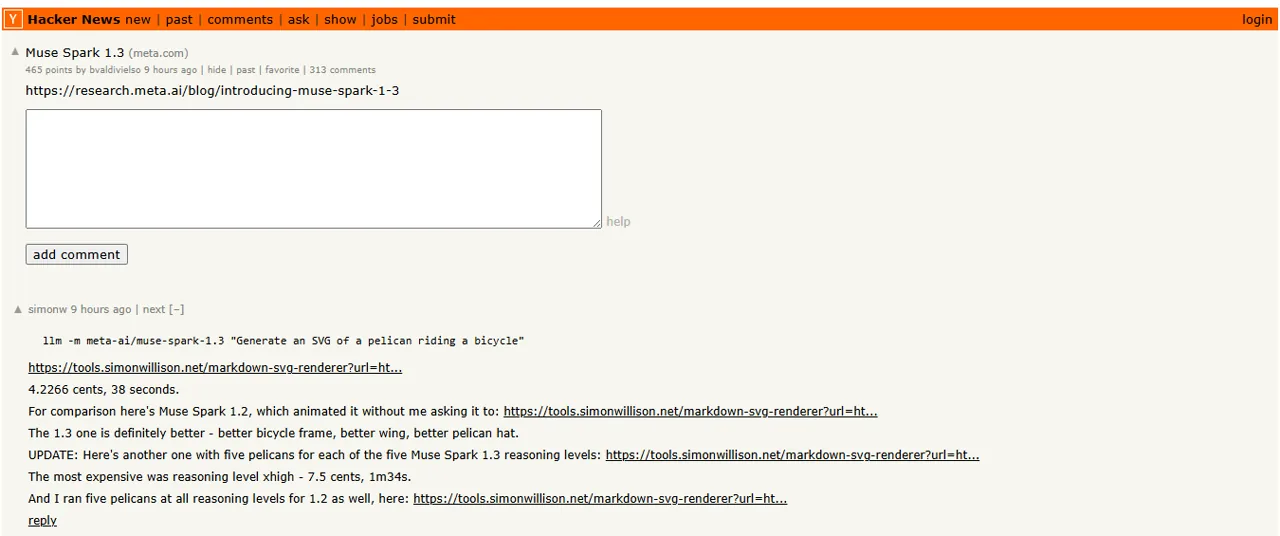
Die ersten Reaktionen sind gemischt und zu spärlich, um von einem Konsens sprechen zu können. In einem Hacker News-Test, Simon Willison meldete eine SVG-Laufzeit von 38 Sekunden und 4,2266 Cent und bewertete das 1,3-Ergebnis als “definitiv besser” als seinen 1,2-Vergleich. Dax beschrieb die Veröffentlichung als Erinnerung daran, wie sehr er schnelle Models vermisste. Sung Kim, … sagte nach etwa einer Stunde mit Muse Code, das Modell sei zwar gut, das Muse-Code-Produkt “bedürfe jedoch noch viel Arbeit”. Diese letzte Bemerkung bezieht sich auf die Erfahrung mit dem Agenten und nicht auf einen reinen Modelltest.
Vor- und Nachteile
Was hat funktioniert?
- Hohe öffentliche Bewertung xHigh-Score
- 1M-Token-Kontextfenster
- OpenAI-kompatible API
- Alle drei Programmieraufgaben wurden beim ersten Durchgang bestanden
- Sehr niedrige Token-Sätze für die niedrigste Beitragsstufe
Was man sich ansehen sollte
- Die maximalen Ergebnisse der Schlagzeilen sind nicht die standardmäßige öffentliche Ansicht.
- Die Kosten für eigenständige Aufgaben stiegen im Vergleich zu 1,2
- Zwei unabhängige Messgrößen wurden einer Regressionsanalyse unterzogen
- Daten von Mitwirkenden können Meta-Produkte verbessern
- Die ersten Reaktionen auf Muse Code sind gemischt
Für wen ist Muse Spark 1.3 geeignet?
VERWENDEN SIE ES FÜR
Bewertungen von Programmieragenten, Arbeit mit Repositorien mit großem Kontextumfang, toolgestützte Automatisierung und kostensensible Experimente, bei denen die Datenrichtlinien akzeptabel sind.
ÜBERSPRINGEN ODER WARTEN, WENN
Sie benötigen nachweislich langfristige Produktionszuverlässigkeit, benötigen die maximale Kapazität bereits heute oder können die Datennutzung auf „Contributor“-Ebene nicht akzeptieren und halten die Standardpreise für nicht wettbewerbsfähig.
Fazit zum Testbericht zu Muse Spark 1.3
Muse Spark 1.3 verdient eine Empfehlung zur Evaluierung. Es vereint öffentliche Hochleistungsberechnungen auf Spitzenniveau, überzeugende Ergebnisse bei langem Kontext, eine vertraute API-Ergonomie und eine aggressive Preisgestaltung. Unsere drei Coding-Aufgaben zur Erstbearbeitung untermauern, dass es die Vorgaben für mehrere Dateien einhalten und testbare Patches erstellen kann.
Wählen Sie für sensiblen Code die Standardstufe. Einen weiteren Vergleich der Sicherheitsstufen finden Sie unter GPT-5 vs. Claude 4. Betrachten Sie die maximalen Benchmark-Ergebnisse als vorläufige Anhaltspunkte, bis diese Ebene der Schlussfolgerung allgemein verfügbar ist. Und bewerten Sie den Muse-Code getrennt von der Modell-API: Die Benutzererfahrung, der Tool-Loop und die Repository-Steuerung eines Agenten können unabhängig vom Basismodell erfolgreich sein oder scheitern.
Muse Spark 1.3 – Häufig gestellte Fragen
Was ist Muse Spark 1.3?
Muse Spark 1.3 ist das am 2. September 2026 veröffentlichte Modell von Meta für Programmier- und agentenbasierte Arbeitsabläufe, das über ein Kontextfenster von 1 Million Token sowie eine native Erkennung von Bildern, Videos und Dokumenten verfügt.
Wie viel kostet Muse Spark 1.3?
Das Standardmodell kostet $1,25 pro Million Eingabetoken, $0,15 für zwischengespeicherte Eingaben und $4,25 für die Ausgabe. Das Mitwirkermodell kostet $0,10, $0,002 bzw. $0,20, doch seine Daten können zur Verbesserung von Meta-Produkten verwendet werden.
Ist „Max Reasoning“ verfügbar?
Meta teilte mit, dass die bestehenden Schlussfolgerungsmodi zum Start verfügbar seien und „max“ nach weiteren Sicherheitstests folgen werde. Bitte überprüfen Sie die aktuelle API-Dokumentation, bevor Sie von einer allgemeinen Verfügbarkeit ausgehen.
Hat Muse Spark 1.3 die Programmiertests bestanden?
Ja. Die ersten Antworten haben alle Ausführungsprüfungen im Rahmen unserer Python-Fehlerbehebung, der TypeScript-Umgestaltung und der JSONL-Funktionstests bestanden. Das Beispiel enthält nur drei kontrollierte Aufgaben und stellt keine allgemeine Zuverlässigkeitsrate dar.
Ist Muse Spark 1.3 besser als 1.2?
Im Wesentlichen basierend auf den verfügbaren Belegen. Die öffentliche xhigh-Intelligenz stieg von 57 auf 61, und Meta berichtet von großen Fortschritten bei der Handlungsfähigkeit und beim Umgang mit langen Kontexten, doch Artificial Analysis stellte zudem höhere Aufwandswerte fest sowie leichte Rückschritte beim Abrufen langer Kontexte und bei der Faktenkalibrierung.
Sollte ich das Mitwirkermodell oder das Standardmodell verwenden?
Verwenden Sie „Standard“ für sensible oder geschützte Eingabeaufforderungen, da Meta angibt, dass diese Daten nicht zur Verbesserung seiner Produkte verwendet werden. „Contributor“ ist deutlich günstiger, allerdings können dessen Eingabeaufforderungen zur Produktverbesserung genutzt werden.