Ja – Grok 4.6 ist ein offizielles xAI-Modell, das am 12. August 2026 veröffentlicht wurde und das Sie unbedingt im Auge behalten sollten, wenn Ihre Arbeit umfangreiche Recherchepakete, Programmierung, mehrstufige Analysen oder bildbasierte Aufgaben umfasst. Dank seines Kontextfensters von 500.000 Token und seiner konfigurierbaren Schlussfolgerungsfähigkeit ist es für anspruchsvolle Projekte geeignet, auch wenn es nicht automatisch die schnellste oder beste Wahl für jede Eingabe ist. Die eigentliche Frage ist nicht mehr, ob Grok 4.6 existiert, sondern ob seine Stärken zu der Arbeit passen, die Sie tatsächlich erledigen müssen.
Wenn Sie diese Frage beantworten möchten, ohne Ihren gesamten Arbeitsablauf an einen einzigen Anbieter zu binden, GlobalGPT ist ein hervorragender Einstieg. Der Browser-Arbeitsbereich ermöglicht es Ihnen, Grok 4.6 zusammen mit anderen führenden Modellen zu nutzen, dieselben Aufgaben in den Bereichen Recherche, Texterstellung, Analyse oder Programmierung auszuführen und die Ergebnisse an einem Ort zu vergleichen. Dies ist eine praktische und erfrischend einfache Möglichkeit, um herauszufinden, wo sich Grok 4.6 wirklich von anderen Modellen abhebt – und wo ein anderes Modell besser zu Ihrer Aufgabe passt –, bevor Sie sich für die für Sie passende Konfiguration oder das passende Abonnement entscheiden.
Was genau ist Grok 4.6?
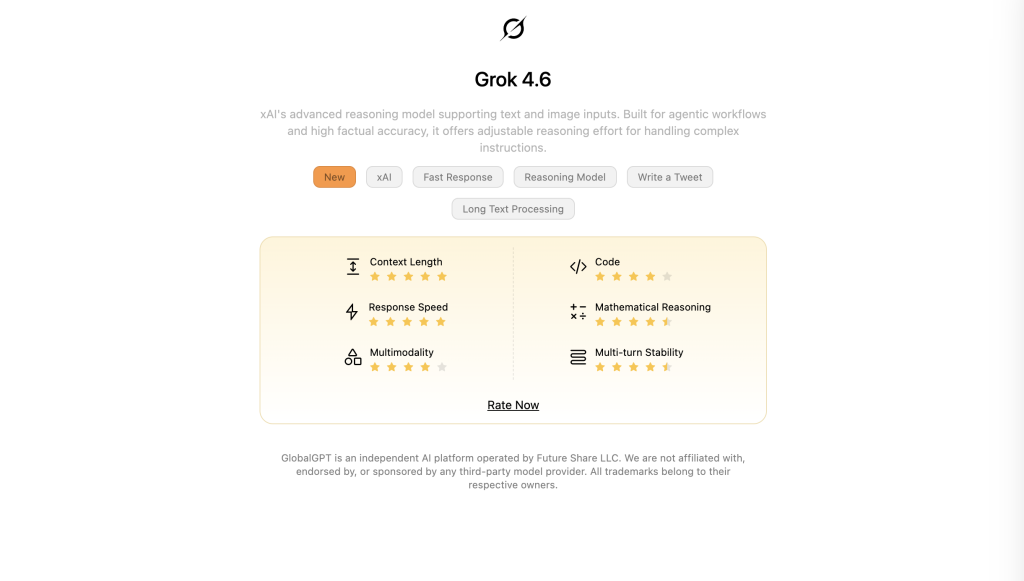
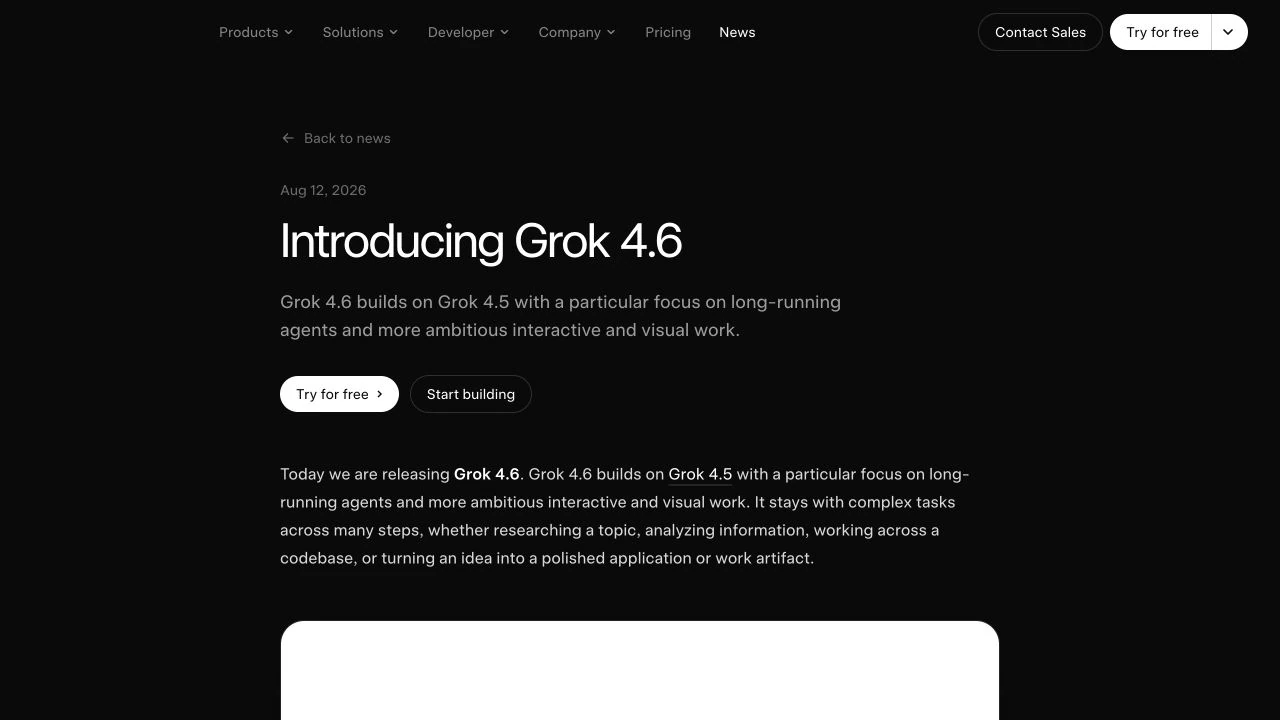
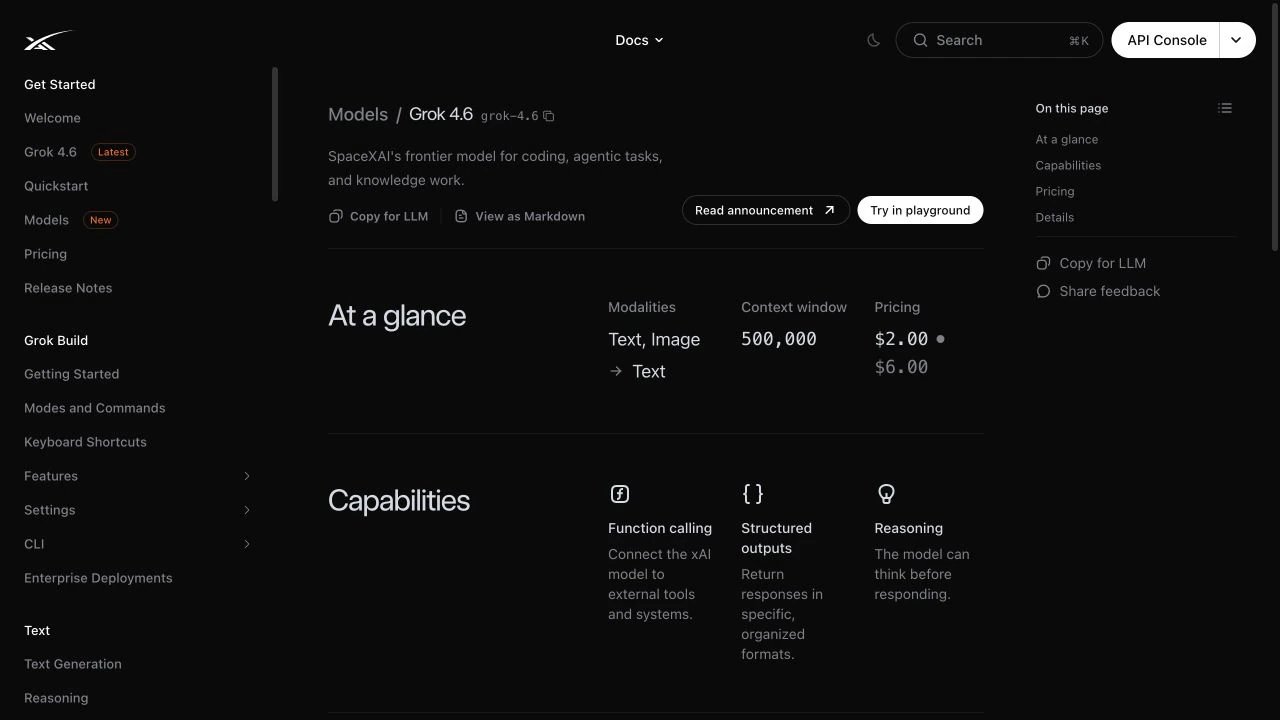
Grok 4.6 ist das Flaggschiffmodell von xAI für das Jahr 2026 in der Grok-Reihe. Auf der offiziellen Modellseite werden Texteingabe und Bildeingabe, Textausgabe, konfigurierbare Schlussfolgerungen sowie ein Kontextfenster von 500.000 Token beschrieben. Die API-Kennung lautet grok-4.6; das ist der Wert, den Entwickler in einer Anfrage verwenden sollten.
Die von xAI selbst verwendete Release-Bezeichnung ist spezifisch: Grok 4.6 konzentriert sich auf lang laufende Agenten sowie anspruchsvollere interaktive und visuelle Arbeiten. In der offiziellen Dokumentation wird es für die Programmierung, agentenbasierte Aufgaben und Wissensarbeit empfohlen, mit Funktionsaufrufen und strukturierten Ausgaben für Arbeitsabläufe, die Werkzeuge oder vorhersehbare Antwortformate erfordern.
Auf der Modellkarte ist als Stichtag für das Vortraining der Januar 2026 angegeben. Diese Unterscheidung ist wichtig. Ein Kontextfenster von 500.000 Zeichen ermöglicht zwar die Eingabe eines sehr umfangreichen Quellpakets, macht das Modell dadurch jedoch nicht automatisch zu einer Echtzeit-Suchmaschine. Bei aktuellen Preisen, Nachrichten oder sich ändernden Produktrichtlinien sollten Sie die Quellen angeben und die Antwort überprüfen.
Wie lauten die offiziellen technischen Daten des Grok 4.6?
| Spezifikation | Offiziell dokumentierter Wert | Warum das wichtig ist |
|---|---|---|
| Datum der Veröffentlichung | 12. August 2026 | Bestätigt, dass es sich um eine offizielle xAI-Veröffentlichung handelt. |
| API-Modell-ID | grok-4.6 | Verwenden Sie genau diesen Slug in API-Anfragen. |
| Kontextfenster | 500.000 Token | Nützlich für umfangreiche Briefings, Codebasen und recherchielastige Arbeiten. |
| Eingabe / Ausgabe | Text- und Bildeingabe; Textausgabe | Unterstützt multimodale Eingabeaufforderungen, jedoch keine Bildgenerierung. |
| Begründung | Konfigurierbar | Ermöglicht es einem Workflow, Geschwindigkeit gegen eine gründlichere Analyse einzutauschen. |
| Funktionsaufruf | Unterstützt | Stellt eine Verbindung zwischen dem Modell und Tools sowie externen Systemen her. |
| Strukturierte Ausgaben | Unterstützt | Nützlich für JSON, Datenextraktion und vorhersehbare Pipelines. |
| Grenzwert vor dem Training | Januar 2026 | Gehen Sie nicht davon aus, dass das Basismodell automatisch auf dem neuesten Stand ist. |
Quelle: Ankündigung von xAI, Modelldokumentation und Grok 4.6 Model Card. Offizielle Spezifikationen entsprechen nicht den unabhängigen Leistungsergebnissen.
Was kann Grok 4.6?
Logisches Denken und strukturierte Analyse
Dank der konfigurierbaren Schlussfolgerungen eignet sich Grok 4.6 für Aufgaben, bei denen eine wohlüberlegte Antwort von Vorteil ist: das Abwägen von Belegen, das Erstellen von Entscheidungstabellen, die Planung einer Implementierung oder die Überprüfung einer Berechnung unter bestimmten Einschränkungen. Mehr Schlussfolgerungen sind nicht automatisch für jede Anfrage besser; daher sollten bei der routinemäßigen Extraktion und Umformulierung geeignete Einstellungen verwendet werden.
Recherche- und quellenintensive Arbeit
Das 500K-Kontextfenster bietet dem Modell ausreichend Platz für umfangreiche Berichte, Transkripte, politische Dokumente und Quellenpakete. Der effizienteste Arbeitsablauf besteht darin, Inhalte anhand expliziter Verweise und Zitierregeln abzurufen und anschließend die Originalquelle zur Überprüfung zu öffnen.
Programmierung und Fehlerbehebung
Veröffentlichte Bewertungen aus dem Bereich Software-Engineering sowie unser kleiner Debugging-Test bestätigen die Eignung des Tools für Code-Reviews, die Fehlerbehebung und strukturierte Agenten-Aufgaben. Entwickler sollten dennoch vor der Bereitstellung Tests lokal durchführen und Patches überprüfen.
Bildverständnis
xAI dokumentiert Text- und Bildeingaben mit Text-Ausgaben. Dies ermöglicht die Auswertung von Screenshots, die Analyse von Dokumentenbildern und die visuelle Beantwortung von Fragen, sollte jedoch nicht mit der Bildgenerierung verwechselt werden.
Lang laufende Agenten und der Einsatz von Tools
Dies ist die Funktion, die am engsten mit der Markteinführung von xAI verbunden ist. Durch Funktionsaufrufe kann Grok 4.6 eine Verbindung zu externen Tools herstellen, während strukturierte Ausgaben die Weitergabe des Ergebnisses an einen weiteren Schritt erleichtern. Diese Kombination eignet sich für Agenten, die Kontextinformationen sammeln, eine Codebasis durcharbeiten, ein Tool aufrufen, ein Ergebnis überprüfen und ein fertiges Artefakt zurückgeben. Das Modell benötigt weiterhin eine externe Laufzeitumgebung, Berechtigungen und Zielprüfungen; “agentic” bedeutet nicht, dass das Basismodell eigenständig agiert.
Interaktive und visuelle Arbeiten
xAI hebt zudem anspruchsvollere interaktive und visuelle Arbeiten hervor. Ein sinnvoller Test ist eine mit zahlreichen Screenshots versehene Produktbeschreibung oder ein durch Diagramme untermauerter Bericht, bei dem das Modell visuelle Belege mit einer schriftlichen Empfehlung verknüpfen muss. Überprüfen Sie Beschriftungen, Achsen, Einheiten und ausgelassene Details, bevor Sie das Ergebnis als endgültig betrachten.
Was hat sich beim Grok 4.6 im Vergleich zu früheren Grok-Modellen geändert?
xAI legt den Schwerpunkt auf eine leistungsfähigere Schlussfolgerung, die Arbeit mit Programmieragenten und die Leistung bei langen Kontexten. Das praktische Upgrade besteht nicht aus einer einzigen auffälligen Funktion, sondern aus der Kombination eines größeren Arbeitsbereichs, anpassbarer Schlussfolgerung und eines Modells, das auf komplexe, mehrstufige Aufgaben abgestimmt ist.
Das muss noch im Arbeitsablauf getestet werden. Ein Modell kann bei einem Benchmark zwar gut abschneiden, sich aber für Ihren Schreibstil, Ihre Zitiervorschriften oder Ihren Code nicht eignen. Grok 4.6 lässt sich am besten anhand der Aufgaben bewerten, die Sie jede Woche wiederholen, und nicht anhand einer einzelnen Ranglistenplatzierung.
Wie schneidet der Grok 4.6 in anerkannten Benchmarks ab?
In der folgenden Tabelle werden die Ergebnisse der xAI-eigenen Modellkarten von den Ergebnissen unabhängiger Messungen getrennt dargestellt. Dies ist von entscheidender Bedeutung, da es sich bei den beiden Terminal-Bench-Werten um unterschiedliche Versionen handelt, die nicht als direkter Vergleich dargestellt werden dürfen.
| Bewerter | Aufgabe / Kennzahl | Ausgewiesenes Ergebnis | Beweisklasse und Verjährung |
|---|---|---|---|
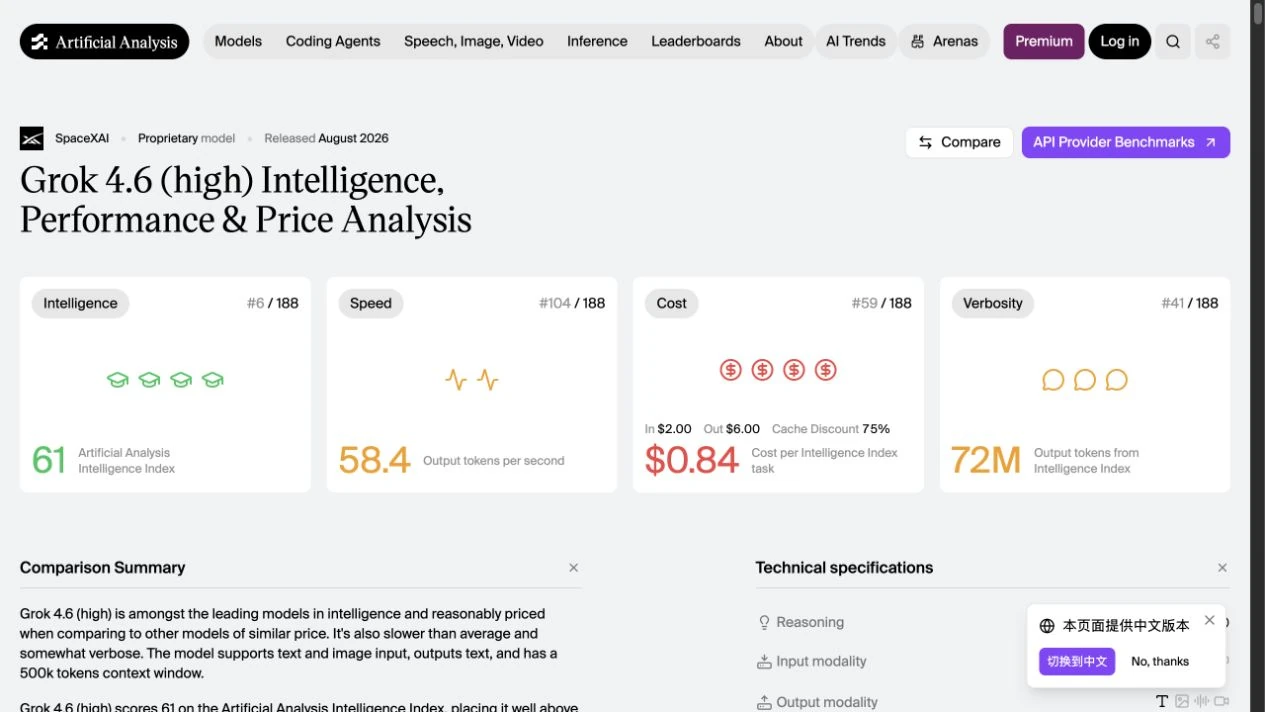
| Künstliche Analyse | Intelligenzindex | 61 (#6 / 188 zum Zeitpunkt der Aufnahme) | Unabhängige Zusammenstellung; bitte die Methodik und das Datum von AA verwenden. |
| Künstliche Analyse | Ausgangsgeschwindigkeit | 58,4 Token pro Sekunde | Unabhängige Geschwindigkeitsmessung; Route und Hardware beeinflussen die Latenz. |
| Künstliche Analyse | Kosten pro Aufklärungsauftrag | $0.84 | Ein Kostenvoranschlag von AA auf Basis des eigenen Aufgabenermischungsverhältnisses; keine xAI-Rechnung. |
| Künstliche Analyse | GDPval-AA v2 | 1753 | Unabhängige Bewertung der Arbeitsleistung. |
| Künstliche Analyse | AA-Aktentasche | 1577 | Unabhängige Bewertung des Arbeitsstils im Wissensbereich. |
| Künstliche Analyse | Terminal-Bench v2.1 | 88.4% | Ergebnis aus „Independent“ v2.1; nicht vergleichbar mit „Terminal-Bench“ 3.0. |
| xAI-Modellkarte | Terminal-Bench 3.0 | 26% | Offizielles Ergebnis der Modellkarte für eine andere Version. |
| Mercor APEX-SWE | Softwareentwicklung | 56,41 TP40T ± 6,21 TP40T | 200 Aufgaben; das Unsicherheitsintervall sollte beibehalten werden. |
| Mercor APEX-Agenten | Aufgaben der Mitarbeiter | 57,51 TP40T ± 3,51 TP40T | 33 Welten / 480 Aufgaben; eine spezifische Agentenbewertung. |
| xAI-Modellkarte | DeepSearchQA | 81.6% | Vom Anbieter gemeldete Qualitätssicherungsbedingungen für die Forschung. |
| xAI-Modellkarte | Häufigkeit von Realitätshalluzinationen | 1.7% | Testbedingung für die Modellkarte, keine allgemeine Fehlerquote. |
Quellen: Artificial Analysis, Mercor APEX-Ranglisten und xAI-Modellkarte. Die Ergebnisse verschiedener Datensätze, Versionen, Aufwandeinstellungen oder Bewerter dürfen nicht miteinander kombiniert werden.
Ist Grok 4.6 besser als Grok 4.5?
Die offizielle Modellkarte liefert keine einfache “Ja”-Antwort, sondern ein gemischtes Ergebnis. Grok 4.6 erzielt ein deutlich höheres DeepSearchQA-Ergebnis, während dieselbe Karte eine höhere Rate an Faktenhalluzinationen aufweist als Grok 4.5. Eine seriöse Bewertung sollte nicht dazu führen, dass ein einzelnes starkes Benchmark-Ergebnis als Beweis für allgemeine Zuverlässigkeit herangezogen wird.
| Offizielle Bewertung | Grok 4,6 | Grok 4,5 | Wie ist das zu interpretieren? |
|---|---|---|---|
| DeepSearchQA | 81.6% | 38.4% | Bei dieser suchorientierten Bewertung wurde ein deutlicher Zuwachs verzeichnet. |
| Häufigkeit von Realitätshalluzinationen | 1.7% | 0.98% | Je niedriger, desto besser; Grok 4,5 ist bei diesem gemeldeten Zustand besser. |
Quelle: xAI Grok 4.6 Model Card. Diese Bewertungen beantworten unterschiedliche Fragen und lassen keinen eindeutigen Sieger erkennen.
Wie schnell, zuverlässig und leistungsfähig ist der Grok 4.6 im praktischen Einsatz?
Die veröffentlichten Erkenntnisse deuten auf ein Modell mit hoher Leistungsfähigkeit hin, doch der Begriff “Leistung” umfasst mehrere Aspekte: Antwortqualität, Latenz, Beibehaltung des Kontexts, Befolgung von Anweisungen und Fehlerbehebung. Bei unserem direkten Zugriff lieferte die Bereitschaftsprüfung den HTTP-Status 200 und BEREIT. Die ersten gültigen Ausgaben für die anderen Aufgaben wurden erfolgreich zurückgegeben, während eine Bearbeitungsanforderung mit Einschränkungen zu einem Ausfall der clientseitigen Infrastruktur führte.
Artificial Analysis bietet über die reinen Leistungsdaten hinaus eine nützliche Realitätsprüfung: Die erfasste Seite zeigt einen Intelligenzindex von 61, eine Ausgabegeschwindigkeit von 58,4 Tokens pro Sekunde und geschätzte Kosten von $0,84 pro Intelligenzaufgabe. Diese Kombination deutet auf ein leistungsfähiges, aber nicht ultraschnelles Modell hin – das sich besser für sinnvolle Arbeit eignet als für belanglose Einzeiler-Antworten.
Dieses gemischte Ergebnis ist hilfreich. Grok 4.6 kann bei strukturierten Aufgaben sehr leistungsfähig sein, doch Anwender in der Produktion sollten auf Wiederholungsregeln, Timeouts und ein Fallback-Modell zurückgreifen, anstatt davon auszugehen, dass sich jede Route identisch verhält.
Wo ist Grok 4.6 am nützlichsten?
Langfristige Programmier- und Produktentwicklungsarbeit
Das Einführungsbeispiel von xAI umfasst die Recherche zu einem Thema, die Analyse von Informationen, die Arbeit an einer Codebasis und die Umsetzung einer Idee in eine ausgereifte Anwendung oder ein fertiges Produkt. Daher eignet sich eine Aufgabe in Feature-Größe besser zur Bewertung als eine einfache „Spielzeug“-Anweisung mit nur einer Funktion. Geben Sie dem Modell ein klar umrissenes Ziel, relevante Dateien, Tests und eine Definition dessen, was als „fertig“ gilt.
Forschungszusammenfassung und Wissensarbeit
Das 500K-Fenster, strukturierte Ausgaben und das überzeugende DeepSearchQA-Ergebnis machen Grok 4.6 zu einem naheliegenden Kandidaten, um ein Quellpaket in einen Kurzbericht umzuwandeln, Unstimmigkeiten abzubilden oder eine Entscheidungstabelle zu extrahieren. Der Quellprüfungs-Test unterstützt diese Verwendung, wenn die Zitierregeln explizit festgelegt sind.
Umfangreiche Berichte und Analysen mehrerer Dokumente
Nutzen Sie das Kontextfenster für Jahresberichte, Transkripte, Richtlinienpakete und Projektverläufe, die andernfalls einen hohen Aufwand beim Aufteilen in Abschnitte erfordern würden. Fragen Sie nach Seiten- oder Abschnittsangaben und überprüfen Sie anschließend die aussagekräftigen Zahlen in den Originaldokumenten.
Bildbasierte Analyse
Die Eingabe von Text und Bildern eignet sich besonders für Screenshots, Grafiken und Diagramme. Dies erweist sich als besonders nützlich, wenn das visuelle Element Teil einer umfassenderen Analyseaufgabe ist, beispielsweise bei der Auswertung eines Dashboards in Verbindung mit schriftlichen geschäftlichen Hintergrundinformationen.
Agentenbasierte Arbeitsabläufe mit klaren Zielen
Funktionsaufrufe und strukturierte Ausgaben unterstützen Arbeitsabläufe wie die Untersuchung eines Problems, den Aufruf eines Tools, die Aktualisierung eines Plans und die Rückgabe eines maschinenlesbaren Ergebnisses. Der sicherste Ausgangspunkt ist eine Aufgabe mit eingeschränkten Berechtigungen, einer klaren Abbruchbedingung und einer objektiven Überprüfung.
| Arbeitsablauf | Warum Grok 4.6 die richtige Wahl ist | Beste Einstiegsaufgabe |
|---|---|---|
| Codierung | xAI-Positionierung sowie Belege aus APEX-SWE und CursorBench | Ein echter Fehler oder eine funktionsrelevante Änderung mit Tests |
| Forschung | 500K-Kontext, strukturierte Ausgabe und DeepSearchQA | Ein durch Quellen belegtes Briefing mit Seitenangaben |
| Lange Dokumente | Großes offizielles Kontextfenster | Ein Jahresbericht oder ein aus mehreren Dokumenten bestehendes Informationspaket |
| Visuelle Analyse | Bildeingabe plus xAI-Positionierung visueller Arbeiten | Ein Bericht mit vielen Diagrammen und schriftlichen Erläuterungen |
| Agenten | Funktionsaufrufe und strukturierte Ausgaben | Eine begrenzte Untersuchung mit einem eindeutigen Prüfer |
Ist Grok 4.6 in der Lage, Recherchen durchzuführen und Fakten zu überprüfen?
Im Quellpaket-Test wurde Grok 4.6 aufgefordert, sechs Behauptungen einzuordnen, ausschließlich zugelassene URLs anzugeben und zwei verlockende Schlussfolgerungen zurückzuweisen.
(1) bestätigt – Die Ankündigung von xAI ist auf den 12. August 2026 datiert und besagt, dass an diesem Tag Grok 4.6 veröffentlicht wird.
(2) bestätigt – In der offiziellen xAI-Modelldokumentation wird die Modell-ID als „grok-4.6“ angegeben.
(3) Bestätigt – In der offiziellen Dokumentation wird ein Kontextfenster von 500.000 angegeben.
(5) Widerlegt – Es handelt sich um unterschiedliche Versionen von Terminal-Bench, die nicht dieselbe Metrik verwenden.
(6) Widerlegt – Die Seite zeigt lediglich einen Eintrag zum Arbeitsbereich, nicht die Einbeziehung in jeden Tarif.
Vollständige Ausgabe von Grok 4.6 anzeigen
| Behauptung | Urteil | Antwort in einem Satz | Quell-URL(s) | Genaue Einschränkung |
|---|---|---|---|---|
| (1) xAI kündigte am 12. August 2026 Grok 4.6 an | bestätigt | Die Ankündigung von xAI ist auf den 12. August 2026 datiert und besagt, dass an diesem Tag Grok 4.6 veröffentlicht wird. | https://x.ai/news/grok-4-6 | Das Paket zitiert nur das Datum und die Zeile zur Veröffentlichung, nicht den vollständigen Beitrag. |
| (2) Die offizielle API-Modell-ID lautet grok-4.6 | bestätigt | In der offiziellen xAI-Modelldokumentation wird die Modell-ID als grok-4.6 angegeben. | https://docs.x.ai/developers/models/grok-4.6 | Die Zusammenfassung von Packet listet keine Aliase oder andere IDs auf. |
| (3) Das offizielle Kontextfenster beträgt 500.000 Token | unterstützt | Die offizielle Dokumentation gibt ein Kontextfenster von 500.000 Token an. | https://docs.x.ai/developers/models/grok-4.6 | In der Paketbeschreibung heißt es “500.000 Kontext”, es wird nicht ausdrücklich von “Tokens” gesprochen. |
| (4) Artificial Analysis hat unabhängig einen Intelligence-Wert von 61 gemessen | unterstützt | AA veröffentlicht einen Intelligence-Index von 61 für Grok 4.6. | https://artificialanalysis.ai/models/grok-4-6 | „Packet“ berichtet über den Wert von AA, nicht über eine separate Prüfung der AA-Methode. |
| (5) Terminal-Bench 3.0 mit 26% und v2.1 mit 88,4% sind direkt vergleichbar | widerlegt | Es handelt sich um unterschiedliche Terminal-Bench-Versionen, die nicht denselben Messwert verwenden. | https://artificialanalysis.ai/models/grok-4-6 ; https://media.x.ai/v1/website/card-4p6-4cd2dc57.pdf | Packet gibt beide Ergebnisse an, jedoch ohne Äquivalenz oder Zuordnungstabelle. |
| (6) Eine Seite mit den Werten GlobalGPT, Grok und 4,6 beweist, dass jeder Tarif das Modell enthält | widerlegt | Die Seite zeigt lediglich einen Eintrag im Workspace, nicht die enthaltene Funktion in jedem Tarif. | https://www.glbgpt.com/home/grok-4-6 | Im Paket selbst wird angegeben, dass es sich um einen Schnittstelleneintrag handelt, nicht um jeden Plan. |
Fazit der Rezension: Es hielt sich gut an die Grenzen der Evidenz, wenn das Format des Quellpakets und der Antwort eindeutig festgelegt waren. Das ist für Forschungsabläufe nützlich, doch die Antwort des Modells bleibt eine Forschungshilfe – und nicht die externe Evidenz selbst.
Die genaue Prüfungsaufgabe anzeigen
Verwenden Sie ausschließlich das beigefügte Quellenpaket. Geben Sie für jeden der sechs Ansprüche eine einzeilige Antwort mit der Angabe „bestätigt“, „widersprochen“ oder „nicht belegt“ sowie die entsprechenden Quell-URLs und die genaue Beschränkung an.
Eignet sich der Grok 4.6 gut zum Programmieren und Debuggen?
Die JavaScript-Aufgabe erforderte einen minimalen Diff, numerische Sortierung, korrekte Behandlung von ungeraden und geraden Medianwerten, Unveränderlichkeit sowie zwei exakte Fehlerbedingungen.
```diff
--- a/median.js
+++ b/median.js
@@ -1 +1,12 @@
-function median(values) { values.sort(); return values[Math.floor(values.length / 2)]; }
+function median(values) {
+  if (!Array.isArray(values)) throw new TypeError();
+  if (values.length === 0) throw new Error("empty input");
+  const sorted = values.slice().sort((a, b) => a - b);
+  const mid = Math.floor(sorted.length / 2);
+  if (sorted.length % 2 === 0) {
+    return (sorted[mid - 1] + sorted[mid]) / 2;
+  }
+  return sorted[mid];
+}Erläuterung anzeigen, die von Grok 4.6 zurückgegeben wird
Das Original hat sein Argument mutiert und die standardmäßige lexikografische Sortierung () verwendet, daher wird mit `slice()` eine Kopie erstellt und diese über `(a, b) => a - b` numerisch sortiert. Nachdem Nicht-Arrays mit einem `TypeError` und leere Arrays mit der Fehlermeldung "empty input" verworfen wurden, ist bei einem Ergebnis ungerader Länge das einzelne mittlere Element das Ergebnis, und bei einem Ergebnis gerader Länge ist es der Durchschnitt der beiden zentralen Werte, also der übliche Median.
Optimale Verwendung: Kleine bis mittelgroße Fehlerbehebung, Erstellen von Tests, Code-Review und Erläuterung einer unbekannten Funktion. Bei einem großen Repository sollten Sie das Modell mit Ihrem eigenen Test-Runner kombinieren und den Diff vor dem Merge überprüfen.
Testbereich anzeigen
Korrigiere `median(values)`, ohne dessen Signatur zu ändern. Die Eingabe darf nicht verändert werden; löse bei Nicht-Arrays einen `TypeError` und bei leeren Arrays einen `Error("empty input")` aus; gib einen minimalen einheitlichen Diff zurück.Ist das 500.000-Zeichen-Kontextfenster bei langen Dokumenten hilfreich?
Eine Abfrage mit mehr als 220.000 Tokens umfasste sieben Felder, Abschnitts- und Seitenangaben sowie eine Erläuterung der beiden „Terminal-Bench“-Versionen.
{
  "release_date": {"value": "12. August 2026", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "locator": "p.2"},
  "context_window": {"value": "500.000 Token", "locator": "p.2"},
  "long_context_input_price": {"value": "$4 pro Million Token (Prompts über 200.000 Token)", "locator": "p.3"},
  "terminal_bench_version": ["3.0", "v2.1"],
  "terminal_bench_score": ["26%", "88,4%"]
}Vollständige Grok 4.6 JSON-Ausgabe anzeigen
{
  "release_date": {"value": "12. August 2026", "section": "xAI-Veröffentlichung", "locator": "p.1"},
  "api_model_id": {"value": "grok-4.6", "section": "API-Modell", "locator": "S. 2"},
  "context_window": {"value": "500.000 Token", "section": "API-Modell", "locator": "S. 2"},
  "long_context_input_price": {"value": "$4 pro Million Token (Prompts über 200.000 Token)", "section": "preise", "locator": "S. 3"},
  "terminal_bench_version": [{"value": "3.0", "section": "Benchmark-Karte", "locator": "S. 4"},{"value": "v2.1", "section": "unabhängiger Benchmark", "locator": "S. 5"}],
  "terminal_bench_score": [{"value": "26%", "section": "Benchmark-Karte", "locator": "S. 4"},{"value": "88,4%", "section": "unabhängiger Benchmark", "locator": "S. 5"}],
  "evidence_limits": {"value": "Die beiden Terminal-Bench-Ergebnisse können nicht miteinander verglichen werden, da es sich um unterschiedliche Benchmark-Versionen handelt. Die Verfügbarkeit im Live-Betrieb wird nicht angegeben.", "section": "unabhängiger Benchmark", "locator": "S. 5"}
}
Was dies beweist: Das Modell kann Informationen aus einem großen, verrauschten Paket unter Einhaltung eines strengen Schemas extrahieren und strukturieren. Was dies nicht beweist: dass jede Anfrage mit 500.000 Token bei einem beliebigen Kundendokument gleichermaßen schnell, kostengünstig und genau ist.
Kann Grok 4.6 strenge Anweisungen befolgen und seine Überlegungen transparent darlegen?
Für ein Zuordnungsrätsel mit Einschränkungen lieferte es die eindeutige Lösung: 7 Stunden Recherche, 9 Stunden Programmierung und 8 Stunden Qualitätssicherung.
{"R":7,"C":9,"Q":8,"total":24,"check":"Die Werte erfüllen die Gleichung R+C+Q=24, wobei C=R+2 und Q=R+1 gilt."}Die genaue Eingabeaufforderung anzeigen
Verteilen Sie 24 Stunden auf Forschung (R), Programmierung (C) und Qualitätssicherung (Q). Geben Sie ausschließlich JSON mit den ganzzahligen Schlüsseln R, C, Q, total und einer einzeiligen Überprüfung zurück. Einschränkungen: R + C + Q = 24; C = R + 2; Q = R + 1. Geben Sie keine versteckten Gedankengänge preis.
Die separate Aufgabe zur eingeschränkten Neufassung lieferte bei zwei Versuchen des Kunden keine API-Antwort. Dies wird als Infrastrukturstörung und nicht als Qualitätsbewertung erfasst. Die praktische Erkenntnis daraus ist, dass für die redaktionelle Produktion immer ein Ausweichweg vorgesehen werden sollte.
Wie viel kostet Grok 4.6?
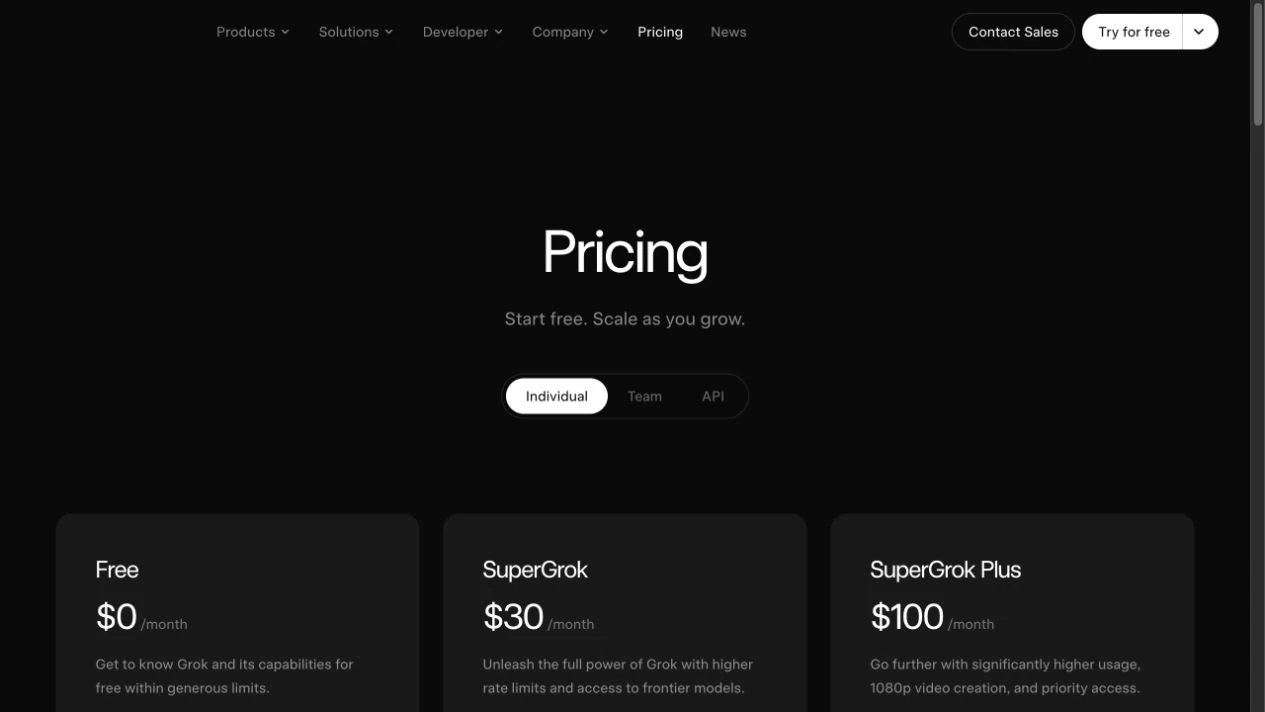
| Option | Aktueller veröffentlichter Preis | Am besten für | Wichtige Grenze |
|---|---|---|---|
| xAI für Privatanwender – kostenlos | $0/Monat | Das native Kundenerlebnis ausprobieren. | Der Zugang zum Free-Tier-Modell und die damit verbundenen Beschränkungen können sich ändern. |
| SuperGrok | $30/Monat | Normale Nutzung durch Verbraucher; auf der aktuellen Seite ist Grok 4.6 aufgeführt. | Überprüfen Sie vor der Veröffentlichung die aktuellen Berechtigungen. |
| SuperGrok Plus | $100/Monat | Intensive Nutzung durch Verbraucher; auf der aktuellen Seite ist Grok 4.6 aufgeführt. | Leiten Sie daraus keine Zugriffsrechte für andere Tarife ab. |
| xAI-API-Basistarif | $2/M-Eingang; $6/M-Ausgang; $0,50/M-Eingang im Cache | Entwickler, die nutzungsbasierte Integrationen erstellen. | Werkzeuge werden gegebenenfalls separat in Rechnung gestellt. |
| xAI-API-Stufe „Long-Context“ | Über 200.000: $4/M-Eingabe; $1/M im Cache; $12/M-Ausgabe | Sehr umfangreiche Eingabeaufforderungen und Dokumente. | Verwenden Sie den Grundpreis nicht für Anfragen über 200.000. |
| GlobalGPT | Aktuelle GlobalGPT-Pläne anzeigen | Vergleich des Grok mit mehreren führenden Modellen in einem Arbeitsbereich. | Gehen Sie nicht davon aus, dass jeder Tarif Grok 4.6 enthält; überprüfen Sie die Tarifseite. |
Was würde eine Grok 4.6-API-Anfrage kosten?
| Beispielanfrage | Berechnung | Geschätzte Kosten pro Modell-Token |
|---|---|---|
| 50K Eingang + 5K Ausgang | 50.000 × $2/M + 5.000 × $6/M | $0.13 |
| 100K Eingang + 10K Ausgang | 100.000 × $2/M + 10.000 × $6/M | $0.26 |
| 250.000 Eingang + 10.000 Ausgang | 250.000 × $4/M + 10.000 × $12/M | $1.12 |
| 400K Eingang + 20K Ausgang | 400.000 × $4/M + 20.000 × $12/M | $1.84 |
Rechenbeispiele unter Verwendung der xAI-Listenpreise. Dabei sind Rabatte für zwischengespeicherte Eingaben, Steuern, Werkzeugkosten und Aufschläge von Drittanbietern nicht berücksichtigt.
GlobalGPT eignet sich besonders gut, wenn Sie sich eher die Frage stellen: “Welches Modell eignet sich am besten für diese Aufgabe?”, als: “Wie kann ich jede Aufgabe einer einzigen API zuweisen?” Sie können Schreib-, Recherche-, Programmier- und Analyseanweisungen in einem Arbeitsbereich vergleichen und dann die Preisseite von GlobalGPT um das Abonnement auszuwählen, das Ihrem Nutzungsbedarf entspricht. Hierbei handelt es sich um eine Empfehlung für ein Abonnement mit mehreren Modellen und nicht um eine Umrechnung von GlobalGPT-Gutschriften in xAI-Token-Preise.
Wie kann man auf Grok 4.6 zugreifen?
Verbraucher können mit den aktuellen Grok-Abonnementoptionen von xAI beginnen. Entwickler sollten die offizielle xAI-API-Dokumentation und die genaue Modell-ID verwenden. grok-4.6. Leser, die Modelle vergleichen möchten, ohne mehrere API-Konten einrichten zu müssen, können den verifizierten Eintrag „Grok 4.6“ im Arbeitsbereich unter GlobalGPT; Der Zugriff auf die Benutzeroberfläche der Plattform sollte nicht mit jeder nativen xAI-Funktion verwechselt werden.
Was sind die wichtigsten Einschränkungen des Grok 4.6?
- Aktuelle Informationen müssen noch belegt werden: Der Stichtag für die Vorbereitungsschulung im Januar 2026 ist keine Garantie für fundiertes Wissen.
- Schlagzeilen zu Benchmark-Ergebnissen können irreführend sein: Version, Bewerter, Aufwand für die Begründung und Datensatz müssen jedem Ergebnis zugeordnet bleiben.
- Ein langer Kontext kostet mehr: Befehle mit mehr als 200.000 Token nutzen die höhere API-Stufe mit großem Kontext.
- Die Zuverlässigkeit der Strecke variiert: Bei unserer Anfrage zur eingeschränkten Bearbeitung ist ein Infrastrukturfehler aufgetreten, obwohl andere Aufgaben erfolgreich ausgeführt wurden.
- Der Zugang zu den Plattformen ist nicht identisch: Ein GlobalGPT-Workspace-Eintrag beinhaltet nicht zwangsläufig alle nativen xAI-Funktionen oder alle Abonnementansprüche.
Sollten Sie sich für Grok 4.6 oder ein anderes KI-Modell entscheiden?
Wählen Sie Grok 4.6, wenn ein umfangreicher Kontext, Programmierung und strukturiertes Denken im Mittelpunkt der Arbeit stehen. Wählen Sie ein anderes Modell, wenn Ihre Hauptpriorität ein bestimmtes Tool-Ökosystem, niedrigere, besser vorhersehbare Kosten, eine bestimmte multimodale Ausgabe oder ein Workflow ist, den Ihr Team bereits gut unterstützt. Der fairste Vergleich erfolgt mit derselben Eingabe, demselben Quellpaket und demselben Checker für alle Modelle – was mit GlobalGPT einfach zu organisieren ist.
Für wen ist Grok 4.6 geeignet?
- Forscher und Analysten: Quellpakete, Beweistabellen und umfangreiche Schriftsätze.
- Entwickler: Fehlerbehebung, Code-Review und strukturierte Implementierungspläne.
- Autoren und Redakteure: Das Verfassen längerer Texte, wenn Sie klare Vorgaben und einen Stilleitfaden bereitstellen.
- Teams, die Modelle vergleichen: wiederholbare Auswertungen mit derselben Eingabeaufforderung in einem Arbeitsbereich.
Was fragen Leser normalerweise zum Grok 4.6?
Ist Grok 4.6 offiziell veröffentlicht worden?
Ja. Die Ankündigung der Veröffentlichung von xAI stammt vom 12. August 2026.
Wie lautet die offizielle API-Modell-ID?
grok-4.6.
Was ist das Kontextfenster?
xAI dokumentiert ein Kontextfenster von 500.000 Token.
Unterstützt das Modell Grok 4.6 Bilder?
Ja. In der offiziellen Modelldokumentation werden Bild-Eingaben und Text-Ausgaben aufgeführt.
Wie viel kostet Grok 4.6?
Auf der aktuellen Kundenseite werden „Free“ für $0/Monat, „SuperGrok“ für $30/Monat und „SuperGrok Plus“ für $100/Monat angezeigt. Die API-Preise richten sich nach der Nutzung und es gibt eine separate Preisstufe für lange Kontexte ab 200.000 Token.
Ist Grok 4.6 besser als Grok 4.5?
Es ist neuer und schneidet bei mehreren zitierten Bewertungen sehr gut ab, allerdings unterscheiden sich die Aufgaben und die Benchmark-Versionen. Testen Sie Ihren eigenen wiederkehrenden Arbeitsablauf.
Kann ich Grok 4,6 in GlobalGPT verwenden?
GlobalGPT enthält einen gerenderten Eintrag für den Arbeitsbereich Grok 4.6. Überprüfen Sie die aktuellen Planberechtigungen auf der Preisseite.
Ist Grok 4.6 für Forschungszwecke zuverlässig?
Im Test mit eingeschränkten Quellpaketen hat es gut abgeschnitten, doch wichtige Behauptungen sollten stets anhand der zitierten Quelle überprüft werden.
Lohnt es sich, Grok 4.6 im Jahr 2026 zu verwenden?
Grok 4.6 ist ein zuverlässiges, offiziell veröffentlichtes Modell mit einem nützlichen Kontextfenster von 500.000 Zeichen, konfigurierbarer Schlussfolgerungslogik, soliden veröffentlichten Benchmark-Ergebnissen und guten ersten Ergebnissen bei strukturierten Rechercheaufgaben und Aufgaben mit langen Dokumenten. Seine Schwächen sind ebenso praktischer Natur: Benchmark-Werte erfordern sorgfältige Versionskennzeichnungen, Live-Fakten benötigen weiterhin Quellenangaben, und die Zuverlässigkeit der Routenführung kann variieren.
Für den nativen Benutzerzugriff oder die API-Entwicklung sollten Sie mit der aktuellen Dokumentation von xAI beginnen. Für einen vergleichbasierten Arbeitsablauf, Versuche Grok 4,6 in GlobalGPT Wählen Sie neben anderen führenden Modellen den Tarif aus, der am besten zu Ihrem Arbeitsaufwand in den Bereichen Schreiben, Recherche, Analyse oder Programmierung passt.
Primärquellen: xAI-Veröffentlichung, Dokumentation zu xAI-Modellen, Preise für die xAI-API, xAI-Preise für Privatkunden, Künstliche Analyse, Mercor APEX-SWE und die xAI-Modellkarte.