DeepSeek V4.1 Flash ist die am 10. September 2026 veröffentlichte Version von DeepSeek, die native Bildeingabe, einen geringeren Cache-Speicherbedarf, bessere von Anbietern gemeldete Agent-Bewertungen und niedrigere API-Raten bietet. Es eignet sich am besten für Entwickler, die Agenten mit hohem Datenaufkommen oder hohem Eingabeaufwand betreiben. Der wichtigste Vorbehalt: DeepSeek hat die veröffentlichten Benchmarks durchgeführt, und V4 Pro liegt bei ausgewählten Tests zur Frontier-Argumentation weiterhin an der Spitze.

Was ist DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash ist ein multimodales Modell mit offenen Gewichten, das für die Codierung, den Werkzeuggebrauch, das visuelle Verständnis und Arbeitsabläufe von Agenten mit langem Kontext entwickelt wurde. DeepSeek hat es am 10. September 2026 veröffentlicht und veröffentlicht die Gewichte als DeepSeek-V4.1-Flash, und stellt das gehostete Modell über die deepseek-flash API-Name.
Diese Version ist von Bedeutung, da sie mehr als nur die Benchmark-Ergebnisse verändert. Flash kann Text und Bilder verarbeiten, bietet ein Kontextfenster mit einer Million Tokens und reduziert den für seinen Schlüssel-Wert-Cache benötigten Speicherplatz erheblich. DeepSeek hat zudem die Preise für seine gehostete API im Vergleich zum auslaufenden V4-Pro-Tarif gesenkt. Diese Kombination zielt auf einen praktischen Engpass ab: die Erschwinglichkeit lang laufender Agenten zu gewährleisten, wenn sich Eingabeaufforderungen, Repository-Kontext, Screenshots und Tool-Verlauf ansammeln.
deepseek-flashDer „Thinking“-Modus ist standardmäßig aktiviert, es steht jedoch auch ein „Non-Thinking“-Modus zur Verfügung. JSON-Ausgabe und Tool-Aufrufe werden unterstützt. DeepSeek bietet zudem Kompatibilität mit der Responses-API und der Anthropic-API, was den Migrationsaufwand für Anwendungen verringert, die bereits auf diesen Schnittstellen basieren.
Was ist neu in DeepSeek V4.1 Flash?
Ein 552B MoE-Backbone mit asymmetrischer Rechenleistung
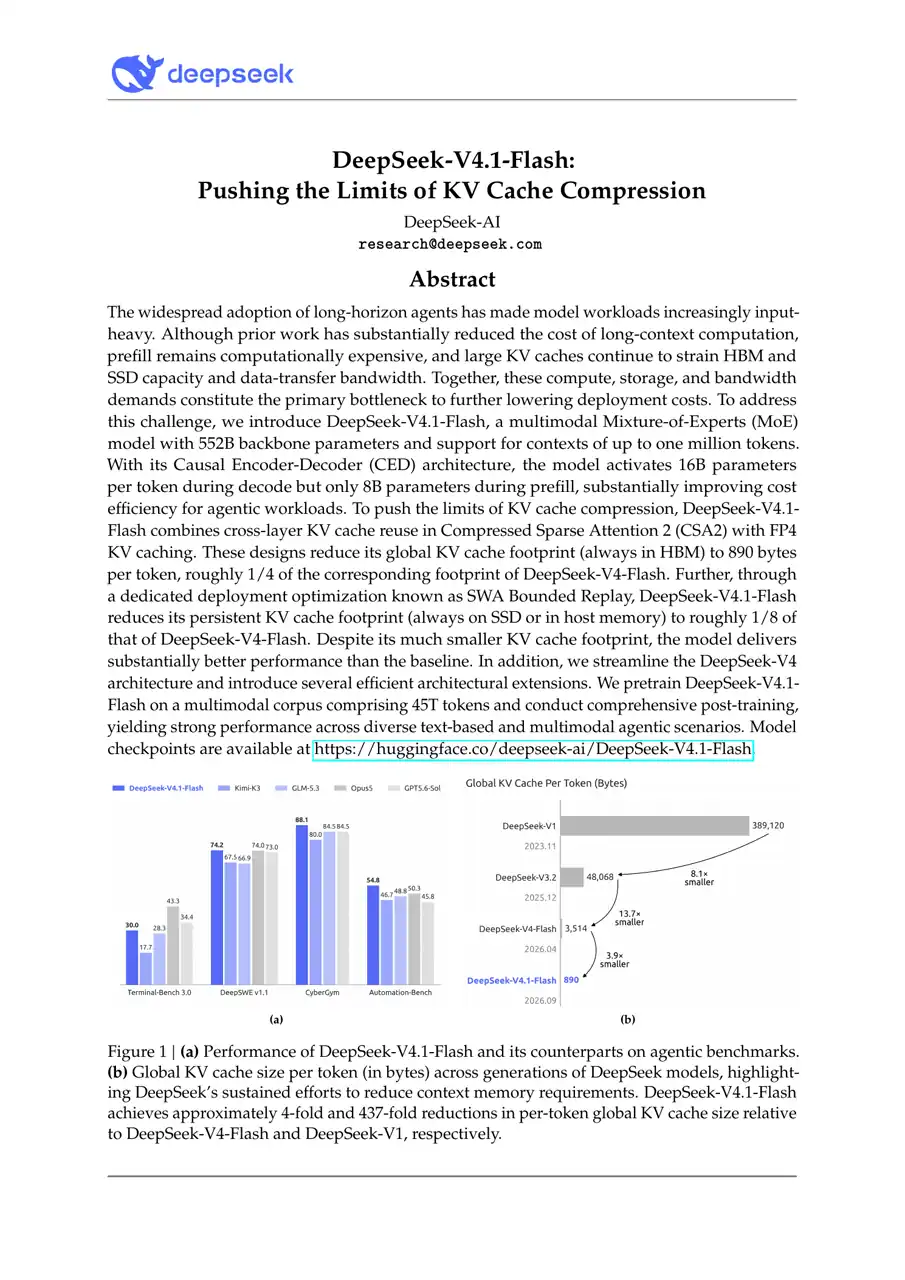
Nach Angaben der Technischer Bericht DeepSeek V4.1, Das Modell verwendet ein „Mixture-of-Experts“-Backbone mit 552 Milliarden Parametern, bestehend aus einem 20-schichtigen kausalen Encoder und einem 20-schichtigen Decoder. Die Gesamtanzahl der Parameter entspricht nicht der Anzahl, die für jedes Token verwendet wird: DeepSeek meldet etwa 8 Milliarden aktive Parameter während der Vorabfüllung und 16 Milliarden während der Dekodierung.
Durch dieses asymmetrische Design stehen für das „Prefill“ und die Generierung unterschiedliche Rechenbudgets zur Verfügung. Das „Prefill“ ist die Phase, in der die Eingabeaufforderung, Dokumente, Bilder und frühere Konversationen verarbeitet werden; bei der Dekodierung wird die Antwort Token für Token erzeugt. Der geringere aktive Rechenaufwand während des „Prefill“ ist besonders relevant für Workloads im Repository-Maßstab und für Forschungsagenten, bei denen vor dem Schreiben ein hoher Aufwand für das Lesen anfällt.
Ein deutlich kleinerer KV-Cache
Der Bericht gibt eine globale KV-Cache-Größe von 890 Byte pro Token, was etwa einem Viertel des Caches von V4 Flash im High-Bandwidth-Memory entspricht. Laut DeepSeek beträgt der Bedarf an persistenten Cache etwa ein Achtel des Wertes der Vorgängergeneration. Bei einem Kontext mit einer Million Tokens handelt es sich hierbei eher um ein Einsatzmerkmal als um ein abstraktes Architekturdetail: Die Cache-Größe beeinflusst, wie viele lange Sitzungen ein Server verwalten kann und wie viel Speicher jede einzelne davon beansprucht.
Native Bilddateneingabe und multimodales Vortraining
V4.1 Flash verarbeitet Bilder nativ, anstatt einen separaten Endpunkt der Marke „Vision“ zu verwenden. Laut DeepSeek wurde das Modell auf einem multimodalen Korpus mit 45 Billionen Token vortrainiert. In der Praxis bedeutet dies, dass Screenshots, Diagramme, gescannte Tabellen, Schnittstellenzustände und visuelle Debugging-Eingaben ebenso Teil derselben Agentenkonversation sind wie Code und Text.
Ein 1M-Token-Kontext kann große Repositorien, umfangreiche Dokumentensätze und einen umfangreichen Agentenverlauf enthalten, vorbehaltlich der kombinierten Eingabe-Ausgabe-Beschränkung.
JPEG-, PNG-, GIF- und WebP-Dateien können mit Text kombiniert werden, um Tabellen zu extrahieren, Screenshots zu analysieren und visuelle Fragen zu beantworten.
Dank Tool-Aufruf, strukturierter JSON-Ausgabe und agentenorientiertem Training eignet sich das Modell für Arbeitsabläufe, bei denen geprüft, entschieden und der Zustand geändert werden muss.
DeepSeek V4.1-Benchmarks: Was die offiziellen Ergebnisse zeigen
Die überzeugendsten Argumente für DeepSeek V4.1 Flash konzentrieren sich auf Coding- und Agent-Benchmarks. Der Anbieter bewertete das Instruct-Modell mit einem experimentellen Aufwand von 100, der öffentlich als maximaler Reasoning-Aufwand angegeben wurde, unter Verwendung von Temperatur=1,0 und top_p=0,95. Bei den Code-Agent-Tests kamen benannte Testumgebungen und ein Kontext mit einer Million Token zum Einsatz; bei den Visual-Agent-Tests wurde der Claude-Code mit einem Kontext von 512.000 Token verwendet.
| Benchmark | V4.1 Flash | V4 Pro | V4 Flash | Anführer |
|---|---|---|---|---|
| Codeforces Bewertung | 3471 | 3348 | 3289 | V4.1 Flash |
| Terminal-Bench 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 beschlossen | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Automatisierungs-Prüfstand Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| GPQA Diamant Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE – Nur Text Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Quelle: Technischer Bericht „DeepSeek V4.1“, Tabelle 3. Innerhalb jeder Zeile gilt: Je höher, desto besser. „Codeforces“ ist eine Wertung; die anderen angezeigten Werte basieren auf den im Bericht genannten prozentualen Kennzahlen. Vergleichen Sie die Werte nicht zeilenübergreifend.

Das Muster ist zwar nützlich, aber weniger umfassend als die pauschale Behauptung, es handele sich um ein “besseres Modell”. V4.1 Flash liegt in den fünf oben dargestellten Bereichen – Programmierung, Terminal, Sicherheit und Automatisierung – vor V4 Pro. Bei „GPQA Diamond“ und der rein textbasierten Teilmenge von „Humanity’s Last Exam“ liegt V4 Pro weiterhin vorn. Entwickler, die eine breitere Auswahl an Codierungsmodellen vergleichen möchten, können unsere Leitfaden zum besten KI-Modell für die Programmierung, aber die Bewertung auf Anwendungsebene ist nach wie vor wichtiger als eine einzige Tabelle.
Der Aufwand für die Schlussfolgerung wirkt sich ebenfalls auf Kosten und Ergebnis aus. Im Bericht von DeepSeek führte eine Erhöhung des experimentellen Aufwands von 25 auf 100 dazu, dass DeepSWE v1.1 von 66,0 auf 74,2 und Terminal-Bench 2.1 von 82,4 auf 90,6 stieg, wobei etwa 2,5-mal so viele Ausgabetoken verbraucht wurden. Die acht Agentenkonfigurationen des Berichts lieferten zudem wesentlich unterschiedliche Ergebnisse ausgehend vom selben Checkpoint, sodass die Wahl des Frameworks Teil des gemessenen Systems ist.
Laut DeepSeek ist die Robustheit gegenüber extremen Eingaben noch nicht vollständig charakterisiert. Der Bericht weist darauf hin, dass Fehler bei der CSA2-Auswahl und die ungefähre Rekonstruktion des Zustands mittels „Sliding-Window-Attention“ die Leistungsfähigkeit in Grenzfällen außerhalb der Testsuite beeinträchtigen können. Außerdem wird eingeräumt, dass bei den anspruchsvollsten Aufgaben im Bereich des „Frontier Reasoning“ und bei Randfällen noch Lücken bestehen. Diese Einschränkungen sollten bei der Interpretation der Gesamtwerte berücksichtigt werden.
Zwei reproduzierbare Aufgaben zur Bewertung von V4.1 Flash
Die folgenden Aufgaben testen konkrete Verhaltensweisen, ohne eine nicht ausgeführte Eingabeaufforderung als Beleg anzugeben. Verwenden Sie die genaue Eingabeaufforderung, halten Sie die Modell- und Aufwands-Einstellungen in Ihrem Protokoll fest und bewerten Sie die Antwort anhand der aufgeführten Kriterien. Die Ergebnisse eines Durchlaufs sollten als datierte Beobachtung und nicht als allgemeiner Maßstab ausgewiesen werden.
DeepSeek V4.1 – Flash-Preise
Die Preisgestaltung der DeepSeek-API basiert auf zwei Tarifen, und alle nachstehenden Angaben lauten in US-Dollar pro einer Million Token. Zu den Spitzenzeiten gehören Montag bis Freitag von 01:00 bis 04:00 Uhr UTC und von 06:00 bis 10:00 Uhr UTC. Alle anderen Zeiten gelten als Nebenzeiten. Zwischengespeicherte Eingaben, nicht zwischengespeicherte Eingaben und Ausgaben werden zu unterschiedlichen Tarifen abgerechnet.
Günstigste Preise für gehostete APIs
- Zwischengespeicherte Eingabe
- $0.003
- Nicht zwischengespeicherte Eingabe
- $0.15
- Ausgabe
- $0.60
Pro 1 Million Token; außerhalb der Spitzenzeiten an Werktagen.
Das Doppelte des Nebenzeittarifs
- Zwischengespeicherte Eingabe
- $0.006
- Nicht zwischengespeicherte Eingabe
- $0.30
- Ausgabe
- $1.20
Pro 1 Mio. Token; werktags von 01:00 bis 04:00 Uhr und von 06:00 bis 10:00 Uhr UTC.
Ein einfaches Rechenbeispiel: Eine Anfrage außerhalb der Spitzenzeiten mit 800.000 nicht zwischengespeicherten Eingabetoken und 20.000 Ausgabetoken würde etwa $0.132: $0,12 für die Eingabe plus $0,012 für die Ausgabe. Die gleiche Anzahl an Tokens bei Spitzenpreisen würde etwa $0.264 kosten. Diese Berechnung dient nur zur Veranschaulichung und stellt keine gemessene Arbeitslastabrechnung dar; Cache-Treffer, Wiederholungsversuche, Tool-Durchläufe und die Länge der Schlussfolgerungen beeinflussen den Gesamtbetrag.
Zwischengespeicherte Eingaben sind in beiden Tarifen fünfzigmal günstiger als nicht zwischengespeicherte Eingaben, wodurch stabile Prompt-Präfixe und wiederverwendbarer Kontext wirtschaftlich von Bedeutung sind. Der öffentliche DeepSeek-API-Tarif ist unabhängig vom GlobalGPT-Zugang und der Abrechnung. Diese Token-Preise sind nicht als Preise für ein GlobalGPT-Abonnement oder Guthaben zu verstehen.
DeepSeek V4.1 – API, Vision und Grenzen
Die direkte DeepSeek-API verwendet deepseek-flash. Entwickler können den Standard-Endpunkt unter https://api.deepseek.com, die Responses-API auf derselben Basis oder die Anthropic-kompatible Basis unter https://api.deepseek.com/anthropic. Funktionswerkzeuge werden in „Responses“ unterstützt. DeepSeek dokumentiert zudem die Patch anwenden Benutzerdefiniertes Tool; andere integrierte Antworttypen werden ignoriert und nicht ausgeführt.
deepseek-flashStandardmäßig ist die Denkfunktion aktiviert; es stehen die Voreinstellungen „niedrig“, „hoch“ und „maximal“ zur Verfügung.
Wählen Sie die Kompatibilitätsschicht aus, die zur vorhandenen Anwendung passt.
Die Gesamtlänge der Ein- und Ausgabe muss innerhalb des Kontextfensters von 1 Million Token bleiben.
Formate für Bildmotive und Platzierungsregeln
DeepSeek unterstützt die Bildformate JPEG, PNG, GIF und WebP. Ein Inline-Bild darf bis zu 32 MiB groß sein, während ein Dateibild bis zu 64 MiB groß sein darf. Die dokumentierte gemeinsame Obergrenze erlaubt bis zu 600 Bilder in einer Anfrage. Diese Obergrenze ist keine Empfehlung: Große Stapel erhöhen die Prompt-Größe, die Latenz und erschweren die Rückverfolgung, welches Bild eine Antwort unterstützt hat.
Bei der Responses-API gehören Bildinhalte in die Benutzernachrichten. Bilder, die in System oder Assistent Die Nachrichten geben den HTTP-Status 400 zurück. Die Kompatibilitätsschicht akzeptiert keine allgemeinen Dateieingaben als Eingabeelemente. Daher sollten Anwendungen die dokumentierten „image-input“-Formate verwenden, anstatt von einer vollständigen Funktionsübereinstimmung mit OpenAI-Antworten auszugehen.
Kontext-, Ausgabe- und Parallelitätsbeschränkungen
Der maximale Kontext umfasst eine Million Token, und die maximale Ausgabe beträgt 384.000 Token. Eingabe und Ausgabe müssen zusammen in das Kontextfenster passen. Flash erlaubt 2.500 gleichzeitige Verbindungen pro Konto; Anfragen, die dieses Kontolimit überschreiten, erhalten den HTTP-Status 429. Bei der Kapazitätsplanung sollten daher die Auslastung der aktiven Verbindungen und das Wiederholungsverhalten berücksichtigt werden.
DeepSeek V4.1 Flash vs. V4 Pro
V4.1 Flash ist die praktischere Standardwahl für Codieragenten mit hohem Durchsatz, visuelle Eingaben und Anwendungen mit langem Kontext. V4 Pro bleibt während des kurzen Übergangszeitraums als Referenz für Schlussfolgerungen relevant, unterstützt jedoch keine Bildverarbeitung und weist eine geringere dokumentierte Parallelität auf. Unsere frühere Testbericht zum DeepSeek V4 Pro behandelt diesen Prüfpunkt nach eigenen Maßstäben; die dabei erzielten praktischen Ergebnisse sollten nicht als Belege für V4.1 umgewertet werden.
| Entscheidungsfaktor | V4.1 Flash | V4 Pro vor der Routenänderung |
|---|---|---|
| Beste Passform | Agenten, Programmierung, umfangreiche Eingaben, Bildverarbeitung | Ausgewählte Aufgaben zur logischen Schlussfolgerung |
| Bildeingabe | Unterstützt | Nicht unterstützt |
| Parallelität/Konto | 2.500 Verbindungen | 500 Verbindungen |
| Eingabe außerhalb der Spitzenzeiten, nicht im Cache gespeichert | $0,15 / 1M | $0,66 / 1M |
| Leistung außerhalb der Spitzenzeiten | $0,60 / 1M | $1,98 / 1M |
| Offizielles Bewertungsschema | Anzeigen von Leads in Makler-/Kodierungszeilen | Leads GPQA Diamond und HLE (nur Text) |
Bei den Preisen handelt es sich um DeepSeek-API-Tarife, nicht um GlobalGPT-Preise. Vor der angekündigten Routing-Änderung am 14. September gelten die Pro-Tarife.
Zu Nebenzeittarifen ist der nicht zwischengespeicherte Flash-Eingabeverkehr etwa 77% günstiger als der angegebene Pro-Tarif, und der Flash-Ausgabeverkehr ist etwa 70% günstiger. Diese Prozentsätze sind rechnerisch aus dem offiziellen Tarif abgeleitet und stellen keine gemessenen Einsparungen dar. Die tatsächlichen Einsparungen hängen von der Cache-Wiederverwendung, der Ausgabelänge, Wiederholungsversuchen und davon ab, ob die Arbeitslast die leistungsstärkeren Ergebnisse von „Pro“ für die ausgewählten Schlussfolgerungszeilen benötigt.
Die dringlichere Unterscheidung ist operativer Natur. DeepSeek behält die deepseek-v4-pro Name, während das dahinterstehende Modell vorübergehend geändert wird. Ein stabiler API-Name garantiert kein stabiles Ausgabeverhalten. Speichern Sie repräsentative V4 Pro-Antworten, Tool-Traces, Latenzwerte und Fehlerfälle vor dem 14. September und führen Sie anschließend dieselbe Abnahmesuite nach den Routing-Änderungen aus. Informationen zum älteren Checkpoint-Vergleichs-Framework finden Sie unter DeepSeek V4 Pro vs. Flash.
Was Entwickler sagen
Die ersten Reaktionen hinsichtlich Durchsatz, Cache-Effizienz und Agenten-Bewertungen sind positiv, doch die Belege sind uneinheitlich. Einige Kommentare beziehen sich eher auf einen Vorschau-Endpunkt als auf den endgültigen Produktions-Checkpoint, und manche Berichte fassen Vorführungen zusammen, anstatt kontrollierte Tests zu beschreiben. Die nützlichste öffentliche Diskussion dreht sich daher darum, wo getestet werden soll, und nicht darum, ob eine einzige Zahl vom Tag der Markteinführung die Entscheidung endgültig besiegelt.
Die Analyse zur Einführung empfiehlt, eine V4 Pro-Basisversion beizubehalten und das veröffentlichte Flash-Modell vor der Routing-Änderung am 14. September zu testen. Außerdem wird betont, dass die Leistungssteigerungen je nach Benchmark, Framework und Einstellungsoptionen variieren.
Lesen Sie die AnalyseIn einer Zusammenfassung der Vorab-Demonstrationen auf der „World of AI“ hob die Publikation eine beobachtete Spitzengeschwindigkeit von 427 Tokens pro Sekunde hervor und wies auf Überdenken sowie ein schwächeres Verhalten bei der Physiksimulation hin. Dies ist keine offizielle Geschwindigkeitsgarantie.
Lesen Sie den Vorschau-ArtikelIm Thread zur Einführung sprach sich der Kommentator dagegen aus, validierte Pro-Workflows stillschweigend an ein anderes Modell weiterzuleiten, und plädierte für eine festgelegte Auslaufphase. Dies ist eine namentlich genannte Meinung aus der Community, kein Konsens.
Kommentar öffnenDer AI-Pentest-Leiter von Aikido berichtete über Verbesserungen beim „Single-Run-Recall“, beim „Pass@3-Recall“, bei der Präzision und bei der Cache-Trefferquote in einem Cybersicherheits-Benchmark. In seinem Beitrag wird ein Endpunkt aus einer bald ablaufenden Vorschauversion genannt, daher gilt dies nicht als Nachweis für den endgültigen Checkpoint.
Vorschau des Berichts anzeigenDiese Reaktionen weisen auf drei Überprüfungen hin, die bei jeder realen Bereitstellung durchgeführt werden sollten: Vergleichen Sie die Ausgabequalität bei festgelegter Aufwandseinstellung, beobachten Sie, ob lange Schlussfolgerungsketten die Ausgabekosten in die Höhe treiben, und führen Sie Regressionsfälle erneut durch, wenn ein Alias das Modell hinter einem Endpunkt verändert. Vorschau-Ergebnisse zu Durchsatz und Sicherheit können als Orientierung für die Testgestaltung dienen, sollten jedoch nicht mit Tabelle 3 aus DeepSeek kombiniert werden, als stammten sie aus einem einzigen kontrollierten Benchmark.
So greifen Sie auf den DeepSeek V4.1-Flash-Speicher zu
Es gibt drei verschiedene Zugangswege. Wählen Sie den für Sie passenden Weg aus, je nachdem, ob Sie direkte API-Steuerung, selbst gehostete Gewichte oder einen Browser-Arbeitsbereich benötigen, der den Modellwechsel erleichtert. Die Nutzungsbedingungen, Preise und die betriebliche Verantwortung unterscheiden sich je nach Zugangsweg.
DeepSeek-API
Verwenden Sie die offizielle deepseek-flash Modell für native, Responses- oder Anthropic-kompatible Integrationen.
Offene Gewichte
Laden Sie die Modellkarte und die unter der MIT-Lizenz stehenden Gewichte herunter. Überprüfen Sie vor dem Commit die Unterstützung durch den Serving-Stack und die Infrastrukturanforderungen.
Das Modell-Repository öffnenGlobalGPT
Verwenden Sie den speziellen V4.1-Flash-Eintrag innerhalb eines modellübergreifenden Arbeitsbereichs. Die Abrechnung für GlobalGPT erfolgt getrennt vom API-Tarif von DeepSeek.
Probieren Sie DeepSeek V4.1 Flash aus
Die direkte API ist die naheliegendste Wahl, wenn Sie programmatische Steuerungsmöglichkeiten, eine Nutzungsprotokollierung und Zugriff auf die dokumentierten Schnittstellen von DeepSeek benötigen. „Open Weights“ sind für Teams gedacht, die die Inferenzunterstützung validieren und ein sehr großes MoE-Modell betreiben können. GlobalGPT ist der reibungslosere Weg für die interaktive Nutzung und für Vergleiche innerhalb einer All-in-One-Workflow für KI-Modelle.
In dem offiziellen Ankündigungsbeitrag zu DeepSeek heißt es, dass das Unternehmen bei der Unterstützung von Inferenzverfahren mit der Open-Source-Community zusammenarbeiten und weitere Bereitstellungsoptionen ausloten wird. Betrachten Sie dies als eine Aussage zur Roadmap und nicht als Beweis dafür, dass jeder lokale Serving-Stack V4.1 Flash bereits effizient unterstützt.
Für wen ist der DeepSeek V4.1-Flash geeignet?
Priorisieren Sie „V4.1 Flash“, wenn Terminalarbeit, Repository-Navigation, Automatisierung, Tool-Nutzung und lange Eingabeaufforderungen im Vordergrund stehen. Die offiziellen Agent-Ergebnisse und die geringeren Eingaberaten rechtfertigen einen arbeitslastspezifischen Pilotversuch.
Dank der Möglichkeit, Bilder im Originalformat einzuspielen, ist Flash die praktischere Wahl als V4 Pro für Screenshots, Diagramme, Tabellen und Screenshots von Benutzeroberflächen. Überprüfen Sie die Genauigkeit der Extraktion anhand bekannter Antworten.
V4 Pro liegt bei den angezeigten reinen Textzeilen „GPQA Diamond“ und „HLE“ an der Spitze. Vergleichen Sie die festen Eingabeaufforderungen und Aufwandeinstellungen, bevor Sie einen validierten Schlussfolgerungs-Workflow ersetzen.
Die MIT-Lizenz ist zwar großzügig, aber ein 552B-MoE-Backbone ist kein leichtgewichtiges lokales Modell. Überprüfen Sie die Hardware, die Cache-Strategie, die Quantisierung und die Unterstützung für das Serving.
Für eine umfassendere Modellauswahl gilt die Vergleich zwischen GPT-5.5 und DeepSeek V4 stellt den Kontext mit einer Million Token und die Preisposition neben eine andere Frontier-Option. Teams, die sich auf den Code-Output-Stil konzentrieren, können zudem die DeepSeek vs. ChatGPT – Python-Code-Test. Diese Artikel beantworten damit zusammenhängende Fragen; keiner von beiden ersetzt jedoch die Überprüfung des genauen Flash-Endpunkts der Version 4.1, der in der Produktion verwendet wird.
Normale Nutzer, die sich zwischen verschiedenen Ökosystemen entscheiden müssen, könnten das breitere Vergleich zwischen DeepSeek und ChatGPT nützlicher als eine Überprüfung auf Architekturebene. V4.1 Flash überzeugt am meisten, wenn sich seine spezifischen Vorteile – lange Eingaben, Bildverständnis, Werkzeuge und geringe Token-Kosten – auf einen konkreten Arbeitsablauf übertragen lassen.
Urteil
Die niedrigeren API-Tarife, der 1-M-Kontext, die native Bild-Eingabe, das Kontingent von 2.500 Verbindungen sowie die von DeepSeek gemeldeten Agent-Gewinne sprechen eindeutig für eine Evaluierung. Es handelt sich jedoch nicht um einen universellen Ersatz für die Pro-Version: V4 Pro ist in ausgewählten Bereichen der Argumentation weiterhin führend, „Maximum-Effort“-Ergebnisse erfordern eine höhere Anzahl an Ausgabe-Token, und Änderungen beim Endpunkt-Routing können das validierte Verhalten beeinflussen.
DeepSeek V4.1-Flash-Speicher im GlobalGPT öffnenBeginnen Sie mit einer kleinen Akzeptanztestreihe: einer repräsentativen Programmieraufgabe, einer bildbasierten Extraktionsaufgabe, einem Fall mit langem Kontext und einem Tool-Workflow. Legen Sie die Einstellungen für die Schlussfolgerung fest, zeichnen Sie den Modellablauf auf und vergleichen Sie sowohl die Fehlermodi als auch die durchschnittliche Qualität. So gelangen Sie zu einer Entscheidung, die Sie verteidigen können, ohne die Benchmarks der Anbieter oder die Reaktionen am Tag der Markteinführung als garantierte Anwendungsleistung zu betrachten.
Häufig gestellte Fragen
Was ist DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash ist ein multimodales „Mixture-of-Experts“-Modell mit offenen Gewichten, das am 10. September 2026 veröffentlicht wurde. Es unterstützt Text- und Bildeingaben, Textausgaben, ein Kontextfenster von einer Million Token, einen „Thinking“- und einen „Non-Thinking“-Modus, JSON-Ausgaben sowie Tool-Aufrufe.
Wie viel kostet die DeepSeek V4.1 Flash-API?
Die API-Tarife außerhalb der Spitzenzeiten für DeepSeek betragen $0,003 pro 1 Mio. zwischengespeicherte Eingabetoken, $0,15 pro 1 Mio. nicht zwischengespeicherte Eingabetoken und $0,60 pro 1 Mio. Ausgabetoken. Die Spitzenraten betragen $0,006, $0,30 bzw. $1,20. Hierbei handelt es sich um DeepSeek-API-Preise, nicht um GlobalGPT-Preise.
Welchen API-Modellnamen sollte ich für den DeepSeek V4.1 Flash verwenden?
Verwenden Sie deepseek-flash mit der offiziellen DeepSeek-API. DeepSeek unterstützt außerdem Responses-API-Aufrufe unter https://api.deepseek.com sowie Anthropic-kompatible Anrufe unter https://api.deepseek.com/anthropic.
Wie lauten die Einschränkungen hinsichtlich Kontext, Ausgabe und Parallelität?
DeepSeek V4.1 Flash verfügt über ein Kontextfenster von einer Million Token und eine maximale Ausgabe von 384.000 Token; Eingabe und Ausgabe müssen zusammen in das Kontextfenster passen. DeepSeek unterstützt 2.500 gleichzeitige Verbindungen pro Konto; bei Überschreitung dieses Limits wird der HTTP-Statuscode 429 zurückgegeben.
Ist der DeepSeek V4.1 Flash besser als der V4 Pro?
Das hängt von der jeweiligen Aufgabe ab. In der vom Anbieter DeepSeek erstellten Tabelle liegt V4.1 Flash bei den angezeigten Benchmarks für Codierung, Terminal, Sicherheit und Automatisierung vor V4 Pro, während V4 Pro bei GPQA Diamond und HLE (nur Text) die Nase vorn hat. Flash ist zudem kostengünstiger, unterstützt Bildverarbeitung und ermöglicht mehr gleichzeitige Verbindungen.
Unterstützt DeepSeek V4.1 Flash-Bilder?
Ja. Es akzeptiert JPEG-, PNG-, GIF- und WebP-Dateien als Eingabe und gibt Text aus. DeepSeek dokumentiert bis zu 32 MiB für Inline-Bilder, 64 MiB für Dateibilder und 600 Bilder pro Anfrage im Rahmen der gemeinsamen Obergrenzen. Bilder aus API-Antworten müssen in Benutzernachrichten eingefügt werden.
Gibt es die DeepSeek V4.1-Flash-Gewichte zum Herunterladen?
Ja. DeepSeek veröffentlicht die Modellgewichte „DeepSeek-V4.1-Flash“ auf Hugging Face unter der MIT-Lizenz. Die freizügige Lizenz hebt die Anforderungen an die Infrastruktur jedoch nicht auf: Die Teams benötigen weiterhin kompatible Serving-Software und ausreichend Hardware für das 552B-MoE-Backbone.
Kann ich den DeepSeek V4.1-Flash auf dem GlobalGPT verwenden?
Ja. GlobalGPT verfügt über einen eigenen DeepSeek V4.1-Flash-Eintrag für die browserbasierte Nutzung. Der Zugriff darauf und die Abrechnung erfolgen getrennt vom direkten API-Tarif von DeepSeek, und die Verfügbarkeit der Plattform stellt keine unabhängige Bestätigung der von DeepSeek veröffentlichten Benchmark-Ergebnisse dar.