
Claude Sonnet 5.5 vs. Opus 5.5: Preis, Benchmarks und Praxistests
Sonnet 5.5 und Opus 5.5 gehören beide zur 5.5-Generation der Claude-Reihe, unterscheiden sich jedoch in Preis und Positionierung. In diesem Vergleich werden beide mit denselben fünf Eingabeaufforderungen getestet und die tatsächlich ausgegebenen Ergebnisse aufgeführt.
Der Unterschied liegt vor allem in den Kosten und der Geschwindigkeit. In diesem Paket mit fünf Aufgaben war Sonnet 5.5.5 schneller, verbrauchte weniger Ausgabetoken und lieferte die niedrigere Schätzung der arithmetischen Anforderungskosten. Opus 5.5 verbrauchte mehr Token und Zeit, während seine Antworten oft umfangreicher ausfielen. Die Aufgabenkarten zeigen, wo dieser zusätzliche Text das brauchbare Ergebnis veränderte und wo beide Modelle die Aufgabe einfach bestanden haben.
Die Eingabeaufforderungen, die Anforderungsobergrenze, die Aufwandsfestlegung, der Endpunkt und das Design mit einem Durchlauf pro Modell wurden an die vorherige Version angepasst. Claude Opus 5.5 – Testbericht.
Kurze Antwort
- Geschwindigkeit in dieser Vergleichsfahrt: Sonnet 5.5 hat lokal fünf aufeinanderfolgende Anfragen in 31,930 Sekunden bearbeitet; Opus 5.5 benötigte dafür 47,725 Sekunden.
- Durch die Route gemeldete Ausgabetoken: Sonnet 5.5: 2.686; Opus 5.5: 3.952. Die „Thinking Fields“ lagen bei 987 bzw. 2.214.
- Rechnerische Schätzung des Listenpreises: Die fünf Sonnet-Anfragen beliefen sich auf etwa $0,02826; die fünf Opus-Anfragen beliefen sich auf etwa $0,08184, unter Verwendung der offiziellen Standard-Token-Sätze und ohne Berücksichtigung von Cache, Gutschriften, Steuern und Aufschlägen.
- Ergebnis der Aufgabe: Beide Modelle haben die Aufgaben zu Extraktion, JSON und Mathematik erfolgreich gemeistert. Sonnet hat das geforderte chinesische Format mit zwei Absätzen sauberer umgesetzt; die Programmierausgaben waren beide brauchbar, unterschieden sich jedoch hinsichtlich der Tiefe und der Erläuterung von Sonderfällen.
- API-Migration: Das Denken lässt sich nicht ausschalten; eine erzwungene Werkzeugwahl wird abgelehnt, und die Symbolbudgets beinhalten das Denken. Siehe Hinweise zur Migration vor dem Umschalten.
- Entscheidungsgrenze: Hierbei handelt es sich um einen Durchlauf pro Aufgabe über eine Route eines Drittanbieters. Gemessen werden die beobachteten Reaktionszeiten auf Eingabeaufforderungen, die lokale Laufzeit und die von der Route gemeldete Auslastung – es handelt sich nicht um einen allgemeinen Leistungswert.
Offizielle Preise und technische Daten der Modelle
In den aktuellen Modellkarten von Anthropic sind sowohl Modelle mit einem Kontextfenster von 1 Mio. Token als auch eine maximale Ausgabekapazität von 128K aufgeführt. Sonnet 5.5 ist gekennzeichnet als Schnell mit hohem Aufwand bei der Standardausführung; Opus 5.5 ist gekennzeichnet als Mäßig bei mittlerem Standardaufwand. Bei den Standard-Token-Sätzen beträgt der Wert von Sonnet 5.5 die Hälfte des Ein- und Ausgabepreises von Opus 5.5.
| Modell | API-ID | Offizielle Latenzangabe | Eingabe / Ausgabe | Kontext / maximale Leistung | Standardaufwand | Cache-Lesezugriff |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-sonnet-5-5 | Aktiv · Schnell | $2 / $10 pro MTok | 1 Mio. / 128 K | Hoch | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Aktiv · Mäßig | $4 / $20 pro MTok | 1 Mio. / 128 K | Mittel | $0.20 / MTok |
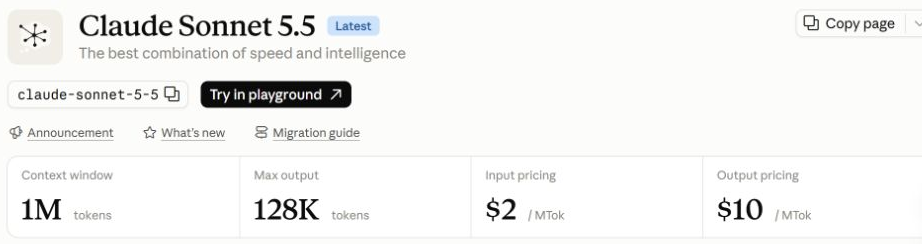
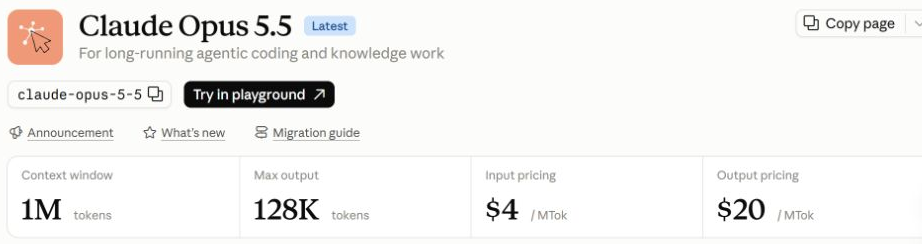
Bei einem einfachen Beispiel ohne Zwischenspeicherung mit 100.000 Eingabetoken und 20.000 Ausgabetoken ergeben sich die angegebenen Token-Raten von etwa $0,40 auf Sonnet 5,5 und $0,80 auf Opus 5,5. Siehe die Leitfaden zu Preisen und Limits für Claude für den Plan-Kontext.
Offizieller Benchmark-Kontext
Anthropic’s Bekanntmachung zu Sonnet 5.5 Führt beide Modelle in einer vom Anbieter gemeldeten Tabelle zusammen. Die Zeilenstruktur variiert je nach Benchmark und Aufwandsstufe.
| In Anthropic ausgewiesener Referenzwert | Sonnet 5.5 | Opus 5.5 | Maß |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,41 TP40T¹ | Agentische Terminal-Kodierung |
| FrontierCode v1.1 (Hauptversion) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Ob Codeänderungen zusammengeführt würden |
| CursorBench 4.0 | 55.5% | 57.8% | Mehrdeutige Kodierungsaufgaben mit mehreren Dateien |
| GDPval-AA v2.1 | 1844 | 1846 | Wissensarbeit in verschiedenen Berufen |
| Die letzte Prüfung der Menschheit | 64.5% mit Werkzeugen | 67,71 TP40T mit Werkzeugen | Interdisziplinäres Denken |
| OSWorld 2.1 | 80.1% teilweise | 81,81 TP40T teilweise | Aufgaben am Computer |
| Kartografie | 61,61 TP40T, keine Werkzeuge | 64,41 TP40T, keine Werkzeuge | Erkennung von Diagrammen |
¹ Opus 5.5 Terminal-Bench verwendet den xhigh-Aufwand; ² Sonnet 5.5 FrontierCode liegt bei 46,21 TP40T bei „Max“ und bei 52,11 TP40T bei „Xhigh“-Aufwand. Die OSWorld-Werte sind als unvollständig gekennzeichnet. Es handelt sich hierbei um Anbieter-spezifische Werte und nicht um eine unabhängige Wiederholung bei gleichem Aufwand.
API-Methode mit derselben Eingabeaufforderung
Jedes Modell erhielt dieselben fünf Eingabeaufforderungen über POST-https://anywhere.broly.ai/v1/messages. Der Client hat eine Benutzernachricht gesendet, max_tokens: 8192, output_config.effort: hoch, und ohne Tools. Jede Anfrage lieferte den HTTP-Status 200 und end_turn.
Der Testansatz folgt dem allgemeineren GlobalGPT-Workflow zur Modellprüfung. Ein separates Claude-API-Handbuch behandelt die Einrichtung von Anfragen und die Token-Abrechnung.
Zeitaufwand, Wertmarken und geschätzte Kosten
| Route | Fünf Uhr Ortszeit | Eingabetoken | Ausgabe-Token | Zugeordnete Denkweise | Geschätzte Kosten für die Anfrage* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Schätzung auf der Grundlage der gemeldeten Token und der offiziellen Standardraten. Sonnet 5.5 lag in diesem Paket hinsichtlich der lokalen Verstrichzeit um 33,11 TP40T und hinsichtlich der Anzahl der ausgegebenen Token um 32,01 TP40T niedriger.
Fünf passende Aufgabenkarten
Auf jeder Karte sind die Aufgabe, die Beobachtung, die Ortszeit, die gemeldeten Routenmarker, der Status und die Begrenzung zusammengefasst.
Können die Modelle eine Deduplizierungsfunktion mit gemischten Typen reparieren?
Aufgabeneinstellung: Die genaue Eingabeaufforderung wurde aus dem früheren Claude Opus 5.5 – Testbericht Testpackung.
| Modell | Zeitaufwand / Routennutzung | Kurze Ergebnisbezeichnung |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 Eingänge / 830 Ausgänge 0 Gedanken HTTP 200 · end_turn | Korrigierte Aufgabe plus zwei Tests; kürzere Erläuterung. |
| Claude Opus 5,5 | 15,844 s 145 Eingänge / 1478 Ausgänge 700 Gedanken HTTP 200 · end_turn | Korrigierte Funktion sowie zwei Tests; ausführlichere Erörterung von Randfällen. |
Beobachteter Vergleich: Beide gaben eine korrigierte Funktion und zwei Tests zurück. Sonnet 5.5 verwendete typmarkierte Schlüssel, casefold(), und eine Ausweichlösung in Form einer Liste in einer kürzeren Antwort; Opus 5.5 verwendete mehr Ausgabetoken, um zusätzliche Randfälle zu erläutern. Bei keinem der beiden Durchläufe lässt sich ein allgemeiner Sieger in Sachen Codierung feststellen.
Grenze: Eine einzige kleine Python-Korrektur prüft konkrete Randfälle, nicht jedoch die Zuverlässigkeit über Repositorys hinweg oder bei der toolgestützten Programmierung.
Können die Modelle fünf vorgegebene Fakten beibehalten, ohne zusätzliche Behauptungen hinzuzufügen?
Aufgabeneinstellung: Die genaue Eingabeaufforderung wurde aus dem früheren Claude Opus 5.5 – Testbericht Testpackung.
| Modell | Zeitaufwand / Routennutzung | Kurze Ergebnisbezeichnung |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 Eingänge / 209 Ausgänge 0 Gedanken HTTP 200 · end_turn | Fünf nummerierte Aufzählungspunkte; die angegebenen Fakten wurden beibehalten. |
| Claude Opus 5,5 | 4,374 s 210 Eingänge / 312 Ausgänge 101 Denkweisen HTTP 200 · end_turn | Fünf nummerierte Aufzählungspunkte; die angegebenen Fakten wurden beibehalten. |
Beobachteter Vergleich: Beide lieferten genau fünf nummerierte Aufzählungspunkte und hielten sich an die vorgegebenen Fakten. Sonnet 5.5 verwendete 209 Ausgabetoken gegenüber 312 bei Opus 5.5, allerdings handelte es sich bei der Eingabe um eine kurze Notiz und nicht um eine Eingabe mit großem Kontext.
Grenze: Hierbei handelt es sich um eine fundierte Überprüfung der Extraktion und Formatierung; sie ist kein Beleg für die Leistung bei einem Kontext von einer Million Tokens.
Können die Modelle genau die angeforderte Struktur zurückgeben?
Aufgabeneinstellung: Die genaue Eingabeaufforderung wurde aus dem früheren Claude Opus 5.5 – Testbericht Testpackung.
| Modell | Zeitaufwand / Routennutzung | Kurze Ergebnisbezeichnung |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 Eingänge / 260 Ausgänge 0 Gedanken HTTP 200 · end_turn | Parsierbares JSON; angeforderte Schlüssel und Anzahl der Elemente. |
| Claude Opus 5,5 | 8,276 s 128 Eingänge / 622 Ausgänge 390 Gedanken HTTP 200 · end_turn | Parsierbares JSON; angeforderte Schlüssel und Anzahl der Elemente. |
Beobachteter Vergleich: Beide lieferten analysierbares JSON mit den angeforderten Schlüsseln sowie zwei Vor- und zwei Nachteile. Sonnet 5.5 war mit 260 Ausgabetoken prägnanter; die Zeichenfolgen beschreiben ein fiktives Bewertungsszenario und stellen keine Produktangaben dar.
Grenze: Ein einmaliges Durchlaufen dieses Schemas reicht nicht aus, um die Zuverlässigkeit strukturierter Ausgaben bei Tool-Aufrufen oder langen Konversationen zu bewerten.
Können die Modelle die abgerundete Abfolge der Chargen bis zum Endergebnis weiterführen?
Aufgabeneinstellung: Die genaue Eingabeaufforderung wurde aus dem früheren Claude Opus 5.5 – Testbericht Testpackung.
| Modell | Zeitaufwand / Routennutzung | Kurze Ergebnisbezeichnung |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 Eingänge / 163 Ausgänge 0 Gedanken HTTP 200 · end_turn | Richtiges Ergebnis: 67; Endergebnis in einer eigenen Zeile. |
| Claude Opus 5,5 | 3,830 s 89 Eingänge / 257 Ausgänge 74 Gedanken HTTP 200 · end_turn | Richtiges Ergebnis: 67; Endergebnis in einer eigenen Zeile. |
Beobachteter Vergleich: Beide berechneten den Wert 67 und setzten die endgültige Antwort in eine eigene Zeile. Sonnet 5.5 verwendete 163 Ausgabetoken gegenüber 257 bei Opus 5.5, wobei bei dieser Eingabe keine Unterschiede in der Korrektheit festgestellt wurden.
Grenze: Eine arithmetische Folge allein reicht nicht aus, um die Zuverlässigkeit allgemeiner Schlussfolgerungen einzuschätzen.
Kann die Route die gewünschte Gliederung in zwei Absätze beibehalten?
Aufgabeneinstellung: Die genaue Eingabeaufforderung wurde aus dem früheren Claude Opus 5.5 – Testbericht Testpackung.
| Modell | Zeitaufwand / Routennutzung | Kurze Ergebnisbezeichnung |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 Eingänge / 1224 Ausgänge 987 Gedanken HTTP 200 · end_turn | Zwei chinesische Absätze; keine zusätzliche Einrahmung. |
| Claude Opus 5,5 | 15,401 s 128 Eingänge / 1283 Ausgänge 949 Gedanken HTTP 200 · end_turn | Die Punkte wurden behandelt; Markdown und eine Anmerkung auf Englisch wurden hinzugefügt. |
Beobachteter Vergleich: Sonnet 5.5 lieferte die angeforderten zwei chinesischen Absätze ohne zusätzliche Formatierung. Opus 5.5 deckte ebenfalls die angeforderten Punkte ab, fügte jedoch eine Markdown-Formatierung und eine englische Anmerkung hinzu. Diese Aufzeichnung bezieht sich auf das Format nach einem Durchlauf und nicht auf die allgemeine Qualität des Chinesischen.
Grenze: Die Vorgabe verlangt eine Einleitung zum Thema „Opus 5.5“, daher stellt der Text selbst keinen Maßstab für neutrale Sprache dar.
Hinweise zu APIs und Migration
Sonnet 5.5 verwendet standardmäßig adaptives Denken; bei „thinking: disabled“ wird ein 400-Fehler zurückgegeben, und „max_tokens“ umfasst sowohl das Denken als auch den Antworttext. Eine erzwungene „tool_choice“-Einstellung von „any/tool“ wird abgelehnt. Analysieren Sie Inhaltsblöcke nach Typ und legen Sie die Token-Budgets vor dem Wechsel neu fest.
Was die Beweislage belegt
Beurteilung auf Aufgabenebene
Sonnet 5.5: niedrigere gemessene Kosten und Zeitaufwand auf dieser Route bei einwandfreier Einhaltung der Formatvorgaben bei der chinesischen Aufgabe.
Opus 5.5: hier teurer und umfangreicher; bei mehreren Aufgaben mit offenem Ausgang liegen die offiziellen Benchmark-Reihen weiterhin vorn.
Wählen Sie anhand der Erkenntnisse auf Aufgabenebene einen Ausgangspunkt aus und überprüfen Sie anschließend den Arbeitsaufwand, der für Sie von Bedeutung ist.
Weitere Informationen zum Kontext finden Sie unter Vergleich der Claude-Produktfamilie, Rezension zu „Opus 5“, und Fable 5.1 – Testbericht.
FAQ
Welches Modell war im Vergleichstest schneller?
Sonnet 5.5 erzielte die niedrigere lokale Gesamtzeit: 31,930 Sekunden gegenüber 47,725 Sekunden bei Opus 5.5 über fünf aufeinanderfolgende Anfragen hinweg. Dies umfasst die hier verwendete Route und den Netzwerkpfad, es handelt sich also nicht um eine anbieterseitige Latenz.
Welches Modell hat weniger Ausgabe-Token verbraucht?
Sonnet 5.5 verwendete bei den fünf Aufgaben insgesamt 2.686 in den Routen gemeldete Ausgabetoken, verglichen mit 3.952 bei Opus 5.5. Die Anzahl der Token allein sagt jedoch nichts über die Qualität der Antworten aus.
Welches Modell war in diesem Durchlauf günstiger?
Unter Verwendung der offiziellen Standard-API-Raten und der zurückgegebenen Ein- und Ausgabewerte belaufen sich die fünf Sonnet 5.5-Anfragen auf schätzungsweise $0,02826, gegenüber $0,08184 bei Opus 5.5. Die Berechnung berücksichtigt keine Cache-Gebühren, Plattformgutschriften, Steuern und Aufschläge.
Schlägt Sonnet 5.5 Opus 5.5 in jedem Benchmark?
Die Tabelle von Nr. Anthropic ist je nach Benchmark und Leistungsanforderung gemischt: Sonnet 5.5 schneidet bei Terminal-Bench 4.0 besser ab, während Opus 5.5 bei FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld und Chartography besser abschneidet. Hierbei handelt es sich um vom Anbieter gemeldete Ergebnisse, nicht um eine unabhängige Wiederholung der Tests.
Ist Sonnet 5.5 ein direkter API-Ersatz?
Nein. Im Migrationsleitfaden heißt es, dass „thinking“ standardmäßig ausgeführt wird, „thinking: disabled“ einen 400-Fehler zurückgibt, die erzwungene Tool-Auswahl „any/tool“ abgelehnt wird und Clients Inhaltsblöcke nach Typ analysieren sollten. Passen Sie die Token-Budgets und Tool-Schleifen vor der Umstellung an die neuen Vorgaben an.
Handelte es sich hierbei um einen Long-Context-Benchmark?
Nein. Die Extraktionsaufforderung enthält einen kurzen Textabschnitt. Dabei werden die sachliche Fundiertheit und die exakte Formatierung überprüft; das Verhalten in der Nähe des dokumentierten Kontextfensters von 1 Million Token wird nicht gemessen.



