يُعد طراز Qwen 3.8 Max الطراز الرائد الجديد من Alibaba Qwen المخصص للبرمجة، والأعمال الاحترافية، وتشغيل الوكلاء لفترات طويلة، والمهام متعددة الوسائط. واسمه الرسمي هو Qwen3.8-Max, ، وقد أُعلن عن ذلك في 3 أغسطس 2026، حيث بلغ إجمالي المعلمات 2.4 تريليون معلمة، وبلغ عدد المعلمات النشطة 95 مليار معلمة، وبلغ حجم نافذة السياق مليون توكن.
لا يقتصر هذا الإطلاق على مجرد تحديث روتيني للمعايير. فـ Qwen تضع هذا النموذج في موقع الوكيل القادر على التخطيط، واستخدام الأدوات، وفحص الملاحظات المرئية، ومواصلة العمل عبر سلاسل مهام طويلة — وليس مجرد روبوت دردشة يرد على استفسار واحد في كل مرة. وهذا يضعه في نفس سياق المحادثة التسويقية مثل أفضل نماذج الذكاء الاصطناعي للاستخدام العملي, ، لكن سعر واجهة برمجة التطبيقات (API) الخاصة بها، وخطة «الوزن المفتوح»، ومتطلبات النشر تستحق دراسة متأنية قبل أن تقرر التبديل.
ما هو Qwen3.8-Max؟
Qwen3.8-Max هو نموذج كبير من نوع «مزيج الخبراء» (Mixture of Experts) طوره فريق Qwen التابع لشركة «أليبابا». ويحتوي النموذج على 2.4 تريليون معلمة إجمالاً، لكنه يقوم بتنشيط 95 مليار معلمة لكل رمز. يجمع النموذج بين النص والرمز والفهم البصري واستخدام الأدوات والتخطيط طويل المدى في نظام واحد مصمم لإنجاز الأعمال المعقدة من البداية إلى النهاية.
إن الإصدار الرسمي لـ Qwen يصف أربعة أهداف رئيسية: برمجة ذاتية أكثر قوة، ومخرجات احترافية بجودة الإنتاج، ومهام ذات دورة مغلقة أطول، ووكلاء متعددي الوسائط أصليين. من الناحية العملية، يهدف مشروع Qwen إلى أن ينتقل النموذج من مرحلة “الإجابة على هذا السؤال” إلى مرحلة “تحديد هذا الهدف، ووضع خطة، واستخدام الأدوات المتاحة، والتحقق من النتيجة، والاستمرار حتى إنجاز العمل”.”
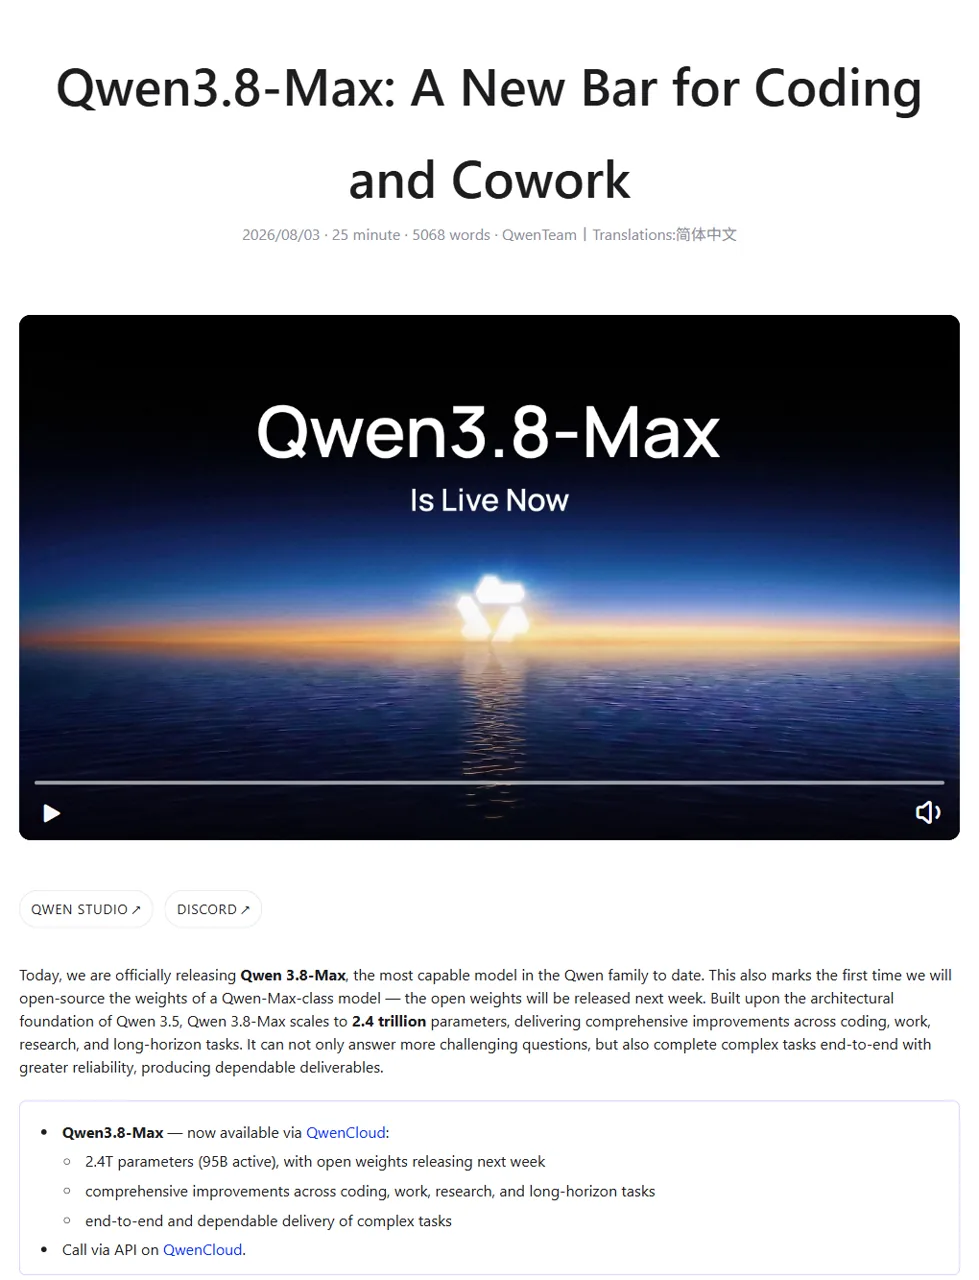
Qwen 3.8 - المواصفات القصوى
يحتاج عدد المعلمات إلى سياق. فالنموذج الذي يحتوي على 2.4 تريليون معلمة هو نموذج ضخم، لكن نموذج «Qwen3.8-Max» لا يستخدم كل معلمة مع كل رمز. فتصميمه القائم على «مزيج الخبراء» يوجه كل رمز عبر جزء نشط أصغر من الشبكة. لذلك، فإن رقم الـ 95 مليار معلمة نشطة أكثر فائدة لفهم سلوك الاستدلال مقارنةً بالعدد الإجمالي وحده، على الرغم من أن كلا الرقمين لا يوضحان بمفردهما زمن الاستجابة الفعلي أو متطلبات الأجهزة.
تُعد نافذة السياق التي تتسع لمليون رمز أكثر فائدةً على المدى القريب. فهي قادرة على استيعاب مستودعات كبيرة، أو مجموعات مستندات طويلة، أو سجلات وكلاء ممتدة، أو سجلات تشغيلية تمتد لشهور، كل ذلك في طلب واحد. ولا يضمن ذلك استرجاعًا كاملاً لكل رمز على حدة، لكنه يمنح المطورين مساحة أكبر بكثير للاحتفاظ بالتعليمات، ومخرجات الأدوات، والكود، والقرارات المرحلية دون الحاجة إلى إجراء عمليات اقتطاع مفرطة.
ما الذي يمكن أن يفعله جهاز Qwen3.8-Max؟
الترميز الذاتي
تُبرز مواد إطلاق Qwen المشاريع التي تتجاوز بكثير مجرد طلب واحد لتوليد الكود. تصف الشركة عملية تطوير ذاتية تستمر لأكثر من 10 أيام، تبدأ من مجلد فارغ وصولاً إلى مشروع إنتاجي مع التكيف مع الأخطاء والمتطلبات الجديدة. وهذا هو الاتجاه الصحيح لوكلاء على نطاق المستودع، على الرغم من أنه لا يزال يتعين على المشترين التحقق من صحة النموذج على لغاتهم الخاصة، ومجموعات الاختبارات، وقواعد الأمان، وبيئة النشر.
أما في مجال الهندسة اليومية، فإن الأسئلة العملية تكون أبسط: هل يستطيع النموذج معالجة عدة ملفات في آن واحد؟ هل يحافظ على الواجهات أثناء إعادة الهيكلة؟ هل سيقوم بكتابة الاختبارات، وفحص الأخطاء، وتصحيح التصحيح الذي قام به بنفسه؟ هذه المعايير أكثر أهمية من مجرد نتيجة واحدة في قائمة المتصدرين عند اختيار أفضل نموذج ذكاء اصطناعي للبرمجة.
مهام “العمل المشترك” الاحترافية
تشير كلمة “cowork” إلى مخرجات العمل وليس إلى المحادثات غير الرسمية. يسلط موقع Qwen الضوء على التقارير، والأبحاث، والعروض التقديمية، والتحليلات، والوثائق، وغيرها من المخرجات في مئات التخصصات المهنية. يجب أن يتبع نموذج «cowork» الجيد موجزًا، وأن ينظم الأدلة، ويستخدم التنسيق الصحيح، ويقدم شيئًا يمكن للشخص تعديله أو تسليمه — وليس مجرد فقرة معقولة.
الوكلاء ذوو الأفق الطويل
كما يُشير Qwen إلى مهام على مستوى النظام تمتد لمئات الدورات. وتشمل الأمثلة التي يقدمها أكثر من 500 دورة من تحسين تصميم الرقائق ومحاكاة استراتيجية التجارة الإلكترونية لمدة عام كامل. وهذه عروض توضيحية من الموردين، وليست وعدًا بأن كل وكيل سيعمل دون مراقبة لعدة أيام. لكنها توضح بالفعل الهدف الذي يسعى المنتج إلى تحقيقه: التخطيط المستمر، والتقييم في حلقة مغلقة، والتحسين المتكرر بدلاً من الحلول المعزولة.
التخطيط متعدد الوسائط والتغذية الراجعة البصرية
يعالج Qwen3.8-Max الصور والشاشات كجزء من حلقة العمل الخاصة بالوكيل. يمكن للوكيل البصري فحص صفحة ما، واختيار إجراء ما، ومراقبة التغييرات التي طرأت، ومراجعة خطته. ويدعم ذلك مهام استخدام الكمبيوتر، وفهم المستندات، واختبار الواجهات، والبرمجة البصرية، والرسوم البيانية، والاستدلال المكاني. لا يكمن الصعوبة في مجرد التعرف على الصورة فحسب، بل في الحفاظ على ارتباط الملاحظات البصرية بهدف الوكيل عبر العديد من الخطوات.
اختبارات عملية: نتائج مفيدة، استجابات بطيئة، وتجربة واحدة لم تسفر عن نتائج
لقد قمت بتشغيل ثلاثة طلبات مستقلة على qwen3.8-max معرف النموذج من خلال واجهة برمجة التطبيقات (API) المتوافقة مع Anywhere OpenAI في 4 أغسطس 2026. وهذه اختبارات بسيطة وعملية، وليست معيارًا مستقلًا أو ادعاءً بشأن كل عملية نشر لنظام Qwen. وهي مفيدة لأنها تُظهر كلاً من جودة الإجابة الظاهرة وسلوك مسار البوابة الذي تم اختباره.
تصحيح أخطاء أداة «Retry-helper»
استخدمت المهمة الأولى وظيفة إعادة المحاولة المعطلة من سيناريو «webhook» للدفع. وقد حددت التعليمات النموذج بثلاث محاولات، وفترتي تأخير تراجع محددتين بدقة، والعودة الفورية في حالة النجاح، وإعادة إثارة الاستثناء الثالث بعد الفشل التام.
حددت الإجابة ثلاثة عيوب منفصلة: النوم غير المشروط بعد كل محاولة، و النتيجة بعد الاستثناءات، وفحص «الصحة الظاهرية» الذي أدى إلى تأخير النجاح أو التعامل معه بشكل خاطئ. وكان السطر المتوقع هو "paid" مع معلمات sleep_fn [0.1، 0.2].
ثم قمت بتشغيل الكود محليًّا بدلًا من الاكتفاء بالشرح. وقد نجح الكود في ثلاث حالات: حالتان من الفشل تلاهما نجاح، وقيمة نجاح كاذبة في الاستدعاء الأول تبلغ 0, ، وثلاث حالات فشل حيث كانت النتيجة النهائية RuntimeError("failure-3") كان لا بد من إعادة إرسالها. وكان هذا حلاً هندسيًّا جيدًا. لكن الثمن كان زمن الاستجابة: فقد استغرقت الاستجابة المرئية 51.577 ثانية عبر البوابة التي خضعت للاختبار.
توليف الأدلة المتضاربة
وقد اختبرت المهمة الثانية مدى قدرة النموذج على التمييز بين الحقائق الرسمية الحالية من جهة، والملاحظات القديمة، وادعاءات البائعين، وتعليق أحد أفراد المجتمع، ومسار منصة لم يتم التحقق منه، من جهة أخرى.
تعامل النموذج مع الصراع المُفتعل بشكل صحيح. فلم يكرر سياق 256K أو سعر الإدخال $1.20 على أنه السعر الحالي، ولم يحول تعليقًا يتعلق بأربع وحدات معالجة رسومات (GPU) إلى متطلبات للأجهزة، ولم يزعم أن GlobalGPT لديه بالفعل مسار مخصص Qwen3.8-Max. كما صنّف جدول المعايير القياسية الرسمي على أنه «مُبلغ عنه من قبل المورد». استغرقت الاستجابة 94.973 ثانية، لذا كانت هذه نتيجة أخرى تضع الجودة في المقام الأول بدلاً من أن تكون نتيجة استخراج سريعة.
ما الذي فشل في اختبار التخطيط؟
تضمن الطلب الثالث خطة لترحيل نظام إدارة المحتوى (CMS) مدتها ساعتان ويشارك فيها مهندسان، مع تحديد معايير واضحة لـ«المضي قدماً» أو «عدم المضي قدماً» و«الرجوع إلى الوضع السابق». وانتهى الطلب الأول بعد 133.682 ثانية عندما انقطع الاتصال مع الخادم الرئيسي. مجموعة إعادة محاولة أقصر الحد الأقصى_لإكمال_الرموز إلى 1,200، لكن واجهة برمجة التطبيقات (API) أفادت بأن finish_reason: "الطول", ، واستنفد ميزانية الاستدلال بالكامل، ولم يُرجع أي إجابة مرئية بعد مرور 32.899 ثانية.
هذا تحذير تشغيلي مفيد، لكنه لا يُعد دليلاً على أن Qwen3.8-Max غير قادر على تخطيط عمليات الترحيل. لم تكن هناك خطة متاحة لتقييمها. من خلال هذه البوابة، يتطلب التخطيط المعقد تخصيص وقت إكمال أطول، أو تقسيم البيانات إلى تدفقات، أو موجهًا مرحليًّا حتى لا يستهلك الاستدلال الداخلي ميزانية الاستجابة بالكامل قبل إخراج النص المرئي.
Qwen 3.8 - أعلى النتائج في اختبارات الأداء
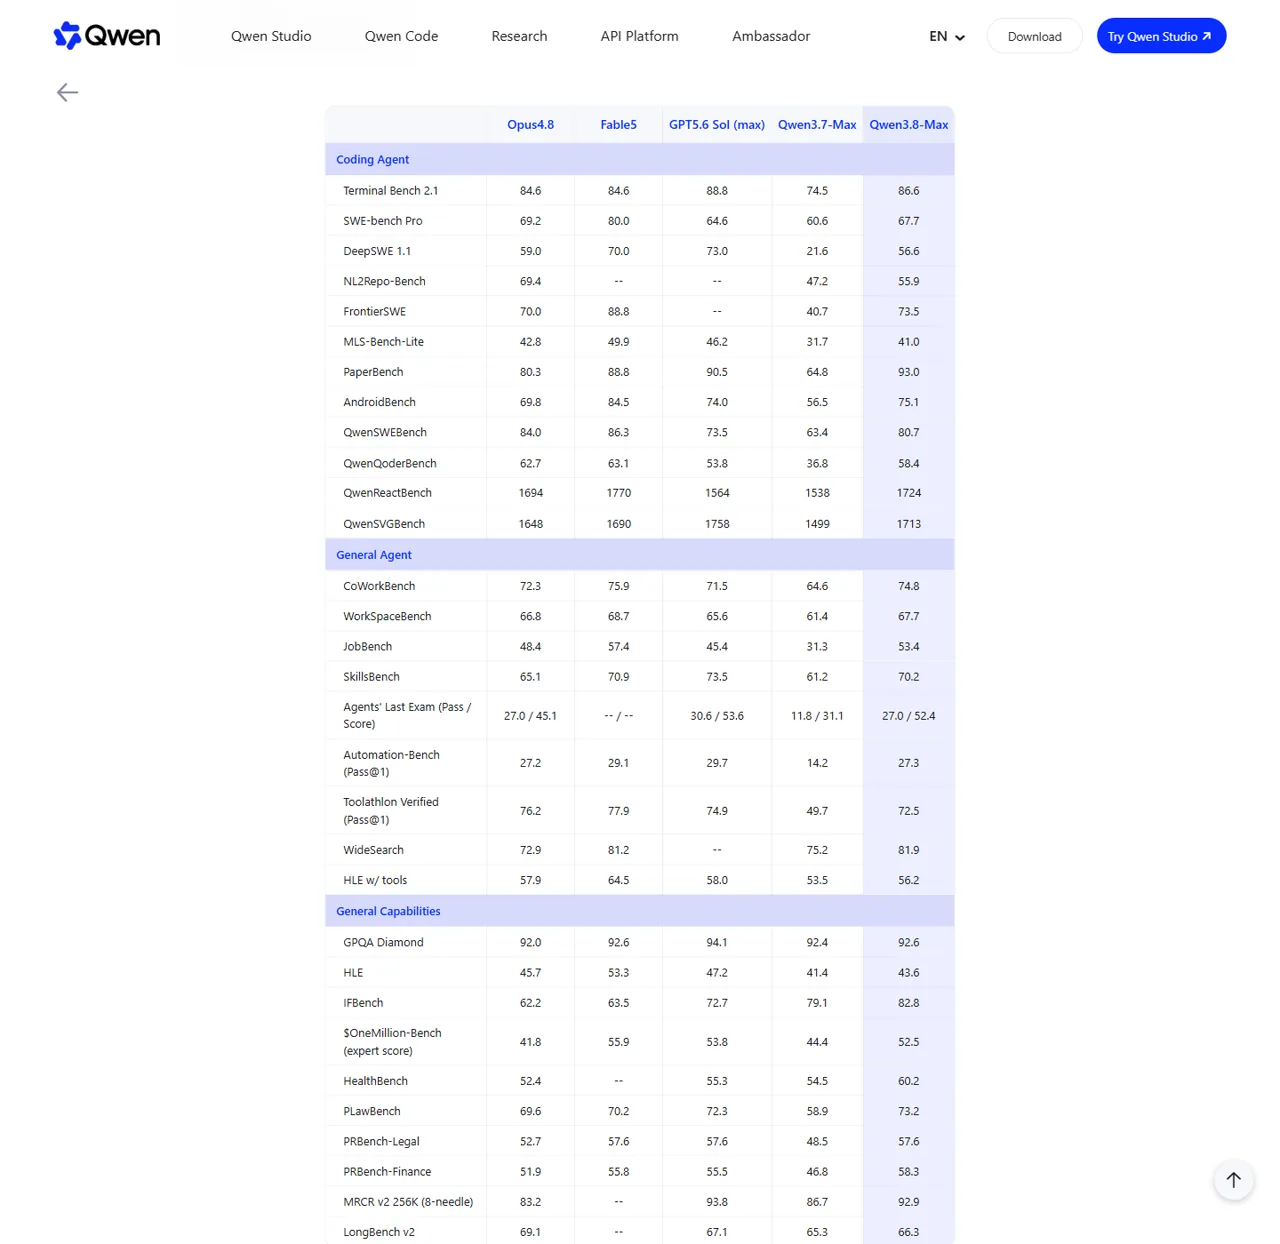
تُظهر حزمة الاختبارات القياسية الرسمية لـ Qwen أن Qwen3.8-Max يُعد وكيلًا قويًّا في مجالي الترميز والقدرات متعددة الوسائط، لكن النتائج كانت متباينة ولم تحقق فوزًا ساحقًا. فهي تتصدر النماذج المدرجة في بعض الاختبارات، وتقترب من المتصدر في اختبارات أخرى، وتأتي خلف GPT-5.6 Sol أو Fable 5 في عدة فئات. وهذه قراءة أكثر توازناً من اختزال عشرات الاختبارات إلى تصنيف واحد هو “أفضل نموذج”.
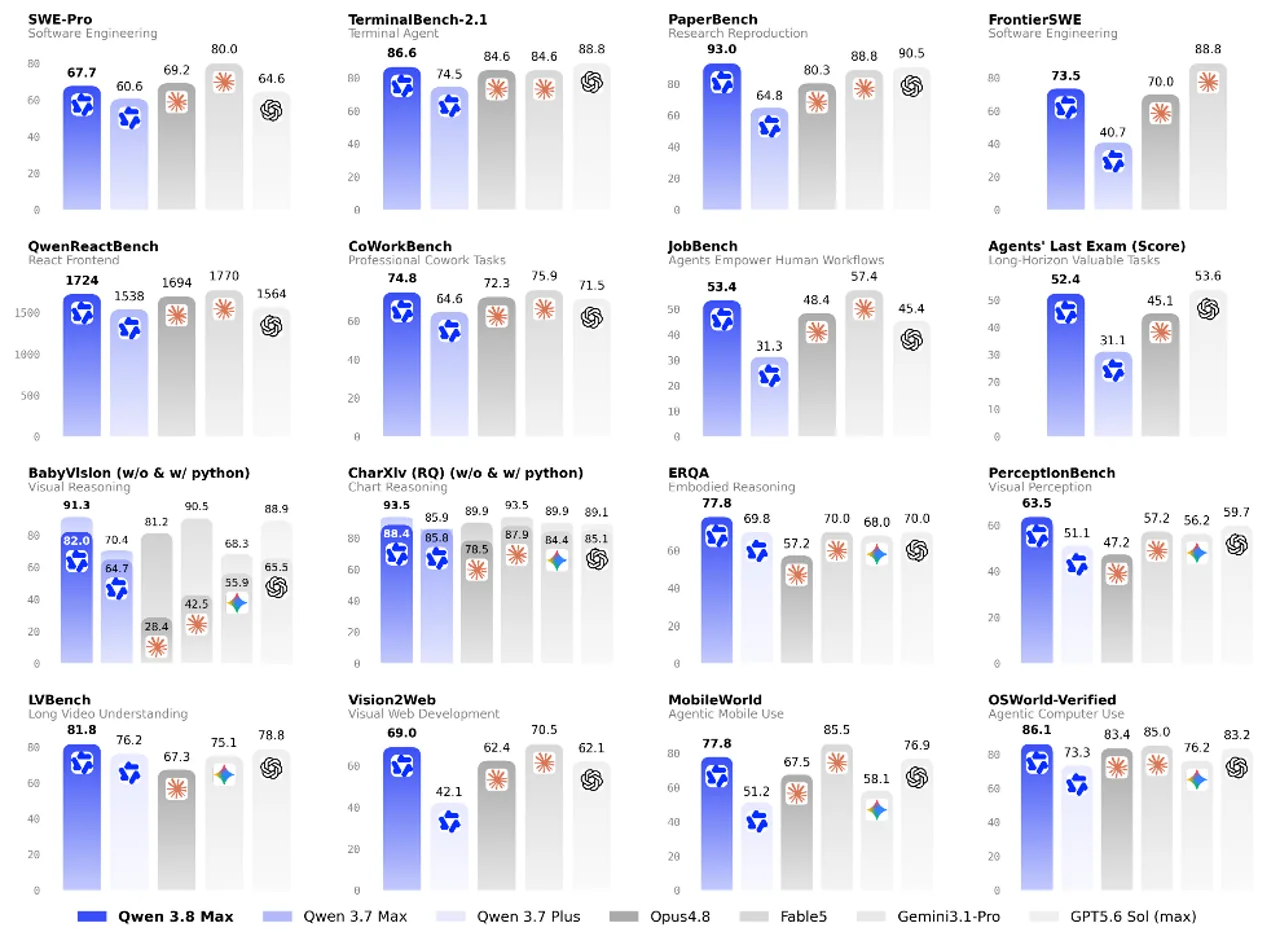
نتائج مختارة من الجدول الرسمي لفريق Qwen
هذه الأرقام مستمدة من المواد الإعلامية الصادرة عن Qwen نفسها. تُظهر الحواشي أن الجدول يجمع بين التقارير الرسمية عن الطرازات، وبطاقات الأنظمة، وقوائم المتصدرين العامة، والتقييمات الداخلية لشركة Qwen. كما تختلف التجهيزات والإعدادات بين بعض الطرازات. استخدم الجدول لتحديد نقاط القوة الواعدة، ثم تحقق من القائمة المختصرة من خلال عملك الخاص قبل اتخاذ قرار يتطلب تكلفة عالية.
ماذا تعني نتائج الترميز؟
الميزة الأبرز هي التوازن. فقد حقق النموذج Qwen3.8-Max نتائج متقاربة في الصدارة عبر مجالات العمل المكتبي، وهندسة البرمجيات، وتنفيذ المهام الورقية، ومهام العمل الجماعي، والبحث على الويب، واتباع التعليمات. ولا يحتاج إلى الفوز في كل صف ليكون مفيدًا؛ فالوكيل الذي يحافظ على أدائه القوي باستمرار في مجالات التخطيط والبرمجة واستخدام الأدوات والفحوصات البصرية قد يكون أكثر موثوقية من نموذج مُحسَّن لاختبار واحد محدود النطاق.
كما يوضح الجدول الرسمي أهمية إجراء الاختبارات المقارنة. يتصدر «GPT-5.6 Sol» العديد من الصفوف المتعلقة بالاستدلال أو المهام الطرفية، في حين يظل «Fable 5» منافساً بشكل خاص في مهام العمل الجماعي والواجهة والمهام البصرية. جدول منفصل مقارنة بين GPT-5.6 وFable 5 يمكن أن يساعدك ذلك في تحويل مجموعات النماذج هذه إلى حالات استخدام يومية قبل إضافة Qwen3.8-Max إلى قائمة الخيارات المختارة.
ماذا تعني النتائج متعددة الوسائط؟
حقق النموذج Qwen3.8-Max نتائج رسمية قوية في مجالات الاستدلال متعدد الوسائط، والتأسيس البصري، واستخدام الكمبيوتر، والعمل على المستندات، والفهم المكاني. وتعتبر درجته البالغة 86.1 في اختبار OSWorld-Verified ذات أهمية خاصة بالنسبة للوكلاء الذين يعملون عبر الشاشة، لأنها تقيس إنجاز المهام داخل بيئات سطح المكتب، وليس مجرد وصف صورة.
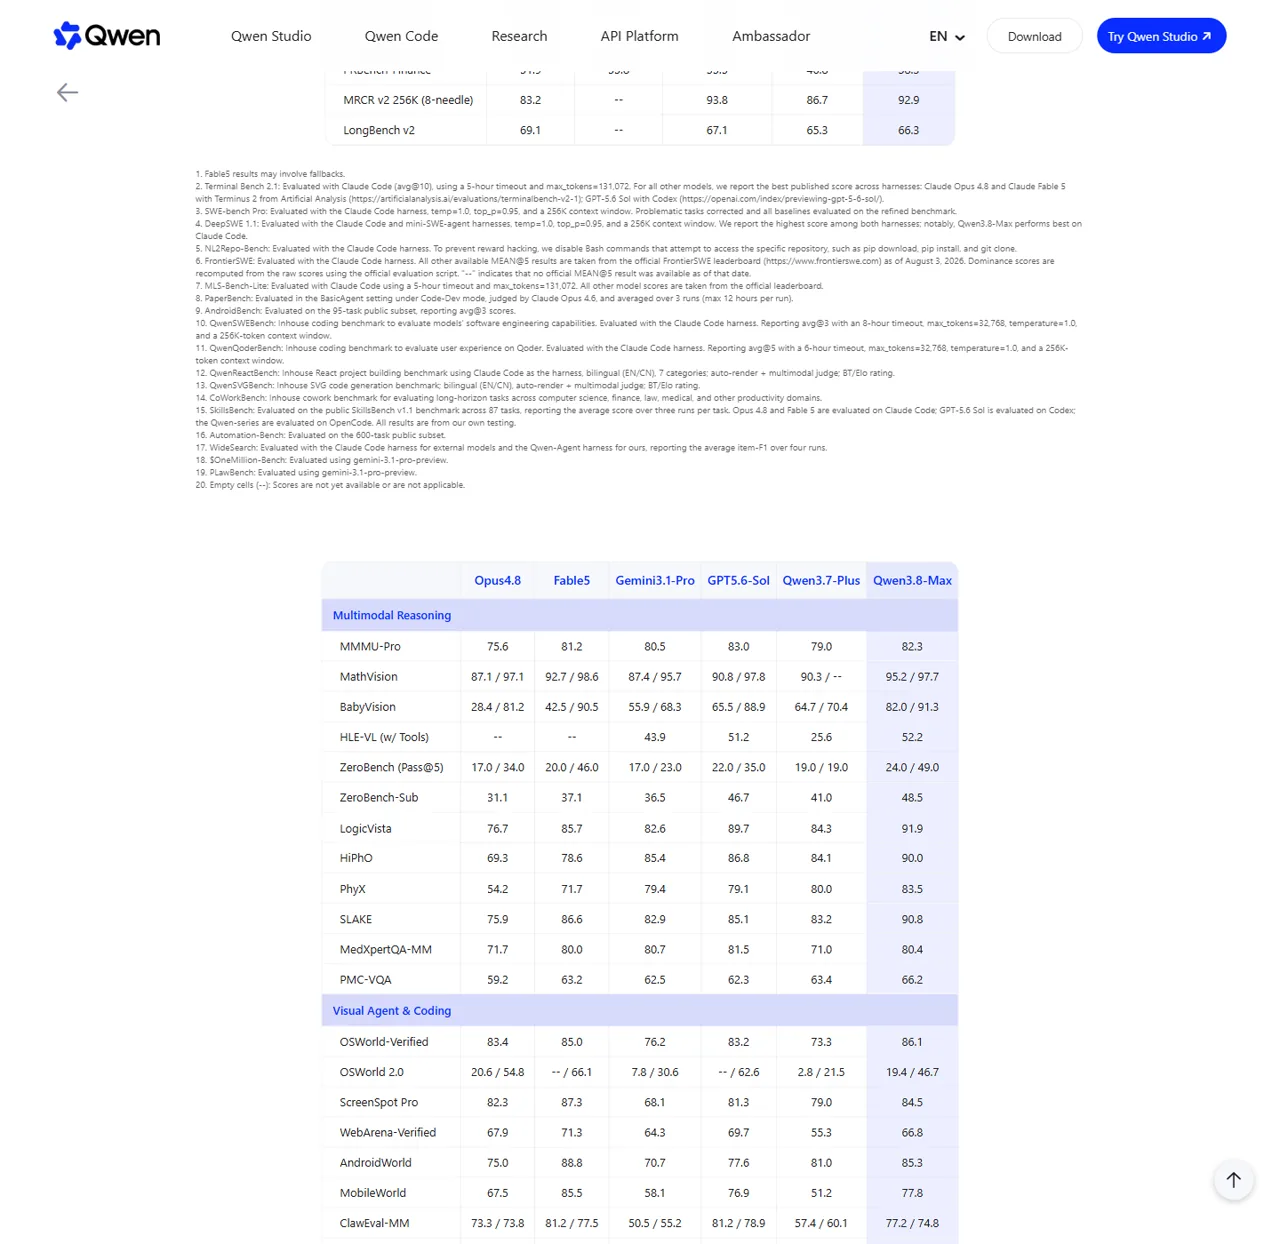
مقارنة بين طراز Qwen3.8-Max والطرازات الأخرى
لا توجد إجابة موجزة ومسؤولة على السؤال: “هل نموذج Qwen3.8-Max أفضل من GPT أو Claude أو Gemini؟” وتُظهر البيانات الخاصة بنموذج Qwen أن المتصدرين في كل فئة يتغيرون من صف إلى آخر. كما يعتمد ملاءمة المنتج على موثوقية الأداة، وجودة المخرجات، وزمن الاستجابة، وتوافر الخدمة في المنطقة، وضوابط الخصوصية، والواجهة المحيطة بالنموذج.
يبدو نموذج Qwen3.8-Max هو الخيار الأكثر جاذبية عندما ترغب في نموذج واحد يغطي البرمجة، والمستندات، والبحوث، والمهام الطويلة، والوكلاء المرئيين. وقد يظل نموذج GPT-5.6 Sol هو الخيار الأفضل لأحمال العمل التي يمكن فيها نقل قدراته القوية في الاستدلال والنتائج النهائية إلى بيئتك. يستحق النموذج Fable 5 نظرة فاحصة للمهام التي تتطلب تعاونًا بين الزملاء والمهام التي تعتمد بشكل كبير على واجهة المستخدم؛ حيث إن مقارنة بين Fable 5 وOpus 4.8 يقدم مزيدًا من السياق بشأن ذلك الجزء من القرار.
قد تصبح الأوزان المفتوحة المخطط لها في النموذج أكبر ميزة هيكلية له. ففي الوقت الحالي، يُعد الأداء القائم على واجهة برمجة التطبيقات (API) وحده هو المهم، لكن الأوزان القابلة للتنزيل توفر خيارات للضبط الدقيق، والبنية التحتية الخاصة، والبحث، والنشر الإقليمي. وستعتمد القيمة النهائية على الترخيص الذي سيتم إصداره، وتنسيقات الأوزان، ودعم التكمية، والأجهزة اللازمة لتشغيل النموذج بسرعة مجدية.
Qwen3.8-Max أسعار واجهة برمجة التطبيقات (API)
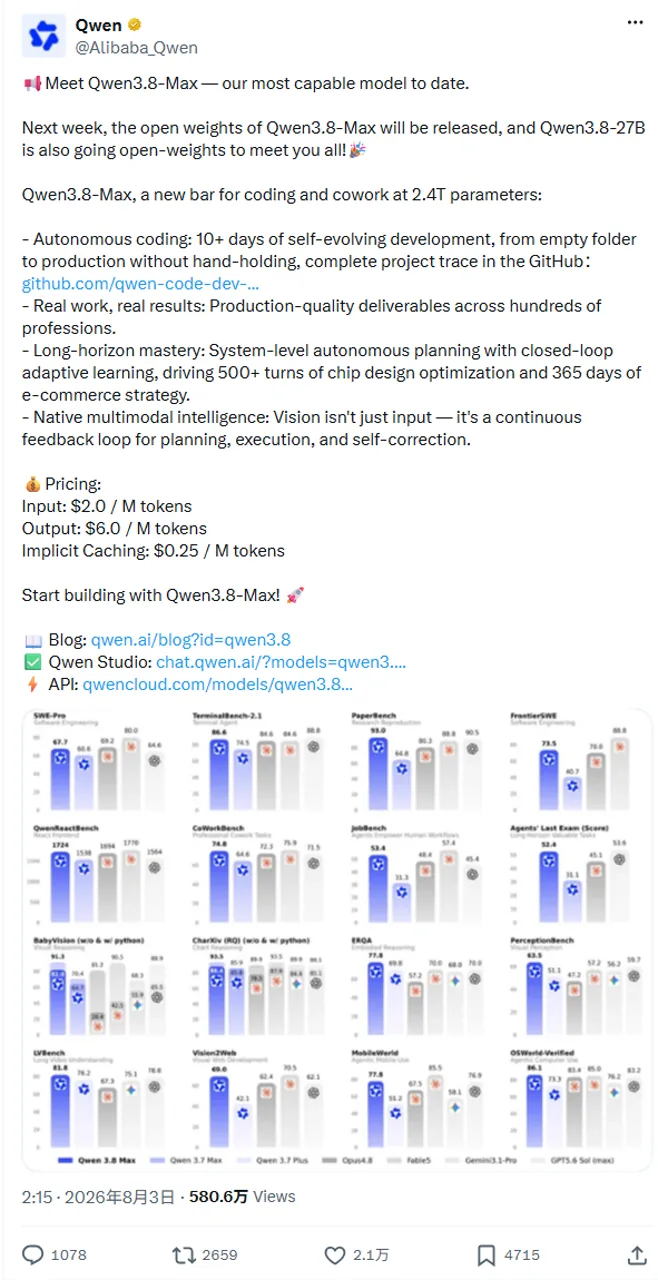
أوردت شركة Qwen الأسعار التالية عند الإطلاق في تقريرها إعلان رسمي:
إحدى التقديرات البسيطة هي:
التكلفة التقديرية = المدخلات غير المخزنة في ذاكرة التخزين المؤقت × $2/M + المدخلات المخزنة في ذاكرة التخزين المؤقت × $0.25/M + المخرجات × $6/M
على سبيل المثال، ستكلف عملية تشغيل تستخدم 10 ملايين رمز إدخال غير مخزّن مؤقتًا و2 مليون رمز إخراج حوالي $32 وفقًا لأسعار الإطلاق قبل احتساب أي رسوم أخرى تفرضها المنصة: $20 للإدخال بالإضافة إلى $12 للإخراج. ويمكن للوكيل الذي يعيد قراءة مستودع كبير في كل دور أن ينفق أكثر من ذلك بكثير، مما يجعل التخزين المؤقت وإدارة السياق أمرين لا يقلان أهمية عن سعر الإدخال الرئيسي.
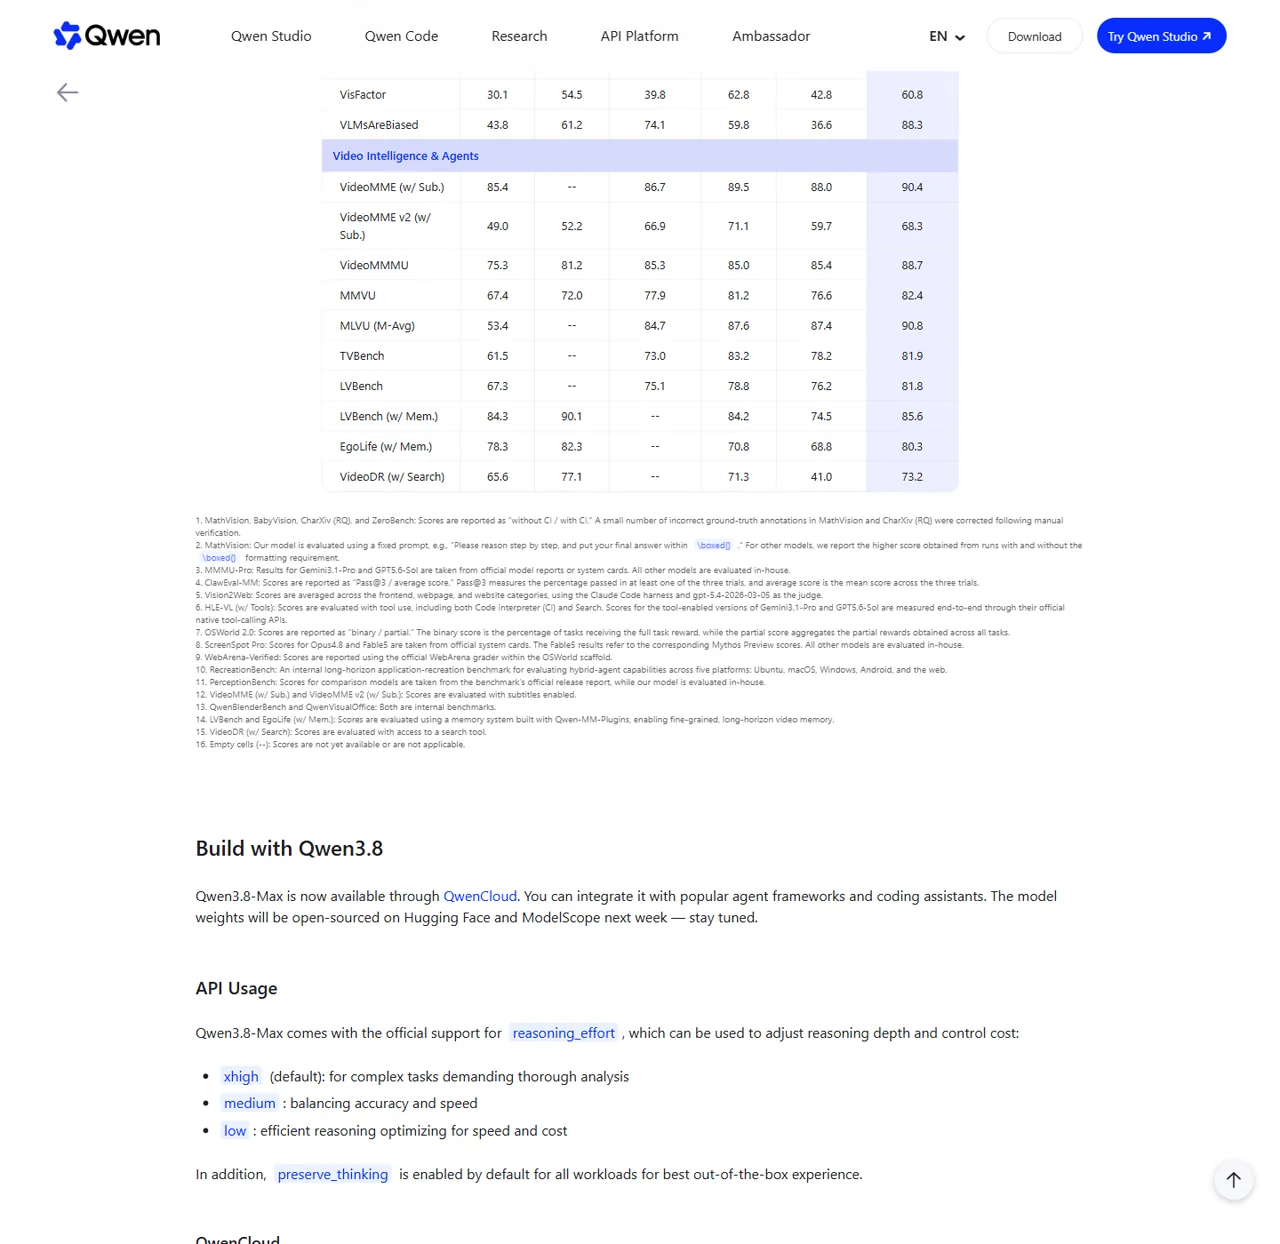
كما يدعم Qwen3.8-Max أيضًا جهد_التفكير عناصر التحكم. يضم قسم واجهة برمجة التطبيقات (API) الرسمي قائمةً بـ xhigh كإعداد افتراضي للتحليل المركب،, متوسط لتحقيق التوازن بين الدقة والسرعة، و منخفض من أجل عمل أسرع وأكثر كفاءة. الحفاظ_على_التفكير يتم تمكينها بشكل افتراضي. يمكن لهذه الضوابط أن تقلل التكلفة، لكن ينبغي اختبارها من حيث جودة المهام بدلاً من التعامل معها كأوضاع قابلة للتبديل.
يتطلب التسعير عبر مزودي الخدمة نفس القدر من الحذر. فقد يكون النموذج الذي يعتمد على سعر رمزي أقل أكثر تكلفة في نهاية المطاف إذا تطلب موجهات أطول، أو محاولات إعادة أكثر، أو استدعاءات إضافية للأدوات. إن دليل أسعار واجهة برمجة التطبيقات (API) لـ Gemini 3.1 Pro وهذا مثال مفيد يوضح أهمية طول السياق ومستويات الاستخدام إلى جانب المعدل الأساسي.
كيفية الوصول إلى Qwen3.8-Max
1. استخدم برنامج Qwen Studio للتقييم المباشر
أسرع طريقة لإلقاء نظرة أولى هي استوديو Qwen. ابدأ بمهمة حقيقية بدلاً من سؤال تافه: قدم موجزًا غير منظم، أو مشكلة برمجة تتضمن ملفات متعددة، أو مجموعة مستندات، أو سير عمل يعتمد على الصور. تحقق مما إذا كانت النتيجة دقيقة وقابلة للتعديل وكاملة بما يكفي لتوفير الوقت.
2. استخدام واجهة برمجة التطبيقات (API) QwenCloud في التطبيقات
يتوفر طراز Qwen3.8-Max من خلال QwenCloud. تشير صفحة الإصدار إلى أن واجهة برمجة التطبيقات (API) الخاصة بها تدعم بروتوكولات إكمال المحادثة والاستجابة المتوافقة مع معايير الصناعة والمتوافقة مع مواصفات OpenAI، بالإضافة إلى واجهة متوافقة مع Anthropic. وهذا يجعل عملية الترحيل أسهل، لكن لا يزال يتعين عليك مراجعة أسماء النماذج والمعلمات وسلوك البث ومخططات الأدوات ومعالجة الأخطاء في الوثائق الرسمية.
3. ربطه بأدوات البرمجة وأدوات الوكلاء
تتضمن صفحة إصدار Qwen عمليات تكامل مع Qwen Code وClaude Code وCodex وOpenClaw. وبالتالي، قد يتناسب هذا النموذج مع سير عمل محطة أو وكيل قائم دون الحاجة إلى واجهة جديدة. لا يلغي دعم التكامل تكلفة الأداة المحيطة، لذا قارن فاتورة النموذج مع الفاتورة المنفصلة هيكل تسعير «كوديكس» قبل توحيد سير العمل داخل الفريق.
يجب على مستخدمي كود Claude أيضًا الفصل بين تكلفة منتج الترميز وواجهة برمجة التطبيقات (API) للنموذج الخارجي. وترد ملخصات للخطط المتاحة ومسارات الفوترة في دليل تسعير الرمز Claude.
يطرح مستخدمو OpenClaw سؤالاً إضافياً: ما هو الطراز الذي يوفر أفضل مزيج بين استخدام الأدوات والسرعة والسعر بالنسبة لوكيل معين؟ إن مقارنة بين طرازي 1TP و13T يوفر إطارًا عمليًّا لاتخاذ هذا الاختيار بدلاً من اللجوء تلقائيًّا إلى النموذج الأكبر حجمًا.
4. الحفاظ على نزاهة سير العمل متعدد النماذج
عند الإطلاق، يُعد QwenCloud مسار الإنتاج المعتمد لطراز Qwen3.8-Max. وإذا قارنت أيضًا بين GPT أو Claude أو Gemini أو البدائل القائمة على تقنية Fable، فإن مساحة عمل متعددة النماذج GlobalGPT يمكن أن يقلل من الحاجة إلى التبديل بين علامات التبويب عبر الطرز التي يدعمها. استخدم مسار Qwen الرسمي لطراز Qwen3.8-Max إلى أن يتم التحقق من صحة صفحة مخصصة لطراز GlobalGPT؛ ولا تفترض وجود عنوان URL جديد للطراز لمجرد أنه تم الإعلان عنه.
Qwen3.8 - الأوزان القصوى المسموح بها
أعلنت شركة Qwen أن أوزان Qwen3.8-Max ستصدر في الأسبوع الذي يلي إطلاق المنتج في 3 أغسطس. نفس الشيء منشور رسمي على X كما ذكر أن طراز Qwen3.8-27B سيصبح من فئة الوزن المفتوح. وهذه أخبار سارة بالنسبة للتطبيقات المحلية والأبحاث، لكن الإعلان وحده لا يكفي للتخطيط لإنشاء مجموعة إنتاجية.
قبل تنزيل الأجهزة أو تخصيص ميزانية لها، تأكد من خمسة عناصر واردة في بطاقة النموذج النهائي:
- شروط الترخيص وشروط الاستخدام التجاري بالتفصيل.
- عناوين URL الرسمية لمستودعات Hugging Face أو ModelScope.
- تنسيقات الدقة والتكمية المتاحة.
- الحد الأدنى والمتطلبات الموصى بها لوحدة المعالجة المركزية (CPU) ووحدة معالجة الرسومات (GPU) وذاكرة الوصول العشوائي (RAM) وسعة التخزين.
- ما إذا كان النموذج الذي تم إصداره يتطابق مع سلوك واجهة برمجة التطبيقات (API) المستضافة وطول السياق.
“مصطلحا ”الوزن المفتوح“ و”المصدر المفتوح» ليسا متطابقين دائمًا. يشير مصطلح «الوزن المفتوح» إلى إمكانية تنزيل معلمات النموذج؛ أما الترخيص فهو الذي يحدد ما يمكنك تعديله أو إعادة توزيعه أو استخدامه تجاريًا. وإلى أن تصبح المستودعات والتراخيص متاحة فعليًّا، فإن الصفحات التي تعد بتنزيل Qwen3.8-Max أو إصدار GGUF أو متطلبات دقيقة للأجهزة المحلية تكون قد استبقت الحقائق.
وينبغي التعامل مع الإعلان الخاص بالطراز 27B بنفس الطريقة. فقد يصبح الخيار الأكثر واقعية للمستخدمين المحليين، لكن يجب أن تستمد معلوماته المتعلقة بالبنية وطول السياق واحتياجات الذاكرة ونتائج اختبارات الأداء من بطاقة المواصفات الرسمية الخاصة به — لا أن تُنسخ من طراز Max.
Qwen3.8-الحدود القصوى والتوافق الأمثل
القيود التي يجب أخذها في الاعتبار
- تأتي معظم الأدلة المتعلقة بالإطلاق من Qwen. قد تستخدم التقييمات المستقلة أسئلة توجيهية أو أدوات أو قواعد تقييم مختلفة.
- السياق الطويل ليس ذاكرة مثالية. قد يستوعب النموذج مليون رمز، ومع ذلك قد يغفل عن أحد التفاصيل أو يتبع تعليمات غير دقيقة.
- قد تصبح العوامل التي تتطلب إنتاجًا مكثفًا مكلفة. يُعد معدل الإخراج البالغ $6 لكل مليون عاملاً مهمًا عندما ينتج سير العمل رموزًا طويلة أو تقارير أو مسارات استدلال متكررة.
- تظل تفاصيل النشر المحلي غير مكتملة إلى حين وصول الأوزان وبطاقة النموذج. لن يعمل نظام «2.4T-total-parameter» بنفس الطريقة التي يعمل بها نموذج المكتب الصغير.
- يُشكل استخدام الأدوات طبقة إضافية من الفشل. قد تؤدي حالة المتصفح، والأذونات، وأخطاء الشبكة، ومخططات الأدوات غير المحددة بشكل جيد إلى تعطيل نموذج كان من الممكن أن يكون فعالاً لولا ذلك.
- تتغير معلومات الإطلاق بسرعة. ينبغي إعادة التحقق من الأسعار والمستودعات وعمليات التكامل وتوافر المنتجات قبل النشر أو الشراء.
من ينبغي أن يجربه الآن؟
الخلاصة البسيطة هي أن Qwen3.8-Max يستحق اختبارًا جادًّا، ولكنه لا يستحق الترحيل الأعمى. استخدم مهمة واحدة صعبة ذات شرط نجاح واضح، وسجل إجمالي الرموز والمحاولات المتكررة، وقارن النتيجة النهائية — وليس مجرد الإجابة الأولى.
الأسئلة المتداولة
متى تم إصدار الإصدار Qwen 3.8 Max؟
تم الإعلان رسميًا عن Qwen3.8-Max في 3 أغسطس 2026. وأصبح النموذج المستضاف متاحًا عبر Qwen Studio وQwenCloud عند الإطلاق. وأعلنت شركة Qwen أن الأوزان المفتوحة ستصدر في الأسبوع التالي، لذا ينبغي اعتبار توفر واجهة برمجة التطبيقات (API) وتوفر الأوزان القابلة للتنزيل معلمين منفصلين.
هل برنامج Qwen3.8-Max مفتوح المصدر؟
أعلنت شركة Qwen عن إصدار “open weights” لبرنامج Qwen3.8-Max، لكن المستودع النهائي والترخيص هما اللذان يحددان ما يجوز للمستخدمين تشغيله أو تعديله أو إعادة توزيعه أو استخدامه تجاريًّا. وإلى أن يتم نشر تلك الملفات والتحقق منها، فإن عبارة «الإعلان عن إصدار open weights» تُعد أكثر دقة من افتراض أن جميع أذونات البرمجيات مفتوحة المصدر أو التنسيقات المحلية متاحة بالفعل.
كم عدد المعلمات التي يحتوي عليها الموديل Qwen3.8-Max؟
يحتوي نموذج Qwen3.8-Max على إجمالي 2.4 تريليون معلمة، ويقوم بتنشيط 95 مليار معلمة لكل توكن. ويستخدم هذا النموذج بنية «مزيج الخبراء» (mixture-of-experts)، لذا فإن إجمالي عدد المعلمات وعدد المعلمات النشطة يصفان أجزاء مختلفة من النظام. ولا يمكن لأي من هذين الرقمين بمفرده التنبؤ بالسرعة الفعلية أو متطلبات الأجهزة.
ما هي نافذة السياق Qwen3.8-Max؟
يحدد الإصدار الرسمي نافذة سياق تبلغ سعتها مليون توكن. وتعد هذه السعة كافية لتغطية الأكواد الضخمة والوثائق ومخرجات الأدوات وسجل العميل، لكن الحد الأقصى لسعة السياق لا يضمن استرجاعًا مثاليًا. قم باختبار النموذج بناءً على موضع المعلومات وتنسيقها وكثافتها المستخدمة في سير عملك الفعلي.
كم تبلغ تكلفة واجهة برمجة التطبيقات Qwen3.8-Max؟
عند الإطلاق، حددت Qwen سعر $2 لكل مليون توكن مدخل، و$6 لكل مليون توكن مخرج، و$0.25 لكل مليون توكن مخزّن ضمنيًا. تعامل مع هذه الأسعار على أنها أسعار الإطلاق وتحقق منها قبل وضع الميزانية. كما تعتمد تكاليف الوكيل على إعادة استخدام السياق، وجهد الاستدلال، ومحاولات الإعادة، وطول المخرجات التي يتم إنشاؤها.
هل طراز Qwen3.8-Max أفضل من طراز GPT-5.6 Sol أو Fable 5؟
ليس في كل اختبار. يُظهر الجدول الرسمي لـ Qwen أن طراز Qwen3.8-Max يتصدر بعض معايير الأداء المتعلقة بالبرمجة والبحث واتباع التعليمات واستخدام الكمبيوتر، بينما يتصدر طراز GPT-5.6 Sol أو Fable 5 معايير أخرى. يعتمد اختيار النموذج الأفضل على المهمة وبيئة الأدوات وزمن الاستجابة والسعر وجودة الناتج النهائي.
هل يمكنني تشغيل Qwen3.8-Max محليًّا؟
أعلنت شركة Qwen عن توفر أوزان قابلة للتنزيل للأسبوع الذي يلي الإطلاق، لكن إمكانية تطبيق ذلك محليًّا تعتمد على الملفات النهائية، والدقة، ودعم التكمية، والترخيص، وإرشادات الأجهزة. انتظر صدور بطاقة النموذج الرسمية قبل الاعتماد على التقديرات الدقيقة لذاكرة الوصول العشوائي (RAM) أو ذاكرة الفيديو (VRAM) أو سعة التخزين. وقد تكون الإصدارات الأصغر حجمًا من طراز Qwen3.8 أكثر عملية بمجرد توثيقها رسميًّا.
ما هو Qwen3.8-27B؟
تشير منشورة إطلاق Qwen إلى أنه سيتم أيضًا إصدار Qwen3.8-27B بأوزان مفتوحة. ولا يقدم مقال إصدار Max تفاصيل كافية لإعادة استخدام مواصفات نموذج Max في الإصدار 27B. يرجى مراجعة بطاقة النموذج المخصصة للاطلاع على بنيته ونوافذ السياق ونتائج الاختبارات القياسية والترخيص وتعليمات التنزيل.
هل يمكنني استخدام Qwen3.8-Max مع GlobalGPT؟
لم يتم التحقق من وجود مسار مخصص GlobalGPT لـ Qwen3.8-Max حتى وقت النشر. استخدم Qwen Studio أو QwenCloud للوصول المباشر. ويظل GlobalGPT مفيدًا لمقارنة نماذج GPT وClaude وGemini وFable الأخرى المتاحة دون الحاجة إلى تغيير المنصات.
الحكم النهائي
استخدم Qwen Studio أو QwenCloud لتقييم Qwen3.8-Max مباشرةً. استخدم GlobalGPT لمقارنة النماذج الأخرى التي تم التحقق منها دون الإشارة إلى وجود مسار مخصص لـ Qwen3.8-Max بالفعل.
قارن بين الطرازات المتوفرةيُعد «Qwen 3.8 Max» أحد أكثر عمليات إطلاق النماذج طموحًا في عام 2026: حيث يبلغ إجمالي المعلمات 2.4 تريليون معلمة، وعدد المعلمات النشطة 95 مليار معلمة، ونافذة سياق تبلغ سعة مليون توكن، ونتائج رسمية قوية في مجالات البرمجة والوكلاء متعددي الوسائط، بالإضافة إلى مسار مفتوح معلن لتحديد الأوزان. وتعتبر أسعار واجهة برمجة التطبيقات (API) الخاصة بإطلاقه تنافسية بما يكفي لإجراء الاختبارات، خاصةً عندما يقلل التخزين المؤقت من تكاليف السياق المتكررة.
السبب الأقوى الذي يدعو إلى الاهتمام ليس مجرد الفوز بمعيار تقييمي واحد، بل هو محاولة الجمع بين البرمجة، والنتائج المهنية، والتخطيط طويل المدى، والتغذية الراجعة المرئية، واستخدام الأدوات في نموذج واحد. ابدأ باستخدام Qwen Studio أو إجراء تقييم خاضع للرقابة لـ QwenCloud، وقم بقياس جودة المهام المنجزة والتكلفة الإجمالية، وانتظر صدور الأوزان الرسمية والترخيص قبل الإدلاء بأي وعود بشأن النشر المحلي.
المصادر الأولية التي تم التحقق منها في 4 أغسطس 2026: الإصدار الرسمي لـ Qwen3.8-Max و المنشور الرسمي لإطلاق @Alibaba_Qwen.