أُجريت الاختبارات في 7 و11 سبتمبر 2026؛ وأُعيد التحقق من المصادر في 16 سبتمبر 2026.
هناك نقطة واحدة تحتاج إلى توضيح بشأن الاسم. لا يزال الناس يبحثون عن “Grok 4”، لكن الطراز الذي قمنا باختباره كان Grok 4.6, ، وليس موعد الإصدار الأصلي في يوليو 2025. الموعد الحالي كتالوج نماذج xAI يوصي باستخدام Grok 4.6 للرمز، في حين أن النسخة الأصلية grok-4-0709 تم إيقاف استخدام اسم واجهة برمجة التطبيقات (API). سأقوم بفصل هذه المنتجات والتواريخ عن بعضها البعض طوال هذه المراجعة.
إذا كنت تقارن بين عدة مساعدين قبل اختيار أحدهم، فابدأ بالنظر إلى الصورة الأوسع أفضل نموذج ذكاء اصطناعي لمقارنة الأكواد البرمجية. والسؤال الأضيق نطاقًا هنا هو ما إذا كان بإمكان Grok تحويل موجز برمجي دقيق إلى عمل يمكنك التحقق منه فعليًّا.
إجابة سريعة: هل طراز Grok 4 مناسب للبرمجة؟
يُعد الإصدار Grok 4.6 جيدًا بما يكفي ليكون مفيدًا في تصحيح أخطاء دالة مضمنة، وإنشاء نسخة أولية من التنفيذ، وشرح الكود غير المألوف، وصياغة الاختبارات. إلا أنه ليس موثوقًا بما يكفي لقبوله دون تنفيذه. فالأخطاء التي ظهرت في مجموعة الاختبارات الصغيرة الخاصة بنا لم تكن مجرد خلافات غامضة حول أسلوب البرمجة: فقد أدى إعادة هيكلة واحدة إلى صافي من كل نتيجة غير فارغة، وفشلت مجموعة اختبارات واحدة تم إنشاؤها في التمييز بين التأخير والطابع الزمني المطلق.
المعيار العملي بسيط: اعطِ البرنامج عقدًا محدودًا، واطلب تغييرًا واحدًا، وقم بإجراء فحوصات مستقلة. فالنموذج الذي ينتج كودًا معقولًا بسرعة قد يقوم مع ذلك بمسح حقل واحد، أو إضعاف ثابت واحد، أو الالتزام بمتطلبات الكود مع تجاهل متطلبات تنسيق الاستجابة.
يمكنك جرب Grok 4.6 على GlobalGPT للمطالبات المحدودة والمقارنات جنبًا إلى جنب. GlobalGPT هي منصة مستقلة؛ وهي لا تحل محل Grok Build، ولا بيئة التطوير المتكاملة (IDE)، ولا الوصول إلى مستودع البرامج، ولا وحدة التحكم الخاصة بواجهة برمجة التطبيقات (API) الأصلية لـ xAI، ولا مسار التكامل المستمر (CI) الخاص بك.
ما قمنا باختباره فعليًّا
قمنا بتقييم أربع مهام صغيرة في لغة جافا سكريبت: إصلاح دمج الفترات الزمنية، وتصحيح أخطاء تخصيص المقاعد بناءً على الأولوية، وإعادة هيكلة دالة تلخيص التغييرات، وكتابة اختبارات لـ "Retry-After" المحلل. كانت كل مهمة مزودة بموجه ثابت ومُقيِّم محلي حتمي. تم تشغيل ثلاث مهام في 11 سبتمبر 2026؛ أما المهمة المتقطعة فقد أعيد استخدام تشغيلها الذي تم في 7 سبتمبر، وقمنا بإعادة فحصها بمقارنتها بالموجه المخزّن والاستجابة الأولية والمُقيِّم.
- المكان: واجهة برمجة تطبيقات (API) تجميع «برولي» المصرح بها من قبل المستخدم، وميزة «إكمال المحادثة».
- الطراز المطلوب والمُعاد:
grok-4.6. - المحاولات: طلب واحد لكل مهمة، دون أي محاولات إعادة.
- التنفيذ: تم عزل جافا سكريبت الذي تم إرجاعه وتشغيله محليًّا باستخدام نماذج اختبار أو متغيرات مُعلنة مسبقًا.
- غير متاح في هذا الطراز: بيئة تطوير متكاملة (IDE)، ومستودع، واتصال بالإنترنت، وأنظمة لتشغيل أدوات الذكاء الاصطناعي (xAI) وأنظمة الإنتاج.
تُعد تسمية البوابة دليلاً مفيداً على المصدر، لكنها لا تثبت بشكل مستقل عملية النشر في المراحل الأولية. ويشمل الوقت المنقضي الأعباء الإضافية للشبكة والبوابة، كما أن أعداد الرموز المُبلغ عنها لا تُعتبر أساساً رسمياً للفوترة الخاصة بـ xAI. للحصول على نظرة أوسع على مستوى المنتج، انظر المستند المنفصل مراجعة Grok 4.6 واختبارات حقيقية.
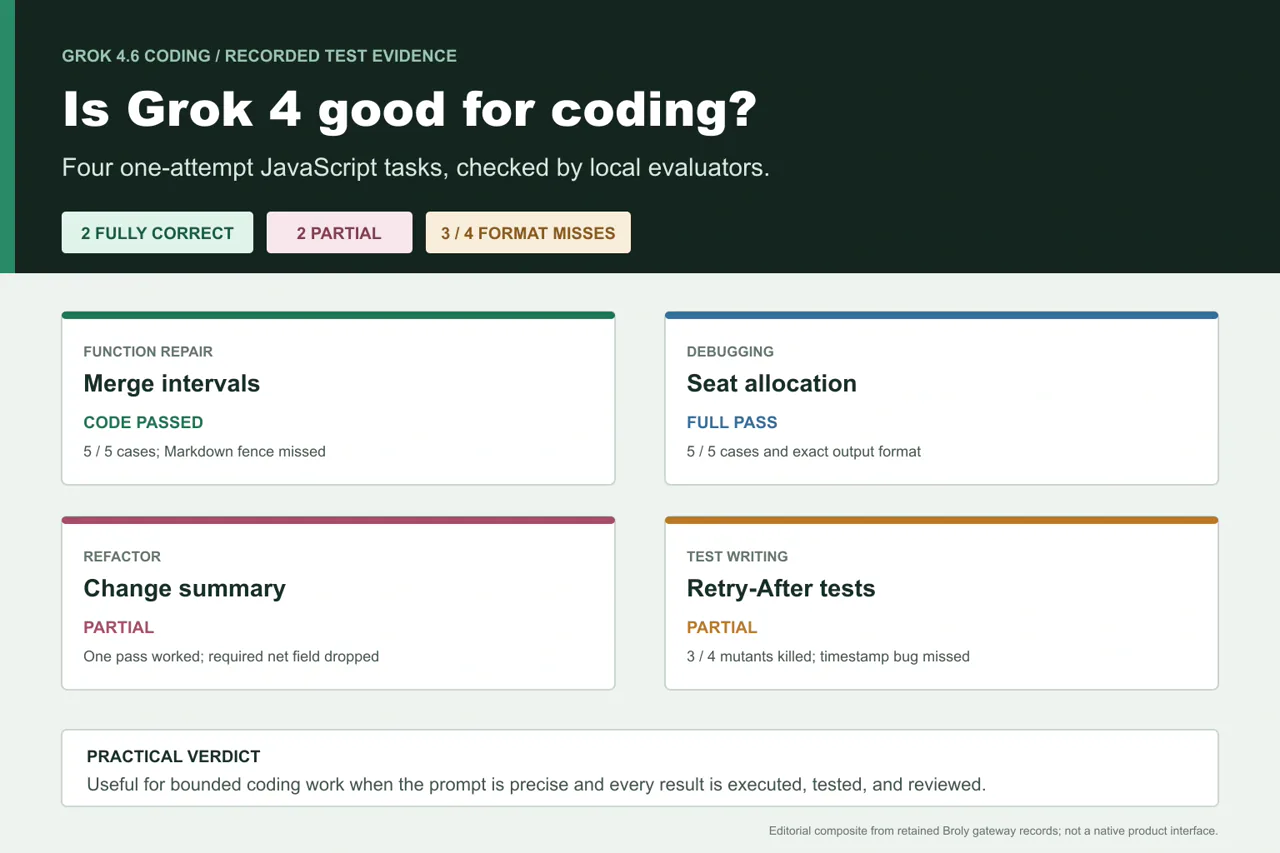
نتائج اختبار البرمجة في لمحة سريعة
صافي.لم تكن أفضل نتيجة هي الإجابة الأطول. بل كانت عملية إصلاح توزيع المقاعد: موجزة، ومنسقة بشكل صحيح، وكاملة من الناحية السلوكية. أما الفشل الأكثر إفادةً فكان عملية إعادة الهيكلة، لأن التنفيذ بدا نظيفًا واستوفى متطلبات «المرور الواحد» بينما غيَّر عقد الإخراج دون الإشارة إلى ذلك.
الاختبار 1: إصلاح دالة فترة الدمج
قامت الدالة الأولى بتغيير قيمة مدخلاتها، وتوقفت عن العمل عند وجود مصفوفة فارغة، وفشلت في دمج نقاط النهاية المتجاورة، كما تمكنت من تقليص الفاصل الزمني الأكبر عند ظهور فاصل زمني متداخل لاحقًا. وقد أوضحت المطالبة تلك الثوابت بشكل صريح.
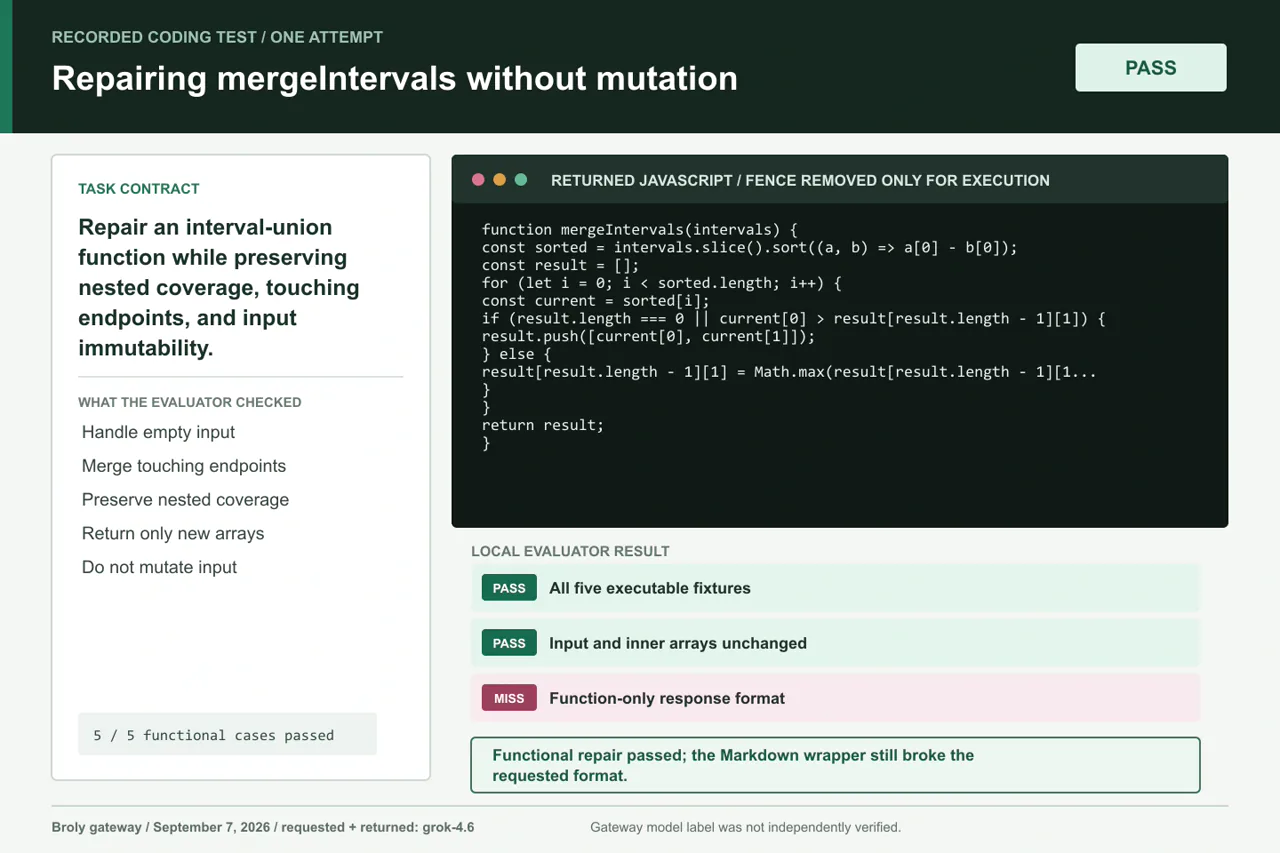
الحد الرئيسي: تم اجتياز اختبار الإصلاح الوظيفي بعد إزالة السياج الخارجي لـ Markdown فقط من أجل التنفيذ.
النتيجة: تم اجتياز جميع الحالات الخمس القابلة للتنفيذ. فقد أعادت الدالة مصفوفات جديدة، ولم تُغير قيم المدخلات، وحافظت على التغطية المتداخلة، ودمجت نقاط النهاية المتجاورة. ومع ذلك، فشلت في تنفيذ تعليمة واحدة صريحة بسبب تغليف الكود بلغة ماركداون. وبعد إزالة ذلك الحاجز الخارجي للتنفيذ فقط، كانت النتيجة الوظيفية صحيحة.
نصيحة عملية: تمكنت Grok من معالجة مشكلة بسيطة في الإصلاح عندما أشارت الأداة إلى الحالات الاستثنائية الخفية. قد يبدو خطأ التنسيق هذا بسيطًا بالنسبة للفرد، لكنه قد يؤدي إلى تعطل سلسلة العمليات التي تتوقع نصًا قابلًا للتنفيذ مباشرةً.
الاختبار 2: تصحيح أخطاء تخصيص المقاعد بناءً على الأولوية
جمعت هذه المهمة بين معالجة حالات التعادل الثابتة، وأولوية الترتيب التنازلي، وعدم التغيير، والسعة الدقيقة، وقاعدة “التخطي والمتابعة”. كان الكود الأصلي يقوم بالفرز في الاتجاه الخاطئ، ويُغيّر مصفوفة المدخلات، ويتوقف قبل الأوان عندما يكون حجم أحد الطلبات أكبر من المسموح به.
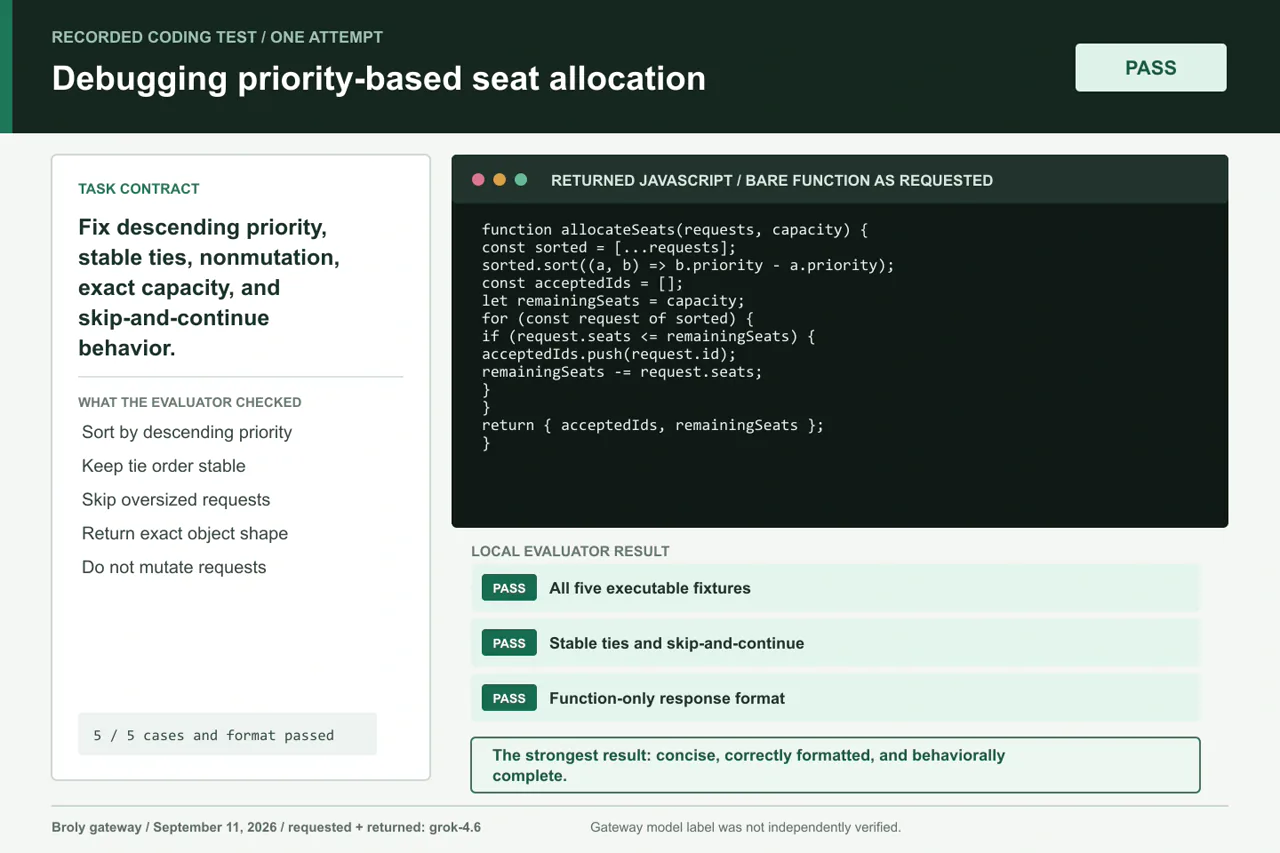
الحد الرئيسي: كان هذا هو الرد الوحيد الذي استوفى شروط العقد السلوكي وتنسيق الإخراج المطلوب بالضبط.
النتيجة: تم اجتياز الحالات الخمس جميعها، بما في ذلك ترتيب الأولوية المتساوية، والطلب الرئيسي ذو الحجم الزائد، والسعة المحددة، والسعة الصفرية، والقائمة الفارغة. وظل الإدخال دون تغيير،, المعرّفات المقبولة كان مصفوفة جديدة، ولم يُرجع النموذج سوى الدالة المطلوبة.
نصيحة عملية: هذا هو النوع من المهام التي تتناسب تمامًا مع Grok: وظيفة واحدة، وعقد واضح، وحالات حدية يمكن تنفيذها على الفور.
الاختبار 3: إعادة هيكلة الكود دون فقدان السلوك
طلبت المهمة الثالثة من Grok استبدال عمليات المسح المتكررة بمرحلة تجميع واحدة مع الحفاظ على الترتيب وأسماء الملفات غير المعتادة وشكل المخرجات بالضبط. ويُعد هذا خطرًا واقعيًا يترتب على إعادة هيكلة الكود: فقد يصبح الكود أسرع وأكثر نظافة، لكن مع فقدان بعض السلوكيات.
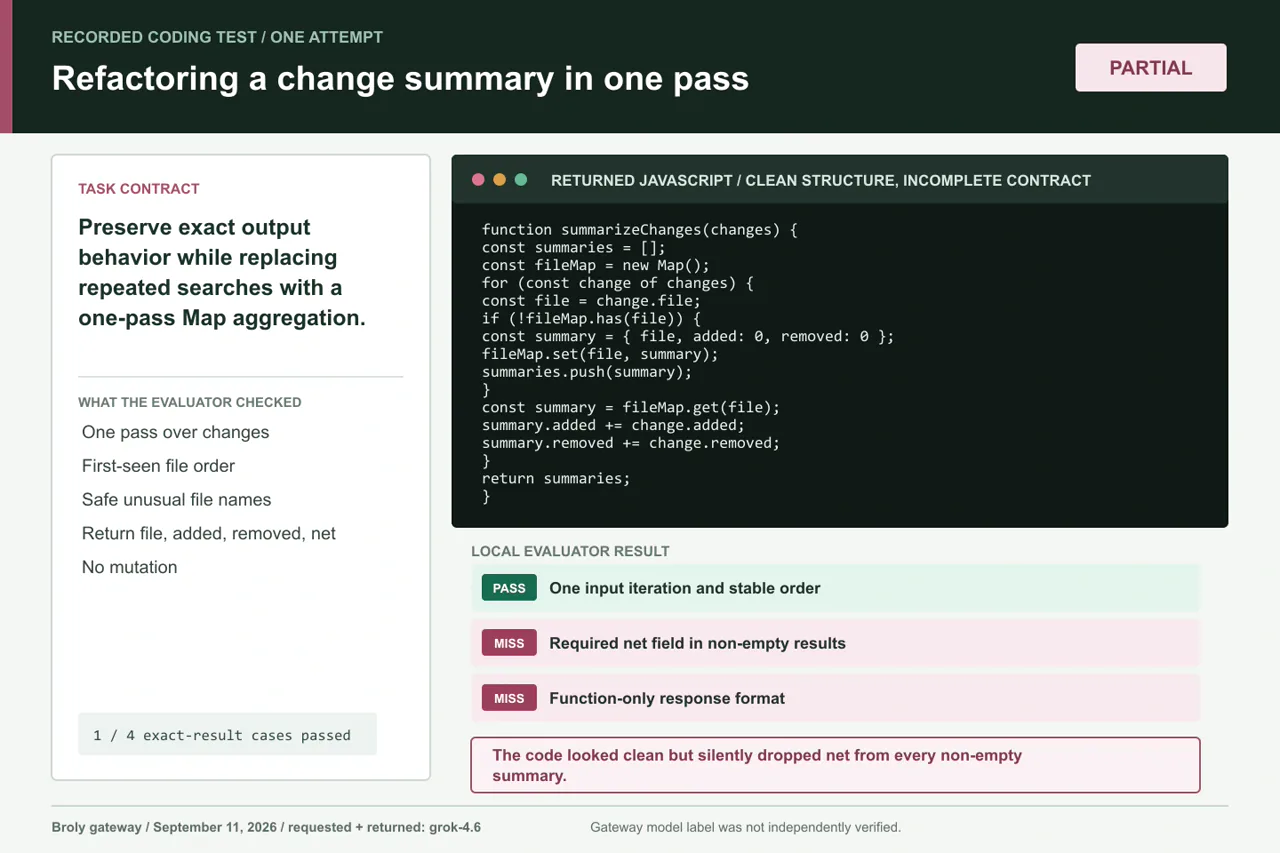
الحد الرئيسي: بدا نهج «Map» ذو المرور الواحد صحيحًا، لكنه حذف الحقل «net» المطلوب دون إظهار أي رسالة خطأ.
النتيجة: استخدمت الاستجابة تمريرة واحدة، وهي خريطة, ، والترتيب الصحيح حسب أول ظهور، والتعامل الآمن مع __proto__ و منشئ, ، ولم تحدث أي طفرة في المدخلات. لكنه لم يقم أبدًا بالحساب أو بإرجاع النتيجة صافي. تم اجتياز الحالة الفارغة لأنها لم تحتوِ على أي كائنات نتائج؛ أما الحالات الثلاث غير الفارغة فقد فشلت جميعها في المقارنة الدقيقة.
نصيحة عملية: لا تحكم أبدًا على عملية إعادة الهيكلة بناءً على التعقيد الخوارزمي أو نظافة الكود فقط. قم بأخذ لقطة من المخرجات القديمة، وتأكد من صحة كل الحقول المطلوبة، وقارن الأداء قبل قبول الإصدار الجديد.
الاختبار 4: كتابة اختبارات تكشف عن الأخطاء المحتملة
عكست المهمة الأخيرة الترتيب المعتاد: فقد كتب Grok الاختبارات، وقام نظام الاختبار الخاص بنا بتشغيلها على تنفيذ مرجعي صارم واحد بالإضافة إلى أربعة تنفيذات خاطئة عن عمد. ولم يكن الهدف هو تغطية الأسطر، بل كان الهدف هو معرفة ما إذا كانت المدخلات المختارة قادرة على التمييز بين الدلالات المتشابهة في المظهر.
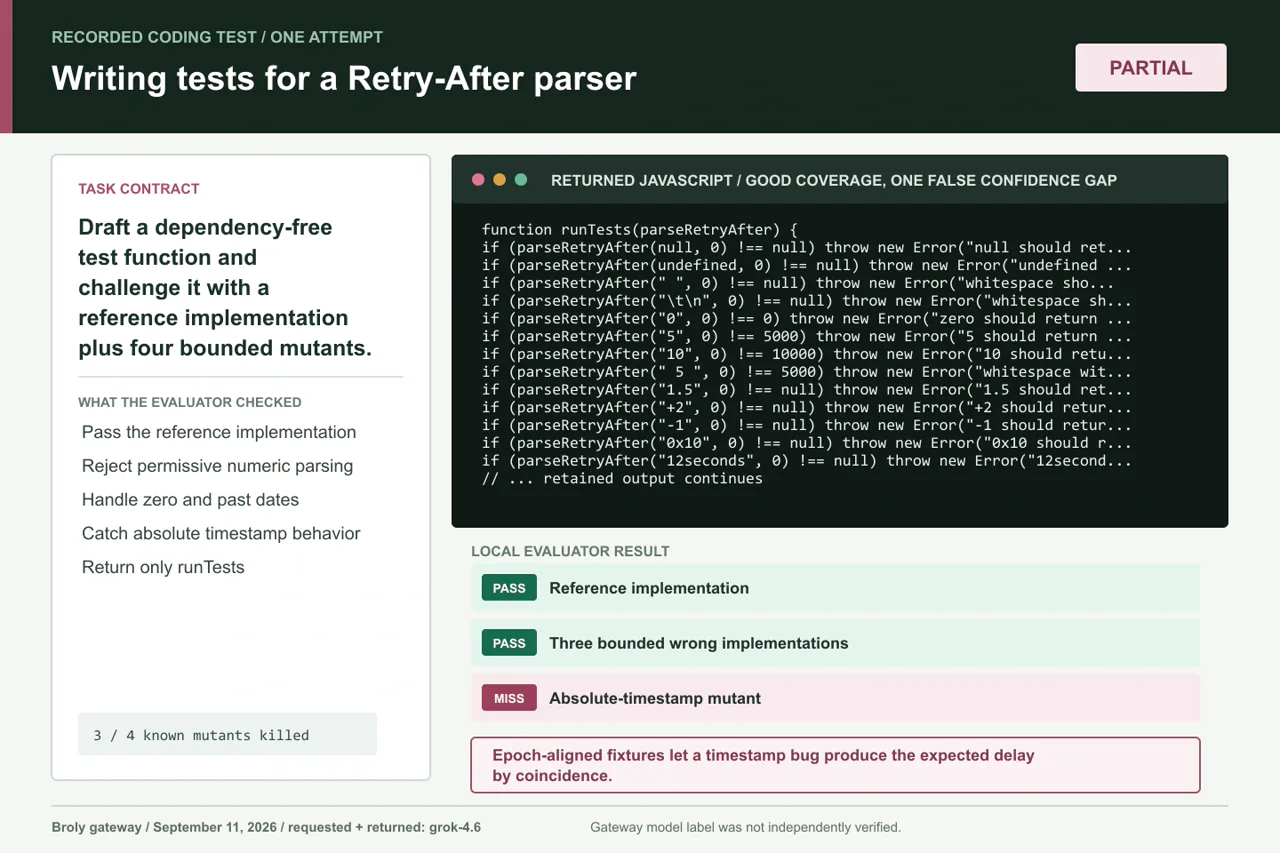
الحد الرئيسي: تسمح آليات تحديد التواريخ المرتبطة بالعصر باستمرار وجود خطأ في الطابع الزمني المطلق عن طريق الصدفة.
النتيجة: اجتازت المجموعة الاختبار المرجعي واكتشفت حالات التحليل العددي المتساهل، حيث عُومل الصفر على أنه قيمة كاذبة، والتأخير السلبي لتاريخ مضى. لكنها لم تكتشف الحالة الشاذة التي أعادت الطابع الزمني المطلق للتاريخ الذي تم تحليله. استخدم كلا اختباري التاريخ قيمًا مُحاذاة مع العصر، لذا صادف أن التأخير المتوقع كان مساويًّا للطابع الزمني.
نصيحة عملية: تعد الاختبارات المكتوبة بواسطة الذكاء الاصطناعي خطوة أولى مفيدة، وليست دليلاً على صحة النتائج. اسأل عن ما يميز كل اختبار. فاختبارات الطفرات، واختبارات الخصائص، والقيم غير المتوافقة عمدًا، يمكن أن تكشف عن مجموعة اختبارات تبدو شاملة فحسب.
Grok 4 وGrok 4.6 وGrok Build ليست نفس الشيء
سياق الإطلاق في يوليو 2025. تم إيقاف استخدام رابط واجهة برمجة التطبيقات (API) القديم لاحقًا.
العلامة التي أرجعتها البوابة في هذه المهام الأربع المنفصلة.
وكيل مستقل يمكنه العمل من خلال سير عمل مستودع تفاعلي أو غير تفاعلي.
أداة Python تعمل في بيئة معزولة (sandbox) ويجب تفعيلها في طلب مدعوم.
إن الإعلان الأصلي رقم Grok 4 وهو سياق الإطلاق التاريخي. ولا يصف النموذج المستخدم في اختباراتنا لعام 2026.
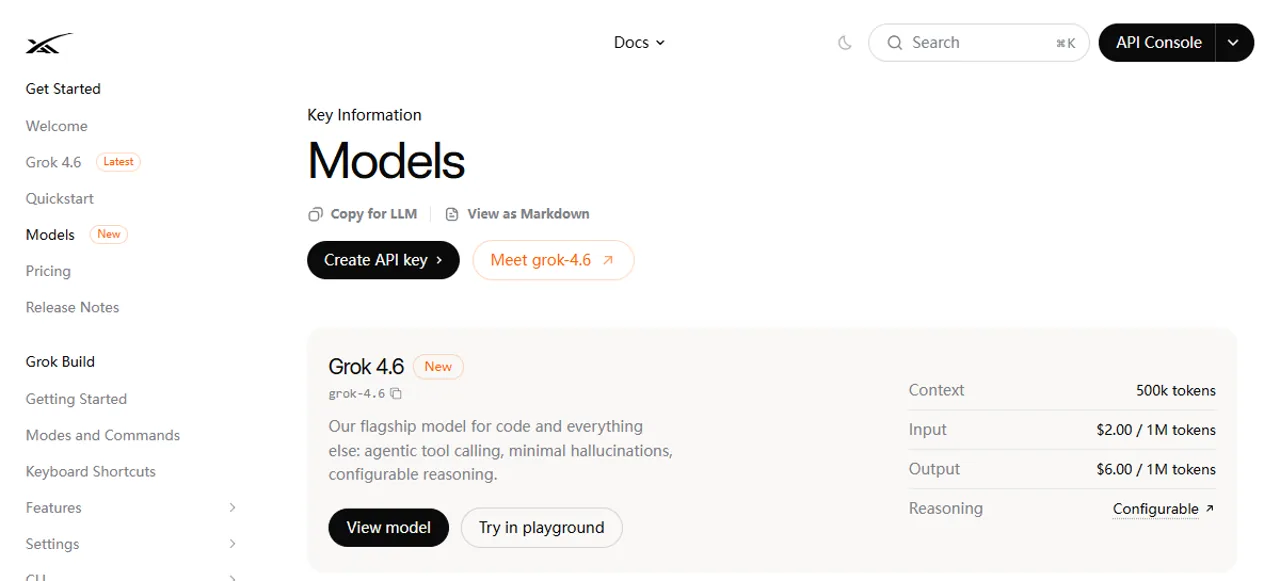
xAI’s 15 مايو 2026 — إشعار بالانتقال يقول grok-4-0709 يتم الآن إعادة التوجيه إلى Grok 4.3 مع مستوى منخفض من الاستدلال. وهذا لا يعني أن كل منتج يحمل اسم عائلة Grok 4 قد اختفى؛ بل يعني أن معرّف الطراز المحدد هو ما يهم.
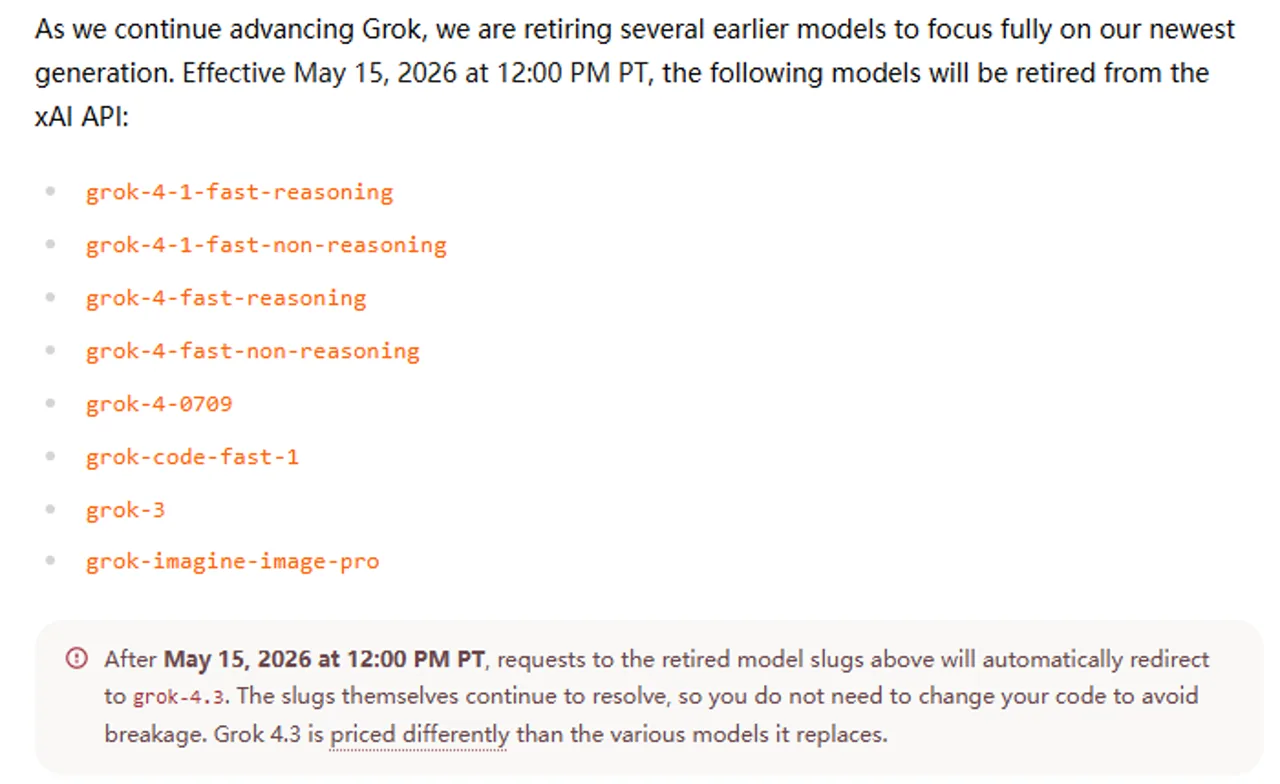
Grok 4.6 هو الطراز الحالي الذي توصي به xAI لكتابة الكود. النسخة الرسمية مواصفات Grok 4.6 وتشمل قائمة الأدوات المدعومة استدعاء الدوال، والبحث على الويب، والبحث في X، وتنفيذ التعليمات البرمجية. ولا يعني الدعم التفعيل التلقائي: فالمنتج المستدعي أو طلب واجهة برمجة التطبيقات (API) هو الذي يحدد ما يمكن للنموذج رؤيته والقيام به.
إن إعلان Grok 4.6 يُعد هذا النموذج مثاليًّا للوكلاء الذين يعملون لفترات طويلة ولأعمال قاعدة الكود. وهذه مزاعم رسمية عن المنتج، وليست نتائج قياسات أجراها بشكل مستقل كل من مهام جافا سكريبت الأربع المنفصلة لدينا.
إصدار Grok هو أداة الترميز المستقلة. ويمكن لواجهة المحطة الطرفية التفاعلية الخاصة به ووضع التشغيل بدون واجهة مستخدم أن تعمل ضمن سير عمل المستودع. إذا كنت تختار من بين أسماء النماذج بدلاً من منتجات الترميز، فإن أفضل طراز Grok حسب المهمة يشرح الدليل الوضع الحالي للأسرة.
إن أداة تنفيذ التعليمات البرمجية xAI هي بيئة Python اختيارية تعمل في وضع الحماية. لم تكن هذه البيئة نشطة في اختباراتنا الخاصة بـ Broly، لذا لم يقم النموذج بتشغيل جافا سكريبت خاص به أو فحص ملاحظات المُقيِّم قبل الإجابة.
أفضل حالات استخدام الترميز لـ Grok
تصحيح خطأ محصور
يكون Grok أكثر فائدة عندما يمكن اختزال الخلل إلى دالة، أو تتبع مكدس، أو أداة اختبار معطلة، أو مقارنة قصيرة. قم بتضمين ما كان من المفترض أن يحدث، وما حدث فعليًّا، والحدود التي لا تريد تغييرها. تُظهر نتيجة تخصيص المقاعد كيف يمكن لحالة حدية محددة أن تحول طلبًا غامضًا من نوع “أصلح هذا” إلى تصحيح قابل للتحقق.
إنشاء النسخة الأولى من التطبيق
بالنسبة للمحولات والمحللات ووظائف التحويل وأمثلة واجهة برمجة التطبيقات (API)، يمكن لـ Grok التغلب على العقبات التي تسببها الصفحات الفارغة. اطلب أصغر وحدة كاملة، وإصدارات مكتبة الدبابيس، وقم بتشغيل المقتطف البرمجي. الـ دليل تكامل واجهة برمجة التطبيقات (API) لـ Grok 4 وهي الخطوة التالية عندما يتعلق الأمر بواجهة برمجة التطبيقات (API) بدلاً من حل برمجي منفرد.
مراجعة الاختبارات أو صياغتها
اطلب من Grok تحديد حالات الحدود المفقودة، والثوابت، والمتغيرات المرشحة. ثم تحقق مما إذا كانت كل مدخلة تميز السلوك الذي تدعي اختبارها. كانت مجموعة اختبارات «Retry-After» واسعة النطاق نظريًّا، لكن زوجًا واحدًا من الطوابع الزمنية المتوافقة سمح لخطأ دلالي بالبقاء.
مقارنة بين النُهج البديلة
كما يُعد Grok مفيدًا كرأي ثانٍ بشأن خوارزمية أو بنية بيانات أو فرضية تتعلق بتصحيح الأخطاء. وعندما يتعلق القرار بملاءمة المساعد بدلاً من تصحيح واحد، فإن مقارنة الترميز بين Grok وChatGPT يضيف عرضًا مشتركًا بين النماذج.
الحالات التي تتطلب الإشراف على الترميز Grok
عمليات إعادة الهيكلة التي تحافظ على السلوك: يمكن للنموذج أن يستوفي متطلبات الخوارزمية المطلوبة مع وجود حقل إخراج واحد مفقود. قم بإجراء اختبارات الانحدار وقارن بين المخرجات المتسلسلة، والأخطاء، وترتيب العناصر، والتغييرات، والآثار الجانبية.
التغييرات في مستودع الملفات المتعددة: لا تشمل أدلتنا عمليات اكتشاف التبعيات، وأنظمة البناء، والبحث في الكود، والملفات المُنشأة، وعمليات الترحيل، أو عمليات التحرير المنسقة. استخدم أداة برمجة حقيقية تتمتع بحق وصول محدود إلى المستودع، ثم راجع أوامرها ونتائج المقارنة. الـ مقارنة بين «كوديكس» و«Claude» كعامل تشفير يوضح ذلك لماذا يُعد سير العمل المحيط بالنموذج أمرًا لا يقل أهمية عن النموذج نفسه.
الأعمال الأمنية والإنتاجية: لا تعتبر الردود المؤكدة بمثابة نموذج للتهديدات أو تدقيقًا للتبعيات أو موافقة على النشر. احرص على إشراك كل من البنية المستمرة (CI) والتحليل الثابت وفحص الأسرار وبيئة الاختبار والتراجع والمراجعة البشرية في العملية.
تنسيقات صارمة للتواصل بين الأجهزة: استخدمت ثلاثة من أصل أربعة ردود أولية سياج «ماركداون» على الرغم من وجود تعليمات صريحة بعدم استخدام «ماركداون». يجب التحقق من صحة الناتج وتحليله عند الحدود؛ ولا يجب أبدًا تمرير نص النموذج مباشرةً إلى مرحلة التنفيذ لمجرد أنه يبدو وكأنه كود برمجي.
التكاليف وسلاسل الاستدلال الطويلة: أبلغت بوابتنا عن 4,260 رمز إتمام لطلب يتضمن max_tokens: 4096, ، وغالبًا ما تكون بمثابة رموز استدلالية. هذه الملاحظة لا تثبت سلوك «xAI» فيما يتعلق بالفوترة أو تحديد السقف. راجع المنصة الرسمية الحالية وقارنها بـ Grok 4: دليل التسعير والإعداد لواجهة برمجة التطبيقات (API) قبل تقدير ميزانية الإنتاج.
طريقة عمل عملية لاستخدام Grok في الكود
1. الحد من المشكلة
يرجى تزويدنا بأصغر نسخة من Grok التي لا تزال تُظهر الخطأ. يرجى تضمين تفاصيل الخطأ، والشفرة ذات الصلة، ونتيجة واحدة متوقعة. يرجى حذف سجل المشروع والأسرار غير ذات الصلة.
2. اكتب عقدًا، لا مجرد أمنية
اذكر اسم الدالة، والمدخلات المقبولة، وشكل الناتج الدقيق، وترتيب المعلمات، وقواعد التغيير، وحدود التبعية، وتنسيق الناتج. و دليل استخدام Grok 4 يغطي هذا الموضوع النطاق الأوسع للعملية وسير العمل المرتبط بها.
3. اطلب بعض الفكة
يفضل استخدام دالة واحدة أو تعديل محدد الهدف بدلاً من إعادة كتابة شاملة. اطلب منه الحفاظ على السلوك العام وتحديد أي افتراضات اضطر إلى وضعها.
4. إجراء عمليات تدقيق مستقلة
قم بتنفيذ الكود خارج استجابة النموذج. أضف حالات الحدية التي تميز بين المعاني المتقاربة، وتحقق من تغير المدخلات، وقارن كل حقل من حقول المخرجات، واختبر حالات الفشل المتوقعة. بالنسبة لمجموعات الاختبارات التي تم إنشاؤها، قم بتشغيل المتغيرات المعروفة عندما يبرر الخطر ذلك.
5. مراجعة الفروق واتخاذ القرار
اقرأ ملف الفروق النهائي كما لو كان صادرًا عن مساهم بشري. تأكد من تغييرات التبعيات، وحدود الأمان، وقابلية المراقبة، وإمكانية التراجع. ويظل الشخص الذي يقوم بالدمج أو النشر مسؤولاً عن النتيجة.
ما يعلنه المطورون علنًا
تتباين تجارب المستخدمين، وهي تعتمد بشكل كبير على المهمة والمنتج والموضوع والتاريخ. ويوضح تعليقان على موقع «هاكر نيوز» هذا التباين، لكن لا يُعتبر أي منهما معيارًا أو استطلاعًا تمثيليًّا.
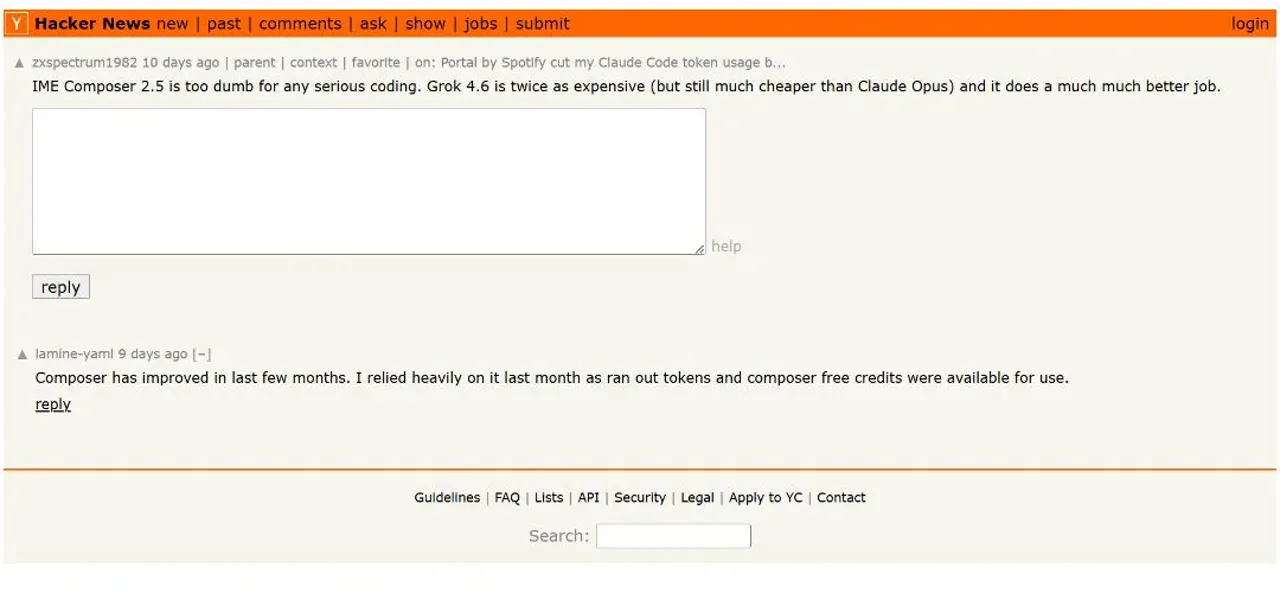
في 5 سبتمبر 2026، أحد مستخدمي موقع Hacker News zxspectrum1982 وصف Grok 4.6 بأنه يؤدي مهام البرمجة المعقدة بشكل أفضل بكثير من Composer 2.5، مع الإشارة في الوقت نفسه إلى أن تكلفته أعلى. وهذه مقارنة من جانب مستخدم واحد، وليست ادعاءً عامًّا بشأن الأداء.
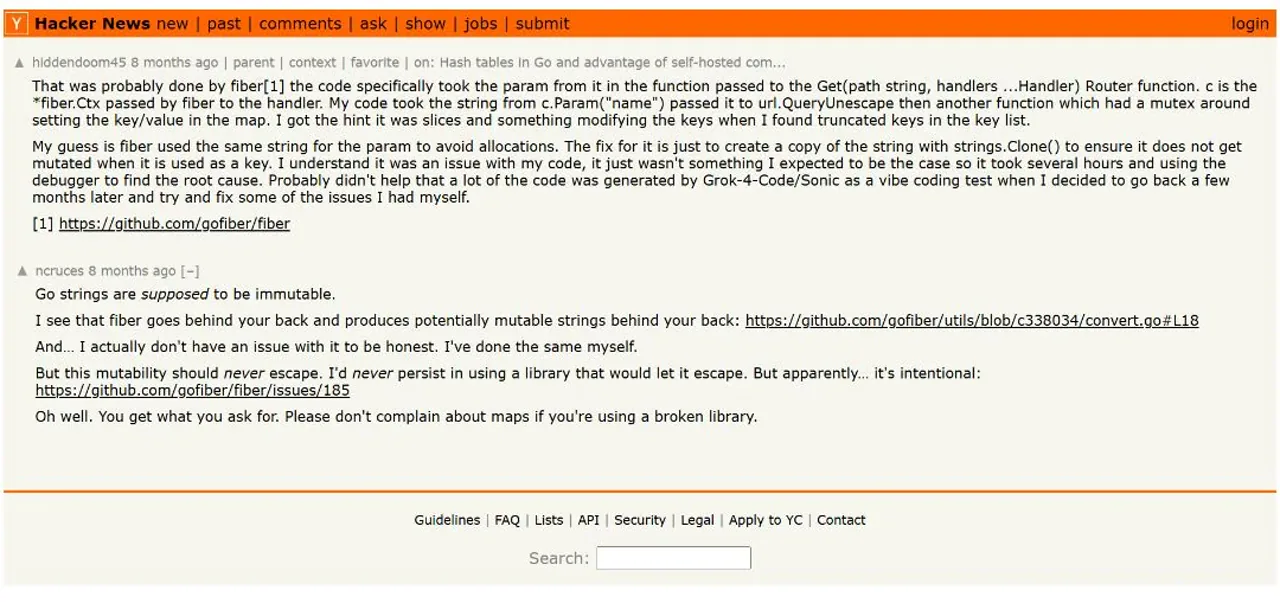
في 20 ديسمبر 2025، أحد مستخدمي موقع Hacker News hiddendoom45 وقد وُصف اكتشاف خطأ خفي يتعلق بعمر سلسلة Go/Fiber لاحقًا باستخدام أداة تصحيح الأخطاء بعد أن تم إنشاء الكود خلال تجربة Grok-4-Code/Sonic. ويدعم هذا السرد التاريخي أهمية التصحيح اليدوي والمراجعة التي تراعي عمر السلسلة؛ لكنه لا يثبت وجود معدل فشل يبلغ Grok 4.6.
القاسم المشترك ليس أن نمط Grok ينجح أو يفشل دائمًا، بل أن جودة البرمجة لا تظهر إلا بعد أن تتفاعل الاستجابة مع مهمة محددة، وسلسلة أدوات معينة، ومراجع معين. وينطبق الأمر نفسه على الحالة المنفصلة تقييم واقعي لترميز ChatGPT: لا يمكن فصل دور مساعد الجودة عن عملية التحقق.
الأسئلة الشائعة
هل يُعد جهاز Grok 4 مناسبًا للمبتدئين في مجال البرمجة؟
نعم، من أجل التوضيحات والأمثلة البسيطة والتصحيح الموجه. ومع ذلك، ينبغي على المبتدئين تشغيل كل مقتطف برمجي، والسؤال عن التغييرات التي يحدثها كل سطر، وتجنب لصق المعلومات السرية أو نشر كود غير مألوف دون مراجعته أولاً.
ما هو طراز Grok الذي ينبغي أن أستخدمه في البرمجة؟
بناءً على ما تم التحقق منه في 11 سبتمبر 2026، توصي xAI باستخدام Grok 4.6 في الكود. يرجى التأكد من معرّف الطراز الدقيق في منتجك، لأن معرّف واجهة برمجة التطبيقات (API slug) الأصلي grok-4-0709 قد تم إيقاف استخدامه.
هل يمكن لـ Grok 4.6 تحرير مستودع بأكمله؟
يمكن لهذا النموذج دعم أعمال المستودع عند استخدامه داخل وكيل يتمتع بحق الوصول المحدود إلى الملفات والأوامر. وكانت اختباراتنا عبارة عن مطالبات منفصلة، لذا فهي لا تثبت الجاهزية المستقلة للتعامل مع ملفات متعددة أو الجاهزية للإنتاج.
هل «Grok Build» هو نفسه استخدام «Grok» في الدردشة؟
يُعد «No. Grok Build» وكيل برمجة تفاعلي أو غير تفاعلي مستقل. ولا تتلقى عمليات إكمال الدردشة العادية أو واجهة برمجة التطبيقات (API) تلقائيًّا سياق مستودعها أو محطة العمل أو الأذونات أو حلقة الأدوات الخاصة بها.
هل يمكنني استخدام Grok 4.6 للبرمجة على جهاز GlobalGPT؟
نعم. توفر منصة GlobalGPT مسارًا مُثبتًا Grok 4.6 مخصصًا لمطالبات الترميز المحدودة ومقارنات النماذج. وهي منصة مستقلة ولا تحل محل Grok Build، ولا بيئة تطوير المتكاملة (IDE)، ولا أدوات واجهة برمجة التطبيقات (API) الأصلية الخاصة بـ xAI.
هل يجب أن أثق في الكود الذي تم إنشاؤه بواسطة Grok دون اختباره؟
لا. قم بتنفيذ الكود، وأضف حالات الحدود، وافحص الفروق، وقم بتشغيل فحوصات lint وtype والأمن وCI المعتادة. بدت عملية إعادة الهيكلة التي قمنا بها سليمة، لكنها أغفلت حقلًا إلزاميًا في كل نتيجة غير فارغة.
الحكم النهائي
هل طراز Grok 4 مناسب للبرمجة؟ يُعد النموذج الحالي Grok 4.6 مساعدًا فعالًا في البرمجة فيما يتعلق بالإصلاحات المحدودة، والوظائف الصغيرة، والتفسيرات، واختبارات المراجعة الأولية. وفي مجموعة المهام الأربع التي قمنا بها، أنتج النموذج حلين صحيحين تمامًا، وعملية إعادة هيكلة أدت إلى خلل في السلوك، ومجموعة اختبارات غير مكتملة. كما تجاهل تعليمات حظر استخدام لغة Markdown بشكل صارم في ثلاث ردود.
استخدمها في الحالات التي يكون فيها اكتشاف الأخطاء أمراً سهلاً: نطاق ضيق، وعقود واضحة، و«فيكستشرز» قابلة للتنفيذ، ومراجعة بشرية. لا تعامل هذه الأدلة على أنها إذن بإجراء تغييرات غير خاضعة للإشراف على المستودع، أو موافقة أمنية، أو نشر في بيئة الإنتاج.
لإجراء تجربة عملية،, فتح Grok 4.6 على GlobalGPT, ، قم بتشغيل إحدى الأوامر الكاملة المذكورة أعلاه، وقارن النتيجة مع اختباراتك الخاصة قبل أن تقرر ما إذا كان ينبغي إدراجها في سير عملك.