
Claude Sonnet 5.5 مقابل Opus 5.5: السعر، ونتائج الاختبارات القياسية، والاختبارات العملية
يتشارك كل من Sonnet 5.5 و Opus 5.5 في الجيل Claude 5.5، لكنهما يختلفان من حيث السعر والموقع في السوق. تُخضع هذه المقارنة كلا البرنامجين لنفس المهام الخمس وتقدم تقريراً عما أرجعه كل منهما فعليًّا.
تتمحور الفجوة التي تم قياسها في الغالب حول التكلفة والسرعة. في هذه الحزمة المكونة من خمس مطالبات، أنجز النموذج Sonnet 5.5 المهمة بشكل أسرع، واستخدم عددًا أقل من الرموز الناتجة، وأنتج تقديرًا أقل لتكلفة الطلب الحسابية. أما النموذج Opus 5.5، فقد استخدم عددًا أكبر من الرموز واستغرق وقتًا أطول، في حين كانت إجاباته في كثير من الأحيان أكثر تفصيلًا. توضح بطاقات المهام الأماكن التي أدى فيها النص الإضافي إلى تغيير النتيجة المفيدة، والأماكن التي نجح فيها كلا النموذجين ببساطة.
تم الحفاظ على توافق المطالبات، والحد الأقصى للطلبات، وإعدادات الجهد، ونقطة النهاية، وتصميم «تشغيل واحد لكل نموذج» مع النسخة السابقة مراجعة Claude Opus 5.5.
إجابة سريعة
- السرعة في هذا السباق المتكافئ: أنهى Sonnet 5.5 خمسة طلبات متتالية محليًّا في 31.930 ثانية؛ بينما استغرق Opus 5.5 47.725 ثانية.
- رموز الإخراج المُبلغ عنها عبر المسار: استخدمت نسخة Sonnet 5.5 2,686؛ بينما استخدمت نسخة Opus 5.5 3,952. وبلغ عدد «مجالات التفكير» 987 و2,214 على التوالي.
- تقدير السعر المعلن الحسابي: بلغت تكلفة الطلبات الخمسة الخاصة بـ «Sonnet» حوالي $0.02826؛ وبلغت تكلفة الطلبات الخمسة الخاصة بـ «Opus» حوالي $0.08184، وذلك باستخدام الأسعار القياسية الرسمية للرموز الرقمية، مع استبعاد تكاليف ذاكرة التخزين المؤقت والرصيد والضرائب وهامش الربح.
- نتيجة المهمة: اجتاز كلا النموذجين اختبارات الاستخراج وملفات JSON والمسائل الحسابية. وحافظ نموذج «سونيت» على التنسيق الصيني المطلوب المكون من فقرتين بشكل أكثر دقة؛ وكانت مخرجات البرمجة قابلة للاستخدام في كلا الحالتين، لكنها اختلفت من حيث العمق وشرح الحالات الاستثنائية.
- ترحيل واجهة برمجة التطبيقات (API): لا يمكن تعطيل التفكير؛ ويُرفض فرض اختيار الأدوات، كما أن الميزانيات الرمزية تشمل التفكير. تحقق من التحذيرات المتعلقة بالهجرة قبل التبديل.
- حدود القرار: وهذا يمثل عملية تشغيل واحدة لكل مهمة عبر مسار تابع لجهة خارجية. ويقيس هذا الإجراء الاستجابات الفورية الملحوظة، والوقت الفعلي المحلي، والاستخدام المبلغ عنه من قبل المسار — وليس درجة شاملة للقدرة.
السعر الرسمي ومواصفات الطراز
تُدرج بطاقات النماذج الحالية لـ Anthropic كلا النموذجين اللذين يتميزان بنافذة سياق تبلغ 1 مليون رمز وخرج أقصى يبلغ 128 ألف. ويُشار إلى Sonnet 5.5 بـ سريع مع جهد افتراضي مرتفع؛ يُصنف Opus 5.5 على أنه معتدل بجهد افتراضي متوسط. وبحسب أسعار التوكن القياسية، فإن سعر Sonnet 5.5 يبلغ نصف سعر الشراء والبيع لـ Opus 5.5.
| نموذج | معرّف واجهة برمجة التطبيقات (API) | تصنيف زمن الاستجابة الرسمي | الإدخال / الإخراج | السياق / الحد الأقصى للإنتاج | الجهد الافتراضي | قراءة ذاكرة التخزين المؤقت |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | كلود-سونيت-5-5 | نشط · سريع | $2 / $10 لكل MTok | 1 ميغابايت / 128 كيلوبايت | عالية | $0.20 / MTok |
| Claude Opus 5.5 | كلود - أوبوس 5-5 | نشط · معتدل | $4 / $20 لكل MTok | 1 ميغابايت / 128 كيلوبايت | متوسط | $0.20 / MTok |
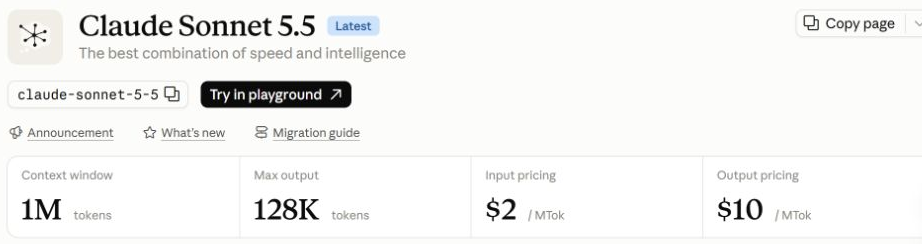
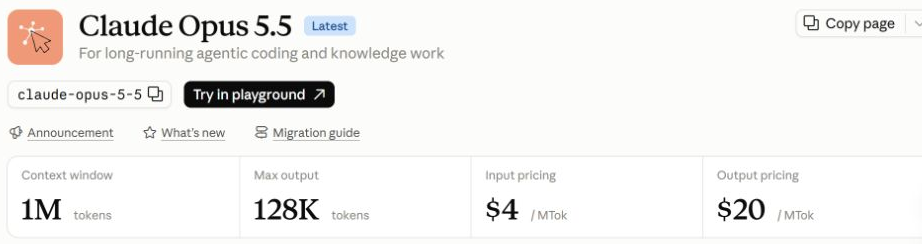
بالنسبة لمثال بسيط بدون تخزين مؤقت يتضمن 100,000 رمز إدخال بالإضافة إلى 20,000 رمز إخراج، تبلغ معدلات الرموز المذكورة حوالي $0.40 على Sonnet 5.5 و$0.80 على Opus 5.5. انظر دليل الأسعار والحدود لـ Claude للسياق الخاص بالخطة.
سياق المعيار المرجعي الرسمي
Anthropic إعلان Sonnet 5.5 يضع كلا النموذجين في جدول واحد أعدته الجهة المُقدِّمة للخدمة. ويتنوع نمط الصفوف حسب المعيار المرجعي وإعدادات الجهد.
| مؤشر مرجعي مُدرج في Anthropic | Sonnet 5.5 | الأوبوس 5.5 | القياس |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%¹ | الترميز الطرفي الفاعلي |
| FrontierCode الإصدار 1.1 (الرئيسي) | 46.2% Max² / 52.1% Xhigh | 54.4% | ما إذا كان سيتم دمج التغييرات في الكود |
| CursorBench 4.0 | 55.5% | 57.8% | مهام الترميز الغامضة التي تتضمن ملفات متعددة |
| GDPval-AA الإصدار 2.1 | 1844 | 1846 | العمل المعرفي عبر مختلف المهن |
| الامتحان الأخير للبشرية | 64.5% مع الأدوات | 67.7% مع الأدوات | التفكير متعدد التخصصات |
| OSWorld 2.1 | 80.1% جزئي | 81.8% جزئي | المهام التي تتطلب استخدام الكمبيوتر |
| علم الخرائط | 61.6% بدون أدوات | 64.4% بدون أدوات | التعرف البصري على المخططات |
¹ يستخدم Opus 5.5 Terminal-Bench مستوى الجهد «xhigh»؛ ² يبلغ أداء Sonnet 5.5 FrontierCode 46.2% عند المستوى «Max» و52.1% عند مستوى الجهد «Xhigh». قيم OSWorld مُصنَّفة على أنها جزئية. هذه القيم تعكس سياق المزود، وليست نتيجة إعادة تشغيل مستقلة بجهد متساوٍ.
طريقة واجهة برمجة التطبيقات (API) ذات المطالبة نفسها
تلقى كل نموذج نفس المطالبات الخمس من خلال المنشور https://anywhere.broly.ai/v1/messages. أرسل العميل رسالة واحدة إلى أحد المستخدمين،, max_tokens: 8192, output_config.effort: مرتفع, ، وبدون استخدام أي أدوات. وقد أرجعت كل طلبات الاستعلام رمز الحالة HTTP 200 و نهاية الدور.
ويتبع نهج الاختبار الإطار الأوسع نطاقاً سير عمل اختبار النموذج GlobalGPT. تقرير منفصل دليل واجهة برمجة التطبيقات (API) لـ Claude يتناول إعداد الطلبات ومحاسبة الرموز.
الوقت، والرموز، والتكلفة التقديرية
| المسار | الساعة المحلية: خمسة رنات | رموز الإدخال | رموز الإخراج | طريقة التفكير المذكورة | التكلفة التقديرية للطلب* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 31.930 ثانية | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5 | 47.725 ثانية | 700 | 3,952 | 2,214 | $0.08184 |
* تقدير مستند إلى الرموز المُبلغ عنها في المسار والمعدلات القياسية الرسمية. كان Sonnet 5.5 أقل بمقدار 33.1% من حيث الوقت المنقضي محليًّا، وأقل بمقدار 32.0% من حيث عدد الرموز الناتجة في هذه المجموعة.
خمس بطاقات مهام متطابقة
تحتوي كل بطاقة على المهمة، والملاحظة، والوقت المحلي، ورموز المسار المُبلغ عنها، والحالة، والحدود، كلها في مكان واحد.
هل يمكن للنماذج إصلاح وظيفة إزالة التكرار ذات الأنواع المختلطة؟
إعداد المهمة: تم نسخ النص الدقيق من الرسالة السابقة مراجعة Claude Opus 5.5 عبوة تجريبية.
| نموذج | الوقت / استخدام المسار | تسمية النتيجة المختصرة |
|---|---|---|
| Claude Sonnet 5.5 | 8.679 ثانية 145 مدخل / 830 مخرج 0 تفكير HTTP 200 · end_turn | الدالة المصححة بالإضافة إلى اختبارين؛ شرح موجز. |
| Claude Opus 5.5 | 15.844 ثانية 145 مدخلات / 1478 مخرجات 700 فكرة HTTP 200 · end_turn | تم تصحيح الدالة بالإضافة إلى اختبارين؛ ومزيد من مناقشة الحالات الاستثنائية. |
المقارنة الملاحظة: وقد أرجع كلاهما دالة مصححة واختبارين. استخدمت الدالة Sonnet 5.5 مفاتيح مُعلَّمة بالنوع،, casefold(), ، وقائمة بديلة في استجابة أقصر؛ بينما استخدم Opus 5.5 عددًا أكبر من الرموز في الإخراج لشرح حالات استثنائية إضافية. ولم يثبت أي من الاختبارين وجود فائز عام في مجال البرمجة.
الحدود: تقوم تعديل بسيط واحد في لغة بايثون بالتحقق من حالات حافة محددة، وليس بالتحقق من الموثوقية عبر المستودعات أو البرمجة التي تعتمد على الأدوات.
هل يمكن للنماذج الاحتفاظ بالحقائق الخمس المقدمة دون إضافة أي ادعاءات؟
إعداد المهمة: تم نسخ النص الدقيق من الرسالة السابقة مراجعة Claude Opus 5.5 عبوة تجريبية.
| نموذج | الوقت / استخدام المسار | تسمية النتيجة المختصرة |
|---|---|---|
| Claude Sonnet 5.5 | 3.569 ثانية 210 مدخلات / 209 مخرجات 0 تفكير HTTP 200 · end_turn | خمس نقاط مرقمة؛ مع الحفاظ على الحقائق الواردة. |
| Claude Opus 5.5 | 4.374 ثانية 210 مدخلات / 312 مخرجات 101 طريقة في التفكير HTTP 200 · end_turn | خمس نقاط مرقمة؛ مع الحفاظ على الحقائق الواردة. |
المقارنة الملاحظة: وقد أرجع كلاهما خمس نقاط مرقمة بالضبط، وظل كل منهما في نطاق الحقائق المقدمة. استخدم Sonnet 5.5 209 رموزًا ناتجة مقابل 312 رمزًا في Opus 5.5، لكن المطالبة كانت عبارة عن ملاحظة قصيرة وليس مدخلاً ذي سياق واسع.
الحدود: هذه عملية استخراج وتدقيق التنسيق قائمة على أساس متين؛ وهي لا تُعد دليلاً على الأداء في سياق يتضمن مليون رمز.
هل يمكن للنماذج أن تُرجع البنية المطلوبة بالضبط؟
إعداد المهمة: تم نسخ النص الدقيق من الرسالة السابقة مراجعة Claude Opus 5.5 عبوة تجريبية.
| نموذج | الوقت / استخدام المسار | تسمية النتيجة المختصرة |
|---|---|---|
| Claude Sonnet 5.5 | 5.052 ثانية 128 مدخل / 260 مخرج 0 تفكير HTTP 200 · end_turn | بيانات JSON قابلة للتحليل؛ المفاتيح المطلوبة وعدد العناصر. |
| Claude Opus 5.5 | 8.276 ثانية 128 مدخل / 622 مخرج 390 فكرة HTTP 200 · end_turn | بيانات JSON قابلة للتحليل؛ المفاتيح المطلوبة وعدد العناصر. |
المقارنة الملاحظة: أرجع كلاهما بيانات JSON قابلة للتحليل تحتوي على المفاتيح المطلوبة، بالإضافة إلى ميزتين وعيبين. كان Sonnet 5.5 أكثر إيجازًا حيث بلغ عدد الرموز الناتجة 260 رمزًا؛ وتصف السلاسل إعدادًا خياليًّا لمراجعة، ولا تمثل حقائق عن المنتج.
الحدود: إن إجراء اختبار هذا المخطط مرة واحدة لا يكفي لقياس موثوقية المخرجات المنظمة في سياق استدعاءات الأدوات أو المحادثات الطويلة.
هل يمكن للنماذج أن تطبق تسلسل المجموعات المستديرة حتى الوصول إلى الإجابة النهائية؟
إعداد المهمة: تم نسخ النص الدقيق من الرسالة السابقة مراجعة Claude Opus 5.5 عبوة تجريبية.
| نموذج | الوقت / استخدام المسار | تسمية النتيجة المختصرة |
|---|---|---|
| Claude Sonnet 5.5 | 2.947 ثانية 89 مدخلًا / 163 مخرجًا 0 تفكير HTTP 200 · end_turn | النتيجة الصحيحة: 67؛ يُكتب الجواب النهائي في سطر منفصل. |
| Claude Opus 5.5 | 3.830 ثانية 89 مدخلات / 257 مخرجات 74 فكرة HTTP 200 · end_turn | النتيجة الصحيحة: 67؛ يُكتب الجواب النهائي في سطر منفصل. |
المقارنة الملاحظة: قام كلاهما بحساب الناتج 67 ووضع الإجابة النهائية في سطر منفصل. استخدمت Sonnet 5.5 163 رمزًا في الناتج مقابل 257 رمزًا في Opus 5.5، دون أن يُلاحظ أي اختلاف في الدقة في هذه المطالبة.
الحدود: لا يمكن لتسلسل حسابي واحد أن يقيّم موثوقية الاستدلال العام.
هل يمكن أن يحافظ المسار على هيكل الفقرتين المطلوب؟
إعداد المهمة: تم نسخ النص الدقيق من الرسالة السابقة مراجعة Claude Opus 5.5 عبوة تجريبية.
| نموذج | الوقت / استخدام المسار | تسمية النتيجة المختصرة |
|---|---|---|
| Claude Sonnet 5.5 | 11.683 ثانية 128 مدخل / 1224 مخرج 987 فكرة HTTP 200 · end_turn | فقرتان باللغة الصينية؛ بدون أي إطارات إضافية. |
| Claude Opus 5.5 | 15.401 ثانية 128 مدخل / 1283 مخرج 949 فكرة HTTP 200 · end_turn | تمت تغطية النقاط؛ وأُضيف نظام «ماركداون» وملاحظة باللغة الإنجليزية. |
المقارنة الملاحظة: أعاد Sonnet 5.5 الفقرتين الصينيتين المطلوبتين دون أي إطارات إضافية. كما غطى Opus 5.5 النقاط المطلوبة، لكنه أضاف إطارات Markdown وملاحظة باللغة الإنجليزية. يسجل هذا تنسيق النص في مسار واحد، وليس الجودة الإجمالية للصينية.
الحدود: تطلب المهمة كتابة مقدمة عن Opus 5.5، لذا فإن النص نفسه لا يُعد معيارًا للغة المحايدة.
ملاحظات بشأن واجهة برمجة التطبيقات (API) وعملية الترحيل
يُشغَّل Sonnet 5.5 وضع «التفكير التكيفي» بشكل افتراضي؛ وتؤدي عبارة «thinking: disabled» إلى إرجاع خطأ 400، بينما يشمل «max_tokens» كلاً من التفكير ونص الرد. ويتم رفض الإعداد القسري لـ «tool_choice» بقيمة «any/tool». قم بتحليل كتل المحتوى حسب النوع وأعد تحديد ميزانيات الرموز كخط أساس قبل التبديل.
ما تؤيده الأدلة
الحكم على مستوى المهمة
Sonnet 5.5: انخفاض التكلفة والوقت المقيسين على هذا المسار، مع الامتثال التام لمعايير التنسيق في المهمة الصينية.
الأوبوس 5.5: أسعارها أعلى وأكثر انتشارًا هنا؛ ولا تزال المعايير المرجعية الرسمية تتفوق في العديد من المهام المفتوحة.
استخدم الأدلة المتعلقة بمستوى المهام لاختيار نقطة انطلاق، ثم قم بالتحقق من حجم العمل الذي يهمك.
للاطلاع على السياق المجاور، انظر مقارنة بين عائلة Claude, مراجعة لعبة Opus 5, و مراجعة Fable 5.1.
الأسئلة الشائعة
أي طراز كان الأسرع في الاختبار المقارن؟
سجل Sonnet 5.5 أقل وقت إجمالي محلي: 31.930 ثانية مقابل 47.725 ثانية لـ Opus 5.5 عبر خمسة طلبات متتالية. ويشمل ذلك المسار ومسار الشبكة المستخدمين هنا، لذا فإن هذا ليس زمن انتقال من جانب المزود.
أي نموذج استخدم عددًا أقل من الرموز الناتجة؟
استخدمت Sonnet 5.5 2,686 رمزًا من النتائج المبلغ عنها عبر المسار في المهام الخمس، مقارنة بـ 3,952 رمزًا في Opus 5.5. ولا يُعد عدد الرموز بحد ذاته دليلاً على جودة الإجابة.
أي طراز كان أرخص في هذه الجولة؟
باستخدام معدلات واجهة برمجة التطبيقات (API) القياسية الرسمية وأعداد عمليات الإدخال/الإخراج التي تم إرجاعها، تبلغ التقديرات الخاصة بالطلبات الخمسة لـ Sonnet 5.5 ما مجموعه $0.02826، مقابل $0.08184 لـ Opus 5.5. يستبعد هذا الحساب رسوم ذاكرة التخزين المؤقت، وأرصدة المنصة، والضرائب، وهامش الربح.
هل يتفوق Sonnet 5.5 على Opus 5.5 في جميع اختبارات الأداء؟
يختلف أداء الجدول الخاص بـ Anthropic باختلاف اختبار الأداء وإعدادات الجهد: يحقق طراز Sonnet 5.5 نتائج أعلى في اختبار Terminal-Bench 4.0، بينما يحقق طراز Opus 5.5 نتائج أعلى في اختبارات FrontierCode وCursorBench وGDPval-AA وHumanity’s Last Exam وOSWorld وChartography. هذه النتائج مقدمة من المزود، وليست نتائج اختبارات مستقلة أعيد إجراؤها.
هل يُعد Sonnet 5.5 بديلاً مباشراً لواجهة برمجة التطبيقات (API)؟
لا. يشير دليل الترحيل إلى أن عملية «thinking» تعمل بشكل افتراضي، وأن تعيين «thinking: disabled» يؤدي إلى ظهور خطأ 400، كما أن الاختيار القسري لأي أداة (any/tool) يُرفض، ويجب على العملاء تحليل كتل المحتوى حسب النوع. قم بإعادة تحديد ميزانيات الرموز وحلقات الأدوات قبل التبديل.
هل كان هذا اختبار أداء في سياق طويل؟
لا. تحتوي مطالبة الاستخراج على مقطع قصير. وهي تتحقق من صحة المعلومات ومن دقة التنسيق؛ ولا تقيس السلوك بالقرب من نافذة السياق الموثقة التي تضم مليون رمز.



