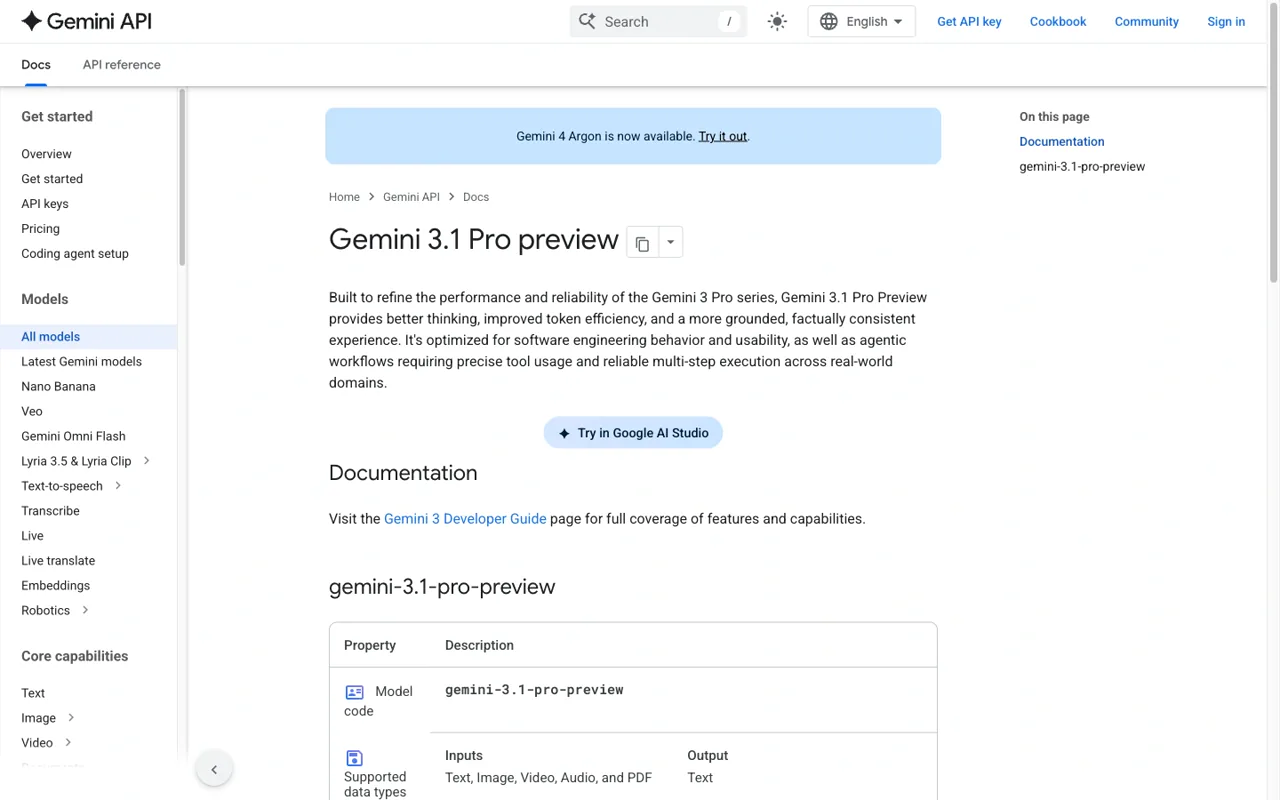
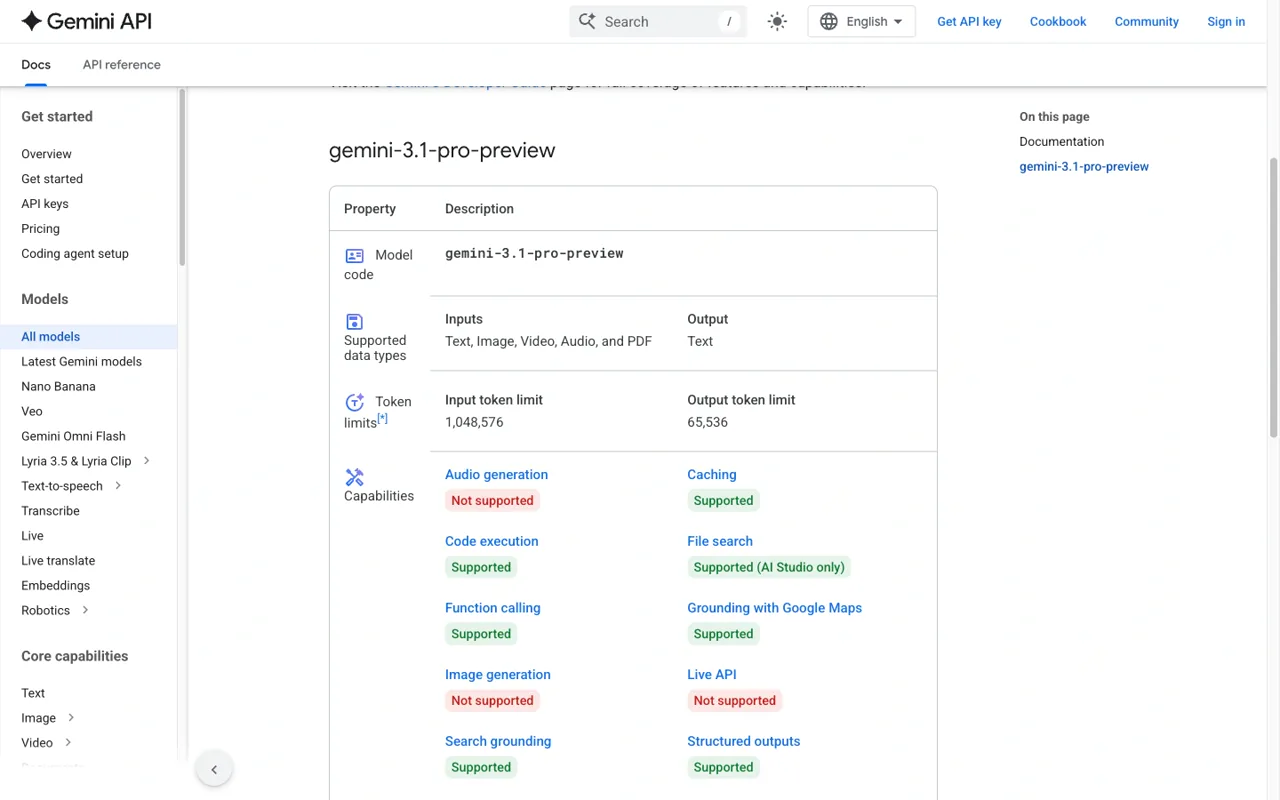
Die derzeit eindeutigste Angabe ist die Begrenzung des Modellkontexts: Gemini 3.1 Pro Preview akzeptiert bis zu 1.048.576 Eingabetoken und gibt bis zu 65.536 Ausgabetoken zurück. Das ist nicht dasselbe wie ein API-Konto ohne Nutzungsbeschränkungen. Ihr Projekt kann dennoch an eine Ratenbegrenzung, eine Quote, eine Einschränkung der Abrechnungsstufe oder eine Nutzungsgrenze von Google Gemini Apps stoßen.
Dieser Leitfaden unterscheidet zwischen diesen Ebenen und ersetzt die alte “Bypass”-Herangehensweise durch praktische Lösungen: die Grenze ermitteln, die Anfrage verkürzen oder in Stapeln senden, bei Transportproblemen mit Backoff erneut versuchen und die richtige Route für die jeweilige Aufgabe wählen.
Wenn Sie einen langen Programmier- oder Forschungsablauf fortsetzen müssen, während eine Verbindung gedrosselt ist, GlobalGPT vereint Gemini 3.1 Pro zusammen mit anderen Modellen und KI-Funktionen in einem Arbeitsbereich. Die API, CLI, MCP und Yukie-Agent-Routen sind nützlich, wenn die Aufgabe eine wiederholbare Übergabe erfordert; sie belasten Googles eigene Kontingente nicht.
Welche Einschränkungen gelten für den Gemini 3.1 Pro?
| Grenzschicht | Aktuelle Erkenntnisse | Was es steuert |
|---|---|---|
| Modell-Eingabekontext | 1.048.576 Token | Wie viel Text, Medien und Gesprächskontext eine Anfrage enthalten kann. |
| Modellausgabe | 65.536 Token | Wie viel Text, gegebenenfalls einschließlich Denkmarken, eine Antwort zurückgeben kann. |
| API-Preisgrenze | 200.000 Eingabetoken | Welche Ein- und Ausgaberaten gelten für die kostenpflichtige Standardstufe?. |
| Projektquote | Hängt von der Abrechnung und den Kontingenten von Google Cloud / AI Studio ab | Wie viele Anfragen oder Token das Projekt innerhalb eines bestimmten Zeitraums senden kann. |
| Gemini – Nutzung von Apps | Auf Berechnungen basierend; wird alle 5 Stunden aktualisiert, bis ein wöchentliches Limit erreicht ist | Zugriff auf Verbraucher-Apps, Funktionen und tarifspezifische Nutzung. |
Es gibt keinen einzelnen “Gemini 3.1 Pro Limit”-Schalter. Eine Anfrage kann innerhalb des Kontextfensters liegen und dennoch einen 429-Fehler erhalten, weil das Projekt zu viele Anfragen sendet, das Kontingent des Kontos ausgeschöpft ist oder der Dienst vorübergehend ausgelastet ist.
Token- und Kontextbeschränkungen
Auf der Modellseite von Google wird der Endpunkt wie folgt bezeichnet: gemini-3.1-pro-vorschau. Es akzeptiert Text, Bilder, Videos, Audiodateien und PDF-Dateien als Eingabe und gibt Text zurück. Auf der Seite werden folgende Funktionen aufgeführt: Denkfunktionen, Zwischenspeicherung, Codeausführung, Funktionsaufrufe, Verknüpfung mit Google-Suche und Google Maps, URL-Kontext, strukturierte Ausgabe, Batch-API, Flex sowie Prioritätsoptionen.


API-Ratenbegrenzungen und Kontingentstufen
API-Limits werden auf Projekt- und Abrechnungsebene festgelegt und richten sich nicht nur nach dem Modellnamen. Auf der Quoten-Seite des Projekts finden Sie Angaben zu Anfragen pro Minute, Tokens pro Minute, Tageslimits und der aktiven Abrechnungsstufe. Google kann die verfügbaren Werte je nach Region, Konto und Servicestufe ändern, sodass eine alte Angabe aus einem Blogbeitrag keine verlässliche Angabe der aktuellen Quote darstellt.
- Drehzahl: Anfragen pro Minute. Viele kleine Aufrufe können diese Grenze erreichen, noch bevor die Token-Kapazität erschöpft ist.
- TPM: Token pro Minute. Schon wenige Anfragen mit großem Kontext können dieses Kontingent schnell aufbrauchen.
- Tägliche oder monatliche Quote: eine Zeitspanne mit längerer Gültigkeitsdauer, die nach einem kurzen erneuten Versuch weiterhin aufgebraucht bleiben kann.
- Rechnungsstatus: Für ein Projekt muss möglicherweise die Abrechnung aktiviert werden, um höhere Limits oder Zugriff auf die Produktionsumgebung zu erhalten.
- Verwendung des Werkzeugs: Die Suche nach Grunddaten, Karten-Grunddaten, Funktionsaufrufe und andere Tools können zusätzlichen Aufwand und Kosten verursachen.
Die Preisgrenze von 200.000 ist eine Abrechnungsgrenze, keine feste Kontextgrenze. Eine Anfrage mit 250.000 Token kann innerhalb des 1-Millionen-Kontextfensters liegen und dennoch zu den höheren Standardtarifen abgerechnet werden.
So beheben Sie den Fehler „Gemini 3.1 Pro 429“

- Lesen Sie die Details zur Antwort. Notieren Sie die Modell-ID, das Projekt, den Statuscode, den Wert für „Retry-After“ und den Namen der Quote, sofern die API einen solchen zurückgibt.
- Beende die Salve. Senden Sie dieselbe Anfrage nicht in einer engen Schleife; dies kann das Drosselungsfenster verlängern.
- Erneut versuchen, mit exponentiellem Backoff. Verwenden Sie eine begrenzte Anzahl von Wiederholungsversuchen und beachten Sie gegebenenfalls die Angabe „Retry-After“.
- Verkürzen Sie die Anfrage. Den Zeitrahmen verkürzen, doppelte Dateien entfernen, das Budget für die Produktion senken oder die Arbeit in Etappen aufteilen.
- Projektkontingente und Abrechnung prüfen. Ein erneuter Versuch kann eine bereits ausgeschöpfte Quote nicht wiederherstellen.
- Führen Sie die Aufgabe bedächtig aus. Bei einem terminkritischen interaktiven Auftrag sollten Sie den Auftrag in einem anderen Modell oder Arbeitsbereich fortsetzen, anstatt so zu tun, als ob die Anbieter-Beschränkung nicht mehr bestünde.
Diese Schritte beheben Transport- und Auslastungsprobleme. Sie umgehen die Kontrollen des Anbieters nicht und sollten nicht dazu verwendet werden, Sicherheits- oder Kontingentbeschränkungen zu umgehen.
So versenden Sie umfangreiche Arbeiten, ohne das Budget zu strapazieren
Ein langer Kontext funktioniert am besten, wenn die Anfrage einen klaren Auftrag hat. Legen Sie das gemeinsam genutzte Referenzmaterial in einem stabilen Präfix ab, fordern Sie zunächst einen Index oder eine Extraktion an und senden Sie dann nur die relevanten Abschnitte an die nächste Stufe.
- Beginnen Sie mit einer Gliederung oder der Herausarbeitung der wichtigsten Fakten, anstatt sofort eine vollständige Überarbeitung zu verlangen.
- Halten Sie ein einheitliches Projektkonzept ein und geben Sie zwischen den einzelnen Schritten eine kurze Zusammenfassung des aktuellen Standes weiter.
- Verwenden Sie Caching, wenn dasselbe lange Präfix wiederholt gesendet wird und die Abrechnungsdaten des Anbieters Cache-Treffer bestätigen.
- Verwenden Sie „Batch“ oder „Flex“, wenn die Verarbeitung asynchron erfolgt und Ihre Serviceebene dies unterstützt.
- Halten Sie die Ausgangsgrenzen hoch genug für die jeweilige Aufgabe, aber niedrig genug, um unbeabsichtigte übermäßige Reaktionen zu verhindern.

Wenn API, CLI, MCP oder eine Workspace-Route in Frage kommen
Verwenden Sie die API, wenn Ihre Anwendung programmierbare Aufrufe, Protokolle und eine Anbieterabrechnung benötigt. Verwenden Sie die CLI, wenn das Modell neben einem Terminal oder Repository arbeiten muss. Verwenden Sie MCP, wenn für die Aufgabe genehmigte Tools wie Dateisuche, Codezugriff oder interne Dienste erforderlich sind. Verwenden Sie einen Yukie-Agenten, wenn die Arbeit Planung, Tool-Aufrufe und Übergaben umfasst.

GlobalGPT ist hier vor allem als Kontinuitätsschicht nützlich: Vergleichen Sie eine Antwort, arbeiten Sie den Entwurf weiter aus, leiten Sie das Briefing an die Programmierer oder die Kreativabteilung weiter und halten Sie die Kostenentscheidung getrennt von einem Google-API-Kontingent. Die aktuelle Preisberechnung finden Sie unter Die Preisübersicht für den Gemini 3.1 Pro.
FAQ
Wie hoch ist die maximale Eingangsleistung des Gemini 3.1 Pro?
Auf der aktuellen Modellseite von Google sind 1.048.576 Eingabetoken für gemini-3.1-pro-vorschau.
Wie hoch ist die maximale Leistung?
Auf derselben Seite sind 65.536 Output-Token aufgeführt. Output- und Thinking-Token sollten bei der Planung und Abrechnung berücksichtigt werden.
Bedeutet ein Kontextfenster von 1M, dass die Nutzung unbegrenzt ist?
Nein. Es beschreibt die Größe des Kontexts einer einzelnen Anfrage. Projektkontingente, Ratenbegrenzungen, Abrechnungsregeln und Regeln zur App-Nutzung gelten weiterhin.
Wie behebe ich den Fehler „429 Too Many Requests“?
Lesen Sie die Details der Antwort, beachten Sie den „Retry-After“-Wert, warten Sie eine gewisse Zeit ab, reduzieren Sie die Größe oder Häufigkeit der Anfragen und überprüfen Sie die Projektkontingente und die Abrechnung. Eine Wiederholungsschleife führt nicht zu einer Erhöhung des Kontingents.
Kann GlobalGPT die Einschränkungen von Gemini 3.1 Pro aufheben?
Es kann die Einschränkungen von Google nicht ändern. Es kann jedoch ein alternatives Modell und einen alternativen Arbeitsablauf bieten, wenn die Arbeit fortgesetzt werden muss.
Diagnostizieren Sie zunächst die Ebene: Kontextkapazität, Ausgabebudget, Projektkontingent, App-Nutzung und vorübergehende Drosselung erfordern unterschiedliche Lösungen.