Claude Sonnet 4.5 ist ein veraltetes Modell mit einer klaren Identität: Anthropic führte es am 29. September 2025 für die Programmierung, agentenbasierte Arbeitsabläufe, die Computernutzung und lange, mehrstufige Aufgaben ein. Wenn eine bestehende Anwendung davon abhängt, hängt die Entscheidung von drei Faktoren ab: den Stärken bei der Programmierung, den Betriebskosten und dem Aufwand für die Umstellung auf ein anderes Modell.
Für Entwickler, die zwischen Recherche, Texterstellung, Programmierunterstützung und modellspezifischen Aufgaben hin- und herwechseln, GlobalGPT bietet einen vernetzten Arbeitsbereich. Ein einziges Abonnement vereint einen umfangreichen Modellkatalog und zahlreiche KI-Funktionen und bietet so eine kostengünstige Möglichkeit, einen Entwicklungsworkflow abzudecken. Die CLI von GlobalGPT verbindet diesen Workflow mit Ihrem Terminal und Ihren bestehenden Entwicklungstools.
Was ist Claude Sonnet 4.5?
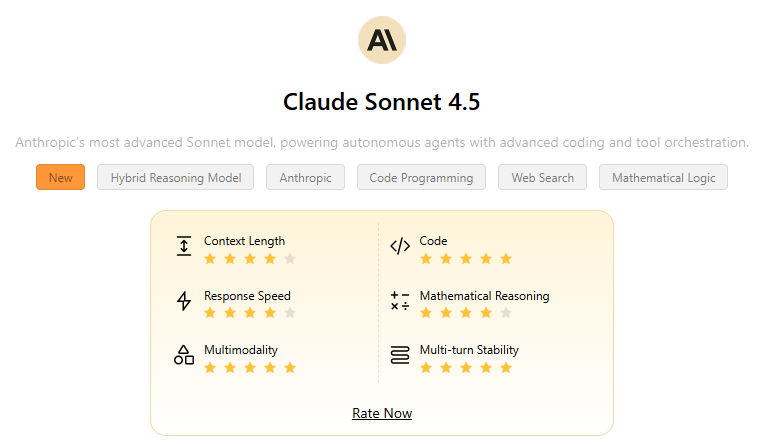
Sonnet 4.5 war bei der Markteinführung die praktische Mittelklasse von Anthropic: leistungsstärker als ein Leichtbaumodell für komplexe Softwareaufgaben, dabei preislich unterhalb der Opus-Reihe angesiedelt. Anthropic’s Ankündigung der Markteinführung im Mittelpunkt standen Programmieren, der Umgang mit dem Computer, die Erstellung von Agenten, logisches Denken und Mathematik.
Diese Aussagen beziehen sich auf die Veröffentlichung im September 2025. Sie bedeuten nicht, dass Sonnet 4.5 im Jahr 2026 die neueste Claude-Option sein wird, und ein Hersteller-Benchmark ist keine Garantie für jede Codebasis. Die Entscheidung, die Sie heute treffen müssen, lautet: Benötigen Sie das bekannte Verhalten dieses Modells oder können Sie auf eine neuere Standardeinstellung umsteigen?.
Aktueller API-Status und Übersicht über auslaufende APIs
claude-sonnet-4-5Die Tabelle zur Modellauslaufphase von Anthropic zeigte eine veraltete Momentaufnahme claude-sonnet-4-5-20250929 als Aktiv bei Überprüfung am 30. September 2026. In derselben Zeile steht Frühestens am 29. September 2026. Diese Formulierung stellt eine Untergrenze dar, nicht einen festgelegten Termin für die Stilllegung. Überprüfen Sie vor einer Migration in die Produktion die Live-Lebenszyklustabelle..
Was die Daten zur Markteinführung zeigen
Die aussagekräftigen Belege sind konkret und datiert. Sie zeigen, warum Sonett 4.5 zu einem Bezugspunkt in der Programmierung wurde, während die Testbedingungen erläutern, wie weit sich jede Zahl ausbreiten kann.
Ergebnisse zur Computernutzung bei der Markteinführung
OSWorld-Erfolgsquote auf einer Skala von 0 bis 100%. Je höher, desto besser.
Quelle: Ankündigung der Markteinführung von Anthropic, 29. September 2025; überprüft am 28. September 2026. Ein Anstieg um 19,2 Prozentpunkte in der gemeldeten Bewertung; dies ist keine allgemeine Garantie für den Erfolg bei Desktop-Aufgaben.
| Beweise | Ergebnis aus der Startphase | Wie man es liest |
|---|---|---|
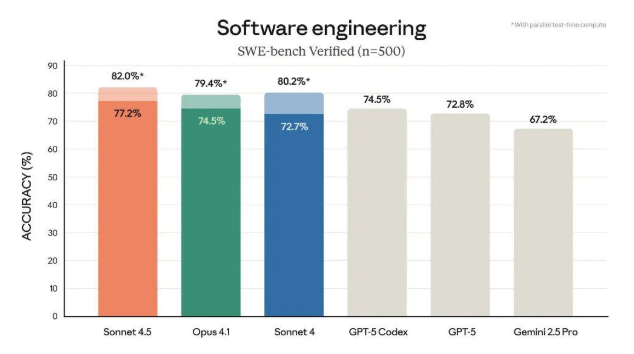
| SWE-Bank Geprüft | 77.2% – Vorläufiges Ergebnis | 500 Aufgaben, gemittelt über 10 Durchläufe, keine zusätzliche Rechenzeit während des Tests, 200.000 Denkbudget |
| SWE-Bench-Variante mit hoher Rechenleistung | 82.0% | Parallele Versuche, Filterung anhand sichtbarer Regression und interne Kandidatenauswahl |
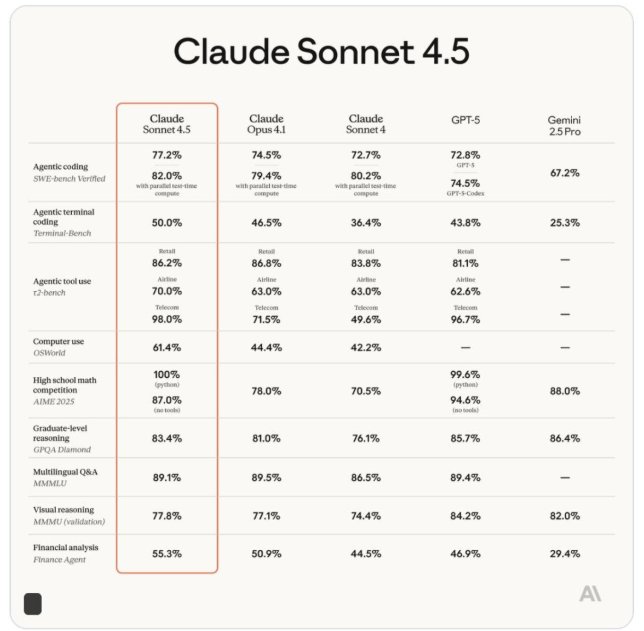
| OSWorld | 61,41 TP40T gegen Sonnet 4 bei 42,21 TP40T | Der von Anthropic veröffentlichte Vergleichstest zur Computernutzung |
Das primäre, von SWE-bench verifizierte Ergebnis von Anthropic (77,2%) umfasste alle 500 Aufgaben, basierte auf einem Durchschnitt von 10 Durchläufen, benötigte keine zusätzliche Rechenzeit während der Testphase und verwendete ein Denkbudget von 200.000. Der Wert von 82,01 TP40T stammt aus einer separaten, rechenintensiven Konfiguration mit parallelen Versuchen, Filterung sichtbarer Regressionen und interner Kandidatenauswahl. Dabei handelt es sich um unterschiedliche Bewertungsbedingungen.
Anthropic erzielte bei OSWorld zudem einen Wert von 61,41 TP40T, verglichen mit 42,21 TP40T für den Sonnet 4 vier Monate zuvor. Da OSWorld Aufgaben im Bereich der Computernutzung testet, sagt das Ergebnis etwas über die Interaktion mit Softwareumgebungen aus; es lässt jedoch keine Rückschlüsse auf den Erfolg bei jedem Desktop-Workflow zu.
Anthropic gab an, beobachtet zu haben, dass Sonnet 4.5 bei komplexen, mehrstufigen Aufgaben über 30 Stunden hinweg den Fokus beibehielt. Dabei handelt es sich um eine Beobachtung des Anbieters und nicht um eine Zusicherung, dass jede Benutzeraufgabe 30 Stunden lang läuft oder dass eine ununterbrochene Autonomie immer wünschenswert ist.
Programmierung und Agent-Upgrades zum Start
Die Version umfasste Änderungen an Modellen und Werkzeugen. Anthropic bot insbesondere Checkpoints zum Speichern und Zurücksetzen des Fortschritts, ein überarbeitetes Terminal, eine native VS Code-Erweiterung, Werkzeuge zur kontextbezogenen Bearbeitung und Speicherverwaltung, Codeausführung und Dateierstellung sowie das Claude Agent SDK.
- Kontrollpunkte hilft dabei, sich während einer langen Programmier-Session von einem Rückschlag zu erholen, ohne den gesamten Durchlauf zu verlieren.
- Die Claude Agent SDK stellt die Grundlage Anthropic vor, die für den Claude-Code verwendet wird, damit Teams aufgabenspezifische Agenten entwickeln können.
- Der parallele Einsatz von Tools und Aufgaben mit längerem Zeithorizont waren Teil der Einführungsphase; aktuelle Befehle und Menüs sollten in der aktuellen Dokumentation nachgeschlagen werden.
- Der Claude-Code, die API und die Web-App sind separate Zugriffswege. Wählen Sie den Weg, der Ihren Berechtigungen, Abrechnungsmodalitäten und Prüfprozessen entspricht.
Für Details zur Implementierung sollten Sie die aktuelle Entwicklerdokumentation zu Anthropic heranziehen, anstatt eine Einführungsanleitung aus dem Jahr 2025 zu kopieren. Die Modell-ID ist ein verlässlicher Ausgangspunkt; Tools und das Verhalten der Clients sollten anhand der aktuellen API- und Claude-Code-Dokumentation überprüft werden.
In der Ankündigung zur Markteinführung wird zudem Cursor-CEO Michael Truell zitiert, der von einer besseren Programmierleistung und einer besseren Bewältigung von Aufgaben mit längerem Zeithorizont spricht. Diese Kundenbewertung trägt dazu bei, die Attraktivität der neuen Version für Entwickler zu erklären, während die oben genannten Benchmark-Methoden eine präzisere Vergleichsgrundlage bieten.
API-Preise und -Zugang
Die Preistabelle für Anthropic Gibt für Sonnet 4.5 $3 pro Million Eingabetoken und $15 pro Million Ausgabetoken an. In der Preistabelle sind zudem niedrigere Batch-Raten sowie Schreib- und Leseraten für den Prompt-Cache für Workloads aufgeführt, bei denen lange Kontexte wiederverwendet werden; die Preisseite wurde am 28. September 2026 überprüft.
| API-Route | Eingabe | Ausgabe | Wenn es passt |
|---|---|---|---|
| Standard-API | $3 / MTok | $15 / MTok | Interaktive Anfragen und normale Produktionsanrufe |
| Batch-API | $1.50 / MTok | $7.50 / MTok | Asynchrone Massenverarbeitung; Anthropic dokumentiert einen Rabatt von 50% auf Token |
| Prompt-Cache | $3,75 / MTok (5-Minuten-Schreibvorgang) oder $6 / MTok (1-Stunden-Schreibvorgang) | - | Wiederholte lange Befehle; Cache-Lesezugriffe betragen $0,30 / MTok |
Gleiche Arbeitslast: Standard vs. Batch
100.000 nicht zwischengespeicherte Eingabetoken + 10.000 Ausgabetoken. USD; Skalierung von Null auf bis zu $0,45.
Berechnung anhand von Preisliste von Anthropic, abgerufen am 28. September 2026. Bei asynchroner Verarbeitung senkt die Stapelverarbeitung diese Token-Gebühr um 50%. Ausgenommen sind Caching, regionale Modifikatoren und sonstige Gebühren; dies ist ein Beispiel, keine gemessene Rechnung.
Eine Anfrage mit 100.000 nicht im Cache gespeicherten Eingabetoken und 10.000 Ausgabetoken würde bei Standardtarifen vor Berücksichtigung von Cache, Datenresidenz oder anderen Modifikatoren etwa $0,45 betragen. Die gleiche Tokenanzahl im Batch-Modus würde etwa $0,225 betragen. Hierbei handelt es sich um rechnerische Beispiele, nicht um ein Abrechnungsangebot.
Bei der Verbraucher-App, dem Claude-Code, GlobalGPT und der API können sich die Zugangs- und Abrechnungsbedingungen unterscheiden. Wenn Sie Sonnet 4.5 in einem Arbeitsbereich mit mehreren Modellen nutzen möchten, Die aktuelle Seite zu GlobalGPT Sonnet 4.5 öffnen. Für direkte API-Aufrufe in der Produktionsumgebung nutzen Sie bitte die Konsolen- und API-Dokumentation von Anthropic.
So nutzen Sie Sonnet 4.5 heute
Es gibt drei sinnvolle Vorgehensweisen, von denen jede eine andere Aufgabe erfüllt:
- GlobalGPT-Arbeitsbereich: Sonnet 4.5 mit anderen Modellen und Funktionen öffnen wenn Sie Chat, Recherche, Schreiben oder Programmierhilfe miteinander verknüpfen möchten, ohne mehrere separate Arbeitsflächen verwalten zu müssen.
- Anthropic-API: verwenden.
claude-sonnet-4-5in der Messages-API, wenn Sie Eigentümer der Anwendung sind, eine direkte Abrechnung benötigen oder einen Snapshot fixieren möchten. - Claude-Code oder eine Editor-Integration: Nutzen Sie den Werkzeugpfad, wenn Repository-Arbeit, Shell-Zugriff und Überprüfungsberechtigungen genauso wichtig sind wie das Modell.
Sicherheitsnachweise
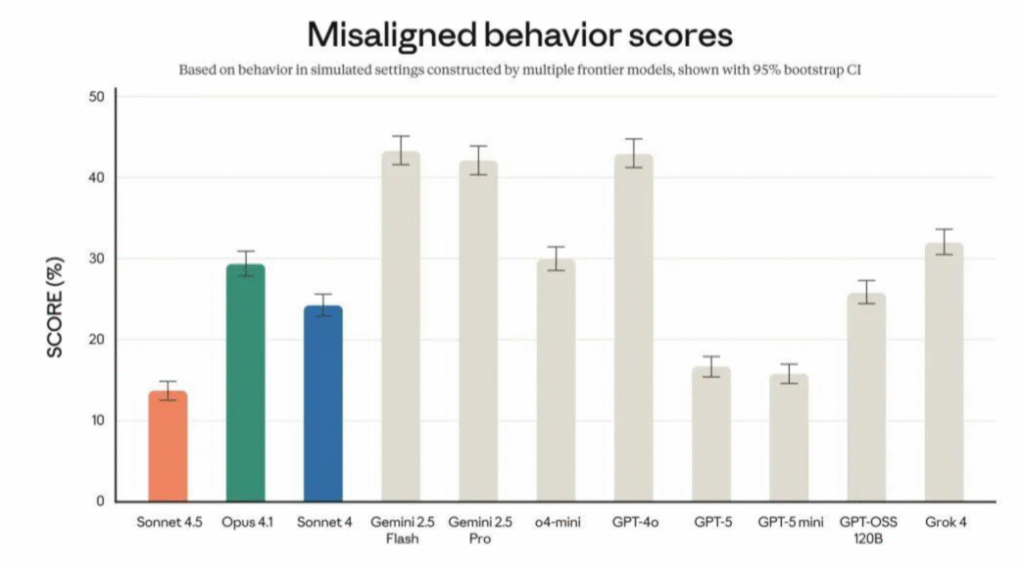
In der Ankündigung zur Markteinführung von Anthropic wurde Sonnet 4.5 als das zu diesem Zeitpunkt am besten abgestimmte Pioniermodell beschrieben; außerdem wurde über eine Verringerung von Verhaltensweisen wie Unterwürfigkeit, Täuschung, Machtstreben und der Förderung von Wahnvorstellungen berichtet. Zudem wurden Fortschritte bei der Prompt-Injektion für agentenbasierte Systeme und Systeme zur Computernutzung beschrieben.
Das beigefügte Diagramm des Verhaltensprüfers ist enger gefasst als eine pauschale Sicherheitsgarantie. Es ist als simuliertes Szenario gekennzeichnet und verwendet 95%-Bootstrap-Konfidenzintervalle; niedrigere Werte sind besser. Das Ergebnis liefert Erkenntnisse über die getestete Konfiguration, ist jedoch kein Beweis dafür, dass jeder Einsatz sicher ist oder dass die Prompt-Injektion nicht mehr auftritt.
Lies den Claude Sonnet 4.5-Systemkarte Informieren Sie sich über die Einzelheiten der Bewertung und die Einschränkungen, bevor Sie das Modell in einem Arbeitsablauf mit hoher Auswirkung einsetzen.
Aktuelle Alternativen und Hinweise zur Kompatibilität
Anthropic’s Aktuelle Modellübersicht listet neben dem 4.5-Snapshot auch neuere Familien auf. Die Auswahl erfolgt aufgabenbasiert:
Behalte Sonett 4.5
Wählen Sie diese Option, wenn Ihre Integration, Ihr Prompt-Set oder Ihr Regressionsverlauf vom Verhalten im Jahr 2025 abhängt und die Lebenszykluszeile Ihre Bereitstellung weiterhin unterstützt.
Wechseln Sie zu einer neueren Sonnet-Version
Entscheiden Sie sich für die aktuelle Sonnet-Produktfamilie, wenn Sie eine unterstützte Standardeinstellung wünschen und einen Kompatibilitätsschritt in Kauf nehmen können, bevor Sie die Modell-ID ändern.
Eine andere Familie verwenden
Wählen Sie ein Modell im Opus-Stil für tiefgreifendere Schlussfolgerungen oder ein Modell im Haiku-Stil für Geschwindigkeit und geringere Rechenlasten; überprüfen Sie die Eignung anhand der Aufgabe, die Sie tatsächlich ausführen.
Einen spezifischen Vergleichspfad für Claude finden Sie unter Der Leitfaden von GlobalGPT zu den Claude Sonnet 4.5-Alternativen. Für API- und Plan-Kontext, die aktuelle Preisliste für Claude erläutert, wie Abonnements, API-Gebühren und Nutzungsbeschränkungen zusammenhängen.
Lohnt es sich noch, Sonnet 4.5 zu verwenden?
Ja, wenn es sich um kompatibilitätskritische Programmierung, einen bekannten Claude-Code-Workflow oder einen Benchmark- und Regressions-Referenzfall handelt. Der Startnachweis ist nach wie vor aussagekräftig, die API-ID ist eindeutig, und auf der Lebenszyklus-Seite wurde der Snapshot bei der letzten erfassten Überprüfung als „Aktiv“ angezeigt.
Ohne Kompatibilitätsbeschränkungen ist es als neuer Universal-Standard weniger attraktiv. Ein neueres, unterstütztes Modell bietet möglicherweise bessere aktuelle Werkzeuge oder Schlussfolgerungsmöglichkeiten, und die am 29. September 2026 auslaufende Untergrenze macht einen Migrationsplan sinnvoll. Vergleichen Sie Ihre eigenen Eingabeaufforderungen und Tool-Aufrufe und wählen Sie dann das Modell aus, das den von Ihnen benötigten Workflow erfüllt.
FAQ
Was ist Claude Sonnet 4.5?
Es handelt sich um das Programmier- und Agentenmodell von Anthropic vom September 2025. Die API-Modell-ID lautet claude-sonnet-4-5, mit dem datierten Snapshot claude-sonnet-4-5-20250929.
Ist Claude Sonnet 4.5 noch aktiv?
In der Lebenszyklustabelle von Anthropic wurde die veraltete Momentaufnahme bei der Überprüfung am 30. September 2026 als “Aktiv” angezeigt. In der Zeile steht außerdem „Frühestens am 29. September 2026“, was jedoch eher eine Untergrenze als ein festes Auslaufdatum darstellt. Überprüfen Sie die aktuelle Tabelle vor einer langfristig geplanten Bereitstellung erneut.
Wie viel kostet die Sonnet 4.5-API?
Die Standardpreise betragen $3 pro Million Eingabetoken und $15 pro Million Ausgabetoken. Die Preise für Batch-Verarbeitung betragen $1,50 bzw. $7,50. Für Schreib- und Lesevorgänge im Cache gelten separate Tarife.
Ist Claude Sonnet 4.5 kostenlos?
Die direkte Nutzung der API wird pro Token abgerechnet. Der Zugriff über Claude oder GlobalGPT unterliegt dem jeweiligen Service-Tarif und den Nutzungsbeschränkungen; überprüfen Sie den ausgewählten Service, bevor Sie eine umfangreiche Arbeitslast starten.
War die Angabe von 30 Stunden eine Garantie für den Nutzer?
Nr. Anthropic gab an, mehr als 30 Stunden bei komplexen, mehrstufigen Aufgaben beobachtet zu haben. Dabei handelt es sich um eine veraltete Beobachtung des Anbieters, nicht um eine Zusicherung für jeden Nutzer oder jede Arbeitslast.
Ist Sonnet 4.5 besser als ChatGPT 5?
Ohne Aufgabe, Aufgabenstellung, Werkzeuge und Bewertungsregeln gibt es keinen eindeutigen Gewinner. Vergleichen Sie die Modelle hinsichtlich Ihres Arbeitsablaufs bei der Programmierung, der Argumentation und dem Einsatz von Werkzeugen, anstatt einen Suchausschnitt als Maßstab heranzuziehen.
Um Sonnet 4.5 zusammen mit Ihren anderen KI-Tools zu nutzen, Die aktuelle Modellseite für GlobalGPT öffnen. Beginnen Sie mit einer konkreten Programmieraufgabe oder einer Debugging-Aufgabe und übertragen Sie dann denselben Projektkontext auf die Recherche und Dokumentation.