إجابة سريعة: تصف الإرشادات الموثوقة من نوع Kling 3.0 ما يجب أن يراه المشاهد ويسمعه: الموضوع، والحركة المرئية، وسلوك الكاميرا، والمكان، والإضاءة، والصوت. تعامل مع هذه الإرشادات كقائمة مرجعية عملية، وليس كصيغة رسمية جامدة. بالنسبة للمقاطع التي تتكون من لقطات متعددة، قم بتسمية كل لقطة وحدد نطاقها الزمني.
ومع ذلك، فإن محاولة اكتشاف هذه الصيغة عن طريق التخمين المباشر داخل أداة إنشاء الفيديو تؤدي إلى استنزاف الرصيد المكلف بسرعة. ففي كل مرة تفشل فيها المطالبة أو يتم حظرها بواسطة مرشح أمان صارم، فإنك تخسر المال وتفقد زخمك الإبداعي.
قد تؤدي التوجيهات الغامضة إلى إنتاج لقطة مذهلة، لكنها توفر لـ Kling القليل من الدلائل حول الحركة، والاستمرارية، والحوار، والصوت. فهم كيفية كيفية عرض أسماء المساهمين في مقاطع الفيديو التي تم إنتاجها باستخدام الذكاء الاصطناعي مما يسهل تخصيص موارد الحوسبة المدفوعة للمطالبات الجاهزة للاختبار.
جلوبال جي بي تي تي يجمع خطوات التخطيط والإنشاء في مساحة عمل واحدة. يمكنك استخدام GPT-5.6 Sol لتحديد قائمة اللقطات، قم بإنشاء صورة مرجعية باستخدام نموذج صور مدعوم، ثم قم بتحريكها باستخدام Kling 3.0. تبلغ تكلفة خطة Pro لـ GlobalGPT $10.8 شهريًا عند الدفع سنويًّا؛ وقد تتغير الأسعار وقواعد الائتمان، لذا يرجى مراجعة صفحة الطلب قبل الاشتراك.

جدول المحتويات
دليل موجه Kling 3.0 لمقاطع فيديو أفضل للذكاء الاصطناعي: ما هي “عقلية المخرج”؟
تعني “عقلية المخرج” كتابة النص التوجيهي كما لو كنت تعطي تعليمات عملية لمصور وممثل في موقع تصوير فيلم حقيقي، بدلاً من الاكتفاء بوصف شكل اللوحة.
- التخلص من عادات استخدام الصور كمحفزات: قد تصف قائمة مثل “امرأة جميلة، 4K، تحفة فنية، تفاصيل دقيقة للغاية” المظهر، لكنها لا توضح ما الذي يتغير بمرور الوقت. أضف إجراءً واضحًا واحدًا وتوجيهًا واحدًا للكاميرا.
- إعطاء الأولوية للإجراءات الملموسة: بدلاً من “كأس مكسور على الأرض”، اكتب “كأس يسقط من الطاولة ويتحطم على الأرض”. فالأفعال الملموسة تزود النموذج بحدث ليصوره. وهذا دليل حركة كاميرا Kling المزودة بتقنية الذكاء الاصطناعي وهذا مفيد عند اختيار سلوك العدسة عند حدوث ذلك الحدث.
- ركز على الموضوع منذ البداية: حدد الشخص أو الشيء الرئيسي قبل إضافة تفاصيل الخلفية. فهذا يزيد من احتمالية أن تحافظ اللقطة على تركيز الانتباه على الموضوع المقصود، على الرغم من أنه لا يضمن التناسق التام.
كيف يمكن صياغة موجه قوي لـ Kling 3.0؟
يمكن أن تتبع المطالبة المفيدة المكونة من لقطة واحدة هيكلاً أساسيًّا مكونًا من خمسة أجزاء: الكاميرا + المشهد + حركة الشخصية + المظهر/الإضاءة + الصوت. هذا إطار عملي للكتابة، وليس قاعدة رسمية خاصة بـ Kling فقط. إذا كنت تريد تسلسلًا أطول، فانتقل إلى اللقطات المُعلمة بدلاً من حشر كل تعليمات في جملة واحدة. سير العمل في كيفية استخدام Kling 3.0 كالمحترفين يوضح كيف تندرج تلك الخيارات ضمن عملية إنتاج كاملة.
- ابدأ بالكاميرا: تحديد الإطار والحركة، مثل “لقطة مقربة ثابتة” أو “تحريك عربة التصوير ببطء إلى الأمام”. استخدم حركة رئيسية واحدة في كل لقطة ما لم يكن الانتقال ضروريًا.
- وصف المكان والأحداث: اذكر المكان والشخصية وما تفعله هذه الشخصية الآن: “في أحد شوارع طوكيو المليئة بالضباب، يرفع محقق من عالم السايبربانك كوبًا ورقيًّا ويراقب حركة المرور.”
- اختتم بالمظهر والصوت: أضف تفاصيل تتعلق بالإضاءة والأجواء والأصوات التي يمكن وصفها: “انعكاسات أضواء النيون، منتصف الليل الممطر، أصوات حركة المرور البعيدة، صوت المطر وهو ينقر على المظلة”.”
- استخدم قدر ما تتطلبه اللقطة من تفاصيل: لا يوجد عدد مثالي مؤكد يتراوح بين 20 و50 كلمة. احذف التناقضات والعبارات الزخرفية غير الضرورية، لكن احتفظ بالتفاصيل التي تتعلق بالتوقيت أو الحوار أو الصوت أو التسلسل الزمني.
قالب لقطة واحدة:
[الكاميرا والتأطير]. [الشخصية] [الحركة المرئية] في [الموقع]. [الإضاءة والأسلوب البصري]. الصوت: [الحوار، والأصوات المحيطة، والمؤثرات الصوتية]. حافظ على اتساق [تفاصيل الاستمرارية المهمة].قالب اللقطات المتعددة:
اللقطة 1 (0-2 ثانية)، [التأطير/الحركة]: [الشخصية والحركة].
اللقطة 2 (2-5 ثوانٍ)، [التأطير/الحركة]: [الحركة التالية والحوار].
الصوت: [خلفية صوتية محيطة]، [مؤثرات صوتية محددة]، [المتحدث وطريقة الإلقاء].
التسلسل: حافظ على اتساق [الوجه/الملابس/الاكسسوارات/التصميم/اتجاه الإضاءة] في كلا اللقطتين.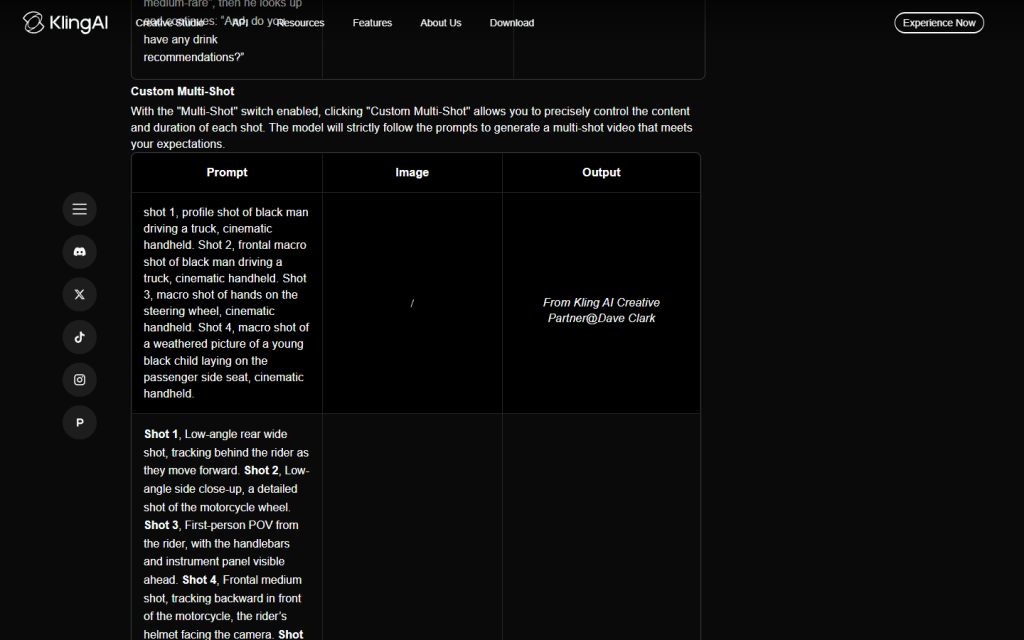
ما هي أفضل موجهات حركة الكاميرا والصوت الأصلي؟
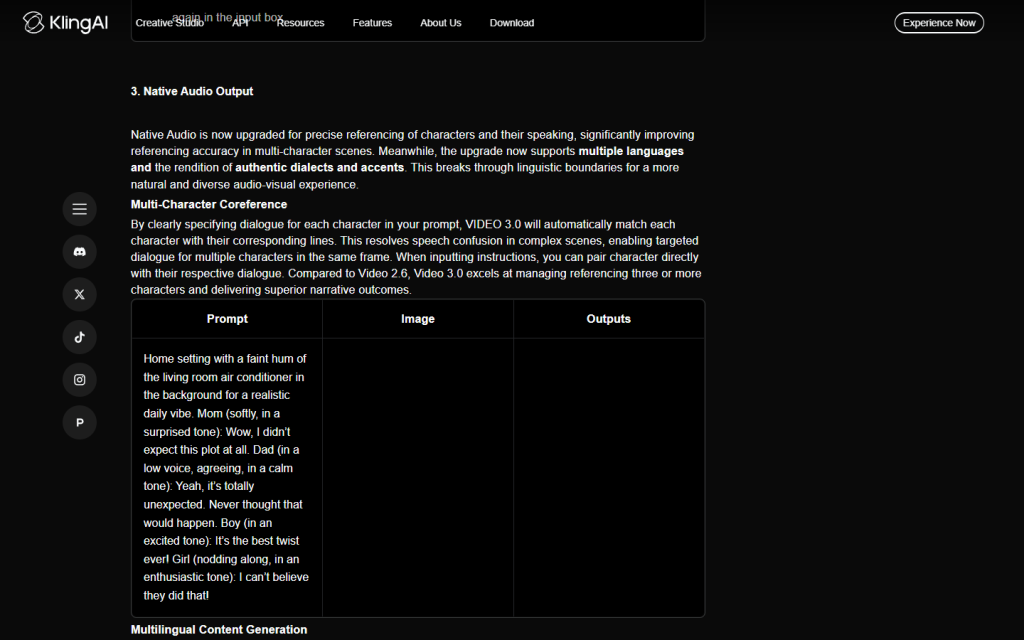
أفضل التوجيهات الخاصة بحركة الكاميرا تستخدم المصطلحات الهوليوودية التقليدية مثل “لقطة متتبعة” أو “تحريك الكاميرا أفقياً”، بينما يتم تفعيل الصوت الأصلي عن طريق وضع الحوار بين علامتي اقتباس ووصف المؤثرات الصوتية.
للحصول على توجيه صوتي أوضح، حدد المتحدث، وأسلوب الإلقاء، والأجواء المحيطة، والمؤثرات الصوتية. وفقًا لـ الدليل الرسمي للفيديو Kling الإصدار 3.0, ، يدعم VIDEO 3.0 الصوت الأصلي وإنشاء لقطات متعددة مخصصة؛ ولا يقتصر الصوت الأصلي على نموذج Omni.
- استخدم مصطلحات الكاميرا الدقيقة: “تتطلب ”لقطة المتابعة“ أن تتبع الكاميرا الهدف. أما ”لقطة التحليق بالطائرة بدون طيار“ فتوفر منظرًا جويًّا من ارتفاع عالٍ. أما ”اللقطة الثابتة على الحامل الثلاثي» فتتطلب أن تظل الكاميرا ثابتة بينما تجري الأحداث داخل الإطار.
- أعطِ كل لقطة مهمة واحدة: إذا كنت بحاجة إلى لقطة عامة ورد فعل حميمي، فقسّمهما إلى «اللقطة 1» و«اللقطة 2». فهذا أوضح من طلب لقطة عامة ولقطة مقربة للغاية في نفس اللحظة.
- اسم المقطع الصوتي البيئي: أضف أصواتًا يمكن ملاحظتها مثل “خطوات ثقيلة على الحصى الرطب”، أو “مطر متواصل على قماش الخيمة”، أو “رعد بعيد”. أما بالنسبة للمشاهد التي تعتمد على الملمس، فإن المبدأ نفسه ينطبق على Kling: سير عمل فيديو ASMR.
- تخصيص حوار لشخصية ما: اكتب اسم الشخصية، والكلمات بالضبط، وطريقة الإلقاء:
يهمس الجندي بصوت خافت منهك: "سنعود إلى ديارنا أخيرًا"." - اختر إحدى لغات الحوار المدعومة: يُدرج دليل VIDEO 3.0 الخاص بـ Kling اللغات الصينية والإنجليزية واليابانية والكورية والإسبانية، مع الإشارة إلى عدة لهجات أو لهجات محلية لكل من اللغتين الصينية والإنجليزية.
قوالب موجهات كلينغ 3.0 الاحترافية (نسخ ولصق)
[توجيهات للحركة والحوار]
لقطة مقربة ثابتة، جندي متعب في خندق موحل يرفع نظره إلى السماء، والمطر ينهمر بغزارة، فيهمس: "سنعود إلى ديارنا أخيرًا"، إضاءة سينمائية داكنة، وأجواء حزينة.
[موضوع فيزياء وحركة]
لقطة متحركة بطيئة، سيارة رياضية تنزلق حول منعطف جبلي حاد، والإطارات تنفث دخانًا وتقذف الحصى باتجاه العدسة، وأشعة شمس الظهيرة الساطعة، بدقة 8K واقعية.[توجيهات الحوار للمشاهد المتعددة الموجهة]
المشهد 1 (0-2 ثانية)، لقطة مقربة ثابتة: جندي متعب في خندق موحل يرفع رأسه ببطء بينما تتساقط قطرات المطر الغزير على خوذته. اللقطة 2 (2-5 ثانية)، تقريب لطيف بالكاميرا المحمولة باليد: يزفر، ويبقي نظره موجهًا نحو السماء، ويهمس بصوت منخفض منهك: "سنعود إلى ديارنا أخيرًا". الصوت: صوت المطر المتواصل على القماش، ورعد بعيد، وحركة ناعمة للنسيج. إضاءة سينمائية خافتة، وأجواء كئيبة. يجب الحفاظ على نفس الوجه، والزي العسكري، وتصميم الخندق، واتجاه المطر في اللقطتين.كيف تساهم الصور المرجعية في تحسين اتساق مقاطع الفيديو التي يُنتجها الذكاء الاصطناعي؟
توفر الصور المرجعية لـ Kling نقطة انطلاق بصرية للوجوه والملابس والأدوات المسرحية والأسلوب. ويمكنها تحسين الاتساق وتقليل تكرار الوصف البصري، لكنها لا تحدد كل التفاصيل بشكل نهائي. ولا يزال المرجع القوي يعطي أفضل النتائج عندما يقترن بتوجيه حركة محدد. لمزيد من تقنيات الاتساق، انظر هذا الشرح لـ Kling اتساق شخصيات الذكاء الاصطناعي.
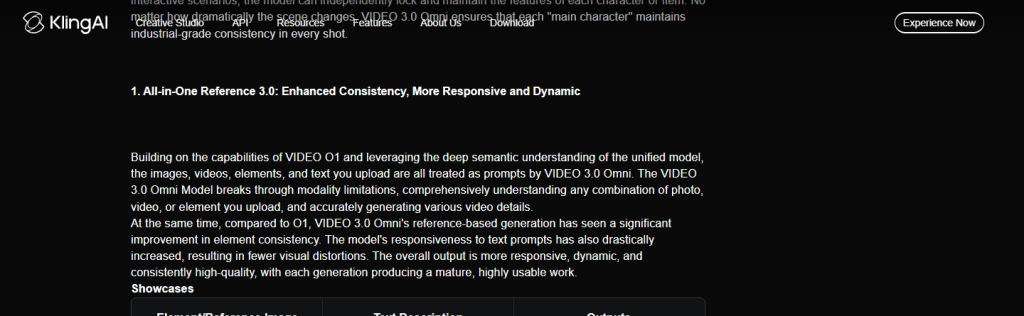
- إزالة التفاصيل المتكررة في المظهر: بمجرد إرفاق صورة شخصية مناسبة، ركز في بقية النص على الحركة وسلوك الكاميرا والصوت، بدلاً من تكرار وصف الشعر والملابس وملامح الوجه.
- صف الحركة التي تتناسب مع المصدر: تُعد الصورة المقربة مناسبة للتعبير الوجهي المعتدل؛ أما الصورة التي تُظهر الجسم بالكامل فتوفر للموديل مزيدًا من المعلومات فيما يتعلق بالمشي أو الإيماءات. هذا مسار عمل تحويل الصور إلى فيديو في Kling يتناول إعداد الصورة الأصلية بمزيد من التفصيل.
- إعادة تأكيد أولويات الاستمرارية: إذا كان الوجه أو المظهر أو الدعامة أو اتجاه الإضاءة هو الأهم، فاذكر ذلك. تزيد المراجع من احتمالات الحفاظ على الاتساق؛ لكنها لا تقضي تمامًا على التغير التدريجي أو انحراف المشهد.
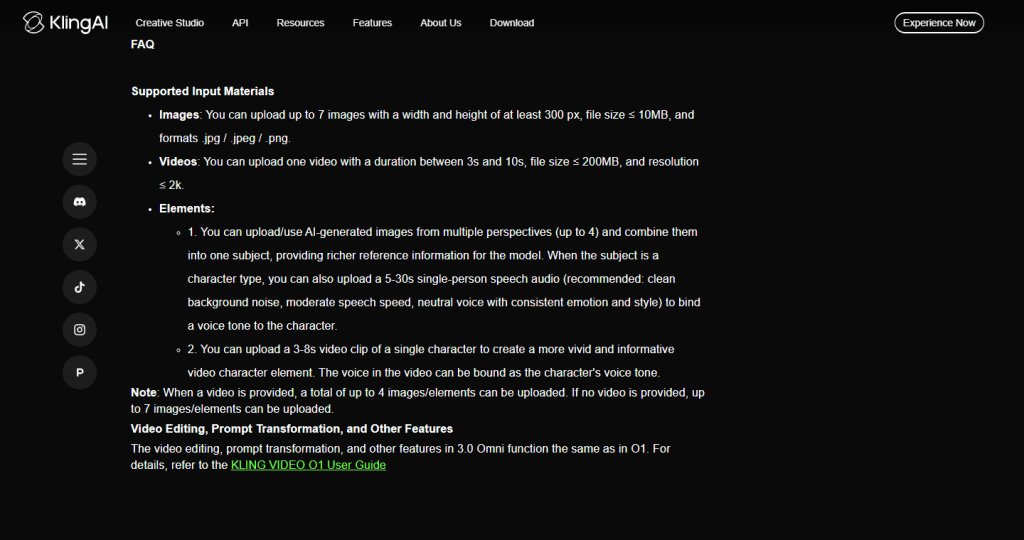
إن الدليل الرسمي لـ VIDEO 3.0 Omni يسمح الدليل بتقديم ما يصل إلى سبع صور أو مقطع فيديو واحد مدته من 3 إلى 10 ثوانٍ كمدخلات مدعومة. وعند تقديم مقطع فيديو، يحدد الدليل عدد الصور أو العناصر الإضافية بأربع صور أو عناصر. كما تنطبق قواعد حجم الملف والأبعاد الدنيا؛ لذا، يرجى مراجعة لوحة التحميل الحالية قبل إعداد مجموعة كبيرة من الملفات.
| المدخلات | يُفضل استخدامه في | التركيز الفوري | تحذير رئيسي |
|---|---|---|---|
| النص فقط | استكشاف المفاهيم والمشاهد التي لا تحتوي على شخصيات ثابتة | الموضوع، الحركة، الكاميرا، الموقع، الإضاءة، الصوت | يجب وصف المزيد من التفاصيل المرئية |
| صورة مرجعية | شخصية أو شيء أو زي أو أسلوب بصري معروف | الحركة، الكاميرا، الأداء، الصوت | يتحسن الاتساق، لكنه ليس مضمونًا |
| فيديو مرجعي في Omni | إشارات الحركة أو الاستمرارية من مقطع موجود | ما الذي يجب الحفاظ عليه وما الذي يجب تغييره | تسري الشروط الحالية المتعلقة بالمدة وحدود مشاركة المرافقين |
كيف يمكنك بناء سير عمل متعدد النماذج لحفظ أرصدة الجيل؟
يمكنك بناء سير عمل متعدد النماذج باستخدام ذكاء اصطناعي نصي سريع لكتابة النص، وذكاء اصطناعي عالي الجودة للصور لتوليد صورتك المرجعية، وأخيرًا استخدام ذكاء اصطناعي Kling AI فقط للرسوم المتحركة الفعلية، مما يقلل بشكل كبير أرصدة مهدرة.
سيختلف مقدار التوفير باختلاف المشروع، لكن هذا الترتيب يتيح إجراء التعديلات غير المكلفة في مرحلة مبكرة، قبل إنتاج الفيديو. ويظهر نفس المنطق التحضيري في سير العمل هذا بالنسبة لـ تحويل الصور إلى مقاطع فيديو سينمائية Kling.
- اكتب موجز اللقطة: اطلب من نموذج النص GPT-5.6 Sol أو أي نموذج نصي آخر قادر على ذلك أن يحدد حالات الإطار المتناقضة، وملكية الحوار غير الواضحة، والانتقالات المفقودة، واللقطات المزدحمة. تعامل مع المسودة كأنك محرر، وليس كخبير في الحدود الحالية لنموذج Kling.
- إنشاء المرجع: قم بإنشاء أو اختيار صورة تُظهر بوضوح الموضوع والملابس والأدوات المسرحية والتأطير المطلوبين للحركة.
- الرسوم المتحركة في Kling 3.0: أضف المرجع، ثم استخدم الموجه بشكل أساسي للإشارة إلى الحركة والكاميرا والتوقيت والصوت. قم بإنشاء نسخة معدلة واحدة خاضعة للرقابة قبل توسيع المشهد.
- مراجعة حالات الفشل التي يمكن ملاحظتها: لاحظ الانحراف في هوية الشخصيات، والإجراءات المفقودة، وحركة الكاميرا الخاطئة، وتوازن الصوت، والاتساق. قم بتغيير سبب واحد في كل مرة.
شاهد: كيفية توجيه فيديوهات الذكاء الاصطناعي مثل المخرجين
شاهد كيف يستخدم صانعو الأفلام المحترفون في مجال الذكاء الاصطناعي مطالبات سينمائية محددة وصورًا مرجعية للتحكم في حركات الكاميرا المعقدة في هذا البرنامج التعليمي المتعمق:
كيف يمكنك إصلاح الأخطاء والهلوسات الشائعة في الذكاء الاصطناعي؟
ابدأ بإزالة التعليمات المتعارضة وتحديد أي خطأ هو الأكثر أهمية. بعض المنصات توفر حقلًا للموجهات السلبية وبعضها لا يوفره؛ وحتى في حالة توفر هذا الحقل، فإنه قد يقلل من الأنماط غير المرغوب فيها ولكنه لا يستطيع ضمان عرض نظيف. إذا كنت تقارن سلوك النموذج بالإضافة إلى الموجهات، فإن هذا مقارنة بين Seedance 2.0 و Kling 3.0 يقدم معلومات أساسية مفيدة.
| المشكلة | السبب المحتمل | ما الذي يمكن تجربته |
|---|---|---|
| إطارات مشوهة | تطلب المطالبة مشاهد غير متوافقة، مثل لقطة مقربة للغاية ولقطة لكامل الجسم في آن واحد | اختر حجم إطار واحد لكل لقطة أو قسّم المشاهد إلى لقطات معلمة |
| الحركة التي فاتت | هناك عدد كبير جدًّا من الإجراءات التي تتداخل في فترة زمنية قصيرة | احرص على أن تحتوي كل لقطة على إيقاع حركة رئيسي واحد، وانقل الحركة الثانوية إلى اللقطة التالية |
| انعدام المشاعر | تحدد العبارة عاطفةً دون أن تعبر عنها | صف السلوكيات الظاهرة مثل ارتعاش اليد، أو النظر إلى الأسفل، أو الدموع على الخد |
| مكبر الصوت غير الصحيح | لم يتم تحديد الحوار بوضوح | اذكر اسم المتحدث، واقتبس العبارة بالضبط، ووصف أسلوب إلقائه |
| انحراف الشخصية | تفاصيل المظهر أو أولويات المرجع غير واضحة | استخدم مرجعًا واضحًا وكرر فقط تفاصيل الاستمرارية الأكثر أهمية |
| خلفية ذابلة أو اهتزاز | الحركة السريعة، أو تعقيد الكاميرا، أو التغييرات المتتالية في المشاهد | بسّط الحركة؛ إذا كانت الواجهة تقدم توجيهات سلبية، فصف العنصر المحدد دون توقع أي ضمان |
الأسئلة الشائعة
ما هو تنسيق المطالبة الأفضل لـ Kling 3.0؟
أفضل تنسيق هو صيغة سينمائية منظمة: حركة الكاميرا + وصف المشهد + حركة المشهد + حركة الموضوع + الإضاءة/الجو + علامات الصوت/التوقيت.
كيف أجعل شخصيات Kling AI تتحدث؟
اذكر اسم الشخصية، واكتب الحوار بالضبط بين علامتي اقتباس، ووصف طريقة نطقه. يدعم كل من Kling VIDEO 3.0 وVIDEO 3.0 Omni الصوت الأصلي؛ ويشير دليل VIDEO 3.0 الحالي إلى أن الحوار متوفر باللغات الصينية والإنجليزية واليابانية والكورية والإسبانية.
ما هي المدة القصوى لمقطع فيديو Kling VIDEO 3.0؟
تشير أدلة "VIDEO 3.0" و"VIDEO 3.0 Omni" الحالية الخاصة بـ Kling إلى أن مدة إنشاء الدلائل تتراوح بين 3 و15 ثانية. وقد تختلف الخيارات المتاحة وفقًا للوضع المحدد وواجهة النظام الأساسي.
ما الفرق بين Kling VIDEO 3.0 و VIDEO 3.0 Omni؟
يدعم كلا الطرازين الصوت الأصلي وسير العمل المتعدد اللقطات. ويضيف VIDEO 3.0 Omni سير عمل مرجعيًّا شاملاً يمكنه دمج النص مع الصور والفيديو والعناصر القابلة لإعادة الاستخدام، مع مراعاة حدود الإدخال الحالية.
كم عدد المراجع التي يمكنني إضافتها إلى جهاز Kling VIDEO 3.0 Omni؟
يحدد دليل Omni الرسمي ما يصل إلى سبع صور أو مقطع فيديو واحد مدته من 3 إلى 10 ثوانٍ. وعند تقديم مقطع فيديو، يمكن استخدام ما يصل إلى أربع صور أو عناصر إضافية. يرجى مراجعة الواجهة الحالية للتعرف على متطلبات حجم الملف وأبعاده.
لماذا تتشوه مقاطع الفيديو التي أنتجتها باستخدام الذكاء الاصطناعي Kling أو تذوب؟
عادةً ما تتشوه مقاطع الفيديو بسبب احتواء موجهك على الكثير من التعليمات أو حركات الكاميرا المتناقضة أو افتقاره إلى صورة مرجعية ثابتة لتثبيت التفاصيل الجسدية للشخصية.
هل الصور المرجعية أفضل من التوجيهات النصية فقط؟
تُعد الصور المرجعية مفيدة عندما يكون من الضروري أن تظل الهوية أو الملابس أو المقتنيات أو الأسلوب البصري قابلة للتعرف عليها. أما التوجيهات النصية فقط فتظل مفيدة لاستكشاف المفاهيم. ويمكن أن تساهم الصورة المرجعية في تحسين الاتساق، لكنها لا تضمن تشكيل شخصية محددة تمامًا.
هل يمكنني استخدام Kling 3.0 مع GlobalGPT؟
نعم. يحتوي GlobalGPT على مساحة عمل فيديو Kling 3.0 مزودة بعناصر تحكم في المرجع والصوت الأصلي والمدة والدقة. قد تتغير أسعار المنصة وقواعد الائتمان، لذا يرجى التأكد من الإعدادات الحالية قبل إنشاء دفعة كبيرة.
الخاتمة
تتمحور توجيهات Kling 3.0 الأفضل حول توجيه الخيارات الملموسة أكثر من التركيز على الكلمات المفتاحية السحرية. حدد الموضوع، واعطِ كل لقطة حركة واضحة ومهمة للكاميرا، وخصص الحوار، واستخدم المراجع عندما تكون الهوية البصرية مهمة. يمكن أن يقلل سير العمل المنظم من عمليات إعادة التصوير التي يمكن تجنبها، في حين يجب أن تتضمن المراجعة النهائية التحقق من التسلسل، والعيوب، والصوت. قبل نشر عمل العميل، راجع أيضًا الإرشادات الحالية بشأن Kling الاستخدام التجاري للذكاء الاصطناعي.