PERPLEXITY API · Python 教學 · 2026
本 Perplexity API 教學將向您展示如何建立一個 Python 腳本,使其能回傳包含可點擊的網路來源的答案。請使用 Agent API 傳送問題、讀取答案、將答案中的引用標記與來源 ID 配對,並匯出可供您檢視的 Markdown 檔案。.
我們將貫穿全文使用一個問題: 小型 Python 專案應如何使用虛擬環境並管理依賴項? 請從一個基本的請求開始,接著加入來源解析和網域篩選功能。您需要具備基本的 Python 知識,並擁有一個已設定 API 計費功能的 Perplexity 開發者帳戶。.
如果您也利用人工智慧進行日常的研究和寫作,, Perplexity 對 GlobalGPT 可在一體化的 AI 工作區內進行操作,減少了在不同工具之間切換的需求。此處所指的消費者工作流程,與開發者金鑰及 API 計費機制是分開的。.
快速回答: 使用 快速 針對第一個基於網路的答案所預設的代理程式,請閱讀 response.output_text 查看答案,並閱讀 搜尋結果 項目位於 response.output 用於來源。根據其回傳的值,將每個內嵌標記與相應的來源進行配對 id. 引用意指「該回答指出了這個結果」;這並不保證該頁面能證明每項論點。.
狀態範例: 此請求語法遵循 2026 年 9 月 28 日查閱的官方文件。引用輔助工具已使用離線樣本資料進行驗證;本教學未執行任何付費 API 請求。圖中顯示的來源記錄僅為說明性範例。.
- 您應該使用哪種 Perplexity API?
- 步驟 1:取得 API 金鑰並設定 Python
- 步驟 2:發送您的第一個源極接地請求
- 步驟 3:提取答案並對應其來源
- 步驟 4:利用搜尋篩選器優化答案
- 步驟 5:儲存包含可點擊來源的完整答案
- 串流與結構化輸出
- 成本與常見錯誤
- 從較舊的 Sonar 教學轉移過來
- 常見問題
Perplexity API 教學:選擇合適的 API
這些是開發者介面。聊天產品可能會以不同的方式整合類似的功能;關於我們的概述 《Perplexity》的特色 描述了使用者端的使用體驗。.
Perplexity 的 官方 API 快速入門 根據您需要完成的任務,將其開發者產品進行分類。請選擇能產生您的應用程式實際所需資料的最小工作表面。.
| API | 最適合 | 您的程式碼會收到什麼 |
|---|---|---|
| 代理人 | 基於網路搜尋或其他工具所得出的完整答案 | 輸入的輸出項目、答案文字及搜尋結果紀錄 |
| 搜尋 | 您的應用程式會自行對結果進行排序、篩選或彙總 | 無需請 Perplexity 寫出最終答案的搜尋結果 |
| 路由器 | 將請求轉發至合適的模型 | 透過路由器選取的範例回應 |
| 嵌入向量 | 語義檢索與 RAG 索引 | 用於您自己的搜尋圖層的向量圖 |
本教學選擇「Agent」,因為您想要的結果是完整的答案及其來源。關於更廣泛的研究工作流程,請參閱我們的指南: 將 Perplexity 用於研究.
關於 Sonar: 目前的 遷移概覽 指出 Sonar Chat Completions 仍持續獲得支援,並建議所有新專案採用 Agent。因此,本教學將使用 Agent。請勿因舊版教學中提及的截止日期,而推斷舊版整合功能已停止運作。.
步驟 1:取得 API 金鑰並設定 Python
建立金鑰並準備帳務處理
開啟 Perplexity API 控制台, 選擇或建立您將使用的專案、設定 API 計費,並建立金鑰。請將金鑰保留在伺服器端。開發者 API 的計費方式與使用者訂閱分開;在發出請求前,請先確認您的專案餘額。.
安裝官方 SDK
python -m venv .venv

# macOS/Linux:請選擇此啟用指令
source .venv/bin/activate

# Windows PowerShell:請改用此指令
.venv\Scripts\Activate.ps1

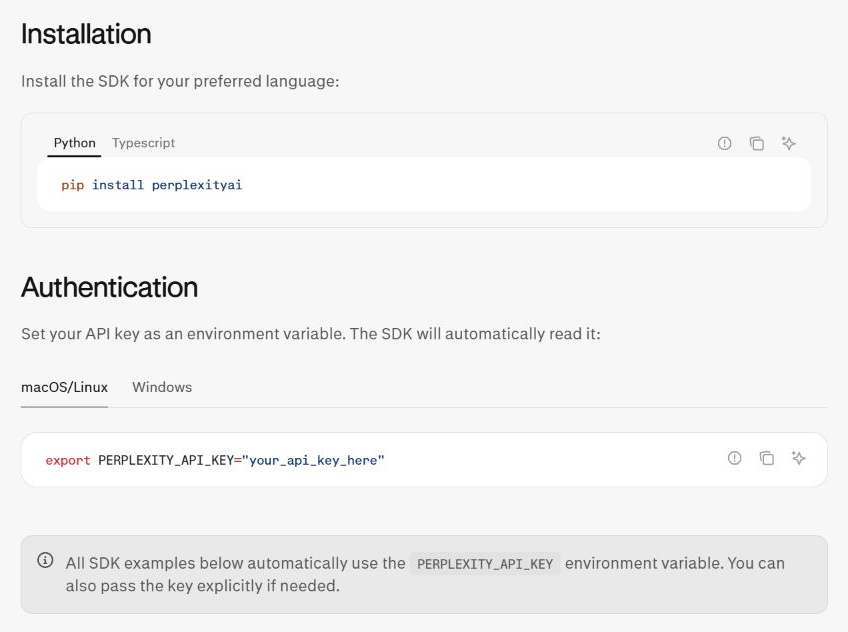
python -m pip install --upgrade perplexityai
請使用 Python 3.10 或更新版本來執行以下程式碼。請根據您的作業系統,使用對應的指令來啟用環境,然後安裝 SDK。如果 PowerShell 阻擋了環境啟用,請使用 .venv\Scripts\python.exe 取代 python 用於安裝及執行腳本。.
套件名稱是 perplexityai, 而 Python 的匯入語法則是 困惑. 請使用虛擬環境,以免本教學的依賴項影響其他專案。.
此範例採用程式設計問題,是因為其論點可透過參照經維護的文件來驗證。我們的指南說明 Perplexity 用於編碼 說明了研究支援在「自行測試程式碼」的過程中扮演何種角色。.
將 API 金鑰設定為環境變數
# macOS/Linux
export PERPLEXITY_API_KEY="您的金鑰請填入此處"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "您的金鑰請填入此處"
SDK 讀取 困惑_API_金鑰 在建立客戶端時。請勿將金鑰貼到筆記本中、提交至 Git,或傳送至瀏覽器。若您在本地端使用 .env 檔案,請將該檔案排除在版本控制之外,並透過您選擇的環境變數函式庫來載入該檔案。.
步驟 2:發送您的第一個源極接地請求
Agent API 快速入門 文件 文章連結 https://api.perplexity.ai/v1/agent. 其 Python 客戶端會將請求封裝在 client.responses.create(). . 快速 預設值會預先啟用網頁搜尋功能,因此讓第一個範例保持簡短。.
from perplexity import Perplexity

client = Perplexity()

question = (
    "一個小型 Python 專案應如何使用虛擬環境"
    "並管理依賴項?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
將此程式片段儲存為 first_request.py, 然後執行 python first_request.py 在您設定金鑰的同一終端機中執行。若呼叫成功,應會輸出非空的回應文字。若您需要結果的證明,請繼續進行來源擷取步驟;僅憑文字本身並不能視為完整的檢查。.
便利性屬性 輸出文字 會提供給您最終的答案文字。請一併保留整個回應物件:來源記錄和使用詳情都包含在類型化輸出中,而不僅僅是列印出來的段落內容。.
使用 cURL 發出相同的請求
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "小型 Python 專案應如何使用虛擬環境並管理依賴項?"
  }'
此 cURL 範例採用適用於 macOS/Linux 或與 Bash 相容的 shell 的 Bash 語法。每次執行都會產生另一項需計費的請求。請僅在需要將端點問題與 Python 問題區分開來時才使用此範例;請勿僅為了跟隨範例而執行每個版本。.
等效的伺服器端 JavaScript 程式碼
Node.js 18 及以上版本包含 fetch, ,因此伺服器端的煙霧測試無需額外的函式庫。閱讀原始碼 輸出 JSON 回應中的項目;Python SDK 提供了便捷的 輸出文字 配件。.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "一個小型 Python 專案應如何使用虛擬環境並管理依賴項?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
步驟 3:提取答案並對應其來源
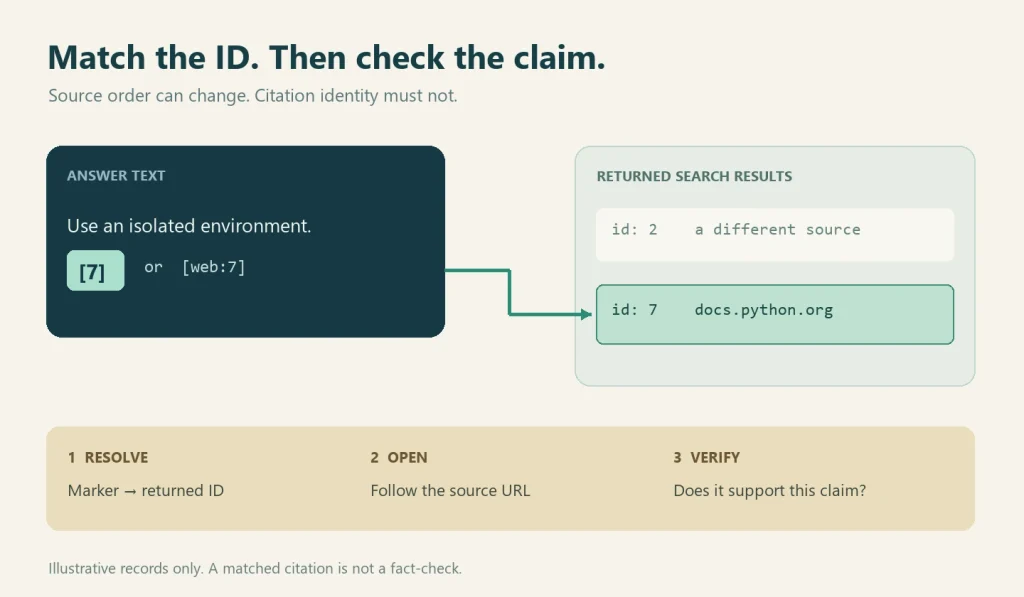
官方引用指引 將散文與其證據記錄區分開來。資料以一種 輸出 類型為 的項目 搜尋結果. 閱讀該項目的 結果 並將每個引用標記與結果的 id. 結果包含標題和網址;在顯示結果前,請先處理缺失的值。.
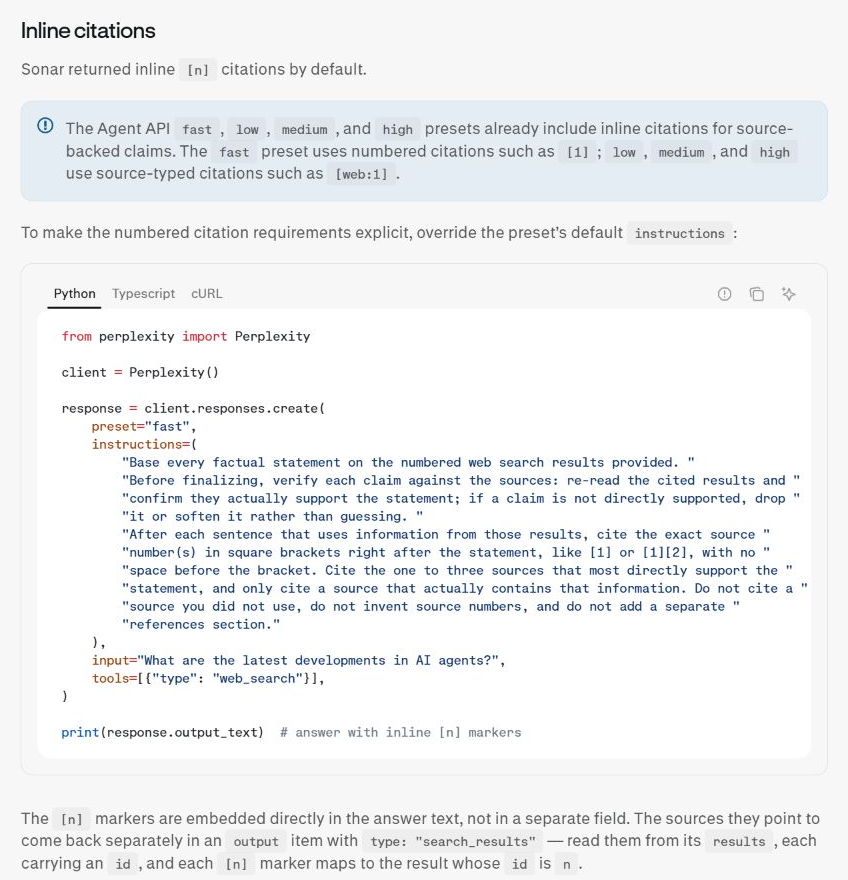
這個最後的細節很重要。請不要假設在其他工具新增一項內容後,「引用 1」總是陣列中的第一個元素。應先建立一個根據 ID 進行查詢的機制,然後解析實際出現在答案中的標記。.
def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict), else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"來源 ID {key} 的 URL 發生衝突")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # 這是來源 ID,而非陣列位置 7
以下完整的腳本可識別 [1] 和 [web:1], ,即常見預設值的已記錄引用格式。上述輔助程式同時支援 SDK 物件和字典,並會拒絕將衝突的 URL 指派給同一個 ID。它不會重新編號結果,也不會推測缺失的來源。.
關於引用品質的更廣泛討論,請參閱我們的 Perplexity 引用準確性指南. 引用是一條稽核軌跡;您的應用程式仍需針對過期頁面、重複網址及未受支援的主張制定相關政策。.
舉例來說,如果回傳的陣列中包含 ID 2,緊接著是 ID 7,則該標記 [7] 必須連結至 ID 7。如果相同的 URL 同時出現在 ID 7 和 ID 9 下,您可以只顯示該 URL 一次,同時保留這兩個 ID。如果 ID 8 永遠不會出現,請保留 [8] 顯示出來,並標記為「未匹配」。.
步驟 4:利用搜尋篩選器優化答案
一旦基本查詢能正常運作,當您的問題有明確的權威範圍時,請縮小搜尋範圍。就 Python 套件編譯而言,語言文件和套件編譯指南比隨意的教學文章更適合作為起點。.
response = client.responses.create(
    preset="fast",
    input=(
 "小型 Python 專案應如何使用虛擬環境 "
 "並管理依賴項?請引用您所遵循的指引。"
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
該篩選器應位於網頁搜尋工具的設定中。遷移文件中亦說明了 search_recency_filter 適用於對時間敏感的問題。當問題取決於近期發布的內容或新聞時,請採用「近期性」原則;若領域與日期的組合過於狹窄,可能會導致可用證據過少。.
若要詢問關於過去一個月內發行的問題,請加上 "search_recency_filter": "month" 旁邊 search_domain_filter. 請將其從虛擬環境範例中省略:穩定版文件可能具有較早的發布日期。若您從預設模型切換至直接選取的模型,請明確包含網路搜尋工具。.
在開發過程中,請比較經過篩選與未經篩選的結果。若答案有所變化,請記錄原因:篩選機制可能移除了有用的背景資訊,也可能移除了那些會干擾模型的權威性較低頁面。這是一項品質決策,而非保證所有剩餘的頁面皆正確無誤。.
如果您的應用程式僅需帶有排名的連結和摘要,請呼叫 搜尋 API 並親自進行合成。這種分離能讓審查和快取工作更為容易。若要與 Google 進行更廣泛的比較,請參閱 Perplexity 與 Google 的差異何在.
步驟 5:儲存包含可點擊來源的完整答案
將以下內容儲存為 perplexity_tutorial.py. 它是一個獨立運作的系統:包含來源輔助程式、套用 Python 文件領域篩選器、將匹配的引用標記轉為連結、在不遺失 ID 的情況下將重複的 URL 進行分組,並將完整的 SDK 回應與 Markdown 檔案一併儲存。.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
 "一個小型 Python 專案應如何使用虛擬環境 "
 "並管理依賴項?"
)
# 支援在散文式回答中使用文件中所述的 [1] 及 [web:1] 格式。
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
 return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
 sources = {}
 for item in output or []:
 if field(item, "type") != "search_results":
 continue
 for result in field(item, "results", []) or []:
 sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
 raise ValueError(f"來源 ID {key} 的 URL 發生衝突")
 sources[key] = result
 return sources

def safe_url(value):
 if not isinstance(value, str):
 return None
 parsed = urlsplit(value)
 if parsed.scheme not in ("http", "https") or not parsed.netloc:
 return None
 # 保護 Markdown 尖括號目標。
 return value.replace("", "").replace(" ", "")

def md_label(value):
 return re.sub(r"([\\\[\]])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
 sources = source_index(output)
 cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
 missing = [
 sid for sid in cited
 if sid not in sources or not safe_url(field(sources[sid], "url"))
 ]
 def link(match):
 sid = match.group(1)
 url = safe_url(field(sources.get(sid, {}), "url"))
 return f"[{match.group(0)[1:-1]}]()" if url else match.group(0)

 # 當同一 URL 出現在不同 ID 下時,保留每個 ID。
 grouped = defaultdict(list)
 titles = {}
 for sid in cited:
 source = sources.get(sid, {})
 url = safe_url(field(source, "url"))
 if url:
 grouped[url].append(sid)
 titles.setdefault(url, field(source, "title") or url)

 lines = ["# 基於來源的答案", "", 問題, "",
 CITATION_RE.sub(連結, 答案), "", "## 被引用的來源", ""]
 for url, ids in grouped.items():
 lines.append(f"- IDs {', '.join(ids)}: [{md_label(titles[url])}]()")
 if missing:
 lines.append("- 未匹配或無法使用的來源 ID: " + ", ".join(missing))
 if not cited:
 lines.append("- 未發現可識別的內嵌引用;證據未經驗證。")
 lines.extend(["", "來源連結需經審查;僅憑 ID 匹配無法驗證主張。"])
 return "\n".join(lines) + "\n"

def main():
 from perplexity import Perplexity
 response = Perplexity().responses.create(
 preset="fast",
 input=QUESTION,
 tools=[{"type": "web_search", "filters": {
 "search_domain_filter": ["docs.python.org", "packaging.python.org"]
 }}],
 )
 answer = response.output_text or ""
 if not answer.strip():
 raise RuntimeError("未返回答案文字;請檢查回應狀態與錯誤訊息。")
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 print("已儲存 perplexity-answer.md 和 perplexity-response.json")

if __name__ == "__main__":
 main()
奔跑 python perplexity_tutorial.py 從您的專案目錄中。它會寫入 perplexity-answer.md 和 perplexity-response.json 該處會以這些檔案取代先前同名的檔案。Markdown 檔案包含問題、連結的答案、引用來源以及任何未配對的 ID。JSON 檔案則保留回傳的輸出內容及使用方式,供診斷之用。.
此解析器專門針對散文中已記錄的單標記形式。它並非完整的 Markdown 解析器:若您的應用程式需要處理任意的 Markdown、程式碼範例或引用,例如 [1,2], 為該格式新增一個支援語法辨識的渲染器及相關測試。請勿在未發出警示的情況下重新解讀不熟悉的標記。.
請確認連結的頁面是否支援該答案
以這個範例為例,請確認所引用的文件是否確實說明了環境隔離與依賴項安裝。連結至 Python 官方首頁的連結,其實用性不如相關文件章節。如果某個解答建議使用特定指令,請在執行前先確認其作業系統與 Python 版本。Mark 聲稱該引用內容並未將此問題標記為「未解決」。.
必要時加入串流或結構化輸出
串流
串流技術可改善聊天介面的感知延遲。代理程式遷移指南中記載了諸如以下這類的文字差異事件: response.output_text.delta. 請在收到這些增量更新時立即進行渲染,但同時也要收集最終的回應項目,以便在回答完成後,您的使用者介面能顯示來源清單。單純的文字串並不能構成來源清單。.
以下僅為文字顯示。請保留第一個完整來源記錄的非串流匯出檔;在實際生產環境的串流實作中,還必須收集工具/輸出事件,並處理中斷或失敗的執行程序。.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
    print(event.delta, end="", flush=True)
結構化輸出
當下游程式碼需要諸如以下欄位時,請採用結構化回應: 回答, confidence_note 和 後續問題. 請將來源 ID 設為獨立欄位,或保留原始 Agent 輸出內容,以免您的資料結構掩蓋相關證據。在將資料結構應用於工作流程之前,請先使用您自己的測試案例進行驗證。.
遷移參考資料保留了 response_format 與 type: "json_schema" 針對結構化輸出。請定義必填欄位,並在適當情況下禁止出現未預期的屬性。模式有效性檢查著重於格式,而非真實性:來源 ID 仍須能解析為實際回傳的記錄,且由模型生成的置信度標籤並非準確度的衡量標準。.
Perplexity API 的費用與常見錯誤
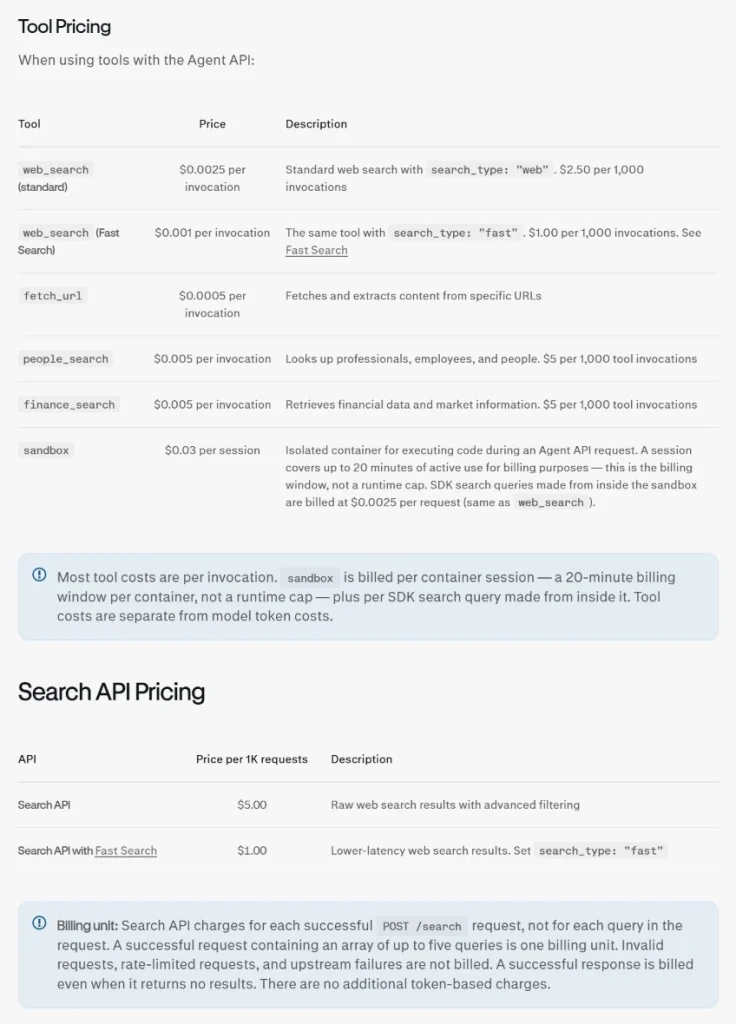
Perplexity 的官方定價頁面, ,查閱日期為 2026 年 9 月 28 日,此處將 Agent 模型代幣與工具呼叫區分開來。以下為 USD 工具/搜尋費用。該 快速 代理預設值與 search_type: "快速" 這些是不同的設定選項;請勿根據預設名稱推斷搜尋速率。.
| 可計費行為 | 每股美元 | 每 1,000 美元 |
|---|---|---|
| 代理標準網路搜尋 | $0.0025 | $2.50 |
| Agent Fast Search 的呼叫 | $0.001 | $1.00 |
| 代理程式 URL 擷取 | $0.0005 | $0.50 |
| 搜尋 API 請求成功 | $0.005 | $5.00 |
| 搭配 Fast Search 的搜尋 API | $0.001 | $1.00 |
範例: 1,000 次標準網路搜尋呼叫加上 1,000 次 URL 擷取的費用為 $3.00 的工具費 ($2.50 + $0.50),此為模型代幣或其他費用前的金額。這僅為教學範例中假設的工作量,並非實際測量出的成本。單一代理請求可能會調用多個工具。如有提供,請檢視 使用量.成本.總成本 在已完成的回覆上。.
| 症狀 | 首先應檢查什麼 |
|---|---|
| 401 或 403 | 環境變數名稱、金鑰有效性、帳戶存取權限,以及請求是否已傳送至當前端點。. |
| 計費或配額錯誤 | API 配額、付款設定、模型/工具費用及帳戶限額。Perplexity 消費者方案並不代表會自動獲得 API 配額。. |
| 429 | 速率限制與重試行為。應採用有限的指數退避機制,並避免盲目地重發已成功處理的請求。. |
| 超時 | 網路路徑、提示字元大小、工具數量及客戶端超時設定。若 SDK 提供了請求 ID,請將其記錄下來,但切勿記錄金鑰。. |
| 此答案沒有相符的來源 | 檢查原料 response.output, 引用語法與來源識別碼;應將答案標記為「未經核實」,而非捏造連結。. |
搜尋 API 會對成功的請求進行計費,包括未返回任何結果的請求;其請求價格不包含額外的代幣費用。代理程式成本則取決於模型代幣和工具。在比較「回答」工作流程與「僅搜尋」工作流程時,請將這些計費單位區分開來。.
若要比較 API 的預算,我們的 Perplexity API 費用指南 提供了背景資訊,但官方定價頁面仍是查閱現行費率的權威來源。.
從較舊的 Sonar 教學轉移過來
許多搜尋結果仍顯示舊版的「聊天內容自動完成」圖形。客服專員遷移指南採用直接的概念對應方式。若您要比較消費者模型標籤與 API 預設值,請參閱我們關於 LLM Perplexity 使用什麼 雖提供背景資訊,但不能取代 Agent API 文件。.
| 較舊的聲納圖案 | 代理 API 模式 |
|---|---|
訊息 | 輸入 |
模型 | 預設 |
choices[0].message.content | 輸出文字 |
| 較早的引文陣列假設 | 搜尋結果 輸出項目與基於 ID 的比對 |
| 請求中的搜尋參數 | tools=[{"type":"web_search","filters":{...}}] |
閱讀直播 遷移概覽 和 遷移詳情 在修改生產代碼之前。預設的映射僅為起點,並不保證新舊模型在品質、延遲或成本方面能達到相同水準。.
常見問題
Perplexity API 是免費的嗎?
根據目前的快速入門指南和定價文件,API 採用隨用隨付的計費方式。請勿假設消費者訂閱、試用或促銷抵用額會使每個 API 請求都免費。.
我需要 Perplexity Pro 才能使用這個 API 嗎?
API 存取權限與「Pro」級使用者方案是兩項獨立的產品。請為您計劃使用的開發者帳戶建立 API 憑證,並確認 API 計費相關資訊。.
我應該使用 Agent API 還是 Search API?
若您希望獲得附有來源的完整且有根據的答案,請選擇「Agent」;若您的應用程式應自行負責排序、篩選與綜合分析,請選擇「Search」。若您需要對每個生成步驟進行嚴格控制,可將「Search」與您自己的模型結合使用。.
我可以在 JavaScript 中呼叫 Perplexity 嗎?
是的。請使用上方的伺服器端 Node.js 範例或官方的 JavaScript SDK。請將金鑰存放在伺服器上。在讀取原始 JSON 時,請檢查已標記類型的輸出項目,並套用相同的來源 ID 映射規則。.
Perplexity 的引用資料是否保證正確?
不。引用僅是告訴您,該答案所指涉的是哪一項檢索結果。您的申請案或審查員仍須確認該頁面的時效性、權威性,以及該頁面是否確實支持該主張。.
為什麼我的解析器找不到任何來源?
檢查原始輸出項目的類型,確認網路搜尋是否已執行,並檢查您的正規表達式是否符合預設的引用格式。若未出現任何標記,請將答案儲存為「未經核實」,並進一步調查該請求,而非隨意添加猜測的連結。.
GlobalGPT 能否取代 Perplexity API 金鑰?
GlobalGPT 是一個專為日常 AI 應用設計的一體化 AI 工作區。其訂閱服務與模型存取權限,與 Perplexity 開發者帳戶、API 金鑰及 API 額度是分開的;本 Python 教學將使用該開發者帳戶。.
實用的發射檢查清單
- 建立伺服器端金鑰並確認 API 計費設定。.
- 執行最小配置
快速在新增篩選條件或開始串流之前,請先提出請求。. - 請儲存完整的回應內容,而不僅是可見的答案文字。.
- 將引用標記與回傳的來源識別碼進行配對,並標記未配對的標記。.
- 檢視所引用的頁面,以確認其是否能支持主張、內容是否最新,以及是否存在重複的網址。.
- 部署前,請再次確認「Live Agent」、定價及遷移相關文件。.
現在您已經掌握了可靠 Perplexity API 整合的核心模式:提出針對性的問題、讓 Agent API 進行搜尋、將答案與佐證資料一併保存,並確保每項引用皆可追溯。在此基礎上,您可以針對相同的來源 ID 工作流程,加入快取、重試機制以及您自訂的審核規則。.