O Grok 4.7 representa uma atualização significativa para programação e trabalho intelectual, mas ainda é cedo para tirar conclusões: as declarações oficiais de lançamento e os testes de desempenho independentes apontam para uma melhora, mas não para um sucesso universal.
Resposta rápida
O Grok 4.7 é a atualização da xAI de 21 de setembro de 2026, voltada para programação e tarefas complexas de trabalho intelectual. A xAI afirma que o modelo dedica mais tempo a problemas complexos, verifica seu trabalho com mais cuidado e adiciona uma nova pilha de proteções, mantendo o mesmo preço e a mesma velocidade do Grok 4.6. A página de lançamento também o apresenta como duas vezes mais rápido e pela metade do preço de modelos comparáveis — uma comparação entre fornecedores que deve ser interpretada levando em conta a tarefa e o caminho subjacentes. Dados independentes da Artificial Analysis indicam um pequeno avanço geral em relação ao Grok 4.6 e registram uma janela de contexto de 500 mil. Em nosso teste de API com três tarefas, o Grok 4.7 se destacou na depuração e na disciplina de limites de código-fonte; seu plano de projeto preservou bem a incerteza, mas foi menos prático do que o solicitado. Essa é uma evidência prática útil, não uma prova de que ele supera todos os modelos concorrentes.
O que é o Grok 4.7?
O Grok 4.7 é o modelo mais recente da linha Grok da xAI, anunciado em 21 de setembro de 2026. O anúncio oficial da xAI isso o posiciona como o modelo mais capaz da empresa para programação e trabalho intelectual. A mudança significativa não está em uma nova lista de recursos voltados para o consumidor. Trata-se de uma mudança na forma como se espera que o modelo distribua seus esforços: mais tempo dedicado a tarefas difíceis, mais autoverificação e uma camada de segurança destinada a tornar essa capacidade adicional mais controlável.
Esse posicionamento é importante porque descreve um modelo de fluxo de trabalho, e não a personalidade de um chatbot. O Grok 4.7 está sendo comercializado como um modelo para tarefas que se beneficiam de uma análise contínua: depuração, planejamento, redação técnica, síntese de pesquisas e prompts longos que exigem que o modelo mantenha várias restrições em consideração.
A limitação é igualmente importante. O anúncio da xAI é uma declaração do fornecedor sobre o comportamento pretendido. Não se trata de uma prova independente de que o Grok 4.7 supere todos os modelos concorrentes, todas as instruções ou todos os repositórios de código. Considere a página de lançamento como a fonte das afirmações da xAI e, em seguida, utilize medições independentes e sua própria tarefa para decidir se essas afirmações são relevantes.
Grok 4.7 x Grok 4.6: o que realmente mudou?
A interpretação mais plausível é que se trata de uma melhoria em termos de esforço e confiabilidade, e não de um produto completamente diferente.
| Área | Grok 4,7 | O que as evidências indicam |
|---|---|---|
| Lançamento | 21 de setembro de 2026 | Data indicada na página oficial de lançamento da xAI |
| Posicionamento principal | Programação e trabalho intelectual | Posicionamento oficial da xAI |
| Tarefas difíceis | Esforço mais prolongado e autoverificação mais cuidadosa | Descrição oficial do xAI; nossa execução da API com três tarefas oferece uma breve avaliação prática, e não uma comparação direta |
| Segurança | Nova pilha de salvaguardas | Descrição oficial da xAI |
| Preço e velocidade | Igual ao Grok 4.6, de acordo com a xAI | Uma alegação de lançamento, não uma auditoria de preços realizada por terceiros |
| Contexto | 500 mil tokens no perfil “Análise Artificial” | Perfil de modelo independente; verifique a rota que você utiliza |
| Controles de raciocínio | De ’Baixa” a “xAlta” na lista da Artificial Analysis | Metadados independentes de rota/modelo |
Essa é uma distinção útil para os compradores. Se a versão Grok 4.6 já se adapta ao seu fluxo de trabalho, a versão 4.7 é uma atualização sem grandes complicações que vale a pena avaliar. Se a versão 4.6 não se adaptou devido a restrições relacionadas ao ecossistema, latência, confiabilidade ou acesso, um número mais alto no benchmark, por si só, não resolve esses problemas.
Para um quadro mais abrangente de aquisição de modelos, o Guia de preços do GPT-5.6 e Comparação entre GPT-5.6 são lembretes úteis para diferenciar a qualidade do modelo dos aspectos econômicos do projeto e da adequação ao fluxo de trabalho.
Recursos: em que o Grok 4.7 deve ajudar
Codificação e depuração
O principal argumento de lançamento da xAI é a programação. A promessa não é simplesmente que o Grok 4.7 escreva mais código; é que ele consiga se dedicar por mais tempo a um problema complexo de engenharia, analise sua própria resposta e apresente um patch ou uma explicação mais bem fundamentada. Esse é o comportamento que se deve buscar em um repositório real: ele preserva o projeto existente, identifica a causa raiz, adiciona testes úteis e indica o que ainda não consegue saber?
Não avalie o modelo com uma solicitação do tipo “crie um aplicativo de tarefas” a partir do zero. Apresente a ele um bug delimitado com um teste que falha, um pequeno conjunto de arquivos e restrições explícitas. Peça um diagnóstico antes de um patch. Isso facilita perceber se o raciocínio mais extenso realmente gera menos trabalho de revisão ou se trata apenas de um texto mais longo.
A mesma regra se aplica às equipes que comparam diferentes formas de codificação. A Análise do DeepSeek V4 Pro e o Revisão do Plano de Codificação do GLM fornecem um contexto útil para comparação, mas nenhum deles deve ser considerado um substituto para testar o repositório e a cadeia de ferramentas que você realmente utiliza.
Trabalho intelectual com contexto extenso
O Artificial Analysis indica uma janela de contexto de 500 mil tokens para o Grok 4.7. Isso é grande o suficiente para mudar a maneira como você lida com trabalhos que envolvem muito material de referência: uma longa especificação técnica, um conjunto de notas de reunião, uma parte do código-fonte ou um pacote de pesquisa podem permanecer em uma única conversa, em vez de serem resumidos repetidamente.
A capacidade de contexto não é a mesma coisa que a qualidade do contexto. Um modelo pode aceitar uma entrada extensa e, mesmo assim, deixar passar uma restrição no meio do texto, dar peso excessivo ao último parágrafo ou produzir um resumo confiante que precise de verificação da fonte. O teste prático é a recuperação sob pressão: coloque alguns fatos decisivos em diferentes partes de um documento longo, solicite uma decisão com restrições e verifique se a resposta cita as passagens corretas.
A conta oficial da SpaceXAI no X repetiu a apresentação do lançamento em 22 de setembro, classificando o Grok 4.7 como uma melhoria notável em relação ao Grok 4.6, com o mesmo preço e velocidade, e compartilhando o gráfico de comparação entre os modelos. Essa publicação é uma evidência útil do posicionamento público da empresa, não uma validação independente nem um consenso da comunidade.
Se o modelo for utilizado para pesquisa, mantenha o ciclo de evidências visível. Nosso Comparação entre Gemini e Perplexity e Guia de alternativas ao Perplexity apresentam a mesma observação prática: uma resposta bem elaborada não equivale a uma auditoria de fontes.
Autoverificação e segurança
A xAI afirma que o Grok 4.7 verifica seu trabalho com mais cuidado e introduz uma nova pilha de proteções. Esses são objetivos valiosos, especialmente quando se pede ao modelo que tome uma longa sequência de decisões. No entanto, eles não garantem que o resultado seja correto ou seguro para execução automática.
Para uso em produção, mantenha os controles habituais em torno do modelo: testes, permissões, revisão humana, verificações de citações e uma condição clara de interrupção. A autoverificação do modelo é mais um sinal a ser analisado, não um substituto para os controles que o cercam.
Tests de desempenho do Grok 4.7: o que os números revelam
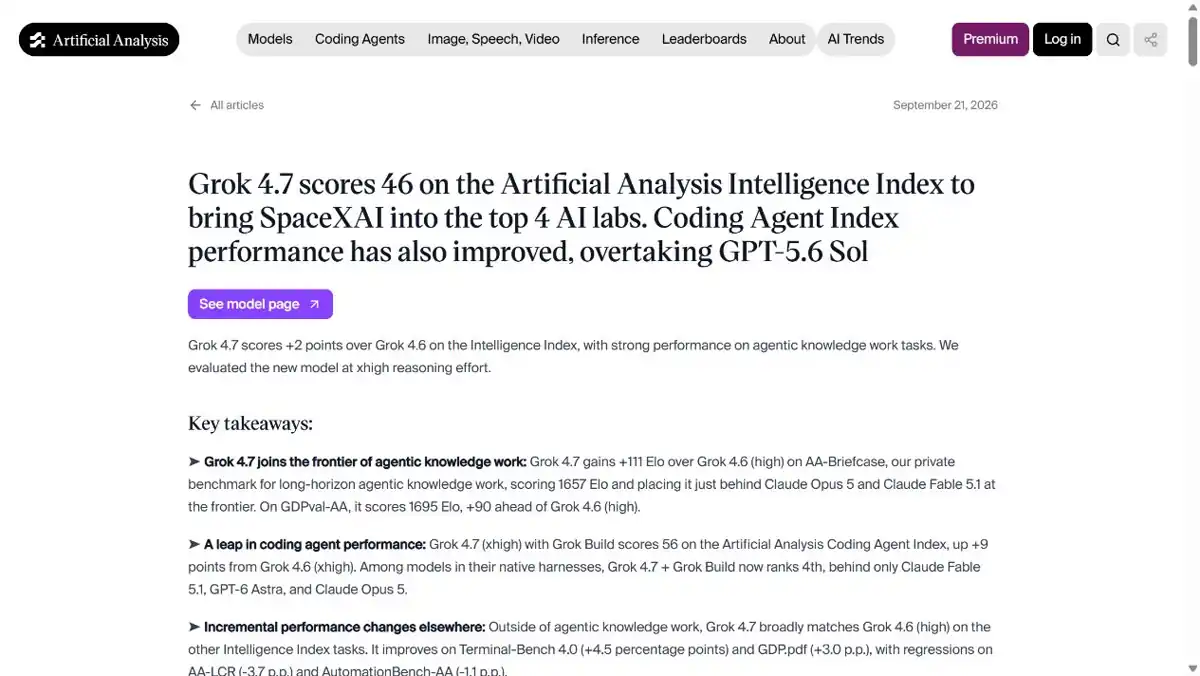
O panorama independente mais útil no momento vem de Artigo de benchmarking da ’Artificial Analysis” sobre o Grok 4.7, datado de 21 de setembro de 2026.
| Medida | Resultado divulgado | Como ler |
|---|---|---|
| Índice de Inteligência Artificial em Análise | 46 | Dois pontos acima do Grok 4,6 no mesmo índice |
| AA-Pasta | 1.657 Elo | 111 Elo acima de Grok 4,6 nessa avaliação |
| Janela de contexto | 500 mil tokens | Um campo de perfil de modelo, e não uma prova de recuperação perfeita em contexto longo |
| Esforço de raciocínio | Baixo a xalto | Um controle no nível da rota listado pela Artificial Analysis |
A tendência é animadora: o índice independente mostra uma melhora em relação à versão anterior, e a maior diferença no Elo no AA-Briefcase sugere um ganho mais perceptível nessa avaliação específica. No entanto, a tabela ainda apresenta dois conjuntos de dados, e não um ranking universal. A composição do benchmark, o acesso às ferramentas, a amostragem e as configurações do modelo podem alterar o resultado.
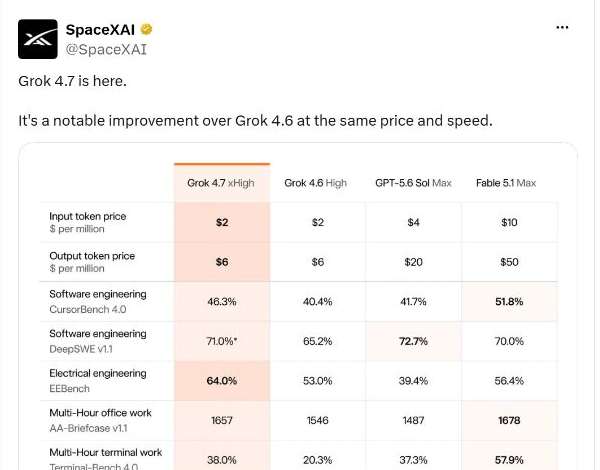
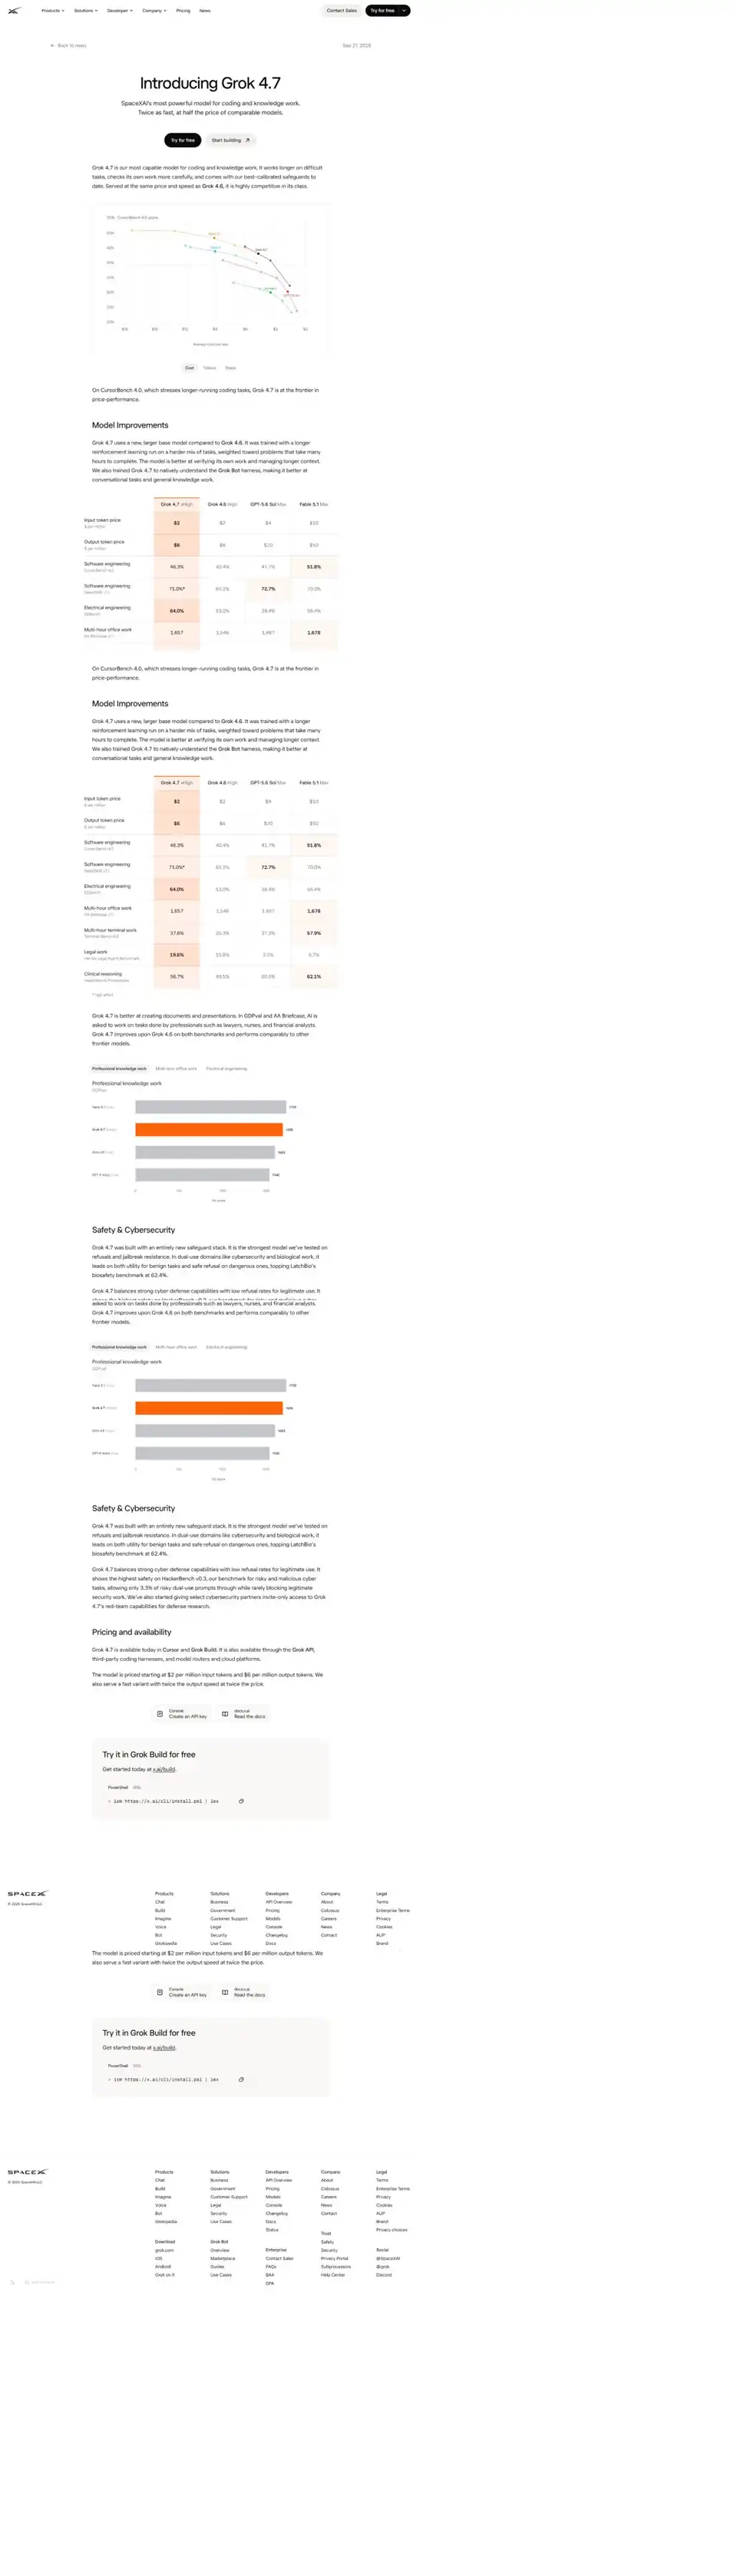
A página oficial de lançamento da xAI exibe o Grok 4.7 em 46,31 TP40T no CursorBench 4.0 em sua tabela comparativa, ao lado do Grok 4,6 com 40,4%, do GPT-5.6 Sol com 41,7% e do Fable 5.1 com 51,8%. A página também mostra 71,01 TP40T no DeepSWE v1.1 com alto esforço, 64,01 TP40T no EEBench e 1.657 no AA-Briefcase v1.1. Esses são números comparativos apresentados pelo fornecedor; portanto, considere-os como resultados oficiais divulgados, e não como substituto de uma replicação independente. A conclusão mais segura é que o xAI tem como alvo tarefas sérias de programação e trabalho intelectual profissional, enquanto medições independentes mostram uma melhoria significativa em algumas tarefas e resultados mais modestos em outras.
Teste prático Grok 4.7: três tarefas práticas
Testamos três prompts fixos com o grok-4.7 ID do modelo por meio de uma API de teste compatível com OpenAI em 23 de setembro de 2026. Trata-se de uma avaliação de rota única, não da API direta do xAI nem de um teste comparativo com concorrentes. A resposta visível de cada execução está preservada abaixo; os rastros de raciocínio privados foram excluídos.
| Tarefa | Tempo observado | Resultado |
|---|---|---|
| Bug de concorrência no TypeScript | 333,7 segundos, transmitido | Aprovação com nota alta: diagnóstico correto do problema com `shared-promise`, correção mínima, dois testes úteis e uma restrição cuidadosa ao que o trecho de código poderia provar |
| Notas de pesquisa contraditórias | 68,7 segundos | Aprovação com ressalvas: manteve a atribuição, calculou os dois cenários de concessão e recusou a aprovação até que o conflito de fontes fosse verificado |
| Plano desorganizado de uma semana | 50,6 segundos | Aprovação parcial: prazos mantidos, contradições, proprietários desconhecidos e cinco riscos, mas não transformou o trabalho em um cronograma diário claro |
Os valores de latência referem-se exclusivamente a esta rota e a estas solicitações. A tarefa de codificação sofreu inicialmente um tempo limite de gateway sem streaming e, em seguida, foi concluída com o streaming ativado. Trata-se de um aviso prático de implantação sobre o transporte e o gerenciamento de tempos limite, e não de uma pontuação geral de velocidade Grok 4,7.
Teste 1: Depuração de concorrência no TypeScript
Tarefa 1 — Depuração de concorrência no manipulador da API do TypeScript

Um pequeno manipulador do TypeScript retorna, de forma intermitente, um código de status HTTP 200 com um corpo vazio quando duas solicitações chegam em intervalos curtos.

Arquivos fornecidos:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

O sintoma em produção é intermitente apenas quando duas solicitações se sobrepõem. O carregador em si pode ser chamado simultaneamente com segurança e retorna uma carga útil diferente para cada solicitação. Não há outros arquivos disponíveis.

Retorne exatamente estas seções:
1. Causa raiz
2. O menor patch seguro (mostre um diff unificado)
3. Dois testes de regressão (código no estilo TypeScript ou Jest)
4. Suposições e limites
Não afirme ter executado o código.1. Causa principal
`current` é um estado no nível do módulo compartilhado por todas as chamadas. Em um ciclo de execução do JavaScript, a verificação de nulo e a atribuição são atômicas; portanto, duas chamadas sobrepostas não executam ambas o `load()`. A primeira chamada armazena sua promessa; uma segunda chamada que chega antes que essa promessa seja resolvida ignora seu próprio `load()` e aguarda a mesma promessa. O `handler`, então, retorna um HTTP 200 cujo `body` é a string da primeira chamada, e não a carga útil da segunda solicitação. Essa janela existe apenas enquanto uma chamada está em andamento; portanto, a falha só aparece quando as solicitações se sobrepõem.
`current = null` é executado em cada continuação depois que `await` já capturou a promessa. Isso não faz com que o outro aguardante releia a variável; portanto, esses arquivos por si só não resolvem esse aguardante como `null` ou `""`. O que eles realmente produzem na sobreposição é uma resolução compartilhada e um `load` por solicitação ignorado. A limpeza também torna o slot um cache inadequado para um único voo: a primeira continuação a ser retomada descarta `current`, e um chamador posterior pode iniciar um `load()` diferente enquanto outro chamador ainda está sendo desenrolado.
2. Menor correção segura (mostrar um diff unificado)
Cada solicitação deve chamar `load()` por conta própria. Chamadas simultâneas de `load()` são permitidas, e cada uma retorna uma carga útil diferente; portanto, a deduplicação em uma única promessa compartilhada não é segura. O arquivo `handler.ts` não precisa de alterações.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Dois testes de regressão (código no estilo TypeScript ou Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('solicitações sobrepostas em cada execução carregam e mantêm seu próprio corpo', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('uma carga sobreposta rejeitada não altera a outra resposta', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('falha no upstream'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('falha no upstream');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Suposições e limites
Não executei este código nem os testes. Os testes pressupõem um executador no estilo Jest e um arquivo em um diretório irmão de `src/` (por exemplo, `test/cache.test.ts`).
Tratei “carga diferente para cada solicitação” como um requisito de que chamadas sobrepostas de `getPayload` não devem compartilhar um único resultado de `load()`. Uma reescrita correta de execução única (`load().finally(() => { current = null; }); return current`) ainda acoplaria essas solicitações, por isso não a utilizei. Não há chave de cache presente, e nenhum requisito de deduplicação é declarado.
Um corpo HTTP literalmente vazio não é gravado pelas instruções mostradas se `load` retornar uma string não vazia. Se esse sintoma vier de um adaptador fora desses arquivos, ele não é visível aqui. O patch apenas remove o acoplamento de sobreposição que esses arquivos realmente implementam. Ele não adiciona bloqueio, novas tentativas ou um cache com chave.Grok 4.7 concluiu corretamente que, no nível do módulo, atual A promessa faz com que solicitações sobrepostas compartilhem um único resultado do carregador, mesmo que cada solicitação precise de sua própria carga útil. Foi proposta a menor alteração segura: remover a promessa compartilhada e chamar load() conforme solicitado. Os dois testes de regressão abrangeram cargas úteis simultâneas distintas e o isolamento quando um carregador rejeita. O ponto mais forte da resposta foi sua moderação: ela afirmou explicitamente que o código apresentado comprova o acoplamento entre solicitações, mas, por si só, não explica um corpo literalmente vazio se o carregador sempre retornar uma string não vazia.
Veredicto: Aprovação com nota alta em precisão da causa raiz, escopo da correção, cobertura de regressão e tratamento de incertezas.
Teste 2: Relatório de pesquisa com fontes conflitantes
Tarefa 2 — Conciliar notas de pesquisa conflitantes em um memorando de decisão.

Use apenas estas seis notas e mantenha o nome da fonte ao lado de cada afirmação factual:

- Fornecedor A, página de preços, 20/09/2026: O plano para equipes custa $40 por licença mensalmente e inclui 100.000 ações.
- Fornecedor B, postagem comparativa, 21/09/2026: O plano para equipes do Fornecedor A inclui 120.000 ações por licença mensalmente.
- Entrevista com cliente, 18/09/2026: Nossa equipe tem 8 licenças e utilizou 710.000 ações no mês passado.
- Planilha financeira, 19/09/2026: O teto orçamentário atual é de $360 por mês.
- Fornecedor A, página de limites, 20/09/2026: O excedente é cobrado a $0,004 por ação após a cota incluída.
- Nota de compras, 22/09/2026: A troca só é aceitável se o total mensal permanecer dentro do orçamento e a cota for verificada.

Retorne exatamente estas seções:
1. Fatos verificados
2. Alegações atribuídas
3. Tabela de conflitos
4. Cálculos independentes (calcule os cenários 8 x 100.000 e 8 x 120.000, além de qualquer excedente)
5. Recomendação
6. Apenas uma pergunta esclarecedora, caso o conflito altere a recomendação
Não resolva silenciosamente o conflito entre 100.000 e 120.000.
1. Fatos comprovados
- O plano Team custa $40 por licença por mês (Fornecedor A, página de preços, 20 de setembro de 2026).
- A equipe tem 8 licenças e utilizou 710.000 ações no mês passado (entrevista com o cliente, 18/09/2026).
- O teto orçamentário atual é de $360 por mês (planilha de finanças, 19/09/2026).
- O excedente é cobrado a $0,004 por ação após a cota incluída (Fornecedor A, página de limites, 20/09/2026).
- Uma mudança só é aceitável se o total mensal permanecer dentro do orçamento e a cota for verificada (Nota de compras, 22/09/2026).

2. Reivindicações atribuídas
- O pacote inclui 100.000 ações (Fornecedor A, página de preços, 20/09/2026). Essa nota não menciona explicitamente “por licença”.
- A equipe do Fornecedor A inclui 120.000 ações por licença mensalmente (Fornecedor B, postagem de comparação, 21/09/2026).

3. Tabela de conflitos
| Item | Alegação | Fonte | Status |
| --- | --- | --- | --- |
| Ações incluídas | 100.000 ações incluídas; “por licença” não está indicado | Fornecedor A, página de preços, 20/09/2026 | Não resolvido |
| Ações incluídas | 120.000 ações por licença mensalmente | Fornecedor B, postagem de comparação, 21/09/2026 | Não resolvido |

O conflito entre 100.000 e 120.000 não foi resolvido. Essas notas não indicam qual valor está correto.

4. Cálculos independentes
Custo básico por licença, o mesmo em ambos os cenários: 8 licenças (entrevista com o cliente, 18/09/2026) × $40 por licença mensal (Fornecedor A, página de preços, 20/09/2026) = $320 por mês.

Ambos os multiplicadores abaixo foram calculados conforme solicitado. Eles não constituem uma constatação de que o Fornecedor A tenha declarado um valor por assento.

- 8 × 100.000 = 800.000 ações incluídas, utilizando o valor de 100.000 (Fornecedor A, página de preços, 20/09/2026).
- O uso de 710.000 (entrevista com o cliente, 18/09/2026) está 90.000 abaixo de 800.000; portanto, ações excedentes = 0.
- Cobrança por excedente = 0 × $0,004 = $0 (Fornecedor A, página de limites, 20/09/2026).
- Total mensal = $320 + $0 = $320, o que está dentro do limite máximo de $360 (planilha de Finanças, 19/09/2026).

- 8 × 120.000 = 960.000 ações incluídas, utilizando o valor de 120.000 (Fornecedor B, postagem comparativa, 21/09/2026).
- O uso de 710.000 (entrevista com o cliente, 18/09/2026) está 250.000 abaixo de 960.000; portanto, ações excedentes = 0.
- Cobrança por excedente = 0 × $0,004 = $0 (Fornecedor A, página de limites, 20/09/2026).
- Total mensal = $320 + $0 = $320, o que está dentro do teto de $360 (planilha de finanças, 19/09/2026).

5. Recomendação
Não aprove a mudança ainda. De acordo com ambas as cotações calculadas, as 710.000 ações do mês passado (Entrevista com o cliente, 18/09/2026) não geram excedente e resultam em um total mensal de $320, que está dentro do limite máximo de $360 (planilha de Finanças, 19/09/2026). Esse resultado de custo não depende da escolha entre 100.000 ou 120.000. A mudança ainda não atende à segunda condição: a cota deve ser verificada (Nota de compras, 22/09/2026), e essas notas apresentam 100.000 (Fornecedor A, página de preços, 20/09/2026) em conflito com 120.000 (Fornecedor B, postagem comparativa, 21/09/2026).

6. Apenas uma pergunta de esclarecimento, caso o conflito altere a recomendação
Nenhuma pergunta de esclarecimento. O conflito entre 100.000 e 120.000 não altera a recomendação.
O pacote de pesquisa apresentava contradições deliberadas quanto ao fato de a cota ser de 100.000 ou 120.000 ações por assento. O Grok 4.7 manteve as duas fontes separadas, observou que a primeira fonte não mencionava explicitamente “por assento”, calculou os dois cenários de oito assentos e mostrou que ambos permaneceram no valor de $320, sem excedente para o uso fornecido. Ainda assim, recomendou a suspensão da aprovação, pois o departamento de compras exigia que a cota fosse verificada. Essa é a distinção correta entre uma recomendação numericamente estável e um fato contratual ainda não esclarecido.
Veredicto: Nota alta em atribuição, aritmética, gestão de conflitos e disciplina na tomada de decisões.
Teste 3: Anotações desorganizadas para o plano de execução
Tarefa 3 — Converta essas anotações desorganizadas do projeto em um plano de execução de uma semana com menos de 700 palavras.

Observações:
- Lançamento da página de destino na sexta-feira às 17h; o proprietário do produto menciona que será na quinta-feira de manhã em uma anotação posterior.
- Mina: redigir o título e a tabela de preços. Mina também informa que só poderá revisar o texto na quarta-feira à tarde.
- Arjun: eventos de análise; uma nota duplicada indica que o responsável pela análise ainda está a ser definido.
- O time de design tem duas tarefas duplicadas: “recorte do hero para celular” e “recorte final do hero para celular”.
- A revisão jurídica deve ocorrer antes de qualquer lançamento público.
- O controle de qualidade (QA) precisa de um dia inteiro após a disponibilização dos eventos de análise.
- Omar estará ausente na terça-feira à tarde.
- O e-mail de lançamento está agendado para sexta-feira às 16h.
- Desconhecido: quem é o responsável pela decisão final de seguir ou não adiante.

Requisitos: agrupar tarefas duplicadas, marcar responsáveis desconhecidos como “a definir”, preservar ambos os prazos rígidos, sinalizar contradições em vez de resolvê-las silenciosamente e encerrar com uma lista de cinco riscos.

Retorne exatamente estas seções:
1. Plano de uma semana
2. Contradições e incógnitas
3. Cinco riscos
Não invente responsáveis nem datas.
1. Plano semanal

Não há datas no calendário nas notas, portanto nenhuma é adicionada. São utilizadas apenas as referências e dependências indicadas. O trabalho de design duplicado é considerado uma única tarefa. Os responsáveis ainda não definidos permanecem como “A definir”. Os horários de lançamento conflitantes são mantidos.

- Texto: Mina redige o título e a tabela de preços. A revisão do texto por ela só ocorre na tarde de quarta-feira.
- Design: uma tarefa, recorte da imagem principal para dispositivos móveis, incluindo a revisão “final”. Nenhum responsável específico foi indicado.
- Eventos de análise: devem estar definidos antes do controle de qualidade. O responsável ainda não foi definido (Arjun em uma nota; a definir em outra).
- Controle de Qualidade (QA): um dia inteiro, somente após a disponibilização dos eventos de análise. Responsável a ser definido. Nenhum dia para o QA foi designado aqui.
- Revisão jurídica: necessária antes de qualquer lançamento público. Responsável a ser definido. Não está programada nas notas.
- Aprovação/rejeição: responsável a ser definido. Não é considerado como decidido.
- Marcos do lançamento público, ambos mantidos: quinta-feira de manhã (responsável pelo produto) e sexta-feira às 17h (página de destino).
- E-mail de lançamento: sexta-feira às 16h. Responsável a definir.
- Omar estará ausente na terça-feira à tarde. Nenhuma tarefa nessas notas está atribuída a Omar, portanto, nenhuma foi transferida.

Ordem, sem novas datas: o rascunho da Mina deve estar pronto para revisão na tarde de quarta-feira; o design conclui o recorte do hero único; os eventos de análise são entregues pelo responsável ainda não definido; o controle de qualidade (QA) tem então um dia inteiro; a revisão jurídica é concluída antes de qualquer lançamento público; a decisão de avançar ou não (a definir) ainda não tem responsável. Não descarte quinta-feira de manhã, sexta-feira às 17h ou sexta-feira às 16h.

2. Contradições e incógnitas

Contradições (não resolvidas):
- O lançamento da página de destino é na sexta-feira às 17h, e uma nota posterior do proprietário do produto indica quinta-feira de manhã.
- O responsável pela análise de dados é Arjun em uma nota e “a definir” em uma nota duplicada.

Incertezas, marcadas como “a definir”:
- Responsável final pela decisão de seguir adiante ou não.
- Responsável definitivo pela análise de dados.
- Responsável pela revisão jurídica.
- Responsável pelo controle de qualidade.
- Responsável pelo e-mail de lançamento.
- Responsável pelo design, além da menção genérica “Design”.
- Função de Omar; apenas a ausência na terça-feira à tarde está indicada.
- Qual horário de lançamento é o definitivo e se o e-mail de sexta-feira às 16h corresponde a algum desses horários. Não são fornecidas datas além desses horários dos dias da semana.

3. Cinco riscos

1. A manhã de quinta-feira e sexta-feira às 17h não podem ser ambas o horário de lançamento da página de destino; usar qualquer um deles sem uma decisão pode resultar em um lançamento antecipado ou no não cumprimento do outro prazo.
2. O e-mail de lançamento está marcado para sexta-feira às 16h, antes das 17h de sexta-feira e não está alinhado nas notas com a manhã de quinta-feira; portanto, pode ser enviado para uma página que ainda não está ou já não está no estado pretendido.
3. A responsabilidade pela análise de dados está em disputa, portanto, os eventos podem sofrer atrasos; O controle de qualidade (QA) ainda precisa de um dia inteiro após os eventos e pode não se encaixar antes de nenhum dos prazos de lançamento.
4. A revisão jurídica deve preceder qualquer lançamento público, mas não tem responsável nem horário definido, portanto, o lançamento pode ser bloqueado ou ocorrer sem a revisão.
5. Não foi designado nenhum responsável pela decisão de prosseguir ou não, portanto, nenhum dos prazos rígidos tem uma pessoa designada para aprovar ou interromper o lançamento.
A versão Grok 4.7 unificou a tarefa duplicada “mobile-hero”, manteve o conflito de lançamento na quinta-feira de manhã e na sexta-feira às 17h, preservou o prazo para envio de e-mail na sexta-feira às 16h, marcou os responsáveis não definidos como “A definir” e terminou com exatamente cinco riscos. Ela não inventou datas no calendário nem atribuiu responsáveis. O ponto fraco foi a exequibilidade: em vez de distribuir o trabalho em uma sequência de segunda a sexta-feira, ele retornou uma lista ordenada de dependências e informou que nenhum dia para controle de qualidade poderia ser designado. Essa cautela é justificável, mas a solicitação pedia um plano de execução de uma semana; portanto, a resposta atendeu apenas parcialmente ao formato solicitado.
Veredicto: Aprovação parcial: excelente preservação das restrições, menor utilidade no planejamento.
Preços do Grok 4.7 e acesso à API
É na questão dos preços que as análises de modelos costumam se tornar enganosas. Há pelo menos três valores diferentes que o leitor pode encontrar: o preço direto da API da xAI, o preço de rota de um agregador e o preço da assinatura para o consumidor. Eles não são intercambiáveis.
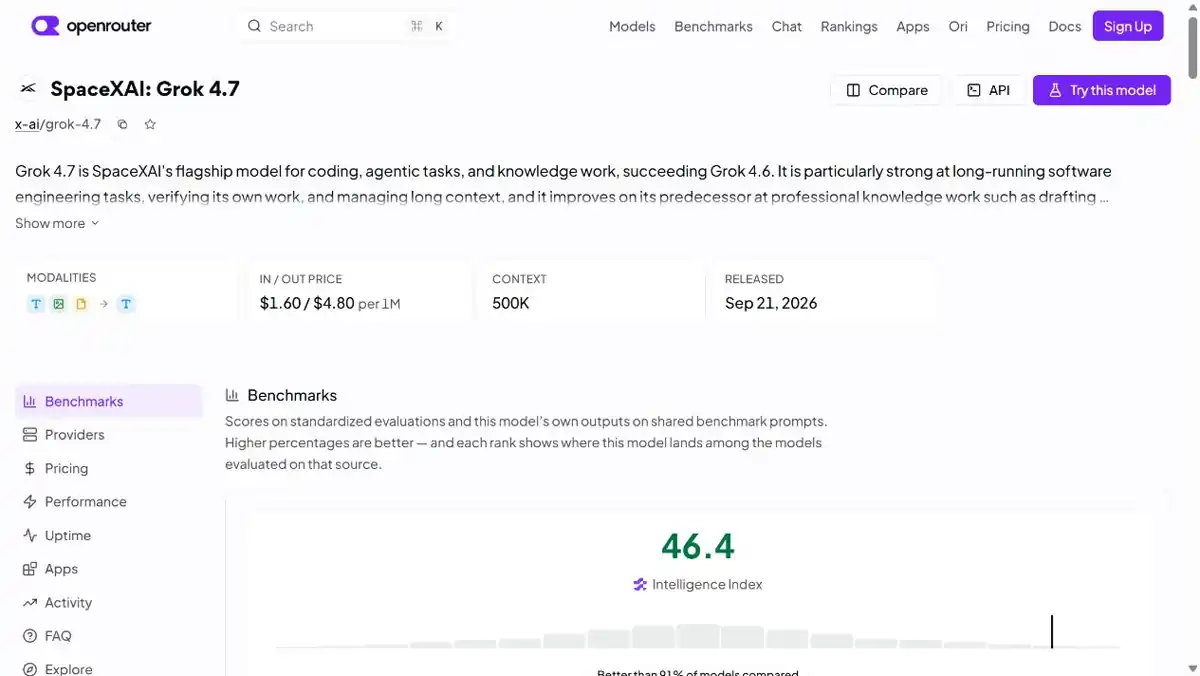
De acordo com o anúncio da xAI, o Grok 4.7 é oferecido pelo mesmo preço e com a mesma velocidade que o Grok 4.6. A página de lançamento informa que o modelo padrão custa a partir de $2 por 1 milhão de tokens de entrada e $6 por 1 milhão de tokens emitidos; A “Análise Artificial” apresenta, de forma independente, os mesmos números relativos à rota direta e $0,50 por 1 milhão de tokens de entrada armazenados em cache. A xAI também afirma que uma variante rápida dobra a velocidade de produção, mas custa o dobro do preço. Use o documentação oficial para desenvolvedores verifique o contrato de API atual e a disponibilidade específica da conta antes de enviar tráfego de produção.
Página 4.7 do Grok da OpenRouter mostra $1,60 por 1 milhão de tokens de entrada e $4,80 por 1 milhão de tokens gerados para sua rota. Esse é um preço do OpenRouter/provedor, não uma correção do preço de tabela direto da xAI. O roteamento, a margem de lucro, o armazenamento em cache, os limites e a disponibilidade podem variar de acordo com o provedor.
Não há uma resposta única e confiável para a pergunta “Quanto custa Grok 4,7?” sem especificar a rota. Para um comprador de API, compare:
- taxas de tokens de entrada e saída;
- tratamento de entrada em cache;
- limites de contexto e de saída;
- limites de tarifa e disponibilidade regional;
- se o provedor disponibiliza controles de raciocínio;
- termos relativos ao registro, à retenção e ao processamento de dados.
No que diz respeito ao acesso de consumidores, não presuma que o preço de uma API corresponda ao preço de uma assinatura do X ou do Grok. O plano do consumidor, a rota da API e o agregador de terceiros podem ter regras de acesso diferentes.
Como acessar o Grok 4.7
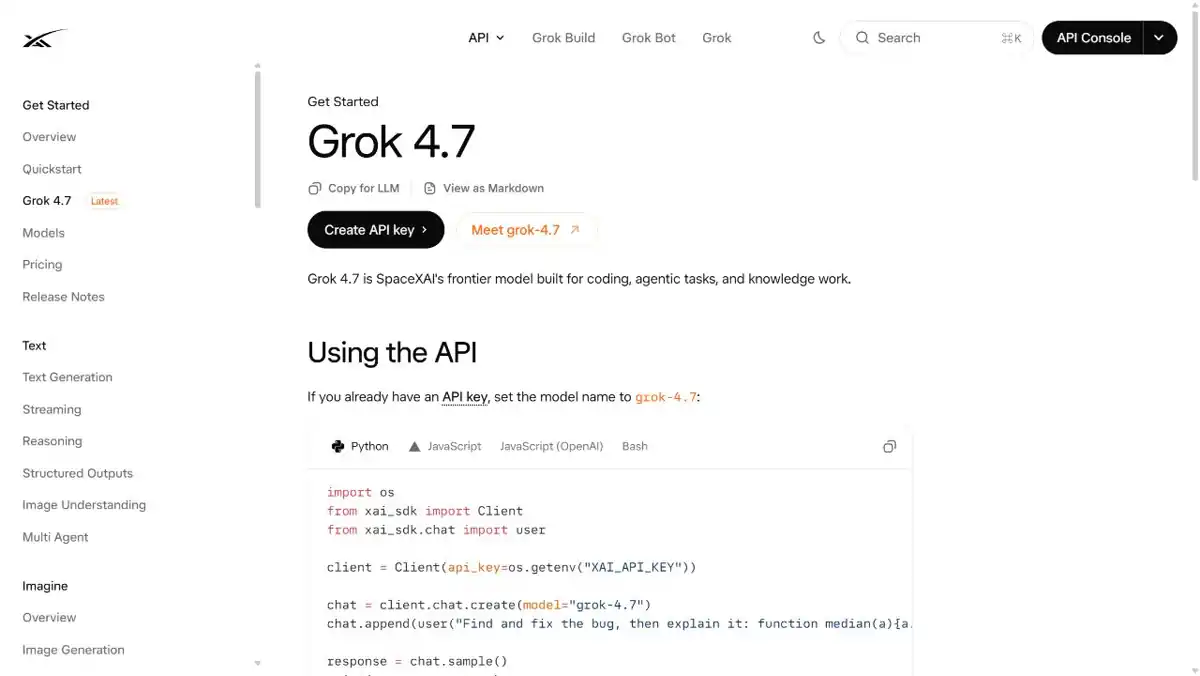
A maneira mais simples é começar com o Anúncio da xAI e Página do desenvolvedor do xAI, em seguida, confirme se você precisa do Grok Build, do Cursor, da API direta ou de um agregador. A xAI informa que o Grok 4.7 está disponível no Cursor e no Grok Build, por meio da API do Grok, bem como por meio de kits de codificação de terceiros, roteadores de modelos e plataformas em nuvem. Essa distinção determina o faturamento, os controles do modelo, os termos de privacidade e as ferramentas disponíveis.
Se você utilizar um agregador, abra a página do modelo e verifique a rota do provedor, os preços dos tokens, o limite de contexto e o identificador do modelo antes de desenvolver com base nele. O OpenRouter é uma rota documentada, mas seus preços não devem ser copiados para uma tabela de faturamento do xAI.
Para os leitores que desejam comparar várias famílias de modelos em uma única área de trabalho, O espaço de trabalho multimodelo do GlobalGPT pode ser útil para a avaliação comparativa de prompts. Este artigo faz não afirmam que a rota Grok 4.7 já está disponível nesse local. A disponibilidade da rota listada no catálogo é uma questão à parte e deve ser verificada na interface do produto antes da compra.
Grok 4,7 vs ChatGPT, Claude e Gemini
Esta análise inclui três resultados da tarefa Grok 4.7, mas não apresenta comparações com ChatGPT, Claude ou Gemini. Uma conclusão universal do tipo “o Grok 4.7 vence” continuaria sendo propaganda, e não uma análise. Uma escolha mais adequada depende dos trabalhos relacionados ao modelo:
| Se sua prioridade for... | Comece avaliando… | Por que |
|---|---|---|
| Pacotes técnicos longos | Grok 4.7 e outras rotas de grande contexto | Verifique a precisão da recuperação, e não apenas o intervalo anunciado |
| Depuração do repositório | Grok 4.7, um modelo voltado para a codificação, e seu ciclo de testes normal | Comparar a qualidade da análise da causa raiz e o tempo de revisão |
| Pesquisa com foco na fonte | Um fluxo de trabalho voltado para a pesquisa aliado a um modelo de raciocínio geral | Verifique as referências antes de aceitar as conclusões |
| Integrações de produtividade existentes | O modelo já está integrado às suas ferramentas | O custo de troca pode superar o ganho em relação ao índice de referência |
| Conta de API mais baixa | Rotas diretas e por agregadores lado a lado | Os preços variam de acordo com o provedor e o comportamento do cache |
O “Guia ”Por qual IA vale a pena pagar?” utiliza a pergunta certa na hora da compra: qual tarefa recorrente se torna suficientemente vantajosa para compensar o custo da assinatura ou da API? Essa é uma regra de decisão mais duradoura do que ficar atrás da mais recente novidade no ranking.
Limitações e questões em aberto
A versão Grok 4.7 é muito recente para que haja um amplo consenso independente. As evidências disponíveis deixam várias questões em aberto:
- Até que ponto a melhora é consistente nas tarefas de programação, pesquisa, redação e tarefas multimodais?
- O contexto de 500 mil continua confiável próximo ao limite, ou a recuperação se deteriora antes disso?
- Quanta latência adicional o maior esforço de raciocínio introduz?
- Quais planos de consumidor, regiões, ferramentas e limites de taxa expõem o modelo?
- Como as novas medidas de proteção se comportam em relação a trabalhos técnicos legítimos, porém confidenciais?
- O direct xAI, o OpenRouter e outros provedores apresentam resultados ou limites significativamente diferentes?
Essas questões não são motivos para descartar o modelo. Elas são o motivo para realizar uma avaliação pequena, mas representativa, antes de migrar um fluxo de trabalho ou prometer uma economia de custos.
Quem deve usar o Grok 4.7?
Vale a pena testar o Grok 4.7 primeiro se você:
- depurar código ou analisar material técnico por longos períodos;
- trabalhar com pacotes de código-fonte que excedam o tamanho das janelas de bate-papo comuns;
- valorizar um modelo que esteja disposto a dedicar mais esforço a um prompt complexo;
- pode revisar os resultados em vez de enviá-los diretamente para a produção;
- estão comparando a economia da API direta com a dos agregadores.
Essa opção não é a mais adequada se você precisar de uma integração madura, um plano de uso claramente documentado ou uma vantagem comprovada na execução da mesma tarefa em relação ao modelo que já está em sua pilha de tecnologias. Nesses casos, a camada de acesso e fluxo de trabalho pode ser mais importante do que um ganho de dois pontos no índice.
PERGUNTAS FREQUENTES
O que é o Grok 4.7?
O Grok 4.7 é a versão do modelo lançada pela xAI em 21 de setembro de 2026 para programação e trabalho de conhecimento. A xAI afirma que ele dedica mais tempo a tarefas complexas, verifica seu trabalho com mais cuidado e incorpora uma nova pilha de proteções, mantendo o mesmo preço e a mesma velocidade do Grok 4.6.
Quando foi lançado o Grok 4.7?
A xAI anunciou o Grok 4.7 em 21 de setembro de 2026. A página oficial de lançamento e a documentação para desenvolvedores são as melhores fontes de informação sobre o status do lançamento, a disponibilidade do modelo e as alterações na API.
O Grok 4.7 é melhor do que o Grok 4.6?
A Análise Artificial apresenta um Índice de Inteligência de 46, dois pontos acima do Grok 4.6, e um Elo de 1.657 no AA-Briefcase, 111 pontos acima do 4.6. Esses são sinais úteis, mas não constituem um resultado universal para todos os fluxos de trabalho.
O que é a janela de contexto do Grok 4.7?
A Análise Artificial indica uma janela de contexto de 500 mil tokens para o Grok 4.7. Uma janela grande não garante uma recuperação perfeita; portanto, teste o modelo com fatos posicionados em diferentes pontos de um documento longo antes de confiá-lo para trabalhos que exijam muitas fontes.
Quanto custa o Grok 4.7 API?
A Artificial Analysis indica que a rota direta da API tem um custo de $2 por 1 milhão de tokens de entrada e $6 por 1 milhão de tokens de saída, enquanto a entrada em cache custa $0,50 por 1 milhão de tokens. Verifique a documentação atualizada do xAI antes de utilizá-lo em produção.
O preço do Grok 4.7 da OpenRouter é o mesmo que o da xAI?
Não. O OpenRouter indica $1,60 por 1 milhão de tokens de entrada e $4,80 por 1 milhão de tokens de saída para sua rota. Esse é um preço específico do provedor e deve ser comparado separadamente dos preços diretos da API da xAI. O OpenRouter também exibe campos específicos do provedor, como cache, latência, taxa de transferência e privacidade, que podem alterar o custo prático de uma rota.
Como posso acessar o Grok 4.7?
Comece consultando o anúncio oficial da xAI e a documentação para desenvolvedores; em seguida, escolha o produto Grok para consumidores, a API direta da xAI ou um agregador, como o OpenRouter. Verifique o ID do modelo, a região, os limites de taxa, o contexto e o faturamento na rota que você realmente pretende usar.
A versão Grok 4.7 está disponível no GlobalGPT?
Esta análise não afirma que a rota Grok 4.7 tenha sido verificada no GlobalGPT. O GlobalGPT pode ser usado para comparar as famílias de modelos disponíveis, mas é recomendável verificar o catálogo atual e a disponibilidade exata dos modelos na interface do produto antes da compra.
Veredicto final
O Grok 4.7 parece ser uma atualização séria e incremental do modelo, com um objetivo claro: trabalho de programação e de conhecimento que recompense o esforço contínuo. O comunicado oficial oferece uma explicação plausível para a mudança; os primeiros dados da Artificial Analysis mostram uma melhora em relação ao Grok 4.6, em vez de um retrocesso; e nossa execução da API acrescenta um pequeno indício prático. O modelo lidou particularmente bem com um bug de concorrência e um memorando de fonte conflitante; sua resposta de planejamento foi cuidadosa, mas não tão operacional quanto solicitado.
O veredicto definitivo ainda é provisório. Foram três execuções isoladas em uma rota de teste; a tarefa mais lenta exigiu streaming após um tempo limite de gateway sem streaming; e não há nenhuma execução de concorrente comparável nem um consenso independente generalizado. Comece com uma tarefa difícil do seu fluxo de trabalho real, compare o resultado e o tempo de análise com o modelo que você já utiliza e, então, decida se a atualização vale o custo específico da rota.