
Claude Sonnet 5.5 x Opus 5.5: Preço, benchmarks e testes reais
O Sonnet 5.5 e o Opus 5.5 pertencem à geração Claude 5.5, mas têm preços e posicionamentos diferentes. Esta comparação submete ambos aos mesmos cinco comandos e relata o que a rota realmente retornou.
A diferença observada diz respeito, principalmente, ao custo e à rapidez. Neste pacote de cinco prompts, o Sonnet 5.5 concluiu a tarefa mais rapidamente, utilizou menos tokens de saída e apresentou a estimativa mais baixa de custo aritmético de solicitação. O Opus 5.5 utilizou mais tokens e tempo, enquanto suas respostas costumavam ser mais extensas. Os cartões de tarefa mostram em quais casos esse texto adicional alterou o resultado útil e em quais ambos os modelos simplesmente foram aprovados.
As instruções, o limite máximo de solicitações, a configuração de esforço, o ponto final e o projeto de uma execução por modelo foram mantidos alinhados com o anterior Análise do Claude Opus 5.5.
Resposta rápida
- Velocidade nesta corrida em dupla: O Sonnet 5.5 concluiu cinco solicitações consecutivas em 31,930 segundos localmente; o Opus 5.5 levou 47,725 segundos.
- Tokens de saída relatados pela rota: O Sonnet 5.5 utilizou 2.686; o Opus 5.5 utilizou 3.952. Os campos de reflexão foram 987 e 2.214, respectivamente.
- Estimativa aritmética do preço de tabela: os cinco pedidos do Sonnet totalizaram cerca de $0,02826; os cinco pedidos do Opus totalizaram cerca de $0,08184, utilizando as tarifas oficiais padrão por token e excluindo cache, créditos, impostos e margem de lucro.
- Resultado da tarefa: Ambos os modelos foram aprovados nas tarefas de extração, JSON e matemática. O Sonnet manteve o formato solicitado de dois parágrafos em chinês de maneira mais clara; os resultados de programação eram ambos utilizáveis, mas diferiam em profundidade e na explicação de casos extremos.
- Migração da API: O raciocínio não pode ser desativado; a escolha forçada de ferramentas é rejeitada, e os orçamentos de fichas incluem o raciocínio. Verifique o considerações sobre a migração antes de mudar.
- Limite de decisão: Trata-se de uma execução por tarefa por meio de uma rota de terceiros. Ela mede as respostas observadas ao prompt, o tempo real local e o uso relatado pela rota — não se trata de uma pontuação universal de capacidade.
Preço oficial e especificações do modelo
As fichas técnicas atuais do Anthropic listam ambos os modelos com uma janela de contexto de 1 milhão de tokens e uma saída máxima de 128 mil. O Sonnet 5.5 é identificado como Rápido com alto nível de esforço padrão; o Opus 5.5 é identificado como Moderado com um esforço padrão médio. As taxas padrão dos tokens fazem com que o Sonnet 5.5 tenha metade do preço de entrada e de saída do Opus 5.5.
| Modelo | ID da API | Indicação oficial de latência | Entrada / saída | Contexto / potência máxima | Esforço padrão | Leitura do cache |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-soneto-5-5 | Ativo · Rápido | $2 / $10 por MTok | 1M / 128K | Alto | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Ativo · Moderado | $4 / $20 por MTok | 1M / 128K | Médio | $0.20 / MTok |
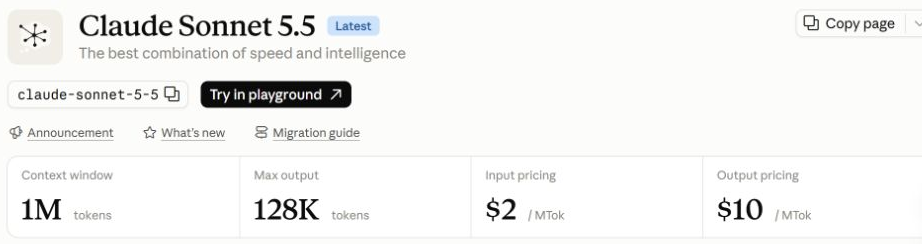
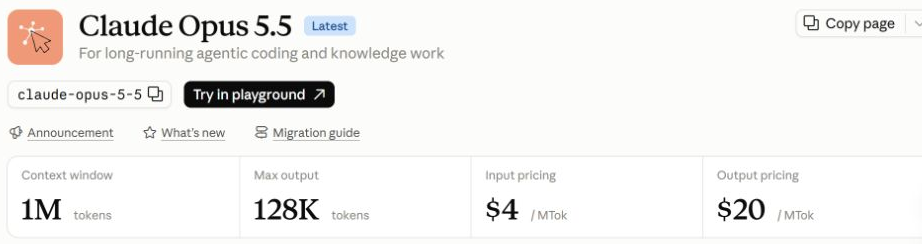
Para um exemplo simples, sem cache, com 100.000 tokens de entrada e 20.000 tokens de saída, as taxas de tokens listadas correspondem a cerca de $0,40 no Sonnet 5,5 e $0,80 no Opus 5,5. Consulte o Guia de preços e limites do Claude para o contexto do plano.
Contexto oficial da avaliação comparativa
Anthropic’s Anúncio Sonnet 5.5 coloca os dois modelos em uma única tabela fornecida pelo prestador. O padrão das linhas varia de acordo com o parâmetro de referência e a configuração de esforço.
| Índice de referência divulgado pela Anthropic | Sonnet 5.5 | Opus 5.5 | Medida |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,4%¹ | Codificação de terminal agênica |
| FrontierCode v1.1 (Principal) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Se as alterações no código seriam incorporadas |
| CursorBench 4.0 | 55.5% | 57.8% | Tarefas ambíguas de codificação de vários arquivos |
| GDPval-AA v2.1 | 1844 | 1846 | Trabalho do conhecimento em diversas profissões |
| O último exame da humanidade | 64,51 TP40T com ferramentas | 67,71 TP40T com ferramentas | Raciocínio multidisciplinar |
| OSWorld 2.1 | 80.1% parcial | 81,81 TP40T parcial | Tarefas que envolvem o uso do computador |
| Cartografia | 61,61 TP40T sem ferramentas | 64,41 TP40T sem ferramentas | Reconhecimento visual de gráficos |
¹ O Opus 5.5 Terminal-Bench utiliza o nível de esforço “xhigh”; ² O Sonnet 5.5 FrontierCode apresenta 46,2% no nível “Max” e 52,1% no nível de esforço “Xhigh”. Os valores do OSWorld estão marcados como parciais. Trata-se de um contexto específico do provedor, e não de uma repetição independente com esforço equivalente.
Método da API com o mesmo prompt
Cada modelo recebeu as mesmas cinco instruções por meio de POST https://anywhere.broly.ai/v1/messages. O cliente enviou uma mensagem ao usuário, max_tokens: 8192, output_config.effort: alto, e sem ferramentas. Todas as solicitações retornaram o código HTTP 200 e fim_do_turno.
A abordagem de testes segue o conceito mais amplo de Fluxo de trabalho de teste do modelo GlobalGPT. Um outro Guia da API Claude abrange a configuração de solicitações e a contabilidade de tokens.
Tempo, fichas e custo estimado
| Rota | Hora local das cinco | Tokens de entrada | Tokens de saída | Pensamento relatado | Custo estimado da solicitação* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Estimativa com base nos tokens relatados pela rota e nas taxas padrão oficiais. O Sonnet 5.5 apresentou uma redução de 33,1% no tempo decorrido local e de 32,0% na contagem de tokens de saída neste grupo.
Cinco cartões de tarefas correspondentes
Cada cartão reúne a tarefa, a observação, a hora local, os tokens de rota registrados, o status e os limites.
Os modelos são capazes de corrigir uma função de deduplicação de tipo misto?
Configuração da tarefa: A instrução exata foi copiada da versão anterior Análise do Claude Opus 5.5 pacote de teste.
| Modelo | Tempo / uso da rota | Rótulo de resultado curto |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 de entrada / 830 de saída 0 reflexão HTTP 200 · fim_do_turno | Função corrigida, além de dois exercícios; explicação mais sucinta. |
| Claude Opus 5,5 | 15,844 s 145 de entrada / 1.478 de saída 700 reflexões HTTP 200 · fim_do_turno | Função corrigida, além de dois testes; mais discussão sobre casos extremos. |
Comparação observada: Ambos retornaram uma função corrigida e dois testes. O Sonnet 5.5 utilizou chaves com marcação de tipo, casefold(), e uma alternativa em forma de lista em uma resposta mais curta; o Opus 5.5 utilizou mais tokens de saída para explicar casos extremos adicionais. Nenhuma das duas execuções indica um vencedor geral em termos de codificação.
Limite: Uma única pequena correção em Python verifica casos extremos específicos, e não a confiabilidade entre repositórios ou na codificação orientada por ferramentas.
Os modelos conseguem preservar os cinco fatos fornecidos sem acrescentar afirmações?
Configuração da tarefa: A instrução exata foi copiada da versão anterior Análise do Claude Opus 5.5 pacote de teste.
| Modelo | Tempo / uso da rota | Rótulo de resultado curto |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 de entrada / 209 de saída 0 reflexão HTTP 200 · fim_do_turno | Cinco marcadores numerados; os fatos apresentados foram mantidos. |
| Claude Opus 5,5 | 4,374 s 210 de entrada / 312 de saída 101 formas de pensar HTTP 200 · fim_do_turno | Cinco marcadores numerados; os fatos apresentados foram mantidos. |
Comparação observada: Ambos geraram exatamente cinco marcadores numerados e se mantiveram dentro dos fatos fornecidos. O Sonnet 5.5 utilizou 209 tokens de saída, contra os 312 do Opus 5.5, mas o prompt era uma nota curta, e não uma entrada com contexto amplo.
Limite: Trata-se de uma verificação fundamentada de extração e formatação; não constitui evidência de desempenho em contextos com milhões de tokens.
Os modelos conseguem retornar exatamente a estrutura solicitada?
Configuração da tarefa: A instrução exata foi copiada da versão anterior Análise do Claude Opus 5.5 pacote de teste.
| Modelo | Tempo / uso da rota | Rótulo de resultado curto |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 de entrada / 260 de saída 0 reflexão HTTP 200 · fim_do_turno | JSON analisável; chaves solicitadas e contagem de itens. |
| Claude Opus 5,5 | 8,276 s 128 de entrada / 622 de saída 390 reflexões HTTP 200 · fim_do_turno | JSON analisável; chaves solicitadas e contagem de itens. |
Comparação observada: Ambos retornaram um JSON analisável com as chaves solicitadas e duas vantagens e duas desvantagens. O Sonnet 5.5 foi mais conciso, com 260 tokens de saída; as sequências de caracteres descrevem uma situação fictícia de avaliação e não são informações sobre o produto.
Limite: A execução desse esquema uma única vez não permite avaliar a confiabilidade da saída estruturada em chamadas de ferramentas ou conversas longas.
Os modelos conseguem aplicar a sequência arredondada de lotes até a resposta final?
Configuração da tarefa: A instrução exata foi copiada da versão anterior Análise do Claude Opus 5.5 pacote de teste.
| Modelo | Tempo / uso da rota | Rótulo de resultado curto |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 de entrada / 163 de saída 0 reflexão HTTP 200 · fim_do_turno | Resultado correto: 67; a resposta final deve constar em uma linha separada. |
| Claude Opus 5,5 | 3,830 s 89 de entrada / 257 de saída 74 reflexões HTTP 200 · fim_do_turno | Resultado correto: 67; a resposta final deve constar em uma linha separada. |
Comparação observada: Ambos calcularam 67 e colocaram a resposta final em uma linha separada. O Sonnet 5.5 utilizou 163 tokens de saída, contra os 257 do Opus 5.5, sem que se observasse diferença na precisão nesse prompt.
Limite: Uma sequência aritmética por si só não é suficiente para avaliar a confiabilidade do raciocínio geral.
Será que o roteiro pode manter a estrutura solicitada de dois parágrafos?
Configuração da tarefa: A instrução exata foi copiada da versão anterior Análise do Claude Opus 5.5 pacote de teste.
| Modelo | Tempo / uso da rota | Rótulo de resultado curto |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 entradas / 1.224 saídas 987 reflexões HTTP 200 · fim_do_turno | Dois parágrafos em chinês; sem formatação adicional. |
| Claude Opus 5,5 | 15,401 s 128 entradas / 1.283 saídas 949 reflexões HTTP 200 · fim_do_turno | Abordei os pontos; adicionei Markdown e uma nota em inglês. |
Comparação observada: O Sonnet 5.5 entregou os dois parágrafos em chinês solicitados, sem formatação adicional. O Opus 5.5 também abordou os pontos solicitados, mas acrescentou formatação em Markdown e uma nota em inglês. Este registro reflete o formato seguido em uma única execução, e não a qualidade geral do texto em chinês.
Limite: A instrução pede uma introdução sobre o Opus 5.5; portanto, o texto em si não é um parâmetro de referência de linguagem neutra.
Considerações sobre API e migração
O Sonnet 5.5 executa o pensamento adaptativo por padrão; a opção “thinking: disabled” retorna um erro 400, e o parâmetro `max_tokens` abrange tanto o pensamento quanto o texto da resposta. A escolha forçada de ferramenta (`any/tool`) é rejeitada. Analise os blocos de conteúdo por tipo e redefina os limites de tokens antes de alternar.
O que as evidências indicam
Veredicto no nível da tarefa
Sonnet 5.5: custo e tempo medidos mais baixos nessa rota, com conformidade perfeita com o formato na tarefa chinesa.
Opus 5.5: mais caro e mais abrangente aqui; as séries de testes de desempenho oficiais continuam à frente em várias tarefas de duração indeterminada.
Use as evidências no nível da tarefa para escolher um ponto de partida e, em seguida,avalie a carga de trabalho que é importante para você.
Para o contexto adjacente, consulte o Comparação da família Claude, Resenha de Opus 5, e Análise do Fable 5.1.
PERGUNTAS FREQUENTES
Qual modelo foi mais rápido no teste comparativo?
O Sonnet 5.5 apresentou o menor tempo total local: 31,930 segundos contra 47,725 segundos do Opus 5.5 em cinco solicitações consecutivas. Isso inclui a rota e o caminho de rede utilizados neste caso, portanto, não se trata de latência do lado do provedor.
Qual modelo utilizou menos tokens de saída?
O Sonnet 5.5 utilizou 2.686 tokens de saída relatados pela rota nas cinco tarefas, em comparação com 3.952 do Opus 5.5. A contagem de tokens por si só não comprova a qualidade da resposta.
Qual modelo ficou mais barato nessa série de testes?
Utilizando as taxas oficiais padrão da API e as contagens de entrada/saída retornadas, as cinco solicitações Sonnet 5.5 totalizam $0,02826, contra $0,08184 para o Opus 5.5. O cálculo exclui encargos de cache, créditos de plataforma, impostos e margem de lucro.
O Sonnet 5.5 supera o Opus 5.5 em todos os testes de desempenho?
A tabela do Anthropic apresenta resultados variados de acordo com o benchmark e a configuração de esforço: O Sonnet 5.5 apresenta desempenho superior no Terminal-Bench 4.0, enquanto o Opus 5.5 apresenta desempenho superior no FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld e Chartography. Esses são resultados informados pelos fornecedores, não uma repetição independente dos testes.
A Sonnet 5.5 é um substituto direto da API?
Não. O guia de migração indica que o “thinking” é executado por padrão; a opção “thinking: disabled” retorna um erro 400; a escolha forçada de ferramenta “any/tool” é rejeitada; e os clientes devem analisar os blocos de conteúdo por tipo. Reajuste os orçamentos de tokens e os ciclos das ferramentas antes de fazer a mudança.
Esse foi um teste de desempenho em contexto extenso?
Não. A solicitação de extração contém um pequeno trecho. Ela verifica a fundamentação factual e a formatação exata; não avalia o comportamento próximo à janela de contexto documentada de 1 milhão de tokens.



