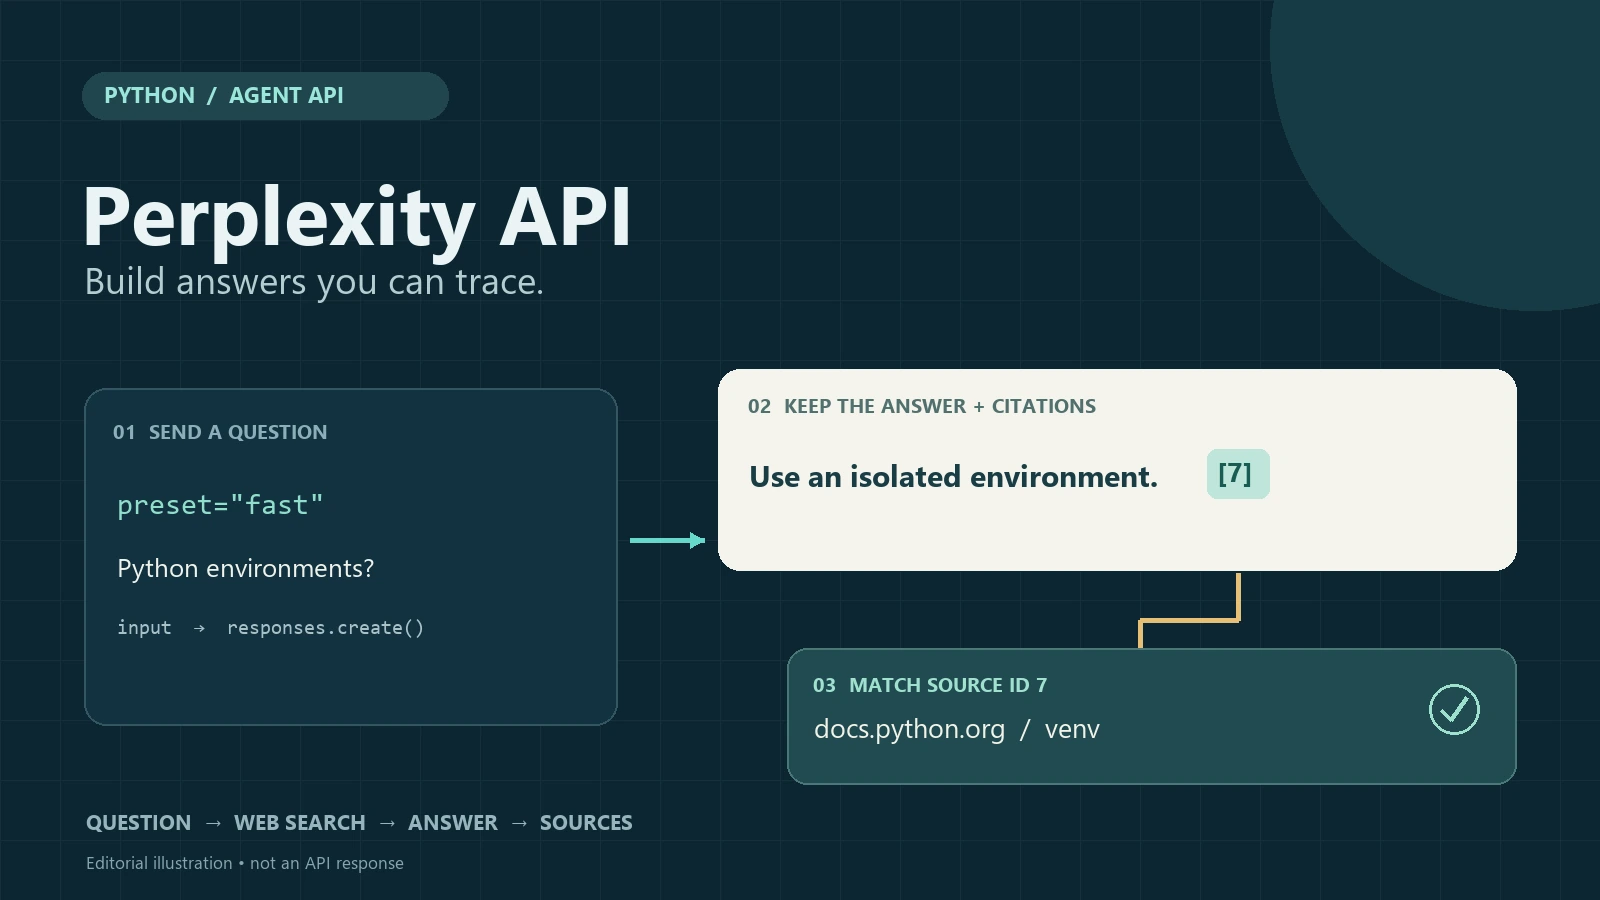
PERPLEXITY API · PYTHON-HANDLEIDING · 2026
In deze tutorial over de Perplexity API leer je hoe je een Python-script kunt maken dat een antwoord retourneert met aanklikbare webbronnen. Gebruik de Agent API om een vraag te versturen, het antwoord te lezen, de bronvermeldingen te koppelen aan bron-ID’s en een Markdown-bestand te exporteren dat je kunt bekijken.
We zullen één vraag steeds weer gebruiken: Hoe moet een klein Python-project gebruikmaken van virtuele omgevingen en afhankelijkheden beheren? Begin met een eenvoudig verzoek en voeg vervolgens bronanalyse en domeinfilters toe. Je hebt basiskennis van Python nodig en een Perplexity-ontwikkelaarsaccount waarbij API-facturering is ingesteld.
Als je AI ook gebruikt voor je dagelijkse onderzoek en schrijfwerk, Perplexity op GlobalGPT biedt toegang binnen één alles-in-één AI-werkruimte, waardoor je minder vaak tussen afzonderlijke tools hoeft te schakelen. Die workflow voor consumenten staat los van de ontwikkelaarsleutel en de API-facturering die hier worden gebruikt.
Snel antwoord: Gebruik de snel Voorinstelling van de agent voor een eerste, op het web gebaseerd antwoord, lees response.output_text voor het antwoord, en lees de zoekresultaten item in response.output voor bronnen. Koppel elke inline-markering aan een bron op basis van de geretourneerde waarde id. Een bronvermelding betekent dat “het antwoord naar dit resultaat verwijst”; het garandeert niet dat de pagina elke bewering bewijst.
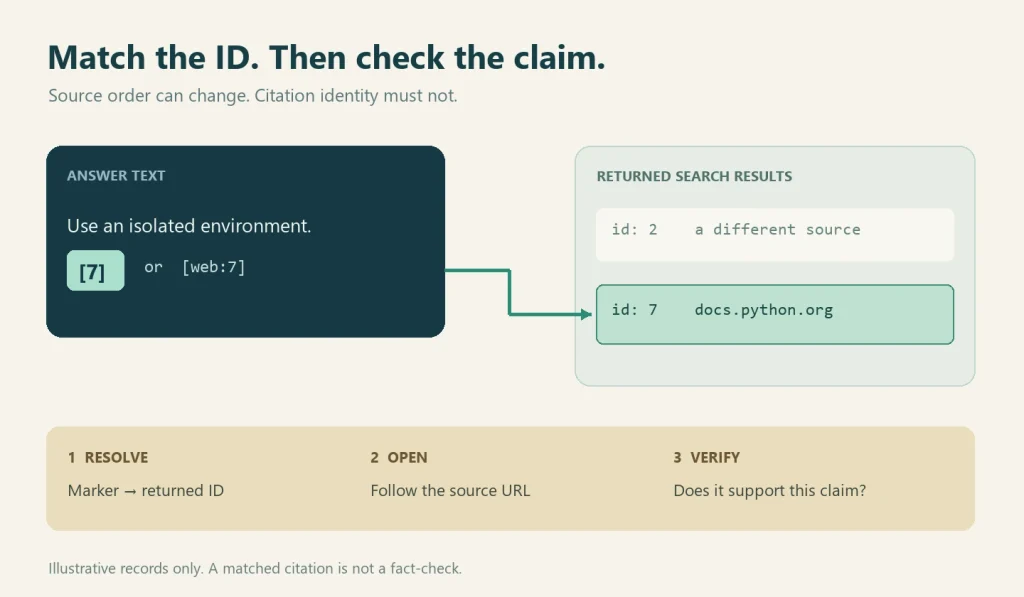
Voorbeeldstatus: De syntaxis van het verzoek is in overeenstemming met de officiële documentatie, gecontroleerd op 28 september 2026. De citatiehulp is getest met offline voorbeeldgegevens; voor deze tutorial is geen betaald API-verzoek uitgevoerd. De bronrecords in de afbeelding dienen ter verduidelijking.
- Welke Perplexity-API moet je gebruiken?
- Stap 1: Vraag een API-sleutel aan en installeer Python
- Stap 2: Dien je eerste verzoek met bron-aarding in
- Stap 3: Haal het antwoord eruit en koppel het aan de bronnen
- Stap 4: Verfijn het antwoord met zoekfilters
- Stap 5: Sla een volledig antwoord op met aanklikbare bronnen
- Streaming en gestructureerde uitvoer
- Kosten en veelvoorkomende fouten
- Doorgaan vanaf een oudere Sonar-handleiding
- Veelgestelde vragen
Perplexity API-handleiding: kies de juiste API
Dit zijn interfaces voor ontwikkelaars. Het chatproduct kan soortgelijke functies op een andere manier aanbieden; ons overzicht van Functies van Perplexity beschrijft de ervaring van de gebruiker.
De verwarring van officiële API-snelstartgids groepeert zijn ontwikkelaarsproducten op basis van de taak die je moet uitvoeren. Kies het kleinste oppervlak dat de gegevens oplevert die je applicatie daadwerkelijk nodig heeft.
| API | Beste pasvorm | Wat je code ontvangt |
|---|---|---|
| Agent | Een volledig antwoord op basis van zoekresultaten op het internet of andere hulpmiddelen | Getypte uitvoeritems, antwoordteksten en zoekresultaten |
| Zoek op | Uw applicatie zal de resultaten zelf rangschikken, filteren of samenvatten | Zoekresultaten zonder Perplexity te vragen het definitieve antwoord te geven |
| Router | Verzoeken doorsturen naar een geschikt model | Een modelantwoord dat via de router is geselecteerd |
| Inbeddingen | Semantisch zoeken en een RAG-index | Vectoren voor je eigen zoeklaag |
In deze tutorial wordt voor ‘Agent’ gekozen, omdat het gewenste resultaat een volledig antwoord plus de bronnen daarvan is. Voor de bredere onderzoeksworkflow kun je onze handleiding raadplegen over het gebruik van Perplexity voor onderzoek.
Over Sonar: De huidige overzicht van migratie vermeldt dat Sonar Chat Completions nog steeds wordt ondersteund en raadt Agent aan voor alle nieuwe projecten. In deze handleiding wordt daarom gebruikgemaakt van Agent. Trek uit een in een oudere handleiding genoemde deadline niet de conclusie dat een oude integratie niet meer werkt.
Stap 1: Vraag een API-sleutel aan en installeer Python
Maak de sleutel aan en regel de facturering
Open de Perplexity API-console, kies of maak het project aan dat je gaat gebruiken, stel de API-facturering in en maak een sleutel aan. Bewaar deze op de server. De ontwikkelaars-API’s worden apart gefactureerd, los van de consumentenabonnementen; controleer het saldo van je project voordat je verzoeken indient.
Installeer de officiële SDK
python -m venv .venv

# macOS/Linux: kies deze activeringsopdracht
source .venv/bin/activate

# Windows PowerShell: gebruik in plaats daarvan deze opdracht
.venv\Scripts\Activate.ps1

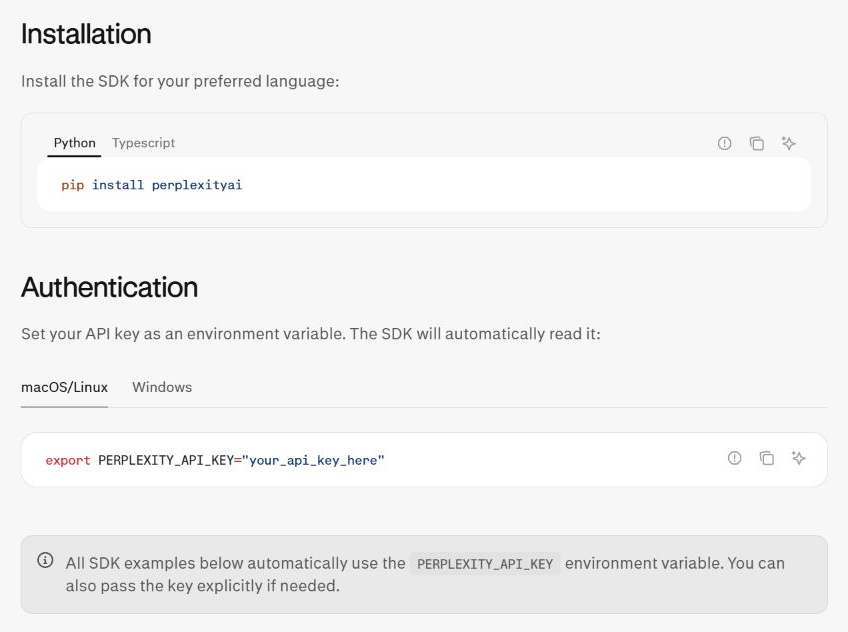
python -m pip install --upgrade perplexityai
Gebruik Python 3.10 of nieuwer voor de onderstaande code. Activeer de omgeving met de opdracht die bij jouw besturingssysteem hoort en installeer vervolgens de SDK. Als PowerShell de activering blokkeert, gebruik dan .venv\Scripts\python.exe in plaats van python voor de installatie en het uitvoeren van scripts.
De naam van het pakket is perplexityai, terwijl de Python-import als volgt luidt: verbijstering. Gebruik een virtuele omgeving, zodat de afhankelijkheden van deze tutorial geen invloed hebben op een ander project.
In dit voorbeeld wordt een vraag over codering gebruikt, omdat de beweringen daarin kunnen worden getoetst aan de bijgewerkte documentatie. Onze gids voor Perplexity voor codering legt uit hoe onderzoeksondersteuning zich verhoudt tot het zelf testen van code.
Stel de API-sleutel in als omgevingsvariabele
# macOS/Linux
export PERPLEXITY_API_KEY="je-sleutel-hier"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "je-sleutel-hier"
De SDK leest PERPLEXITEIT_API_SLEUTEL wanneer je de client aanmaakt. Plak de sleutel niet in een notitieboekje, voeg hem niet toe aan Git en stuur hem niet naar een browser. Als je lokaal een .env-bestand gebruikt, houd dat bestand dan buiten de versiebeheeromgeving en laad het met de door jou gekozen bibliotheek voor omgevingsvariabelen.
Stap 2: Dien je eerste verzoek met bron-aarding in
De snelstartgids voor de Agent API documenten POST-https://api.perplexity.ai/v1/agent. De Python-client verpakt het verzoek met client.responses.create(). De snel De standaardinstelling schakelt het zoeken op internet standaard in, waardoor het eerste voorbeeld kort blijft.
from perplexity import Perplexity

client = Perplexity()

question = (
    "Hoe moet een klein Python-project gebruikmaken van virtuele omgevingen "
    "en afhankelijkheden beheren?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
Sla het fragment op als first_request.py, voer vervolgens het volgende uit python first_request.py in dezelfde terminal waarin je de sleutel hebt ingesteld. Bij een geslaagde oproep zou er een niet-lege antwoordtekst moeten verschijnen. Als je bewijs nodig hebt voor het resultaat, ga dan verder met de stap voor het extraheren van de brontekst; tekst alleen is geen volledige controle.
De eigenschap ‘gemak’ uitvootekst geeft je de definitieve tekst van het antwoord. Bewaar ook het volledige antwoordobject: de bronrecords en gebruiksgegevens staan in de getypte uitvoer, niet alleen in de afgedrukte alinea.
Hetzelfde verzoek met cURL
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "Hoe moet een klein Python-project virtuele omgevingen gebruiken en afhankelijkheden beheren?"
  }'
In dit cURL-voorbeeld wordt de Bash-syntaxis gebruikt voor macOS/Linux of een Bash-compatibele shell. Bij elke uitvoering wordt er een nieuw factureerbaar verzoek verzonden. Gebruik dit alleen als je een probleem met een eindpunt wilt onderscheiden van een Python-probleem; voer niet elke versie uit alleen maar om het voorbeeld te volgen.
Equivalent in server-side JavaScript
Node.js 18+ bevat ophalen, dus voor een smoke-test aan de serverzijde is geen extra bibliotheek nodig. Lees de ruwe uitvoer items in het JSON-antwoord; de Python SDK biedt de handige uitvootekst accessoire.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "Hoe moet een klein Python-project virtuele omgevingen gebruiken en afhankelijkheden beheren?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
Stap 3: Haal het antwoord eruit en koppel het aan de bronnen
De officiële richtlijnen voor het vermelden van bronnen maakt een onderscheid tussen de proza-tekst en de bewijsstukken. Bronnen komen binnen in een uitvoer item met type zoekresultaten. Lees het artikel over resultaten en koppel elke bronvermelding aan het resultaat van de id. Een resultaat heeft een titel en een URL; zorg ervoor dat ontbrekende waarden worden verwerkt voordat het wordt weergegeven.
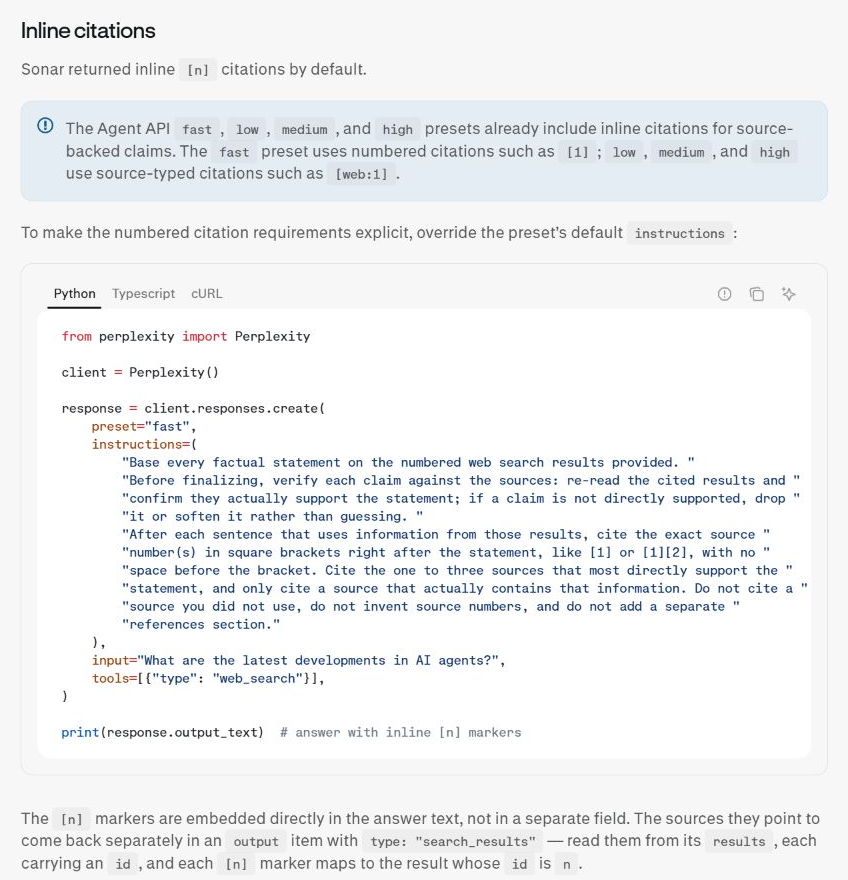
Dat laatste detail is belangrijk. Ga er niet zomaar vanuit dat “citation 1” altijd het eerste element in een array is nadat een andere tool een item heeft toegevoegd. Stel een opzoeklijst op basis van ID samen en bepaal vervolgens welke markeringen daadwerkelijk in het antwoord voorkomen.
def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"Conflicterende URL’s voor bron-ID {key}")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # Een bron-ID, niet positie 7 in de array
Het onderstaande volledige script herkent [1] en [web:1], de gedocumenteerde citatieformulieren voor de gangbare voorinstellingen. De bovenstaande hulpfunctie verwerkt zowel SDK-objecten als woordenboeken en weigert conflicterende URL’s die aan dezelfde ID zijn toegewezen. De functie hernummert de resultaten niet en raadt ook geen ontbrekende bron aan.
Voor een uitgebreidere bespreking van de kwaliteit van bronvermeldingen, zie onze Perplexity-handleiding voor nauwkeurigheid bij het citeren. Een bronvermelding is een controlespoor; je applicatie heeft nog steeds een beleid nodig voor verouderde pagina’s, dubbele URL’s en niet-onderbouwde beweringen.
Als de geretourneerde array bijvoorbeeld ID 2 gevolgd door ID 7 bevat, dan is de markering [7] moet naar ID 7 verwijzen. Als dezelfde URL onder ID’s 7 en 9 voorkomt, kun je die URL één keer weergeven met behoud van beide ID’s. Als ID 8 nooit verschijnt, behoud dan [8] zichtbaar maken en markeren als ‘niet-overeenkomend’.
Stap 4: Verfijn het antwoord met zoekfilters
Zodra de basiszoekopdracht werkt, kun je de zoekopdracht verfijnen als je vraag een duidelijke afbakening heeft. Voor het maken van Python-pakketten zijn de taaldocumentatie en de handleiding voor het maken van pakketten betere uitgangspunten dan een willekeurige tutorial.
response = client.responses.create(
    preset="fast",
    input=(
 "Hoe moet een klein Python-project gebruikmaken van virtuele omgevingen "
 "en afhankelijkheden beheren? Verwijs naar de richtlijnen die je gebruikt."
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
Het filter hoort thuis in de configuratie van de zoekfunctie op het web. In de documentatie over de migratie wordt ook beschreven zoekfilter_op_recente_resultaten voor vragen waarbij de actualiteit van belang is. Gebruik ‘recency’ wanneer de vraag afhankelijk is van recente publicaties of nieuws; bij een zeer beperkte combinatie van vakgebied en datum kan het zijn dat je te weinig bewijsmateriaal hebt.
Als je een vraag hebt over releases van de afgelopen maand, voeg dan toe: "search_recency_filter": "maand" naast zoekfilter_domein. Laat dit weg uit het voorbeeld met de virtuele omgeving: stabiele documentatie kan een oudere publicatiedatum hebben. Als je overschakelt van een vooraf ingesteld model naar een rechtstreeks geselecteerd model, neem dan expliciet de tool voor het zoeken op internet op.
Vergelijk tijdens de ontwikkeling de gefilterde en ongefilterde resultaten. Als het antwoord verandert, noteer dan waarom: een filter kan nuttige context verwijderen, of het kan pagina’s met een lage autoriteit verwijderen die het model afleidden. Dit is een kwaliteitsbeslissing, geen garantie dat elke overgebleven pagina correct is.
Als je applicatie alleen gerangschikte links en fragmenten nodig heeft, roep dan de Zoek-API en voer de synthese zelf uit. Die scheiding kan het controleren en in de cache opslaan vergemakkelijken. Zie voor een uitgebreidere vergelijking met Google waarin Perplexity verschilt van Google.
Stap 5: Sla een volledig antwoord op met aanklikbare bronnen
Sla het volgende op als perplexity_tutorial.py. Het is een op zichzelf staand programma: het bevat de bronhelper, past het Python-documentatiedomeinfilter toe, zet overeenkomende citatiemarkeringen om in links, groepeert dubbele URL’s zonder ID’s te verliezen en slaat het volledige SDK-antwoord samen met de Markdown op.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
 "Hoe moet een klein Python-project gebruikmaken van virtuele omgevingen"
 "en afhankelijkheden beheren?"
)
# Ondersteunt de gedocumenteerde [1] en [web:1]-vormen in proza-antwoorden.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
 return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
 sources = {}
 for item in output or []:
 if field(item, "type") != "search_results":
 continue
 for result in field(item, "results", []) or []:
 sid, url = field(result, "id"), field(result, "url")
 als sid None is:
 ga verder
 key = str(sid)
 als key in sources zit en field(sources[key], "url") != url is:
 raise ValueError(f"Conflicterende URL's voor bron-ID {key}")
 sources[key] = result
 return sources

def safe_url(value):
 if not isinstance(value, str):
 return None
 parsed = urlsplit(value)
 if parsed.scheme not in ("http", "https") or not parsed.netloc:
 return None
 # Bescherm een Markdown-bestemming tussen puntige haakjes.
 return value.replace("", "").replace(" ", "")

def md_label(value):
 return re.sub(r"([\\\[\]])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(antwoord, uitvoer, vraag=VRAAG):
 bronnen = source_index(uitvoer)
 geciteerd = list(dict.fromkeys(CITATION_RE.findall(antwoord)))
 missing = [
 sid for sid in cited
 if sid not in sources or not safe_url(field(sources[sid], "url"))
 ]
 def link(match):
 sid = match.group(1)
 url = safe_url(field(sources.get(sid, {}), "url"))
 return f"[{match.group(0)[1:-1]}]()" if url else match.group(0)

 # Bewaar elke ID wanneer dezelfde URL onder verschillende ID’s voorkomt.
 grouped = defaultdict(list)
 titles = {}
 for sid in cited:
 source = sources.get(sid, {})
 url = safe_url(field(source, "url"))
 if url:
 grouped[url].append(sid)
 titles.setdefault(url, field(source, "title") or url)

 lines = ["# Antwoord op basis van bronnen", "", vraag, "",
 CITATION_RE.sub(link, antwoord), "", "## Geciteerde bronnen", ""]
 for url, ids in grouped.items():
 lines.append(f"- IDs {', '.join(ids)}: [{md_label(titles[url])}]()")
 if missing:
 lines.append("- Niet-overeenkomende of onbruikbare bron-ID's: " + ", ".join(missing))
 if not cited:
 lines.append("- Geen herkende inline-bronvermeldingen; bewijs niet geverifieerd.")
 lines.extend(["", "Bronlinks moeten worden gecontroleerd; het matchen van ID's is geen bewijs voor de beweringen."])
 return "\n".join(regels) + "\n"

def main():
 from perplexity import Perplexity
 response = Perplexity().responses.create(
 preset="fast",
 input=QUESTION,
 tools=[{"type": "web_search", "filters": {
 "search_domain_filter": ["docs.python.org", "packaging.python.org"]
 }}],
 )
 answer = response.output_text or ""
 if not answer.strip():
 raise RuntimeError("Er is geen antwoordtekst geretourneerd; controleer de responsstatus en fouten.")
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 Path("perplexity-answer.md").write_text(
 export_markdown(answer, response.output), encoding="utf-8"
 )
 print("perplexity-answer.md en perplexity-response.json opgeslagen")

if __name__ == "__main__":
 main()
Uitvoeren python perplexity_tutorial.py vanuit je projectmap. Het schrijft perplexity-answer.md en perplexity-response.json daar, waarbij eerdere bestanden met die namen worden vervangen. Het Markdown-bestand bevat de vraag, het gekoppelde antwoord, de aangehaalde bronnen en eventuele niet-overeenkomende ID’s. Het JSON-bestand bewaart de geretourneerde uitvoer en het gebruik voor diagnostische doeleinden.
De parser is gericht op de gedocumenteerde vormen met één markering in proza. Het is geen volledige Markdown-parser: als je applicatie vraagt om willekeurige Markdown, codevoorbeelden of citaten zoals [1,2], voeg een syntaxisgevoelige renderer en tests voor dat formaat toe. Herinterpreteer onbekende markeringen niet zonder waarschuwing.
Controleer of de gelinkte pagina het antwoord ondersteunt
Controleer in dit voorbeeld of de aangehaalde documentatie daadwerkelijk uitleg geeft over het isoleren van de omgeving en het installeren van afhankelijkheden. Een link naar de Python-homepage is minder nuttig dan het relevante gedeelte van de documentatie. Als in een antwoord een specifieke opdracht wordt aanbevolen, controleer dan eerst het besturingssysteem en de Python-versie voordat je deze uitvoert. Mark beweert dat de aangehaalde tekst het probleem niet als ‘onopgelost’ bestempelt.
Voeg indien nodig streaming- of gestructureerde uitvoer toe
Streaming
Streaming vermindert de waargenomen vertraging bij een chatinterface. In de migratiehandleiding voor agenten worden tekstdelta-gebeurtenissen beschreven, zoals response.output_text.delta. Geef die delta's weer zodra ze binnenkomen, maar verzamel ook de definitieve antwoorditems, zodat je gebruikersinterface de bronnen kan weergeven zodra het antwoord compleet is. Een tekststroom op zich is nog geen bronnenlijst.
Het volgende is uitsluitend een tekstweergave. Bewaar de niet-streaming-export voor je eerste volledige bronrecord; bij een productie-implementatie met streaming moeten ook de tool-/uitvoergebeurtenissen worden verzameld en moet worden omgegaan met onderbroken of mislukte uitvoeringen.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
Gestructureerde uitvoer
Gebruik een gestructureerde respons wanneer code verderop velden nodig heeft zoals antwoord, confidence_note en vervolgvragen. Bewaar bron-ID's als een apart veld of behoud de oorspronkelijke uitvoer van Agent, zodat je schema de bewijzen niet verbergt. Controleer het schema aan de hand van je eigen testcases voordat je er in een workflow op vertrouwt.
De migratie-referentie blijft behouden response_format met type: "json_schema" voor gestructureerde uitvoer. Definieer verplichte velden en verbied waar nodig onverwachte eigenschappen. Schemavaliditeitscontroles hebben betrekking op de vorm, niet op de waarheid: bron-ID’s moeten nog steeds verwijzen naar daadwerkelijk geretourneerde records, en een door het model gegenereerd betrouwbaarheidslabel is geen maatstaf voor nauwkeurigheid.
Kosten en veelvoorkomende fouten bij de Perplexity API
De officiële prijspagina van Perplexity, geraadpleegd op 28 september 2026, maakt een onderscheid tussen tokens van het Agent-model en toolaanroepen. Hieronder volgen de USD-kosten voor tools en zoekopdrachten. De snel Vooraf ingestelde agent en search_type: "snel" dit zijn verschillende configuratieopties; leid de zoekfrequentie niet af uit de naam van de voorinstelling.
| Factureerbare handeling | USD per aandeel | USD per 1.000 |
|---|---|---|
| Standaardwebzoekopdracht via Agent | $0.0025 | $2.50 |
| Het aanroepen van Agent Fast Search | $0.001 | $1.00 |
| URL ophalen door agent | $0.0005 | $0.50 |
| Zoek-API: verzoek geslaagd | $0.005 | $5.00 |
| Zoek-API met Fast Search | $0.001 | $1.00 |
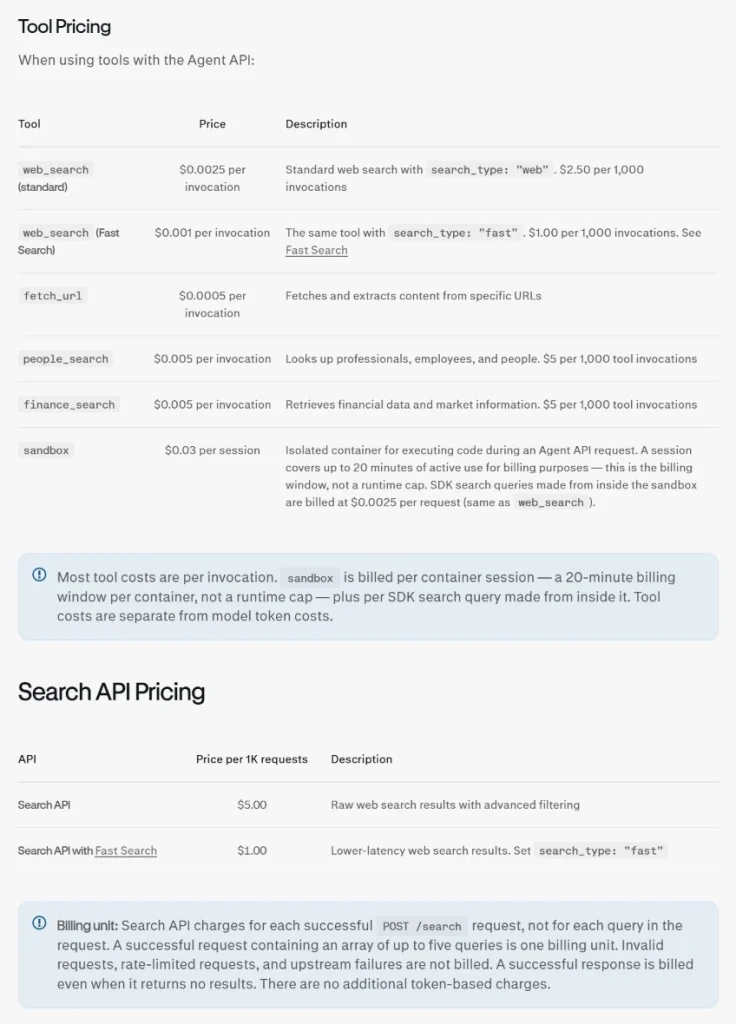
Voorbeeld: 1.000 standaard webzoekopdrachten plus 1.000 URL-opvragingen kosten $3.00 aan gereedschapskosten ($2.50 + $0.50), exclusief modeltokens of andere kosten. Dit is een geschatte werklast, geen gemeten kostprijs voor de tutorial. Eén enkel verzoek van een agent kan meerdere tools activeren. Controleer, indien beschikbaar, gebruik.kosten.totale_kosten op het ingevulde antwoordformulier.
| Symptoom | Wat moet je als eerste controleren? |
|---|---|
| 401 of 403 | De naam van de omgevingsvariabele, de geldigheid van de sleutel, de toegang tot het account en of het verzoek het huidige eindpunt bereikt. |
| Fout in de facturering of het quotum | API-tegoed, betalingsinstellingen, kosten voor modellen/tools en accountlimieten. Een Perplexity-abonnement voor consumenten houdt niet automatisch in dat er API-tegoed is. |
| 429 | Verzoeklimieten en herhalingsgedrag. Gebruik een begrensde exponentiële back-off en vermijd het blindelings herhalen van een verzoek waarvoor al is betaald. |
| Time-out | Instellingen voor netwerkpad, promptgrootte, aantal tools en time-out van de client. Registreer een verzoek-ID als de SDK er een verstrekt, maar registreer nooit de sleutel. |
| Het antwoord heeft geen overeenkomende bronnen | Controleer het ruwe materiaal response.output, de opmaak van bronvermeldingen en bron-ID’s; markeer het antwoord als ‘niet geverifieerd’ in plaats van links te verzinnen. |
De Search API brengt succesvolle verzoeken in rekening, ook als er geen resultaten worden geretourneerd; voor de prijs van het verzoek worden geen extra tokenkosten in rekening gebracht. De kosten voor agents zijn afhankelijk van modeltokens en tools. Houd deze factureringseenheden gescheiden wanneer je een workflow met antwoorden vergelijkt met een workflow die uitsluitend uit zoekopdrachten bestaat.
Voor een vergelijking van API-budgetten, onze Kostenoverzicht voor de Perplexity API geeft aanvullende informatie, terwijl de officiële prijspagina de maatstaf blijft voor de huidige tarieven.
Doorgaan vanaf een oudere Sonar-handleiding
Veel zoekresultaten tonen nog steeds de oudere weergave van ‘Chat Completions’. De migratiehandleiding voor agenten maakt gebruik van een directe conceptuele koppeling. Als je labels uit het consumentenmodel vergelijkt met API-voorinstellingen, kun je onze uitleg over wat LLM Perplexity gebruikt biedt achtergrondinformatie, maar is geen vervanging voor de documentatie van de Agent API.
| Ouder Sonar-patroon | Agent-API-patroon |
|---|---|
berichten | invoer |
model | vooraf ingesteld |
choices[0].message.content | uitvootekst |
| Oudere aannames met betrekking tot de citatenmatrix | zoekresultaten uitvoeritem en op ID gebaseerde koppeling |
| Zoekparameters in het verzoek | tools=[{"type":"web_search","filters":{...}}] |
Lees het liveverslag overzicht van migratie en migratiegegevens voordat u de productiecode wijzigt. De vooraf ingestelde toewijzingen vormen een uitgangspunt, maar zijn geen garantie dat oude en nieuwe modellen dezelfde kwaliteit, latentie of kosten opleveren.
Veelgestelde vragen
Is de Perplexity API gratis?
De API's worden per gebruik gefactureerd, conform de huidige quickstart- en prijsdocumentatie. Ga er niet vanuit dat een consumentenabonnement, een proefperiode of een promotietegoed ervoor zorgt dat elk API-verzoek gratis is.
Heb ik Perplexity Pro nodig om de API te gebruiken?
API-toegang en een Pro-abonnement voor consumenten zijn afzonderlijke producten. Maak API-inloggegevens aan en controleer de API-facturering voor het ontwikkelaarsaccount dat je van plan bent te gebruiken.
Moet ik de Agent API of de Search API gebruiken?
Kies ‘Agent’ als je een kant-en-klaar, onderbouwd antwoord met bronvermeldingen wilt. Kies ‘Search’ als je applicatie zelf moet zorgen voor rangschikking, filtering en synthese. Je kunt ‘Search’ combineren met je eigen model als je strikte controle wilt hebben over elke generatiestap.
Kan ik Perplexity vanuit JavaScript aanroepen?
Ja. Gebruik het bovenstaande Node.js-voorbeeld aan de serverzijde of de officiële JavaScript SDK. Bewaar de sleutel op de server. Controleer bij het inlezen van onbewerkte JSON de getypeerde uitvoeritems en pas dezelfde regels voor het toewijzen van bron-ID's toe.
Zijn Perplexity-verwijzingen gegarandeerd correct?
Nee. Een bronvermelding geeft aan op welk zoekresultaat het antwoord betrekking heeft. Je aanvraag of beoordelaar moet nog steeds controleren of de informatie actueel en betrouwbaar is en of de pagina de exacte bewering ondersteunt.
Waarom heeft mijn parser geen bronnen gevonden?
Controleer de typen van de ruwe uitvoer, ga na of de zoekopdracht op het web is uitgevoerd en kijk of je reguliere expressie overeenkomt met de citatievorm van de voorinstelling. Als er geen markering verschijnt, sla het antwoord dan op als ‘niet geverifieerd’ en onderzoek het verzoek in plaats van een link toe te voegen op basis van een gok.
Kan een GlobalGPT een Perplexity API-sleutel vervangen?
GlobalGPT is een alles-in-één AI-werkruimte voor dagelijks gebruik van AI. Het abonnement en de toegang tot modellen staan los van een Perplexity-ontwikkelaarsaccount, API-sleutel en API-tegoed; in deze Python-handleiding wordt gebruikgemaakt van het ontwikkelaarsaccount.
Een praktische checklist voor de lancering
- Maak een sleutel aan aan de serverzijde en bevestig de API-facturering.
- Voer de minimale versie uit
snelVraag dit aan voordat je filters toevoegt of gaat streamen. - Sla het volledige antwoord op, niet alleen de zichtbare tekst van het antwoord.
- Koppel de citatiemarkeringen aan de teruggevonden bron-ID’s en markeer de markeringen die niet overeenkomen.
- Controleer de aangehaalde pagina’s op onderbouwing van de beweringen, actualiteit en dubbele URL’s.
- Controleer nogmaals de documentatie over Live Agent, de prijzen en de migratie voordat u de oplossing implementeert.
Je beschikt nu over het basispatroon voor een betrouwbare Perplexity API-integratie: stel een gerichte vraag, laat de Agent API zoeken, houd het antwoord en het bewijsmateriaal bij elkaar en zorg ervoor dat elke bronvermelding controleerbaar is. Voeg hier vervolgens caching, herhalingspogingen en je eigen beoordelingsregels toe binnen dezelfde bron-ID-workflow.