Modelinformatie bijgewerkt op 26 september 2026.
Hoewel sommige gebruikers manieren hebben gevonden om de ChatGPT-filters tijdelijk te omzeilen, riskeren dergelijke methoden beleidsovertredingen, accountverboden en zelfs juridische gevolgen. Het is veel waardevoller om te begrijpen waarom deze filters bestaan, hoe ze zowel gebruikers als AI-systemen beschermen en hoe onderzoekers op verantwoorde wijze moderatielimieten kunnen testen.
Binnen het hedendaagse AI-ecosysteem, GlobalGPT biedt een uniform platform biedt toegang tot meer dan 100 krachtige AI-modellen, allemaal op één plek. Hierdoor kunnen ontwikkelaars en onderzoekers de prestaties en filtermechanismen van modellen vergelijken binnen een compliant kader, waardoor ze uitgebreidere inzichten krijgen.
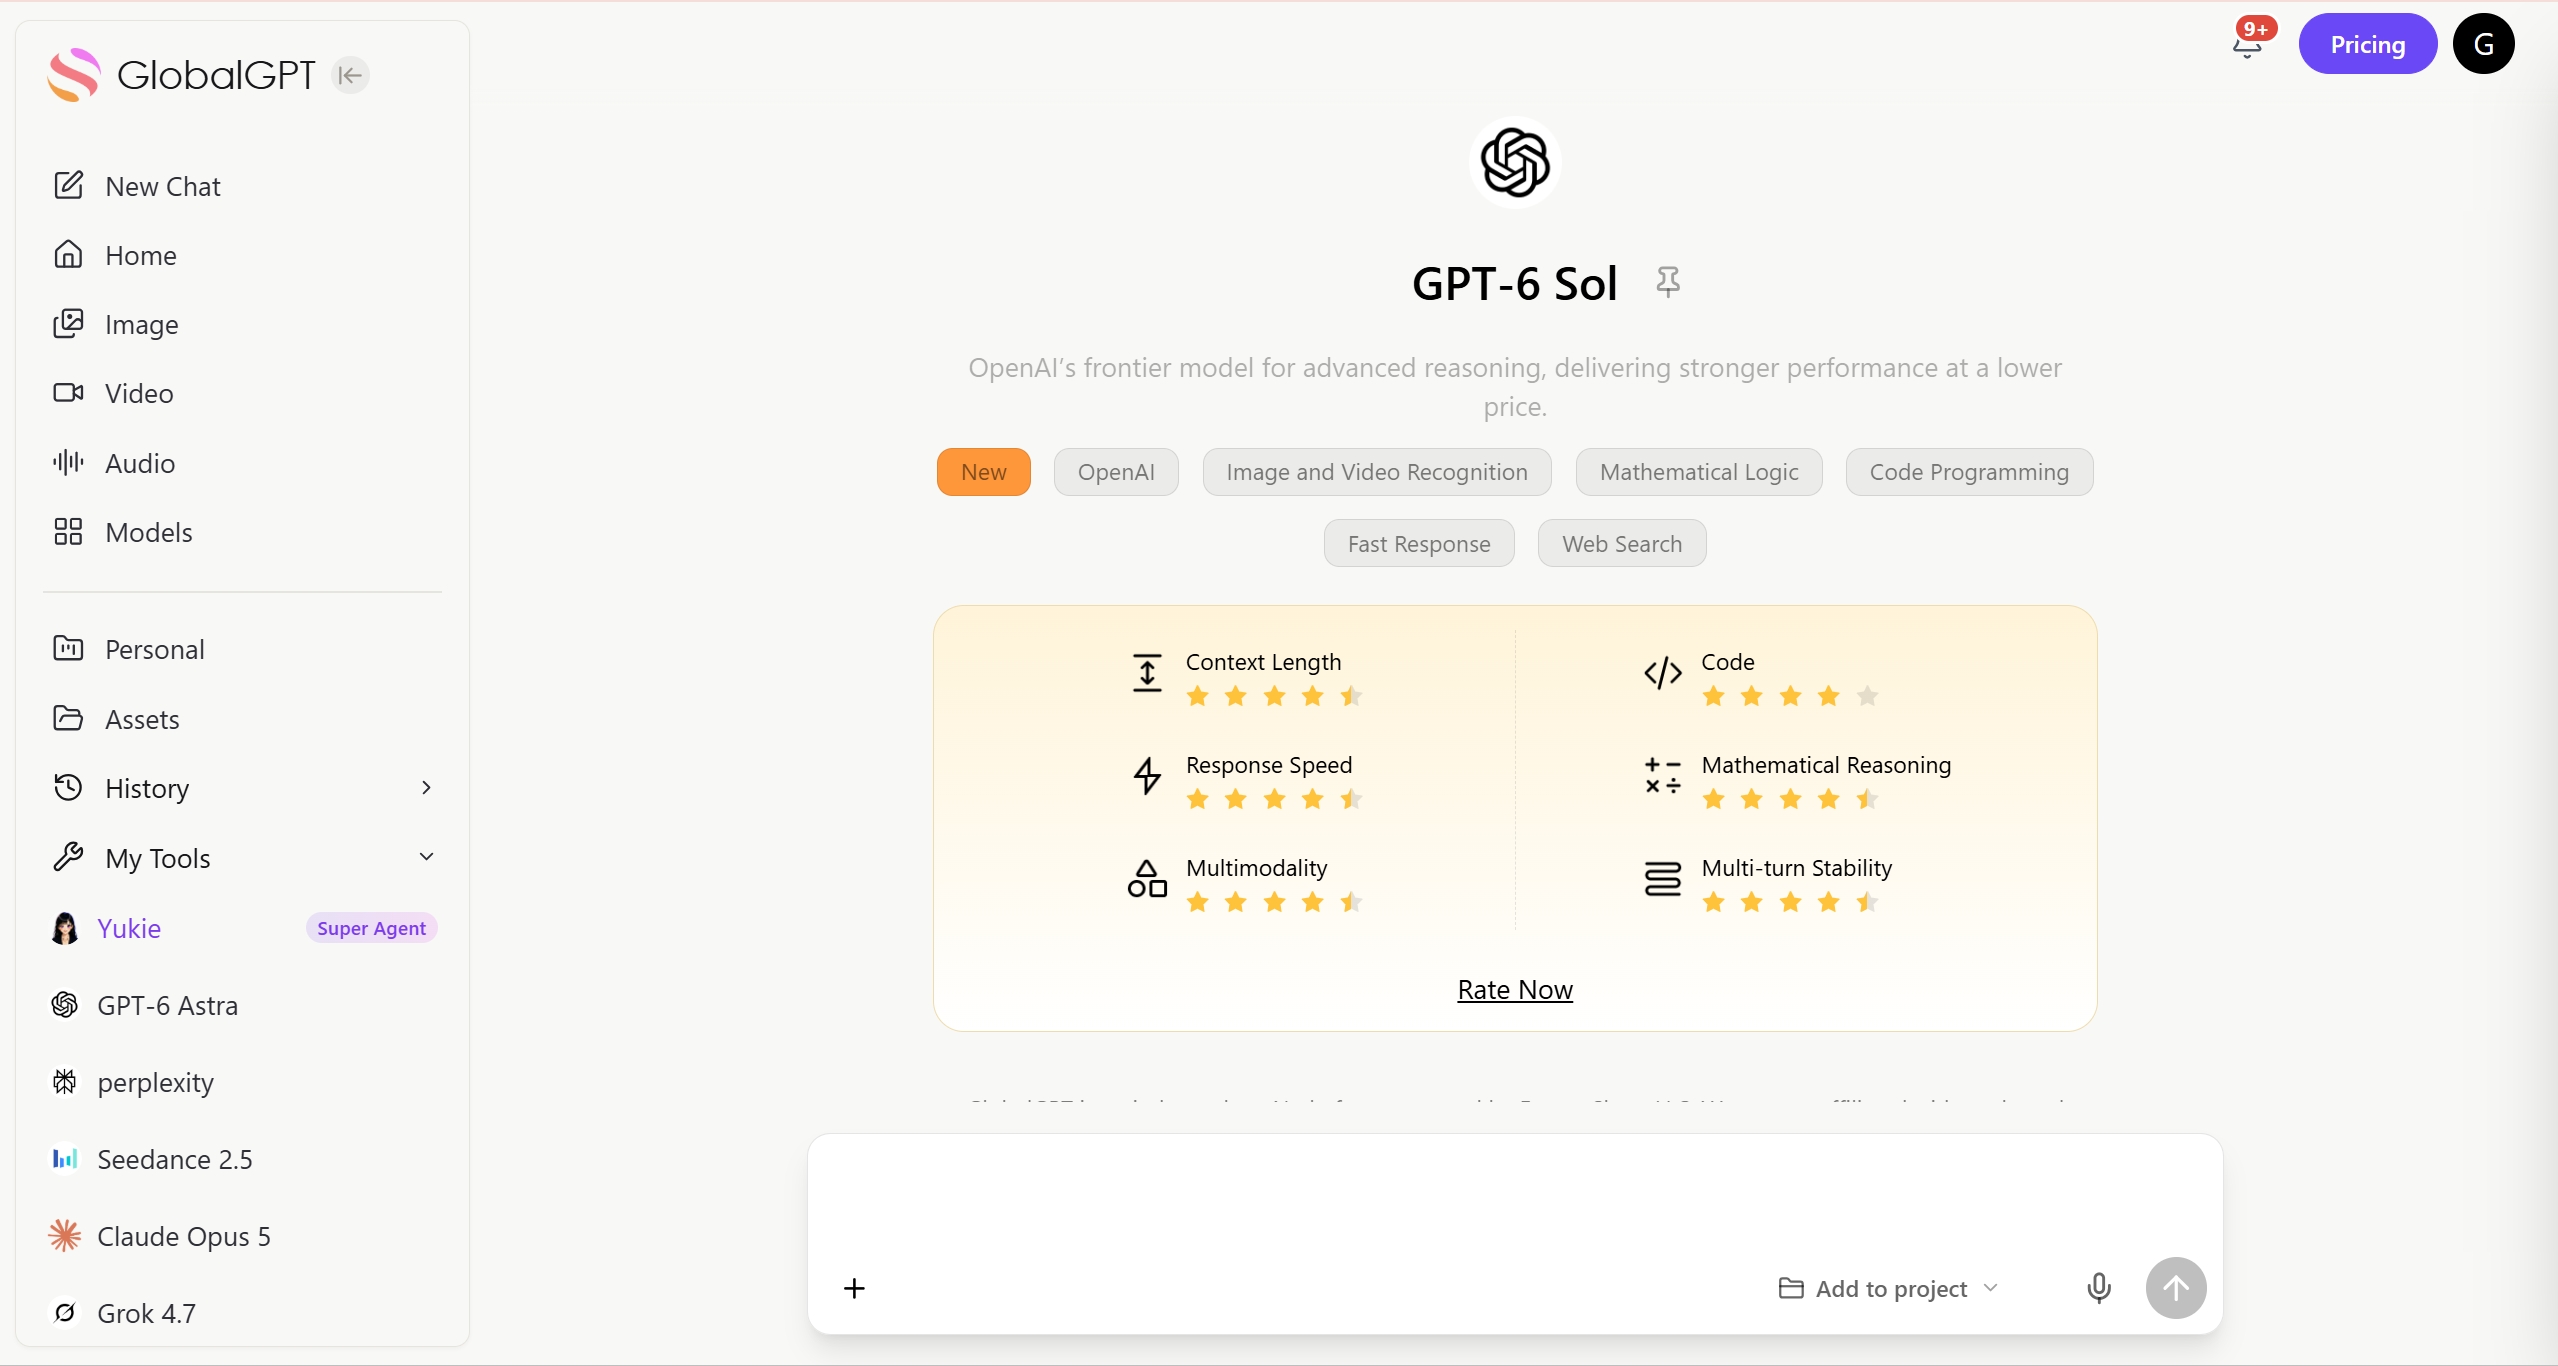
Alles-in-één AI-platform voor het genereren van teksten, afbeeldingen en video's met GPT-6 Sol, GPT-6 Astra, Nano Banana Pro en meer
- Wat zijn de filters, veiligheidssystemen en moderatielagen van ChatGPT?
- Welke inhoud blokkeert ChatGPT? - Filtertriggers en veiligheidsregels analyseren
- De opkomst van “Jailbreak Prompts”: Wat betekent omzeilen?
- Hoe ChatGPT's Moderatie Systeem werkt (Zonder Technische Exploits)
- Meest voorkomende “Bypass”-patronen (waargenomen, niet aangemoedigd)
- Ethische, juridische en accountrisico's van het omzeilen van ChatGPT-filters
- Verantwoorde manieren om de grenzen van ChatGPT te verkennen
- De schaal van gebruik en de uitdaging van moderatie
- Alternatieve hulpmiddelen en omgevingen voor veilige AI-experimenten
- Hoe platformen jailbreaks detecteren en patchen
- Verantwoorde innovatie boven uitbuiting
- Veelgestelde vragen
Wat zijn de filters, veiligheidssystemen en moderatielagen van ChatGPT?
AI-chatbots zoals ChatGPT vertrouwen op meerlaagse moderatie, ook bekend als “filters” of “vangrails”. Deze omvatten geautomatiseerde veiligheidscontroles, interne weigeringslogica op modelniveau, gebruikersrapportage en menselijke beleidsbeoordeling. Voor ontwikkelaars kan OpenAI's openbare Moderations endpoint potentieel schadelijke inhoud in tekst en afbeeldingen identificeren, met omni-moderatie-laatst ondersteunt multimodale input en bredere categorisatie dan het oudere tekst-only moderatiemodel.
Bijgewerkte vertrouwens- en transparantiegegevens
In de transparantiecijfers van OpenAI voor juli–december 2025 wordt een onderscheid gemaakt tussen het aantal meldingen dat naar het NCMEC is gestuurd en het aantal gemelde inhoudsstukken. Dit zijn verschillende maatstaven en mogen niet worden geïnterpreteerd als het huidige aantal gebruikers of het aantal unieke daders.
- Juli - december 2025: 107.817 CyberTipline-meldingen aan NCMEC.
- Juli - december 2025: In totaal 107.667 stuks inhoud gerapporteerd aan NCMEC.
Dit betekent niet dat de filters perfect zijn en het betekent ook niet dat elke geblokkeerde prompt gevaarlijk is. Het laat wel zien waarom platforms strenge regels hanteren voor de veiligheid van kinderen, seksuele inhoud met minderjarigen, kinderlokkerij, leeftijdsongeschikte inhoud voor minderjarigen en seksueel of gewelddadig rollenspel met minderjarigen.
Welke inhoud blokkeert ChatGPT? - Filtertriggers en veiligheidsregels analyseren
ChatGPT-filters zijn geen zwarte lijst met losse trefwoorden. Ze werken eerder als een gelaagd beveiligingssysteem dat de gebruiker beoordeelt intentie, het onderwerp, het waarschijnlijke risico en het soort uitvoer dat wordt gevraagd.
Voor ontwikkelaars kan een veiligheidsworkflow verschillende controles combineren. Dit is een algemeen ontwerppatroon, geen gedetailleerde specificatie van elk ChatGPT-verzoek:
- Geautomatiseerde inhoudscontroles kunnen risicocategorieën vaststellen; een trefwoord op zich is niet altijd de reden voor elke afwijzing.
- Contextuele en intentiegebaseerde analyse - Het systeem evalueert betekenis, toon en ethisch risico.
OpenAI's Gebruiksvoorwaarden schadelijk gebruik aan banden leggen. Het feit dat een onderwerp gevoelig is, betekent op zich nog niet dat het verzoek verboden is; het doel, de context en het gevraagde resultaat zijn van belang. Voorbeelden hiervan zijn:
- Illegale activiteiten en kwaadwillige of misbruikende cyberactiviteiten, waaronder het binnendringen in de systemen van anderen.
- Seksueel geweld, intieme beelden zonder toestemming en de seksualisering van minderjarigen; dit staat niet gelijk aan een algeheel verbod op elk expliciet woord.
- Bedreigingen, terrorisme en steun die geweld in de hand werkt; een educatieve bespreking van een historisch conflict is iets heel anders.
- Opzettelijke verspreiding van verkeerde informatie: Elke volledig verzonnen inhoud die is gemaakt om te misleiden of te manipuleren.
- Politieke campagnevoering, lobbyactiviteiten, inmenging in verkiezingen en activiteiten gericht op het ontmoedigen van kiezers. Dit betekent niet dat de meeste neutrale politieke kwesties categorisch worden geblokkeerd.

Maar omdat sommige van deze onderwerpen breed zijn, kun je de filters onbedoeld activeren. OpenAI verklaart zijn integriteits- en beveiligingsteams “Beleid, processen en tools voortdurend bewaken en optimaliseren om ze af te stemmen op veranderende beveiligingsstrategieën tijdens de globalisering van producten”.”
Deze voortdurende verfijning verklaart waarom onschadelijke queries af en toe worden afgewezen - fout-positieven zijn een inherente afweging in het beveiligingsontwerp.
Inhoudsveiligheid en auteurschapsdetectie zijn verschillende systemen; vergelijk de bespreking van ChatGPT-detectie en valse positieven.
Als een legitiem verzoek wordt afgewezen, geef dan duidelijker aan wat de daadwerkelijke opdracht, de doelgroep en de grenzen zijn. Vraag bijvoorbeeld om een neutrale samenvatting van een overheidsbeleid in plaats van overtuigende boodschappen gericht op een bepaalde kiezersgroep. Verwijder persoonlijke gegevens en meld een kennelijke fout via het feedback- of bezwaartraject van het product.
De opkomst van “Jailbreak Prompts”: Wat betekent omzeilen?
Gebruikers bespreken “jailbreaks” en persona-prompts op openbare forums. De effectiviteit hiervan verschilt per model en update; er is geen betrouwbare, algemene geldigheidsduur voor een omzeiling. Ook een wijziging in de bewoording maakt van een verboden gebruik nog geen toegestaan gebruik.

Het beleid van OpenAI verbiedt het omzeilen van beveiligingsmaatregelen en het uitvoeren van ongevraagde veiligheidstests. Legitiem onderzoek dient te voldoen aan het door de aanbieder goedgekeurde programma, de reikwijdte en de openbaarmakingsvereisten.
Hoe ChatGPT's Moderatie Systeem werkt (Zonder Technische Exploits)
Een ontwikkelaar kan een gelaagde applicatieworkflow ontwerpen, zoals:
- Invoercontroles die zijn afgestemd op de toepassing en het risico.
- Modelinstructies en weigeringsgedrag.
- Controles van de output, rapportage door gebruikers en, indien nodig, beoordeling door mensen.
OpenAI biedt een openbaar moderatie-eindpunt voor API-ontwikkelaars en beschrijft bredere geautomatiseerde en handmatige veiligheidsprocessen. Deze openbare tools garanderen niet dat elke invoer en uitvoer van ChatGPT een bepaalde interne API-reeks doorloopt.
De OpenAI-service van Microsoft Azure gebruikt een vergelijkbare architectuur.vier inhoudscategorieën (haat, seksueel, geweld, zelfbeschadiging) elk beoordeeld van “veilig” tot “hoog” ernst.
Deze producten beschikken over verschillende veiligheidscontroles. Vergelijk de gedocumenteerde instellingen en beleidsregels ervan, in plaats van ervan uit te gaan dat ze dezelfde interne moderatiearchitectuur hebben.
Meest voorkomende “Bypass”-patronen (waargenomen, niet aangemoedigd)
Waargenomen in gebruikersdiscussies-but niet aanbevolen:
- Rollenspel of persona-injectie - het model vertellen om “te handelen als een fictief personage”.”
In het oorspronkelijke voorbeeld dat hier is afgebeeld, werd één politieke vraag geweigerd en werd er wel een antwoord gegeven op een anders geformuleerde vraag. Die historische constatering betekent niet dat er een algemeen verbod op politieke standpunten geldt, noch bewijst het dat dit gedrag zich bij alle modellen en updates voordoet.

- Hypothetisch kader - vragen “wat als het legaal zou zijn in een ander universum”.”
- Anders formuleren of eufemismen - het maskeren van beperkte woorden.
- Verhaal of onderzoekscontext - gevoelige thema's in een verhaal verankeren.
Deze kortdurende exploits benadrukken creatieve prompt engineering, maar ethische en beleidsmatige risico's met zich meebrengen.
Ethische, juridische en accountrisico's van het omzeilen van ChatGPT-filters
Matiging omzeilen kan:
- Inbraak OpenAI’Gebruiksvoorwaarden en leiden tot accountbeëindiging.
- Trekker API intrekking van toegang voor commerciële ontwikkelaars.
- Gebruikers blootstellen aan juridische verantwoordelijkheid als de uitvoer lasterlijke of illegale inhoud bevat.
- Het vertrouwen in AI en ethische normen ondermijnen.
Verantwoord gebruik beschermt zowel individuen als het bredere ecosysteem.
Verantwoorde manieren om de grenzen van ChatGPT te verkennen
Ethische onderzoeksopties zijn onder andere:
- Aansluiten bij OpenAI red-teaming en bug-bounty-programma's.
- Testen binnen sandboxed of open-source LLM's (bijv. LLaMA of GPT-Neo).
- Vraag toestemming aan en stel een onschadelijke testomvang vast; het feit dat een verzoek als “onderwijsonderzoek” wordt aangemerkt, betekent op zich nog geen toestemming.
In het Global Affairs-rapport van OpenAI van juni 2025 staat dat zijn systemen “misbruik opgespoord, verstoord en onthuld, inclusief social engineering en geheime beïnvloedingsoperaties.” Dit toont verantwoordelijk toezicht in actie.
Voor standaardbedieningselementen voor aanwijzingen en feedback begin je met de ChatGPT-handleiding voor beginners.
De schaal van gebruik en de uitdaging van moderatie
- In het oorspronkelijke artikel werden 400 miljoen wekelijkse gebruikers en 2,5 miljard dagelijkse prompts genoemd als historische schaalcijfers; het gaat hierbij niet om een schatting van het huidige gebruik.
- Grootschalige diensten moeten een evenwicht vinden tussen handhaving van het beleid en zinvolle reacties; in het overheidsbeleid wordt geen universele screeningstijd per melding vermeld.
- Het enorme volume zorgt voor valse positieven en af en toe mazen in de wet, waardoor de belangstelling voor “bypass” toeneemt.
Inzicht in de schaal maakt duidelijk waarom matiging een van de moeilijkste problemen van AI blijft: het vinden van een balans tussen vrijheid, veiligheid en snelheid.
Alternatieve hulpmiddelen en omgevingen voor veilige AI-experimenten
Onderzoekers die op zoek zijn naar flexibiliteit kunnen:
- Implementeer zelf gehoste modellen met aangepaste filters.
- Gebruik Azure OpenAI of Anthropic sandboxes voor gecontroleerde tests.
- Microsoft bevestigt zijn filtercategorieën (haat, seks, geweld, zelfbeschadiging) bevatten elk vier ernstniveaus voor een gedetailleerde analyse. Met deze kaders kunnen ontwikkelaars de grenzen verkennen zonder de ethiek of voorwaarden te schenden.
Hoe platformen jailbreaks detecteren en patchen
OpenAI verbetert voortdurend de moderatie door:
- Geautomatiseerde telemetrie en patroonherkenning.
- Snelle modelupdates en regelafstelling.
- Rapporten van de gemeenschap en samenwerking tussen onderzoekers.
Deze iteratieve aanpak zorgt ervoor dat de meeste “bypass”-aanwijzingen uiteindelijk niet meer werken, waardoor ethische innovatie de enige duurzame weg is.
Verantwoorde innovatie boven uitbuiting
Hoewel “bypass”-trucs slim lijken, houden ze zelden stand en kunnen ze het hele ecosysteem schaden. De duurzame route is ethische innovatie: leren hoe moderatie werkt, veilig testen en samenwerken met AI-aanbieders om sterkere modellen te bouwen.
Door ons te richten op transparantie, verantwoordingsplicht en gebruikerseducatie bevorderen we AI op een verantwoorde manier en zetten we nieuwsgierigheid om in constructieve vooruitgang.
Veelgestelde vragen
Blokkeert ChatGPT elke politieke vraag?
Nee. Een neutrale uitleg is iets anders dan campagnevoeren, lobbyen of inmenging in verkiezingen. Het gaat om het gevraagde gebruik en de gevraagde output, niet alleen om de aanwezigheid van een politiek onderwerp.
Wat moet ik doen na een onterechte weigering?
Geef duidelijk aan wat het legitieme doel en de reikwijdte zijn, verwijder overbodige gevoelige gegevens en maak gebruik van de feedback- of bezwaarprocedure van het product. Probeer een verboden verzoek niet te verhullen.
Maakt de vermelding “voor onderzoek” een verzoek toegestaan?
Nee. Bij onderzoek moet nog steeds het beleid van de zorgverlener worden gevolgd en moet er toestemming voor het testen zijn. Een etiket op zich verandert niets aan het risico en houdt nog geen toestemming in.
Is de Moderations API hetzelfde als het interne systeem van ChatGPT?
Nee. Het is een openbaar hulpmiddel voor ontwikkelaars. Het bestaan ervan onthult niet de volledige reeks controles die door het ChatGPT-consumentenproduct wordt gebruikt.
Kan ik modellen vergelijken op GlobalGPT?
GlobalGPT biedt een werkruimte voor meerdere modellen waarin je resultaten kunt vergelijken. Houd vast aan dezelfde legitieme taak en beoordelingscriteria, en houd je aan de regels van de dienst die je gebruikt.