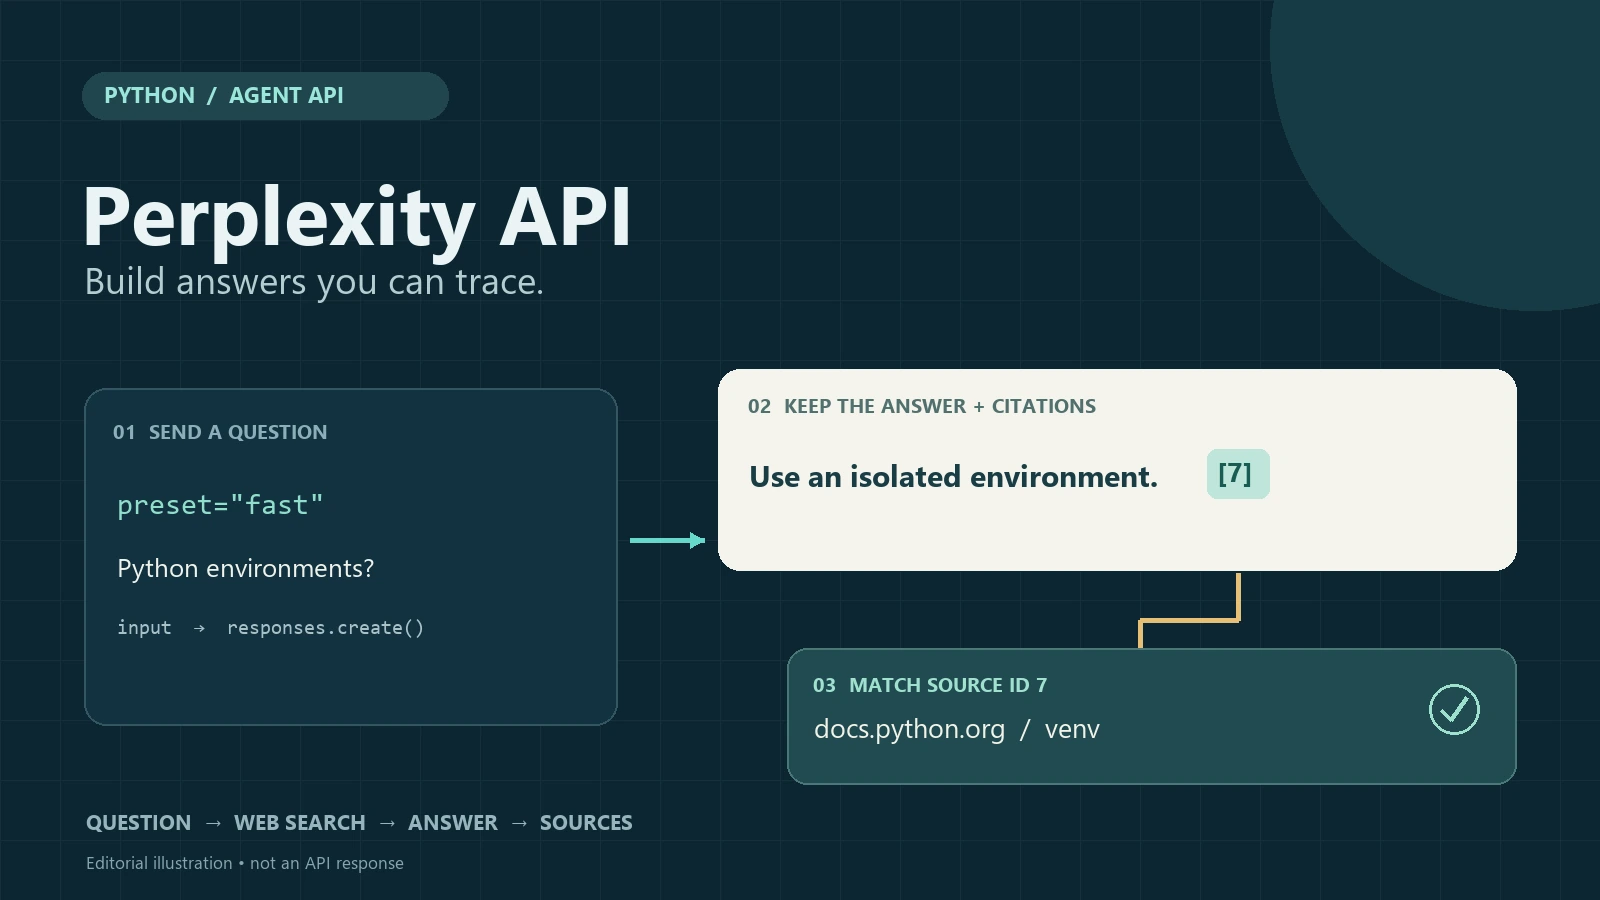
PERPLEXITY API · 파이썬 튜토리얼 · 2026
이 Perplexity API 튜토리얼에서는 클릭 가능한 웹 출처가 포함된 답변을 반환하는 Python 스크립트를 작성하는 방법을 설명합니다. Agent API를 사용하여 질문을 전송하고, 답변을 읽어들이며, 답변 내 인용 마커를 출처 ID와 매칭한 후, 검토할 수 있는 Markdown 파일을 내보내 보세요.
이 글에서는 한 가지 질문을 계속 다룰 것입니다: 소규모 파이썬 프로젝트에서는 가상 환경을 어떻게 활용하고 의존성을 관리해야 할까요? 기본 요청부터 시작한 다음, 소스 파싱과 도메인 필터를 추가하세요. 기본적인 파이썬 지식이 필요하며, API 과금이 설정된 Perplexity 개발자 계정이 있어야 합니다.
여러분도 일상적인 조사나 글쓰기에 AI를 활용하고 계신다면, Perplexity 대 GlobalGPT 올인원 AI 작업 공간 내에서 모든 기능을 이용할 수 있어, 별도의 도구 간을 오갈 필요가 줄어듭니다. 이 소비자용 워크플로는 여기서 사용되는 개발자 키 및 API 과금 시스템과는 별개입니다.
간단한 답변: 사용하십시오 빠른 웹 기반의 첫 번째 답변을 위한 에이전트 사전 설정, 읽기 response.output_text 답변을 확인하시고, 다음을 읽어보시기 바랍니다. 검색 결과 ~에 있는 항목 response.output 출처의 경우. 각 인라인 마커를 반환된 값을 기준으로 출처와 매칭합니다. id. 인용이란 “해당 답변이 이 결과를 가리킨다”는 의미일 뿐, 해당 페이지가 모든 주장을 입증한다는 것을 보장하는 것은 아닙니다.
상태 예시: 이 요청 구문은 2026년 9월 28일 확인된 공식 문서를 따릅니다. 인용 도우미는 오프라인 샘플 데이터를 사용하여 검증되었으며, 이 튜토리얼을 위해 유료 API 요청은 실행되지 않았습니다. 그림에 표시된 소스 레코드는 설명을 위한 예시입니다.
- 어떤 Perplexity API를 사용해야 할까요?
- 1단계: API 키를 발급받고 Python을 설정합니다.
- 2단계: 첫 번째 소스 접지 요청 보내기
- 3단계: 답을 추출하고 그 출처를 확인하세요
- 4단계: 검색 필터를 활용하여 답변의 정확도를 높이기
- 5단계: 클릭 가능한 출처가 포함된 완전한 답변 저장하기
- 스트리밍 및 구조화된 출력
- 비용 및 흔히 발생하는 오류
- 구버전 Sonar 튜토리얼에서 넘어오며
- 자주 묻는 질문
Perplexity API 튜토리얼: 적합한 API 선택하기
이것들은 개발자용 인터페이스입니다. 채팅 제품에서는 유사한 기능을 다른 방식으로 구현할 수 있습니다. 당사의 개요에 따르면 Perplexity의 주요 기능 사용자가 직접 경험하는 내용을 설명합니다.
Perplexity의 공식 API 빠른 시작 가이드 개발자용 제품을 수행해야 할 작업별로 분류합니다. 애플리케이션에 실제로 필요한 데이터를 생성하는 가장 작은 표면을 선택하십시오.
| API | 가장 적합 | 코드가 수신하는 내용 |
|---|---|---|
| 에이전트 | 웹 검색이나 기타 도구를 바탕으로 작성된 완성된 답변 | 입력된 출력 항목, 답변 텍스트 및 검색 결과 기록 |
| 검색 | 신청서를 제출하면 결과가 자동으로 순위가 매겨지거나, 필터링되거나, 요약됩니다. | Perplexity에게 정답을 직접 작성해 달라고 요청하지 않고 얻은 검색 결과 |
| 라우터 | 요청을 적절한 모델로 전달 | 라우터를 통해 선택된 모범 답안 |
| 임베딩 | 의미 기반 검색과 RAG 인덱스 | 사용자 정의 검색 레이어를 위한 벡터 데이터 |
이 튜토리얼에서는 사용자가 원하는 결과가 완성된 답변과 그 출처이므로 ‘Agent’를 선택합니다. 보다 포괄적인 연구 워크플로우에 대해서는 다음 가이드를 참조하십시오. 연구 목적으로 Perplexity 활용.
Sonar 소개: 현재 마이그레이션 개요 Sonar Chat Completions는 계속 지원된다고 밝히고 있으며, 모든 신규 프로젝트에는 Agent를 사용할 것을 권장합니다. 따라서 이 튜토리얼에서는 Agent를 사용합니다. 이전 튜토리얼에 언급된 기한을 근거로 기존 통합 기능이 더 이상 작동하지 않는다고 추측하지 마십시오.
1단계: API 키를 발급받고 Python을 설정합니다.
키 생성 및 청구 준비
Perplexity API 콘솔을 엽니다., 사용할 프로젝트를 선택하거나 생성하고, API 결제 설정을 구성한 다음 키를 생성하세요. 키는 서버 측에 보관하세요. 개발자용 API 요금은 소비자용 구독 요금과 별도로 청구되므로, 요청을 보내기 전에 프로젝트 잔액을 확인하세요.
공식 SDK 설치하기
python -m venv .venv

# macOS/Linux: 이 활성화 명령어를 선택하세요
source .venv/bin/activate

# Windows PowerShell: 대신 이 명령어를 사용하세요
.venv\Scripts\Activate.ps1

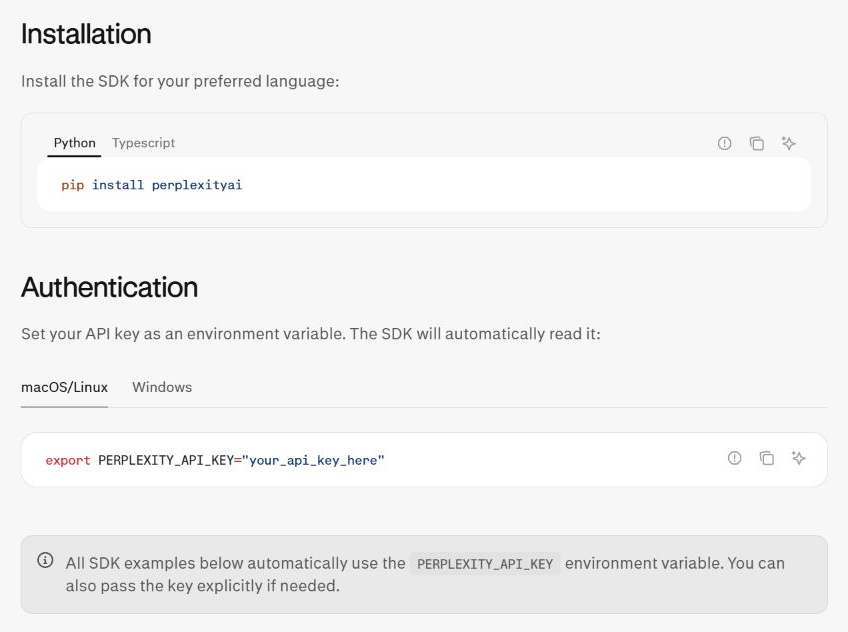
python -m pip install --upgrade perplexityai
아래 코드를 실행하려면 Python 3.10 이상을 사용하십시오. 사용 중인 운영 체제에 맞는 명령어를 사용하여 환경을 활성화한 다음, SDK를 설치하십시오. PowerShell에서 환경 활성화가 차단되는 경우, 다음을 사용하십시오. .venv\Scripts\python.exe ~ 대신 파이썬 설치 및 스크립트 실행을 위해.
패키지 이름은 perplexityai, 반면 파이썬의 import 문은 당황스러움. 이 튜토리얼의 종속성이 다른 프로젝트에 영향을 미치지 않도록 가상 환경을 사용하세요.
이 예시에서는 코딩 관련 문제를 다루고 있는데, 이는 해당 주장을 꾸준히 관리되는 문서를 통해 확인할 수 있기 때문입니다. 당사의 가이드에 따르면 코딩용 Perplexity 연구 지원이 직접 코드를 테스트하는 과정과 어떻게 조화를 이루는지 설명합니다.
API 키를 환경 변수로 설정하세요
# macOS/Linux
export PERPLEXITY_API_KEY="여기에 키 입력"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "여기에 키 입력"
SDK는 다음과 같이 읽습니다. PERPLEXITY_API_KEY 클라이언트를 생성할 때입니다. 키를 메모장에 붙여넣거나, Git에 커밋하거나, 브라우저로 전송하지 마십시오. 로컬에서 .env 파일을 사용하는 경우, 해당 파일을 버전 관리 대상에서 제외하고 선택한 환경 변수 라이브러리를 통해 불러오십시오.
2단계: 첫 번째 소스 접지 요청 보내기
Agent API 빠른 시작 가이드 문서 게시물 https://api.perplexity.ai/v1/agent. 이 Python 클라이언트는 요청을 다음과 같이 감싸서 client.responses.create(). . 빠른 이 사전 설정은 기본적으로 웹 검색을 활성화하므로, 첫 번째 예제의 크기를 작게 유지할 수 있습니다.
from perplexity import Perplexity

client = Perplexity()

question = (
    "소규모 파이썬 프로젝트에서는 가상 환경을 어떻게 사용하고
    의존성을 관리해야 할까요?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
이 코드 조각을 다음 이름으로 저장하세요 first_request.py, 그런 다음 다음 명령을 실행합니다. python first_request.py 키를 설정한 것과 동일한 터미널에서 실행하십시오. 호출이 성공하면 빈 텍스트가 아닌 응답 텍스트가 출력되어야 합니다. 결과에 대한 확인이 필요하다면 소스 추출 단계로 진행하십시오. 텍스트만으로는 검사가 완료된 것이 아닙니다.
편의성 속성 출력 텍스트 최종 답변 텍스트를 제공합니다. 응답 객체 전체도 함께 보관하세요. 원본 기록과 사용 내역은 출력된 단락에만 있는 것이 아니라, 타입화된 출력물에 포함되어 있습니다.
cURL을 사용한 동일한 요청
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "소규모 파이썬 프로젝트에서는 가상 환경을 어떻게 사용하고 의존성을 관리해야 할까요?"
  }'
이 cURL 예제는 macOS/Linux 또는 Bash 호환 셸에서 사용되는 Bash 구문을 사용합니다. 실행할 때마다 요금이 부과되는 요청이 하나씩 발생합니다. 엔드포인트 문제와 Python 문제를 구분해야 할 때에만 이 예제를 사용하십시오. 단순히 예제를 따라 하기 위해 모든 버전을 실행하지 마십시오.
서버 측 자바스크립트 대응 코드
Node.js 18 이상에는 다음이 포함됩니다. 가져오기, 따라서 서버 측 스모크 테스트에는 별도의 라이브러리가 필요하지 않습니다. 원본을 읽어보세요 출력 JSON 응답에 포함된 항목들; Python SDK는 편리한 출력 텍스트 액세서리.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "소규모 Python 프로젝트에서 가상 환경을 사용하고 의존성을 관리하려면 어떻게 해야 할까요?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
3단계: 답을 추출하고 그 출처를 확인하세요
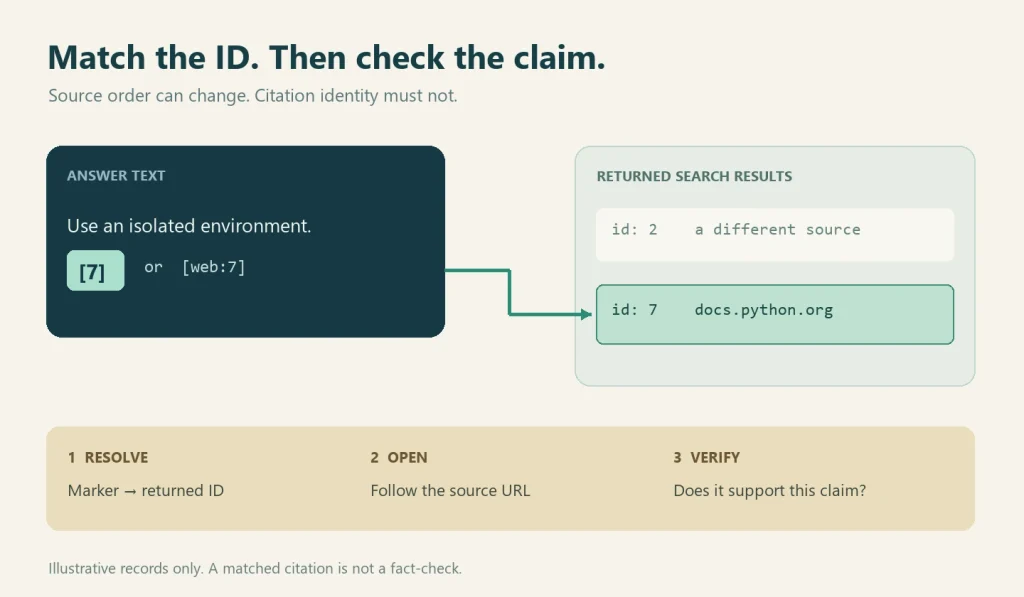
공식 인용 지침 이 산문을 증거 기록들과 구별한다. 자료들은 출력 유형이 지정된 항목 검색 결과. 해당 기사의 결과 그리고 각 인용 표시를 결과의 id. 결과에는 제목과 URL이 포함됩니다. 결과를 표시하기 전에 누락된 값을 처리하십시오.
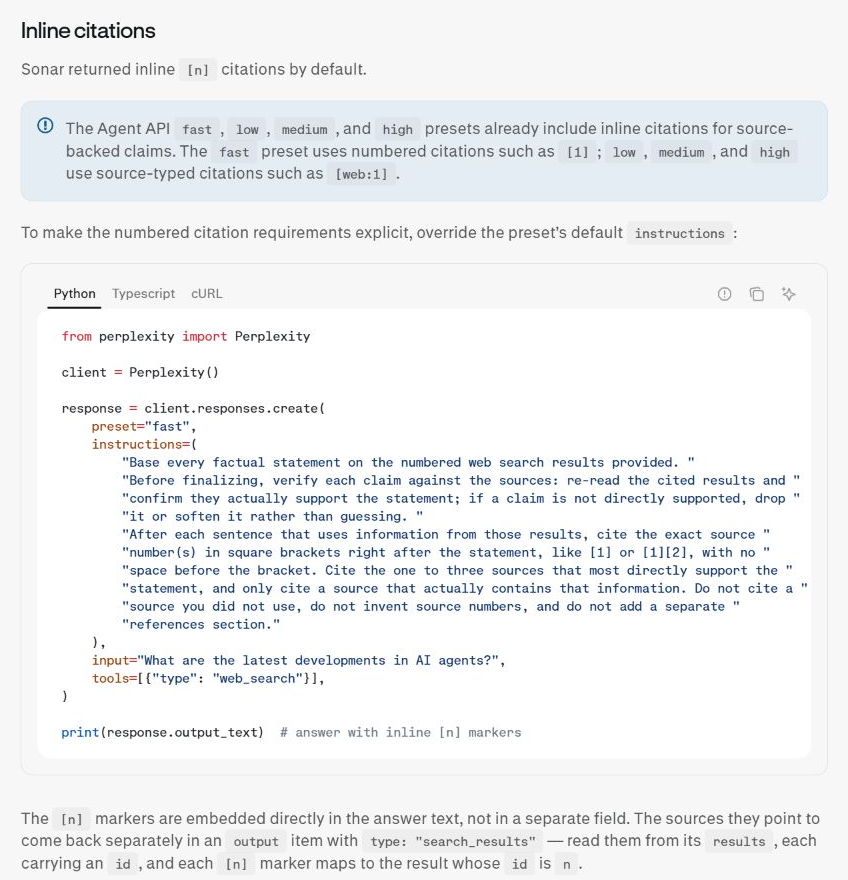
이 마지막 세부 사항이 중요합니다. 다른 도구가 항목을 추가한 후에도 “인용 1”이 항상 배열의 첫 번째 요소라고 가정해서는 안 됩니다. ID를 기준으로 조회 기능을 구축한 다음, 답변에 실제로 나타나는 마커를 식별하십시오.
def field(obj, name, default=None):
    if isinstance(obj, dict): return obj.get(name, default); else: return getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"소스 ID {key}에 대한 URL 충돌")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # 소스 ID이며, 배열의 7번째 위치가 아님
아래의 전체 스크립트는 다음을 인식합니다. [1] 그리고 [web:1], 일반적인 사전 설정에 대해 문서화된 호출 형식입니다. 위의 헬퍼는 SDK 객체와 사전 모두를 처리하며, 동일한 ID에 할당된 중복 URL을 허용하지 않습니다. 또한 결과의 순서를 재조정하지 않으며, 누락된 소스를 추측하지도 않습니다.
인용의 질에 대한 보다 포괄적인 논의는 당사의 Perplexity 인용 정확도 가이드. 인용은 추적 기록입니다. 애플리케이션에는 여전히 오래된 페이지, 중복 URL 및 지원되지 않는 주장에 대한 정책이 필요합니다.
예를 들어, 반환된 배열에 ID 2 다음에 ID 7이 포함되어 있다면, 마커는 [7] ID 7에 연결되어야 합니다. ID 7과 9 모두에 동일한 URL이 표시되는 경우, 두 ID를 모두 유지하면서 해당 URL을 한 번만 표시할 수 있습니다. ID 8이 나타나지 않는다면, [8] 표시하고 ‘일치하지 않음’으로 표시합니다.
4단계: 검색 필터를 활용하여 답변의 정확도를 높이기
기본적인 요청이 제대로 작동하면, 질문의 전문 분야가 명확히 정해진 경우 검색 범위를 좁혀보세요. 파이썬 패키징의 경우, 임의의 튜토리얼보다 해당 언어의 문서와 패키징 가이드를 참고하는 것이 더 좋은 출발점이 됩니다.
response = client.responses.create(
    preset="fast",
    input=(
 "소규모 파이썬 프로젝트에서는 가상 환경을 어떻게 사용하고 "
 "의존성을 관리해야 할까요? 참고하는 가이드라인을 인용해 주세요."
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
이 필터는 웹 검색 도구 설정 내에 위치합니다. 마이그레이션 문서에도 다음과 같이 설명되어 있습니다. search_recency_filter 시의성 있는 질문의 경우. 질문이 최근 출시된 제품이나 뉴스에 좌우될 때는 ‘최근성’을 활용하세요. 분야와 날짜의 범위를 너무 좁게 설정하면 근거 자료가 너무 부족해질 수 있습니다.
지난 한 달 동안의 출시 내역에 대한 질문이라면, 다음을 추가하세요. "search_recency_filter": "month" 옆에 search_domain_filter. 가상 환경 예제에서는 이를 제외하십시오. 안정적인 문서의 경우 게시일이 더 오래된 경우가 있을 수 있습니다. 사전 설정된 모델에서 직접 선택한 모델로 전환하는 경우, 웹 검색 도구를 명시적으로 포함시키십시오.
개발 과정에서 필터링된 결과와 필터링되지 않은 결과를 비교해 보세요. 결과가 달라진다면 그 이유를 기록해 두세요. 필터링 과정에서 유용한 맥락이 제거되었을 수도 있고, 모델의 주의를 분산시키던 신뢰도가 낮은 페이지들이 제거되었을 수도 있습니다. 이는 품질을 판단하기 위한 결정일 뿐, 남아 있는 모든 페이지가 정확하다는 보장은 아닙니다.
애플리케이션에 순위가 매겨진 링크와 스니펫만 필요한 경우, 다음을 호출하십시오. 검색 API 그리고 직접 합성을 수행하세요. 이러한 분리는 검토와 캐싱을 더 쉽게 만들어 줄 수 있습니다. Google과의 더 광범위한 비교에 대해서는 다음을 참조하세요. Perplexity가 구글과 어떻게 다른가.
5단계: 클릭 가능한 출처가 포함된 완전한 답변 저장하기
다음 내용을 다음 이름으로 저장하세요. perplexity_tutorial.py. 이 도구는 모든 기능을 자체적으로 갖추고 있습니다. 소스 헬퍼를 포함하고, Python 문서 도메인 필터를 적용하며, 일치하는 인용 마커를 링크로 변환하고, ID를 유지한 채 중복 URL을 그룹화하며, 마크다운과 함께 완전한 SDK 응답을 저장합니다.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
 "소규모 파이썬 프로젝트에서는 가상 환경을 어떻게 사용하고 "
 "의존성을 관리해야 할까요?"
)
#는 산문형 답변에서 문서화되어 있는 [1] 및 [web:1] 형식을 지원합니다.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
 return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
 sources = {}
 for item in output or []:
 if field(item, "type") != "search_results":
 continue
 for result in field(item, "results", []) or []:
 sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
 raise ValueError(f"소스 ID {key}에 대한 URL 충돌")
 sources[key] = result
 return sources

def safe_url(value):
 if not isinstance(value, str):
 return None
 parsed = urlsplit(value)
 if parsed.scheme not in ("http", "https") or not parsed.netloc:
 return None
 # 마크다운 각괄호() 대상 보호.
 return value.replace("", "").replace(" ", "")

def md_label(value):
 return re.sub(r"([\\\[\]])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
 sources = source_index(output)
 cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
 missing = [
 sid for sid in cited
 if sid not in sources or not safe_url(field(sources[sid], "url"))
 ]
 def link(match):
 sid = match.group(1)
 url = safe_url(field(sources.get(sid, {}), "url"))
 return f"[{match.group(0)[1:-1]}]()" if url else match.group(0)

 # 동일한 URL이 서로 다른 ID 아래에 나타날 경우 모든 ID를 유지합니다.
 grouped = defaultdict(list)
 titles = {}
 for sid in cited:
 source = sources.get(sid, {})
 url = safe_url(field(source, "url"))
 if url:
 grouped[url].append(sid)
 titles.setdefault(url, field(source, "title") or url)

 lines = ["# 출처 기반 답변", "", question, "",
 CITATION_RE.sub(link, answer), "", "## 인용된 출처", ""]
 for url, ids in grouped.items():
 lines.append(f"- ID {', '.join(ids)}: [{md_label(titles[url])}]()")
 if missing:
 lines.append("- 일치하지 않거나 사용할 수 없는 출처 ID: " + ", ".join(missing))
 if not cited:
 lines.append("- 인식된 인라인 인용 없음; 증거가 확인되지 않음.")
 lines.extend(["", "출처 링크 검토 필요; ID 일치만으로는 주장의 진위 여부를 확인할 수 없음."])
 return "\n".join(lines) + "\n"

def main():
 from perplexity import Perplexity
 response = Perplexity().responses.create(
 preset="fast",
 input=QUESTION,
 tools=[{"type": "web_search", "filters": {
 "search_domain_filter": ["docs.python.org", "packaging.python.org"]
 }}],
 )
 answer = response.output_text or ""
 if not answer.strip():
 raise RuntimeError("답변 텍스트가 반환되지 않았습니다. 응답 상태 및 오류를 확인하십시오.")
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 Path("perplexity-answer.md").write_text(
 export_markdown(answer, response.output), encoding="utf-8"
 )
 print("perplexity-answer.md 및 perplexity-response.json을 저장했습니다")

if __name__ == "__main__":
 main()
달리다 python perplexity_tutorial.py 프로젝트 디렉터리에서. 다음을 기록합니다. perplexity-answer.md 그리고 perplexity-response.json 거기에, 해당 이름의 기존 파일을 대체하여 저장합니다. 마크다운 파일에는 질문, 링크된 답변, 인용된 출처 및 일치하지 않는 ID가 포함되어 있습니다. JSON 파일에는 반환된 결과와 진단용 사용 정보가 저장됩니다.
이 파서는 문서에 명시된 산문 형식의 단일 마커 형태를 대상으로 합니다. 이 파서는 완전한 마크다운 파서가 아닙니다. 만약 애플리케이션에서 다음과 같은 임의의 마크다운, 코드 예제 또는 인용문을 요청하는 경우 [1,2], 해당 형식에 대한 구문 인식 렌더러와 테스트를 추가하십시오. 알 수 없는 마커를 아무런 경고 없이 재해석하지 마십시오.
링크된 페이지에서 해당 답변을 확인할 수 있는지 확인하세요
이 예시의 경우, 인용된 문서가 실제로 환경 격리 및 의존성 설치에 대해 설명하고 있는지 확인해 보세요. Python 홈페이지 링크는 관련 문서 섹션보다 유용성이 떨어집니다. 답변에서 특정 명령어를 추천하는 경우, 실행하기 전에 해당 명령어가 지원하는 운영 체제와 Python 버전을 확인하세요. Mark는 인용된 문구가 ‘해결되지 않음’ 상태를 뒷받침하지 않는다고 주장합니다.
필요할 때 스트리밍 또는 구조화된 출력을 추가하세요
스트리밍
스트리밍은 채팅 인터페이스에서 체감되는 지연 시간을 개선합니다. 상담원 마이그레이션 가이드에는 다음과 같은 텍스트 델타 이벤트가 설명되어 있습니다. response.output_text.delta. 델타 데이터가 도착하는 대로 렌더링하되, 최종 응답 항목도 함께 수집하여 답변이 완료된 후 UI에 소스 목록을 표시할 수 있도록 하세요. 텍스트 스트림만으로는 소스 목록이 될 수 없습니다.
다음은 텍스트 표시용입니다. 첫 번째 완전한 소스 레코드에 대해서는 비스트리밍 내보내기 방식을 유지하십시오. 실제 스트리밍 구현에서는 툴/출력 이벤트를 수집하고, 중단되거나 실패한 실행을 처리해야 합니다.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
정형화된 출력
하류 코드에서 다음과 같은 필드가 필요한 경우, 구조화된 응답을 사용하십시오. 답변, confidence_note 그리고 추가 질문. 소스 ID를 별도의 필드로 유지하거나 원래의 에이전트 출력 결과를 그대로 보존하여, 스키마가 관련 증거를 가리지 않도록 하십시오. 워크플로우에서 해당 스키마를 사용하기 전에, 직접 테스트 케이스를 통해 스키마의 유효성을 확인하십시오.
마이그레이션 참조 정보는 유지됩니다 응답 형식 와 함께 type: "json_schema" 구조화된 출력을 위해. 필수 필드를 정의하고, 필요한 경우 예상치 못한 속성을 허용하지 않도록 합니다. 스키마 유효성 검사는 형식을 검증할 뿐, 사실 여부를 검증하지는 않습니다. 즉, 소스 ID는 여전히 실제로 반환된 레코드로 해결되어야 하며, 모델이 생성한 신뢰도 라벨은 정확도 측정값이 아닙니다.
Perplexity API 비용 및 자주 발생하는 오류
Perplexity의 공식 가격 안내 페이지, 2026년 9월 28일 확인, 에이전트 모델 토큰과 도구 호출을 구분합니다. 다음은 USD 기준 도구/검색 요금입니다. 이 빠른 에이전트 사전 설정 및 search_type: "fast" 이는 서로 다른 구성 옵션일 뿐이며, 사전 설정 이름만으로 검색 빈도를 추측해서는 안 됩니다.
| 청구 대상 업무 | 주당 USD | 1,000당 USD |
|---|---|---|
| 에이전트 표준 웹 검색 | $0.0025 | $2.50 |
| Agent Fast Search 호출 | $0.001 | $1.00 |
| 에이전트 URL 가져오기 | $0.0005 | $0.50 |
| 검색 API 요청 성공 | $0.005 | $5.00 |
| Fast Search를 활용한 검색 API | $0.001 | $1.00 |
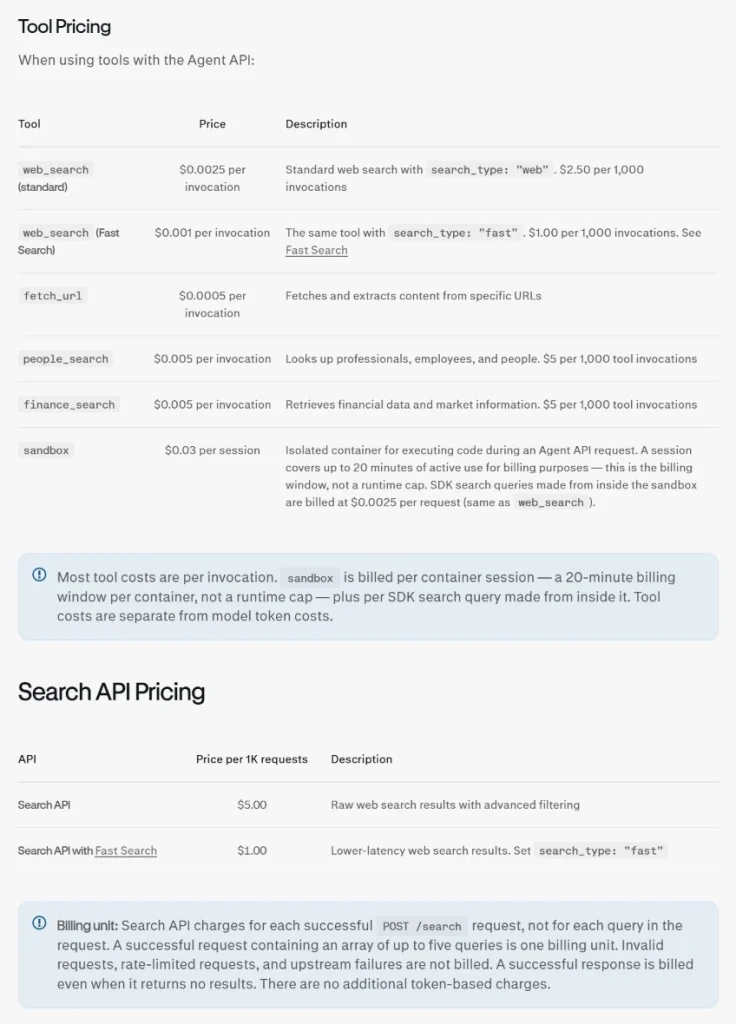
예시: 표준 웹 검색 호출 1,000회와 URL 조회 1,000회의 비용은 공구 비용 $3.00 ($2.50 + $0.50), 모델 토큰이나 기타 요금이 적용되기 전입니다. 이는 튜토리얼을 위해 측정된 비용이 아닌, 가정된 작업량입니다. 단일 에이전트 요청이 여러 도구를 호출할 수 있습니다. 가능한 경우, 다음을 확인하십시오. 사용량.비용.총비용 완료된 응답에 대해.
| 증상 | 가장 먼저 확인해야 할 사항 |
|---|---|
| 401 또는 403 | 환경 변수 이름, 키 유효성, 계정 액세스 권한, 그리고 요청이 현재 엔드포인트에 도달하고 있는지 여부. |
| 청구 또는 할당량 오류 | API 크레딧, 결제 설정, 모델/도구 이용료 및 계정 한도. Perplexity 소비자 요금제를 선택한다고 해서 자동으로 API 크레딧이 제공되는 것은 아닙니다. |
| 429 | 요청 제한 및 재시도 동작. 제한된 지수적 백오프를 사용하고, 이미 처리된 요청을 무분별하게 다시 실행하지 않도록 합니다. |
| 타임아웃 | 네트워크 경로, 프롬프트 크기, 도구 수 및 클라이언트 타임아웃 설정. SDK에서 요청 ID를 제공하는 경우 이를 기록하되, 키는 절대 기록하지 마십시오. |
| 답변에 해당하는 출처가 없습니다. | 원재료를 검사하십시오 response.output, 인용 구문 및 출처 ID; 링크를 임의로 만들어내는 대신 해당 답변을 ‘확인되지 않음’으로 표시하십시오. |
검색 API는 결과가 반환되지 않는 요청을 포함하여 성공한 요청에 대해 요금을 부과하며, 요청 요금에는 토큰 요금이 별도로 부과되지 않습니다. 에이전트 비용은 모델 토큰 및 도구에 따라 달라집니다. 응답 워크플로우와 검색 전용 워크플로우를 비교할 때는 이러한 청구 단위를 구분하여 고려해야 합니다.
API 비용 비교를 위해, 당사의 Perplexity API 요금 안내 배경 정보를 제공하지만, 현재 요금은 공식 요금 페이지의 내용을 기준으로 합니다.
구버전 Sonar 튜토리얼에서 넘어오며
많은 검색 결과에는 여전히 이전 버전의 ‘채팅 완성(Chat Completions)’ 모양이 표시됩니다. 상담원 마이그레이션 가이드에서는 직접적인 개념 매핑 방식을 사용합니다. 소비자 모델 레이블과 API 사전 설정을 비교하고 계신다면, 당사의 설명 자료를 참고하시기 바랍니다. LLM 퍼플렉서티가 사용하는 것 배경을 설명해 주지만, Agent API 문서를 대신할 수는 없습니다.
| 구형 소나 패턴 | 에이전트 API 패턴 |
|---|---|
메시지 | 입력 |
모델 | 사전 설정 |
choices[0].message.content | 출력 텍스트 |
| 구형 인용 배열에 대한 가정 | 검색 결과 출력 항목 및 ID 기반 매칭 |
| 요청의 검색 매개변수 | tools=[{"type":"web_search","filters":{...}}] |
실시간 중계 보기 마이그레이션 개요 그리고 이주 세부 정보 프로덕션 코드를 변경하기 전에. 사전 설정된 매핑은 단지 출발점일 뿐이며, 기존 모델과 새 모델이 동일한 품질, 지연 시간 또는 비용을 보장하는 것은 아닙니다.
자주 묻는 질문
Perplexity API는 무료인가요?
현재의 퀵스타트 및 요금 정책 문서에 따르면, API는 종량제 방식으로 요금이 부과됩니다. 소비자 구독, 체험판 또는 프로모션 크레딧이 모든 API 요청을 무료로 만들어 준다고 가정하지 마십시오.
API를 사용하려면 Perplexity Pro가 필요한가요?
API 이용 권한과 소비자용 Pro 요금제는 별개의 상품입니다. 사용할 개발자 계정에 대해 API 인증 정보를 생성하고 API 청구 내역을 확인하세요.
Agent API를 사용해야 할까요, 아니면 Search API를 사용해야 할까요?
출처가 명시된 완성된 답변이 필요할 때는 ‘에이전트’를 선택하세요. 신청서에서 순위 지정, 필터링 및 요약 기능을 직접 처리해야 할 때는 ‘검색’을 선택하세요. 모든 생성 단계를 엄격하게 제어해야 할 경우, ‘검색’ 기능을 자체 모델과 결합하여 사용할 수 있습니다.
자바스크립트에서 Perplexity를 호출할 수 있나요?
네. 위의 서버 측 Node.js 예제나 공식 JavaScript SDK를 사용하세요. 키는 서버에 보관하세요. 원시 JSON을 읽을 때는 유형이 지정된 출력 항목을 확인하고 동일한 소스 ID 매핑 규칙을 적용하세요.
Perplexity 인용 정보가 반드시 정확한가요?
아닙니다. 인용 정보는 해당 답변이 어떤 검색 결과를 가리키는지 알려줄 뿐입니다. 귀하의 애플리케이션이나 검토자는 여전히 정보의 최신성, 신뢰성, 그리고 해당 페이지가 정확한 주장을 뒷받침하는지 여부를 확인해야 합니다.
왜 파서가 소스를 찾지 못했을까요?
원본 출력 항목 유형을 확인하고, 웹 검색이 실행되었는지 확인한 다음, 정규 표현식이 프리셋의 인용 형식과 일치하는지 확인하십시오. 표시기가 나타나지 않으면, 추측한 링크를 추가하지 말고 답변을 ‘확인되지 않음’으로 저장한 후 해당 요청을 조사하십시오.
GlobalGPT가 Perplexity API 키를 대체할 수 있나요?
GlobalGPT는 일상적인 AI 사용을 위한 올인원 AI 작업 공간입니다. 이 서비스의 구독 및 모델 이용 권한은 Perplexity 개발자 계정, API 키 및 API 크레딧과는 별도로 제공되며, 이 Python 튜토리얼에서는 개발자 계정을 사용합니다.
실용적인 출시 체크리스트
- 서버 측 키를 생성하고 API 요금 결제를 확인하십시오.
- 최소 구성으로 실행하세요
빠른필터를 추가하거나 스트리밍을 시작하기 전에 요청해 주세요. - 보이는 답안 텍스트뿐만 아니라 전체 응답 내용을 저장하세요.
- 인용 마커를 반환된 출처 ID와 대조하고, 일치하지 않는 마커를 표시합니다.
- 인용된 페이지를 검토하여 청구항의 근거, 최신성 및 중복 URL 여부를 확인하십시오.
- 배포하기 전에 라이브 에이전트, 가격 정책 및 마이그레이션 문서를 다시 한 번 확인하십시오.
이제 신뢰할 수 있는 Perplexity API 통합을 위한 핵심 패턴을 파악하셨습니다. 구체적인 질문을 던지고, 에이전트 API가 검색하도록 하며, 답변과 근거를 함께 보관하고, 모든 인용을 검증 가능하게 만드는 것입니다. 이를 바탕으로 동일한 소스 ID 워크플로우를 중심으로 캐싱, 재시도 기능 및 자체 검토 규칙을 추가하시면 됩니다.