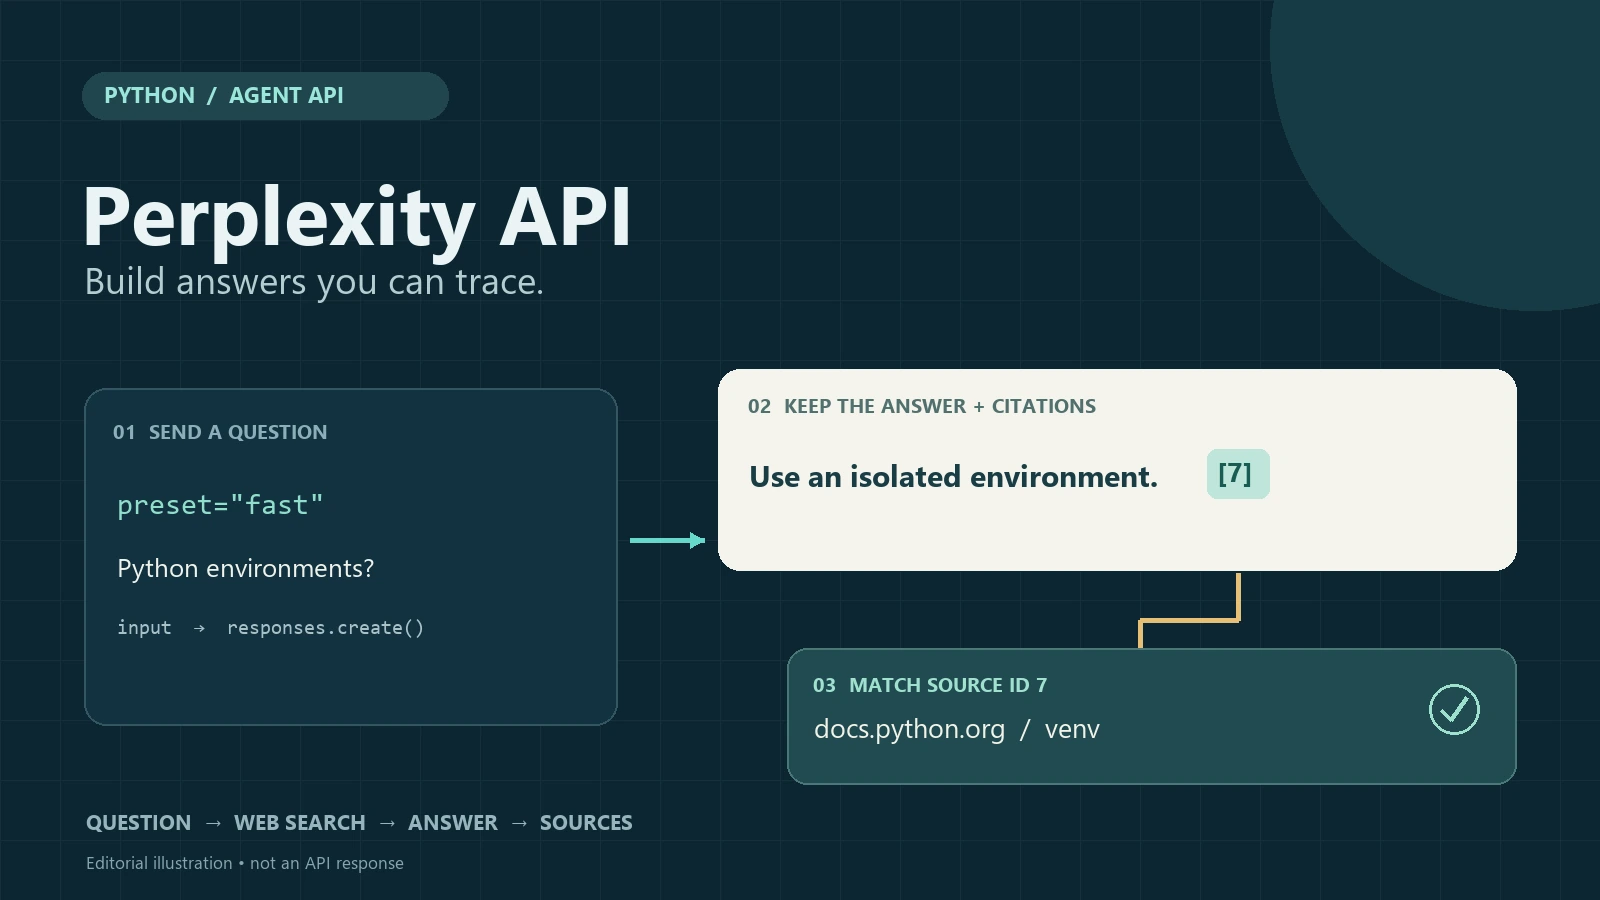
PERPLEXITY API · Python チュートリアル · 2026
この Perplexity API チュートリアルでは、クリック可能な Web ソースを含む回答を返す Python スクリプトの作成方法を解説します。Agent API を使用して質問を送信し、回答を読み取り、その引用マーカーを出典 ID と照合し、確認用の Markdown ファイルをエクスポートします。.
ここでは、ある1つの質問をずっと使い続けます: 小規模なPythonプロジェクトでは、仮想環境をどのように活用し、依存関係を管理すべきでしょうか? まずは基本的なリクエストから始め、その後、ソースの解析やドメインフィルターを追加していきます。基本的なPythonの知識と、API課金設定が完了したPerplexity開発者アカウントが必要です。.
もしあなたも、日々の調査や執筆にAIを活用しているのであれば、, Perplexity 対 GlobalGPT オールインワンのAIワークスペース内で利用可能となるため、個別のツールを切り替える手間が省けます。この一般ユーザー向けのワークフローは、ここで使用されている開発者用キーやAPIの課金とは別物です。.
簡単な答え: 使用する 速い 最初のウェブベースの回答用に設定されたエージェント、読み込み中 response.output_text 答えについては、以下をお読みください。 検索結果 項目 response.output ソースについて。各インラインマーカーを、その戻り値に基づいてソースと照合します。 id. 引用とは、「その回答がこの結果を指摘している」という意味であり、そのページがすべての主張を証明していることを保証するものではありません。.
ステータスの例: リクエストの構文は、2026年9月28日時点で確認された公式ドキュメントに準拠しています。引用ヘルパーはオフラインのサンプルデータを用いて検証済みであり、このチュートリアルでは有料APIリクエストは実行されていません。図に示されているソースレコードは、説明用の例です。.
- どのPerplexity APIを使用すべきでしょうか?
- ステップ 1: API キーを取得し、Python をセットアップする
- ステップ 2:最初の「ソース接地」リクエストを送信する
- ステップ3:答えを抽出し、その出典と照合する
- ステップ4:検索フィルターを使って回答を絞り込む
- ステップ 5:クリック可能な出典を記載した完全な回答を保存する
- ストリーミングと構造化出力
- 費用とよくある間違い
- 以前のSonarチュートリアルからの移行
- よくある質問
Perplexity API チュートリアル:適切な API の選び方
これらは開発者向けインターフェースです。チャット製品では、同様の機能が異なる形で提供されている場合があります。当社の概要では、 Perplexityの機能 ユーザーに提供される体験について説明しています。.
Perplexityの 公式APIクイックスタート 開発者向け製品は、実行すべきタスクごとに分類されています。アプリケーションが実際に必要とするデータを生成する最小限のサーフェスを選択してください。.
| API | ベストフィット | コードが受け取るもの |
|---|---|---|
| エージェント | ウェブ検索やその他のツールを活用して導き出された完成された回答 | 入力項目、回答テキスト、および検索結果レコード |
| 検索 | アプリケーションが自動的に検索結果をランク付け、絞り込み、または要約します | Perplexityに最終的な答えを書かせることなく表示される検索結果 |
| ルーター | リクエストを適切なモデルにルーティングする | ルーターを通じて選択されたモデル応答 |
| 埋め込み | セマンティック検索とRAGインデックス | 独自の検索レイヤー用のベクトルデータ |
このチュートリアルでは、「Agent」を選択しています。これは、求めている結果が「完成した回答とその出典」であるためです。より広範な調査ワークフローについては、当社のガイドをご覧ください。 研究におけるPerplexityの活用.
Sonarについて: 現在の 移行の概要 では、Sonar Chat Completionsは引き続きサポートされているとし、新規プロジェクトにはすべてAgentの使用を推奨しています。そのため、このチュートリアルではAgentを使用します。以前のチュートリアルに記載されていた期限から、古い統合機能が動作しなくなったと推測しないでください。.
ステップ 1: API キーを取得し、Python をセットアップする
鍵を作成し、請求の準備を行う
Perplexity API コンソールを開く, 使用するプロジェクトを選択または作成し、APIの課金設定を行い、キーを作成してください。このキーはサーバー側で保管してください。開発者向けAPIの課金は、コンシューマー向けサブスクリプションとは別に行われます。リクエストを行う前に、プロジェクトの残高を確認してください。.
公式SDKをインストールする
python -m venv .venv

# macOS/Linux: このアクティベーションコマンドを選択してください
source .venv/bin/activate

# Windows PowerShell: 代わりにこのコマンドを使用してください
.venv\Scripts\Activate.ps1

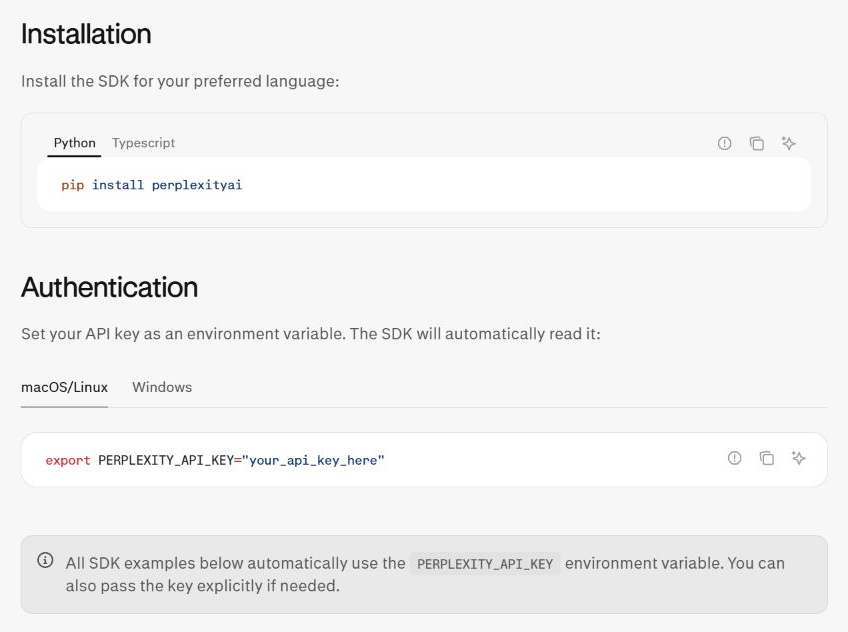
python -m pip install --upgrade perplexityai
以下のコードを実行するには、Python 3.10 以降を使用してください。お使いのオペレーティングシステムに応じたコマンドで環境を有効にした後、SDK をインストールしてください。PowerShell によって環境の有効化がブロックされた場合は、 .venv\Scripts\python.exe ~の代わりに Python インストールおよびスクリプトの実行のために。.
パッケージ名は perplexityai, 一方、Pythonのインポートは 当惑. 仮想環境を使用することで、このチュートリアルの依存関係が他のプロジェクトに影響を与えないようにします。.
この例では、コーディングに関する質問を取り上げています。その理由は、その主張が、常に最新の状態に維持されているドキュメントと照らし合わせて確認できるからです。当ガイドでは、 コーディング用のPerplexity 研究による支援が、自分でコードをテストすることとどのように位置づけられるかを説明しています。.
APIキーを環境変数として設定する
# macOS/Linux
export PERPLEXITY_API_KEY="ここにキーを入力"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "ここにキーを入力"
SDKは次のように読み取ります PERPLEXITY_API_KEY クライアントを作成する際。キーをノートに書き留めたり、Gitにコミットしたり、ブラウザに送信したりしないでください。ローカルで.envファイルを使用する場合は、そのファイルをバージョン管理の対象外とし、お好みの環境変数ライブラリを使用して読み込んでください。.
ステップ 2:最初の「ソース接地」リクエストを送信する
Agent API クイックスタート 文書 投稿 https://api.perplexity.ai/v1/agent. そのPythonクライアントは、リクエストを client.responses.create(). . 速い このプリセットでは、デフォルトでウェブ検索が有効になっているため、最初の例は簡潔にまとまっています。.
from perplexity import Perplexity

client = Perplexity()

question = (
    "小規模なPythonプロジェクトでは、仮想環境をどのように使用し、
    "依存関係を管理すべきでしょうか?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
スニペットを次の名前で保存してください first_request.py, その後、以下を実行します python first_request.py キーを設定したのと同じターミナルで実行してください。呼び出しが成功すると、空ではない応答テキストが表示されます。結果の確認が必要な場合は、ソース抽出の手順に進んでください。テキストが表示されただけでは、チェックが完了したとはみなされません。.
利便性という特性 出力テキスト これにより、最終的な回答テキストが得られます。レスポンスオブジェクト全体も保存しておいてください。ソースレコードや使用状況の詳細は、出力された段落だけでなく、型指定された出力にも含まれています。.
cURL を使った同じリクエスト
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "小規模なPythonプロジェクトでは、仮想環境をどのように活用し、依存関係を管理すべきでしょうか?"
  }'
この cURL の例では、macOS/Linux または Bash 互換のシェル向けの Bash 構文を使用しています。実行するたびに、課金対象となるリクエストが 1 件生成されます。エンドポイントの問題と Python の問題を区別する必要がある場合にのみ使用してください。単に手順を追うためだけに、すべてのバージョンを実行しないでください。.
サーバーサイド JavaScript での同等な記述
Node.js 18 以降には以下が含まれます フェッチ, そのため、サーバーサイドのスモークテストには追加のライブラリは必要ありません。生のデータを参照してください 出力 JSONレスポンスに含まれる項目。Python SDKでは、便利な 出力テキスト アクセサ。.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "小規模なPythonプロジェクトでは、仮想環境をどのように利用し、依存関係を管理すべきでしょうか?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
ステップ3:答えを抽出し、その出典と照合する
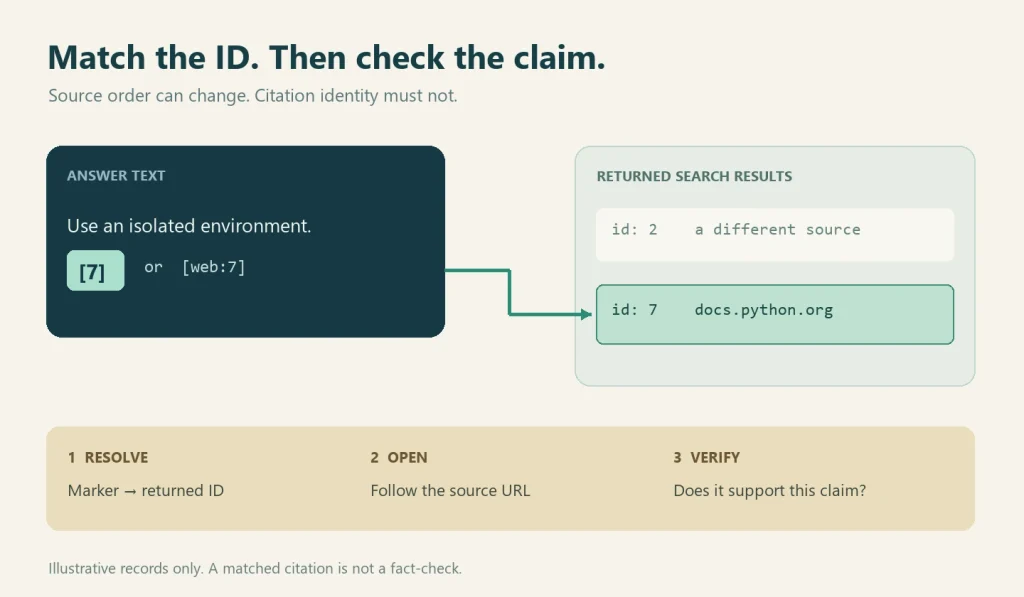
公式の引用ガイドライン その散文を証拠記録と区別している。資料は 出力 タイプが指定された項目 検索結果. その記事の 結果 そして、各引用マーカーを結果の id. 結果にはタイトルとURLが含まれます。表示する前に、値が存在しない場合への対応を行ってください。.
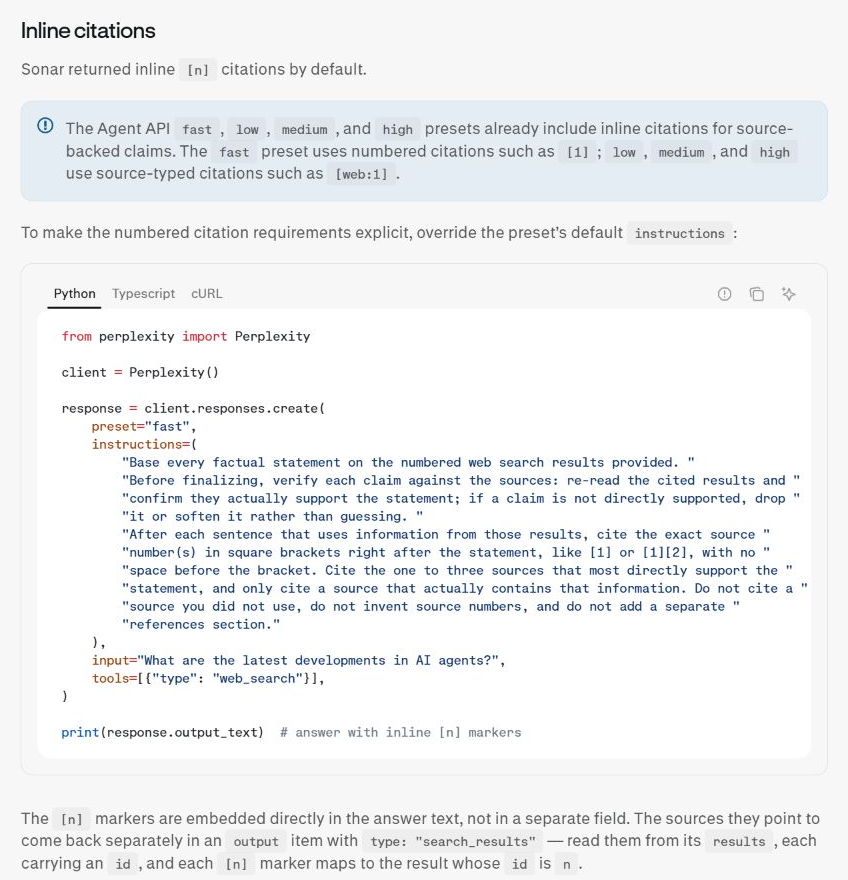
この最後の点が重要です。「引用 1」が、他のツールによって項目が追加された後、必ずしも配列の最初の要素になるとは限らないことを念頭に置いてください。ID による検索機能を構築し、回答に実際に表示されるマーカーを特定してください。.
def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"ソースID {key} に対する URL が重複しています")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # ソースIDであり、配列のインデックス7ではありません
以下の完全なスクリプトは、以下を認識します [1] そして [web:1], 、一般的なプリセットについて文書化された引用形式です。上記のヘルパーは、SDKオブジェクトと辞書の両方を処理し、同じIDに割り当てられた重複するURLを拒否します。また、結果の番号を付け直したり、欠落しているソースを推測したりすることはありません。.
引用品質に関するより詳細な議論については、当社の Perplexity 引用精度ガイド. 引用は監査証跡です。アプリケーションには、古いページ、重複するURL、およびサポートされていないクレームに対するポリシーが依然として必要です。.
たとえば、返された配列に ID 2 の後に ID 7 が含まれている場合、マーカーは [7] ID 7 にリンクする必要があります。ID 7 と ID 9 の両方に同じ URL が表示されている場合は、両方の ID を維持したまま、その URL を 1 回だけ表示できます。ID 8 が表示されない場合は、そのままにしておいてください。 [8] 表示され、一致しないものとしてフラグを立てる。.
ステップ4:検索フィルターを使って回答を絞り込む
基本的なリクエストが機能するようになったら、質問の権威の範囲が明確な場合は、検索の範囲を絞り込みましょう。Pythonのパッケージ作成に関しては、恣意的なチュートリアルよりも、言語のドキュメントやパッケージ作成ガイドの方が良い出発点となります。.
response = client.responses.create(
    preset="fast",
    input=(
 "小規模なPythonプロジェクトでは、仮想環境をどのように利用し、
 "依存関係を管理すべきでしょうか?実際に参照しているガイドラインを挙げて教えてください。"
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
このフィルターは、Web検索ツールの設定内に配置されます。移行に関するドキュメントには、以下の点についても記載されています。 search_recency_filter 時間的制約のある質問の場合。質問の内容が最近のリリースやニュースに依存する場合は、「最新性」を考慮してください。対象分野と日付の組み合わせが狭すぎると、根拠となる情報が不足してしまう可能性があります。.
過去1か月間のリリースに関する質問の場合は、以下を追加してください "search_recency_filter": "month" そばに search_domain_filter. 仮想環境の例からはこれを除外してください。安定版のドキュメントは、公開日が古い場合があります。プリセットから直接選択したモデルに切り替える場合は、Web検索ツールを明示的に含めてください。.
開発中は、フィルタリングした結果とフィルタリングしていない結果を比較してください。結果が異なる場合は、その理由を記録しておきましょう。フィルタリングによって有用な文脈が削除された可能性もあれば、モデルの判断を妨げていた信頼性の低いページが除外された可能性もあります。これは品質に関する判断であり、残ったページがすべて正しいという保証ではありません。.
アプリケーションで必要なのが順位付きのリンクとスニペットのみの場合は、 検索API そして、合成を自分で実行してください。この分離を行うことで、レビューやキャッシュが容易になります。Googleとのより広範な比較については、以下を参照してください。 PerplexityとGoogleの違い.
ステップ 5:クリック可能な出典を記載した完全な回答を保存する
以下を次の名前で保存してください perplexity_tutorial.py. これは独立した機能であり、ソースヘルパーを含み、Pythonドキュメントのドメインフィルターを適用し、一致した引用マーカーをリンクに変換し、IDを失うことなく重複するURLをグループ化し、Markdownとともに完全なSDKレスポンスを保存します。.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
 "小規模なPythonプロジェクトでは、仮想環境をどのように使用し、
 "依存関係を管理すべきでしょうか?"
)
# 文章形式の回答において、ドキュメント[1]および[web:1]に記載された形式をサポートします。
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
 return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
 sources = {}
 for item in output or []:
 if field(item, "type") != "search_results":
 continue
 for result in field(item, "results", []) or []:
 sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
 raise ValueError(f"ソース ID {key} の URL が重複しています")
 sources[key] = result
 return sources

def safe_url(value):
 if not isinstance(value, str):
 return None
 parsed = urlsplit(value)
 if parsed.scheme not in ("http", "https") or not parsed.netloc:
 return None
 # Markdownの角括弧で囲まれた宛先を保護する。
 return value.replace("", "").replace(" ", "")

def md_label(value):
 return re.sub(r"([\\\[\]])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
 sources = source_index(output)
 cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
 missing = [
 sid for sid in cited
 if sid not in sources or not safe_url(field(sources[sid], "url"))
 ]
 def link(match):
 sid = match.group(1)
 url = safe_url(field(sources.get(sid, {}), "url"))
 return f"[{match.group(0)[1:-1]}]()" if url else match.group(0)

 # 同じURLが異なるIDの下に表示される場合、すべてのIDを保持する。
 grouped = defaultdict(list)
 titles = {}
 for sid in cited:
 source = sources.get(sid, {})
 url = safe_url(field(source, "url"))
 if url:
 grouped[url].append(sid)
 titles.setdefault(url, field(source, "title") or url)

 lines = ["# 出典に基づく回答", "", question, "",
 CITATION_RE.sub(link, answer), "", "## 引用された出典", ""]
 for url, ids in grouped.items():
 lines.append(f"- IDs {", '.join(ids)}: [{md_label(titles[url])}]()')
 if missing:
 lines.append("- 一致しない、または使用できない出典ID: " + ", ".join(missing))
 if not cited:
 lines.append("- 認識可能なインライン引用なし;証拠は検証されていません。")
 lines.extend(["", "出典リンクの確認が必要;IDの一致だけでは主張の検証にはならない。"])
 return "\n".join(lines) + "\n"

def main():
 from perplexity import Perplexity
 response = Perplexity().responses.create(
 preset="fast",
 input=QUESTION,
 tools=[{"type": "web_search", "filters": {
 "search_domain_filter": ["docs.python.org", "packaging.python.org"]
 }}],
 )
 answer = response.output_text or ""
 if not answer.strip():
 raise RuntimeError("回答テキストが返されませんでした。レスポンスのステータスとエラーを確認してください。")
 Path("perplexity-response.json").write_text(
 response.model_dump_json(indent=2), encoding="utf-8"
 )
 Path("perplexity-answer.md").write_text(
 export_markdown(answer, response.output), encoding="utf-8"
 )
 print("perplexity-answer.md および perplexity-response.json を保存しました")

if __name__ == "__main__":
 main()
走る python perplexity_tutorial.py プロジェクトディレクトリから。これにより、 perplexity-answer.md そして perplexity-response.json そこで、同じ名前の以前のファイルを上書きします。Markdownファイルには、質問、リンク先の回答、引用元、および一致しなかったIDがすべて含まれています。JSONファイルには、返された出力結果と、診断用の使用状況が保存されています。.
このパーサーは、文書化されている散文中の単一マーカー形式を対象としています。これは完全なMarkdownパーサーではありません。アプリケーションで、次のような任意のMarkdown、コードサンプル、または引用を要求する場合、 [1,2], 、その形式に対応した構文認識機能を備えたレンダラーとテストを追加してください。未知のマーカーを黙って再解釈してはいけません。.
リンク先のページがその回答に対応しているかどうかを確認してください
この例では、引用されたドキュメントに実際に環境の分離や依存関係のインストールについて説明があるかどうかを確認してください。Pythonのホームページへのリンクは、関連するドキュメントのセクションほど有用ではありません。回答で特定のコマンドが推奨されている場合は、実行する前にそのコマンドが動作するOSとPythonのバージョンを確認してください。Mark氏は、引用されたテキストではこの問題が未解決であると主張しています。.
必要に応じて、ストリーミング出力または構造化出力を追加する
ストリーミング
ストリーミングにより、チャットインターフェースにおける体感遅延が改善されます。エージェント移行ガイドには、次のようなテキストデルタイベントが記載されています。 response.output_text.delta. デルタデータは到着次第レンダリングしますが、回答が完了した後にUIでソースを表示できるよう、最終的なレスポンス項目も収集してください。テキストのストリームだけではソースリストとはなりません。.
以下はテキスト表示のみです。最初の完全なソースレコードについては、非ストリーミング形式でのエクスポートを維持してください。本番環境でのストリーミング実装では、ツール/出力イベントも収集し、実行の中断や失敗に対処する必要があります。.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
    print(event.delta, end="", flush=True)
構造化出力
下流のコードで次のようなフィールドが必要な場合は、構造化されたレスポンスを使用してください。 回答, confidence_note そして 追加の質問. ソースIDは別のフィールドとして保持するか、元のエージェント出力をそのまま残すことで、スキーマによって証拠が隠されないようにしてください。ワークフローでスキーマを利用する前に、独自のテストケースでスキーマの妥当性を検証してください。.
移行リファレンスには、以下の内容が記載されています response_format と type: "json_schema" 構造化された出力を得るために。必須フィールドを定義し、必要に応じて予期しないプロパティを許可しないようにします。スキーマの妥当性チェックは形式を検証するものであり、真実性を検証するものではありません。つまり、ソースIDは依然として実際に返されるレコードに解決される必要があり、モデルによって生成された信頼度ラベルは精度の測定値ではありません。.
Perplexity API の費用とよくあるエラー
Perplexityの公式価格ページ, (2026年9月28日確認)では、エージェントモデルのトークンとツールの呼び出しが区別されています。以下は、USD建てのツール/検索料金です。 速い エージェントのプリセットと search_type: "fast" これらは異なる設定オプションです。プリセット名から検索速度を推測しないでください。.
| 請求対象となる業務 | 1株あたりの米ドル | 1,000あたりUSD |
|---|---|---|
| エージェントによる標準的なウェブ検索 | $0.0025 | $2.50 |
| Agent Fast Search の呼び出し | $0.001 | $1.00 |
| エージェントによるURLの取得 | $0.0005 | $0.50 |
| 検索APIのリクエストが正常に処理されました | $0.005 | $5.00 |
| Fast Search を利用した検索 API | $0.001 | $1.00 |
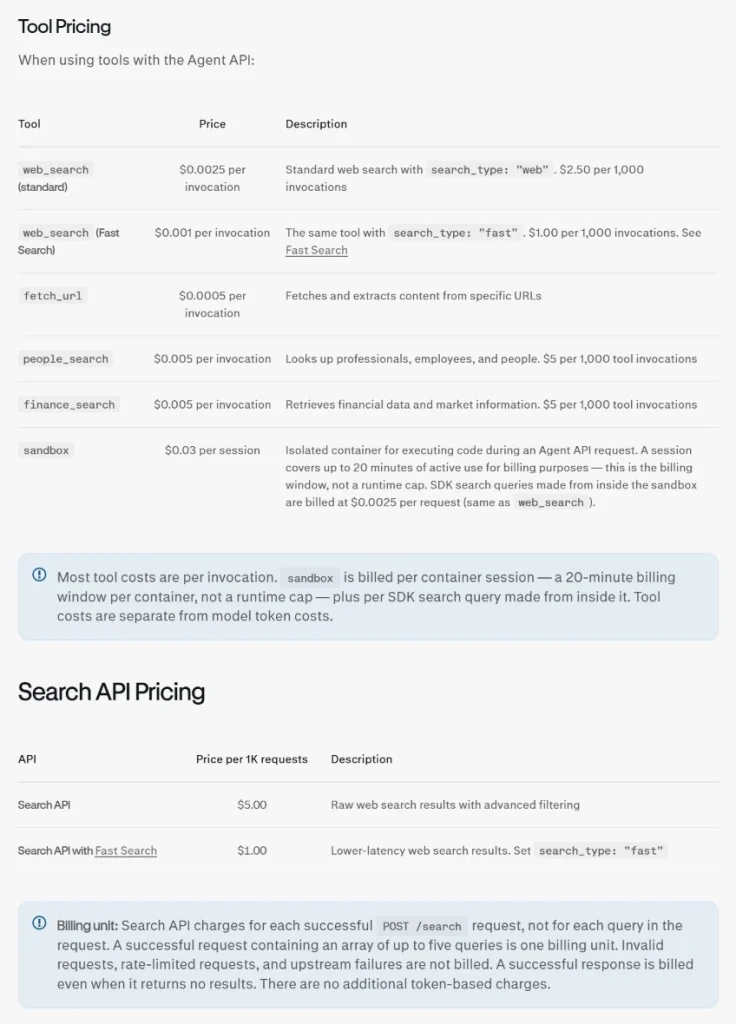
例 標準的なウェブ検索の呼び出し1,000回とURLの取得1,000回にかかる費用 工具代:$3.00 ($2.50 + $0.50)、モデルトークンやその他の課金対象となる費用を除く。これは想定されるワークロードであり、チュートリアルにおける実測コストではありません。1つのエージェントリクエストで複数のツールが呼び出される場合があります。利用可能な場合は、以下を確認してください。 使用量.コスト.総コスト 回答が完了した時点で。.
| 症状 | まず確認すべきこと |
|---|---|
| 401 または 403 | 環境変数の名前、キーの有効性、アカウントへのアクセス権限、およびリクエストが現在のエンドポイントに到達しているかどうか。. |
| 請求または利用枠に関するエラー | APIクレジット、支払い設定、モデル/ツールの利用料金、およびアカウントの制限。Perplexityのコンシューマープランに加入しても、自動的にAPIクレジットが付与されるわけではありません。. |
| 429 | レート制限と再試行の挙動。制限付き指数関数的バックオフを採用し、処理済みのリクエストを無闇に再送信しないようにする。. |
| タイムアウト | ネットワークパス、プロンプトサイズ、ツール数、およびクライアントタイムアウトの設定。SDKがリクエストIDを公開している場合はそれをログに記録しますが、キー自体は決してログに記録しないでください。. |
| この回答には一致する情報源がありません | 原材料を検査する response.output, 、引用形式や出典IDなど;リンクをでっち上げるのではなく、その回答を「未確認」としてマークしてください。. |
検索 API では、結果が返されないリクエストも含め、成功したリクエストに対して課金されます。リクエスト料金には、トークンの追加料金は発生しません。エージェントのコストは、モデルのトークンおよびツールによって異なります。回答ワークフローと検索のみのワークフローを比較する際は、これらの課金単位を区別してください。.
APIの予算比較については、当社の Perplexity API 料金ガイド 背景情報を補足していますが、現在の料金については公式の価格ページが正式な情報源となります。.
以前のSonarチュートリアルからの移行
多くの検索結果には、依然として旧バージョンの「チャット補完」シェイプが表示されています。「エージェント移行ガイド」では、概念的な対応関係を直接的に示しています。コンシューマーモデルのラベルとAPIのプリセットを比較する場合は、当社の解説記事( LLM パープレキシティが使用しているもの 背景情報を提供しますが、Agent APIのドキュメントの代わりにはなりません。.
| 旧式のソナーパターン | エージェントAPIパターン |
|---|---|
メッセージ | 入力 |
モデル | プリセット |
choices[0].message.content | 出力テキスト |
| 従来の引用配列に関する仮定 | 検索結果 出力項目とIDに基づく照合 |
| リクエストの検索パラメータ | tools=[{"type":"web_search","filters":{...}}] |
ライブ配信をご覧ください 移行の概要 そして 移行の詳細 本番コードを変更する前に。あらかじめ設定されたマッピングはあくまで出発点であり、新旧のモデルが同一の品質、レイテンシ、コストを実現することを保証するものではありません。.
よくある質問
Perplexity APIは無料ですか?
現在のクイックスタートガイドおよび料金に関するドキュメントによると、APIは従量課金制となっています。コンシューマー向けサブスクリプション、トライアル、またはプロモーションクレジットを利用しているからといって、すべてのAPIリクエストが無料になるとは限らない点にご注意ください。.
APIを利用するには、Perplexity Proが必要ですか?
APIへのアクセスと「Consumer Pro」プランは、それぞれ別の製品です。使用する予定の開発者アカウントで、API認証情報を作成し、APIの課金状況を確認してください。.
Agent APIとSearch API、どちらを使うべきでしょうか?
出典が明記された、完成された確かな回答が必要な場合は「エージェント」を選択してください。アプリケーション側でランキング、フィルタリング、統合を行う必要がある場合は「検索」を選択してください。生成の各ステップを厳密に制御する必要がある場合は、「検索」を独自のモデルと組み合わせることができます。.
JavaScriptからPerplexityを呼び出すことはできますか?
はい。上記のサーバーサイドのNode.jsサンプル、または公式のJavaScript SDKをご利用ください。キーはサーバー側に保管してください。生のJSONを読み込む際は、型指定された出力項目を確認し、同じソースIDのマッピングルールを適用してください。.
Perplexityの引用は、必ず正しいと保証されていますか?
いいえ。引用情報からは、その回答がどの検索結果を指しているかがわかります。ただし、あなたのアプリケーションまたはレビュー担当者は、情報の最新性、信頼性、そしてそのページが主張の内容を正確に裏付けているかどうかを、依然として確認する必要があります。.
なぜパーサーがソースを見つけられなかったのですか?
生の出力項目のタイプを確認し、ウェブ検索が実行されたことを確認した上で、正規表現がプリセットの引用形式に一致するかどうかを確認してください。マーカーが表示されない場合は、その回答を「未確認」として保存し、推測したリンクを追加するのではなく、リクエストの内容を調査してください。.
GlobalGPTはPerplexityのAPIキーの代わりになりますか?
GlobalGPTは、日常的なAI利用のためのオールインワンAIワークスペースです。そのサブスクリプションおよびモデルへのアクセスは、Perplexityの開発者アカウント、APIキー、APIクレジットとは別ものです。このPythonチュートリアルでは、開発者アカウントを使用します。.
実用的なローンチチェックリスト
- サーバー側のキーを作成し、APIの課金設定を確認してください。.
- 最小構成を実行する
速いフィルタを追加したりストリーミングを開始したりする前に、リクエストを行ってください。. - 表示されている解答テキストだけでなく、回答全体を保存してください。.
- 引用マーカーを返されたソースIDと照合し、一致しないマーカーにフラグを立てる。.
- 引用されたページについて、クレームの裏付け、最新性、および重複URLの有無を確認してください。.
- 展開を行う前に、Live Agent、価格設定、および移行に関するドキュメントを再度確認してください。.
これで、信頼性の高い Perplexity API 統合のための基本パターンが確立されました。具体的には、的を絞った質問を行い、エージェント API に検索させ、回答と根拠を一緒に保持し、すべての引用を監査可能にすることです。ここから、キャッシュ機能や再試行機能を追加し、同じソース ID ワークフローに基づいて独自のレビュールールを設定してください。.