
GPT-LIVE 1 レビュー・ドキュメント(2026年10月1日確認)
GPT-Live 1は、OpenAIが開発した、話しながらも聞き続けることができる音声会話用モデルです。しかし、これは音声エージェントの実用的な基盤となるのでしょうか、それとも、単にデモが洗練されただけの、ありふれた音声モデルに過ぎないのでしょうか。
本レビューでは、実際の構築に影響を与える要素、すなわち全二重通信、バックエンドへの委譲、ツールの活用、トランスポートの選択、価格設定、レート制限、およびGPT-LiveとRealtime APIの違いについて検証します。 また、GlobalGPTが同様のオーディオワークフローを提供している点と、公開されている情報だけでは機能の同等性が証明できない点についても検証します。.
このレビューは、有料の実機ベンチマークではなく、資料に基づいたものです。 以下の事実は、OpenAIの現行モデルおよびGPT-Liveのガイド、さらにGlobalGPTの公開されている音声およびAPIページに基づいています。つまり、この評価はアーキテクチャと適合性に関するものであり、測定されていない1回の通話における遅延、音声品質、または信頼性についての主張ではありません。.
簡単な答え: GPT-Live 1は、アプリケーションで自然で中断可能な音声会話が必要であり、かつ会話が継続している間も検索やツールの呼び出し、作業の完了などを行えるバックエンドエージェントが求められる場合に、有力な選択肢となります。そのモデル利用料は 音声セッション1分あたり$0.05、1秒単位で課金, 、バックエンドのモデルおよびツール利用料は別途加算されます。GlobalGPTは、公開されているテキスト読み上げ、音声文字変換、録音、文字起こしツールを通じて同様の音声活用事例を提供していますが、その公開ページでは、OpenAIと互換性のあるGPT-Liveセッションや、同様の全二重委任アーキテクチャは確立されていません。.
このページでは
GPT-Live 1とは何ですか?
GPT-Live 1は、リアルタイムの会話に対応した全二重音声モデルです。全二重とは、モデルが音声の受信と発話を同時に行うことができることを意味します。そのため、回答する前に録音が終わるのを待つ必要がなく、会話中に割り込みや短い確認、発言の重なりなどが自然に組み込まれるようになります。.
OpenAIは、ライブ音声レイヤーと推論・実行レイヤーを分離しています。GPT-Liveは音声による会話を管理し、いつ支援を求めるかを判断します。バックエンドモデルまたはエージェントが、より高度な推論、ウェブ検索、関数呼び出し、ビジネスルール、およびタスクの状態を処理します。OpenAIでは、この引き継ぎを「ハンドオフ」と呼んでいます。 代表団.
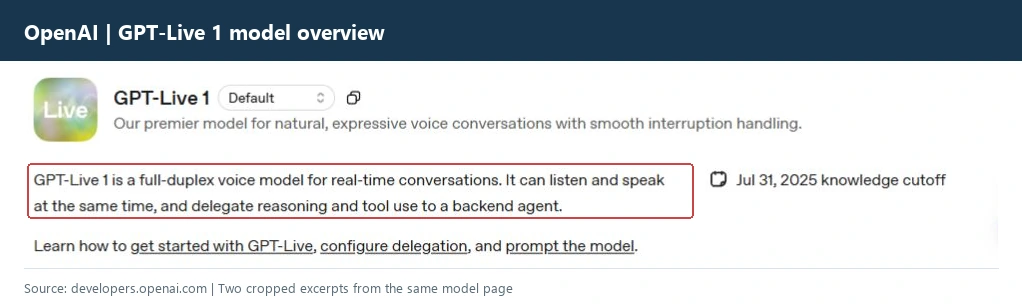
GPT-Live 1のリクエストがどのように分割されるか
ユーザーは、ブラウザ、サーバー、または電話回線を通じて話します。GPT-Liveはそれを聞き取り、応答し、会話の順番を管理します。.
ライブモデルは、設定済みのResponsesバックエンド、またはクライアントが管理する独自のエージェントにタスクを送信します。.
このアプリケーションは、権限を確認し、ツールを実行して、GPT-Liveが音声で説明できるよう、検証済みの結果を返します。.
この分離こそが、GPT-Live 1が、音声認識リクエストに続いてテキスト補完リクエスト、さらにテキスト読み上げリクエストを行う場合とは異なる感覚を与える理由です。連鎖型の設計も有効ですが、その場合、アプリケーション側でターン検出、トランスクリプトの状態、中断処理、再生順序の管理を行う必要があります。GPT-Liveは、その役割を担う音声会話レイヤーを提供します。.
参考となる比較情報については、当社のガイド「 ChatGPT 音声機能の展開 また、一般ユーザー向けの音声機能と開発者向けAPIの実用上の違いについても。.
GPT-Live 1 対 リアルタイム API
どちらもライブオーディオに対応しているため、これらの名称は混同されがちです。OpenAIの現在のオーディオガイドでは、GPT-Liveを新しい会話型音声アプリケーションの起点として位置付けていますが、特定の制御モデルが必要な場合は、Realtime APIの方が依然としてセッションやイベントを重視したアプローチとなっています。.
WebRTCやWebSocketトランスポートを共有しても、GPT-LiveとRealtimeのハンドシェイク、認証情報、イベント形式が互換性を持つわけではありません。これらを別々の統合オプションとして扱い、選択したAPIの接続ガイドに従ってください。.
製品にすでにテキストエージェントが実装されている場合、GPT-Liveを会話用フロントエンドとして活用しつつ、既存のエージェントをバックエンドとしてそのまま維持することができます。すべての音声イベントを検査する必要がある場合や、カスタムセッションコントローラーを構築する必要がある場合は、Realtimeを利用することで、ご希望の低レベルな制御が可能になるでしょう。.
GPT-Live 1の優れた点
公式仕様によると、GPT-Live 1の最大の強みは、会話と仕事の境界線にあります。この製品は、アシスタントが情報を検索したり、ツールを起動したり、タスクを完了させたりしている間も、ユーザーが自然に会話を続けられることを想定して設計されています。.
バックエンドの分離は、ガバナンスの面でも役立ちます。アプリケーションは、引き続き権限チェック、必要な確認、ツールの実行、およびタスクの状態を管理します。GPT-Liveは、信頼できない音声コマンドを、システムに対する自動的な権限に変換することはありません。.
エージェントのアーキテクチャではなく、音声出力を比較するチームについては、この質問を別個に扱うようにしてください。A テキスト読み上げのワークフロー 声や話し方を評価するものであり、モデルが任されたリアルタイムの会話を維持できることを証明するものではない。.
最小限のセッション構成とはどのようなものか
以下の形式は、Pythonの公式なデリゲーションの例を反映したものです。これはドキュメント上の例であり、実際に実行されたリクエストではなく、APIキーは含まれていません。.
session = {
    "model": "gpt-live-1",
    "delegation": {
 "type": "responses",
        "responses": {
 "model": "gpt-6-luna",
 "instructions": "簡潔に回答し、注文情報の検索は承認済みのツールに委任してください。"
 }
    }
}
GPT-Live 1の課題点
GPT-Live 1は、アプリケーション開発の必要性を排除する完全な音声エージェント製品ではありません。公開されているモデルはリアルタイムの会話機能を提供しますが、その製品が安全で、有用で、手頃な価格であるかどうかは、依然として周辺システムによって決まります。.
- バックエンドのコストが積み上がっていく。. $0.05の音声セッション料金には、Responsesモデル、ツール、ウェブ検索、およびその他のバックエンドの利用は含まれません。.
- 無料プランへのアクセスは記載されていません。. モデルページには、無料プランでは同時セッションがサポートされていないと記載されています。有料のAPIプランには、同時セッション数の上限があります。.
- 構造化出力はサポートされていません。. GPT-Liveのモデルページには、構造化出力と微調整が非対応と記載されているため、厳格なスキーマが必要な場合はバックエンドを使用してください。.
- それでもアプリケーションサーバーは必要です。. APIキーは信頼できるサーバーに保管し、権限管理を適切に行い、クライアント委任を使用する際はトランスクリプトやタスクの状態を保持してください。.
- 音声の品質については、ご自身で評価していただく必要があります。. 公式ページにはこのモデルの役割が説明されていますが、ユーザーの語彙やネットワーク環境における発音、音声認識の精度、遅延については保証されていません。.
- リアルタイム処理は、必ずしもそのまま置き換えられるわけではありません。. ハンドシェイクやイベント形式が異なるため、既存のRealtimeアプリには移行計画が必要になる場合があります。.
OpenAIのドキュメントでは、割り込みについても重要な区別が示されています。呼び出し元が割り込みを行ってもバックエンドの処理は継続されますが、その処理を完了させるか中止するかはアプリケーション側が決定します。この方針の選択は、ユーザーの信頼、ツールのコスト、および誤ったタスクが実行されてしまう可能性に影響を与えます。.
単に文字起こし、字幕、または1回限りのナレーションが必要な場合は、専用のオーディオエンドポイントの方が手軽かもしれません。次に読むと役立つ記事として、当社の概要記事「 動画文字起こしの方法.
GPT-Live 1 の価格と費用の例
OpenAIでは、GPT-Live 1を以下のように記載しています。 音声通話は1分あたり$0.05, 、1秒単位で課金されます。セッション時間は1分単位に切り上げられません。この料金にはライブ音声モデルの利用料が含まれます。バックエンドのResponsesへの呼び出しおよびツールの利用については、それぞれ独自の料金体系が適用されます。.
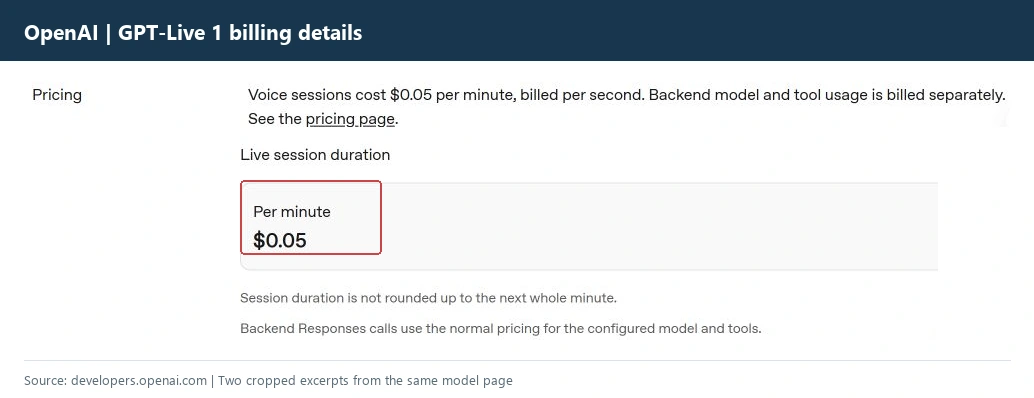
通話1分あたり$0.05の料金例
予算策定の際は、ライブボイスモデルとの接続時間、バックエンドでの推論時間、ツールや検索の利用時間の3つの数値を分けて考慮してください。たとえ短い会話であっても、各ターンで大規模なバックエンドモデルへの委譲が行われたり、コストのかかるツール呼び出しが繰り返されたりすれば、コストが高くなってしまう可能性があります。.
モデルページには、API ティアごとの同時セッション数の上限が記載されています。無料プランではサポートされておらず、Tier 1 は 25、Tier 2 は 50、Tier 3 は 200、Tier 4 は 300、Tier 5 は 500 と記載されています。 これらは、すべての組織が同等のスループットを得られるという保証ではなく、サービス開始前に確認すべきアカウントごとの制限として扱ってください。.
GlobalGPTには、それに似た機能はありますか?
はい、GlobalGPTには音声入力や文字起こし用のツールが備わっているという点で、実用的な意味ではそうです。 その公開AIオーディオインターフェースでは、音声の録音やアップロード、文字起こし、そして結果として得られたテキストのダウンロードやエクスポートを含む、テキスト読み上げ(TTS)および音声文字変換(STT)のワークフローが提供されています。また、公開APIの概要では、チャット、画像、動画のタスクに加え、オーディオタスクについても説明されています。.
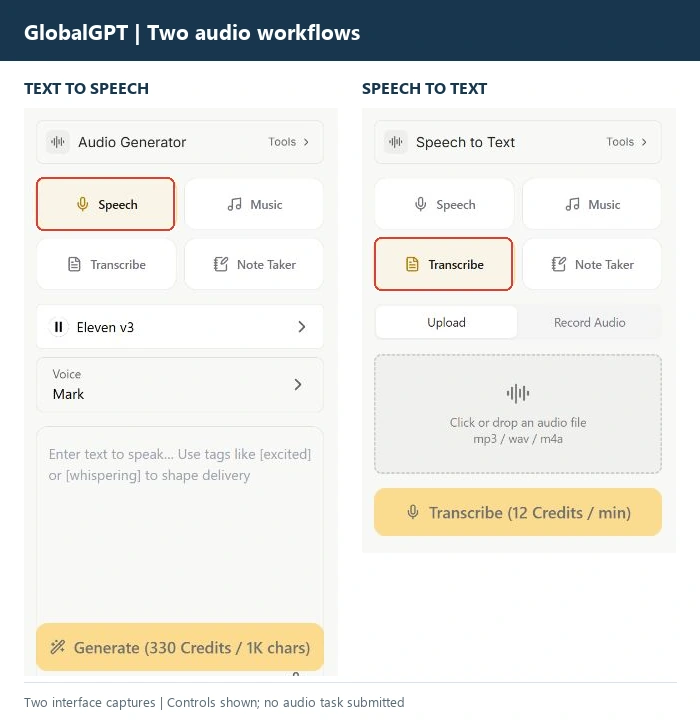
これにより、モデルごとに個別のプロバイダーアカウントを開設することなく、音声やオーディオの作業を追加するという目標を掲げる場合、チームは同様の出発点から始めることができます。以下の内容を検討してみてください。 オールインワンAIモデルワークフロー, 次に、現在のタスクに「会話」「文字起こし」「ナレーション」、あるいは「生成」のどれが必要かを選択してください。.
これは機能の類似性を比較したものであり、互換性を保証するものではありません。GlobalGPTの公開ページは、OpenAIのGPT-Liveリクエスト、エンドポイント、イベントストリーム、またはバックエンド委任設定を、変更なしでそのままコピーできることを証明するものではありません。自動化された統合を構築する前に、モデルカタログおよび選択したタスクのリクエストフィールドを確認してください。.
音声生成、音楽、サウンドデザインの比較については、当サイトの以下のレビューをご覧ください。 Eleven Multilingual v2, Seed Audio 1.0, そして オーディオモデルの選択肢 目的が異なる。音声エージェントと音声生成ツールは、同じテストで評価すべきではない。.
GPT-Live 1はどのような方に適していますか?
製品において、ユーザーが自然な話し方でアシスタントに話しかけ、会話の途中でアシスタントの話を遮り、会話が継続する中でバックエンドからの支援を受けられる必要がある場合は、「GPT-Live 1」を選択してください。カスタマーサポートの初期対応、予約の変更、旅行支援、ガイド付きフォーム、および社内業務などは、ツールの権限やタスクの状態を明確に定義できる場合に、このアーキテクチャに適しています。.
セッション/イベント制御モデルが必要で、会話の基盤部分についてより多くの責任を負う用意がある場合は、「Realtime」を選択してください。文字起こし、推論、音声生成を個別に切り替えたり、非同期で実行したりする必要がある場合は、「チェーン型スタック」を選択してください。.
複数のオーディオおよびAIワークフローを1か所で利用したい場合や、特定のプロバイダーが提供するライブエージェント型アーキテクチャを選択する前に、オーディオツールを比較したい場合は、GlobalGPTを検討してみてください。まずは重要度の低い簡単なタスクから始め、具体的なモデルやリクエストの経路を確認し、自身のレイテンシーや出力品質を測定してみてください。.
本番運用前のテスト中の中断、ちょっとした修正、マイクの雑音、ドメイン固有の用語、ツールの不具合、権限確認のポップアップ、そしてバックエンドがまだ動作している最中に気が変わるユーザー。こうしたケースこそが、音声エージェントが信頼できるかどうかを左右するのです。.
音声、音楽、ナレーションの各ワークフローの選択に関する詳細については、当社の オーディオモデルの比較. 個別のサブスクリプションを維持せずに、複数のモデルファミリーを比較したい場合は、, GlobalGPTのAPI概要 これが現実的な次のステップです。.
よくある質問
GPT-Live 1とは何ですか?
GPT-Live 1は、OpenAIが開発したリアルタイム会話向けの全二重音声モデルです。このモデルは、話しながら相手の話を聞くことができ、推論やツール操作をバックエンドモデルやエージェントに委任することができます。.
GPT-Live 1の価格はいくらですか?
OpenAIでは、音声セッションが1分あたり$0.05で、1秒単位で課金されます。バックエンドモデルの利用およびツールへの呼び出しは、別途課金されます。.
GPT-Live 1 は Realtime API と同じものですか?
いいえ。これらは関連するライブオーディオのユースケースに対応していますが、セッション、ハンドシェイク、イベントのモデルが異なります。ドキュメントに記載されている制御モデルがご自身のアプリケーションに適しているAPIを選択してください。.
GPT-Live 1 は関数呼び出しに対応していますか?
モデルページには、関数呼び出しがサポートされていると記載されています。アプリケーションでは、引き続き承認された関数を実行し、権限、確認、および依存関係をチェックします。.
GPT-Live 1は、ユーザーが操作を中断しても動作しますか?
はい。OpenAIでは全二重通信が規定されており、発信者が割り込んだ場合でもバックエンドの処理を継続できるとされています。その処理を完了させるかキャンセルするかは、アプリケーション側で決定します。.
GPT-Live 1は構造化された出力をサポートしていますか?
モデルページには、構造化出力はサポートされていないと記載されています。代わりに、バックエンドのワークフローで厳格なJSONまたはスキーマの検証を行ってください。.
GlobalGPTには、GPT-Live 1に相当するものはありますか?
GlobalGPTには、テキスト読み上げ、音声認識、録音、アップロード、文字起こしなどの同様の音声ツールが備わっています。その公開ページでは、GPT-Liveの全二重セッションやOpenAI互換のライブエンドポイントについては確認されていません。.
GlobalGPTとOpenAIのどちらを直接選ぶべきでしょうか?
GPT-Liveの文書化されたセッションおよび委任アーキテクチャが必要な場合は、OpenAIを直接選択してください。1つのプラットフォームで複数の音声およびAIワークフローを試してみたい場合は、GlobalGPTをご検討ください。スケールアップを行う前に、具体的なモデルルート、パラメータ、および価格を必ず確認してください。.
より幅広いオーディオワークフローを試してみましょう
特定のプロバイダーのスタックを決定する前に、音声認識、文字起こし、その他のAIワークフローを比較したい場合は、GlobalGPTのオーディオツールやモデルカタログをぜひご確認ください。.



