
Claude Sonnet 5.5 vs Opus 5.5: Harga, Uji Kinerja, dan Uji Nyata
Sonnet 5.5 dan Opus 5.5 sama-sama termasuk dalam generasi Claude 5.5, namun keduanya memiliki harga dan posisi pasar yang berbeda. Perbandingan ini menguji keduanya dengan lima perintah yang sama dan melaporkan hasil yang sebenarnya diberikan oleh masing-masing sistem.
Perbedaan yang teramati tersebut terutama berkaitan dengan biaya dan kecepatan. Dalam paket lima prompt ini, Sonnet 5.5 menyelesaikan tugas lebih cepat, menggunakan lebih sedikit token keluaran, dan menghasilkan perkiraan biaya permintaan aritmatika yang lebih rendah. Opus 5.5 menggunakan lebih banyak token dan waktu, sementara jawabannya sering kali lebih panjang. Kartu tugas menunjukkan di mana teks tambahan tersebut memengaruhi hasil yang berguna dan di mana kedua model tersebut berhasil menyelesaikan tugas dengan baik.
Prompt, batas permintaan, pengaturan upaya, titik akhir, dan desain “satu eksekusi per model” tetap disesuaikan dengan yang sebelumnya Ulasan Claude Opus 5.5.
Jawaban singkat
- Kecepatan pada putaran yang disesuaikan ini: Sonnet 5.5 menyelesaikan lima permintaan berturut-turut dalam waktu 31,930 detik secara lokal; sedangkan Opus 5.5 membutuhkan waktu 47,725 detik.
- Token keluaran yang dilaporkan berdasarkan rute: Sonnet 5.5 menggunakan 2.686; Opus 5.5 menggunakan 3.952. Bidang pemikiran masing-masing berjumlah 987 dan 2.214.
- Perkiraan harga katalog secara aritmatika: Lima permintaan Sonnet berjumlah sekitar $0.02826; lima permintaan Opus berjumlah sekitar $0.08184, dengan menggunakan tarif token standar resmi dan tidak termasuk cache, kredit, pajak, serta markup.
- Hasil tugas: Kedua model tersebut berhasil menyelesaikan tugas ekstraksi, JSON, dan soal matematika. Sonnet mampu mempertahankan format dua paragraf dalam bahasa Mandarin yang diminta dengan lebih rapi; hasil kode yang dihasilkan keduanya dapat digunakan, namun berbeda dalam hal kedalaman dan penjelasan mengenai kasus-kasus khusus.
- Migrasi API: Berpikir tidak dapat dinonaktifkan; pemaksaan pilihan alat ditolak, dan alokasi sumber daya simbolis mencakup proses berpikir. Periksa hal-hal yang perlu diperhatikan terkait migrasi sebelum mengganti.
- Batas keputusan: Ini merupakan satu kali eksekusi per tugas melalui rute pihak ketiga. Pengukuran ini mencakup respons prompt yang teramati, waktu lokal, dan penggunaan yang dilaporkan oleh rute—bukan skor kemampuan universal.
Harga resmi dan spesifikasi model
Kartu model Anthropic saat ini mencantumkan kedua model tersebut, yang masing-masing memiliki jendela konteks sebesar 1 juta token dan keluaran maksimum sebesar 128 ribu. Sonnet 5.5 diberi label Cepat dengan tingkat kegagalan yang tinggi; Opus 5.5 diberi label Sedang dengan tingkat upaya standar sedang. Nilai token standar membuat Sonnet 5.5 setengah dari harga input dan output Opus 5.5.
| Model | ID API | Label latensi resmi | Masukan / keluaran | Konteks / keluaran maksimum | Upaya standar | Pembacaan cache |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-soneta-5-5 | Aktif · Cepat | $2 / $10 per MTok | 1M / 128K | Tinggi | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Aktif · Sedang | $4 / $20 per MTok | 1M / 128K | Sedang | $0.20 / MTok |
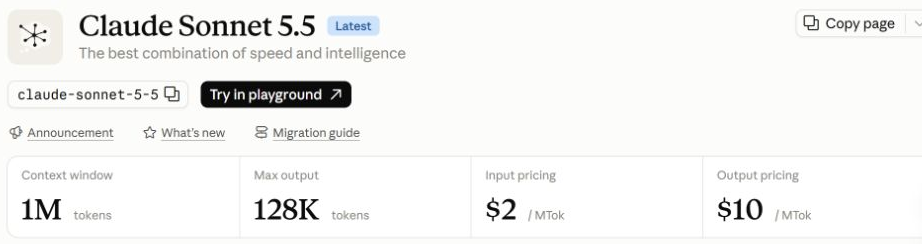
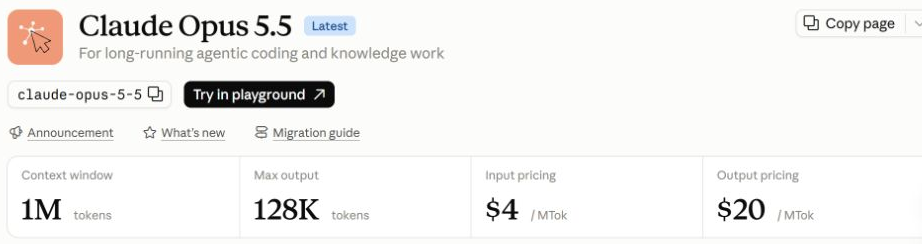
Untuk contoh sederhana tanpa cache dengan 100.000 token masukan ditambah 20.000 token keluaran, tarif token yang tercantum menghasilkan sekitar $0,40 pada Sonnet 5,5 dan $0,80 pada Opus 5,5. Lihat Panduan Harga dan Batas Claude sebagai konteks rencana.
Konteks tolok ukur resmi
Anthropic’s Pengumuman Sonnet 5.5 menempatkan kedua model tersebut dalam satu tabel yang dilaporkan oleh penyedia layanan. Pola barisnya bervariasi tergantung pada tolok ukur dan pengaturan upaya.
| Tolok ukur yang dilaporkan oleh Anthropic | Sonnet 5.5 | Opus 5.5 | Ukuran |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,41 TP40T¹ | Pengkodean terminal agensial |
| FrontierCode v1.1 (Utama) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Apakah perubahan kode tersebut akan digabungkan |
| CursorBench 4.0 | 55.5% | 57.8% | Tugas pengkodean multi-file yang ambigu |
| GDPval-AA v2.1 | 1844 | 1846 | Pekerjaan berbasis pengetahuan di berbagai bidang pekerjaan |
| Ujian Terakhir Manusia | 64,51 TP40T beserta perkakasnya | 67,71 TP40T beserta perkakasnya | Penalaran multidisiplin |
| OSWorld 2.1 | 80.1% parsial | 81,81 TP40T parsial | Tugas-tugas yang melibatkan penggunaan komputer |
| Kartografi | 61,61 TP40T tanpa alat | 64,41 TP40T tanpa alat | Pengenalan diagram visual |
¹ Opus 5.5 Terminal-Bench menggunakan tingkat usaha xhigh; ² Sonnet 5.5 FrontierCode memiliki nilai 46,2% pada pengaturan Max dan 52,1% pada tingkat usaha xhigh. Nilai OSWorld ditandai sebagai parsial. Ini merupakan konteks penyedia, bukan pengulangan independen dengan tingkat usaha yang sama.
Metode API dengan prompt yang sama
Setiap model menerima lima prompt yang sama melalui POST https://anywhere.broly.ai/v1/messages. Klien mengirimkan satu pesan pengguna, max_tokens: 8192, output_config.effort: tinggi, dan tanpa alat apa pun. Setiap permintaan mengembalikan kode status HTTP 200 dan akhir_giliran.
Pendekatan pengujian ini sejalan dengan kerangka yang lebih luas Alur kerja pengujian model GlobalGPT. Sebuah terpisah Panduan API Claude mencakup pengaturan permintaan dan pencatatan token.
Waktu, token, dan perkiraan biaya
| Rute | Waktu setempat pukul lima | Masukkan token | Token keluaran | Pemikiran yang dilaporkan | Perkiraan biaya permintaan* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 detik | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 detik | 700 | 3,952 | 2,214 | $0.08184 |
* Perkiraan berdasarkan token yang dilaporkan dari rute dan tarif standar resmi. Sonnet 5.5 lebih rendah sebesar 33,1% berdasarkan waktu tempuh lokal dan lebih rendah sebesar 32,0% berdasarkan jumlah token keluaran dalam kelompok ini.
Lima kartu tugas yang serupa
Setiap kartu memuat informasi mengenai tugas, pengamatan, waktu setempat, token rute yang dilaporkan, status, dan batas wilayah secara terpadu.
Apakah model-model tersebut mampu memperbaiki fungsi deduplikasi tipe campuran?
Pengaturan tugas: Prompt yang tepat itu disalin dari yang sebelumnya Ulasan Claude Opus 5.5 paket uji coba.
| Model | Waktu / penggunaan rute | Label hasil singkat |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 detik 145 masukan / 830 keluaran 0 pemikiran HTTP 200 · end_turn | Fungsi yang telah diperbaiki ditambah dua soal latihan; penjelasan yang lebih ringkas. |
| Claude Opus 5,5 | 15,844 detik 145 masukan / 1.478 keluaran 700 pemikiran HTTP 200 · end_turn | Fungsi yang telah diperbaiki ditambah dua tes; pembahasan lebih lanjut mengenai kasus-kasus khusus. |
Perbandingan yang diamati: Keduanya mengembalikan fungsi yang telah diperbaiki dan dua tes. Sonnet 5.5 menggunakan kunci yang diberi tag tipe, casefold(), serta opsi cadangan berupa daftar dalam respons yang lebih singkat; Opus 5.5 menggunakan lebih banyak token keluaran untuk menjelaskan kasus-kasus khusus tambahan. Tidak ada satu pun dari kedua uji coba tersebut yang menunjukkan pemenang secara umum dalam hal pemrograman.
Batas: Sebuah perbaikan kecil dalam Python hanya memeriksa kasus-kasus khusus tertentu, bukan keandalan di seluruh repositori atau pemrograman yang didorong oleh alat.
Apakah model-model tersebut dapat mempertahankan lima fakta yang diberikan tanpa menambahkan klaim?
Pengaturan tugas: Prompt yang tepat itu disalin dari yang sebelumnya Ulasan Claude Opus 5.5 paket uji coba.
| Model | Waktu / penggunaan rute | Label hasil singkat |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 detik 210 masukan / 209 keluaran 0 pemikiran HTTP 200 · end_turn | Lima poin berurutan; fakta-fakta yang disajikan tetap dipertahankan. |
| Claude Opus 5,5 | 4,374 detik 210 masukan / 312 keluaran 101 Cara Berpikir HTTP 200 · end_turn | Lima poin berurutan; fakta-fakta yang disajikan tetap dipertahankan. |
Perbandingan yang diamati: Keduanya menghasilkan tepat lima poin bernomor dan tetap sesuai dengan fakta yang diberikan. Sonnet 5.5 menghasilkan 209 token, sedangkan Opus 5.5 menghasilkan 312 token; namun, prompt-nya berupa catatan singkat, bukan masukan dengan konteks yang luas.
Batas: Ini adalah pemeriksaan ekstraksi dan pemformatan yang didasarkan pada data aktual; hal ini bukanlah bukti kinerja dalam konteks jutaan token.
Apakah model-model tersebut dapat menghasilkan struktur yang persis seperti yang diminta?
Pengaturan tugas: Prompt yang tepat itu disalin dari yang sebelumnya Ulasan Claude Opus 5.5 paket uji coba.
| Model | Waktu / penggunaan rute | Label hasil singkat |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 detik 128 masukan / 260 keluaran 0 pemikiran HTTP 200 · end_turn | JSON yang dapat diurai; kunci yang diminta dan jumlah item. |
| Claude Opus 5,5 | 8,276 detik 128 masukan / 622 keluaran 390 pemikiran HTTP 200 · end_turn | JSON yang dapat diurai; kunci yang diminta dan jumlah item. |
Perbandingan yang diamati: Keduanya menghasilkan JSON yang dapat diparsing dengan kunci-kunci yang diminta serta dua kelebihan dan dua kekurangan. Sonnet 5.5 lebih ringkas dengan 260 token keluaran; string-string tersebut menggambarkan skenario ulasan fiktif dan bukan fakta produk.
Batas: Melakukan pengujian skema ini sekali saja tidak cukup untuk mengukur keandalan keluaran terstruktur saat pemanggilan alat atau percakapan yang panjang.
Apakah model-model tersebut dapat menerapkan urutan batch yang dibulatkan hingga menghasilkan jawaban akhir?
Pengaturan tugas: Prompt yang tepat itu disalin dari yang sebelumnya Ulasan Claude Opus 5.5 paket uji coba.
| Model | Waktu / penggunaan rute | Label hasil singkat |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 detik 89 masukan / 163 keluaran 0 pemikiran HTTP 200 · end_turn | Hasil yang benar: 67; jawaban akhir ditulis pada baris tersendiri. |
| Claude Opus 5,5 | 3,830 detik 89 masukan / 257 keluaran 74 pemikiran HTTP 200 · end_turn | Hasil yang benar: 67; jawaban akhir ditulis pada baris tersendiri. |
Perbandingan yang diamati: Keduanya menghitung 67 dan menempatkan jawaban akhir pada baris tersendiri. Sonnet 5.5 menggunakan 163 token keluaran, sedangkan Opus 5.5 menggunakan 257 token, tanpa terdapat perbedaan akurasi yang teramati pada prompt ini.
Batas: Satu deret aritmetika tidak dapat digunakan untuk menilai keandalan penalaran secara umum.
Apakah rute tersebut dapat mempertahankan struktur dua paragraf yang diminta?
Pengaturan tugas: Prompt yang tepat itu disalin dari yang sebelumnya Ulasan Claude Opus 5.5 paket uji coba.
| Model | Waktu / penggunaan rute | Label hasil singkat |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 detik 128 masukan / 1224 keluaran 987 pemikiran HTTP 200 · end_turn | Dua paragraf dalam bahasa Mandarin; tanpa bingkai tambahan. |
| Claude Opus 5,5 | 15,401 detik 128 masukan / 1.283 keluaran 949 pemikiran HTTP 200 · end_turn | Sudah membahas poin-poin tersebut; telah menambahkan Markdown dan catatan dalam bahasa Inggris. |
Perbandingan yang diamati: Sonnet 5.5 menghasilkan dua paragraf dalam bahasa Mandarin sesuai permintaan tanpa format tambahan. Opus 5.5 juga mencakup poin-poin yang diminta, namun menambahkan format Markdown dan catatan dalam bahasa Inggris. Catatan ini mencatat format hasil dalam satu kali proses, bukan kualitas bahasa Mandarin secara keseluruhan.
Batas: Permintaan tersebut meminta paragraf pembuka tentang Opus 5.5, sehingga teks itu sendiri bukanlah tolok ukur bahasa netral.
Hal-hal yang perlu diperhatikan terkait API dan migrasi
Sonnet 5.5 menjalankan mode pemikiran adaptif secara default; perintah "thinking: disabled" akan menghasilkan kesalahan 400, dan parameter `max_tokens` mencakup alokasi token untuk proses pemikiran serta teks respons. Perintah `tool_choice any/tool` yang dipaksakan akan ditolak. Pisahkan blok konten berdasarkan jenisnya dan sesuaikan kembali alokasi token dasar sebelum beralih.
Apa yang didukung oleh bukti-bukti
Keputusan pada tingkat tugas
Sonnet 5.5: biaya dan waktu yang diukur lebih rendah pada rute ini, dengan kepatuhan yang sempurna terhadap format pada tugas Tiongkok.
Opus 5.5: harganya lebih mahal dan cakupannya lebih luas di sini; baris tolok ukur resmi tetap unggul dalam beberapa tugas terbuka.
Gunakan bukti pada tingkat tugas untuk menentukan titik awal, lalu validasi beban kerja yang penting bagi Anda.
Untuk konteks terkait, lihat Perbandingan keluarga Claude, Ulasan Opus 5, dan Ulasan Fable 5.1.
PERTANYAAN YANG SERING DIAJUKAN
Model mana yang lebih cepat dalam uji perbandingan tersebut?
Sonnet 5.5 mencatatkan total latensi lokal yang lebih rendah: 31,930 detik dibandingkan dengan 47,725 detik untuk Opus 5.5 dalam lima permintaan berturut-turut. Angka ini sudah mencakup rute dan jalur jaringan yang digunakan di sini, sehingga bukan merupakan latensi dari pihak penyedia layanan.
Model mana yang menggunakan lebih sedikit token keluaran?
Sonnet 5.5 menggunakan 2.686 token keluaran yang dilaporkan berdasarkan rute di lima tugas tersebut, dibandingkan dengan 3.952 token untuk Opus 5.5. Jumlah token saja tidak cukup untuk membuktikan kualitas jawaban.
Model mana yang harganya lebih murah dalam uji coba ini?
Dengan menggunakan tarif API standar resmi dan jumlah input/output yang dihasilkan, kelima permintaan Sonnet 5.5 diperkirakan mencapai $0.02826, dibandingkan dengan $0.08184 untuk Opus 5.5. Perhitungan ini tidak termasuk biaya cache, kredit platform, pajak, dan markup.
Apakah Sonnet 5.5 mengungguli Opus 5.5 dalam setiap pengujian kinerja?
Tabel khusus Anthropic disusun berdasarkan perpaduan antara hasil benchmark dan pengaturan beban kerja: Sonnet 5.5 mencatat skor lebih tinggi pada Terminal-Bench 4.0, sedangkan Opus 5.5 mencatat skor lebih tinggi pada FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld, dan Chartography. Hasil-hasil ini dilaporkan oleh penyedia, bukan hasil pengujian ulang independen.
Apakah Sonnet 5.5 merupakan pengganti API yang dapat langsung digunakan?
Tidak. Panduan migrasi menyebutkan bahwa fitur “thinking” berjalan secara default; jika “thinking: disabled” digunakan, akan muncul kesalahan 400; pemilihan alat paksa “any/tool” akan ditolak; dan klien harus mengurai blok konten berdasarkan jenisnya. Sesuaikan kembali anggaran token dan siklus alat sebelum melakukan peralihan.
Apakah ini uji kinerja dengan konteks yang panjang?
Tidak. Petunjuk ekstraksi berisi sebuah paragraf pendek. Petunjuk tersebut memeriksa kesesuaian dengan fakta dan format yang tepat; namun, petunjuk tersebut tidak mengukur perilaku di sekitar jendela konteks yang terdokumentasi sebesar 1 juta token.



