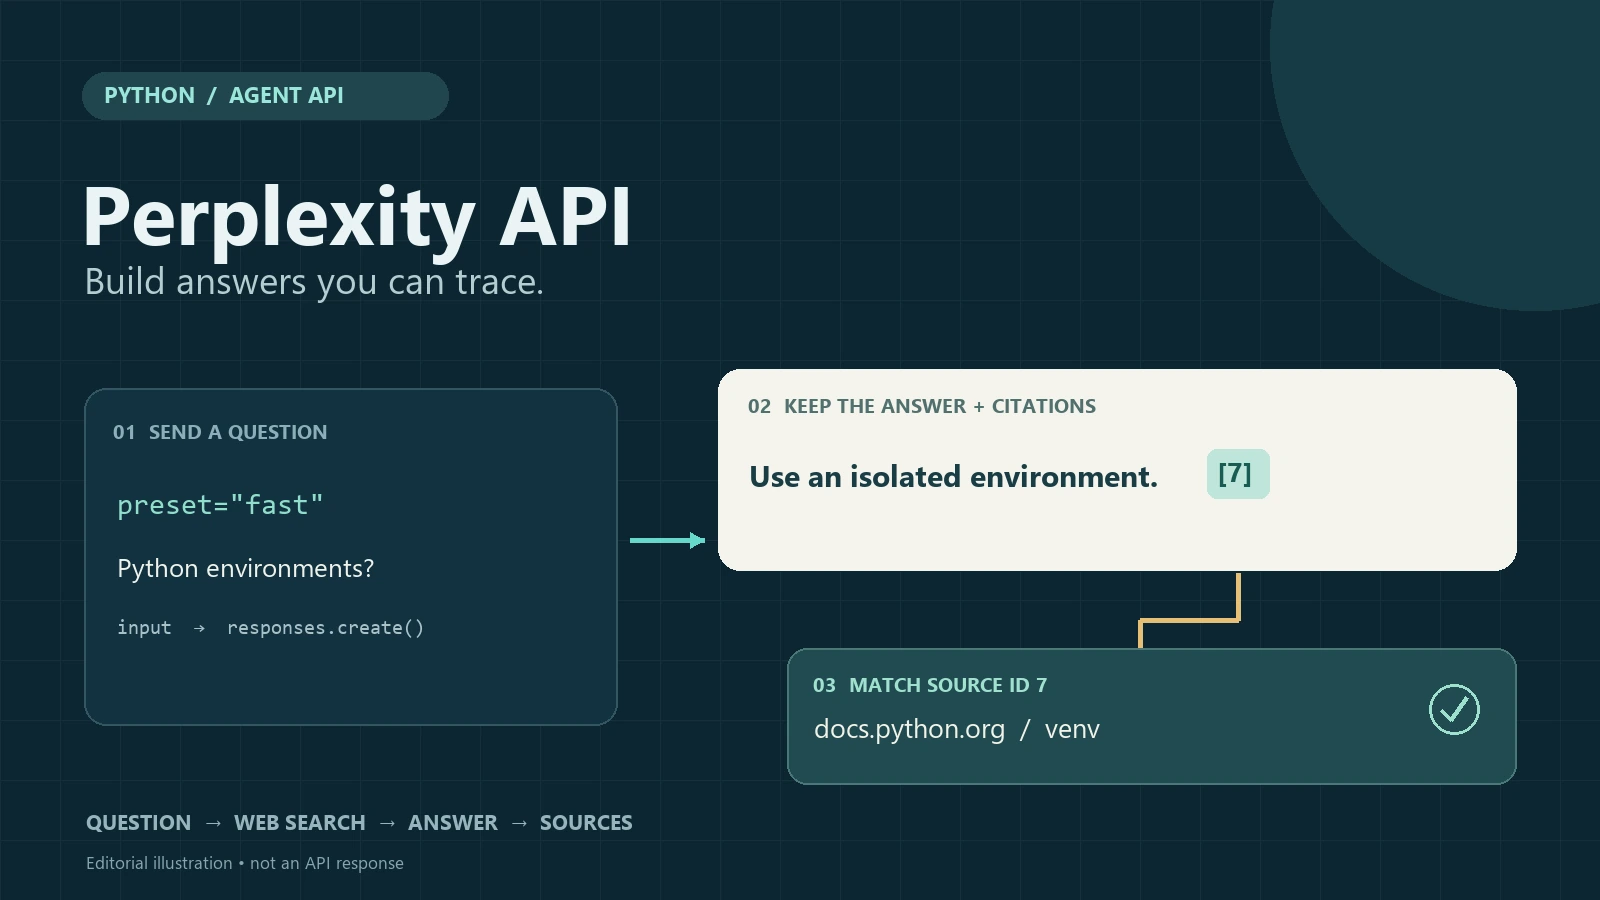
PERPLEXITY API · Python 教程 · 2026
本 Perplexity API 教程将向您展示如何编写一个 Python 脚本,该脚本可返回包含可点击网页来源的答案。使用 Agent API 发送问题、读取答案、将答案中的引用标记与来源 ID 进行匹配,并导出一个可供您查阅的 Markdown 文件。.
我们将始终围绕一个问题展开讨论: 一个小型 Python 项目应该如何使用虚拟环境并管理依赖项? 从一个基本请求开始,然后添加源数据解析和域名过滤功能。您需要具备基本的 Python 知识,并拥有一个已设置 API 计费功能的 Perplexity 开发者账户。.
如果你也在日常的研究和写作中使用人工智能,, Perplexity 位于 GlobalGPT 上 可在一体化 AI 工作区中直接访问,从而减少了在不同工具之间切换的必要。该用户工作流与本文中使用的开发者密钥和 API 计费系统是分开的。.
快速回答: 使用 快 用于首个基于网络的答案的代理预设,请阅读 response.output_text 查看答案,并阅读 搜索结果 项目在 response.output 用于引用来源。根据返回值,将每个内联标记与相应的来源进行匹配 id. 引用意味着“该答案指向了这一结果”;但这并不保证该页面能证明每一项论点。.
状态示例: 该请求语法遵循截至 2026 年 9 月 28 日查阅的官方文档。引用助手已使用离线样本数据进行了验证;本教程中未执行任何付费 API 请求。图中所示的源记录均为说明性示例。.
- 应该使用哪种 Perplexity API?
- 步骤 1:获取 API 密钥并配置 Python
- 步骤 2:发送您的第一个源极接地请求
- 第 3 步:提取答案并匹配其来源
- 第 4 步:使用搜索筛选条件优化答案
- 第 5 步:保存包含可点击来源的完整答案
- 流式输出和结构化输出
- 费用与常见错误
- 从旧版 Sonar 教程过渡
- 常见问题
Perplexity API 教程:选择合适的 API
这些是开发者接口。聊天产品可能会以不同的方式封装类似的功能;我们对 《Perplexity》的游戏特色 描述了面向用户的体验。.
Perplexity的 官方 API 快速入门 根据需要完成的工作来对开发产品进行分类。选择能够生成应用程序实际所需数据的最小工作区。.
| 应用程序接口 | 最合适 | 您的代码接收到的内容 |
|---|---|---|
| 代理 | 基于网络搜索或其他工具得出的完整答案 | 键入的输出项、答案文本和搜索结果记录 |
| 搜索 | 您的应用程序将自动对结果进行排序、筛选或汇总 | 无需让Perplexity写出最终答案的搜索结果 |
| 路由器 | 将请求路由到合适的模型 | 通过路由器选定的示例响应 |
| 嵌入 | 语义检索与 RAG 索引 | 用于自定义搜索图层的矢量图 |
本教程选择“Agent”,是因为您想要的结果是一个完整的答案及其来源。关于更广泛的研究工作流程,请参阅我们的指南: 将Perplexity用于研究.
关于 Sonar: 当前的 迁移概述 指出 Sonar 代码补全功能仍受支持,并建议所有新项目使用 Agent。因此,本教程将使用 Agent。请不要仅因旧教程中提到的截止日期,就推断旧的集成功能已停止工作。.
步骤 1:获取 API 密钥并配置 Python
创建密钥并准备计费
打开 Perplexity API 控制台, 选择或创建您要使用的项目,配置 API 计费,并创建一个密钥。请将该密钥保存在服务器端。开发者 API 的计费与用户订阅分开结算;在发送请求前,请先查看您的项目余额。.
安装官方 SDK
python -m venv .venv

# macOS/Linux:请选择此激活命令
source .venv/bin/activate

# Windows PowerShell:请改用此命令
.venv\Scripts\Activate.ps1

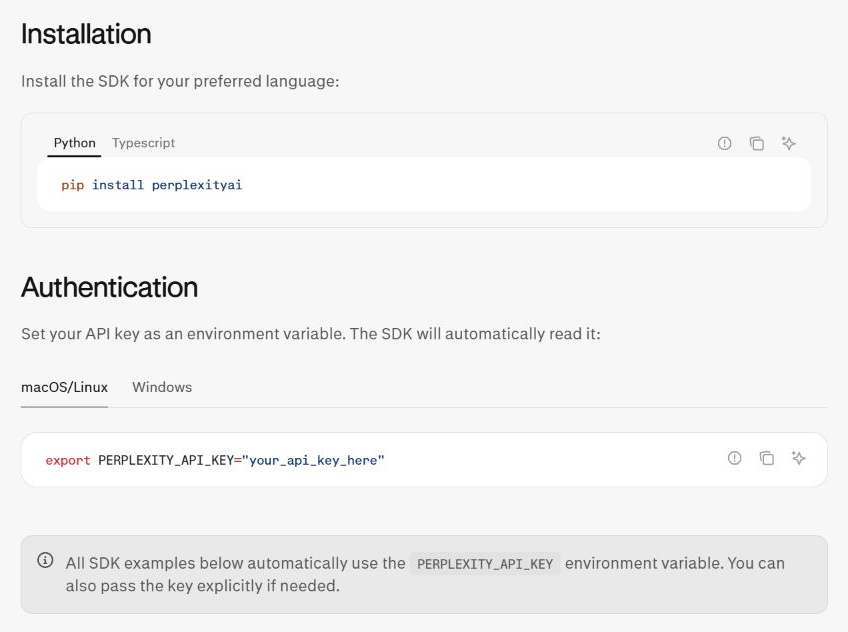
python -m pip install --upgrade perplexityai
请使用 Python 3.10 或更高版本运行以下代码。请使用适用于您操作系统的命令激活环境,然后安装 SDK。如果 PowerShell 阻止了环境的激活,请使用 .venv\Scripts\python.exe 代替 蟒蛇 用于安装和脚本执行。.
包名是 perplexityai, ,而 Python 的导入语句是 迷茫. 请使用虚拟环境,以免本教程的依赖项影响其他项目。.
该示例采用了一个编程问题,因为其结论可以通过查阅维护良好的文档来验证。我们的指南 Perplexity 用于编码 解释了研究支持与自己测试代码之间的关系。.
将 API 密钥设置为环境变量
# macOS/Linux
export PERPLEXITY_API_KEY="your-key-here"

# Windows PowerShell
$env:PERPLEXITY_API_KEY = "your-key-here"
SDK 读取 perplexity_api_key 在创建客户端时。请勿将密钥粘贴到记事本中、提交到 Git,或发送至浏览器。如果在本地使用 .env 文件,请将该文件排除在版本控制之外,并通过您选择的环境变量库加载它。.
步骤 2:发送您的第一个源极接地请求
Agent API 快速入门 文件 POST https://api.perplexity.ai/v1/agent. 其 Python 客户端使用 client.responses.create(). .......。 快 该预设默认启用了网页搜索功能,因此第一个示例的篇幅较短。.
from perplexity import Perplexity

client = Perplexity()

question = (
    "一个小型 Python 项目应该如何使用虚拟环境"
    "并管理依赖项?"
)

response = client.responses.create(
    preset="fast",
    input=question,
)

print(response.output_text)
将代码片段保存为 first_request.py, 然后运行 python first_request.py 在您设置密钥的同一终端中。调用成功时应显示非空的响应文本。如果您需要结果的证明,请继续进行源代码提取步骤;仅凭文本本身并不能算作完整的验证。.
便利性属性 输出文本 会给你最终的答案文本。请同时保留整个响应对象:源记录和使用详情都包含在键入的输出中,而不仅仅是在打印出来的段落里。.
使用 cURL 发送相同的请求
curl https://api.perplexity.ai/v1/agent \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "preset": "fast",
    "input": "一个小型 Python 项目应如何使用虚拟环境并管理依赖项?"
  }'
此 cURL 示例采用适用于 macOS/Linux 或与 Bash 兼容的 shell 的 Bash 语法。每次运行都会发起一次计费请求。请仅在需要将端点问题与 Python 问题区分开来时使用此示例;请勿仅为了跟进示例而运行每个版本。.
服务器端 JavaScript 的等效实现
Node.js 18 及以上版本包含 fetch, ,因此服务器端的烟雾测试无需额外库。阅读原始代码 输出 JSON 响应中的项;Python SDK 提供了一个便捷的 输出文本 accessor.
const res = await fetch("https://api.perplexity.ai/v1/agent", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.PERPLEXITY_API_KEY}`,
    "Content-Type": "application/json"
  },
  body: JSON.stringify({
    preset: "fast",
    input: "一个小型 Python 项目应该如何使用虚拟环境并管理依赖项?"
  })
});
if (!res.ok) throw new Error(`Perplexity HTTP ${res.status}`);
console.log(await res.json());
第 3 步:提取答案并匹配其来源
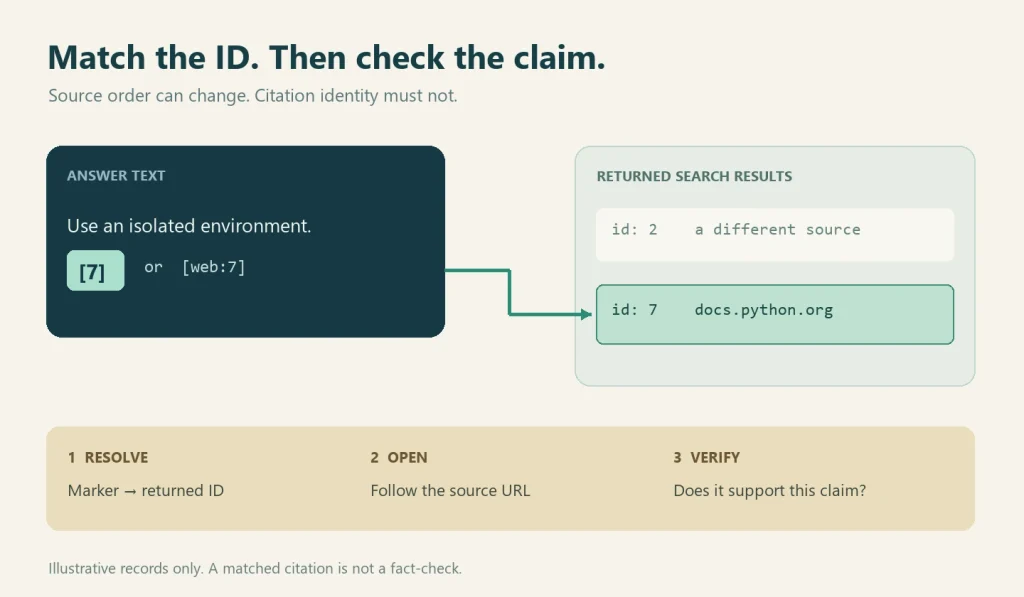
官方引用指南 将散文与其证据记录区分开来。资料以一种……的形式出现。 输出 类型为...的项 搜索结果. 阅读该条目的 结果 并将每个引用标记与结果中的 id. 每个结果都有一个标题和一个 URL;在显示结果之前,需先处理缺失的值。.
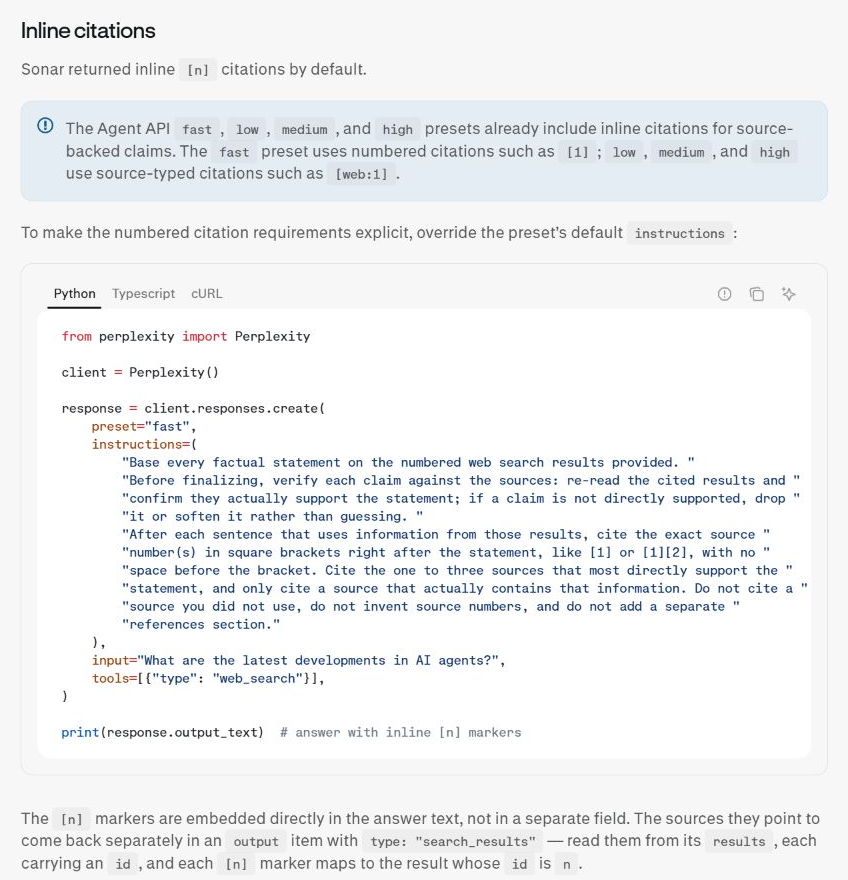
最后这一点很重要。不要假设在其他工具添加了一项内容后,“引用 1”总是数组中的第一个元素。应先根据 ID 建立查找机制,然后再确定答案中实际出现的标记。.
def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict), else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
    if field(item, "type") != "search_results":
        continue
    for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
 if sid is None:
 continue
 key = str(sid)
 if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"源 ID {key} 的 URL 冲突")
 sources[key] = result
    return sources

sources = source_index(response.output)
print(sources.get("7"))  # 这是一个源 ID,而非数组索引 7
下面的完整脚本可识别 [1] 和 [web:1], ,即常用预设的已记录引用格式。上述辅助函数既支持 SDK 对象,也支持字典,且会拒绝将冲突的 URL 分配给同一个 ID。它不会重新编号结果,也不会对缺失的来源进行推测。.
关于引文质量的更广泛讨论,请参阅我们的 Perplexity 引用准确性指南. 引用是一种审计轨迹;您的应用程序仍需制定针对过期页面、重复 URL 和不受支持的声明的处理策略。.
例如,如果返回的数组中包含 ID 2,后面紧接着是 ID 7,那么该标记 [7] 必须链接到 ID 7。如果同一 URL 同时出现在 ID 7 和 ID 9 下,你可以只显示该 URL 一次,同时保留这两个 ID。如果 ID 8 始终未出现,则保留 [8] 显示出来,并将其标记为“未匹配”。.
第 4 步:使用搜索筛选条件优化答案
一旦基本查询能正常工作,当你的问题有明确的权威范围时,请缩小搜索范围。对于 Python 打包,语言文档和打包指南比任意的教程更适合作为起点。.
response = client.responses.create(
    preset="fast",
    input=(
 "一个小型 Python 项目应如何使用虚拟环境"
 "并管理依赖项?请引用您所遵循的指南。"
    ),
    tools=[
 {
 "type": "web_search",
 "filters": {
 "search_domain_filter": [
 "docs.python.org",
                    "packaging.python.org",
 ]
 },
 }
    ],
)
该过滤器应位于网页搜索工具的配置中。迁移文档中还描述了 search_recency_filter 适用于对时间敏感的问题。当问题涉及最新发布的消息或新闻时,应采用“近期性”原则;如果领域和日期范围过于狭窄,可能会导致可用证据不足。.
若要询问过去一个月内的发布情况,请添加 "search_recency_filter": "month" 旁边 search_domain_filter. 在虚拟环境示例中请勿包含此内容:稳定版文档的发布日期可能较早。如果您从预设模型切换到直接选择的模型,请明确包含网络搜索工具。.
在开发过程中,请对比经过过滤和未经过滤的结果。如果答案发生变化,请记录原因:过滤器可能会移除有用的上下文,也可能移除了那些干扰模型的低权威页面。这是一项质量决策,并不保证剩下的每个页面都是正确的。.
如果您的应用程序只需要带排名的链接和摘要,请调用 搜索 API 并亲自进行合成。这种分离可以使审查和缓存变得更加容易。如需与谷歌进行更广泛的比较,请参阅 Perplexity 与 Google 的区别.
第 5 步:保存包含可点击来源的完整答案
将以下内容另存为 perplexity_tutorial.py. 它是一个自包含的工具:包含源辅助程序,应用 Python 文档域过滤器,将匹配的引用标记转换为链接,在不丢失 ID 的情况下对重复的 URL 进行分组,并将完整的 SDK 响应与 Markdown 一起保存。.
from pathlib import Path
from collections import defaultdict
from urllib.parse import urlsplit
import json
import re

QUESTION = (
    "How should a small Python project use virtual environments "
    "and manage dependencies?"
)
# Supports the documented [1] and [web:1] forms in prose answers.
CITATION_RE = re.compile(r"(?<!!)\[(?:web:)?(\d+)\](?!\()")

def field(obj, name, default=None):
    return obj.get(name, default) if isinstance(obj, dict) else getattr(obj, name, default)

def source_index(output):
    sources = {}
    for item in output or []:
        if field(item, "type") != "search_results":
            continue
        for result in field(item, "results", []) or []:
            sid, url = field(result, "id"), field(result, "url")
            if sid is None:
                continue
            key = str(sid)
            if key in sources and field(sources[key], "url") != url:
                raise ValueError(f"Conflicting URLs for source ID {key}")
            sources[key] = result
    return sources

def safe_url(value):
    if not isinstance(value, str):
        return None
    parsed = urlsplit(value)
    if parsed.scheme not in ("http", "https") or not parsed.netloc:
        return None
    # Protect a Markdown angle-bracket destination.
    return value.replace("<", "%3C").replace(">", "%3E").replace(" ", "%20")

def md_label(value):
    return re.sub(r"([\\\[\]<>])", r"\\\1", str(value).replace("\n", " "))

def export_markdown(answer, output, question=QUESTION):
    sources = source_index(output)
    cited = list(dict.fromkeys(CITATION_RE.findall(answer)))
    missing = [
        sid for sid in cited
        if sid not in sources or not safe_url(field(sources[sid], "url"))
    ]
    def link(match):
        sid = match.group(1)
        url = safe_url(field(sources.get(sid, {}), "url"))
        return f"[{match.group(0)[1:-1]}](<{url}>)" if url else match.group(0)

    # Keep every ID when the same URL appears under different IDs.
    grouped = defaultdict(list)
    titles = {}
    for sid in cited:
        source = sources.get(sid, {})
        url = safe_url(field(source, "url"))
        if url:
            grouped[url].append(sid)
            titles.setdefault(url, field(source, "title") or url)

    lines = ["# Source-grounded answer", "", question, "",
             CITATION_RE.sub(link, answer), "", "## Cited sources", ""]
    for url, ids in grouped.items():
        lines.append(f"- IDs {', '.join(ids)}: [{md_label(titles[url])}](<{url}>)")
    if missing:
        lines.append("- Unmatched or unusable source IDs: " + ", ".join(missing))
    if not cited:
        lines.append("- No recognized inline citations; evidence not verified.")
    lines.extend(["", "Source links require review; matching IDs does not verify claims."])
    return "\n".join(lines) + "\n"

def main():
    from perplexity import Perplexity
    response = Perplexity().responses.create(
        preset="fast",
        input=QUESTION,
        tools=[{"type": "web_search", "filters": {
            "search_domain_filter": ["docs.python.org", "packaging.python.org"]
        }}],
    )
    answer = response.output_text or ""
    if not answer.strip():
        raise RuntimeError("No answer text returned; inspect response status and errors.")
    Path("perplexity-response.json").write_text(
        response.model_dump_json(indent=2), encoding="utf-8"
    )
    Path("perplexity-answer.md").write_text(
        export_markdown(answer, response.output), encoding="utf-8"
    )
    print("Saved perplexity-answer.md and perplexity-response.json")

if __name__ == "__main__":
    main()
运行 python perplexity_tutorial.py 从你的项目目录中。它会写入 perplexity-answer.md 和 perplexity-response.json 将这些文件保存到该位置,并用它们替换之前同名的文件。Markdown 文件包含问题、相关链接的答案、引用来源以及任何未匹配的 ID。JSON 文件则保存返回的输出结果及其使用情况,以便进行诊断。.
该解析器针对散文中已记录的单标记形式。它并非一个完整的 Markdown 解析器:如果您的应用程序需要处理任意格式的 Markdown、代码示例或引用,例如 [1,2], 添加一个支持该格式的语法感知渲染器及其测试用例。不要在不报错的情况下对不熟悉的标记进行重新解释。.
检查所链接的页面是否支持该答案
在此示例中,请核实所引用的文档是否确实解释了环境隔离和依赖项安装。Python 主页的链接不如相关文档部分有用。如果某个答案推荐了特定的命令,请在运行之前先确认其操作系统和 Python 版本。Mark 认为所引用的文本无法支持将该问题标记为“未解决”。.
根据需要添加流式或结构化输出
流媒体
流式传输可改善聊天界面的感知延迟。代理迁移指南中记录了诸如以下这类文本增量事件: response.output_text.delta. 在增量数据到达时立即渲染,但也要收集最终的响应项,以便在答案生成完成后,UI 能够显示来源列表。仅靠文本流本身并不构成来源列表。.
以下内容仅供参考。请保留首个完整源记录的非流式导出;在生产环境的流式实现中,还必须收集工具/输出事件,并处理中断或失败的运行。.
stream = client.responses.create(
    preset="fast", input=question, stream=True
)
for event in stream:
    if event.type == "response.output_text.delta":
 print(event.delta, end="", flush=True)
结构化输出
当下游代码需要诸如以下字段时,请使用结构化响应: 答案, confidence_note 和 后续问题. 将源 ID 作为单独字段保留,或保留 Agent 的原始输出,以免模式掩盖相关证据。在工作流中依赖该模式之前,请先使用您自己的测试用例对模式进行验证。.
迁移参考保留了 response_format 与 type: "json_schema" 用于结构化输出。定义必填字段,并在适当情况下禁止出现意外属性。模式有效性检查关注的是结构,而非真实性:源ID仍需能解析为实际返回的记录,且由模型生成的置信度标签并非准确率指标。.
Perplexity API 费用及常见错误
Perplexity的官方定价页面, ,查阅于2026年9月28日,该规则将代理模型令牌与工具调用区分开来。以下是USD工具/搜索费用。该 快 代理预设和 search_type: "fast" 这些是不同的配置选项;请勿根据预设名称推断搜索速率。.
| 可计费操作 | 每股美元 | 每1,000美元 |
|---|---|---|
| 代理标准网页搜索 | $0.0025 | $2.50 |
| 代理快速搜索调用 | $0.001 | $1.00 |
| 代理 URL 获取 | $0.0005 | $0.50 |
| 搜索 API 请求成功 | $0.005 | $5.00 |
| 使用 Fast Search 的搜索 API | $0.001 | $1.00 |
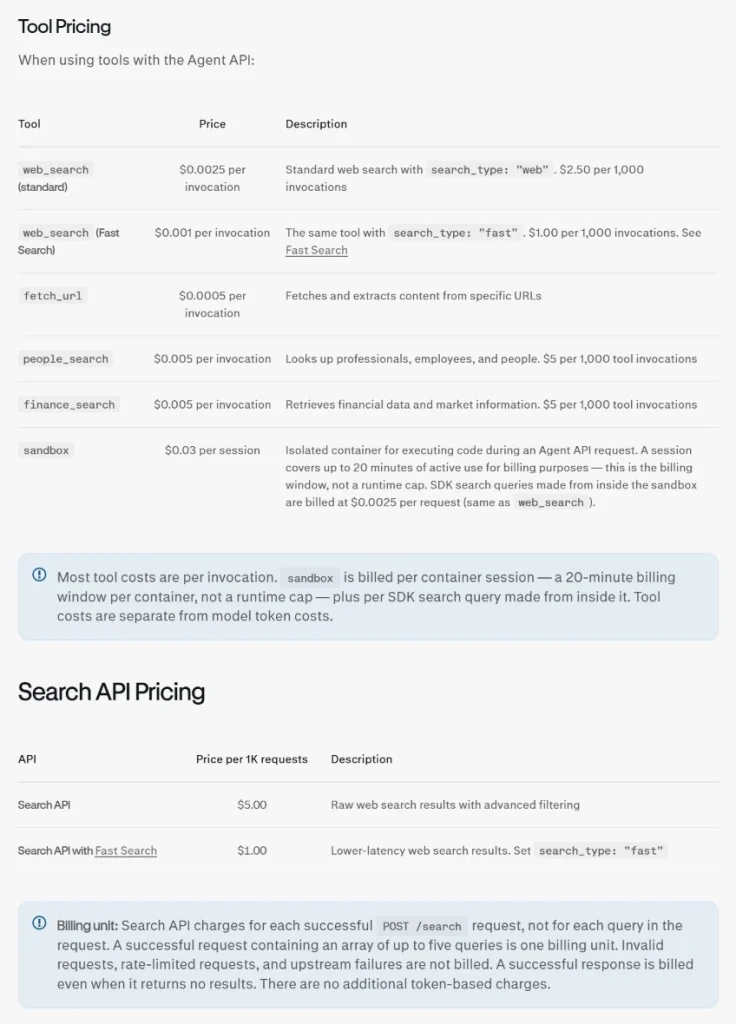
例如 1,000 次标准网页搜索调用加上 1,000 次 URL 获取的费用为 $3.00 刀具费用 ($2.50 + $0.50),不包括模型令牌或其他费用。这是基于假设的工作负载,并非本教程中测得的实际成本。单个代理请求可能会调用多个工具。如有可用,请检查 使用量.成本.总成本 在已完成的答复上。.
| 症状 | 首先应检查什么 |
|---|---|
| 401 或 403 | 环境变量名称、密钥有效性、账户访问权限以及请求是否已到达当前端点。. |
| 计费或配额错误 | API 配额、支付设置、模型/工具费用及账户限额。Perplexity 消费者套餐并不自动包含 API 配额。. |
| 429 | 速率限制和重试行为。应采用有界指数退避算法,并避免盲目重发已成功处理的请求。. |
| 超时 | 网络路径、提示框大小、工具数量和客户端超时设置。如果 SDK 提供了请求 ID,则记录该 ID,但切勿记录密钥。. |
| 该答案没有匹配的来源 | 检查原料 response.output, ,引用格式和来源ID;应将该答案标记为“未核实”,而非捏造链接。. |
搜索 API 会对成功的请求进行计费,包括那些未返回任何结果的请求;其请求价格不包含额外的代币费用。代理成本取决于模型代币和工具。在比较答复工作流与纯搜索工作流时,请将这些计费单位区分开来。.
若要比较 API 预算,请参阅我们的 Perplexity API 费用指南 提供了背景信息,而当前费率的权威来源仍是官方定价页面。.
从旧版 Sonar 教程过渡
许多搜索结果仍显示旧版的“聊天补全”图标。客服人员迁移指南采用了直接的概念映射。如果您正在比较消费者模型标签与 API 预设,请参阅我们关于 LLM Perplexity 的用途 提供了背景信息,但不能替代 Agent API 文档。.
| 较早的声呐模式 | 代理 API 模式 |
|---|---|
信息 | 输入 |
模型 | 预设 |
choices[0].message.content | 输出文本 |
| 过时的引用数组假设 | 搜索结果 输出项与基于ID的匹配 |
| 请求中的搜索参数 | tools=[{"type":"web_search","filters":{...}}] |
阅读直播 迁移概述 和 迁移详情 在修改生产代码之前。预设的映射仅作为起点,并不保证新旧模型在质量、延迟或成本方面完全一致。.
常见问题
Perplexity API 是免费的吗?
根据当前的快速入门和定价文档,API 采用按量付费模式。请不要以为消费者订阅、试用或促销积分就能让每次 API 调用都免费。.
使用该 API 是否需要 Perplexity Pro?
API 访问权限和消费者 Pro 套餐是两个独立的产品。请为计划使用的开发者账户创建 API 凭据,并查看 API 账单信息。.
我应该使用 Agent API 还是 Search API?
当您需要一个附有来源的完整、有依据的答案时,请选择“代理”。当您的应用需要自行处理排序、筛选和综合时,请选择“搜索”。如果您需要对每个生成步骤进行严格控制,可以将“搜索”与您自己的模型结合使用。.
我可以在 JavaScript 中调用 Perplexity 吗?
是的。请使用上文提到的服务器端 Node.js 示例或官方 JavaScript SDK。将密钥保存在服务器上。在读取原始 JSON 时,请检查类型化的输出项,并应用相同的源 ID 映射规则。.
Perplexity的引用是否一定正确?
不。引用仅告知你该答案指向的是哪个检索结果。你的申请或评审人仍需核查该页面的时效性、权威性,以及该页面是否确实支持该论点。.
为什么我的解析器没有找到任何来源?
检查原始输出项的类型,确认网络搜索是否已执行,并检查您的正则表达式是否与预设的引用格式匹配。如果未出现标记,请将答案保存为“未验证”,并调查该请求,而不是添加一个猜测的链接。.
GlobalGPT 能否替代 Perplexity API 密钥?
GlobalGPT 是一个面向日常 AI 应用的全能型 AI 工作区。其订阅和模型访问与 Perplexity 开发者账户、API 密钥及 API 积分是分开的;本 Python 教程使用的是开发者账户。.
一份实用的发布检查清单
- 创建服务器端密钥并确认 API 计费。.
- 运行精简版
快在添加过滤器或开始流式传输之前,请先提交请求。. - 请保存完整的回答内容,而不仅仅是可见的答案文本。.
- 将引用标记与返回的来源ID进行匹配,并对未匹配的标记进行标记。.
- 检查所引用的页面,以确认其对主张的支持性、时效性以及是否存在重复的URL。.
- 部署前,请重新检查生产环境代理、定价及迁移文档。.
现在,您已经掌握了实现可靠的 Perplexity API 集成的核心模式:提出一个针对性问题,让代理 API 进行搜索,将答案与证据关联在一起,并确保每条引用都能被追溯。在此基础上,围绕相同的源 ID 工作流,添加缓存、重试以及您自己的审核规则。.