如果你注重编码性能,但又不希望每次调用 API 时都要支付旗舰机型的价格,那么 GLM-5.3 Flash 就是我推荐关注的机型。. Z.AI 将其定位为原生多模态 GLM-5 系列模型,其官方定价差异显而易见:当前促销价格为每 100 万输入令牌 $0.075,每 100 万输出令牌 $0.25, 而在Z.AI的同一定价页面上,GLM-5.3和GLM-5.2的定价分别为每100万输入令牌$1.40和每100万输出令牌$4.40。.
这并不意味着 GLM-5.3 Flash 适用于所有任务。在我们的受控 API 测试中,它看似成本低廉,但对推理和输出设置也相当敏感。 几个默认的 OpenAI 兼容请求虽然返回了 HTTP 200 状态码,却将大部分完成令牌消耗在推理上,而产生的可见答案却很少甚至没有。在切换到 GLM 风格的推理设置并提高输出上限后,编码调试任务才变得可用。.
本指南详细介绍了 GLM-5.3 闪购价, ,API 访问、官方规格、基准测试指标以及实际测试结果。如果您希望在确定采用某一套技术栈之前先对各种模型进行比较,, GLBGPT 这是比较多个模型输出结果最简便的方式,而 Z.AI 自身的文档和定价页面仍是获取 GLM-5.3 Flash API 官方详细信息的权威来源。.
简答:什么是 GLM-5.3 Flash?
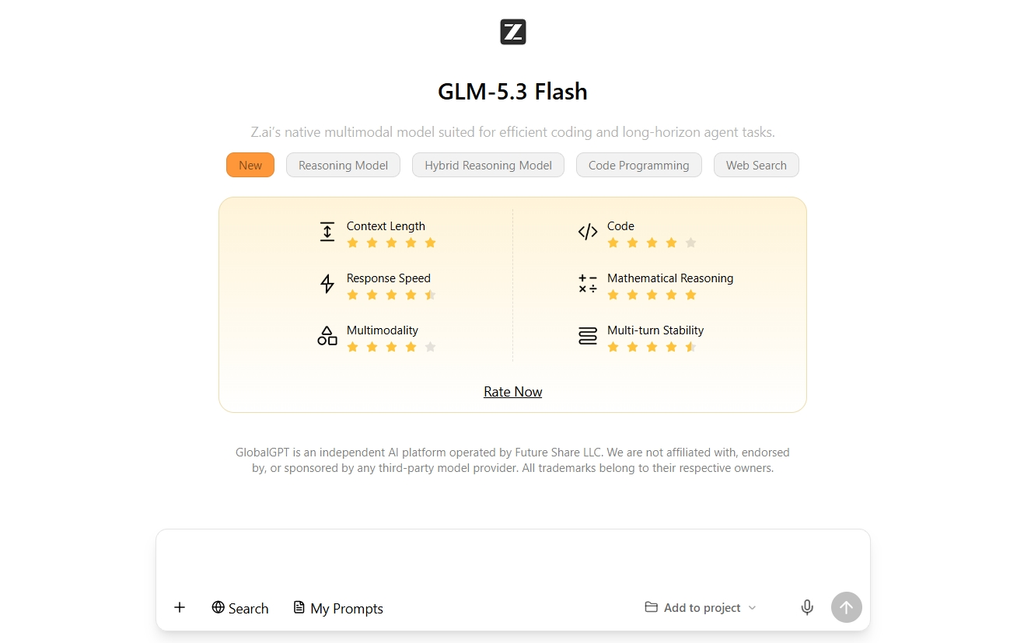
GLM-5.3 Flash 是 Z.AI 推出的一款高性价比的 GLM-5 模型,适用于编码、智能体任务、长上下文处理以及多模态输入。. 官方 GLM-5.3-Flash 文档 列出了 API 模型代码如下: glm-5.3-flash, 支持 1M 个令牌的上下文窗口,并通过 image_url 内容块。.
关键在于权衡取舍。GLM-5.3 Flash 并非仅仅是在同一模型页面上贴了一个更小的标签。 Z.AI 将其描述为 GLM-5 系列中的首个原生多模态模型,总参数数达 320B,激活参数数为 18B。该模型基于一种混合架构构建,旨在在保持长上下文行为有效性的同时,降低服务成本。.
我的实践心得:GLM-5.3 Flash 最适合用于对成本敏感的编码和代理工作负载,在这些场景中可能会多次调用模型。除非对 API 路径和推理设置进行了调优,否则它作为日常写作模型的说服力较弱,因为当输出上限过低时,可见输出可能会被推理令牌的使用所掩盖。.
GLM-5.3 闪电价格
官方 Z.AI 定价页面 是……最可靠的来源 GLM-5.3 闪购价. 根据2026年8月27日的查询结果,Z.AI平台列出的GLM-5.3-Flash享有50%的促销折扣。 折扣价格为:每100万输入代币$0.075,每100万输出代币$0.25。 被划掉的原价分别为:每100万输入令牌$0.15,每100万输出令牌$0.50。.
Z.AI 还指出,本次促销活动将于 2026 年 9 月 9 日 24:00(UTC+8 新加坡时间)结束。这对需要比较长期成本的读者来说很重要:虽然首发折扣是真实的,但除非 Z.AI 延长该优惠,否则不应将其视为永久性的基准价格。.
| 模型 | 输入 / 100万个代币 | 缓存输入 | 产出 / 100万枚代币 | 定价说明 |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 促销价;$0.15 标价 | $0.015 促销价;$0.03 标价 | $0.25 促销价;$0.50 标价 | 50% 优惠活动持续至 2026 年 9 月 9 日(UTC+8) |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | 关于 Z.AI 定价的旗舰版 GLM-5.3 部分 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | 关于Z.AI定价的上一行GLM模型 |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | 归类于 Z.AI 文本模型下 |
Z.AI官方输出的价格对比
来源:Z.AI 官方定价页面,核查日期为 2026 年 8 月 27 日。促销价格仅限时有效。.
没错,根据官方代币定价,GLM-5.3 Flash 确实比 GLM-5.3 和 GLM-5.2 更便宜。但更值得探讨的问题是,在计入提示词、推理设置、工具调用和重试成本后,它是否依然保持低价。我们的实操部分将对此进行探讨。.
如果您想了解上一代产品的定价情况,请参阅我们另一份 GLM-5.2 价格 指南。我建议将该页面重点放在 GLM-5.2 上,而由本文专门介绍 GLM-5.3 Flash 的价格、API 以及基准测试目的。.
GLM-5.3 Flash API 访问
官方 API 模型代码如下: glm-5.3-flash. Z.AI 表示,其文本参数与 GLM-5.3 保持一致,支持 100 万令牌的上下文窗口,并支持通过 image_url 内部的块 messages[].content[]. 这使得 GLM-5.3 Flash 不仅仅是一个纯文本编码模型。.
该设置说明并非无关紧要的细节。文档建议 温度:1, top_p: 0.95, 和 推理_努力:最大. 他们还说 thinking.type 支持 已启用, ,并建议 thinking.clear_thinking: false. 在我们自己的测试中,这种配置确实起到了作用。.
| API 项目 | 使用什么 | 为什么重要 |
|---|---|---|
| 模型代码 | glm-5.3-flash |
请使用确切的型号 ID,而不是猜测变体名称。. |
| 背景 | 100 万代币 | 适用于大型代码库、长文档和代理内存,但仍需考虑成本。. |
| 图像输入 | image_url 内容块 |
支持“截图转代码”和可视化调试工作流。. |
| 思考 | thinking.type: enabled |
推理不能被视为一个微不足道的隐性细节;它可以主导符号的使用。. |
对于非开发人员来说,多模型平台正是在这种情况下能提供帮助。您可以使用 GLBGPT 在投入时间配置某家服务商的 API 之前,先比较各模型的行为表现。关于官方的代币计费和模型参数,请务必查阅 Z.AI 自身的定价和文档。.
GLM-5.3 闪存基准测试与能力信号
在此情况下,基准测试确实很有用,但前提是必须注明来源。Z.AI 的文档提供了官方的模型性能声明和架构细节。. 人工分析 提供第三方基准测试数据。. 开放路由器 提供医疗服务提供商市场数据。这属于三种不同的证据类型。.
Artificial Analysis 的报告显示,GLM-5.3-Flash 的智能指数为 57,在显示的 110 个模型中排名 #3,上下文窗口大小为 1M,每秒输出 50.2 个令牌。报告还显示其输入模态为文本和图像,输出形式为文本。 对于采用 Flash 定价的模型而言,这表明其性能表现强劲,但这仍属于第三方基准测试结果,并非 Z.AI 的官方速度保证。.
价格与性能一览
| 模型 | 官方价格 | 基准信号 | 背景 | 源边界 |
|---|---|---|---|---|
| GLM-5.3-Flash | 每100万枚代币可获得$0.075的输入/$0.25的输出促销奖励 | 57 智能指数;50.2 个输出代币/秒 | 100 万代币 | 价格来自 Z.AI;基准数据来自 Artificial Analysis |
OpenRouter 对于查看市场可用性和运营商特定数值很有用,但我不会将这些数值纳入官方价格表。如果 OpenRouter 显示的某家运营商的吞吐量或临时费率与其他信息不同,请将其标注为“运营商市场数据”。.
API 实践测试:提示词、令牌使用及结果
我们针对五款可用的模型进行了受控的 API 测试: glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, 和 kimi-k3. 这并非一项正式的基准测试,也不应将其视为全球模型排名。其目标更为具体,且对本文更有参考价值:在相同的提示下,GLM-5.3 Flash 是否能返回可用的输出结果,其推理令牌表现如何,以及 API 响应中返回了哪些成本字段?
测试设计刻意保持简单。我们选用了一项编码任务、一项严格的结构化输出任务和一项短文写作任务。这种组合至关重要,因为如果模型在处理编码任务时表现出色,却因在隐含推理上耗尽了输出预算,那么在处理严格的JSON格式或短文写作时,仍可能表现不佳。.
如何阅读测试卡
- 通过 表示模型返回了能够解答该任务的可见输出。.
- 格式错误 表示该内容虽然有用,但并非严格意义上的机器可读输出。.
- 尚无定论 表示请求在技术上已成功,但被测试的路由返回的可见响应很少或根本没有。.
- 成本字段 这些是本次受控API运行中响应返回的数值,并非服务提供商的官方价格承诺。.
使用的默认运行方式 温度:0.2 以及任务级别的输出上限。每个模型/任务仅运行一次,不进行自动重试。随后,我们仅针对GLM-5.3 Flash在编码和写作任务上进行了后续测试,并采用了GLM风格的思维设置,因为默认的Flash响应显示出大量推理标记的使用,需要进行更公正的配置检查。.
任务A
代码调试:模型是否发现了客户分组中的错误?
任务: 找出该 TypeScript 函数中的错误,解释其发生原因,并提供修正后的实现代码。.
精确提示词
您正在审查一个 TypeScript 函数,该函数应按客户 ID 对订单进行分组,并计算每位客户的总消费额。 请找出错误,解释其原因,并提供修正后的实现代码。代码:type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const order of orders) { if (!result[order.id]) result[order.id] = { count: 0, total: 0 }; result[order.id].count += 1; result[order.id].total += order.total; } return result; }
| 模型 | 输出概览 | 代币/成本说明 | 结果 |
|---|---|---|---|
glm-5.3-flash |
默认运行返回了 HTTP 200 状态码,但未显示助手回复,因为推理过程已使用了 1200 个完成令牌中的 1196 个。在“推荐设置”的后续操作中,它正确地识别出 order.id 应为 order.customerId 并给出了修正后的实现。. |
默认:共计 1348 个令牌,成本字段为 $0.0003111。后续:共计 2584 个令牌,成本字段为 $0.00124007598。. | 重跑后通过 |
glm-5.3 |
查明了分组键的错误,并解释了为什么唯一的订单 ID 会阻碍客户层级的聚合。修正后的代码如下: customerId 作为对象键。. |
共计 1348 个代币,成本字段为 $0.00534128。. | 通过 |
glm-5.2 |
还发现了 order.id 与 customerId 解决了该问题,并产出了一套可用的修正版本。. |
共计 1304 个代币。美元成本未在同一响应字段中返回。. | 通过 |
gpt-5.6-luna |
给出了最清晰简洁的解释:累加器以订单 ID 为索引,因此每个订单都成为一个独立的桶。它返回了修正后的 TypeScript 代码。. | 共计509个代币。美元成本待定/未退还。. | 通过 |
kimi-k3 |
发现了同样的 bug,并给出了详细的解释以及修正后的实现方案。这个答案虽然可用,但比 GPT 的答案要长一些。. | 共计1423个代币。美元成本待定/未退还。. | 通过 |
启示 在代码调试过程中,只有在采用GLM风格的思维设置并将输出上限调高后,GLM-5.3 Flash的表现才令人满意。GLM-5.3、GLM-5.2、GPT-5.6 Luna和Kimi K3在首次运行时均给出了可用的、可视化的结果。.
任务 B
严格的 JSON:该模型是否遵循了机器可读格式?
任务: 仅返回严格的 JSON 数据,键名固定,且不包含 Markdown 包裹。.
精确提示词
仅返回严格的 JSON 格式。针对正在选择编码辅助工具的开发者,对比 GLM-5.3-Flash、GLM-5.3 以及 GPT 风格的旗舰模型。请使用以下键:best_for、tradeoffs、cost_warning、recommendation。请勿使用 Markdown 格式。.
| 模型 | 输出概览 | 代币/成本说明 | 结果 |
|---|---|---|---|
glm-5.3-flash |
返回了部分类似 JSON 的内容,但未经清理的话,这并非严格意义上可解析的 JSON。该内容可供人类读者阅读,但不适用于直接自动化处理。. | 总计1267个代币,成本字段为$0.000305025。. | 格式错误 |
glm-5.3 |
在测试的输出上限下未返回任何可见的助手内容,几乎所有完成令牌都被推理过程消耗掉了。. | 总计 1267 个代币,成本字段为 $0.00530084。. | 尚无定论 |
glm-5.2 |
返回了一个类似 JSON 的结果,但该结果不完整,且未经清理无法解析。. | 共计 1268 个代币。美元成本未在同一响应字段中返回。. | 格式错误 |
gpt-5.6-luna |
返回了包含请求键值且不含 Markdown 围栏的可解析 JSON 数据。. | 共计541个代币。美元成本待定/未退还。. | 通过 |
kimi-k3 |
返回的内容类似 JSON 且包含有用的信息,但在经过清理之前,它并非严格意义上的可解析 JSON。. | 共计1339个代币。美元成本待定/未退还。. | 格式错误 |
启示 就严格的结构化输出而言,在这次小规模测试中,GPT-5.6 Luna 的输出最为简洁。GLM-5.3 Flash 或许在更严格的响应格式控制下仍能正常工作,但此默认请求尚不具备自动化处理能力。.
任务 C
产品简要说明:该模型生成的文本是否可用?
任务: 请撰写一篇具体且不带宣传性质的120字说明,阐述在何种情况下GLM-5.3 Flash比更重的旗舰机型更胜一筹。.
精确提示词
请撰写一篇120字的产品说明,解释在什么情况下GLM-5.3-Flash比更重的旗舰机型更合适。内容要具体,不要带有宣传性质。.
| 模型 | 输出概览 | 代币/成本说明 | 结果 |
|---|---|---|---|
glm-5.3-flash |
默认运行在使用了 900 个完成令牌中的 895 个后,未返回任何可见内容。在“推荐设置”后续运行中,推理使用了 1800 个完成令牌中的 1798 个后,同样未返回任何可见内容。. | 默认:共计 946 个令牌,成本字段为 $0.00022845。后续:共计 1846 个令牌,成本字段为 $0.00045345。. | 尚无定论 |
glm-5.3 |
在测试的输出上限范围内未返回任何可见内容。. | 共计 946 个代币,成本字段为 $0.0040244。. | 尚无定论 |
glm-5.2 |
在测试的路由下未返回任何可见内容。. | 共计 947 个代币。美元成本未在同一响应字段中返回。. | 尚无定论 |
gpt-5.6-luna |
提交了一份实用指南,其中包含高吞吐量生成、可预测延迟、摘要支持、信息提取、分类和路由等具体案例。字数接近要求的120个单词。. | 共计 983 个代币。美元成本待定/未退还。. | 通过 |
kimi-k3 |
在测试的路由下未返回任何可见内容。. | 共计1019个代币。美元成本待定/未退还。. | 尚无定论 |
启示 在此路径中进行短文本写入时,尽管GLM-5.3 Flash返回的成本极低,但未能生成可用的可见副本。仅凭价格表,我不会选择它用于写入操作;我会先测试具体的设置。.
测试结果究竟显示了什么
- 就编码成本而言,GLM-5.3 Flash 确实很有意思。. 在采用GLM式思维进行设置后,编码任务得以正常运行,且此次运行的记录成本仍然微乎其微。.
- 默认路由并不支持即插即用。. 在使用推理令牌时,有几个 Flash 响应返回了 HTTP 200 状态码,同时几乎耗尽了全部完成预算。.
- 严格的 JSON 需要额外的验证。. 看起来像 JSON 的回答并不等同于可解析的 JSON,尤其是当该输出将用于自动化流程时。.
- 短篇写作并不是我评判弗拉什的首要标准。. 在此测试中,即使进行了后续设置,写作提示也没有显示出明显的Flash答案。.
我的看法很简单:GLM-5.3 Flash 在注重成本的编码任务中前景可期,但不应将其视为在所有兼容 OpenAI 的路径上都能“即插即用”。在将实际数据量迁移至该模型之前,请设置充足的输出预算,检查推理令牌的行为,并针对计划运行的具体任务类型进行测试。.
GLM-5.3 闪光灯的最佳应用场景
GLM-5.3 Flash 在以下情况下最为合适:任务能从多模态输入、长上下文以及大量重复调用中获益。我不会仅仅因为价格表看起来不错就选择它。只有当任务特征与该模型相匹配时,我才会选择它。.
- 包含大量工具调用的编码代理: 当模型在规划、编辑、测试和修复之间循环往复时,较低的代币定价会有所帮助。.
- 根据截图进行的前端开发: 凭借其对图像输入和编码的侧重,它自然成为 UI 调试和“截图转代码”任务的理想选择。.
- 长上下文代码审查: 当您需要在单次请求中保留更多项目上下文时,1M上下文窗口会非常有用。.
- 涉及大量文档的专业工作: Z.AI 介绍了在 Office 文件、金融研究以及专业文档处理等领域的应用场景。.
- 注重预算的 API 实验: 由于官方定价的价差,在升级到更高级别机型之前,Flash 是一款值得考虑的入门机型。.
如果你主要撰写短篇营销文案,不要仅仅因为Flash更便宜,就认为它是最佳的默认选择。 我们在默认设置和推荐设置下对 Flash 进行的写作测试均未得出明确结论,因为可见内容在选定的输出上限内无法完整呈现。我建议先测试编码和结构化工程任务,然后再决定 Flash 是否也值得纳入你的写作工具集。.
需关注的成本触发条件和 API 设置
GLM-5.3 Flash 最大的风险并非官方代币价格。官方价格本身并不高。真正的风险在于“廉价的请求”与“可用的响应”之间的差距。.
- 推理令牌: 在我们的测试中,在多次运行中,推理令牌消耗了大部分的完成预算。.
- 输出上限: 如果上限较低,即使 HTTP 请求成功,也可能无法返回任何可见内容。.
- 代理循环: 每个“规划-编辑-测试”循环都会使上下文和输出令牌的数量成倍增加。.
- 大背景: 100万个代币虽然有用,但发送超过实际需要的上下文信息仍会影响成本和延迟。.
- 重试次数: 对失败或无输出的配置进行重试会改变每个可用结果的实际成本。.
对于编码任务,我的出发点是:使用官方模型代码,遵循GLM风格的思维设置,为模型预留足够的可见输出空间,并将推理令牌与最终答案令牌分开记录。如果要比较不同路径,应衡量每完成一项任务的成本,而不是每次请求的成本。.
GLM-5.3 Flash 值得购买吗?
如果您的工作负载以编码为主、对成本敏感且由 API 驱动,那么 GLM-5.3 Flash 值得一试。. 官方定价颇具吸引力,第三方基准测试表现强劲,且该模型具备实用的技术规格:原生多模态输入、1M上下文容量,以及专为高效服务而设计的GLM-5系列架构。.
如果您的主要使用场景是普通写作、严格的结构化输出,或者在工作流程中“不可见的推理输出”会造成严重问题,那么我建议您更加谨慎。在这些情况下,请在将数据迁移到闪存之前,先测试具体的路径和设置。模型即使成本低廉,仍需严格遵守配置规范。.
对于希望在选择 API 栈之前先了解模型行为的读者,, GLBGPT 它为您提供了一个便捷的平台,无需为每个服务商都打开单独的标签页,即可比较不同模型的输出结果。一旦您确定了适合您任务的模型,评估官方 API 和定价文档就会变得更加容易。.
常见问题
什么是 GLM-5.3 Flash?
GLM-5.3 Flash 是 Z.AI GLM-5 系列中的一种模型,其 API 模型代码为 glm-5.3-flash. Z.AI 将其描述为一种原生多模态模型,支持 100 万令牌的上下文,并采用成本高效的架构。.
GLM-5.3 Flash 的价格是多少?
根据2026年8月27日的查询结果,Z.AI显示在50%促销期间,GLM-5.3 Flash的费率为每100万输入代币$0.075,每100万输出代币$0.25。 其列出的常规价格为:每100万输入令牌$0.15,每100万输出令牌$0.50。.
GLM-5.3 Flash 是免费的吗?
官方定价页面列出了付费 API 令牌的价格。该页面还显示了一项限时折扣,而非永久免费模式。某些路由或套餐可能会有单独的配额规则,但这些规则应在您实际使用的访问界面中进行确认。.
GLM-5.3 Flash API 的模型代码是什么?
官方模型代码是 glm-5.3-flash.
GLM-5.3 Flash 是否支持图像输入?
是的。Z.AI 的文档中描述了通过 image_url 聊天消息内容数组中的内容块。.
GLM-5.3 Flash 的上下文窗口是什么?
Z.AI 的文档中提到支持 100 万令牌的上下文窗口。OpenRouter 和 Artificial Analysis 也显示了大约 100 万令牌的上下文,但那些是独立的第三方页面。.
GLM-5.3 Flash 比 GLM-5.3 更好吗?
并非绝对如此。GLM-5.3 是一款更强大的模型,适用于复杂编码和长周期任务,而 GLM-5.3 Flash 则成本更低,并支持原生多模态定位。请根据任务类型和成本承受能力进行选择。.
GLM-5.3 Flash 适合编程吗?
它在编码方面前景可期,尤其是在对成本敏感的编码场景中。在我们采用GLM式思维模式设置并提高令牌上限的受控API跟进测试中,它正确修复了一个TypeScript分组错误。在较低的默认输出限制下,由于响应内容几乎没有或完全没有可见内容,部分运行结果无法得出明确结论。.
GLM-5.3 Flash 与 GPT 模型相比如何?
就官方代币价格而言,GLM-5.3 Flash 远比许多旗舰级编码模型便宜,但价格并非唯一因素。在我们进行的小规模默认设置测试中,GPT-5.6 Luna 在三项任务中均返回了可用的输出结果,而 GLM-5.3 Flash 在编码任务中则需要采用推荐设置进行后续处理。.
GLM-5.3 Flash 与 Kimi 相比如何?
Kimi K3 在我们的测试中通过了编码调试任务,但在未进行清理的情况下未能通过严格的 JSON 验证,且在被测路由下的短文写作任务中未返回任何可见内容。这并不意味着 Kimi 的整体表现较差;它仅描述了这套任务和配置的情况。.
在哪里可以试用 GLM-5.3 Flash?
如需访问官方 API,请参阅 Z.AI 的 GLM-5.3 Flash 文档和定价页面。在做出决定之前,若需进行更全面的模型对比,您可以使用 GLBGPT 等多模型平台,在同一界面中对比不同模型的输出结果。.
我应该在生产环境中使用 GLM-5.3 Flash 吗?
只有在对您的具体任务、路径、设置、输出限制和成本记录进行测试后,才可在生产环境中使用该功能。虽然其价格颇具吸引力,但我们的测试表明,配置细节将决定响应结果是否可用。.
最终收获
GLM-5.3 Flash 绝非 GLM-5.3 的一个廉价附带产品。对于注重成本的编码、多模态输入以及长上下文 API 工作而言,它是一个值得认真考虑的新选择。其官方定价极具吸引力,且基准测试表现足够出色,足以证明进行测试是值得的。.
我主要想提醒的是:不要仅凭HTTP 200状态码来判断。请检查可见输出、推理令牌的使用情况以及每个可用答案的成本。如果在您的实际任务中这些指标表现良好,那么GLM-5.3 Flash可能是当前编码堆栈中性价比更高的模型之一。.