型号评测 · 基准测试 · 实际API测试
Gemini 3.7 Flash 被定位为一款适用于编码、智能代理任务、多模态输入及日常创作任务的高速、具备推理能力的模型。更有意义的问题则更具挑战性:当这两个模型收到相同的提示时,它生成的最终作品是否比 Gemini 3.6 Flash 更出色?
本篇关于 Gemini 3.7 Flash 的评测将证据分为三类。谷歌的文档提供了有关模型参数、定价以及官方基准测试声明的支持信息;Artificial Analysis 则提供了独立的第三方基准测试背景信息;而我们的实测对比采用了七项匹配的 API 任务,两款模型均使用了相同的提示词和生成设置。.
Gemini 3.7 Flash 已列入通过 GlobalGPT Gemini 3.7 闪存型号页面. 这样,您就可以在一个地方对多个模型运行同一个提示,包括本评测中使用的基线模型。有关相关背景信息,请参阅我们的 Gemini 3.6 闪评 和 Gemini 3.6 Flash 与 Gemini 3.1 Pro 对比.
Gemini 3.7 闪评:简短总结
在已完成的六组任务中,有三组任务中,Gemini 3.7 Flash 生成的答案完成度更高, ,而Gemini 3.6 Flash则取得了两胜一平的成绩。其优势体现在编码、数据推理以及符合声明要求的SEO编辑方面。Gemini 3.6 Flash编写了更简洁的前端文本方案,并进行了更细致的状态提取,而在代理规划方面则以平局收场。.
评论快照
| 度量 | 观测结果 | 是什么意思 |
|---|---|---|
| 输出质量 | 3.7 胜 3 场;3.6 胜 2 场;1 场平局 | 评判依据是每张卡片上展示的完成作品。. |
| 速度 | 混合型 | 3.7 在四项任务中完成得更快,但3.6在六项任务中的平均成绩略低。. |
| 代币效率 | 3.7 使用了 7,948 个输出令牌;3.6 使用了 10,058 个 | 在所有已完成的任务中,3.7 生成的输出令牌比 21% 少。. |
| 3.7的最高成绩 | 安全无风险的SEO编辑 | 它遵循了已确定的事实,没有添加任何缺乏依据的描述。. |
这六项是小型、受控的文本任务,并非通用模型排名。T01被排除在外,因为两个模型均未在规定的输出上限内完成要求的答案。.
什么是 Gemini 3.7 Flash?
Gemini 3.7 Flash 是谷歌推出的一款稳定的高吞吐量模型,适用于仍需借助推理能力完成的工作。谷歌列出的输入类型包括文本、图像、视频、音频和 PDF;支持的功能包括函数调用、代码执行、搜索锚定、文件搜索、结构化输出以及计算机使用(预览版)。 实际的问题在于,这些控制措施如何转化为最终成果。.
发布日期与供货情况
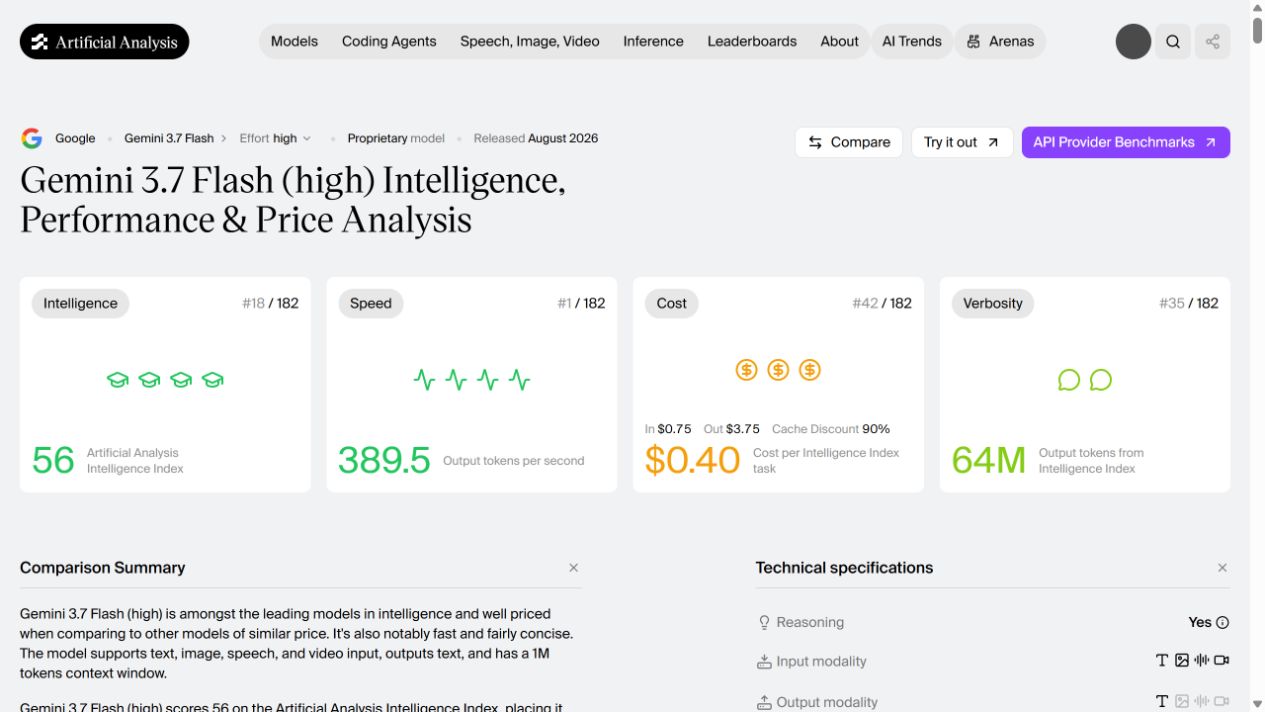
截图中显示的“人工分析”页面标明了 Gemini 3.7 Flash(高)版本,其发布时间列为 2026 年 8 月。如需了解权威状态、型号 ID、支持的功能以及发布详情,请使用 Google 的 官方 Gemini 3.7 闪存模型卡 以及相关联的 API 文档。可用性可能因产品、地区、账户和型号层级而异,因此仅凭列出了某款型号的页面,并不能作为该型号普遍可用的证明。.
与 Gemini 3.6 固件相比,有哪些变化?
这一变化不仅仅体现在基准分数的提升上。谷歌将 Gemini 3.7 Flash 描述为 Gemini 3.6 Flash 的迭代版本,其推理基础和可定制化思维均得到了改进。在我们的配对测试中,这体现在三个任务上对约束的处理能力有所增强,但并未包揽所有任务的胜利。.
| 比较区域 | Gemini 3.7 Flash | Gemini 3.6 Flash | 观察到的证据 |
|---|---|---|---|
| 代码错误修复 | 正确,测试更简洁 | 没错,但更长一些 | 3.7 小胜 |
| 文本前端方案 | 可处理,存在两处编辑错误 | 更简洁,内部一致性更强 | 3.6 微胜 |
| 状态感知提取 | 完全回忆起来了,但有一个被夸大的“成功”标签 | 更精确的状态描述 | 3.6 微胜 |
| 数据推理 | 没错,默认分隔符更清晰了 | 正确,但需补充更多条件细节 | 3.7 小胜 |
| 代理规划 | 强停止门 | 更具体的工具调用细节 | 领带 |
| SEO编辑 | 保留了所有已锁定的索赔 | 添加了一个不受支持的形容词 | 3.7 小胜 |
Gemini 3.7 Flash 规格与上下文窗口
规格很重要,因为它们界定了进行公平比较的条件。如果您比较的是计划限额而非模型行为,那么我们的 Gemini 限额与配额指南 这是更详细的后续说明。上下文窗口的数值并不意味着模型能准确概括每篇长文档;它仅说明该 API 设计上能够处理的范围。下面的提取测试将分别检验召回率、矛盾处理和未知项的处理情况。.
| 规格 | Gemini 3.7 Flash | Gemini 3.6 Flash | 资料来源 |
|---|---|---|---|
| 返回的 API 模型 ID | gemini-3.7-flash | gemini-3.6-flash | 记录的 API 响应 |
| 输入上下文 | 最多 100 万个代币 | 最多 100 万个代币 | Google 模型卡片 |
| 最大文本输出量 | 64K 个代币 | 64K 个代币 | Google 模型卡片 |
| 记录在案的投入 | 文本、图片、音频、视频 | 文本、图片、音频、视频 | Google 模型卡片 |
Gemini 3.7 闪存定价与 API 费用
定价需要明确区分公布费率与单个具体答案的成本。捕获的人工分析摘要显示: 每100万个输入代币为$0.75 和 每100万个输出代币为$3.75 针对所选的 Gemini 3.7 Flash(高)产品条目。这些数据来自第三方页面,不能替代谷歌的官方定价表,也不代表所有接入路径的情况。.
捕获的第三方价格上下文
仅供参考。这些条形图不能替代官方计费单位、计费层级、地区或缓存/批处理规则。.
"(《世界人权宣言》) Google 模型卡片 列出了API的入门费率为 每100万个输入代币为$0.75,每100万个输出代币为$3.75 适用于两款 Flash 机型,有效期至 2026 年 12 月 31 日。下文中的每张卡估算值是将该费率应用于已记录的代币;其中不包括重试、缓存、税费以及特定路由费用。.
| 成本项目 | Gemini 3.7 Flash | Gemini 3.6 Flash | 证据边界 |
|---|---|---|---|
| 初始输入价格 | $0.75 / 1M | $0.75 / 1M | Google 模型卡;有效期至 2026 年 12 月 31 日 |
| 初始出厂价 | $3.75 / 1M | $3.75 / 1M | 不同路线的计费方式可能有所不同 |
| 六组已完成的测试 | 关于 $0.0303 | 关于 $0.0382 | 源自已记录的令牌;不包括 T01 |
Gemini 3.7 Flash 官方基准测试
官方基准测试回答了一个狭义的问题:该模型在已发布的评估中,按照该评估的设置表现如何。这些基准测试虽能提供有用的背景信息,但不能替代本评测中基于相同提示词的输出对比。.
编程、智能体和推理基准测试
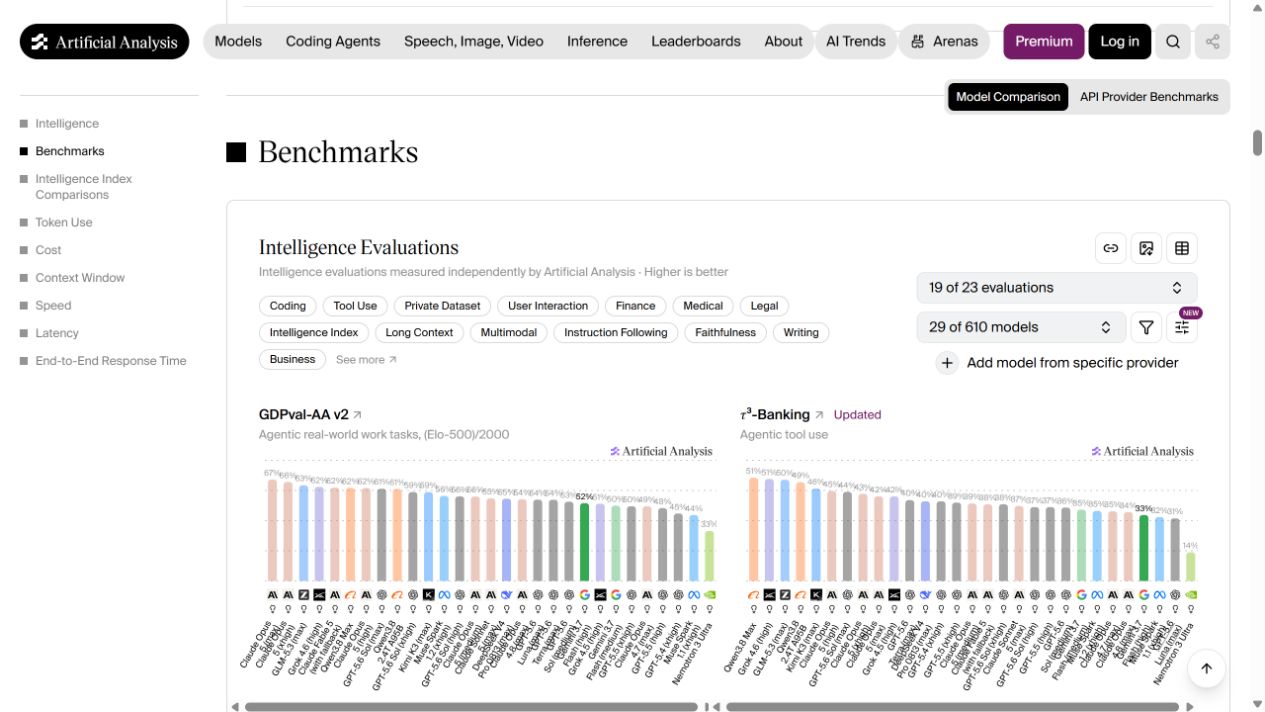
Google 的型号卡片和官方文档是验证 Google 自身基准测试声明的依据。最终版本将针对每个数值列出相应的指标、日期、机型、对比机型以及测试环境。例如,与旧款机型相比获得的 3.7 这一结果,不会被悄然表述为“3.7 对比 3.6”。.
基准测试的收益无法证明什么
- 更高的编码评分并不意味着每个仓库的第一个补丁都更干净。.
- 推理分数并不能证明某人在SEO编辑或截图解读方面更胜一筹。.
- 第三方智力指数不能替代本综述中针对具体任务的证据。.
- 不应将重叠的不确定性或不同的测试设置作为决定性的排名依据。.
我们如何测试 Gemini 3.7 Flash
这是一次匹配的API测试,而非一组互不相关的演示。 两个模型均采用了相同的提示词、源材料、温度值0、输出令牌上限以及呈现方式。T05是在两个模型的首次尝试均触及较低输出上限后,通过共享的5,000令牌重跑获得的评分。T01在两个模型中均未完成,即使经过相同的重跑也是如此。.
| 记录字段 | 为什么重要 |
|---|---|
| 模型 ID 和返回的模型 ID | 确认所请求的模型即为作出响应的模型。. |
| 已过去的时间(秒) | 测量同一路由下的端到端响应时间。. |
| 输入和输出令牌 | 支持提供一份可比的成本估算。. |
| 格式符合性 | 区分正确的答案和仍需在结构上进行整理的答案。. |
| 编辑质量 | 检查正确性、完整性、特异性、呈现方式以及安全性声明。. |
带有请求头但无可用输出的请求将被标记为执行问题,且不会被计为质量损失。.
Gemini 3.7 Flash 实际测试结果
每张卡片都显示了实际的任务要求、每条已保存回复的忠实摘录,以及基于最终成果做出的评估结果。耗时为端到端时间。费用采用上述提到的谷歌入门级费率。.
测试 1 — 研究综述
任务输入: 仅使用提供的四项事实,撰写一篇180词的购买建议,内容应包括一项建议、三个理由、两个未知因素以及一个测试计划。.
Gemini 3.7 Flash
33.427秒 · 85个输入令牌 / 4,996个输出令牌 · 估计值 $0.01880简体中文(大陆)
第二次匹配运行在达到5,000个令牌的上限后停止,随后生成了一个可用的180词推荐结果。.
Gemini 3.6 Flash
28.706秒 · 85个输入令牌 / 4,996个输出令牌 · 估算值 $0.01880简体中文(大陆)
它返回了相同的完成令牌计数和相同的 长度 完成原因。.
输出结果显示了什么
这两款模型首先达到了2,400个令牌,随后在5,000个令牌处再次出现了相同的行为。部分文本不被视为质量证据。.
测试 2 — 代码错误修复
任务输入: 修复 top_paid(records) 返回三个数值最大的已支付记录,在数值相同时保持输入顺序,保留签名,处理空输入,说明原因,并添加两个测试用例。.
Gemini 3.7 Flash
11.379秒 · 90个输入令牌 / 1,431个输出令牌 · 估计 $0.00543
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]它确定了升序排序是导致问题的原因,并测试了过滤、排序、并列情况以及空输入。.
Gemini 3.6 Flash
13.984秒 · 90个输入令牌 / 2,273个输出令牌 · 估计值:$0.00859(简体中文(大陆))
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]它生成了同样正确的补丁,并满足了相同的验收标准,只是响应时间更长。.
输出结果显示了什么
两者都正确地利用了 Python 针对平局情况提供的稳定排序算法。3.7 中的解法更简洁,但最终生成的代码和代码覆盖率是等效的。.
测试 3 — 文本前端实现计划
任务输入: 针对所述的双栏结账页面,制定修复方案,以解决以下问题:多余的空白、层次结构不清晰、"立即支付"标签过小、信任提示可见度低、折扣警告、总金额显示以及移动端页面堆叠问题。. 未提供截图。.
Gemini 3.7 Flash
15.009秒 · 86个输入令牌 / 1,591个输出令牌 · 估计耗时 $0.00603
该方案提出了58/42的网格布局、48–56像素的CTA按钮、附近的信任徽章、琥珀色警告、移动端堆叠布局、焦点状态以及44像素的触摸目标。.
Gemini 3.6 Flash
15.254秒 · 86个输入令牌 / 1,767个输出令牌 · 估计耗时 $0.00669
它呈现了始终如一的 60/40 布局、明确的字体大小、48–52px 的行动号召按钮、有序的右侧栏内容、断点以及无障碍检查。.
输出结果显示了什么
这两处都需要修改。3.7版的答案中写道“点击”可负担性“”,显然是指“可操作性”,还将一个非对称网格称为“对称的”。3.6版需要修改的地方较少。.
测试 4 — 状态感知提取
任务输入: 请用120个词概括关于Orion的九个事实,并附上一张表格,同时保留“已确认”、“计划中”、“待定”、“未知”和“未核实”这几种状态。.
Gemini 3.7 Flash
13.681秒 · 117个输入令牌 / 1,064个输出令牌 · 估计值 $0.00408简体中文(大陆)
报告对图片占比较大的18%项目仍未给出结果,但将82%试点项目的结果描述为“成功”,并将第二个试点项目标记为“已确认/计划中”。”
Gemini 3.6 Flash
9.270秒 · 117个输入令牌 / 1,454个输出令牌 · 估计耗时 $0.00554
该文件中对该试点项目作出了中立描述,称其处理了82%起案件,并将第二个试点项目标注为“已批准(法律程序待定)”。”
输出结果显示了什么
两者均保留了所有重要事实。Gemini 3.6 Flash 对“已批准”、“待定”和“未知”这三种状态的描述更为准确,而 3.7 对首次试飞的描述则略有夸大。.
测试 5 — 数据推理
任务输入: 根据四个渠道的广告支出、点击量、付费转化和收入数据,展示相关计算结果,按可衡量ROAS和转化率进行排序,将零广告支出视为不可衡量,并建议采用“$300”的条件分配方案。.
Gemini 3.7 Flash
16.540秒 · 137个输入令牌 / 1,981个输出令牌 · 估计耗时 $0.00753
ROAS:电子邮件 7.00×,搜索 3.00×,社交媒体 2.60×;合作伙伴数据无法衡量。转化量:电子邮件 12.5%,搜索和合作伙伴 10%,社交媒体 5%。该广告提供了三种条件分组。.
Gemini 3.6 Flash
18.096秒 · 137个输入令牌 / 2,403个输出令牌 · 估计耗时 $0.00911
它生成了相同的排名和边界情况处理方案,随后提供了效率、多元化以及“合伙人测试”分配方案。.
输出结果显示了什么
这两种计算方式都是正确的,且都使该建议带有条件性。两者都围绕“Partner”的零支出添加了推测性内容,因此该句需要来源佐证或予以删除。.
测试 6 — 主动规划与工具使用
任务输入: 仅使用四种已命名的工具,制定一份不超过220词的计划。如果页面不可用、非官方或含义模糊,请停止操作,且不要声称已运行这些工具。.
Gemini 3.7 Flash
10.787秒 · 100个输入令牌 / 1,174个输出令牌 · 估计耗时 $0.00448
其四个步骤与提供的工具一一对应,随后依次经过“官方域名”、“可用性”和“清晰度”三个审核环节。完成该流程需要且仅需一条经过验证的CSV记录。.
Gemini 3.6 Flash
9.702秒 · 100个输入令牌 / 1,328个输出令牌 · 估算值 $0.00506简体中文(大陆)
该方案虽然可行,但增加了“或解析 HTML 正文”这一操作,而该操作超出了所提供工具的范围。.
输出结果显示了什么
两者都遵守“官方来源停止规则”,并避免伪装成已执行工具。3.7方案对可用函数的限制更为严格。.
测试 7 — SEO 写作与编辑
任务输入: 返回的 HTML 内容仅包含一个段落和一个简短列表,精确使用该关键词一次,并保留四个已锁定的事实,切勿杜撰结果、价格、发布日期或可用性声明。.
Gemini 3.7 Flash
7.263秒 · 125个输入令牌 / 707个输出令牌 · 估计 $0.00275
<p>在即将发布的这篇关于 Gemini 3.7 Flash 的评测中,我们将通过对比官方基准测试数据与采用相同提示词的 API 测试结果,对谷歌的该模型进行分析;实际测试结果目前尚未公布。.</p>它遵循了 HTML 结构,仅使用了一次该关键字,并保留了已锁定的声明。.
Gemini 3.6 Flash
7.542秒 · 125个输入令牌 / 833个输出令牌 · 估计耗时 $0.00322
<p>这篇关于 Gemini 3.7 Flash 的初步评测对谷歌的新机型进行了评估……不过详细的实机测试结果目前尚未公布。.</p>结构是正确的,但“新模型”提出了一个超出已定事实范围的主张。.
输出结果显示了什么
决定性的区别在于声明安全性:3.7 版本拒绝添加该无支持依据的描述符,同时返回了有效的紧凑 HTML。.
Gemini 3.7 闪电测试评分表及要点总结
从最终输出质量来看,Gemini 3.7 Flash 在对比中表现更佳,但这种优势主要源于指令执行的严谨性,而非性能上的显著差距。Gemini 3.6 Flash 在代码和算术运算方面仍具竞争力,且生成的前端计划更优。.
配对测试成绩单
| 度量 | Gemini 3.7 Flash | Gemini 3.6 Flash |
|---|---|---|
| 任务胜利 | 3 | 2 |
| 优质领带 | 1 | 1 |
| 结果不明确的任务 | 1 | 1 |
| 可用的已完成任务 | 第 6 页,共 7 页 | 第 6 页,共 7 页 |
| 已完成任务的输出令牌 | 7,948 | 10,058 |
| 最佳观测结果 | 有界能动计划 | 文本前端方案 |
Gemini 3.7 闪存限制
观察到的最大局限性是相同的:在处理一项仅包含180个单词的简单研究综述请求时,这两个模型都耗尽了全部输出配额两次。在测试配置下,T01无法使用。.
Gemini 3.7 Flash 的表现并非全面优异。其前端方案中存在措辞错误,且内部布局与描述不符;而两个数据答案均围绕零消耗通道引入了推测性上下文。 该包仅使用了文本输入,因此无法评估图像、音频、视频或真正长上下文的质量。.
Gemini 3.7 Flash 值得购买吗?
是的,当需要严格遵守指令时,Gemini 3.7 Flash 确实值得测试。. 它在六个可用的任务对中赢得了三项已完成的任务,且总输出令牌数更少。但在简单的代码修复、算术运算或界面规划方面,其表现则不那么突出——在这些任务中,Gemini 3.6 Flash 要么赢得了前端任务,要么表现得非常接近。.
您可以在以下位置运行相同的命令提示符: GlobalGPT 并将其与同一工作区中的 Gemini 3.6 Flash 进行比较。请将您的定期任务作为决定性测试。.
Gemini 3.7 闪评:最终评价
这篇关于 Gemini 3.7 Flash 的评测以一个虽有争议但站得住脚的结论收尾: Gemini 3.7 Flash 赢得了三项已完成的任务,Gemini 3.6 Flash 赢得了两项,还有一项打成平手。. 有一项研究任务未能得出明确结论,因为两个模型都两次达到了共同的输出上限。.
Gemini 3.6 Flash 并未过时。它生成了更优秀的文本前端方案和更严谨的状态表,而 3.7 在编码、数据推理以及基于锁定事实的 SEO 编辑方面表现更强。在代理规划任务上两者不分伯仲,因此此次升级是选择性的,而非绝对的。.
Gemini 3.7 闪存常见问题解答
Gemini 3.7 固件是什么时候发布的?
谷歌将 Gemini 3.7 Flash 列为稳定型号,该型号的文档最后更新于 2026 年 8 月 13 日。.
Gemini 3.7 Flash 版本是稳定版还是预览版?
在 Google 的 Gemini API 模型文档中,该功能被标记为“稳定”。但 AI Studio、Gemini 消费级产品以及第三方接口仍可能显示不同的可用性或配额。.
Gemini 3.7 Flash API 的型号 ID 是什么?
所请求的比较使用了 `gemini-3.7-flash`,但在最终文章将其标记为“已验证”之前,必须先从 API 响应中记录下返回的模型 ID。.
Gemini 3.7 Flash 的价格是多少?
截至2026年12月31日,谷歌付费层级的费率为:每100万个输入令牌$0.75,每100万个输出令牌$3.75; 自2027年1月1日起,列出的费率将调整为$1.50/$7.50。.
Gemini 3.7 Flash 是否免费?
面向消费者或第三方的可用性并不意味着可以无限制地免费访问 API。请查看您计划使用的访问方式对应的接口、配额、速率限制和计费条款。.
什么是 Gemini 3.7 Flash 上下文窗口?
截图中显示的“人工分析”摘要包含一个100万个令牌的上下文列表。请查阅谷歌的文档,确认确切的官方上下文限制,以及针对长上下文的定价或功能限制。.
Gemini 3.7 Flash 是否支持图片、音频、视频和 PDF 文件?
请核实具体 API 模型 ID 所支持的输入类型。在评审过程中,每种受支持的输入模式将被视为文档中记载的功能,而非证明所有输入类型质量均等。.
什么是 Gemini 3.7 闪存思考层级?
Gemini 3.7 Flash 配备了可配置的智能控制功能。具体级别、默认值、代币行为以及计费影响应参考官方 API 文档。.
Gemini 3.7 Flash 比 Gemini 3.6 Flash 更好吗?
在这项匹配的API测试中,Gemini 3.7 Flash在三项完成的任务中胜出,Gemini 3.6 Flash在两项中胜出,一项打平,另一项结果不明确。这表明3.7版本仅具有微弱优势,而非全面胜出。.
Gemini 3.7 Flash 比 Gemini 3.1 Pro 更好吗?
本草案并未作出此类主张。Gemini 3.1 Pro 是一个不同的对比基准,因此需要其专属的匹配提示集和证据,而非基于 Gemini 3.6 Flash 对比结果的推断。.
Gemini 3.7 Flash 适合编程吗?
是的,在本文测试的这一狭义的错误修复任务中,两种模型都生成了正确的最小补丁,但 Gemini 3.7 Flash 因测试覆盖率更干净且完成标记更少,略胜一筹。.
Gemini 3.7 Flash 能否使用工具并运行代理工作流?
请查阅官方工具和函数调用文档以了解确切的执行路径。本评测中的代理测试旨在评估规划能力和边界感知能力;它并不主张仅凭一个计划就能证明工具执行成功。.
在哪里可以获取 Gemini 3.7 固件?
如有提供,请使用谷歌的官方接入点;否则,请尝试 GlobalGPT 型号页面 当该模型在您的账户和所在地区启用时。.
官方基准测试结果与实际使用情况一致吗?
并非自动如此。官方基准测试和第三方评估提供了有用的背景信息,而相同提示词测试则展示了模型如何处理正在被测量的特定任务。本评测将这些证据类型区分开来。.