
Claude Sonnet 4.5 是一款已过时的机型,但其定位十分明确:Anthropic 于 2025 年 9 月 29 日推出该机型,主要用于编码、代理工作流、计算机操作以及长周期多步骤任务。 如果现有应用程序依赖于该模型,决策将取决于以下三点:其编程能力、运行成本以及迁移到其他模型所需的工作量。.
对于那些在研究、写作、编程协助以及特定模型相关任务之间来回切换的开发者来说,, GlobalGPT 提供了一个互联的工作空间. 只需一次订阅,即可获得丰富的模型目录和多种 AI 功能,这是一种经济实惠的方式,可覆盖整个开发工作流。GlobalGPT 的命令行界面(CLI)将该工作流与您的终端及现有开发工具相连接。.
什么是 Claude Sonnet 4.5
Sonnet 4.5 是 Anthropic 推出时实用的中端机型:在处理复杂软件任务时比轻量级机型更强大,而价格却低于其 Opus 系列。Anthropic 的 发布公告 重点强调了编码、计算机应用、代理构建、推理和数学。.
上述陈述描述的是2025年9月的发布版本。这并不意味着Sonnet 4.5将成为2026年最新的Claude选项,而且供应商的基准测试结果并不能保证适用于所有代码库。今天的决策在于:您是需要该模型的已知行为,还是可以切换到更新的默认设置。.
当前 API 状态及停用观察
Claude-sonnet-4-5Anthropic 的型号停产表显示了过时的快照 克劳德-十四行诗-4-5-20250929 作为 活跃 在2026年9月30日查询时。同一行显示: 不早于2026年9月29日. 该表述是一个下限,而非计划停运日期。. 在进行生产环境迁移前,请查看实时生命周期表.
发射证据表明了什么
这些有用的证据既具体又注明了日期。它们说明了为什么第4.5首十四行诗会成为编码的参考点,而测试条件则解释了每个数字能传播多远。.
发布时的计算机使用情况
OSWorld的成功率,采用0–100%的评分标准。数值越高越好。.
资料来源 Anthropic 发布公告, ,2025年9月29日;2026年9月28日核查。报告中的评估结果提高了19.2个百分点;但这并不意味着在所有桌面任务中都能保证成功。.
| 证据 | 发射时期的结果 | 如何阅读 |
|---|---|---|
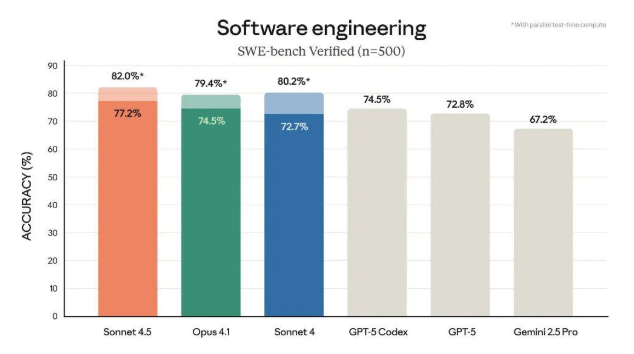
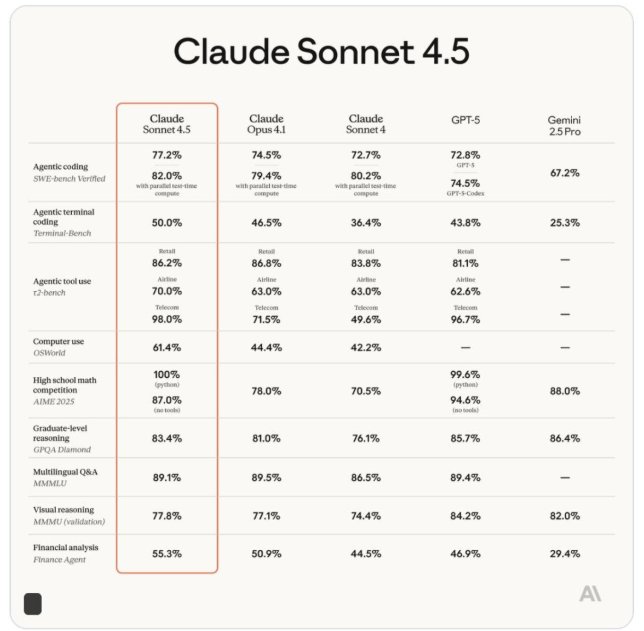
| SWE-bench 验证 | 77.2% 初选结果 | 500道题,取10次尝试的平均值,不额外计算测试时间,思考预算为20万 |
| SWE-bench 高计算变体 | 82.0% | 并行尝试、可见回归过滤和内部候选项选择 |
| 操作系统世界 | 61.4% 对阵 Sonnet 4(42.2%) | Anthropic报道的计算机使用基准测试对比 |
Anthropic的主要77.2% SWE-bench验证结果涵盖了全部500道题目,每道题平均进行10次尝试,未使用额外的测试时间计算资源,且思考预算为200K。 82.0%这一数值来自另一套高计算资源配置,该配置采用了并行尝试、可见回归过滤以及内部候选项选择机制。这些属于不同的评估条件。.
Anthropic在OSWorld上的测试成绩为61.4%,而四个月前Sonnet 4的成绩为42.2%。OSWorld测试的是计算机使用任务,因此该结果反映了与软件环境的交互情况;它并不能预示在所有桌面工作流程中都能取得成功。.
Anthropic 表示,他们观察到 Sonnet 4.5 在执行复杂的多步骤任务时,能够保持专注超过 30 小时。这只是厂商的观察结果,并不意味着每个用户任务都会运行 30 小时,也不意味着不间断的自主运行总是可取的。.
发布时的代码和代理升级
该版本包含模型和工具方面的更新。Anthropic 版本重点推出了用于保存和回滚进度检查点、焕然一新的终端、原生 VS Code 扩展、上下文编辑和内存工具、代码执行和文件创建功能,以及 Claude Agent SDK。.
- 检查站 在长时间的编码过程中,帮助从一次失误中恢复过来,同时避免整个运行结果丢失。.
- "(《世界人权宣言》) 克劳德代理 SDK 揭示了 Claude 代码所使用的 Anthropic 基础架构,以便团队能够构建针对特定任务的智能代理。.
- 并行工具的使用和长期任务是此次发布内容的一部分;请在正式文档中查阅当前的命令和菜单。.
- Claude 代码、API 和 Web 应用是各自独立的访问途径。请选择与您的权限、计费和审核流程相匹配的那一种。.
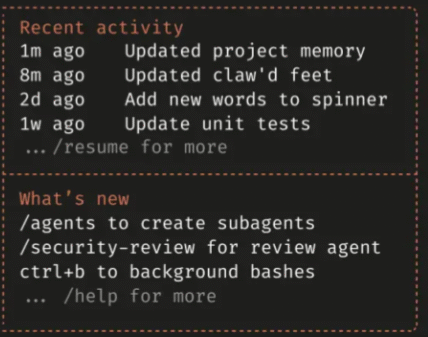
有关实现细节,请参考 Anthropic 的实时开发者文档,而非照搬 2025 版的发布说明。模型 ID 是一个可靠的起点;应根据最新的 API 和 Claude 代码文档来核对工具和客户端的行为。.
发布公告还引用了Cursor首席执行官迈克尔·特鲁埃尔(Michael Truell)的评价,称其在编码性能和长期任务执行方面表现更佳。这一用户评价有助于解释该版本对开发者的吸引力,而上述基准测试方法则提供了更精确的比较依据。.
API 定价与访问
"(《世界人权宣言》) Anthropic 价格表 该页面显示,Sonnet 4.5 的定价为每百万输入令牌 $3,每百万输出令牌 $15。其定价表还列出了针对重复使用长上下文的工作负载所适用的较低批处理速率以及提示词缓存读写速率;该定价页面于 2026 年 9 月 28 日进行了核查。.
| API 路由 | 输入 | 输出 | 当它合适时 |
|---|---|---|---|
| 标准 API | $3 / MTok | $15 / MTok | 交互式请求和常规生产调用 |
| 批处理应用程序接口 | $1.50 / MTok | $7.50 / MTok | 异步批量处理;Anthropic 记录了 50% 的代币折扣 |
| 提示词缓存 | $3.75 / MTok(5分钟写入)或 $6 / MTok(1小时写入) | — | 重复的长时间提示;缓存读取为 $0.30 / MTok |
相同的工作负载:标准模式与批处理模式
100,000 个未缓存的输入令牌 + 10,000 个输出令牌。单位:美元;从零基线扩展至 $0.45。.
根据以下内容计算: Anthropic的价目表, ,查阅于2026年9月28日。当适用异步处理时,批量处理可将该代币费用减少50%。不包括缓存、区域修饰符及其他费用;此为示例,并非实际计费金额。.
一个包含 100,000 个未缓存输入令牌和 10,000 个输出令牌的请求,在未考虑缓存、数据驻留或其他调整因素的情况下,按标准费率计算约为 $0.45。 在“批处理”模式下,相同数量的令牌消耗约为 $0.225。这些仅为算术示例,并非计费报价。.
对于消费者版应用、Claude 代码、GlobalGPT 以及 API,访问和计费方式可能有所不同。如果您希望在多模型工作区中使用 Sonnet 4.5,, 打开当前的 GlobalGPT Sonnet 4.5 页面. 如需直接调用生产环境的 API,请参考 Anthropic 的控制台和 API 文档。.
如何在当今时代运用第4.5首十四行诗
有三种合理的方案,每种方案都能解决不同的问题:
- GlobalGPT 工作区: 在 Sonnet 4.5 中打开其他模型和函数 当您希望在聊天、研究、写作或编程辅助方面进行无缝协作,而无需管理多个独立的模型界面时。.
- Anthropic API: 使用
Claude-sonnet-4-5在“消息”API 中,当您拥有该应用程序、需要直接计费或希望固定一个快照时。. - Claude 代码或编辑器集成: 当代码库操作、Shell 访问权限和代码审查权限与模型本身同样重要时,请使用该工具路径。.
安全性证据
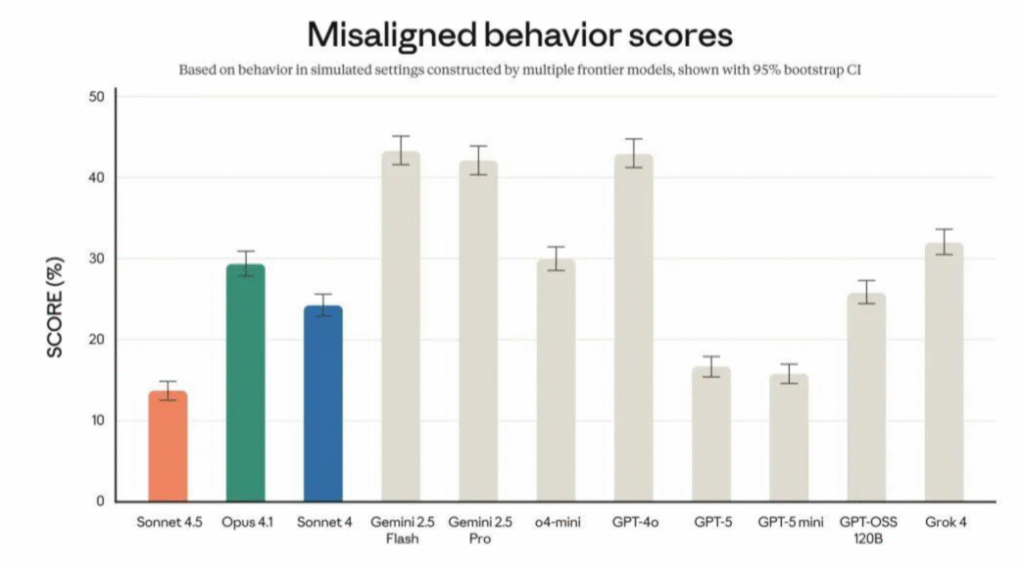
Anthropic的发布公告将Sonnet 4.5描述为当时与其理念最为契合的前沿模型,并报告称该模型在阿谀奉承、欺骗、追求权力以及助长妄想思维等行为方面有所减少。公告还描述了在针对代理系统和计算机使用系统的提示注入方面取得的进展。.
随附的行为审计图所涵盖的范围比全面的安全保证更为有限。该图标注为模拟环境,并采用了 95% 自举置信区间;分数越低越好。该结果仅为受测配置提供了证据,并不能证明每次部署都是安全的,也不能证明提示注入现象已不复存在。.
阅读 Claude Sonnet 4.5 系统卡 在将该模型应用于影响重大的工作流程之前,请先了解其评估详情和局限性。.
当前的替代方案及兼容性指南
Anthropic’s 当前车型概览 在 4.5 快照旁边列出了较新的家族。选择取决于具体任务:
保留十四行诗第4.5首
当您的集成、提示集或回归历史记录依赖于 2025 版本的行为,且生命周期行仍支持您的部署时,请选择此选项。.
切换到较新的 Sonnet 版本
如果您希望采用受支持的默认设置,并且在更改模型 ID 之前能够进行兼容性验证,请选择当前的 Sonnet 系列。.
使用另一个家族
若需更深入的推理,请选择 Opus 风格的模型;若追求速度且工作负载较轻,请选择 Haiku 风格的模型;请根据您实际运行的任务进行验证。.
有关 Claude 特定的比较路径,请参见 GlobalGPT的Claude Sonnet 4.5替代方案指南. 关于 API 和套餐背景,, 当前的 Claude 定价指南 解释了订阅、API 费用和使用限制之间的相互关系。.
Sonnet 4.5 现在还值得使用吗?
是的,当工作涉及兼容性敏感的编码、已知的 Claude Code 工作流,或是基准测试和回归测试参考时。发布证据仍然有用,API ID 明确,且生命周期页面显示该快照在最近一次记录的检查中状态为“活动”。.
如果没有兼容性限制,将其作为新的通用默认选项就没那么有吸引力了。较新的受支持模型可能提供更优的当前工具或推理能力,而且2026年9月29日的下界退役时间线使得制定迁移计划变得合理。请对比您自己的提示词和工具调用,然后选择能够通过您所需工作流测试的模型。.
常见问题
什么是克劳德·索内特 4.5?
这是 Anthropic 的 2025 年 9 月编码模型和代理模型。其 API 模型 ID 为 Claude-sonnet-4-5, ,附带带日期的快照 克劳德-十四行诗-4-5-20250929.
Claude Sonnet 4.5 还在运营吗?
在 2026 年 9 月 30 日核查时,Anthropic 的生命周期表显示该过期快照的状态为“活动”。该行还注明“不早于 2026 年 9 月 29 日”,这仅是一个下限,而非固定的退役日期。在进行长期部署之前,请重新核查实时表。.
Sonnet 4.5 API 的价格是多少?
标准定价为:每百万个输入令牌收取 $3,每百万个输出令牌收取 $15。批量定价分别为 $1.50 和 $7.50。缓存写入和读取分别采用不同的费率。.
Claude Sonnet 4.5 是免费的吗?
直接使用 API 按令牌计费。通过 Claude 或 GlobalGPT 访问时,需遵循相应服务的套餐及使用限制;在启动大规模工作负载之前,请先确认所选服务。.
“30小时”这一说法是用户保证吗?
No. Anthropic 表示,其在复杂的多步骤任务中进行了超过 30 小时的测试。这只是供应商过时的观察结果,并非对每位用户或每种工作负载的承诺。.
第4.5首十四行诗比第ChatGPT首第5首更好吗?
如果没有任务、提示集、工具和评分规则,就不可能有唯一的赢家。请根据模型在编码、推理和工具使用工作流方面的表现进行比较,而不是将搜索片段作为基准。.
若要将 Sonnet 4.5 与其他 AI 工具配合使用,, 打开当前的 GlobalGPT 模型页面. 先从一个真实的编程问题或调试任务入手,然后将同一项目背景延伸到研究和文档编写中。.





