คำตอบด่วน: ลงทุนใน AI ที่ช่วยปรับปรุงงานที่คุณทำซ้ำทุกสัปดาห์ได้อย่างน่าเชื่อถือ การวิจัยแบบ Perplexity คุ้มค่าที่จะลงทุนเมื่อแหล่งข้อมูลมีความสำคัญ โมเดลทั่วไปที่มีประสิทธิภาพสูงก็คุ้มค่าที่จะลงทุนเมื่อคุณต้องปรับกลยุทธ์ วิเคราะห์ และเขียนทั้งวัน โมเดลการเขียนโค้ดก็คุ้มค่าที่จะลงทุนเมื่อมันเข้ากับวงจร “แก้ไข-ทดสอบ-ทบทวน” ส่วนโมเดลภาพและวิดีโอก็คุ้มค่าที่จะลงทุนเมื่อผลลัพธ์ของมันช่วยลดเวลาในการผลิต.
คู่มือนี้รวมข้อมูลอ้างอิงผลิตภัณฑ์อย่างเป็นทางการ การวิเคราะห์จากสื่อผู้พัฒนาอิสระที่มีชื่อเสียง และการเปรียบเทียบแบบทดลองใช้จริงในวงจำกัด ซึ่งดำเนินการเมื่อวันที่ 1 กันยายน 2026 การทดสอบนี้ถูกออกแบบให้มีความเฉพาะเจาะจง: ใช้คำสั่งเดียวและผลลัพธ์หนึ่งชุดต่อโมเดล เพื่อแสดงให้เห็นความแตกต่างในกระบวนการทำงานที่มีประโยชน์ แต่ ไม่ พิสูจน์การจัดอันดับแบบสากล. ประกาศ: GlobalGPT เป็นผู้ดำเนินการเผยแพร่เนื้อหาฉบับนี้.
ซื้อการอ้างอิงและแหล่งข้อมูลล่าสุด.
ซื้อการแก้ไขที่คุณสามารถขอปรับแก้ได้.
รับความคิดเห็นในวงจรการทำงานจริงของคุณ.
ซื้อผลผลิตที่แทนที่การผลิต.

สิ่งที่คุณกำลังจ่ายจริง ๆ เมื่อซื้อ AI
การเข้าถึงแบบฟรีก็เพียงพอสำหรับงานที่ทำเป็นครั้งคราว ส่วนแพ็กเกจแบบเสียเงินจะสร้างรายได้เมื่อมีการเปลี่ยนแปลง ค่าใช้จ่ายในการดำเนินงาน ในการทำงาน: จำนวนแท็บเบราว์เซอร์ที่น้อยลง, การเขียนร่างแรกด้วยมือที่น้อยลง, วงจรรับ-ส่งความคิดเห็นที่เร็วขึ้น, การเข้าถึงข้อมูลล่าสุดที่ดีขึ้น หรือผลลัพธ์ที่เริ่มต้นใกล้กับมาตรฐานคุณภาพขั้นสุดท้ายมากขึ้น ความผิดพลาดที่เสียค่าใช้จ่ายสูงคือการจ่ายเงินเพื่อเข้าถึงบริการ แล้วใช้บริการนั้นเหมือนกล่องค้นหาที่เพียงเพื่อความแปลกใหม่เท่านั้น.
วิธีตัดสินใจว่า AI ตัวไหนคุ้มค่าที่จะจ่ายเงินซื้อ
คำถามที่ผิดคือ “โมเดลไหนฉลาดที่สุด?” ส่วนคำถามที่มีประโยชน์คือ “แพ็กเกจสมัครสมาชิกไหนจะช่วยแก้ปัญหาคอขวดที่เกิดขึ้นซ้ำๆ ของผมได้ โดยใช้ทรัพยากรในการตรวจสอบน้อยที่สุด?” ผู้ก่อตั้งที่ต้องการงานวิจัยการแข่งขันที่มีการอ้างอิงมีเหตุผลในการซื้อที่ต่างจากวิศวกรที่กำลังแก้ไขข้อผิดพลาดในรีโพสิตอรี หรือนักการตลาดที่กำลังผลิตเนื้อหาผลิตภัณฑ์รายสัปดาห์ เริ่มด้วยการระบุสามงานที่ทำซ้ำๆ ของคุณ แล้วทดสอบแต่ละตัวเลือกตามข้อกำหนดจริงเดียวกัน.
มันทำงานนี้อย่างน้อยสัปดาห์ละครั้ง.
คุณสามารถแยกแยะผลลัพธ์ที่ดีกว่าจากผลลัพธ์ที่แย่กว่าได้.
เวลาที่ประหยัดได้มากกว่าเวลาที่ใช้ในการเปลี่ยนและตรวจสอบ.
การวิจัย: Perplexity คุ้มค่าที่จะจ่ายเงินซื้อหรือไม่?
สำหรับคำถามเกี่ยวกับตลาดแบบเรียลไทม์ ควรให้ความสำคัญกับความสามารถในการวิจัยก่อนที่จะเน้นรูปแบบการเขียนที่สวยงาม Perplexity เป็นบริการที่ให้ความสำคัญกับการวิจัยเป็นอันดับแรก: คุณค่าของมันอยู่ที่คำตอบที่สามารถตรวจสอบได้พร้อมแหล่งข้อมูลที่คุณสามารถตรวจสอบได้ แทนที่จะเป็นบทสรุปที่มั่นใจแต่ไม่มีแหล่งอ้างอิง ซึ่งทำให้มันเป็นตัวเลือกที่น่าเชื่อถือสำหรับนักวิเคราะห์ ผู้ซื้อ ผู้เขียน และทีมที่กำลังเตรียมเอกสารสรุปที่จำเป็นต้องอ้างอิงแหล่งข้อมูลอย่างละเอียด เปรียบเทียบบทบาทของมันกับ Gemini ในส่วนนี้ การเปรียบเทียบคุณสมบัติของ Gemini กับ Perplexity, และใช้รายชื่อนี้ของ ทางเลือกที่สร้างความสับสน เมื่อคุณต้องการกระบวนการวิจัยที่แตกต่างออกไป.
อย่าซื้อแผนการวิจัยเพียงเพื่อเขียนอีเมลหรือสรุปบันทึกที่มีอยู่ในแล็ปท็อปของคุณอยู่แล้ว ผลประโยชน์ที่ได้รับจะเพิ่มขึ้นตามค่าใช้จ่ายของข้ออ้างที่ล้าสมัยหรือไม่ได้รับการสนับสนุน ในทางปฏิบัติ ให้ใช้การวิจัยเพื่อรวบรวมและตรวจสอบแหล่งข้อมูล แล้วส่งหลักฐานไปยังโมเดลการวิเคราะห์เพื่อสร้างบันทึกการตัดสินใจ การแบ่งงานเช่นนี้จะช่วยให้ตรวจพบข้อผิดพลาดได้ง่ายขึ้น.
GPT, Claude และ Gemini: ผลลัพธ์ที่การทดสอบกลยุทธ์แสดงให้เห็นจริง ๆ
เราได้มอบโจทย์ที่มีข้อจำกัดเดียวกันให้กับ GPT-5.6 Sol, Claude Sonnet 5 และ Gemini 3.6 Flash: เปิดตัวฟีเจอร์วิเคราะห์ข้อมูล B2B ภายในหกสัปดาห์ ด้วยวิศวกรสองคน งบประมาณคงที่ คำขอจากฝ่ายขายเกี่ยวกับ SSO และกระบวนการ onboarding ที่ไม่สำเร็จ ทุกคำตอบต้องระบุสมมติฐานที่นำมาใช้, จัดทำแผนงาน 6 สัปดาห์, ชี้ให้เห็นความเสี่ยงที่ซ่อนอยู่, และเขียนรายงานอัปเดตสำหรับผู้บริหาร นี่เป็นตัวอย่างงานที่ทำเพียงครั้งเดียว ไม่ใช่การวัดผลมาตรฐาน.
“กำหนดขั้นตอนการทำงานด้านการวิเคราะห์ข้อมูลที่เล็กที่สุดที่สามารถใช้งานได้” และตัดสินใจว่า SSO จะอยู่ในขอบเขตโครงการหรือไม่ เป็นโครงการทดลองเท่านั้น หรือจะเลื่อนการดำเนินการออกไป ก่อนที่จะให้ทีมเริ่มทำงาน.
“คุณไม่สามารถสร้างคุณสมบัติวิเคราะห์ข้อมูลใหม่ แก้ไขปัญหาการเริ่มต้นใช้งานที่ยังไม่ได้รับการวินิจฉัย และจัดตั้งระบบ SSO สำหรับองค์กร ในช่วงเวลาเดียวกันได้ โดยยังคงรักษาคุณภาพไว้อย่างเต็มที่”
แบ่งงานของนักพัฒนาทั้งสองกลุ่มออกเป็นสองส่วน: การปรับให้ระบบใหม่ทำงานได้อย่างเสถียร และการสร้างพื้นฐานข้อมูลวิเคราะห์ แล้วจึงรวมงานทั้งสองส่วนเข้าด้วยกันในสัปดาห์ถัดไป.
ได้จัดทำรายชื่อสมมติฐานที่ครอบคลุมที่สุด ซึ่งรวมถึงเรื่องการปฏิบัติตามข้อกำหนด เกณฑ์การเปิดตัว และตัวชี้วัดความสำเร็จ แต่ไม่ได้สร้างตัวชี้วัดประสิทธิภาพขึ้นมาเอง.
ได้กำหนดจุดสมดุลด้านความจุที่ชัดเจนที่สุด: ไม่ควรบังคับให้รวม SSO ที่ปรับแต่งเอง ระบบวิเคราะห์ข้อมูล และกระบวนการ onboarding ที่ยังไม่เสร็จสมบูรณ์ เข้าไปในโครงการเปิดตัวที่มีวิศวกรเพียงสองคน.
ให้ข้อมูลการแบ่งงานระหว่างผู้พัฒนาตามสัปดาห์ที่ชัดเจนที่สุด แต่สมมติว่ามีแดชบอร์ดที่สร้างไว้ล่วงหน้าและการแยกข้อมูล ซึ่งข้อมูลเหล่านี้ไม่ได้ระบุไว้ในเอกสารข้อกำหนด.
ข้อควรพิจารณาในการซื้อ: GPT เป็นตัวเลือกแรกที่แข็งแกร่งเมื่อคุณให้ความสำคัญกับการตรวจสอบสมมติฐานอย่างกว้างขวาง; Claude เมื่อสิ่งที่สำคัญคือการตัดสินใจทางบรรณาธิการที่ชัดเจน; Gemini เมื่อแผนการส่งมอบที่มีโครงสร้างเป็นสิ่งสำคัญ โปรดตรวจสอบบรีฟของคุณอีกครั้งก่อนตัดสินใจใช้ GPT สำหรับการเข้าถึง GPT และบริบทของแผน โปรดดูที่ คู่มือราคา GPT-5.6 และ การเปรียบเทียบรุ่น GPT-5.6.
หน้าผลิตภัณฑ์อย่างเป็นทางการยังคงเป็นแหล่งข้อมูลที่ดีที่สุดเพื่อตรวจสอบรายละเอียดของแพ็กเกจและคุณสมบัติปัจจุบัน: แชทจีพีที, โคลด, และ ราศีเมถุน. หน้าผลิตภัณฑ์อธิบายว่าผู้ขายแต่ละรายมีอะไรเสนออยู่ในขณะนี้; การทดสอบข้างต้นบันทึกเพียงผลลัพธ์จากการรันทั้งสามครั้งนี้กับคำสั่งที่มีข้อจำกัดเฉพาะนี้เท่านั้น.
วิธีที่กลุ่มโมเดลหลักต่าง ๆ เหมาะสมกับประเภทงานต่าง ๆ
แผนแรกที่ดีที่สุดสำหรับผู้ที่ทำงานสลับกันระหว่างการวิเคราะห์ การร่างเอกสาร การตีความข้อมูล การวางแผน และการแก้ปัญหา ให้ประเมินว่าแผนดังกล่าวเปิดเผยสมมติฐานหรือไม่ และมีการปรับปรุงหลังจากได้รับคำวิจารณ์โดยตรง.
โปรดติดตาม: คำตอบที่ได้รับการปรับปรุงแล้ว แต่ยังจำเป็นต้องตรวจสอบแหล่งที่มาหรือทบทวนด้านเนื้อหา.
มักเป็นตัวเลือกที่เหมาะสมอย่างยิ่งเมื่อผลลัพธ์ที่ต้องการคือการเขียนข้อโต้แย้ง เอกสารสรุป การเขียนใหม่ นโยบาย หรือการตัดสินใจด้านบรรณาธิการ ซึ่งความละเอียดอ่อนและการชั่งน้ำหนักอย่างชัดเจนมีความสำคัญมากกว่าการมีรายการงานที่ครบถ้วนที่สุด.
โปรดติดตาม: การถือข้อความร้อยแก้วที่เขียนอย่างไพเราะเป็นงานวิจัยเชิงข้อเท็จจริง โดยไม่ตรวจสอบแหล่งข้อมูล.
เป็นตัวเลือกที่เหมาะสมสำหรับผู้ที่ต้องการแผนงาน ตาราง และการแบ่งงานออกเป็นส่วนย่อย โดยเฉพาะอย่างยิ่งเมื่องานนั้นดำเนินการผ่านบริการของ Google อยู่แล้ว ลองทดสอบดูว่ามันจัดการกับข้อมูลที่ขาดหายไปอย่างไร แทนที่จะสมมติรายละเอียดการนำไปใช้.
โปรดติดตาม: แผนที่ดูดีแต่สร้างขึ้นบนสมมติฐานที่ยังไม่ได้รับการยืนยัน.
ควรนำมาเปรียบเทียบกันในด้านงานทางเทคนิค การเขียนโค้ด การใช้งานสองภาษา และการทดลองที่ให้ความสำคัญกับมูลค่า ทางเลือกที่ถูกต้องขึ้นอยู่กับภาษาและอินเทอร์เฟซของคุณ รวมถึงว่าผลลัพธ์นั้นจะผ่านการทดสอบชุดทดสอบของคุณได้หรือไม่.
โปรดติดตาม: ประหยัดค่าใช้จ่ายในการสมัครสมาชิก แต่ต้องเสียเวลาไปกับการตรวจสอบเพิ่มเติมหรือเครื่องมือที่ไม่เหมาะสม.
จ่ายเมื่องานเริ่มขึ้นด้วยคำตอบที่ทันสมัยและมีการอ้างอิง ข้อได้เปรียบของเครื่องมือเหล่านี้ไม่ใช่การแทนที่การคิด แต่คือการทำให้การรวบรวมหลักฐานและการตรวจสอบแหล่งข้อมูลเป็นไปอย่างรวดเร็วขึ้น.
โปรดติดตาม: การอ้างอิงโดยไม่เปิดแหล่งข้อมูลต้นฉบับ.
ผู้เชี่ยวชาญจะเริ่มมีประโยชน์เมื่อคุณมีข้อกำหนดงานที่สามารถทำซ้ำได้ ข้อจำกัดของแบรนด์ และกระบวนการแก้ไขผลงาน โดยผลงานแรกที่พวกเขาสร้างขึ้นมักเป็นแนวทางเท่านั้น ไม่ใช่ผลงานสร้างสรรค์ที่พร้อมสำหรับการอนุมัติ.
โปรดติดตาม: การจ่ายเงินให้โมเดลเมื่อโครงการแบบครั้งเดียวไม่สามารถชดเชยค่าใช้จ่ายในการปรับปรุงได้.
สำหรับงานทางเทคนิค กฎที่คล้ายกันก็ใช้ได้เช่นกัน ให้ดำเนินการงานตัวอย่างขนาดเล็กก่อนที่จะเริ่มงานอัตโนมัติขนาดใหญ่: ขอการวิเคราะห์ปัญหา การปรับเปลี่ยนขั้นต่ำ แผนการทดสอบ และความเสี่ยงที่ยังไม่ได้รับการแก้ไข พฤติกรรมของโมเดลที่แข็งแกร่งไม่ใช่เพียงการสร้างโค้ดเท่านั้น แต่ยังช่วยชี้ให้เห็นว่าจุดใดที่ยังจำเป็นต้องมีนโยบายผลิตภัณฑ์หรือบริบทของรีโพสิตอรี นั่นคือเหตุผลที่ รีวิว DeepSeek V4 Pro และ การทบทวนแผนการเขียนโค้ด GLM เป็นบทความที่ควรอ่านต่อ ซึ่งมีประโยชน์มากกว่าการอ้างแบบทั่วไปว่า “AI สำหรับการเขียนโค้ดที่ดีที่สุด” เพียงอย่างเดียว.
การเขียนโค้ด: จ่ายค่าให้กับโมเดลที่ช่วยปรับปรุงวงจรการตรวจสอบ
ในการเขียนโค้ด อินเทอร์เฟซมีความสำคัญเกือบเท่ากับโมเดล เราได้ขอให้ GPT-5.6 Sol และ DeepSeek V4 Pro วิเคราะห์และแก้ไขปัญหา JavaScript อย่างเรียบง่าย รวม (จำนวนสินค้า) ฟังก์ชัน ที่มีข้อผิดพลาดที่ชัดเจนสำหรับราคาและปริมาณที่ขาดหายไป ไม่ถูกต้อง หรือไม่เป็นค่าบวก พร้อมด้วยการทดสอบสามครั้ง และหมายเหตุเกี่ยวกับความเสี่ยง GPT-5.6 Sol ได้สร้างการนำไปใช้ที่กระชับโดยใช้ Number.isFinite, ข้อความข้อผิดพลาดที่มีการจัดเรียงตามดัชนี, การตรวจสอบความถูกต้องของ Node, และหมายเหตุที่สมเหตุสมผลเกี่ยวกับปริมาณเศษส่วน DeepSeek V4 Pro ได้ระบุอย่างถูกต้องว่า NaN ดัก, ได้ปรับปรุงการป้องกันที่อ่อนแอในตอนแรกให้ Number.isFinite, และยังได้ชี้ให้เห็นถึงการตรวจสอบความถูกต้องของอาร์เรย์ที่ยังขาดอยู่ด้วย.
GPT-5.6 Sol: การแก้ไขการตรวจสอบความถูกต้องพร้อมการทดสอบที่ทำงานได้
คำชี้แจงงานร่วมกัน
การนำโค้ดกลับมาใช้ใหม่
สังเกตเห็นใน GlobalGPT: ผลลัพธ์ยังคงเก็บค่าเศษส่วนไว้อย่างชัดเจน ตามนโยบายที่ยังเหลืออยู่ โปรดทดสอบในรีโพสิตอรีของคุณเองก่อนที่จะส่งออกไป.
สิ่งนี้ไม่ได้หมายความว่าฝ่ายใดฝ่ายหนึ่งเป็นผู้ชนะอย่างเด็ดขาดในด้านการเขียนโค้ด แต่ชี้ให้เห็นว่าผู้ช่วยเขียนโค้ดที่มีค่าจ้างดีควรอธิบายขอบเขตการตรวจสอบความถูกต้อง จัดเตรียมการทดสอบที่สามารถรันได้ และระบุการตัดสินใจด้านนโยบายที่ยังเหลืออยู่ แทนที่จะซ่อนมันไว้ อ่าน รีวิว DeepSeek V4 Pro และ การทบทวนแผนการเขียนโค้ด GLM เพื่อบริบทเฉพาะเส้นทาง Kimi Code’s หน้าการเขียนโค้ดอย่างเป็นทางการ เป็นกระบวนการทำงานอีกอย่างหนึ่งที่ควรพิจารณาเมื่อการใช้ CLI เป็นส่วนสำคัญ.
นักพัฒนาควรประเมิน AI สำหรับการเขียนโค้ดแบบเสียเงินอย่างไร
อย่าประเมิน AI สำหรับการเขียนโค้ดโดยใช้คำสั่งแบบ greenfield เช่น “สร้างแอป To-Do” ใช้ภารกิจที่มีขอบเขตชัดเจนจากรีโพสิตอรีที่คุณเข้าใจ: การทดสอบที่ล้มเหลว, ข้อผิดพลาดที่เฉพาะเจาะจง, กฎการตรวจสอบความถูกต้องที่ยังไม่สมบูรณ์, หรือการอัปเดตเอกสารที่เกี่ยวข้องกับโค้ดจริง ขอให้ผู้ช่วยระบุพฤติกรรมที่มันคิดว่าจำเป็นอีกครั้งก่อนที่จะเปลี่ยนแปลงอะไรก็ตาม สิ่งนี้จะแสดงให้เห็นว่ามันได้อ่านภารกิจอย่างละเอียดหรือไม่ หรือกำลังใช้เทมเพลตที่คุ้นเคย.
ต่อไป ให้ตรวจสอบสี่ข้อ ดังนี้ ข้อแรก มันสามารถแยกแยะระหว่างอาการกับสาเหตุหลักได้หรือไม่ ข้อที่สอง มันเสนอการแก้ไขที่เล็กที่สุดแต่ยังคงความสอดคล้องได้หรือไม่ แทนที่จะปรับโครงสร้างโมดูลที่ไม่เกี่ยวข้องกัน ที่สาม มันสร้างการทดสอบที่ล้มเหลวสำหรับข้อผิดพลาดเดิมและผ่านการทดสอบสำหรับวิธีแก้ไขหรือไม่? ที่สี่ มันระบุการตัดสินใจเกี่ยวกับผลิตภัณฑ์ที่ยังไม่ถูกกำหนดไว้หรือไม่ เช่น การปัดเศษ การอนุญาต ความเข้ากันได้กับเวอร์ชันเก่า หรือนโยบายข้อความข้อผิดพลาด? คำถามเหล่านี้มีประโยชน์มากกว่าคะแนนทั่วไปแบบ “เขียนโค้ดได้หรือไม่” เพราะมันสัมพันธ์โดยตรงกับเวลาที่ใช้ในการตรวจสอบ.
รูปแบบการส่งมอบส่งผลต่อด้านเศรษฐกิจ หน้าต่างแชทเหมาะสำหรับการวินิจฉัย การอธิบายโค้ด และโค้ดตัวอย่างสั้นๆ ส่วนตัวแก้ไข CLI หรือกระบวนการทำงานที่เชื่อมต่อกับ MCP จะมีประโยชน์มากขึ้นเมื่อจำเป็นต้องส่งข้อมูลบริบทอย่างปลอดภัยระหว่างไฟล์ คำสั่ง และการทดสอบ แต่การเข้าถึงที่ลึกขึ้นก็ทำให้มาตรฐานการตรวจสอบสูงขึ้นด้วย: อย่าปิดการทดสอบปกติ สิทธิ์ หรือการตรวจสอบโค้ด เพียงเพราะผู้ช่วยใช้คำศัพท์ที่ถูกต้อง สำหรับทีมหลายทีม การตั้งค่าที่คุ้มค่าที่สุดคือโมเดลที่ร่างและอธิบายได้ดี พร้อมด้วยระบบควบคุมทางวิศวกรรมที่มีอยู่ ซึ่งจะเป็นตัวตัดสินว่าการเปลี่ยนแปลงนั้นจะถูกส่งออกไปหรือไม่.
GPT Image 2 vs Nano Banana 2: การทดสอบภาพผลิตภัณฑ์หนึ่งภาพ
เราใช้คำอธิบายงานเดียวกันสำหรับทั้งสองแบบ: “ภาพหลักที่เรียบง่ายสำหรับเว็บไซต์อีคอมเมิร์ซ ของขวดสแตนเลสสตีลสีน้ำเงินเข้มแบบด้านที่สามารถใช้ซ้ำได้, หินสีอ่อน, แสงธรรมชาติ, มีหยดน้ำเล็กน้อย, ไม่มีข้อความหรือโลโก้” GPT Image 2 ยังคงรักษาขวดสีน้ำเงินเข้ม ข้อกำหนดไม่มีโลโก้ และหยดน้ำ แต่เปลี่ยนไปใช้พื้นหลังที่สื่อถึงไลฟ์สไตล์กลางแจ้งหรือริมทะเล แทนที่จะเป็นฉากแคตตาล็อกที่เรียบง่าย ส่วน Nano Banana 2 ก็ยังคงใช้ขวดสีน้ำเงินเข้มและไม่มีโลโก้ เช่นกัน แต่จัดกรอบภาพในลักษณะการถ่ายภาพผลิตภัณฑ์ในร่มมากขึ้น อย่างไรก็ตาม ผลลัพธ์ทั้งสองไม่ได้แสดงพื้นผิวหินสีอ่อนตามที่ร้องขออย่างเคร่งครัด.
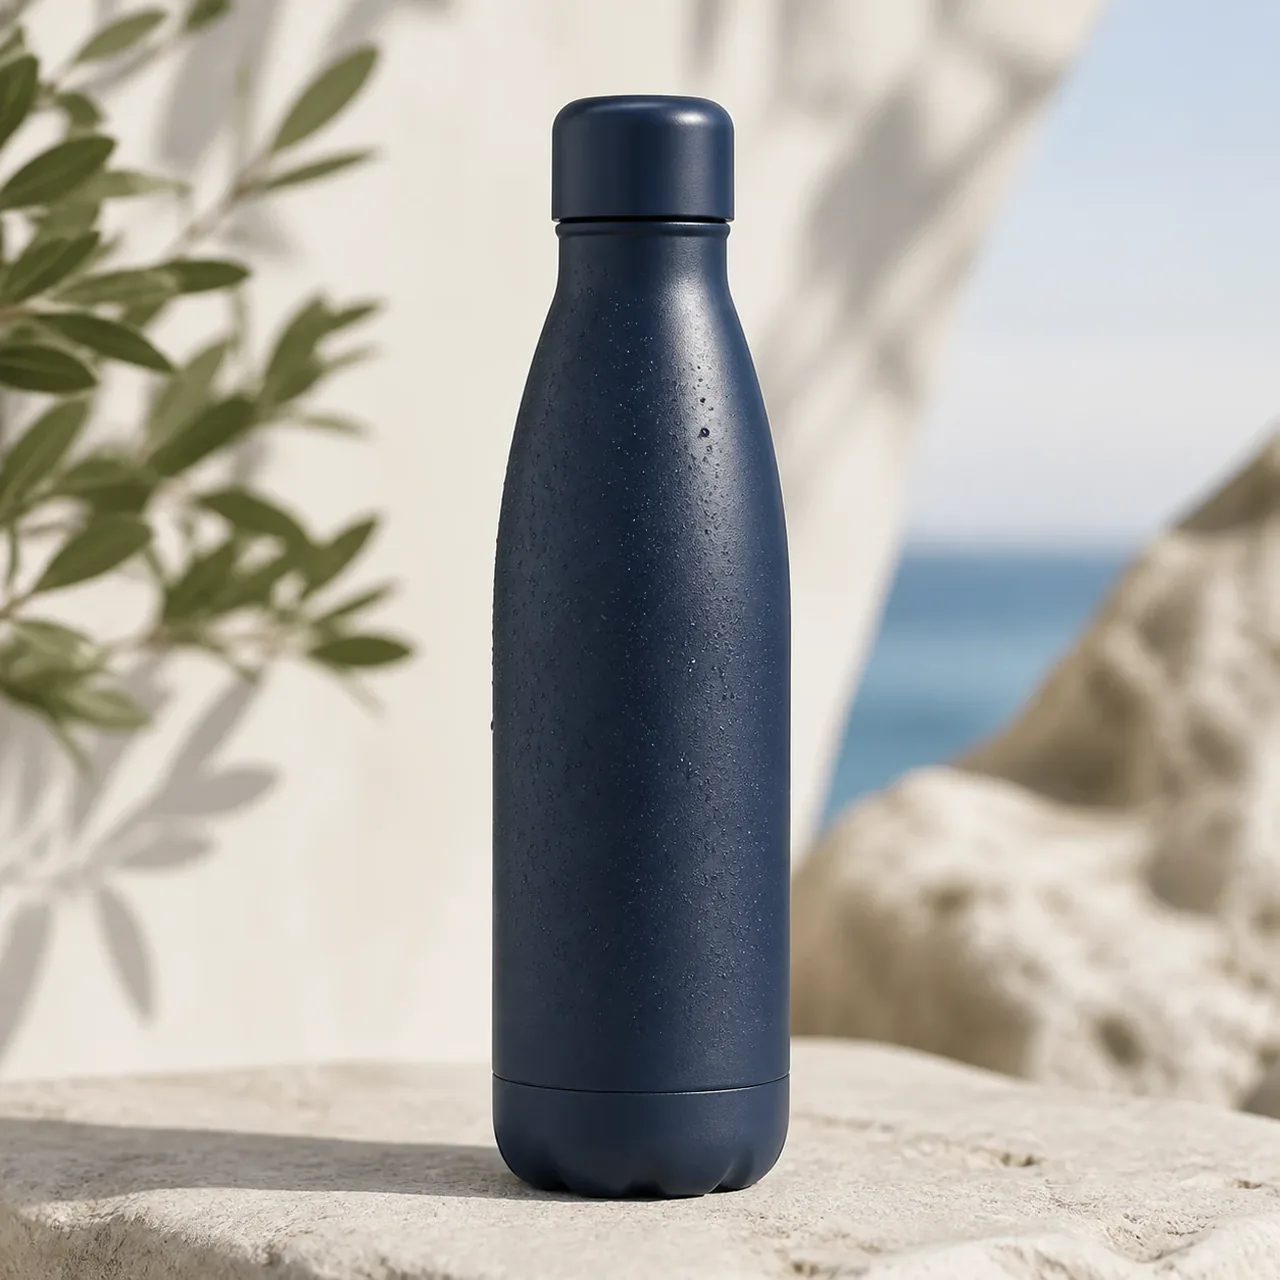
รายละเอียดเกี่ยวกับความชื้นดีขึ้น; ฉากดูมีบรรยากาศแบบไลฟ์สไตล์มากกว่าแคตตาล็อก.
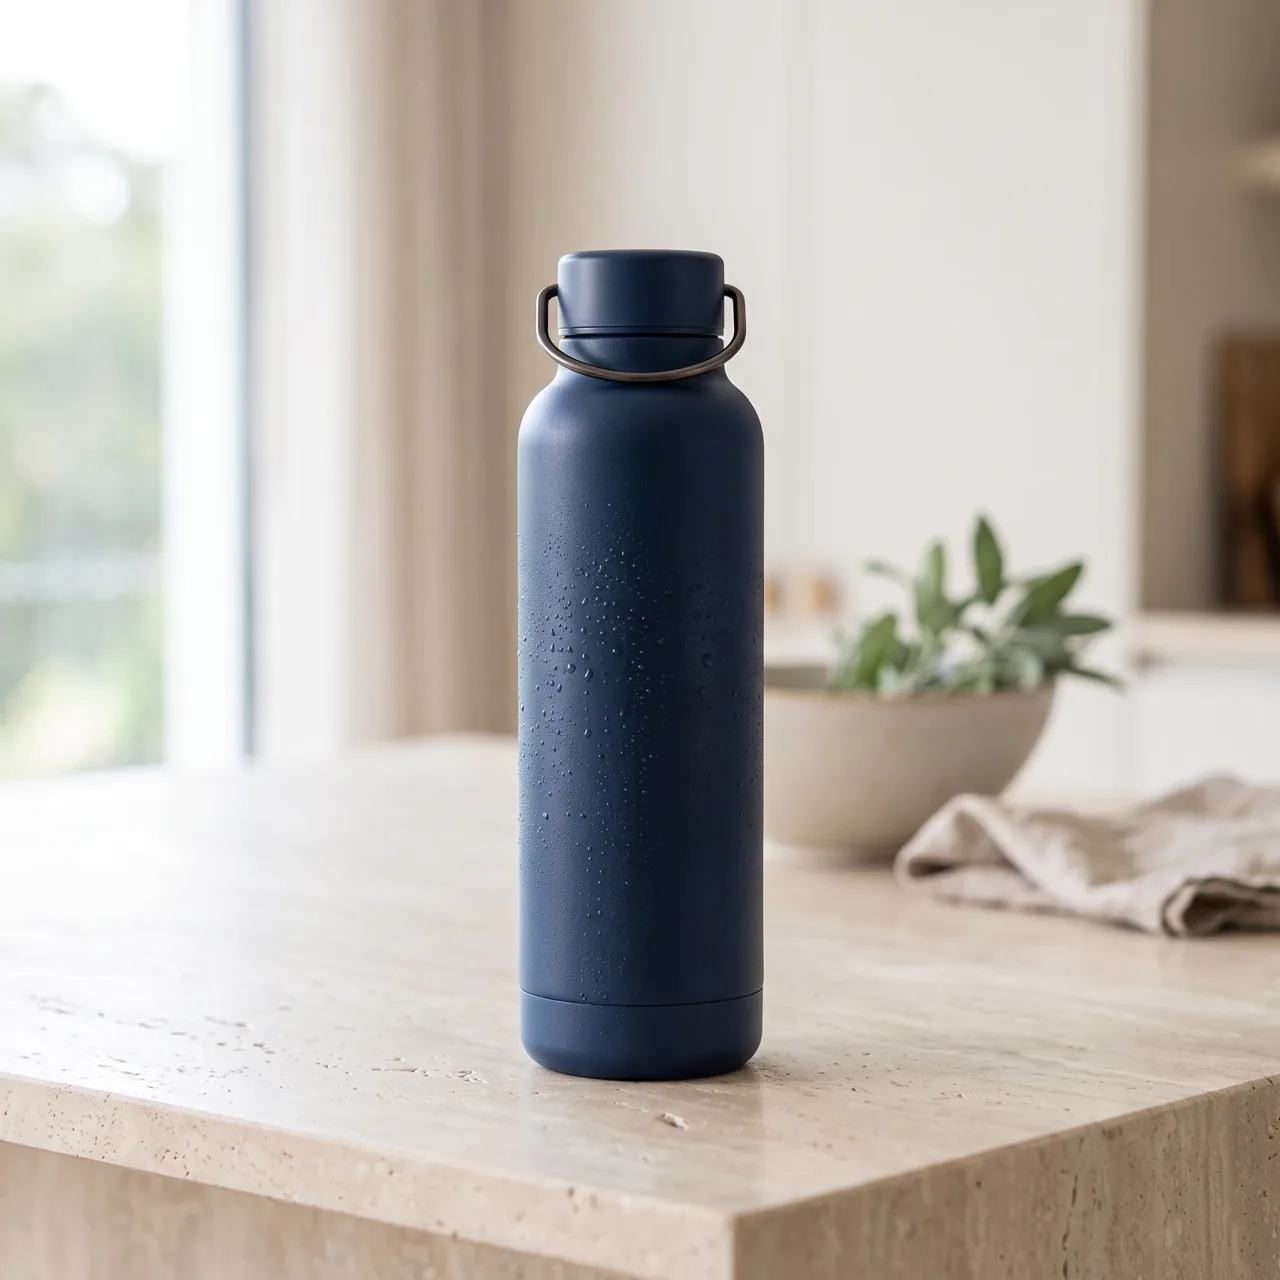
ปรับกรอบภาพผลิตภัณฑ์เพิ่มเติมแล้ว แต่ยังไม่ได้ทำตามคำแนะนำเกี่ยวกับหินสีอ่อน.
บทเรียนจากประสบการณ์จริงคือ ควรเลือกใช้โมเดลภาพที่มีรูปแบบความผิดพลาดที่คุณสามารถแก้ไขได้อย่างรวดเร็ว สำหรับคำสั่งนี้ ทั้งสองผลลัพธ์ยังไม่สามารถเผยแพร่ได้ทันทีโดยไม่ผ่านการแก้ไข ลองทดสอบสีแบรนด์ ข้อความ ภาพอ้างอิง และคำแนะนำการแก้ไขของคุณเองก่อนที่จะเลือกแพ็กเกจ.
สิ่งที่ควรตรวจสอบก่อนจ่ายเงินให้โมเดลภาพ
การประเมินด้านความสร้างสรรค์ควรมีมาตรฐานที่สูงกว่าการถามเพียงว่าภาพนั้นดูดีเมื่อพิจารณาแยกเดี่ยว ภาพโฆษณา มีข้อกำหนดหลายประการที่อาจถูกมองข้ามได้ง่ายในฟีด เช่น รูปทรงของผลิตภัณฑ์ ความถูกต้องของฉลาก สีของแบรนด์ ทิศทางแสง พื้นที่ว่างสำหรับข้อความ สัดส่วนภาพของแคมเปญ และความสามารถในการปรับเปลี่ยนอย่างควบคุมได้โดยไม่ทำลายส่วนที่ทำงานได้ดีอยู่แล้ว สร้างชุดทดสอบขนาดเล็กที่ประกอบด้วย ภาพผลิตภัณฑ์ที่ชัดเจนหนึ่งภาพ ฉากไลฟ์สไตล์หนึ่งภาพ ภาพที่มีข้อจำกัดด้านตัวอักษรหรือบรรจุภัณฑ์หนึ่งภาพ และการแก้ไขภาพที่มีอยู่หนึ่งภาพ.
Veo 3.1 vs Seedance 2.0: การทดสอบวิดีโอผลิตภัณฑ์หนึ่งรายการ
ต่อมา เราขอให้ถ่ายโฆษณาผลิตภัณฑ์ระดับพรีเมียมความยาว 5 วินาที: ขวดสีน้ำเงินเข้มแบบด้านวางอยู่ตรงกลางบนหินสีอ่อน, การซูมเข้าอย่างช้าๆ, มีหยดน้ำเกาะ และไม่มีโลโก้ ข้อความ หรือคนปรากฏในภาพ ผลลัพธ์จาก Veo 3.1 มีระยะเวลา 8 วินาที; ในวินาทีที่ 2 มันแสดงรายละเอียดผลิตภัณฑ์แบบใกล้ที่น่าดึงดูดและหยดน้ำ แต่กล้องได้เคลื่อนเข้าใกล้เกินไปจนไม่สามารถตอบสนองการจัดองค์ประกอบที่ขอไว้ คือขวดอยู่ตรงกลางอย่างสมบูรณ์ Seedance 2.0 ให้ผลลัพธ์ 5.04 วินาที และรักษาขวดในท่าตั้งตรงที่เต็มตัวบนพื้นผิวคล้ายหินไว้ได้ แม้ว่าส่วนบนของขวดจะถูกตัดออก และหยดน้ำบนขวดจะมองเห็นได้น้อยลงมาก.
ข้อความคำสั่งที่ใช้ร่วมกันสำหรับผลลัพธ์ทั้งสอง
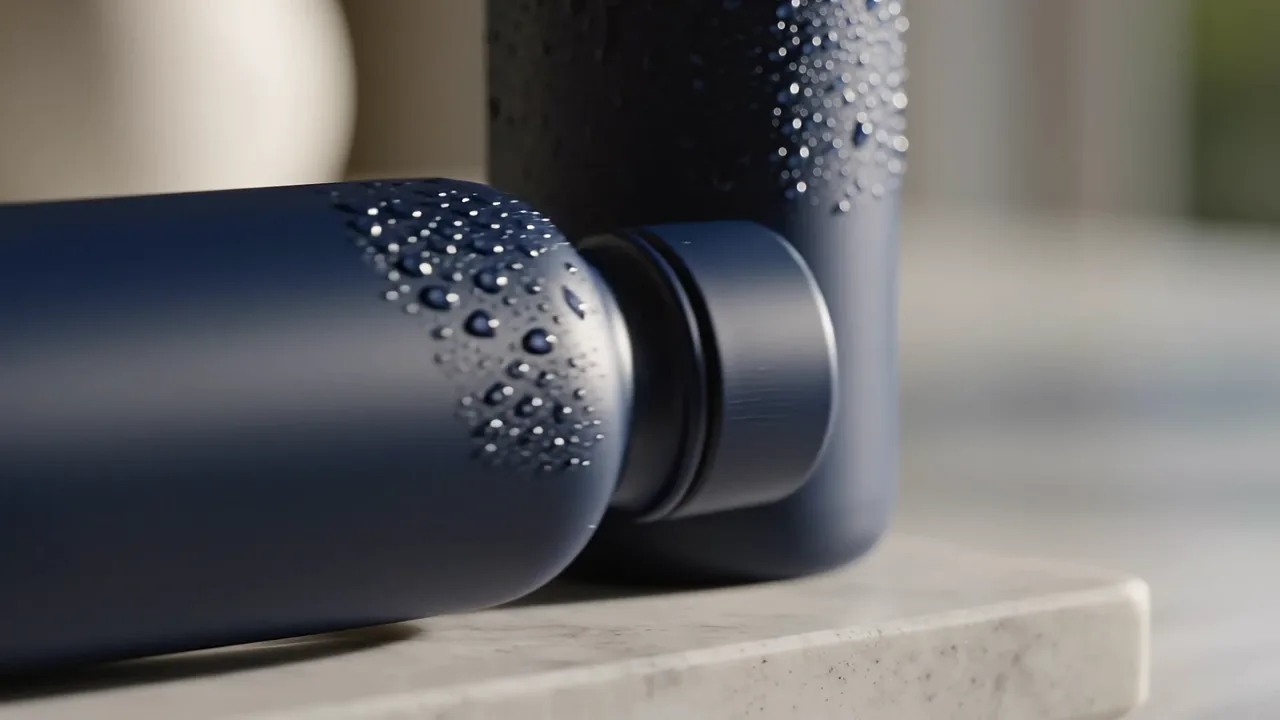
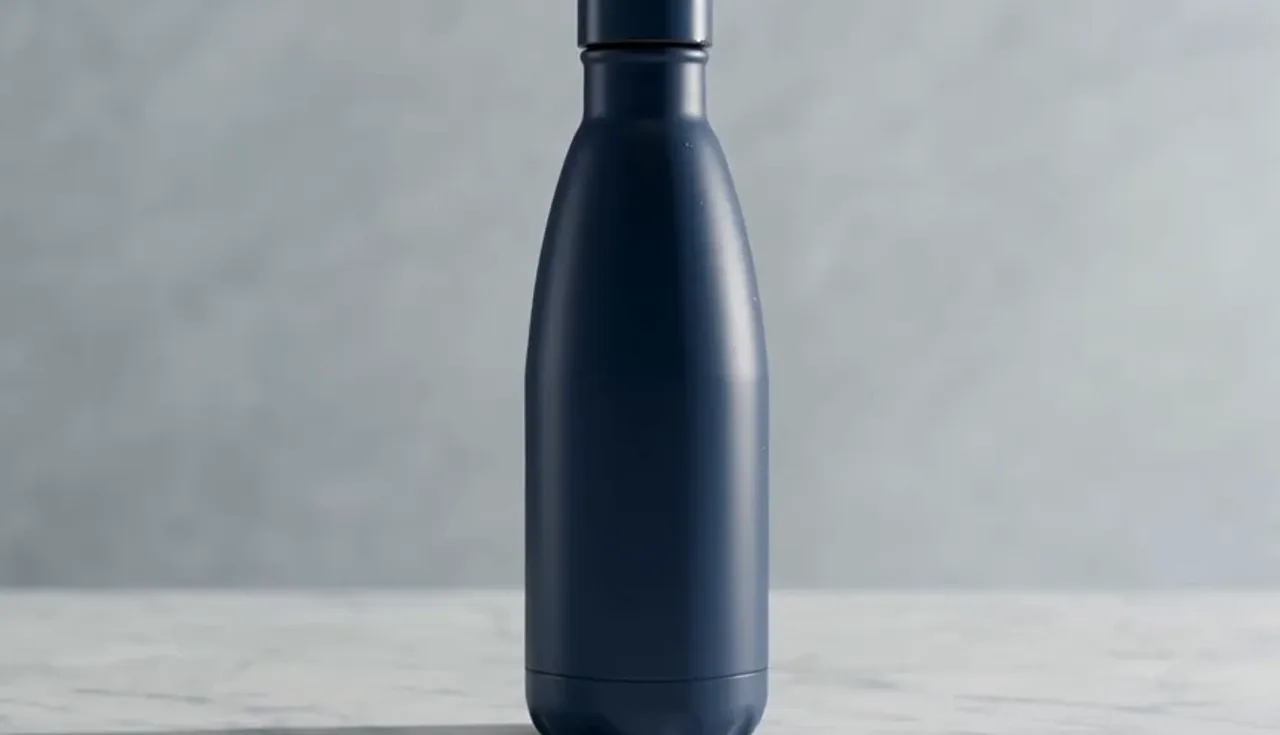
เลือก AI สำหรับวิดีโอโดยพิจารณาจากความเร็วในการปรับกรอบภาพ การเคลื่อนไหว และการควบคุมการแก้ไขให้ตรงตามความต้องการของคุณ ไม่ใช่จากภาพเดียวที่ดูน่าดึงดูด ตรวจสอบสิทธิ์และข้อกำหนดการเข้าถึงปัจจุบันใน Veo 3.1 คู่มือการใช้งานเชิงพาณิชย์ และ คู่มือการใช้งาน Seedance 2.0. Agnes Video ยังมี เอกสารคู่มือผลิตภัณฑ์อย่างเป็นทางการ; ตรวจสอบเงื่อนไขของแผนโดยตรงก่อนซื้อ.
วิธีจัดทำงบประมาณสำหรับ AI โดยไม่ต้องจ่ายเงินสำหรับงานเดียวกันสองครั้ง
คนส่วนใหญ่ไม่จำเป็นต้องสมัครสมาชิกสำหรับทุกประเภทโมเดล งบประมาณที่สมเหตุสมผลควรเริ่มจากงานเดียวที่ใช้ความสนใจมากที่สุดและมีค่าใช้จ่ายสูงที่สุด สำหรับผู้ให้คำปรึกษา อาจเป็นงานวิจัยและเขียนบทความ สำหรับผู้พัฒนา อาจเป็นงานตรวจสอบและแก้ไขข้อผิดพลาดที่คำนึงถึงระบบเก็บข้อมูล สำหรับทีมสร้างสรรค์ อาจเป็นความสามารถในการผลิตและปรับปรุงสินทรัพย์ของแคมเปญ ให้จัดสรรงบประมาณสำหรับจุดคอขวดหลักนั้นก่อน แล้วจึงเพิ่มช่องทางที่สองก็ต่อเมื่อมีงานจริงที่เผยให้เห็นช่องว่าง.
คิดแบบแบ่งเป็นระดับ ระดับแรกคือผู้ช่วยหลักที่คุณใช้บ่อย ระดับที่สองคือผู้เชี่ยวชาญสำหรับงานที่แตกต่างอย่างชัดเจน เช่น การวิจัยที่มีข้อมูลอ้างอิงหรือการสร้างวิดีโอ ระดับที่สามคือสิทธิ์การเข้าถึงที่ยืดหยุ่น สำหรับการทดลอง งานที่ล้นมือ และการขอความคิดเห็นเพิ่มเติม สิ่งที่คุณควรหลีกเลี่ยงคือการใช้บริการแชทสามประเภททั่วไปที่ทั้งหมดสร้างร่างแรกที่คล้ายกันมาก ค่าใช้จ่ายเพิ่มเติมรายเดือนนั้นเห็นได้ชัด แต่ค่าใช้จ่ายที่ก่อให้เกิดความเสียหายมากกว่าคือ ไม่มีใครรู้ว่าควรเชื่อถือคำตอบใด หรือเวอร์ชันสุดท้ายควรอยู่ในที่ใด.
แนวทางทั่วไป/การวิเคราะห์ที่ชัดเจนหนึ่งแนวทาง พร้อมทั้งการเข้าถึงข้อมูลวิจัยเมื่องานต้องการแหล่งข้อมูล เพิ่มรูปภาพหรือวิดีโอเฉพาะในรอบการผลิตที่กำลังดำเนินการอยู่เท่านั้น.
เหมาะที่สุดสำหรับ: นักเขียน, นักวิเคราะห์, ผู้ก่อตั้ง, ที่ปรึกษา.
เส้นทางหนึ่งที่มีฟังก์ชันการเขียนโค้ด ซึ่งเหมาะสมกับตัวแก้ไขหรือ CLI, แบบจำลองที่สองสำหรับคำถามการตรวจสอบที่ยาก, และแบบทดสอบที่มีอยู่เป็นขั้นตอนสุดท้าย.
เหมาะที่สุดสำหรับ: นักพัฒนาอิสระและทีมพัฒนาผลิตภัณฑ์ขนาดเล็ก.
ขั้นตอนการสร้างภาพ/วิดีโอหนึ่งขั้นตอนที่มีความสามารถในการปรับปรุงซ้ำได้เพียงพอ พร้อมด้วยแบบจำลองทั่วไปสำหรับแนวคิดและคำอธิบายโครงการ รวมถึงรายการตรวจสอบการอนุมัติที่สามารถทำซ้ำได้.
เหมาะที่สุดสำหรับ: นักการตลาด ทีมอีคอมเมิร์ซ และเอเจนซี.
สำหรับทีม ควรกำหนดความรับผิดชอบก่อนซื้อสิทธิ์ใช้งาน ใครสามารถใช้การวิจัยออนไลน์แบบเรียลไทม์เพื่อสนับสนุนคำร้องของลูกค้าได้? ใครจะตรวจสอบโค้ดที่สร้างขึ้น? ใครจะอนุมัติทรัพยากรภาพ? ข้อความคำสั่งและผลลัพธ์ที่ได้รับการอนุมัติถูกเก็บไว้ที่ไหน? คำถามเหล่านี้ไม่ใช่คำถามเชิงระบบราชการ แต่เป็นปัจจัยที่กำหนดว่า AI จะช่วยให้ทีมทำงานได้เร็วขึ้น หรือเพียงแต่สร้างร่างงานที่ติดตามไม่ได้มากขึ้นเท่านั้น แผนงานที่เรียบง่ายแต่มีขั้นตอนการทำงานที่ชัดเจน มีค่ามากกว่าการเข้าถึงบริการระดับพรีเมียมที่ไม่มีมาตรฐานการตรวจสอบ.
คำถามที่ควรถามก่อนนำ AI มาใช้ในงานสำคัญ
“คุ้มค่าที่จะจ่ายเงิน” ไม่ใช่เพียงเรื่องราคาเท่านั้น ยิ่งผลที่ตามมาจากการเกิดข้อผิดพลาดมีผลกระทบมากเท่าไร การสมัครสมาชิกก็ยิ่งจำเป็นต้องมีขอบเขตการดำเนินงานที่ชัดเจนมากขึ้นเท่านั้น ร่างคำอธิบายผลิตภัณฑ์และคำแนะนำทางการเงินที่ส่งถึงลูกค้าไม่ควรผ่านกระบวนการเดียวกันที่ยังไม่ได้รับการตรวจสอบ ก่อนที่จะนำโมเดลไปใช้ในกระบวนการทำงานที่จริงจัง ให้กำหนดให้ชัดเจนว่าโมเดลนั้นสามารถรับข้อมูลใดได้บ้าง ผู้ใดจะตรวจสอบผลลัพธ์ ข้อมูลใดต้องได้รับการยืนยันจากแหล่งที่มา และข้อมูลใดที่ห้ามเผยแพร่โดยเด็ดขาดหากไม่มีผู้รับผิดชอบที่เป็นมนุษย์.
- งานเฉพาะใดที่บริการนี้จะรับผิดชอบหรือช่วยเร่งความเร็วอย่างมีนัยสำคัญ?
- แหล่งข้อมูล การทดสอบ หรือผู้ตรวจสอบใดที่พิสูจน์ว่าผลลัพธ์ของมันปลอดภัยพอที่จะใช้งานได้?
- โมเดลจำเป็นต้องรู้อะไร และข้อมูลนั้นเหมาะสมที่จะแบ่งปันหรือไม่?
- สมาชิกทีมอื่นสามารถทำตามขั้นตอนการทำงานนี้ได้หรือไม่ โดยไม่ต้องคัดลอกประวัติการสนทนาส่วนตัว?
- อะไรจะทำให้เราเลิกสมัครบริการนี้ภายใน 30 วัน?
เมื่อพื้นที่ทำงานแบบหลายโมเดลเดียวมีค่ามากกว่าการสมัครสมาชิกแยกกัน
การสมัครใช้บริการโดยตรงอาจเป็นตัวเลือกที่ดีเมื่อคุณต้องการฟีเจอร์ใหม่ล่าสุดจากผู้จำหน่ายรายเดียว ระบบควบคุมระดับองค์กร หรือกระบวนการทำงานที่ผสานรวมอย่างลึกซึ้ง แต่การสมัครใช้บริการแยกกันจะกลายเป็นเรื่องที่ทั้งแพงและน่ารำคาญ เมื่องานของคุณเปลี่ยนจากงานวิจัยที่อ้างอิง ไปสู่การตรวจสอบโค้ด และภาพผลิตภัณฑ์ภายในสัปดาห์เดียวกัน ตามหน้าหลักปัจจุบันของ GlobalGPT บัญชีเดียวให้ใช้งาน AI models กว่า 100 แบบ จาก $5.80/เดือน พร้อมด้วย Perplexity, Deep Research, Yukie, การเข้าถึงผ่านเว็บและ CLI รวมถึงเซิร์ฟเวอร์ MCP สำหรับ Claude Code, Codex และ Cursor.
ลำดับขั้นตอนแบบหลายโมเดลที่ใช้งานได้จริงมีลักษณะดังนี้: เริ่มด้วย Perplexity หรือ Deep Research เพื่อหาหลักฐานปัจจุบัน; ใช้โมเดลทั่วไปเพื่อกำหนดรูปแบบของบันทึก; ขอให้โมเดลที่สองมาท้าทายสมมติฐาน; ส่งคำถามเกี่ยวกับการดำเนินการที่เฉพาะเจาะจงผ่าน CLI หรือ MCP หากนั่นคือขั้นตอนการพัฒนาที่มีอยู่ของคุณ; แล้วจึงย้ายไปใช้ภาพหรือวิดีโอเฉพาะเมื่อแคมเปญต้องการการผลิตเนื้อหาภาพเท่านั้น ลำดับขั้นตอนนี้ทำให้การเลือกเครื่องมือชัดเจนขึ้น นอกจากนี้ยังประหยัดกว่าการซื้อแพ็กเกจระดับสูงสุดจากทุกผู้ให้บริการอย่างอัตโนมัติ ก่อนที่จะรู้ว่าขั้นตอนใดสมควรได้รับงบประมาณ.
อย่าจ่ายเงินแยกกันอีกเมื่องานมีการเปลี่ยนแปลงอยู่เสมอ
ใช้ข้อมูลวิจัยก่อนเริ่มเขียนร่าง, เปลี่ยนโมเดลเมื่อคำตอบตามกลยุทธ์ต้องการความเห็นเพิ่มเติม, ส่งงานเขียนโค้ดผ่าน CLI หรือ MCP แล้วสร้างภาพและวิดีโอจากบัญชีเดียวกัน.
ลองใช้พื้นที่ทำงานแบบหลายโมเดลของ GlobalGPTเหตุผลสำคัญที่สุดในการจ่ายเงินไม่ใช่เพื่อเข้าถึงชื่อโมเดลที่มีชื่อเสียง แต่คือการมีเส้นทางที่เหมาะสมพร้อมใช้งานทันทีที่งานมีการเปลี่ยนแปลง โดยไม่ต้องสร้างระบบสมัครสมาชิกใหม่ สำหรับจุดเข้าใช้งานโมเดลทั่วไป เส้นทาง Sol ของ GPT-5.6 ที่ได้รับการยืนยันจาก GlobalGPT คือ มีให้ดาวน์โหลดที่นี่.
คำถามที่พบบ่อย
AI ตัวไหนที่คุ้มค่าที่สุดที่จะจ่ายเงินซื้อ?
AI ที่ให้ผลตอบแทนดีที่สุดคือ AI ที่ช่วยประหยัดเวลาในการทำงานหลักของคุณได้อย่างต่อเนื่อง งานที่เน้นการวิจัยจะเหมาะกับระบบค้นหาที่อ้างอิงแหล่งข้อมูล; งานวิเคราะห์จะเหมาะกับโมเดลทั่วไปที่แข็งแกร่ง; งานพัฒนาจะเหมาะกับโมเดลและอินเทอร์เฟซที่ช่วยปรับปรุงกระบวนการตรวจสอบ; ส่วนเครื่องมือสำหรับภาพและวิดีโอจำเป็นต้องช่วยลดเวลาการผลิตจริง.
ChatGPT คุ้มค่าที่จะจ่ายเงินซื้อหรือไม่?
ChatGPT อาจคุ้มค่าที่จะลงทุนใช้ หากเป็นสภาพแวดล้อมหลักของคุณสำหรับการร่างแผน วิเคราะห์ และแก้ปัญหาแบบวนซ้ำ ให้ลองนำงานบรีฟประจำของคุณมาประมวลผลผ่านระบบนี้และโมเดลอีกตัวหนึ่ง แล้วเปรียบเทียบเวลาในการทบทวนรวมถึงคำตอบแรก.
Perplexity คุ้มค่าที่จะจ่ายเงินซื้อหรือไม่?
Perplexity มีประโยชน์มากที่สุดเมื่อแหล่งข้อมูลปัจจุบันและแหล่งอ้างอิงที่สามารถตรวจสอบได้มีผลกระทบอย่างมีนัยสำคัญต่อคุณภาพงานวิจัยของคุณ ส่วนหากงานของคุณเป็นหลักในการเขียนแบบออฟไลน์ การเขียนโค้ด หรือการสร้างทรัพยากร หลักการนี้จึงมีความสำคัญน้อยลง.
AI ตัวไหนดีที่สุดสำหรับการเขียนโค้ด?
AI สำหรับการเขียนโค้ดที่ดีที่สุดคือ AI ที่เข้าใจบริบทของรีโพสิตอรีที่เกี่ยวข้อง เสนอการเปลี่ยนแปลงที่สามารถตรวจสอบได้ สร้างการทดสอบที่ทำงานได้ และเข้ากันได้กับตัวแก้ไขโค้ดหรือ CLI ของคุณ ให้ถือโค้ดที่สร้างโดย AI เป็นฉบับร่าง จนกว่าการทดสอบและกระบวนการตรวจสอบปกติจะผ่าน.
ผมควรจ่ายเงินเพื่อใช้ AI สำหรับภาพหรือวิดีโอหรือไม่?
จ่ายเมื่อโมเดลสร้างร่างงานอย่างสม่ำเสมอ ซึ่งสามารถแทนที่เวลาที่ใช้ในการถ่ายภาพ การออกแบบ การแก้ไข หรือเวลาของเอเจนซีได้ เปรียบเทียบคำสั่งที่คำนึงถึงแบรนด์เดียวกันในบริการหลายแห่ง และจัดงบประมาณไว้สำหรับการปรับปรุงหลายครั้ง เนื่องจากผลลัพธ์ครั้งแรกอาจขาดรายละเอียดเกี่ยวกับกรอบภาพหรือเนื้อหา.
การสมัครสมาชิก AI แบบหลายโมเดลนั้นคุ้มค่าหรือไม่?
การสมัครใช้หลายโมเดลจะมีประโยชน์เมื่อคุณต้องสลับไปมาระหว่างการวิจัย การเขียน การเขียนโค้ด การทำงานกับภาพ และวิดีโอ หรือเมื่อต้องการโมเดลที่สองเพื่อตรวจสอบคำตอบสำคัญ อย่างไรก็ตาม แผนบริการโดยตรงจากผู้ขายอาจยังคงเป็นตัวเลือกที่ดีกว่า หากการควบคุมจากผู้ขายเองเป็นเงื่อนไขที่ไม่อาจต่อรองได้.
สามารถใช้ GPT-5.6 Sol กับ GlobalGPT ได้หรือไม่?
GlobalGPT ได้ระบุ GPT-5.6 Sol ในแคตตาล็อกรุ่นปัจจุบันของบริษัท ใช้เส้นทาง GlobalGPT ที่ถูกติดตามในบทความนี้เพื่อตรวจสอบอินเทอร์เฟซที่มีให้บริการในปัจจุบัน และเลือกตัวเลือกการเข้าถึงที่เหมาะกับกระบวนการทำงานของคุณ.