การทบทวนที่อิงตามหลักฐาน · สิงหาคม 2026
น้ำหนักแบบเปิด, API ที่ให้บริการบนแพลตฟอร์มของผู้ให้บริการอื่น และช่องว่างในการตั้งชื่อ — ถูกแสดงอย่างชัดเจน.
ขีดจำกัดของหลักฐาน: ไม่มีข้อมูลคะแนนการฟัง Qwen3-TTS จากประสบการณ์โดยตรง.
การรีวิว Qwen3-TTS ที่มีประโยชน์ต้องตอบคำถามพื้นฐานก่อนที่จะให้คะแนนเสียง: เรากำลังพูดถึง Qwen3-TTS ตัวไหนกันแน่? ในปี 2026 ชื่อนี้ครอบคลุมทั้งจุดตรวจสอบ (checkpoints) ขนาด 0.6B และ 1.7B ที่สามารถดาวน์โหลดได้ API Qwen3-TTS ที่โฮสต์บน Alibaba Cloud และตลาดที่ยังแนะนำให้ใช้ตระกูล Qwen-Audio 3.0 TTS ที่แยกต่างหากด้วย การพิจารณาผลิตภัณฑ์เหล่านี้เป็นผลิตภัณฑ์เดียวจะก่อให้เกิดข้อมูลที่ผิดพลาดเกี่ยวกับความเร็ว ภาษา และราคา.
คำตอบสั้นๆ คือ Qwen3-TTS เป็นหนึ่งในระบบเสียงแบบเปิดที่มีความยืดหยุ่นสูงที่สุดในปี 2026 มันรองรับ 10 ภาษา จุดตรวจสอบเฉพาะงาน (checkpoints) การคัดลอกเสียงในเวลาประมาณ 3 วินาที การออกแบบเสียงด้วยภาษาธรรมชาติ การสนับสนุนการสตรีมมิ่ง และถูกปล่อยภายใต้ใบอนุญาต Apache-2.0 แต่การรีวิวนี้ไม่ได้กำหนดคะแนนการฟัง: สภาพแวดล้อมการทดสอบที่มีอยู่ไม่ได้เปิดเผยจุดปลายทาง Qwen3-TTS ที่จริง และ GPU 2 GB ในเครื่องไม่เหมาะสมสำหรับการทดสอบประสิทธิภาพแบบเปรียบเทียบ 0.6B กับ 1.7B ที่เป็นตัวแทน.
สถานะของ Qwen3-TTS ในปี 2026
Qwen ได้เผยแพร่ชุดน้ำหนัก Qwen3-TTS แบบเปิดเมื่อวันที่ 22 มกราคม 2026. The คลังเก็บอย่างเป็นทางการ Qwen3-TTS แสดงรายการจุดตรวจสอบ 12Hz ที่ได้ปล่อยออกมาแล้ว 5 จุด ได้แก่ 1.7B VoiceDesign, 1.7B CustomVoice, 1.7B Base, 0.6B CustomVoice และ 0.6B Base การจับคู่ คอลเลกชัน Hugging Face ยังรวมถึงเครื่องมือแยกคำด้วย นี่คือโมเดลที่ผู้พัฒนาสามารถตรวจสอบ ดาวน์โหลด และใช้งานได้ภายใต้ใบอนุญาตที่เผยแพร่.
Alibaba Cloud ให้บริการชุดผลิตภัณฑ์ Qwen3-TTS Flash, Instruct, การคัดลอกเสียง และ การออกแบบเสียง แบบโฮสต์แยกกัน ผ่านอินเทอร์เฟซแบบไม่เรียลไทม์และแบบเรียลไทม์ โดยปัจจุบัน รายชื่อแบบจำลองการสังเคราะห์เสียง ควรถือเป็นแหล่งข้อมูลที่เชื่อถือได้สำหรับ alias ที่ถูกโฮสต์ ภูมิภาค ภาษา และอินเทอร์เฟซ เนื่องจากข้อมูลเหล่านั้นอาจเปลี่ยนแปลงได้โดยไม่จำเป็นต้องเปลี่ยนชื่อจุดตรวจสอบที่เปิดอยู่.
ยังมีปัญหาในการตั้งชื่ออีกหนึ่งข้อ คู่มือการเลือกโมเดลปี 2026 ของ Alibaba Cloud ยังแนะนำให้ผู้ใช้เลือก Qwen-Audio 3.0 TTS สำหรับงานหลายประเภทที่ให้บริการบนแพลตฟอร์ม Qwen-Audio 3.0 TTS ไม่ใช่ checkpoint Qwen3-TTS ขนาด 0.6B หรือ 1.7B ที่เปลี่ยนชื่อมา หากคุณกำลังติดตามตระกูล Qwen ที่กว้างขึ้นอยู่แล้ว คำแนะนำของเราคือ Qwen 3.8: บทวิเคราะห์สเปกสูงสุดและการใช้งาน แสดงให้เห็นว่าทำไมการตั้งชื่อแบบจำลองให้ถูกต้องจึงสำคัญสำหรับผลิตภัณฑ์ในตระกูล Qwen.
ใช้ชื่อจุดตรวจสอบแบบเปิด (open checkpoint) สำหรับการอนุมานแบบท้องถิ่น (local inference) ใช้ ID แบบจำลองของ Alibaba Cloud ที่ถูกต้องสำหรับพฤติกรรมของ API และใช้ Qwen-Audio 3.0 TTS เฉพาะในฐานะทางเลือกแยกต่างหากเท่านั้น ซึ่งจะช่วยรักษาทุกคำกล่าวอ้างเกี่ยวกับคุณภาพ ความล่าช้า และราคาที่ผูกติดกับผลิตภัณฑ์ที่สร้างมันขึ้นมา.
บทสรุปสั้นๆ: มีประสิทธิภาพสูง, ให้ผลลัพธ์ที่ชัดเจน และไวต่อหลักฐาน
บทสรุปสั้นๆ
การเผยแพร่แบบเปิด การวิจัย การคัดลอก และเสียงตัวละคร.
จุดตรวจสอบเฉพาะงาน 5 จุด สำหรับสองขนาด.
ความเร็วของผู้ขายขึ้นอยู่กับสภาพแวดล้อมแต่ละแห่ง; ส่วนคุณภาพยังไม่ถูกประเมินในส่วนนี้.
Qwen3-TTS และ Qwen-Audio 3.0 เป็นเส้นทางที่แยกกัน.
Qwen3-TTS เป็นตัวเลือกที่น่าสนใจที่สุดสำหรับทีมที่ต้องการความควบคุมและตัวเลือกในการติดตั้ง จุดตรวจสอบ Base รองรับการคัดลอก CustomVoice ให้เสียงพูดที่ตั้งชื่อไว้ล่วงหน้าพร้อมการควบคุมคำสั่ง และ VoiceDesign สามารถสร้างเสียงพูดจากคำอธิบายที่เขียนไว้ได้ การสนับสนุน 10 ภาษาทำให้ระบบนี้มีประโยชน์มากกว่าเวอร์ชันเดโมแบบเปิดที่รองรับเฉพาะภาษาอังกฤษ ส่วนเวอร์ชัน 0.6B ให้ผู้พัฒนาจุดเริ่มต้นที่เล็กกว่า.
ข้อควรระวังหลักคือคุณภาพของข้อมูล Qwen รายงานผลการทดสอบประสิทธิภาพที่แข็งแกร่งและค่าความหน่วงของแพ็กเก็ตแรกที่ต่ำในสภาพแวดล้อมภายในที่ได้รับการปรับแต่งให้เหมาะสม ตัวเลขเหล่านี้ไม่สะท้อนถึงการเริ่มต้นระบบจากสถานะปิดเครื่องของแล็ปท็อป พื้นที่ว่างของ VRAM ในคอนเทนเนอร์ หรือการออกเสียงชื่อผลิตภัณฑ์ของคุณ ส่วนคำสัญญา "Universal 97 ms" นั้นไม่ได้ระบุเงื่อนไขการทดสอบไว้.
สำหรับต้นแบบที่ติดตั้งบนเซิร์ฟเวอร์เอง Qwen3-TTS ถือเป็นหนึ่งในตัวเลือกอันดับต้นๆ สำหรับ API สำหรับการใช้งานจริง ให้เปรียบเทียบตัวเลือก Qwen3-TTS ที่ให้บริการบนเซิร์ฟเวอร์กับคำแนะนำใหม่ของ Qwen-Audio รวมถึงการสนับสนุนด้านการดำเนินงาน ความพร้อมใช้งานในแต่ละภูมิภาค และค่าใช้จ่ายในการจัดการเสียงที่คัดลอก หากเป้าหมายของคุณไม่เพียงจำกัดอยู่ที่เสียงพูด แต่ยังรวมถึงเอฟเฟกต์เสียงหรือดนตรีด้วย ตัวเลือกที่กว้างขึ้น การทดสอบเสียง SFX และเพลงใน Seed Audio 1.0 เพื่อรองรับกระบวนการทำงานด้านเสียงที่แตกต่างและใช้หลายรูปแบบมากขึ้น.
สรุป: Qwen3-TTS ดูดีมากในด้านสถาปัตยกรรม ความเปิดกว้าง และการครอบคลุมคุณสมบัติ อย่างไรก็ตาม ระดับประสิทธิภาพในการใช้งานจริงยังขึ้นอยู่กับจุดตรวจสอบหรือจุดสิ้นสุดที่เฉพาะเจาะจง ฮาร์ดแวร์ของคุณ ภาษาที่คุณใช้ และเสียงอ้างอิงที่ได้รับการอนุมัติและทดสอบร่วมกับสคริปต์ของคุณเอง.
Qwen3-TTS คืออะไร?
Qwen3-TTS เป็นกลุ่มโมเดลสร้างเสียงที่พัฒนาขึ้นโดยใช้เครื่องมือแบ่งคำพูดแบบไม่ต่อเนื่อง (discrete speech tokenizer) ซึ่งทำงานด้วยความเร็ว 12.5 เฟรมต่อวินาที ตามข้อมูลจาก รายงานทางเทคนิค Qwen3-TTS, ระบบนี้ได้รับการฝึกอบรมด้วยข้อมูลมากกว่าห้าล้านชั่วโมงในสิบภาษา อัตราโทเคนต่ำเป็นจุดสำคัญในการออกแบบ: การใช้โทเคนเสียงน้อยลงสามารถลดงานการถอดรหัสและทำให้การสตรีมมิ่งเป็นไปได้มากขึ้น ในขณะที่โมเดลยังคงต้องรักษาโทนเสียง การออกเสียง และจังหวะการพูดไว้.
สามชั้น สามกฎเกี่ยวกับหลักฐาน
0.6 พันล้าน / 1.7 พันล้าน
Base, CustomVoice และ VoiceDesign 1.7B ใช้สำหรับคำขอที่เกี่ยวข้องกับโมเดลท้องถิ่น.
Flash / Instruct / VC / VD
ใช้แบบจำลอง API, อินเทอร์เฟซ, ภูมิภาค และวันที่ให้ตรงตามเดิม.
Qwen-Audio 3.0 TTS
ทางเลือกแบบโฮสต์ที่มีอยู่ในปัจจุบัน ไม่ใช่ open checkpoint ที่เปลี่ยนชื่อมา.
จุดตรวจสอบทั้งห้าที่ได้รับการเปิดเผยนั้นถูกออกแบบมาเพื่อวัตถุประสงค์เฉพาะแต่ละงาน ไม่ใช่ระบบแบบขั้นบันไดที่โมเดลขนาดใหญ่กว่าทุกตัวสามารถทำทุกอย่างได้:
| จุดตรวจสอบที่ปล่อยแล้ว | ขนาด | งานที่ตรงกับคุณที่สุด | ขอบเขตสำคัญ |
|---|---|---|---|
| Qwen3-TTS-12Hz-0.6B-Base | 0.6 พันล้าน | กระบวนการโคลนนิ่งและวิจัยในขนาดเล็ก | ไม่มีแคตตาล็อก CustomVoice ที่กำหนดไว้ล่วงหน้า |
| Qwen3-TTS-12Hz-1.7B-Base | 1.7B | งานโคลนนิ่งและงานต่อเนื่องที่มีความจุสูงขึ้น | ต้องการหน่วยความจำและกำลังการประมวลผลเพิ่มเติม |
| Qwen3-TTS-12Hz-0.6B-เสียงตามสั่ง | 0.6 พันล้าน | เสียงที่ตั้งไว้ล่วงหน้าพร้อมระบบควบคุมตามคำสั่ง | ใช้ชุดลำโพงที่ได้รับการปล่อยออกมา |
| Qwen3-TTS-12Hz-1.7B-CustomVoice | 1.7B | ระบบสังเคราะห์เสียงแบบตั้งค่าล่วงหน้าที่มีความจุสูงขึ้น | ไม่ใช่จุดตรวจสอบของ VoiceDesign |
| Qwen3-TTS-12Hz-1.7B-VoiceDesign | 1.7B | การสร้างเสียงจากคำอธิบายด้วยข้อความ | ยังไม่มีเวอร์ชัน VoiceDesign peer 0.6B ที่ปล่อยออกมา |
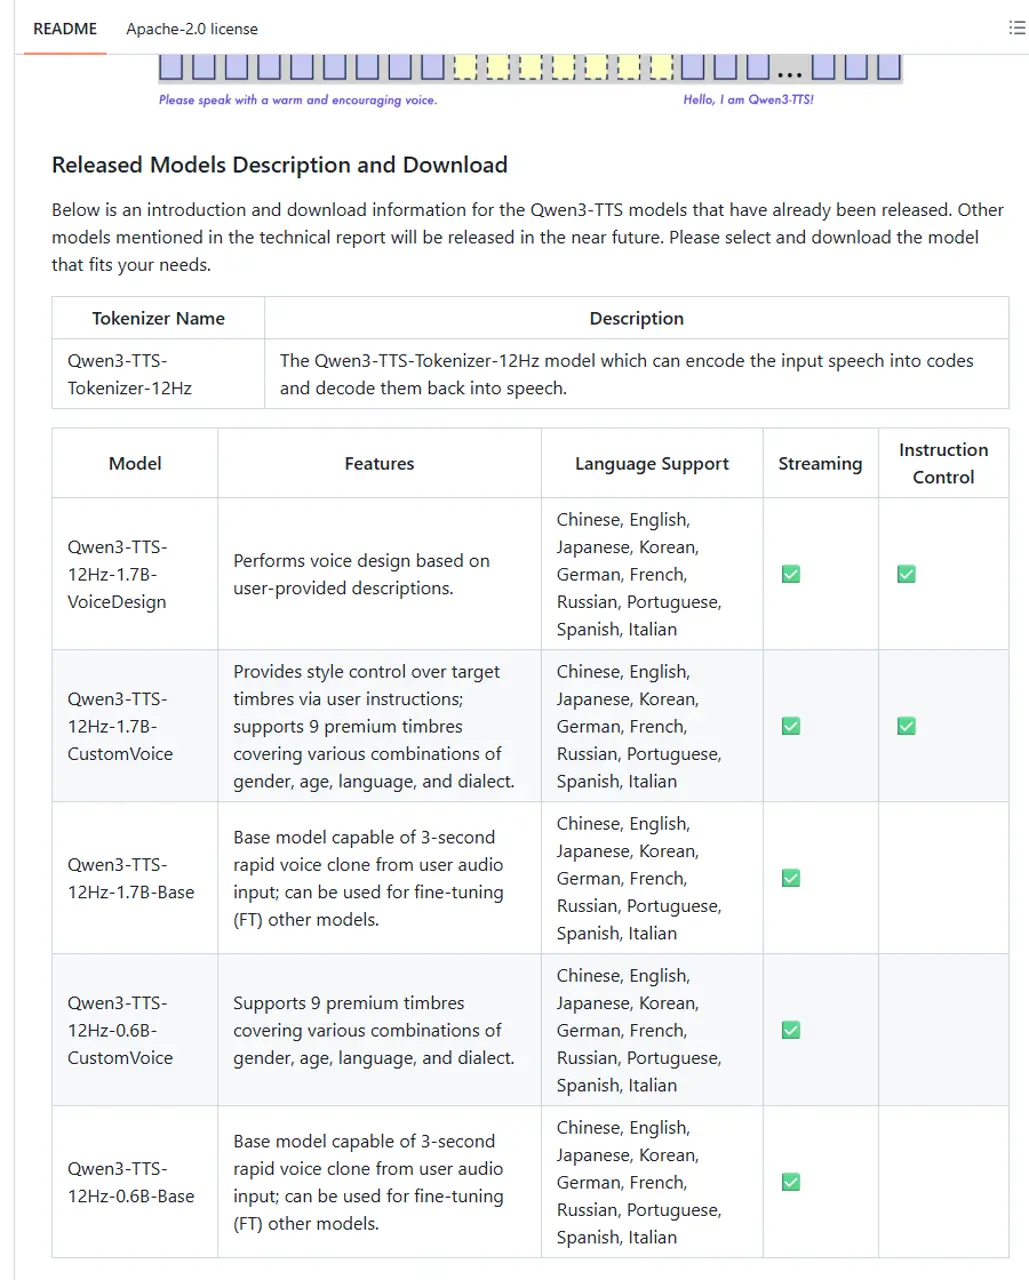
Base เป็นตัวเลือกที่เหมาะสมเมื่อคุณมีเสียงอ้างอิงและได้รับอนุญาตให้ใช้เสียงนั้น ส่วน CustomVoice เป็นวิธีที่ง่ายกว่าเมื่อเสียงพรีเซ็ตที่ Qwen ได้ปล่อยออกมามีเสียงที่เหมาะกับโครงการ ส่วน VoiceDesign เหมาะสำหรับคำอธิบายลักษณะตัวละคร เช่น “ผู้เล่าเรื่องที่สงบและสุกงอม ด้วยเสียงต่ำที่นุ่มนวล” ซึ่งไม่จำเป็นต้องมีบันทึกเสียงอ้างอิง.
คู่มือผลิตภัณฑ์ไม่จำเป็นต้องใช้การคัดลอกเสียง หากผู้บรรยายที่ตั้งค่าไว้ล่วงหน้าทำงานได้ดี และตัวละครสมมติอาจไม่จำเป็นต้องใช้เสียงบันทึกของบุคคลจริง หาก VoiceDesign สามารถสร้างเอกลักษณ์ที่เหมาะสมได้ ให้ประเมินแต่ละงานโดยใช้จุดตรวจสอบที่สอดคล้องกัน.
วิธีการทดสอบรีวิว Qwen3-TTS นี้
การวิเคราะห์นี้ใช้หลักฐานจากสี่ชั้น ได้แก่ เอกสารอย่างเป็นทางการ รายงานทางเทคนิคของ Qwen การตรวจสอบฮาร์ดแวร์ในสถานที่ และการทดสอบแบบควบคุมของตัวห่อเสียง (audio wrapper) ที่ถูกโฮสต์แยกต่างหาก แหล่งข้อมูลอย่างเป็นทางการสนับสนุนข้อมูลเกี่ยวกับผลิตภัณฑ์และผลการทดสอบประสิทธิภาพที่ผู้ผลิตรายงาน ส่วนการควบคุมตัวห่อเสียงนี้สนับสนุนเพียงพฤติกรรมที่สังเกตได้เท่านั้น ไม่ใช่คะแนนคุณภาพเสียงของ Qwen3-TTS.
รายชื่อสภาพแวดล้อมงานที่มีอยู่ qwen-audio-3.0-tts-flash, ไม่ใช่ qwen3-tts-* แบบจำลอง.
สร้างการบันทึกเสียงภาษาอังกฤษที่ชัดเจนและฟังสบาย อ่านตามข้อความต่อไปนี้อย่างถูกต้อง: 'เมื่อพระอาทิตย์ขึ้น ทีมวิจัยได้ตรวจสอบทุกสัญญาณสองครั้งก่อนที่จะประกาศผล' ใช้เสียงผู้บรรยายผู้ใหญ่ที่อบอุ่นและสงบ จังหวะการพูดเป็นธรรมชาติ พยัญชนะชัดเจน และหยุดสั้นๆ หลังจากคำว่า 'พระอาทิตย์ขึ้น' อย่าเพิ่มเพลง, เสียงเอฟเฟกต์, คำนำ หรือคำใด ๆ ที่ไม่อยู่ในประโยคที่อ้างอิง.ในการทดสอบของเรา ข้อมูลนี้สร้างไฟล์ MP3 ความยาว 21.263673 วินาที และอ่านคำสั่งออกเสียง ผลทดสอบแสดงให้เห็นว่า wrapper ได้ประมวลผลข้อความคำสั่งทั้งหมดเป็นข้อความเสียง.
เมื่อพระอาทิตย์ขึ้น ทีมวิจัยได้ตรวจสอบสัญญาณทุกสัญญาณสองครั้งก่อนที่จะประกาศผล.เราได้ทำการทดสอบควบคุมซ้ำโดยใช้เพียงประโยคเป้าหมายเท่านั้น ในการทดสอบของเรา ผลลัพธ์ที่ได้คือไฟล์ MP3 ความยาว 6.086531 วินาที ที่ความถี่ 22,050 Hz, 128 kbps และแบบโมโน ซึ่งตรงกับประโยคเป้าหมายทุกคำ และไม่มีการเพิ่มคำสั่งใดๆ.
ผู้ใช้ได้ฟังทั้งสองไฟล์และยืนยันคะแนนดังต่อไปนี้ นี่เป็นการตรวจสอบเชิงปฏิบัติโดยผู้ฟังคนเดียว ไม่ใช่การศึกษา MOS หรือการประเมินโดยกลุ่มผู้ฟัง.
| มิติการฟัง | ระบบควบคุมที่มีคำสั่ง | การควบคุมข้อความธรรมดา |
|---|---|---|
| ความเป็นธรรมชาติ | 4/5 | 5/5 |
| ความชัดเจน | 5/5 | 5/5 |
| การออกเสียง | 5/5 | 5/5 |
| จังหวะและเสียง | 4/5 | 5/5 |
| ความถูกต้องของข้อความ | 1/5 | 5/5 |
| การปฏิบัติตามสไตล์ | ไม่มีการให้คะแนน | 5/5 |
| การขาดหายไปของวัตถุโบราณ | 5/5 | 5/5 |
| ความสะดวกในการใช้งานในกระบวนการผลิต | 1/5 | 5/5 |
ตัวอย่างที่มีคำแนะนำฟังดูชัดเจนและส่วนใหญ่ฟังดูเป็นธรรมชาติ แต่การอ่านคำแนะนำได้ทำลายความถูกต้องของข้อความและความสะดวกในการใช้งาน ตัวอย่างข้อความธรรมดาฟังดูเป็นธรรมชาติ ติดตามประโยคอย่างแม่นยำ และไม่จำเป็นต้องปรับเนื้อหาให้เหมาะสม คะแนนเหล่านี้อธิบายเพียงสอง qwen-audio-3.0-tts-flash ตัวควบคุม wrapper; พวกมันไม่ใช่การประเมินคุณภาพเสียงของจุดตรวจสอบ Qwen3-TTS.
อย่าสันนิษฐานว่าคำแนะนำเกี่ยวกับสไตล์และการบรรยายอยู่ในพื้นที่เดียวกัน คู่มือของเราเกี่ยวกับ ทำให้คำพูดที่เขียนโดย AI ฟังดูเป็นธรรมชาติมากขึ้น ช่วยปรับปรุงสคริปต์ แต่ฟิลด์ของจุดปลายทางจะเป็นตัวกำหนดว่าคำสั่งจะควบคุมเสียงหรือเข้าสู่การบันทึก.
จากการตรวจสอบในเครื่อง พบว่ามีการ์ดจอ NVIDIA GeForce MX450 พร้อม VRAM 2 GB และหน่วยความจำระบบประมาณ 16.9 GB ซึ่งไม่ใช่แพลตฟอร์มที่เหมาะสมสำหรับเมทริกซ์ 0.6B เทียบกับ 1.7B ที่วางแผนไว้ การถ่ายโอนภาระงานไปยัง CPU อาจเป็นเพียงความเร็วในช่วงเริ่มต้นเท่านั้น ซึ่งไม่สะท้อนความเร็วที่แท้จริง ดังนั้น คุณภาพเสียง Qwen3-TTS, RTF ในระบบท้องถิ่น, ความคล้ายคลึงในการคัดลอก และความสอดคล้องระหว่างภาษา จึงยังไม่ได้รับการให้คะแนน.
คุณภาพเสียงของ Qwen3-TTS: สิ่งที่หลักฐานสามารถพิสูจน์ได้
รายงานอย่างเป็นทางการแสดงผลลัพธ์ที่แข็งแกร่งของ Qwen3-TTS ในด้านความชัดเจนของเสียง ความคล้ายคลึงของผู้พูด การปฏิบัติตามคำสั่ง การสร้างข้อความหลายภาษา การพูดแบบยาว และการสตรีมมิ่ง ผลลัพธ์เหล่านี้เป็นข้อมูลเปรียบเทียบที่มีประโยชน์ แต่ยังคงเป็นเกณฑ์มาตรฐานที่รายงานโดย Qwen3-TTS ไม่ใช่การบันทึกเสียงที่สร้างขึ้นที่นี่.
การทดสอบเสียงสำหรับการผลิตควรครอบคลุมด้านการออกเสียง, เสียงรบกวน, ความเร็วในการพูด, อารมณ์, ความสามารถในการทำซ้ำ, ความยุ่งยากในการแก้ไข, การใช้คำย่อ, วันที่, สกุลเงิน, URL, ชื่อ, การเปลี่ยนภาษา, และประโยคที่ยาว.
ใช้การฟังร่วมกับข้อความถอดเสียงและข้อมูลเมตา; กระบวนการแปลงเสียงเป็นข้อความของ ChatGPT ทำให้การตรวจสอบข้อความสามารถทำซ้ำได้.
Qwen3-TTS ดูมีศักยภาพที่ดี แต่บทวิจารณ์นี้ไม่มีคะแนนจากจุดตรวจสอบโดยตรง ก่อนส่งสินค้า ให้ใช้การประมวลผลหลายรอบ ผู้ฟังแบบเนทีฟ หูฟัง และลำโพงโทรศัพท์.
สิ่งที่ผู้ประเมินจากภายนอกให้ความสำคัญ
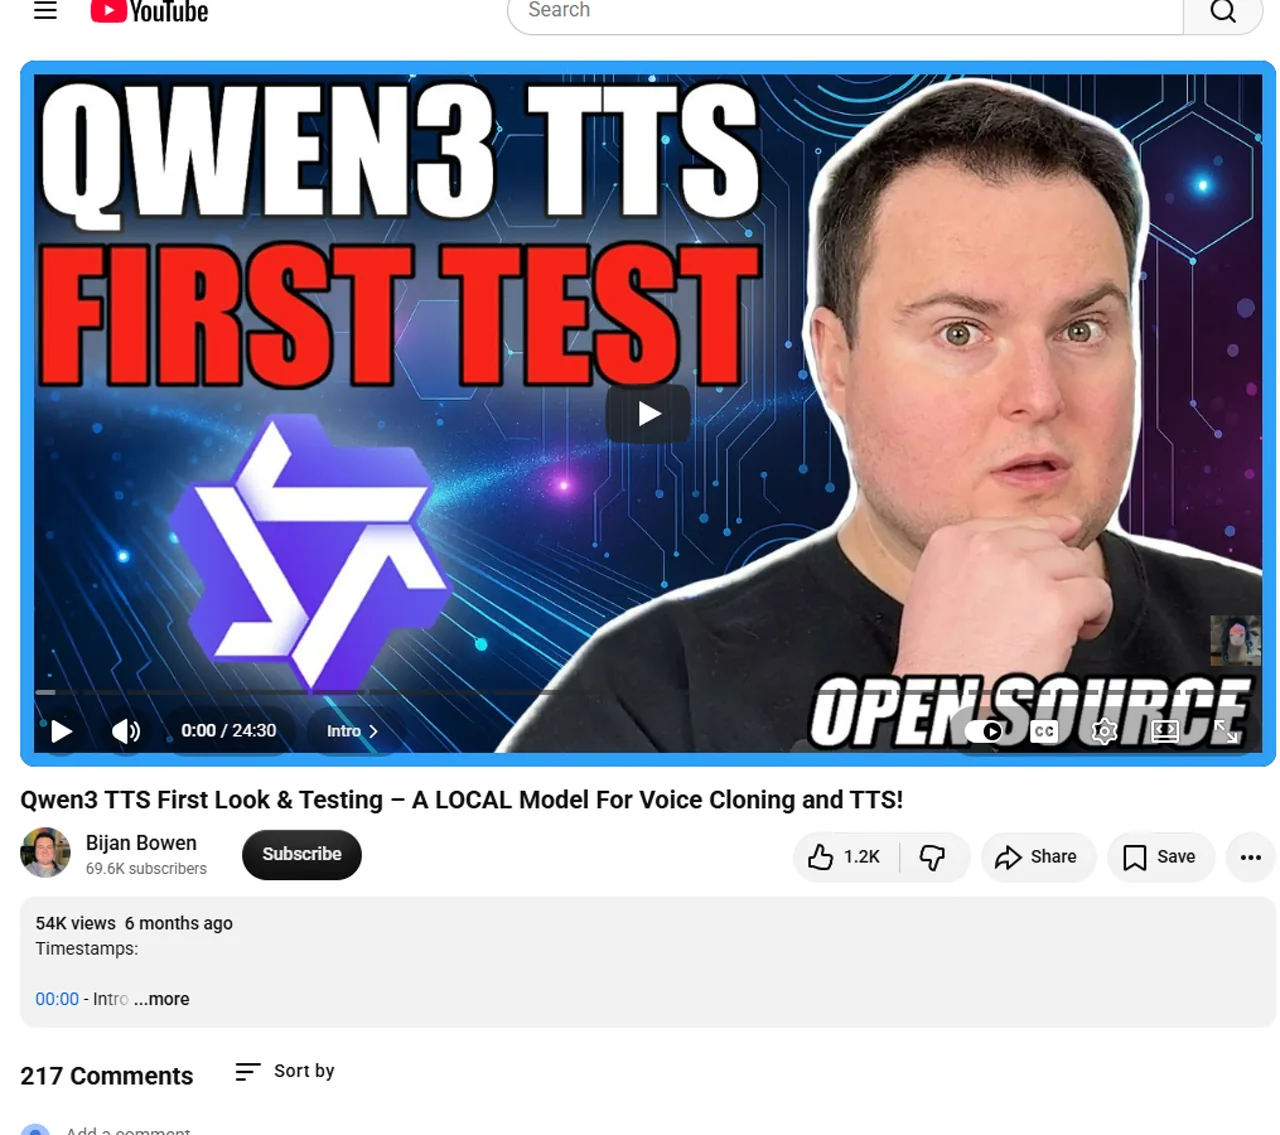
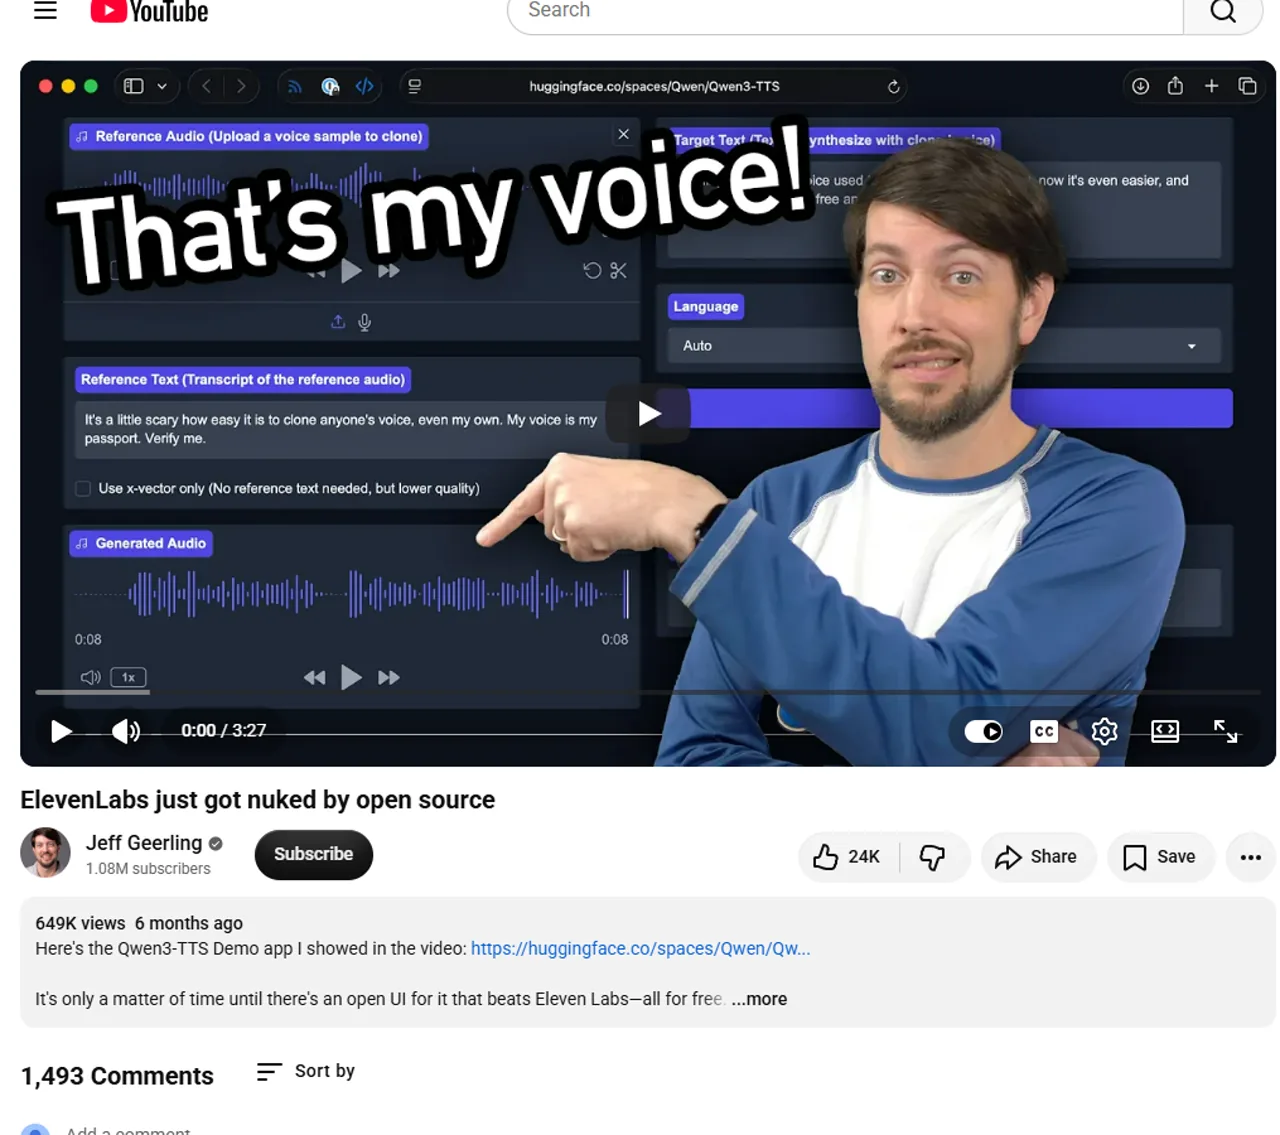
เวอร์ชันสาธิตทางสังคมของ Qwen แสดงให้เห็นถึงเสียงที่หลากหลาย ภาษา และสำเนียง ผู้สร้างอิสระ Bijan Bowen ให้ความสำคัญกับการดำเนินการในท้องถิ่นและการคัดลอกเสียง ส่วน Jeff Geerling มองว่าการเปิดตัวนี้เป็นการแข่งขันที่แข็งแกร่งจากด้านโอเพนซอร์สต่อแพลตฟอร์ม TTS ที่ได้รับการจัดการ มุมมองเหล่านี้เป็นความคิดเห็นของผู้รีวิว ไม่ใช่ผลการทดสอบมาตรฐานหรือหลักฐานของความเห็นพ้องต้องกันทั่วทั้งตลาด.
ความเร็วและความล่าช้าของ Qwen3-TTS
ความล่าช้าของแพ็กเก็ตแรก
0.288 / 0.313
0.6B / 1.7B เมื่อระดับการทำงานพร้อมกันอยู่ที่ 1.
สภาพแวดล้อม vLLM ภายในที่ได้รับการปรับแต่งให้เหมาะสม — ไม่รับประกันว่าสามารถใช้งานได้บนแล็ปท็อป.
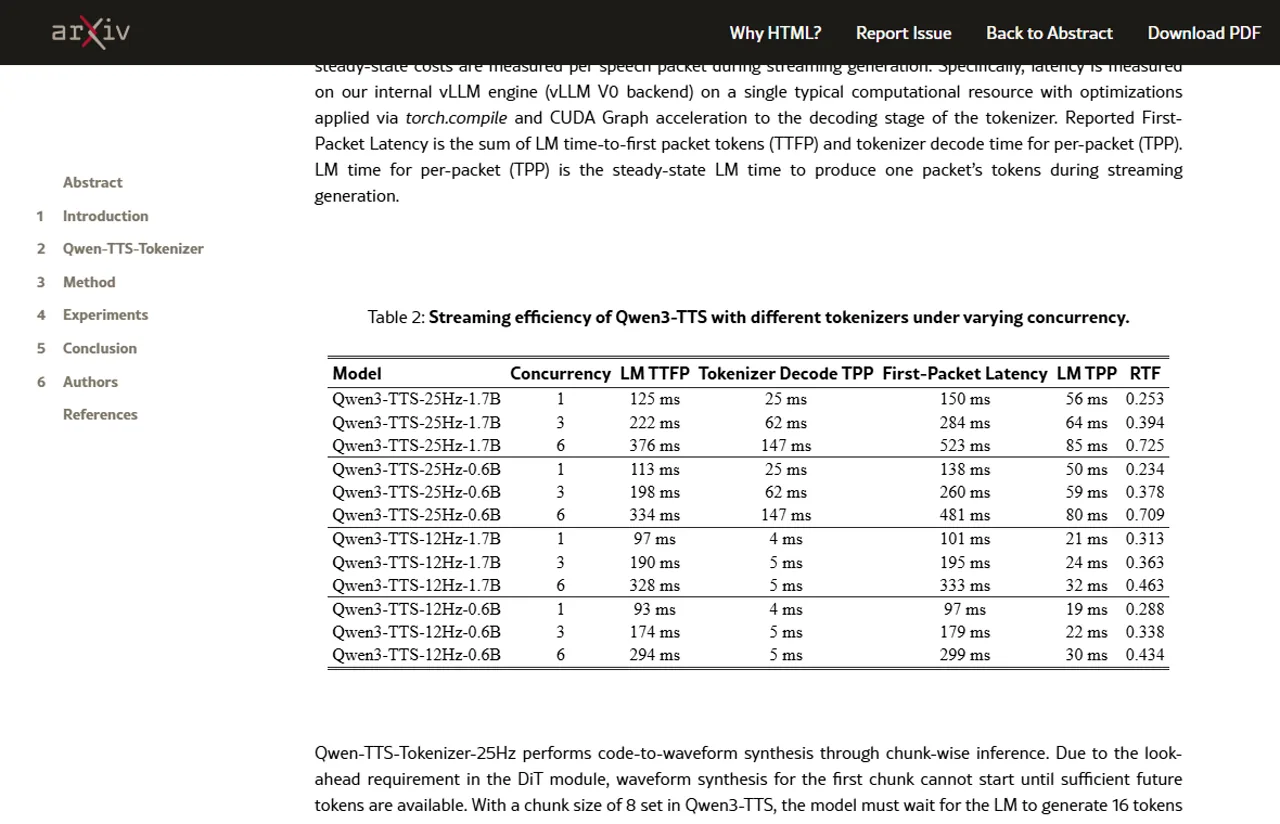
ค่าความล่าช้าของแพ็กเก็ตแรกที่ระบุในหัวข้อหลักคือ 97 ms สำหรับรุ่น 0.6B 12Hz ส่วนตารางในรายงานทางเทคนิคเดียวกันนี้ระบุค่า 101 ms สำหรับรุ่น 1.7B 12Hz ที่ระดับการทำงานพร้อมกัน 1. ค่า RTF ที่รายงานมาคือ 0.288 และ 0.313 ตามลำดับ ในภาษาที่เข้าใจง่าย ค่า RTF ที่ต่ำกว่า 1 หมายความว่ากระบวนการสังเคราะห์ทำงานได้เร็วกว่าความยาวของเสียงที่สร้างขึ้นในสภาพแวดล้อมนั้น.
ผลลัพธ์ดังกล่าวมาจากการตั้งค่า vLLM ภายในที่ได้รับการปรับแต่งของ Qwen และไม่ใช่คำสัญญาทั่วไปเกี่ยวกับเวลาที่ใช้จนถึงเสียงแรก (time-to-first-audio) สำหรับแล็ปท็อป Windows คอนเทนเนอร์แบบ serverless ที่ยังไม่ถูกเรียกใช้ หรือพื้นที่ API ที่ใช้ร่วมกัน รายงานยังแสดงให้เห็นว่า การทำงานพร้อมกันส่งผลต่อความล่าช้า การโหลดโมเดล การประมวลผลเสียงอ้างอิง การส่งผ่านเครือข่าย การจัดคิว การแพ็กเกจเสียง และการเล่นเสียงบนไคลเอนต์ ล้วนเป็นปัจจัยที่อยู่นอกเหนือจากจำนวนเดโคเดอร์หลัก.
บันทึกเกณฑ์มาตรฐานที่ยุติธรรมควรประกอบด้วย:
- ฮาร์ดแวร์ ความแม่นยำ การปรับปรุงรุ่น และความใส่ใจในส่วนหลังระบบ.
- สถานะเย็นหรือร้อน, การทำงานพร้อมกัน, เวลาที่เสียงแรกปรากฏ, เวลารวม, VRAM สูงสุด, ระยะเวลาการส่งออก และ RTF.
- สำหรับ API: ภูมิภาค, ประเภทการเชื่อมต่อ, ID คำขอ, การจัดคิว และการลองใหม่.
โมเดล 0.6B ควรเป็นตัวเลือกที่ปลอดภัยกว่า เมื่อความจำและการทำงานพร้อมกันมีความสำคัญมากกว่าความจุสูงสุด ส่วนโมเดล 1.7B เป็นตัวเลือกที่เหมาะสมกว่าในแง่คุณภาพ เมื่อเครื่องมีพื้นที่ว่างเพียงพอ แต่หากไม่ใช้คำสั่งเดียวกัน ผู้พูดเดียวกัน การตั้งค่าการสุ่มตัวอย่างเดียวกัน และสถานะวอร์มอัพเดียวกัน ขนาดของโมเดลเพียงอย่างเดียวไม่สามารถบอกความแตกต่างของความล่าช้าที่แท้จริงได้.
Qwen3-TTS ภาษาและวิธีออกเสียง
จุดตรวจสอบแบบเปิด Qwen3-TTS รองรับสิบภาษา ได้แก่: จีน, อังกฤษ, ญี่ปุ่น, เกาหลี, เยอรมัน, ฝรั่งเศส, รัสเซีย, โปรตุเกส, สเปน และอิตาลี รายชื่อนี้มาจากคลังข้อมูลปัจจุบันและวัสดุโมเดลที่เผยแพร่แล้ว อย่าเพิ่มภาษาไทย ภาษาอินโดนีเซีย ภาษามาเลย์ หรือภาษาเวียดนามเข้าไปอย่างเงียบๆ เพราะผลิตภัณฑ์เสียง Qwen อื่นๆ ได้สนับสนุนภาษาเหล่านี้แล้ว.
| ภาษา | การสนับสนุนอย่างเป็นทางการ | ลำดับความสำคัญในการตรวจสอบการผลิต |
|---|---|---|
| ภาษาจีน | ใช่ | เสียง ชื่อ การอ่านตัวเลข และสไตล์การเขียนตามภูมิภาค |
| อังกฤษ, ภาษาอังกฤษ | ใช่ | ความเครียด, คำย่อ, ชื่อแบรนด์, ประโยคที่ยาว |
| ภาษาญี่ปุ่น | ใช่ | เสียงเน้นในคำ, คำช่วย, ชื่อ, ข้อความภาษาละตินที่ผสม |
| เกาหลี | ใช่ | การเว้นช่องว่าง, คำยืม, การลงท้ายประโยค |
| ภาษาเยอรมัน | ใช่ | คำประสม, ตัวเลข, กลุ่มพยัญชนะ |
| ภาษาฝรั่งเศส | ใช่ | การประสานงาน, คำย่อ, ชื่อที่ยืมมา |
| ภาษารัสเซีย | ใช่ | ความเครียด, ชื่อ, ตัวเลข, การแทรกคำภาษาละติน |
| ภาษาโปรตุเกส | ใช่ | ยืนยันสำเนียงท้องถิ่นและวิธีเขียนที่ตั้งใจใช้ |
| สเปน | ใช่ | ตรวจสอบสำเนียงท้องถิ่นและชื่อเฉพาะ |
| ภาษาอิตาลี | ใช่ | การเครียด, การเพิ่มพยางค์, ชื่อภาษาต่างประเทศ |
“สนับสนุน” หมายความว่าโมเดลสามารถสังเคราะห์ภาษาได้ แต่ไม่ได้หมายความว่าทุกเสียงจะฟังเหมือนเจ้าของภาษาอย่างเท่าเทียมกันในทุกภูมิภาค ภาษาโปรตุเกสและภาษาสเปนเองก็มีความแตกต่างทางภูมิภาคที่สำคัญ การนำไปใช้ในเชิงพาณิชย์ควรกำหนดภูมิภาคเป้าหมาย จ้างผู้ตรวจสอบที่เป็นเจ้าของภาษา และสร้างชุดข้อมูลการถดถอยการออกเสียงสำหรับชื่อ การวัดค่า ที่อยู่ และวลีทางกฎหมาย.
การเปลี่ยนภาษา (code-switching) จำเป็นต้องมีการทดสอบเฉพาะตัว ประโยคเช่น “Open the Qwen3-TTS API in São Paulo at 9:30 a.m.” รวมกรอบประโยคภาษาอังกฤษ ชื่อโมเดล การออกเสียงภาษาโปรตุเกส เครื่องหมายวรรคตอน และเวลา สิ่งนี้ใกล้เคียงกับข้อความในแอปจริงมากกว่าประโยคตัวอย่างแบบเดียวภาษาที่เรียบง่าย สำหรับการพากย์เสียงในวิดีโอ การออกเสียงยังต้องสอดคล้องกับจังหวะเวลาด้วย; ของเรา Veo 3.1 กระบวนการทำงานด้านบทสนทนา เสียง และการซิงค์ริมฝีปาก ครอบคลุมปัญหาการซิงโครไนซ์ในบริเวณรอบข้าง.
การคัดลอกเสียง, CustomVoice และ VoiceDesign
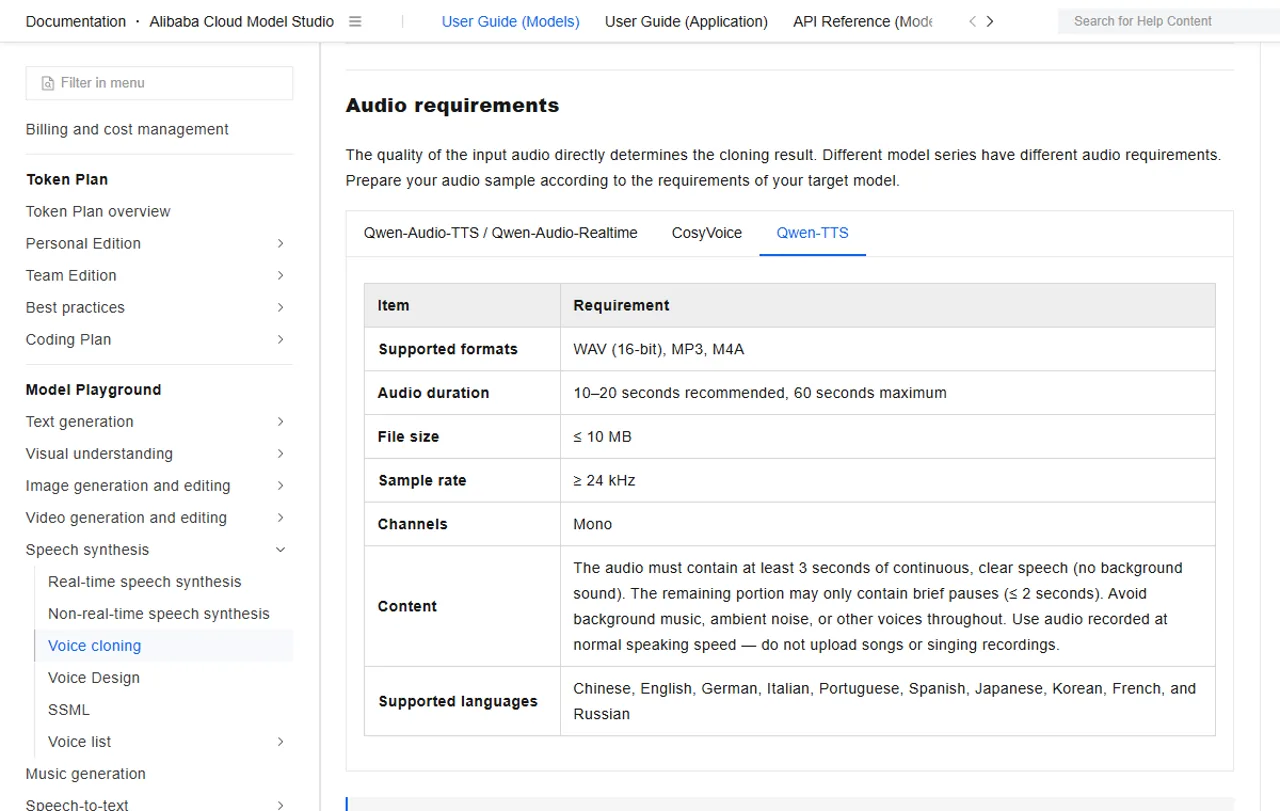
จุดตรวจสอบของ Base รองรับการคัดลอกเสียงอย่างรวดเร็วจากเสียงอ้างอิงที่มีความยาวประมาณสามวินาที นี่เป็นขีดความสามารถขั้นต่ำที่น่าประทับใจ ไม่ใช่คำสัญญาว่าเสียงอ้างอิงสามวินาทีจะเป็นตัวอย่างที่ดีที่สุดสำหรับการผลิตเสมอไป ตัวอย่างเสียงอ้างอิงที่สั้นอาจขาดช่วงเสียง จังหวะการพูด ความครอบคลุมของสระ อารมณ์ และความสม่ำเสมอของไมโครโฟน.
คู่มือการลงทะเบียนแบบโฮสต์ของ Alibaba Cloud มีแนวทางที่ระมัดระวังกว่า: กำหนดให้ต้องมีเสียงพูดที่ชัดเจนและต่อเนื่องอย่างน้อยสามวินาที อนุญาตให้ใช้ตัวอย่างเสียงที่ยาวกว่า และแนะนำให้บันทึกเสียงที่ชัดเจนและยาวกว่า เพื่อการคัดลอกที่ใช้งานได้จริง โปรดทำตามขั้นตอนปัจจุบัน เอกสารเกี่ยวกับเทคโนโลยีการคัดลอกเสียง สำหรับกฎเกี่ยวกับรูปแบบ อัตราตัวอย่าง ช่องสัญญาณ ระยะเวลา และภูมิภาค แทนที่จะถือว่าการสาธิตสามวินาทีในบทความนั้นเป็นข้อกำหนดสำหรับการอัปโหลด.
CustomVoice ไม่ใช้การคัดลอกเสียงของบุคคลจริง การเปิดตัวเวอร์ชันนี้มาพร้อมกับเสียงคุณภาพสูง 9 แบบ สำหรับภาษาหรือสไตล์ต่าง ๆ ซึ่งทำให้เป็นตัวเลือกที่น่าสนใจเมื่อการตั้งค่าตัวตนล่วงหน้าและการควบคุมคำสั่งเพียงพอก็เพียงพอแล้ว.
VoiceDesign สร้างเสียงจากคำอธิบายด้วยภาษาธรรมชาติ ระบบที่โฮสต์ เอกสารการออกแบบเสียง แสดงขั้นตอนการสร้างที่แยกกัน ซึ่งเหมาะสำหรับตัวละครในนิยายและเสียงแบรนด์ที่สร้างขึ้น แต่คำอธิบายยังต้องผ่านการทดสอบด้านอายุที่รับรู้ได้ สำเนียง และอคติทางวัฒนธรรม.
แมทริกซ์ความเสี่ยงด้านเอกลักษณ์เสียง
บันทึกชื่อผู้พูด ขอบเขต คำศัพท์ และขั้นตอนการถอนตัว.
เข้ารหัสการอ้างอิงและลบเสียงที่สร้างขึ้นจากข้อมูลต้นทาง.
บล็อกคำกล่าวอ้างเกี่ยวกับตัวตนที่เป็นอันตราย และเพิ่มฟังก์ชันการรายงาน.
ให้ติดป้ายกำกับเสียงสังเคราะห์เมื่อผู้ฟังอาจเข้าใจผิดว่าเป็นเสียงของมนุษย์.
การคัดลอกข้อมูลจำเป็นต้องมีสิทธิ์ที่ชัดเจนและความยินยอมที่ได้รับการแจ้งให้ทราบอย่างครบถ้วน ให้เก็บรักษาบันทึกความยินยอมต้นฉบับ กำหนดการใช้งานที่ได้รับอนุญาต ป้องกันการลงทะเบียนซ้ำในขั้นตอนต่อไป และจัดให้มีขั้นตอนการลบข้อมูล ความเสี่ยงเหล่านี้ไม่ใช่เพียงทฤษฎีเท่านั้น; การวิเคราะห์ความเป็นส่วนตัวและการให้ความยินยอมในระบบแปลงเสียงจากใบหน้า อธิบายว่าทำไมการตรวจสอบตัวตน ข้อมูลชีวภาพ และมาตรการป้องกันการแอบอ้างตัวตน จึงควรเป็นส่วนหนึ่งของการออกแบบผลิตภัณฑ์ แทนที่จะเป็นเพียงหมายเหตุท้ายหน้า.
Qwen3-TTS 0.6B vs 1.7B: คุณควรใช้เวอร์ชันไหน?
เลือก 0.6B เมื่อข้อจำกัดแรกของคุณคือการปรับใช้ นี่เป็นตัวเลือกที่เหมาะสมกว่าสำหรับ GPU ขนาดเล็ก การทำงานพร้อมกันในระดับสูง การทดลองที่รวดเร็วขึ้น และการโฮสต์ด้วยตนเองที่คำนึงถึงค่าใช้จ่าย ทั้ง Base และ CustomVoice มีอยู่ในขนาดนี้ ดังนั้นคุณจึงสามารถประเมินการคัดลอกหรือใช้เสียงที่ตั้งค่าไว้ล่วงหน้าได้ โดยไม่ต้องเริ่มต้นจากจุดตรวจสอบที่ใหญ่ที่สุด.
เลือก 1.7B เมื่อความยืดหยุ่นด้านคุณภาพและความหลากหลายของฟีเจอร์เป็นปัจจัยสำคัญกว่า นี่คือขนาดเดียวที่ได้รับการปล่อยออกมาพร้อม VoiceDesign และถือเป็นตัวเลือกที่เหมาะสมกว่าสำหรับทีมที่พร้อมแลกความจุกับความจำและอัตราการส่งข้อมูล ตัวเลขความพร้อมกัน 1 ในรายงานทางเทคนิคแสดงให้เห็นถึงความแตกต่างเล็กน้อยในเวลาส่งแพ็กเก็ตแรกและ RTF ในการตั้งค่าที่ได้รับการปรับแต่งของ Qwen แต่ฮาร์ดแวร์ของคุณเองอาจทำให้ช่องว่างนั้นเพิ่มขึ้นหรือลดลงได้.
| ปัจจัยในการตัดสินใจ | เริ่มจาก 0.6B | เริ่มจาก 1.7B |
|---|---|---|
| หน่วยความจำ GPU มีจำกัด | การสวมใส่ที่กระชับยิ่งขึ้น | ความเสี่ยงที่สูงขึ้นต่อการถ่ายโอนภาระงานหรือการประมวลผลพร้อมกันที่ต่ำ |
| ต้องการบริการ VoiceDesign | ไม่มีในชุดที่ออกจำหน่ายแล้ว | จำเป็น |
| ต้องการการโคลนนิ่งแบบฐาน | มีให้บริการ | มีรุ่นที่มีความจุมากขึ้น |
| ต้องการ CustomVoice | มีให้บริการ | มีรุ่นที่มีความจุมากขึ้น |
| ต้องการการทดสอบความเป็นไปได้แบบรวดเร็ว | จุดเริ่มต้นที่ดีที่สุด | ใช้หลังจากงานท่อส่งเสร็จสิ้น |
| ต้องการตัดสินใจเลือกแบบผลิตขั้นสุดท้าย | เปรียบเทียบทั้งสอง | เปรียบเทียบทั้งสอง |
จำนวนพารามิเตอร์ไม่ใช่ข้อกำหนดของ VRAM ความแม่นยำ การนำระบบ Attention มาใช้ แคช ความยาวการอ้างอิง ขนาดแบทช์ และค่าใช้จ่ายของเฟรมเวิร์ก ล้วนมีความสำคัญทั้งสิ้น โมเดลที่โหลดได้เพียงเล็กน้อยไม่ถือเป็นบริการในสภาพแวดล้อมการผลิตที่เชื่อถือได้.
สำหรับ MX450 ความจุ 2 GB ที่ได้รับการตรวจสอบในบทรีวิวนี้ ทั้งสองขนาดไม่ได้ให้ผลลัพธ์การทดสอบประสิทธิภาพ GPU ที่เป็นตัวแทนได้ ขั้นตอนต่อไปที่ปฏิบัติได้จริงคือการใช้ CUDA stack รุ่นใหม่กว่า ร่วมกับ GPU ที่เหมาะสม หรือจุดปลายทาง (endpoint) ที่ได้รับการสนับสนุนอย่างเป็นทางการ คำว่า “มันทำงานได้ด้วยการถ่ายโอนภาระงานไปยัง CPU” เป็นเพียงหมายเหตุเกี่ยวกับความเข้ากันได้ ไม่ใช่คำตัดสินที่มีความหมายเกี่ยวกับความเร็ว.
API Qwen3-TTS: HTTP, การสตรีม และรหัสโมเดล
เลือกวิธีการขนส่งให้เหมาะสมกับความต้องการในการเล่นซ้ำ
วิธีที่ง่ายที่สุดสำหรับการบรรยายแบบกลุ่มและไฟล์ที่ครบถ้วน.
ส่งข้อมูลแบบค่อยเป็นค่อยไป; ยังต้องตรวจสอบว่าเสียงสามารถเล่นได้เมื่อใด.
เหมาะที่สุดสำหรับการสนทนาและการเล่นเพลงแบบต่อเนื่อง.
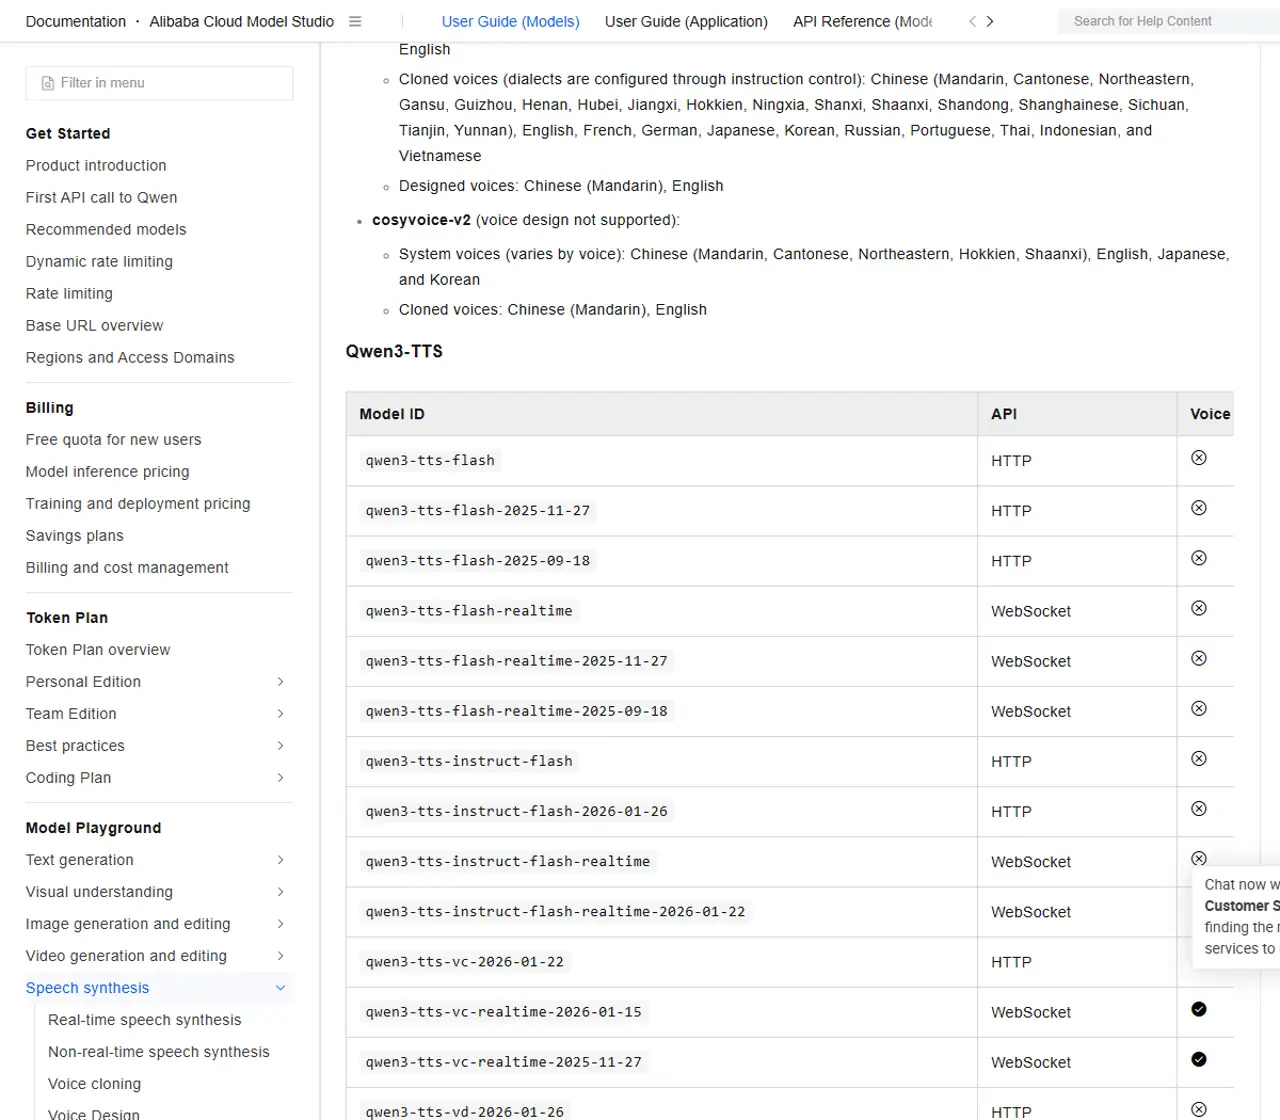
Alibaba Cloud ให้บริการทั้งแบบการสร้าง HTTP แบบไม่เรียลไทม์และแบบ WebSocket แบบเรียลไทม์ ให้ใช้การสร้างแบบไม่เรียลไทม์เมื่อสามารถรอผลลัพธ์ที่สมบูรณ์ได้ และต้องการกระบวนการขอข้อมูลที่เรียบง่ายที่สุด ใช้การสตรีม WebSocket เมื่อความล่าช้าในการสนทนาหรือการเล่นแบบค่อยเป็นค่อยไปเป็นปัจจัยสำคัญ การสตรีม HTTP หรือเหตุการณ์ที่ส่งจากเซิร์ฟเวอร์ (Server-Sent Events) สามารถส่งข้อมูลแบบเพิ่มทีละส่วนได้ แต่ไม่ควรสับสนกับกลุ่มโมเดลแบบเรียลไทม์ที่มีความล่าช้าต่ำโดยเฉพาะ.
กลุ่มเสียงที่ให้บริการในปัจจุบัน ได้แก่ Qwen3-TTS Flash สำหรับเสียงที่ติดตั้งมาพร้อมระบบ, Instruct Flash สำหรับการควบคุมการทำงานด้วยภาษาธรรมชาติ, VC สำหรับเสียงที่คัดลอกมา, และ VD สำหรับเสียงที่ออกแบบขึ้น ID ของโมเดลและสแนปช็อตที่มีวันที่จะแตกต่างกันระหว่างเส้นทางแบบไม่เรียลไทม์และแบบเรียลไทม์ ดังนั้นควรคัดลอกข้อมูลจากเอกสารปัจจุบันแทนที่จะสร้างชื่อโดยอาศัยการเปรียบเทียบ.
ปัจจุบัน เอกสาร API ของ Qwen-TTS จำกัดปริมาณข้อมูลเข้าไว้ที่ 512 tokens ต่อคำขอ นี่คือขีดจำกัดที่เกี่ยวข้องกับตระกูลนี้; กฎ 600 ตัวอักษรที่ระบุไว้สำหรับโมเดล TTS อื่น ๆ ไม่ควรถูกคัดลอกมาใช้ในระบบการบูรณาการ Qwen3-TTS URL ของไฟล์เสียงครบถ้วนมีอายุการใช้งาน 24 ชั่วโมง ดังนั้น ระบบผลิตควรย้ายไฟล์ที่จำเป็นไปยังพื้นที่จัดเก็บข้อมูลที่คงทน แทนที่จะใช้ URL ของการตอบกลับเป็นสื่อถาวร.
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

response = dashscope.MultiModalConversation.call(
    model="qwen3-tts-flash",
    api_key=os.environ["DASHSCOPE_API_KEY"],
    text="Your order is ready for pickup at 4:30 p.m.",
    voice="Cherry",
    language_type="English",
)

print(response)
กุญแจ API และภูมิภาคของจุดปลายทางต้องตรงกัน การติดตั้งในกรุงปักกิ่งและสิงคโปร์ใช้ข้อมูลรับรองและ URL ฐานที่แตกต่างกัน ในขณะที่ความพร้อมใช้งานของโมเดลอาจแตกต่างกันไปตามภูมิภาค อย่าฝังกุญแจไว้ใน WordPress, JavaScript ฝั่งไคลเอนต์ หรือไฟล์ไบนารีบนมือถือ ส่งคำขอสังเคราะห์ผ่านเซิร์ฟเวอร์ที่คุณควบคุม บันทึก ID ของคำขอโดยไม่บันทึกข้อมูลป้อนเข้าที่ละเอียดอ่อน และกำหนดนโยบายวงจรชีวิตสำหรับเสียงที่สร้างขึ้น.
สำหรับเอกสารที่ยาว ให้แบ่งเป็นส่วนๆ ตามขอบเขตความหมาย รักษาบริบท ปรับตัวเลขให้เป็นมาตรฐาน และตรวจสอบทุกจุดที่ข้อมูลถูกเชื่อมต่อกัน คลิปที่ผ่านการตรวจสอบแล้วอาจยังคงฟังเหมือนการบันทึกแยกกัน เมื่อจังหวะหรือพลังงานเปลี่ยนแปลงระหว่างการโทร.
ราคาของ Qwen3-TTS ในตลาดต่างประเทศ
ภาพรวมราคาในภูมิภาคระดับนานาชาติ
แฟลช
$0.10
ต่อทุก 10,000 ตัวอักษรที่ป้อนเข้าInstruct / VC / VD
$0.115
ต่อทุก 10,000 ตัวอักษรที่ป้อนเข้าFlash / VC
$0.13
ต่อทุก 10,000 ตัวอักษรที่ป้อนเข้าคำสั่ง
$0.143
ต่อทุก 10,000 ตัวอักษรที่ป้อนเข้าVD
$0.143353
ต่อทุก 10,000 ตัวอักษรที่ป้อนเข้าการสร้างเสียง: $0.01 ต่อการลงทะเบียน · $0.20 ต่อเสียงที่ออกแบบไว้.
Alibaba Cloud’s หน้าราคาของ Model Studio แสดงราคาสำหรับภูมิภาคระหว่างประเทศดังต่อไปนี้ เมื่อตรวจสอบเมื่อวันที่ 11 สิงหาคม 2026 สำหรับแถวเหล่านี้ การป้อนข้อมูลจะถูกคิดค่าบริการ ส่วนการส่งออกข้อมูลนั้นฟรี ราคา ขีดจำกัดฟรี ชื่อเรียกแทน (alias) และความพร้อมใช้งานในแต่ละภูมิภาคอาจเปลี่ยนแปลงได้ ดังนั้นควรตรวจสอบการปรับใช้ที่เลือกไว้ก่อนดำเนินการในชุดข้อมูลขนาดใหญ่.
| เส้นทาง | ครอบครัวตัวอย่าง | ราคาต่อ 10,000 ตัวอักษรที่ป้อนเข้า |
|---|---|---|
| ไม่ใช่แบบเรียลไทม์ | Qwen3-TTS Flash | $0.10 |
| ไม่ใช่แบบเรียลไทม์ | Instruct, VC หรือ VD | $0.115 |
| แบบเรียลไทม์ | Flash หรือ VC ปัจจุบัน | $0.13 |
| แบบเรียลไทม์ | คำสั่ง | $0.143 |
| แบบเรียลไทม์ | VD | $0.143353 |
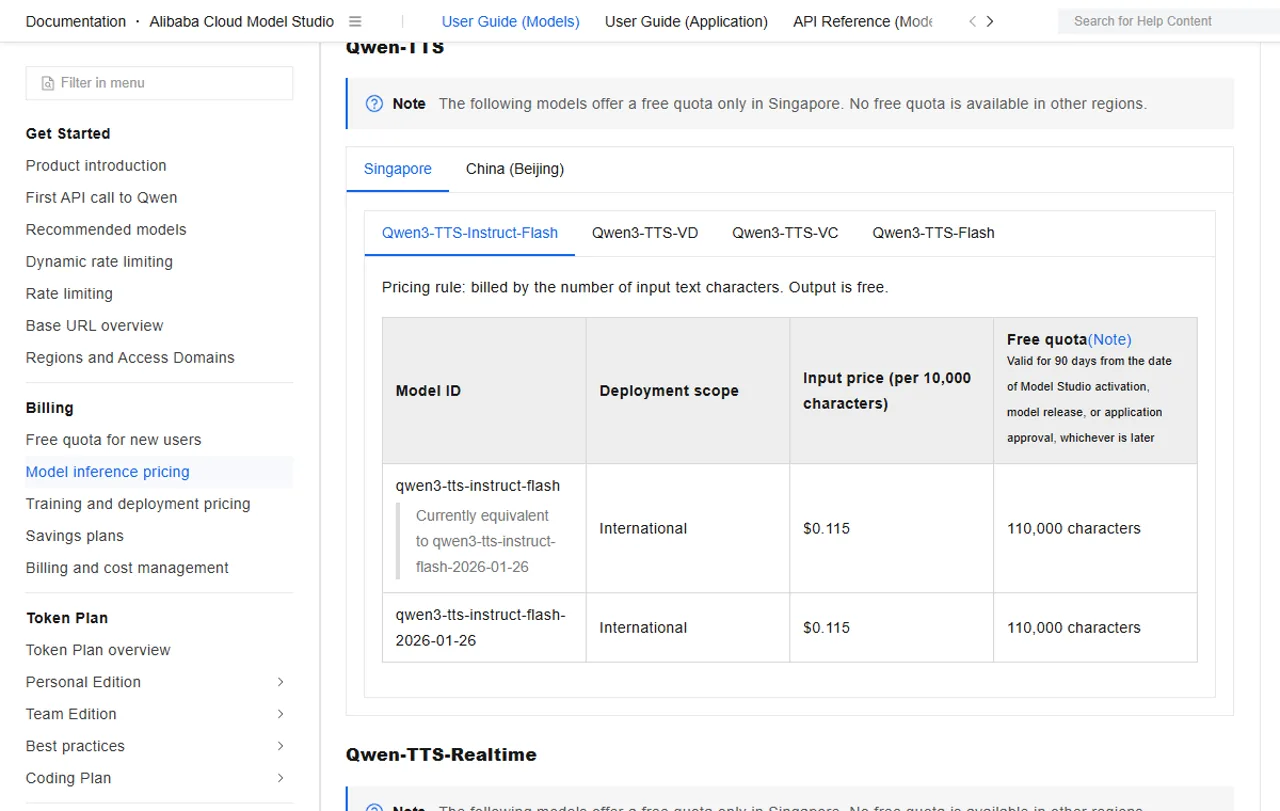
การสร้างเสียงเป็นค่าใช้จ่ายที่แยกต่างหากจากกระบวนการสังเคราะห์เสียง ในตารางราคาสากลเดียวกันนี้ ระบุค่าการลงทะเบียนเสียง Qwen อยู่ที่ $0.01 ต่อแต่ละสำเนา และค่าการออกแบบเสียงอยู่ที่ $0.20 ต่อเสียงที่ออกแบบแต่ละเสียง โดยเมื่อใช้สำเนาหรือเสียงที่ออกแบบแล้ว จะมีการคิดค่าสังเคราะห์เสียงตามจำนวนตัวอักษรที่เกี่ยวข้อง.
ควรกำหนดงบประมาณสำหรับการสร้างเสียง การสังเคราะห์เสียง ตัวละคร โครงสร้างพื้นฐาน และการสร้างใหม่ให้แยกกัน การใช้เวลาในการแก้ไขและการโทรซ้ำบ่อยครั้งมักเป็นปัจจัยที่กำหนดต้นทุนการผลิตจริง.
ราคา API ไม่เท่ากับค่าใช้จ่ายในท้องถิ่น การใช้ Open Checkpoints ช่วยขจัดระบบการคิดค่าบริการตามจำนวนตัวอักษรของผู้ให้บริการ แต่จะเพิ่มค่าใช้จ่ายในด้านเวลาการใช้งาน GPU การออกแบบระบบการปรับใช้ การเฝ้าติดตาม การจัดเก็บข้อมูล การปรับขนาด และการตอบสนองต่อเหตุการณ์ การโฮสต์ด้วยตนเองจะมีความได้เปรียบเมื่อการควบคุม ปริมาณข้อมูล ความใกล้เคียงของข้อมูล หรือการปรับแต่งสามารถชดเชยภาระการดำเนินงานดังกล่าวได้.
ทางเลือกอื่นและเส้นทางเสียง GlobalGPT
Qwen3-TTS อาจไม่ใช่ตัวเลือกที่ดีที่สุดโดยอัตโนมัติสำหรับทุกงานเสียง ElevenLabs เป็นแพลตฟอร์มเสียงแบบจัดการที่พัฒนาแล้วมากขึ้น สำหรับทีมที่ให้ความสำคัญกับแดชบอร์ดที่ดูเรียบร้อย เครื่องมือผลิตที่ครอบคลุม และต้องการโครงสร้างพื้นฐานที่น้อยลง โมเดลเสียง OpenAI อาจเหมาะสมกับผู้พัฒนาที่กำลังปรับใช้ระบบ API เดียวเป็นมาตรฐานแล้ว ส่วน Qwen-Audio 3.0 TTS เป็นเวอร์ชันใหม่ของ Qwen ที่ให้บริการแบบโฮสต์ ซึ่งควรนำมาเปรียบเทียบเมื่อปฏิบัติตามคำแนะนำปัจจุบันของ Alibaba Cloud.
ความต้องการด้านดนตรีและเสียงเอฟเฟกต์ควรถูกนำมาเปรียบเทียบในอีกส่วนหนึ่ง ส่วน การเปรียบเทียบเสียงระหว่าง ElevenLabs, Lyria 3 Pro และ Mureka ช่วยแยกเครื่องมือเสียงพูดออกจากระบบสร้างดนตรีแบบเต็มรูปแบบ โมเดลแปลงข้อความเป็นเสียงพูดไม่ควรถูกหักคะแนนเพียงเพราะไม่สามารถสร้างเพลงที่ผ่านการปรับแต่งอย่างสมบูรณ์ได้ และโมเดลดนตรีก็ไม่ควรถูกเลือกใช้เป็น API สำหรับการบรรยายที่มีความหน่วงต่ำ.
GlobalGPT ปัจจุบันมีบัญชีที่ได้รับการยืนยันแล้ว เส้นทางของเครื่องสร้างเสียง ที่แสดงรายการ qwen-audio-3.0-tts-flash และ Seed Audio 1.0 หน้าตรวจสอบดังกล่าวไม่ได้ระบุ Qwen3-TTS ซึ่งทำให้ GlobalGPT กลายเป็นพื้นที่ทำงานเสียงที่แยกต่างหากอย่างแท้จริง ไม่ใช่หลักฐานว่าจุดตรวจสอบ Qwen3-TTS ที่เปิดอยู่มีอยู่ที่นั่น.
หากผลิตภัณฑ์สุดท้ายของคุณเป็นวิดีโอ ให้ตัดสินใจว่าคุณต้องการผู้บรรยายแยกต่างหาก บทสนทนาที่สร้างขึ้นด้วยระบบอัตโนมัติ เสียงเอฟเฟกต์ หรือโมเดลที่สร้างเสียงไปพร้อมกับภาพหรือไม่ คำตอบของเราคือ Veo 3.1 มีเสียงหรือไม่ ช่วยกำหนดทิศทางของกระบวนการตัดสินใจนั้นให้กว้างขึ้น เส้นทางที่ชาญฉลาดที่สุดมักคือการใช้ชุดเครื่องมือเฉพาะทางขนาดเล็กหลายชิ้น แทนที่จะบังคับให้โมเดลเดียวต้องทำงานด้านเสียงทุกประเภท.
ใบอนุญาต ความยินยอม ความเป็นส่วนตัว และการใช้งานเชิงพาณิชย์
คลังข้อมูล Qwen3-TTS และบัตรโมเดลที่เผยแพร่ใช้ใบอนุญาต Apache-2.0 ซึ่งใบอนุญาตนี้สนับสนุนการพัฒนา การปรับเปลี่ยน และการแจกจ่ายในเชิงพาณิชย์ แต่ไม่ให้สิทธิ์ในการใช้เสียง การแสดง บทละคร เครื่องหมายการค้า หรือข้อมูลส่วนตัวของบุคคลอื่น ใบอนุญาตโมเดลและสิทธิ์ในเนื้อหาเป็นสองชั้นที่แยกกัน.
การประมวลผลข้อมูลในท้องถิ่นช่วยให้คุณควบคุมได้มากขึ้นและมีความรับผิดชอบด้านความปลอดภัยมากขึ้น คุณสามารถเข้ารหัสการบันทึกข้อมูลอ้างอิง จำกัดการเข้าถึง ลดระยะเวลาการเก็บรักษาข้อมูลให้เหลือน้อยที่สุด บันทึกข้อมูลที่สร้างขึ้นจากข้อมูลต้นฉบับ และขยายการลบข้อมูลไปยังเสียงที่ลงทะเบียนและผลลัพธ์ที่เก็บไว้ในแคช.
สำหรับการสังเคราะห์เสียงแบบโฮสต์ โปรดตรวจสอบเงื่อนไขการให้บริการ การจัดการข้อมูลตามภูมิภาค การเก็บรักษาข้อมูล และระบบควบคุมขององค์กร ก่อนส่งสคริปต์หรือตัวอย่างเสียงที่เป็นความลับ.
เสียงสังเคราะห์ที่เผยแพร่สู่สาธารณะทุกเสียงควรมีเจ้าของ บันทึกการให้ความยินยอม นโยบายการใช้ที่อนุญาต และขั้นตอนการตอบสนองต่อการใช้งานผิดวัตถุประสงค์ ควรเพิ่มข้อมูลแจ้งเตือนเมื่อเสียงสังเคราะห์ดังกล่าวอาจถูกเข้าใจผิดว่าเป็นบุคคลจริงได้อย่างสมเหตุสมผล ควรห้ามการแอบอ้างเป็นบุคคลทั่วไปและบุคคลสาธารณะที่มีความเสี่ยงสูง และจัดให้มีช่องทางสำหรับรายงานเสียงที่ก่อให้เกิดอันตราย.
ใครควรใช้ Qwen3-TTS?
เส้นทางไหนเหมาะสม?
รองรับ Pipeline, ความจำที่แน่นขึ้น, Base หรือ CustomVoice.
VoiceDesign หรือการเปรียบเทียบคุณภาพและกำลังประมวลผล โดยใช้พื้นที่ว่างของ GPU.
การทำงานที่รวดเร็วขึ้นเมื่อภูมิภาค นโยบายความเป็นส่วนตัว และราคาเหมาะสม.
สตูดิโอที่ไม่ต้องตั้งค่าล่วงหน้า, ตลาดออนไลน์ที่ได้รับใบอนุญาต, หรือการสนับสนุนผู้ขายที่มีอยู่แล้ว.
Qwen3-TTS เหมาะสำหรับนักวิจัย ผู้พัฒนา ทีมเกม และกลุ่มการแปลภาษา ที่ต้องการน้ำหนักแบบเปิด ตัวเลือกการปรับใช้ การคัดลอก หรือเสียงตัวละครที่อธิบายด้วยข้อความ.
เริ่มต้นด้วย 0.6B หากกำลังทดสอบกระบวนการทำงาน (pipeline) จัดการความจำที่จำกัด หรือทดสอบว่า Base และ CustomVoice ตอบสนองความต้องการของผลิตภัณฑ์หรือไม่ เริ่มต้นด้วย 1.7B หากต้องการใช้ VoiceDesign หรือมีฮาร์ดแวร์เพียงพอเพื่อเปรียบเทียบคุณภาพและปริมาณงานได้อย่างถูกต้อง ใช้ API ที่โฮสต์ไว้หากโครงสร้างพื้นฐานเป็นจุดคอขวด และความพร้อมใช้งานตามภูมิภาค ข้อมูลรับรอง และการจัดการข้อมูลเหมาะสมกับโครงการ.
เลือกทางเลือกอื่นหากต้องการสตูดิโอตัดต่อที่ไม่ต้องตั้งค่าล่วงหน้า ตลาดเสียงที่มีใบอนุญาตขนาดใหญ่ หรือการสนับสนุนสำหรับองค์กรที่มีอยู่แล้วจากผู้จำหน่ายอื่น อย่าคัดลอกโดยไม่ได้รับความยินยอมที่บันทึกไว้.
ใช้สคริปต์จริง 5 ตัว, การทำซ้ำ 3 ครั้ง, รายชื่อที่มีชื่อยาก, ย่อหน้ายาว และทดสอบการกู้คืน 1 ครั้ง วัดค่าความล่าช้าและค่าใช้จ่าย แล้วถามผู้ฟังที่เป็นเจ้าของภาษาว่าผลลัพธ์นั้นพร้อมใช้งานได้โดยไม่ต้องแก้ไขหรือไม่ การแก้ไขอาจทำให้ผลลัพธ์ที่ดีในการทดสอบประสิทธิภาพกลับกลายเป็นไม่ดีได้.
คำถามที่พบบ่อยเกี่ยวกับ Qwen3-TTS
Qwen3-TTS ใช้ได้ฟรีหรือไม่?
จุดตรวจสอบ Qwen3-TTS ที่ได้ปล่อยออกมาแล้วมีให้ใช้งานภายใต้ใบอนุญาต Apache-2.0 ดังนั้นคุณจึงสามารถดาวน์โหลดและใช้งานได้โดยไม่ต้องจ่ายค่าธรรมเนียมตามจำนวนตัวอักษรของโมเดล การโฮสต์ด้วยตนเองยังคงมีค่าใช้จ่ายด้านทรัพยากรการประมวลผล พื้นที่จัดเก็บข้อมูล การพัฒนา และการตรวจสอบ ส่วน API Qwen3-TTS ที่ Alibaba Cloud ให้บริการเป็นบริการแบบมีค่าใช้จ่าย โดยมีราคาและโควตาที่แตกต่างกันตามภูมิภาค.
Qwen3-TTS สามารถนำไปใช้ในเชิงพาณิชย์ได้หรือไม่?
ใบอนุญาต Apache-2.0 อนุญาตให้ใช้โค้ดและน้ำหนักโมเดลที่เผยแพร่แล้วในวัตถุประสงค์เชิงพาณิชย์ แต่ไม่ให้สิทธิ์ในการคัดลอกเสียงของบุคคลใด หรือใช้สคริปต์และแบรนด์ที่ได้รับการคุ้มครอง โครงการเชิงพาณิชย์ยังคงต้องได้รับความยินยอมจากผู้พูด สิทธิ์ในเนื้อหา การควบคุมความเป็นส่วนตัว และการปฏิบัติตามกฎหมายท้องถิ่นและเงื่อนไขของแพลตฟอร์ม.
Qwen3-TTS รองรับภาษาใดบ้าง?
เวอร์ชัน Qwen3-TTS ที่เปิดให้ใช้งานรองรับภาษาจีน อังกฤษ ญี่ปุ่น เกาหลี เยอรมัน ฝรั่งเศส รัสเซีย โปรตุเกส สเปน และอิตาลี ขอบเขตภาษาของโมเดลที่โฮสต์อาจแตกต่างกันไปตามจุดปลายทางและเสียง ดังนั้นควรตรวจสอบ ID โมเดลและภูมิภาคของ Alibaba Cloud ให้ถูกต้องก่อนที่จะพัฒนาผลิตภัณฑ์หลายภาษา.
Qwen3-TTS สามารถให้ความหน่วงได้ 97 ms ได้จริงหรือไม่?
Qwen รายงานค่าความล่าช้าของแพ็กเก็ตแรก (first-packet latency) อยู่ที่ 97 ms สำหรับรุ่น 0.6B 12Hz ที่ระดับการทำงานพร้อมกัน (concurrency) 1 ในสภาพแวดล้อม vLLM ภายในที่ได้รับการปรับแต่งให้เหมาะสม นี่เป็นค่ามาตรฐานจากผู้ผลิตที่ถูกต้อง ไม่ใช่คำสัญญาทั่วไปของอุปกรณ์ การเริ่มต้นระบบจากสถานะเย็น (cold starts), ฮาร์ดแวร์, ความแม่นยำ, การส่งผ่านเครือข่าย, การจัดคิว และการบัฟเฟอร์ของไคลเอนต์ อาจทำให้ความล่าช้าที่สังเกตได้เพิ่มขึ้น.
Qwen3-TTS ต้องการ VRAM เท่าใด?
ไม่มีค่า VRAM ที่แม่นยำเพียงค่าเดียวสำหรับทุกการตั้งค่า ขนาดโมเดล ความแม่นยำ ระบบหลังการประมวลผลแบบ attention ขนาดชุดข้อมูล แคช ความยาวการอ้างอิง และค่าใช้จ่ายของเฟรมเวิร์ก ล้วนมีบทบาทสำคัญ การทดสอบ MX450 2 GB ที่ได้ตรวจสอบนั้นไม่เหมาะสมสำหรับการทดสอบประสิทธิภาพแบบตัวแทน; ควรทดสอบจุดตรวจสอบที่เลือกไว้ด้วยระดับการทำงานพร้อมกันที่ใกล้เคียงกับสภาพแวดล้อมจริง และเหลือพื้นที่การทำงานที่เพียงพอ.
ต้องใช้ข้อมูลเสียงเท่าใดสำหรับการคัดลอกเสียงด้วย Qwen3-TTS?
ข้อมูลตัวอย่างแสดงให้เห็นว่าสามารถสร้างสำเนาได้อย่างรวดเร็วภายในประมาณสามวินาที ส่วนคำแนะนำในการลงทะเบียนแบบโฮสต์จะเน้นให้ใช้เสียงพูดที่ชัดเจนและต่อเนื่อง และอนุญาตให้ใช้ตัวอย่างเสียงที่ยาวกว่าได้ ให้ถือว่าสามวินาทีเป็นขีดความสามารถขั้นต่ำ ไม่ใช่เป้าหมายคุณภาพอัตโนมัติ ให้ใช้ไฟล์เสียงที่ได้รับการอนุญาตแล้วและไม่มีเสียงรบกวน ซึ่งครอบคลุมช่วงเสียงปกติของผู้พูดและภาษาที่ตั้งใจใช้.
ขีดจำกัดการป้อนข้อมูลของ API Qwen3-TTS คืออะไร?
เอกสาร API ของ Qwen-TTS ในปัจจุบันระบุว่า ปริมาณข้อมูลเข้าสูงสุดสำหรับโมเดล Qwen-TTS คือ 512 โทเคน URL ของไฟล์เสียงแบบเต็มจะมีอายุการใช้งาน 24 ชั่วโมง ควรแบ่งสคริปต์ที่ยาวตามขอบเขตความหมาย และคัดลอกผลลัพธ์ที่จำเป็นไปยังพื้นที่จัดเก็บข้อมูลที่คงทน แทนที่จะถือว่า URL ที่ได้รับมาเป็นการโฮสต์แบบถาวร.
สามารถใช้ Qwen3-TTS บน GlobalGPT ได้ไหม?
เครื่องสร้างเสียง GlobalGPT ที่ได้รับการตรวจสอบแล้ว ดังต่อไปนี้ qwen-audio-3.0-tts-flash และ Seed Audio 1.0 ไม่ใช่ Qwen3-TTS คุณสามารถใช้วิธีนั้นเป็นกระบวนการทำงานด้านเสียงที่แยกต่างหากได้ แต่ไม่ควรอธิบายว่าเป็นการเข้าถึงจุดตรวจสอบ 0.6B หรือ 1.7B ของ Qwen3-TTS ที่เปิดให้ใช้งาน.
คำตัดสินสุดท้าย
การรีวิว Qwen3-TTS นี้พบว่ามีคุณสมบัติที่หลากหลายอย่างไม่ธรรมดา: จุดตรวจสอบแบบเปิด 0.6B และ 1.7B, 10 ภาษา, เสียงที่ตั้งไว้ล่วงหน้า, การคัดลอกอย่างรวดเร็ว, VoiceDesign, สถาปัตยกรรมการสตรีมมิ่ง, ใบอนุญาตแบบเปิดกว้าง และ API ที่ให้บริการบนแพลตฟอร์ม.
ข้อจำกัดที่ระบุไว้อย่างตรงไปตรงมาก็มีความสำคัญไม่แพ้กัน เนื่องจากเสียง Qwen3-TTS ที่แท้จริงไม่ได้ถูกสร้างขึ้นในสภาพแวดล้อมการทำงานที่มีอยู่ และ GPU ขนาด 2 GB ที่ได้รับการตรวจสอบไม่สามารถรองรับการเปรียบเทียบในท้องถิ่นที่เป็นตัวแทนได้ ด้วยเหตุนี้ บทความนี้จึงไม่ให้คะแนนคุณภาพเสียงหรืออ้างว่าสามารถให้ประสิทธิภาพ 97 ms ได้ในทุกกรณี.
หากคุณให้ความสำคัญกับน้ำหนักแบบเปิดและการควบคุม ให้ลองใช้ checkpoint 0.6B ก่อน แล้วเปรียบเทียบกับ 1.7B บนสคริปต์และฮาร์ดแวร์เดียวกัน หากคุณให้ความสำคัญกับความเร็วในการนำระบบเข้าสู่การใช้งานจริง ให้ทดสอบเส้นทาง Alibaba Cloud ที่คุณวางแผนจะซื้อโดยตรง และเปรียบเทียบกับตระกูล Qwen-Audio 3.0 TTS ที่วางตำแหน่งแยกต่างหาก โดยให้บันทึกชื่อโมเดล จุดปลายทาง (endpoint) ภูมิภาค บันทึกการยินยอม ความล่าช้า (latency) และค่าใช้จ่ายการแก้ไขรวมไว้ในแผ่นตัดสินใจเดียวกัน.
Qwen3-TTS คุ้มค่าที่จะลองใช้ดู ไม่ควรคิดว่าเอกสารเพียงอย่างเดียวจะสามารถฟังเสียงแทนคุณได้ ทางออกที่ดีที่สุดคือทางที่ยังคงทำงานได้แม้เมื่อต้องเผชิญกับชื่อของคุณ ภาษาของคุณ อุปกรณ์ของคุณ ข้อกำหนดด้านความเป็นส่วนตัวของคุณ และกำหนดเวลาการผลิตของคุณ.