Muse Spark 1.3 เป็นเวอร์ชัน Muse Spark ที่แข็งแกร่งที่สุดของ Meta จนถึงขณะนี้: โมเดล xhigh ที่เปิดให้ใช้งานสาธารณะได้คะแนน 61 บนดัชนีปัญญาประดิษฐ์สำหรับการวิเคราะห์ (Artificial Analysis Intelligence Index), มีหน้าต่างบริบทขนาด 1 ล้านโทเคน และผ่านการทดสอบ API แบบตอบกลับครั้งแรกในทั้งสามภารกิจเขียนโค้ดระดับความยากปานกลาง. ข้อควรระวังสำคัญคือว่า กราฟเปรียบเทียบประสิทธิภาพหลักของ Meta ใช้เวอร์ชัน Max Reasoning ซึ่งในขณะที่เขียนบทวิเคราะห์นี้ Max Reasoning ยังอยู่ระหว่างการรอการปล่อยออกสู่สาธารณะอย่างกว้างขวาง หลังจากผ่านการทดสอบความปลอดภัยเพิ่มเติม.

รีวิว Muse Spark 1.3: ความเห็นเบื้องต้น
คำตัดสินของเรา
Muse Spark 1.3 คุ้มค่าที่จะลองใช้สำหรับเอเจนต์การเขียนโค้ด งานที่มีบริบทยาว และระบบอัตโนมัติที่คำนึงถึงค่าใช้จ่าย ผลลัพธ์ xhigh ที่เปิดเผยต่อสาธารณะของมันนั้นมีความสามารถแข่งขันในระดับแนวหน้าแล้ว แต่อย่าอ้างอิงคะแนนสูงสุดของ Meta ราวกับว่าผู้ใช้ API ทุกคนสามารถทำซ้ำผลลัพธ์เหล่านั้นได้ในวันนี้.
Meta ได้เปิดตัว Muse Spark 1.3 เมื่อวันที่ 2 กันยายน 2569, ซึ่งทำให้ระบบนี้เหมาะสำหรับกระบวนการทำงานแบบเอเจนต์ในระยะยาว ผลลัพธ์การเขียนโค้ดที่สะอาดขึ้น และการทำงานร่วมกันที่เชื่อถือได้มากขึ้น สิ่งนี้เป็นการต่อยอดจากการเปลี่ยนทิศทางสู่ เอเย่นต์ AI ที่พัฒนาขึ้นบนพื้นฐานของโมเดลการใช้เครื่องมือ. Meta ระบุว่า ระบบจะถามคำถามเพื่อขอความชัดเจนเมื่อข้อกำหนดไม่ชัดเจน แจ้งเตือนเมื่อระบบติดขัด และยืนยันก่อนดำเนินการที่ส่งผลสำคัญ ในการเปรียบเทียบภายในกับเวอร์ชัน 1.2 วิศวกรของ Meta สังเกตเห็นว่าการเรียกใช้เครื่องมือลดลงประมาณ 20% และจำนวนโทเคนลดลง 25% นี่เป็นข้อมูลที่ผู้ให้บริการระบุ ไม่ใช่ผลจากการทดสอบของเรา.
มีอะไรที่เปลี่ยนแปลงไปจาก Muse Spark 1.2?
การวิเคราะห์แบบจำลอง: 57 ถึง 61 บน xhigh.
Meta รายงานผล 75.4 เทียบกับ 55.0 บน DeepSWE แต่เปรียบเทียบค่าสูงสุด 1.3 กับ 1.2 xhigh.
หน้าต่าง 1M ยังคงอยู่; คะแนน MRCR ช่วงความถี่สูงเพิ่มขึ้นอย่างรวดเร็วในกราฟของ Meta.
อัตราโทเคนยังคงไม่เปลี่ยนแปลง ส่วน AA วัดได้ $0.55 เทียบกับ $0.40 ต่อแต่ละงานที่ประเมิน.
ผลการทดสอบประสิทธิภาพของ Muse Spark 1.3: Max และ Xhigh ไม่เหมือนกัน
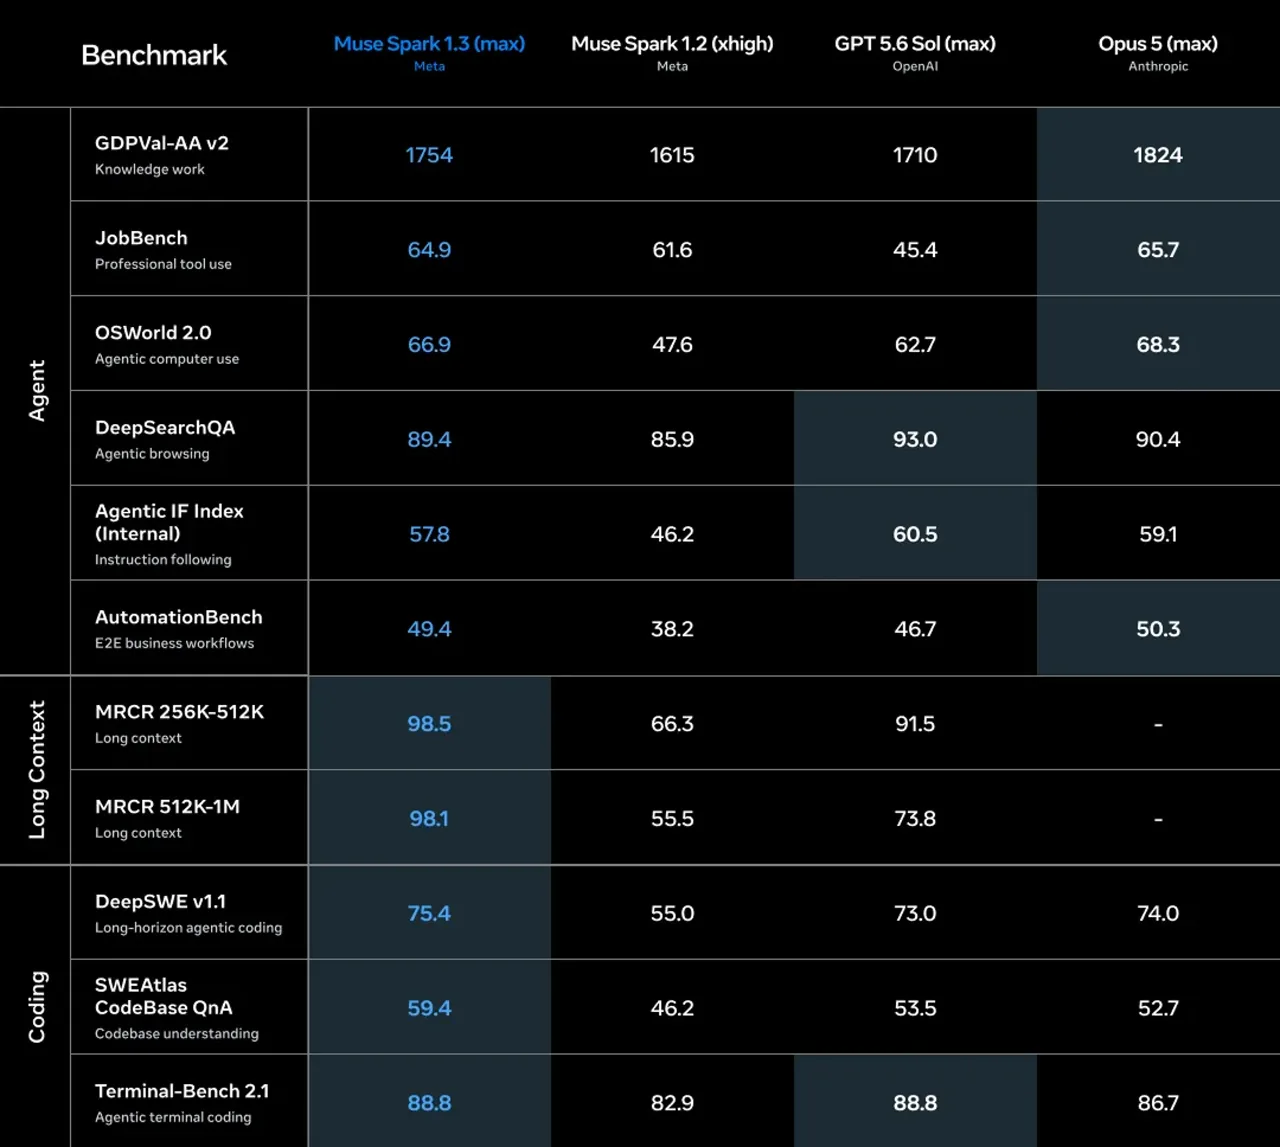
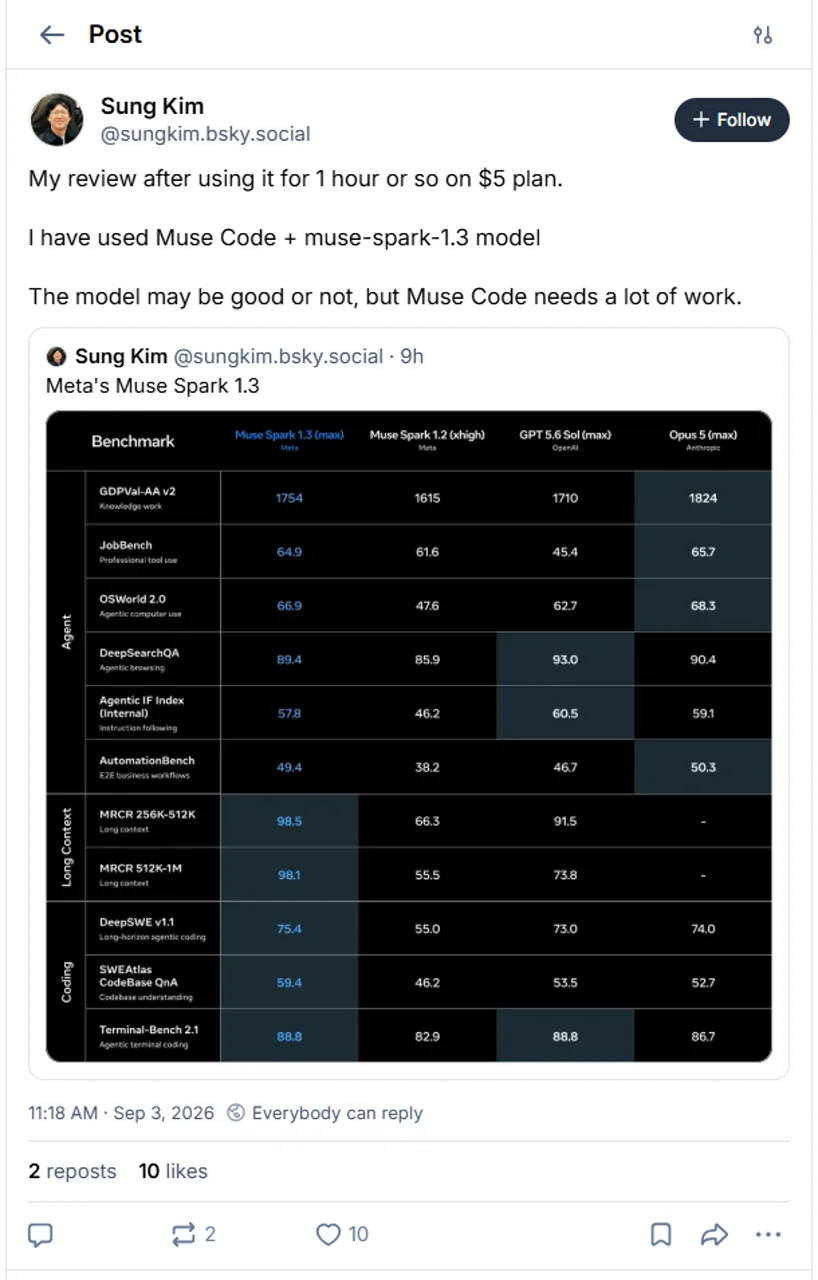
ตารางอย่างเป็นทางการของ Meta เป็นผลลัพธ์ที่น่าประทับใจ Muse Spark 1.3 ได้คะแนนสูงสุด 88.8 ใน Terminal-Bench 2.1, 75.4 ใน DeepSWE v1.1, 98.1 ใน MRCR 512K-1M และ 66.9 ใน OSWorld 2.0 มันมีคะแนนเท่ากันกับ GPT-5.6 Sol max ใน Terminal-Bench และนำหน้าคู่แข่งที่แสดงผลในสองช่วง MRCR ที่มีบริบทยาว นักพัฒนาที่ต้องการเปรียบเทียบตลาดที่กว้างขึ้นสามารถใช้ ภาพรวมของ coding-agent เพื่อเพิ่มข้อมูลบริบทเพิ่มเติม.
รายงานจาก META, การวิเคราะห์แบบ MAX
| เกณฑ์มาตรฐาน | 1.3 สูงสุด | 1.2 xสูง | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| เทอร์มินอล-เบนช์ 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE เวอร์ชัน 1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | ไม่เกี่ยวข้อง |
การตั้งค่าความพยายามที่แตกต่างกัน, ระบบยึดเอเจนต์ และเวอร์ชัน OSWorld ต่างกัน ทำให้การเปรียบเทียบโดยตรงเป็นไปได้ยาก Meta ยังอธิบายว่า Agentic IF Index เป็นดัชนีรวมภายใน.
วิธีอ่านกราฟ
1.3, GPT-5.6 Sol และ Opus 5 ใช้ max; 1.2 ใช้ xhigh.
ตัวแทนที่ระบุชื่อและชุดสายรัดที่ติดตั้งไว้จะแตกต่างกันไปตามการประเมิน.
การรันเวอร์ชัน 1.3 และ 1.2 ใช้เวอร์ชันสภาพแวดล้อมที่แตกต่างกัน.
ดัชนี Agentic IF เป็นดัชนีรวมของ Meta ไม่ใช่ดัชนีอ้างอิงสาธารณะเดียว.
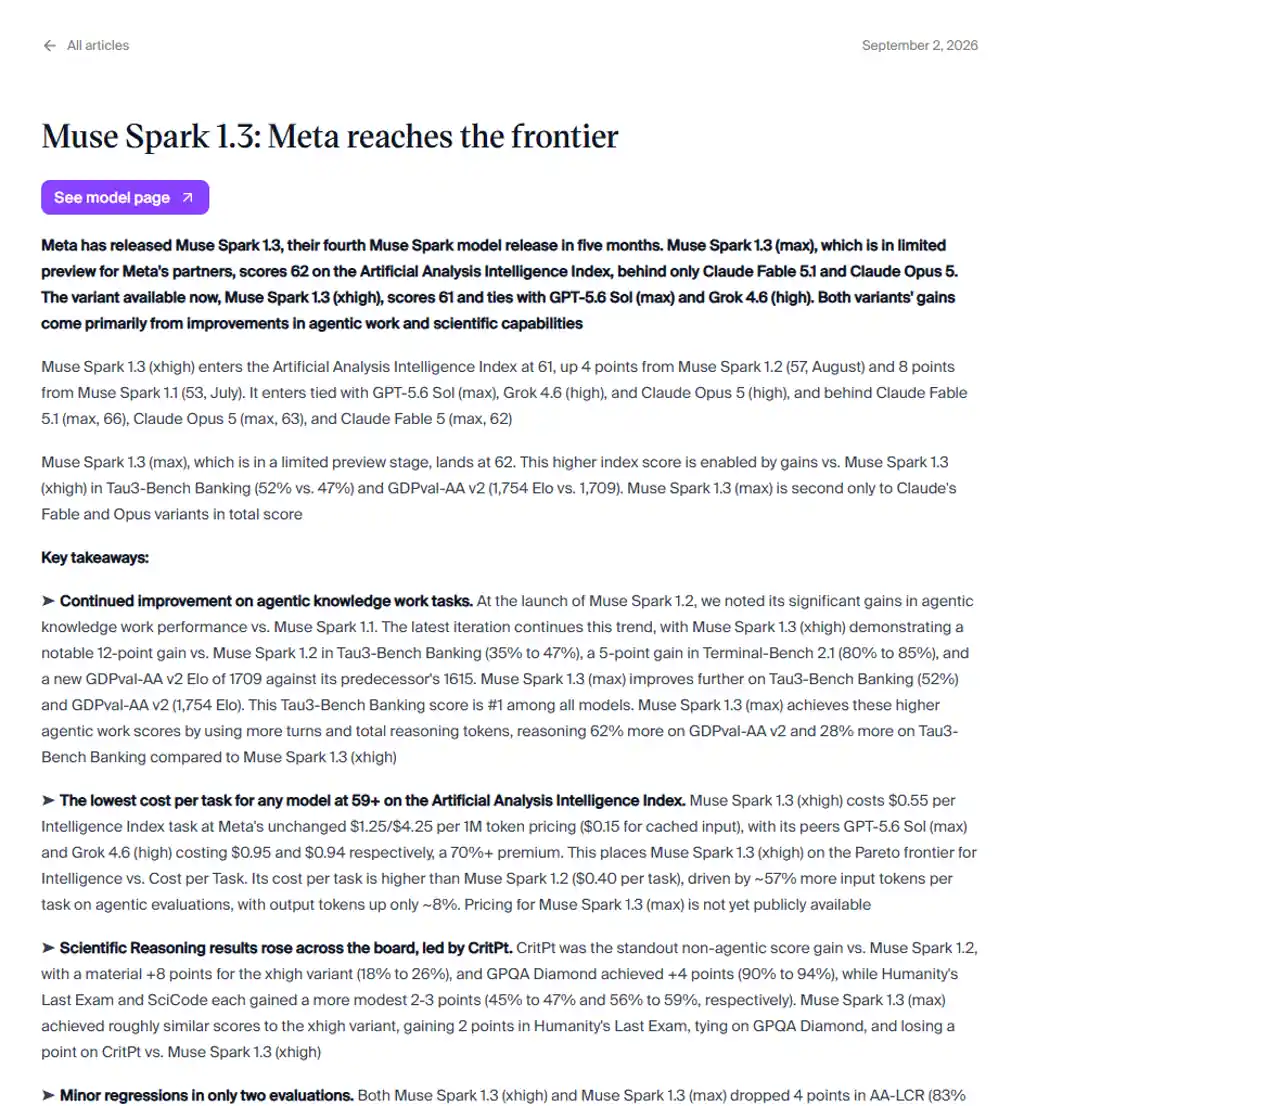
การวิเคราะห์แบบจำลองช่วยให้เห็นภาพที่ชัดเจนขึ้น ของสิ่งที่ผู้ใช้สามารถเข้าถึงได้ในขณะนี้ Muse Spark 1.3 xhigh ได้คะแนน 61, เพิ่มขึ้นจาก 57 ของเวอร์ชัน 1.2 ผลลัพธ์ Terminal-Bench เป็น 85%, GDPval-AA v2 เป็น 1709 Elo, และ Tau3-Bench Banking เป็น 47%. เวอร์ชัน max ในช่วงทดลองใช้แบบจำกัดมีคะแนนรวม 62 นอกจากนี้ยังมีการลดลงในบางด้าน: AA-LCR ลดลงจาก 83% เป็น 79% ส่วน AA-Omniscience Accuracy ลดลงจาก 45% เป็น 42% ใน xhigh.
ราคา Muse Spark 1.3
ผู้ร่วมเขียน
muse-spark-1.3-ผู้ร่วมพัฒนา
$0.10 เข้า / $0.002 เก็บไว้ในแคช / $0.20 ออก ต่อล้านโทเคน.
คำสั่งเหล่านี้อาจถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta.
มาตรฐาน
muse-spark-1.3
$1.25 (ข้อมูลเข้า) / $0.15 (ข้อมูลในแคช) / $4.25 (ข้อมูลออก) ต่อล้านโทเคน.
Meta ระบุว่าระดับนี้ไม่ถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของบริษัท.
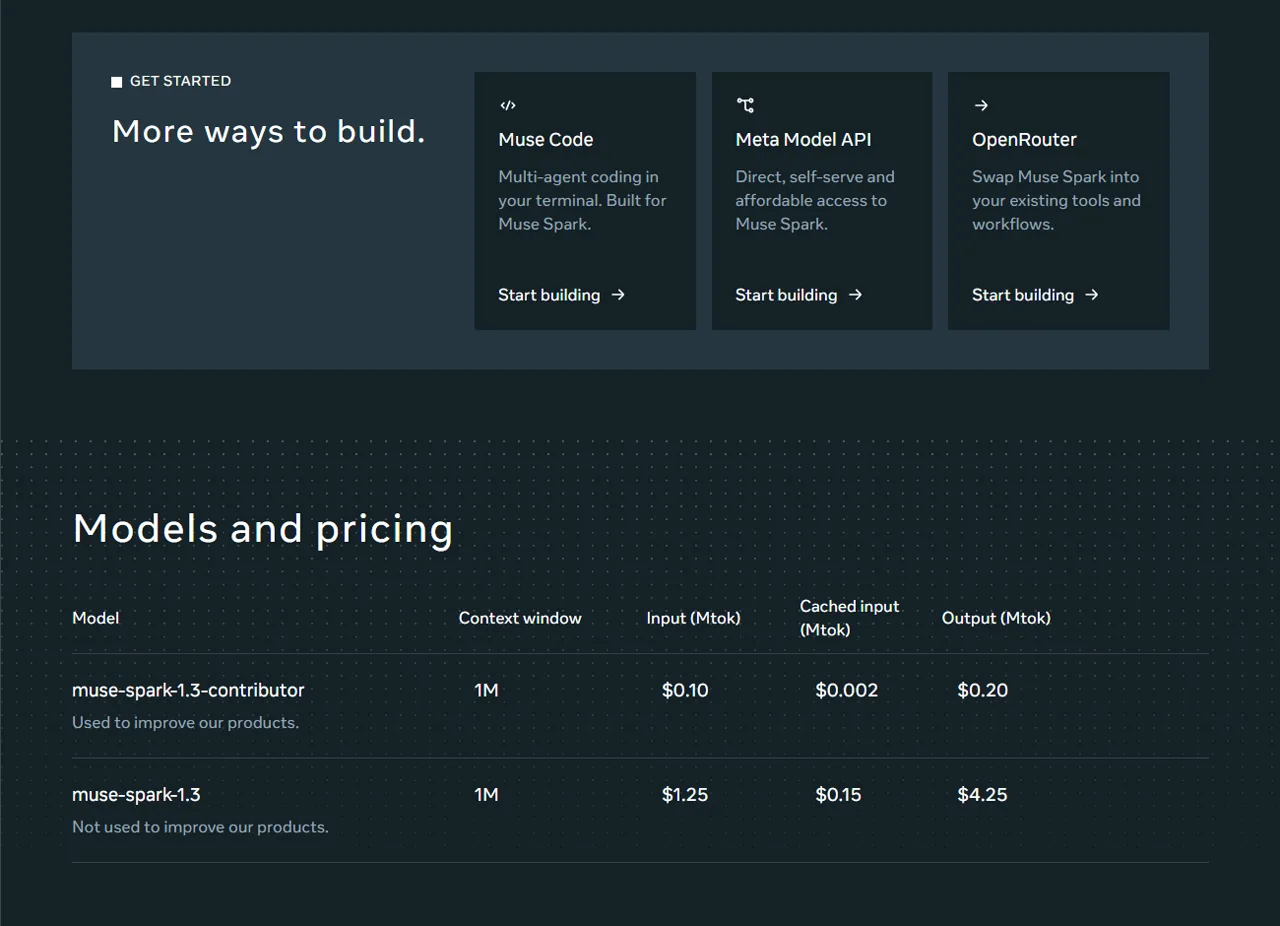
The ราคาโทเคนอย่างเป็นทางการ ไม่เปลี่ยนแปลงจากเวอร์ชัน 1.2 แต่ค่าใช้จ่ายต่องานนั้นไม่เหมือนกัน ระบบของเรา รีวิวแพลตฟอร์ม AI แบบครบวงจร อธิบายว่าทำไมราคาการเข้าถึงและค่าใช้จ่ายในกระบวนการทำงานควรได้รับการประเมินแยกกัน การวิเคราะห์แบบจำลองได้วัดค่า $0.55 ต่องานของดัชนีความฉลาด (Intelligence Index) สำหรับระดับ 1.3 xhigh เทียบกับ $0.40 สำหรับระดับ 1.2 ซึ่งเกิดจากจำนวนโทเคนข้อมูลเข้าที่เพิ่มขึ้นประมาณ 57% ในการประเมินแบบเอเจนต์เป็นหลัก ระดับผู้ร่วมสร้างมีราคาถูกเป็นพิเศษ แต่เงื่อนไขการใช้ข้อมูลของมันเป็นการเลือกผลิตภัณฑ์ที่แท้จริง ไม่ใช่เพียงหมายเหตุประกอบ.
การเข้าถึง API ของ Muse Spark 1.3
Meta’s หนังสือสูตรอาหารอย่างเป็นทางการ ปัจจุบันใช้ muse-spark-1.3 เป็นค่าเริ่มต้น และกำหนดหน้าต่างบริบท (context window) ที่มี 1,048,576 โทเคน API นี้เข้ากันได้กับ SDK OpenAI Muse Code และ Meta Model API เป็นช่องทางเข้าถึงที่ได้รับการยืนยันแล้ว หน้าโมเดลของ Meta ยังแสดง OpenRouter ด้วย แต่เมื่อตรวจสอบแล้วปุ่มของมันยังคงชี้ไปยัง URL 1.2 ดังนั้นควรตรวจสอบเส้นทางก่อนการปรับใช้ สำหรับข้อมูลพื้นฐานเกี่ยวกับความสามารถในการทำงานร่วมกันของเอเจนต์ โปรดดูคู่มือของเราที่ MCP และเครื่องมือ AI.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Review this patch for regressions."}],
)

print(response.choices[0].message.content)
การทดสอบการเขียนโค้ดแบบปฏิบัติจริง: 3/3 ผ่าน
เราได้ทดสอบงานในรีโพสิตอรีระดับความยากปานกลางสามงานผ่าน API ที่อุณหภูมิศูนย์ โดยใช้คำตอบหนึ่งครั้งต่องาน แต่ละคำตอบต้องส่งไฟล์ที่สมบูรณ์ในรูปแบบ JSON ที่มีโครงสร้าง จากนั้นเราได้นำไฟล์เหล่านั้นไปใช้ในโฟลเดอร์แบบใช้แล้วทิ้ง และดำเนินการตรวจสอบทั้งส่วนที่เปิดเผยและส่วนที่ซ่อนอยู่ นี่เป็นการทดสอบขนาดเล็กที่ได้รับการควบคุมอย่างเคร่งครัด ไม่ใช่การแทนที่ Terminal-Bench หรือการทดลองในรีโพสิตอรีจริง.
5/5 การทดสอบ; 18.4 วินาที; 2,473 โทเคน; $0.00905. โมเดลได้ค้นพบชุด processed-ID ที่ยังไม่ได้ใช้ เพิ่มกลไกป้องกันการซ้ำซ้อนตั้งแต่เนิ่นๆ และเขียนการทดสอบการถดถอย.
การตรวจสอบประเภทข้อมูลและการตรวจสอบสองครั้งในระหว่างการทำงานผ่านแล้ว; 47.6 วินาที; 4,945 โทเคน; $0.01661. การตรวจสอบความถูกต้อง การเก็บข้อมูลแบบถาวร และการบันทึกการตรวจสอบได้ถูกแยกออกจากกันโดยไม่ทำให้ขอบเขตการทำธุรกรรมถูกทำลาย.
9/9 การทดสอบ; 20.3 วินาที; 3,789 โทเคน; $0.01446. ความเข้ากันได้กับ CSV, ข้อผิดพลาดที่มีหมายเลขบรรทัด, ผลลัพธ์แบบอะตอมิก, ความปลอดภัยในการรันแบบ dry-run, คำแนะนำ และเอกสารทั้งหมดผ่านการทดสอบ.
รวม: 11,207 โทเคน และ $0.04013 เวลาที่แสดงเป็นเวลาการขอข้อมูลแบบ end-to-end ไม่ใช่ความล่าช้าของ Meta API แบบดั้งเดิมหรือ TTFT.
ผลลัพธ์ดีกว่าที่คะแนน “3/3” เพียงอย่างเดียวบ่งชี้: คำตอบแรกทั้งสามข้อล้วนสามารถตรวจสอบได้และคำนึงถึงข้อจำกัด หลักการด้านหลักฐานเดียวกันนี้มีความสำคัญเมื่ออ่านงานของเรา บทวิจารณ์ GPT-5. อย่างไรก็ตาม ตัวอย่างนี้ไม่ได้วัดความน่าเชื่อถือในการเรียกใช้เครื่องมือซ้ำๆ การนำทางในคลังข้อมูลขนาดใหญ่ หรือชั้นการประสานงานของ Muse Code ผู้อ่านที่กำลังพิจารณาตัวเลือกที่มีราคาประหยัดอาจพบว่า การเปรียบเทียบแบบจำลองการจัดรหัสงบประมาณ มีประโยชน์.
ปฏิกิริยาเบื้องต้นจากผู้พัฒนา
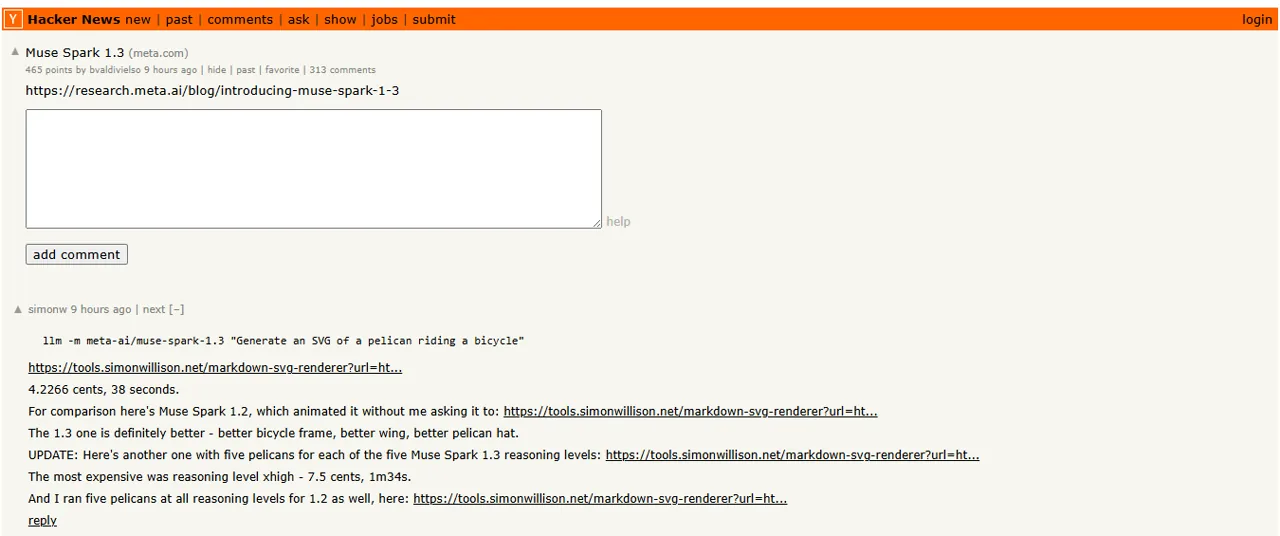
ปฏิกิริยาเบื้องต้นมีทั้งเชิงบวกและเชิงลบ และยังมีไม่มากพอที่จะสรุปได้ว่ามีความเห็นพ้องต้องกัน ใน การทดสอบ Hacker News, Simon Willison รายงานผลการวิ่ง SVG ที่ใช้เวลา 38 วินาที และค่า 4.2266 เซนต์ และประเมินว่าผลลัพธ์ 1.3 นี้ “ดีกว่าอย่างชัดเจน” เมื่อเทียบกับผลลัพธ์ 1.2 ของเขา. Dax ได้อธิบายเกี่ยวกับการปล่อยตัว เพื่อเตือนให้เขาจำได้ว่าเขาคิดถึงนางแบบตัวสูงมากเพียงใด. ซอง คิม, หลังจากใช้ Muse Code ประมาณหนึ่งชั่วโมง ได้กล่าวว่าโมเดลนี้อาจดี แต่ผลิตภัณฑ์ Muse Code “ยังต้องปรับปรุงอีกมาก” ความเห็นสุดท้ายนี้เกี่ยวข้องกับประสบการณ์การใช้งานเอเจนต์ ไม่ใช่การทดสอบโมเดลเพียงอย่างเดียว.
ข้อดีและข้อเสีย
สิ่งที่ได้ผล
- คะแนน xสูงจากประชาชน
- หน้าต่างบริบท 1M-token
- API ที่รองรับ OpenAI
- งานเขียนโค้ดทั้งสามงานผ่านการตรวจสอบครั้งแรก
- อัตราโทเคนสำหรับระดับผู้สนับสนุนที่ต่ำมาก
สิ่งที่ควรดู
- ผลลัพธ์สูงสุดในส่วนหัวไม่ใช่ประสบการณ์สาธารณะที่ตั้งไว้เป็นค่าเริ่มต้น
- ค่าใช้จ่ายของงานอิสระเพิ่มขึ้นเมื่อเทียบกับ 1.2
- สองตัวชี้วัดอิสระที่ผ่านการวิเคราะห์การถดถอย
- ข้อมูลจากผู้มีส่วนร่วมอาจช่วยปรับปรุงผลิตภัณฑ์ของ Meta
- ความคิดเห็นเบื้องต้นเกี่ยวกับ Muse Code มีทั้งด้านบวกและด้านลบ
ใครควรใช้ Muse Spark 1.3?
ใช้มันเพื่อ
การประเมินตัวแทนการเขียนโค้ด, การทำงานกับคลังข้อมูลบริบทขนาดใหญ่, การอัตโนมัติด้วยเครื่องมือ, และการทดลองที่คำนึงถึงค่าใช้จ่าย ซึ่งนโยบายข้อมูลเป็นที่ยอมรับได้.
ข้ามไปหรือรอเมื่อ
คุณต้องการความน่าเชื่อถือในการผลิตที่ได้รับการพิสูจน์แล้วในระยะยาว, ต้องการปริมาณสูงสุดทันที, หรือไม่สามารถยอมรับการใช้ข้อมูลในระดับผู้ร่วมสร้าง และเห็นว่าราคาตามมาตรฐานไม่มีความแข่งขัน.
บทสรุปการรีวิว Muse Spark 1.3
Muse Spark 1.3 ได้รับการแนะนำให้พิจารณา. มันรวมประสิทธิภาพระดับแนวหน้าของระบบสาธารณะ, ผลลัพธ์ที่แข็งแกร่งในบริบทยาว, ความสะดวกในการใช้งานของ API ที่คุ้นเคย และราคาที่แข่งขันได้ งานเขียนโค้ดสามงานแรกของเราช่วยยืนยันว่ามันสามารถปฏิบัติตามข้อจำกัดของหลายไฟล์และสร้างแพตช์ที่สามารถทดสอบได้.
เลือกระดับมาตรฐานสำหรับโค้ดที่ละเอียดอ่อน สำหรับการเปรียบเทียบในขอบเขตอื่น ๆ โปรดดู GPT-5 เทียบกับ Claude 4. ให้ถือว่าผลลัพธ์การทดสอบประสิทธิภาพสูงสุดเป็นหลักฐานเบื้องต้น จนกว่าระดับการให้เหตุผลนั้นจะได้รับการใช้งานอย่างแพร่หลาย และให้ประเมิน Muse Code แยกต่างหากจาก API ของโมเดล: ประสบการณ์ผู้ใช้ (UX) ของเอเจนต์ วงจรการทำงานของเครื่องมือ (tool loop) และการควบคุมที่เก็บข้อมูล (repository control) สามารถประสบความสำเร็จหรือล้มเหลวได้โดยไม่ขึ้นกับโมเดลพื้นฐาน.
คำถามที่พบบ่อย (FAQ) ของ Muse Spark 1.3
Muse Spark 1.3 คืออะไร?
Muse Spark 1.3 เป็นโมเดลกระบวนการทำงานด้านการเขียนโค้ดและการทำงานแบบเอเจนต์ของ Meta ที่เปิดตัวเมื่อวันที่ 2 กันยายน 2026 โดยมีหน้าต่างบริบทขนาด 1 ล้านโทเคน และความสามารถในการรับรู้ภาพ วิดีโอ และเอกสารแบบเนทีฟ.
Muse Spark 1.3 มีราคาเท่าไร?
โมเดลมาตรฐานมีค่าใช้จ่าย $1.25 ต่อหนึ่งล้านโทเคนข้อมูลเข้า $0.15 สำหรับข้อมูลเข้าที่เก็บไว้ในแคช และ $4.25 สำหรับข้อมูลออก โมเดลผู้มีส่วนร่วมมีค่าใช้จ่าย $0.10, $0.002 และ $0.20 ตามลำดับ แต่ข้อมูลจากโมเดลนี้อาจถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของ Meta.
มีฟังก์ชันการวิเคราะห์แบบแม็กซ์ (max reasoning) ให้ใช้หรือไม่?
Meta ระบุว่า โหมดการวิเคราะห์ที่มีอยู่จะพร้อมใช้งานตั้งแต่การเปิดตัว และโหมด Max จะตามมาหลังจากผ่านการทดสอบความปลอดภัยเพิ่มเติม โปรดตรวจสอบเอกสาร API ปัจจุบันก่อนที่จะสันนิษฐานว่าบริการนี้พร้อมใช้งานทั่วไป.
Muse Spark 1.3 ผ่านการทดสอบการเขียนโค้ดแล้วหรือไม่?
ใช่ครับ ผลทดสอบครั้งแรกผ่านทุกการตรวจสอบความสามารถในการทำงานในกระบวนการแก้ไขข้อผิดพลาดของ Python การปรับโครงสร้างใหม่ของ TypeScript และการทดสอบคุณสมบัติ JSONL ตัวอย่างนี้มีเพียงสามงานที่ได้รับการควบคุมเท่านั้น และไม่ใช่ค่าอัตราความน่าเชื่อถือทั่วไป.
Muse Spark 1.3 ดีกว่า 1.2 หรือไม่?
โดยส่วนใหญ่แล้ว เป็นไปตามหลักฐานที่มีอยู่ ความฉลาด xhigh ของระบบสาธารณะเพิ่มขึ้นจาก 57 เป็น 61 และ Meta รายงานว่ามีความก้าวหน้าอย่างมากในด้านความสามารถในการควบคุม (agentic) และการจัดการบริบทที่ยาว (long-context) แต่ Artificial Analysis ยังพบด้วยว่าค่าใช้จ่ายในการทำงานเพิ่มขึ้น และมีการถดถอยเล็กน้อยในการเรียกคืนข้อมูลจากบริบทที่ยาวและการปรับเทียบข้อมูลข้อเท็จจริง.
ผมควรใช้โมเดลผู้ร่วมสร้างหรือโมเดลมาตรฐานดี?
ใช้มาตรฐานสำหรับคำสั่งที่ละเอียดอ่อนหรือเป็นกรรมสิทธิ์ เนื่องจาก Meta ระบุว่าข้อมูลดังกล่าวไม่ถูกใช้เพื่อปรับปรุงผลิตภัณฑ์ของตน ส่วน Contributor มีราคาถูกกว่ามาก แต่คำสั่งที่สร้างขึ้นอาจถูกใช้เพื่อปรับปรุงผลิตภัณฑ์.