เริ่มจากเสียงที่คุณต้องการสร้างขึ้น. Pick Eleven Music v2 สำหรับเพลงและเพลงบรรเลงที่มีโครงสร้างชัดเจน, Qwen Audio 3.0 TTS Flash สำหรับการบรรยายและเสียงที่มีอารมณ์, และ Seed Audio 1.0 เมื่อคุณต้องการผสมผสานเสียงพูด เสียงบรรยากาศ และเสียงเอฟเฟกต์เข้าด้วยกันเป็นฉากที่สมบูรณ์.
คุณไม่จำเป็นต้องหาโมเดลเสียง ‘ที่ดีที่สุด’ เพียงหนึ่งเดียว ผู้สร้างเพลงพื้นหลังต้องการสิ่งที่แตกต่างจากนักการตลาดที่บันทึกเสียงบรรยาย หรือผู้ทำภาพยนตร์ที่กำลังสร้างฉากสถานีรถไฟ เราได้ทดสอบงานจริงเหล่านั้น — ไม่ใช่เพียงรายการคุณสมบัติ — และคุณสามารถฟังผลลัพธ์แรกทั้งสิบชิ้นได้ด้านล่างนี้.
หากคุณต้องการลองใช้แนวคิดเดียวกันนี้กับข้อความเริ่มต้นของคุณเอง, โกลบอลจีพีที ให้คุณสามารถสลับใช้งานทั้งสามแบบได้ในที่เดียว นอกจากนี้ยังเป็นพื้นที่ทำงานแบบหลายโมเดลที่กว้างขวางยิ่งขึ้น: คุณสามารถใช้โมเดลต่างๆ เช่น GPT-5.6 Sol, Claude Opus 4.8 และ Gemini 3.1 Pro สำหรับการเขียนและวิจัย แล้วเปลี่ยนไปใช้ GPT Image 2 หรือ Seedance 2.0 เมื่อโครงการต้องการภาพหรือวิดีโอ นั่นหมายความว่าคุณสามารถร่างบทเขียน สร้างเสียง และพัฒนาส่วนที่เหลือของโครงการต่อไปได้ โดยไม่ต้องรวมเครื่องมือต่าง ๆ ที่แยกกันเข้าด้วยกัน การเข้าถึงโมเดลจะแตกต่างกันไปตามแพ็กเกจ.
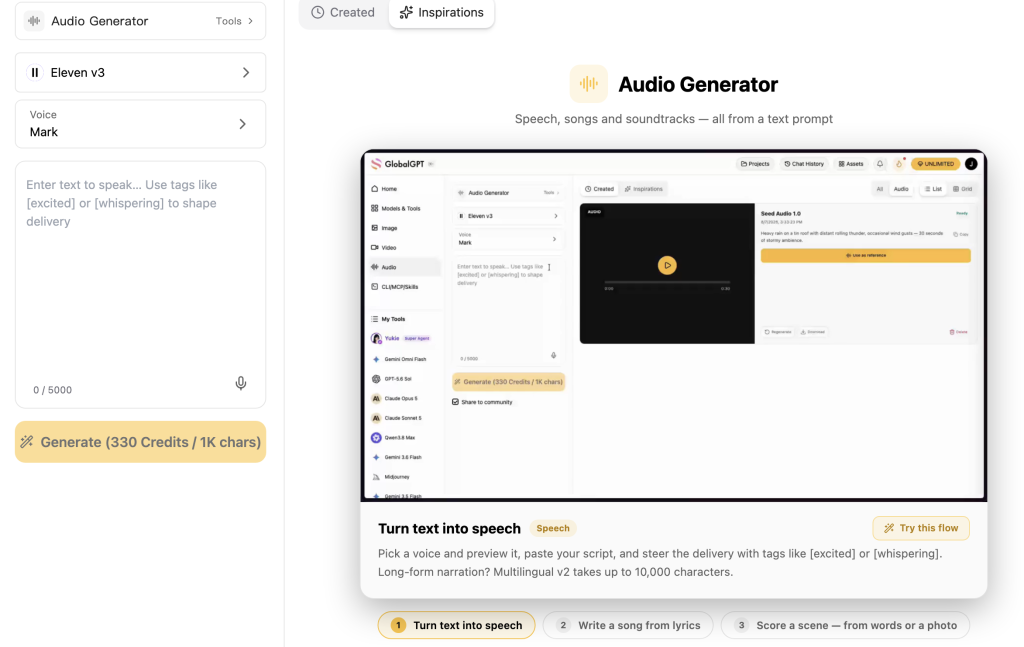
เริ่มจากสิ่งที่คุณต้องการทำ
นี่เป็นจุดเริ่มต้นเท่านั้น ไม่ใช่การจัดอันดับแบบสากล.
คำตอบสั้นๆ: รุ่นไหนเหมาะสำหรับงานด้านเสียงแบบไหน?
นี่คือวิธีตัดสินใจที่ง่ายที่สุด: เลือกตามผลลัพธ์ที่ต้องการ ไม่ใช่ตามแบรนด์ Eleven เป็นจุดเริ่มต้นที่เหมาะสมที่สุดเมื่อผลลัพธ์สุดท้ายคือเพลง; Qwen TTS Flash เหมาะสำหรับการบรรยายและเสียงที่แสดงอารมณ์; ส่วน Seed เหมาะสำหรับฉากที่ต้องการเสียงพูด เสียงบรรยากาศ และเสียงเอฟเฟกต์ร่วมกัน หกงานทดลองของเราแสดงให้เห็นว่าตัวเลือกใดให้ผลลัพธ์ที่ดีที่สุดในแต่ละกรณี และผู้เล่นสิบคนด้านล่างนี้จะช่วยให้คุณได้ยินด้วยตัวเองถึงจุดแข็งและจุดอ่อนของแต่ละตัวเลือก.
| แบบจำลอง | เริ่มจากที่นี่เมื่อ… | สิ่งที่เราได้ลองทำ | โปรดจำไว้ |
|---|---|---|---|
| Eleven Music v2 | คุณต้องการเพลงหรือเพลงบรรเลงที่มีโครงสร้าง | การแข่งขันดนตรีสองรายการ และการแสดงเพลงร้องหนึ่งรายการ | เราไม่ได้ใช้มันในการบรรยาย |
| Qwen Audio 3.0 TTS Flash | คุณต้องการเสียงบรรยายหรือเสียงที่แสดงอารมณ์ | การแข่งขันการพูดสองคู่ | ผลลัพธ์เหล่านี้ใช้ได้กับเวอร์ชัน Flash ที่ได้รับการทดสอบ |
| Seed Audio 1.0 | คุณต้องการฉากที่ครบถ้วนพร้อมด้วยหลายประเภทของเสียง | เพลง คำพูด และฉากที่สถานีรถไฟ | ผลลัพธ์ที่ยืดหยุ่นจะไม่สร้างซ้ำทุกคุณสมบัติจากส่วนต้น |
ก่อนอื่น นี่คือสามประเภทของโมเดลเสียงที่แตกต่างกัน
Eleven Music v2: กระบวนการทำงานที่ออกแบบมาโดยเฉพาะสำหรับดนตรี
ElevenLabs อธิบายว่า Eleven Music เพื่อสร้างเนื้อเพลงจากข้อความ โดยสามารถควบคุมประเภท สไตล์ และโครงสร้างได้ เอกสารยังแสดงผลลัพธ์ทั้งเสียงร้องและเครื่องดนตรี การสร้างเนื้อหาหลายภาษา รวมถึงการแก้ไขตามส่วนหรือทั้งเพลง คุณสมบัติเหล่านี้ทำให้มันเป็นกระบวนการทำงานด้านดนตรีที่ชัดเจนที่สุดที่นี่ แต่ไม่ได้หมายความว่ามันเป็นวิธีการแปลงข้อความเป็นเสียง (TTS) แบบเดียวกับ Qwen.

Qwen Audio 3.0 TTS Flash: เส้นทางการแปลงข้อความเป็นเสียงที่ได้รับการทดสอบในที่นี้
Qwen Audio 3.0 TTS Flash — เส้นทาง Anywhere ที่ถูกต้องคือ qwen-audio-3.0-tts-flash—คือเส้นทางเสียงที่ใช้ใน B1 และ B2. เอกสารคู่มือระบบสังเคราะห์เสียงของ Alibaba Cloud ระบุชื่อ Flash ที่ตรงกันนั้นในบริบทเสียงที่กำหนดเอง บทความนี้ไม่ถ่ายโอนข้อมูลเกี่ยวกับระยะเวลา รูปแบบ หรือคำกล่าวอ้างเกี่ยวกับเสียงที่ติดตั้งมาพร้อมระบบ จากแถวหรือตัวแปรอื่น ๆ ของ Qwen.

Seed Audio 1.0: กระบวนการทำงานที่กว้างขึ้นในวงการเสียง
ตำแหน่งใน ByteDance Seed Audio 1.0 เพื่อสร้างฉากเสียงแบบครบวงจร รวมถึงเสียงพูด เสียงเอฟเฟกต์ เสียงบรรยากาศ และการจัดเรียงเสียงแบบรวมเป็นหนึ่ง ซึ่งทำให้มันเป็นตัวเลือกที่เหมาะสมที่สุดเมื่อผลลัพธ์เดียวต้องประสานงานกับหลายประเภทเสียง ภาพรวมที่แสดงไว้นั้นไม่ได้ระบุอย่างชัดเจนว่าเกี่ยวข้องกับดนตรี ดังนั้นข้อสังเกตเกี่ยวกับดนตรีในบทความนี้จึงมาจากการทดสอบจริงของเรา ไม่ใช่จากภาพดังกล่าว.

ส่วนที่แยกต่างหาก หน้า API ของ BytePlus ระบุ seed-audio-1.0 ในฐานะเส้นทางที่ไม่ใช้การสตรีมมิ่ง ซึ่งมีสัญญาณเสียงหรือภาพอ้างอิง การควบคุมเวลา และระยะเวลาการส่งออกสูงสุด 120 วินาที นี่คือข้อมูลเกี่ยวกับเส้นทาง ซึ่งถูกแยกออกจากคำอธิบายตำแหน่งของโมเดลในภาพรวม.

วิธีที่เราทดสอบกระบวนการทำงานด้านเสียงทั้งสาม
เราได้ล็อกข้อความคำสั่งก่อนการสร้างเนื้อหา ส่งคำขอสิบรายการแบบต่อเนื่อง และเก็บผลลัพธ์ที่ถูกต้องครั้งแรกจากแต่ละคำขอไว้ คำขอทั้งสิบรายการสำเร็จทั้งหมดโดยไม่จำเป็นต้องลองใหม่เลย คลิปเสียงที่ยังไม่พร้อมใช้งานถูกตัดออก; เสียงทดสอบด้านล่างคือสื่อดิบที่ถูกต้องครั้งแรก.
- หลักฐานอย่างเป็นทางการ: เอกสารผลิตภัณฑ์หรือ API ของผู้พัฒนาเอง.
- หลักฐานจากเส้นทางที่สังเกตได้: รูปแบบ, เวลา, ค่าใช้จ่าย, การถอดรหัส และการตรวจสอบสัญญาณจากเซสชันนี้.
- หลักฐานการฟัง: ความชอบแบบคู่แบบไม่เปิดเผยของผู้ใช้หนึ่งคนต่อ A1, A2, B1 และ B2 พร้อมกับการประเมินเชิงความหมายสำหรับ C1 และ C3.
- ขีดจำกัด: การตรวจสอบความเสถียรภาพยังไม่ได้รับการดำเนินการ; B1 และ B2 ยังไม่ได้รับการถอดความหรือตรวจสอบคำต่อคำโดยอัตโนมัติ.
ค่าชาร์จรวมที่บันทึกได้คือ $0.4819752667 สำหรับ 10 ผลลัพธ์ ตัวเลขนี้ใช้เพื่ออธิบายเซสชันนี้เท่านั้น และไม่ใช่คำสัญญาด้านราคาอย่างเป็นทางการ.
การทดสอบระบบเสียง: Eleven Music v2 vs Seed Audio 1.0
A1: เพลงประกอบแบบสารคดี
A1: เพลงประกอบแบบสารคดี
เพลงประกอบแบบไม่มีคำร้องสำหรับสารคดีท่องเที่ยวความยาว 30 วินาที ที่มีจังหวะค่อยๆ เพิ่มขึ้นอย่างนุ่มนวลและจบลงอย่างสมบูรณ์.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
สร้างเพลงประกอบแบบไม่มีเสียงร้อง (instrumental) ความยาว 30 วินาที สำหรับสารคดีท่องเที่ยวสั้นๆ เริ่มต้นด้วยเสียงกีตาร์อะคูสติกที่เล่นด้วยนิ้วอย่างนุ่มนวลและเสียงเปียโนที่อบอุ่น เพิ่มเสียงเครื่องเคาะมือเบาๆ หลังจากผ่านไปหนึ่งในสามของเพลง สร้างบรรยากาศให้ค่อยๆ เพิ่มขึ้นอย่างนุ่มนวล และจบด้วยจังหวะที่ชัดเจนและลงตัว ให้ความรู้สึกเต็มไปด้วยความหวังและชวนให้ครุ่นคิด ไม่มีเสียงร้อง ไม่มีเสียงพูด และไม่มีเสียงเอฟเฟกต์.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | ครั้งแรกที่ถูกต้อง | 30.041 วินาที | MP3, สเตอริโอ 44.1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | ครั้งแรกที่ถูกต้อง | 30.000s | PCM WAV, สเตอริโอ 40 kHz | $0.0700000 |
- การตรวจสอบอย่างเป็นกลาง
- ทั้งสองไฟล์ถูกถอดรหัสอย่างถูกต้อง ไม่มีการตัดสัญญาณที่ใกล้เกิดขึ้น และจบลงด้วยการลดระดับเสียงอย่างชัดเจน ไม่มีการบันทึกข้อมูลความสอดคล้องของอุปกรณ์อย่างละเอียด.
- การตัดสินของผู้ฟัง
- ผู้ฟังชอบ Eleven Music v2 มากกว่า เพราะการเปลี่ยนจากจังหวะเบาไปสู่จังหวะหนักรู้สึกเป็นธรรมชาติมากขึ้น และการประสานเสียงของเครื่องดนตรีฟังดูกลมกลืนกันมากขึ้น.
- ผลลัพธ์ของงาน
- Eleven เป็นตัวเลือกที่เหมาะที่สุดสำหรับงานนี้ ซึ่งเป็นงานที่สร้างผลลัพธ์ครั้งแรก.
- ข้อจำกัด
- ผลลัพธ์ที่ถูกต้องเพียงหนึ่งครั้งต่อโมเดล; ไม่มีการทดสอบความเสถียร.
การทดสอบการฟัง A1
ฟังเสียงจากช่องออก A1 ก่อน
เล่นไพ่ใบใดใบหนึ่งเพื่อเปรียบเทียบทั้งสองแบบโดยตรง.
Eleven Music v2
eleven-music-v2สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
Seed Audio 1.0
seed-audio-1.0สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
สำหรับ A1 ผู้ฟังได้เลือกเวอร์ชันแรกของ Eleven เพื่อความต่อเนื่องที่ธรรมชาติยิ่งขึ้นจากส่วนที่เบาสู่ส่วนที่หนัก และความประสานกันของเครื่องดนตรีที่กลมกลืนยิ่งขึ้น.
A2: สัญญาณการเปิดตัวผลิตภัณฑ์ที่มีโครงสร้าง
A2: สัญญาณการเปิดตัวผลิตภัณฑ์ที่มีโครงสร้าง
เพลงบรรเลงแบบมีจังหวะ แบ่งเป็นสามส่วน ความยาวรวม 30 วินาที: จังหวะพื้นฐานที่เรียบง่าย เพิ่มกลองและพลังงานที่ค่อยๆ เพิ่มขึ้น จนถึงช่วงท้ายที่สดใสและพุ่งขึ้น.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
สร้างเพลงบรรเลงความยาว 30 วินาที สำหรับการเปิดตัวผลิตภัณฑ์ โดยแบ่งเป็นสามส่วนที่ชัดเจน: 0–8 วินาที เป็นจังหวะซินธ์แบบมินิมัล; 8–22 วินาที เพิ่มเสียงกลองอิเล็กทรอนิกส์ที่คมชัดและพลังงานฮาร์โมนิกที่เพิ่มขึ้น; 22–30 วินาที สร้างจุดสูงสุดที่สดใสและจบลงอย่างสะอาด ทันสมัยและมั่นใจ แต่ไม่ก้าวร้าว ไม่ใช้เสียงร้อง เสียงพูด หรือเสียงสิ่งแวดล้อม.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | ครั้งแรกที่ถูกต้อง | 30.041 วินาที | MP3, สเตอริโอ 44.1 kHz | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | ครั้งแรกที่ถูกต้อง | 27.704 วินาที | PCM WAV, สเตอริโอ 40 kHz | $0.0646436 |
- การตรวจสอบอย่างเป็นกลาง
- ไฟล์ทั้งสองถูกถอดรหัสอย่างถูกต้อง โดยไม่มีปัญหาการตัดสัญญาณที่ใกล้จะเกิดขึ้น Seed แสดงค่า 27.704 วินาที สำหรับคำขอ 30 วินาที; นี่เป็นพฤติกรรมตามเส้นทาง ไม่ใช่การลดคุณภาพ.
- การตัดสินของผู้ฟัง
- ผู้ฟังชอบ Seed Audio 1.0 มากกว่า เนื่องจากส่วนเปิดมีความชัดเจนมากขึ้นและชั้นเสียงดนตรีมีความลึกซึ้งยิ่งขึ้น ส่วนเปิดของ Eleven ฟังได้ยาก.
- ผลลัพธ์ของงาน
- Seed เป็นตัวเลือกที่เหมาะที่สุดสำหรับงานผลแรกนี้; ส่วนการทดสอบเพลงสองครั้งนั้นให้ผลลัพธ์ที่แตกต่างกัน.
- ข้อจำกัด
- ยังไม่มีการตรวจสอบเวลาของแต่ละส่วนอย่างละเอียดถี่ถ้วน; ยังไม่มีการทดสอบความเสถียร.
การทดสอบการฟัง A2
ฟังเสียงจากช่องออก A2 ครั้งแรก
เล่นไพ่ใบใดใบหนึ่งเพื่อเปรียบเทียบทั้งสองแบบโดยตรง.
Eleven Music v2
eleven-music-v2สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
Seed Audio 1.0
seed-audio-1.0สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
สำหรับ A2 ผลลัพธ์แรกจาก Seed ได้รับการชื่นชอบจากผู้ฟัง เนื่องจากส่วนอินโทรชัดเจนกว่า และชั้นเสียงรู้สึกมีความลึกซึ้งมากขึ้น เส้นทางของ Seed ใช้เวลา 27.704 วินาที สำหรับคำขอ 30 วินาที; เราบันทึกความแตกต่างนี้แยกต่างหาก ไม่ใช่เพื่อพิจารณาว่าเป็นข้อเสียด้านคุณภาพ เนื่องจากแต่ละโมเดลมีผลงานที่ดีกว่าในภารกิจด้านดนตรีอย่างละหนึ่ง จึงไม่มีผู้ชนะในหมวดหมู่ดนตรี.
การทดสอบเสียงพูด: Qwen TTS Flash เทียบกับ Seed Audio 1.0
B1: เสียงบรรยายแบบสารคดีที่เป็นกลาง
B1: เสียงบรรยายสารคดีแบบกลางๆ
การบรรยายเกี่ยวกับท่าเรือในภาษาอังกฤษแบบเดิม ด้วยน้ำเสียงที่สงบและเป็นกลาง จังหวะการพูดที่พอเหมาะ และช่วงหยุดที่ดูเป็นธรรมชาติ.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
ทุกเช้า ท่าเรือตื่นขึ้นก่อนเมือง เรือเฟอร์รีแล่นข้ามน้ำ ไฟร้านค้าเริ่มสว่างขึ้น และผู้เดินทางไปทำงานกลุ่มแรกเริ่มก้าวขึ้นท่าเรือ เมื่อถึงเวลาเจ็ดโมง ชายฝั่งที่เงียบสงบก็กลายเป็นศูนย์กลางของวันนั้นแล้ว เสียงบรรยายสารคดีที่สงบด้วยภาษาอังกฤษที่ชัดเจนและเป็นกลาง ใช้จังหวะที่พอเหมาะและหยุดพักอย่างเป็นธรรมชาติ ไม่ใช้ดนตรี เสียงบรรยากาศ หรือเสียงเอฟเฟกต์.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | ครั้งแรกที่ถูกต้อง | 27.507 วินาที | MP3, 22.05 kHz โมโน | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | ครั้งแรกที่ถูกต้อง | 18.780 วินาที | PCM WAV, สเตอริโอ 40 kHz (ช่องเสียงทั้งสองเหมือนกัน) | $0.0438200 |
- การตรวจสอบอย่างเป็นกลาง
- ทั้งสองไฟล์ถูกถอดรหัสอย่างถูกต้อง และมีเสียงที่คล้ายการพูดรวมถึงช่วงหยุดพัก ผู้ใช้รายงานว่าไม่มีปัญหาเกี่ยวกับข้อความที่ชัดเจน.
- การตัดสินของผู้ฟัง
- ผู้ฟังชอบ Qwen มากกว่า เพราะฟังดูเป็นธรรมชาติและคล้ายกับเสียงในสารคดี ส่วน Seed ฟังดูแข็งกระด้าง เหมือนคำเตือนก่อนสอบ.
- ผลลัพธ์ของงาน
- Qwen เป็นตัวเลือกที่แนะนำสำหรับงานที่เน้นผลลัพธ์แรกนี้.
- ข้อจำกัด
- ความถูกต้องตามคำต่อคำยังไม่ได้รับการตรวจสอบ; ยังไม่มีการทดสอบความเสถียร.
การทดสอบการฟังระดับ B1
ฟังสัญญาณออกแรกจาก B1
เล่นไพ่ใบใดใบหนึ่งเพื่อเปรียบเทียบทั้งสองแบบโดยตรง.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashสร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
Seed Audio 1.0
seed-audio-1.0สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
ผลลัพธ์แรกจาก Qwen ฟังดูเป็นธรรมชาติและคล้ายกับสารคดีมากกว่า ส่วน Seed ฟังดูแข็งกระด้างสำหรับผู้ฟัง หากการตรวจสอบบทถอดเสียงเป็นส่วนสำคัญในกระบวนการทำงานของคุณ คู่มือแยกต่างหากนี้จะอธิบาย วิธีที่ ChatGPT สามารถแปลงเสียงเป็นข้อความได้. เราไม่ได้ใช้การถอดเสียงเพื่อตรวจสอบคำ B1 คำต่อคำ.
B2: การพัฒนาทางอารมณ์
B2: การพัฒนาทางอารมณ์
เสียงผู้หญิงหนึ่งเสียงที่เปลี่ยนจากเสียงกระซิบที่ตึงเครียด ไปสู่การเล่าเรื่องอย่างเป็นกลาง จนถึงเสียงตื่นเต้นที่โล่งอก.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
“เราทำสำเร็จแล้ว,” มายาพูดด้วยเสียงเบาๆ แล้วไฟก็สว่างขึ้นอีกครั้ง “โอเค—ตอนนี้เราฉลองได้แล้ว!” ใช้เสียงผู้หญิงผู้ใหญ่เพียงหนึ่งเดียวที่สม่ำเสมอ อ่านประโยคแรกด้วยเสียงเบาๆ และเต็มไปด้วยความตึงเครียด ประโยคกลางด้วยน้ำเสียงเล่าเรื่องที่เป็นกลาง และประโยคสุดท้ายด้วยความตื่นเต้นที่โล่งอก ให้ความเปลี่ยนแปลงทางอารมณ์ชัดเจนแต่ไม่ดูเกินจริง ไม่ใช้ดนตรีหรือเสียงเอฟเฟกต์.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | ครั้งแรกที่ถูกต้อง | 25.913 วินาที | MP3, 22.05 kHz โมโน | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | ครั้งแรกที่ถูกต้อง | 9.180 วินาที | PCM WAV, สเตอริโอ 40 kHz (ช่องเสียงทั้งสองเหมือนกัน) | $0.0214200 |
- การตรวจสอบอย่างเป็นกลาง
- ทั้งสองไฟล์ถูกถอดรหัสอย่างถูกต้อง; มีหลายส่วนเสียงปรากฏอยู่ ความแตกต่างด้านระยะเวลาไม่ถูกนับเป็นปัจจัยด้านคุณภาพ.
- การตัดสินของผู้ฟัง
- ผู้ฟังชอบ Qwen มากกว่า เพราะให้เสียงกระซิบที่ชัดเจนยิ่งขึ้น และสร้างบรรยากาศการเล่าเรื่องที่น่าเชื่อถือมากขึ้น.
- ผลลัพธ์ของงาน
- Qwen เป็นตัวเลือกที่แนะนำสำหรับงานที่เน้นผลลัพธ์แรกนี้.
- ข้อจำกัด
- ความถูกต้องตามคำต่อคำยังไม่ได้รับการตรวจสอบ; ยังไม่มีการทดสอบความเสถียร.
การทดสอบการฟัง B2
ฟังเสียงจาก B2 ครั้งแรก
เล่นไพ่ใบใดใบหนึ่งเพื่อเปรียบเทียบทั้งสองแบบโดยตรง.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flashสร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
Seed Audio 1.0
seed-audio-1.0สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
ผลลัพธ์ครั้งแรกของ Qwen มีลักษณะเสียงกระซิบที่ชัดเจนยิ่งขึ้น และให้ความรู้สึกเหมือนการเล่าเรื่องมากขึ้น ผู้ใช้ไม่พบปัญหาด้านข้อความที่ชัดเจนใน B1 หรือ B2 แต่ความแม่นยำของคำที่ตรงกันยังไม่ได้รับการยืนยัน.
ตัวอย่างกระบวนการทำงานแบบโมเดลเดียว
C1: Eleven Music v2 เพลงที่มีส่วนร้องจัดโครงสร้าง
C1: เพลงร้องที่มีโครงสร้าง
เพลงอินดี้-ป็อปความยาว 30 วินาที ที่มีเครื่องดนตรี โครงสร้าง และสองบรรทัดเนื้อเพลงที่กำหนดไว้.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
สร้างเพลงอินดี้-ป็อปที่มีจังหวะสดใส ความยาว 30 วินาที โดยมีนักร้องนำหญิงหนึ่งคน กีตาร์ที่สดใส เบส และเสียงตบมือ โครงสร้าง: อินโทรดนตรี 4 วินาที ท่อนร้องสั้น ท่อนคอรัส และส่วนจบที่ชัดเจน ใช้แต่ละบรรทัดเนื้อเพลงต่อไปนี้เพียงครั้งเดียว: ท่อนร้อง: ‘Morning on the window, plans are taking flight.’ ท่อนคอรัส: ‘Start where you are, and make the moment bright.’ ไม่มีการบรรยายด้วยเสียงหรือเอฟเฟกต์เสียง.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | ครั้งแรกที่ถูกต้อง | 30.041 วินาที | MP3, สเตอริโอ 44.1 kHz | $0.0750000 |
- การตรวจสอบอย่างเป็นกลาง
- ไฟล์ MP3 ถูกถอดรหัสอย่างถูกต้อง พบตัวอย่างสัญญาณเต็มสเกลที่แยกออกมาได้เล็กน้อย ซึ่งไม่มีปัญหาการตัดสัญญาณ (clipping) ที่เกิดขึ้นอย่างแพร่หลาย.
- การตัดสินของผู้ฟัง
- ผู้ฟังประเมินว่าตรงตามเกณฑ์บางส่วน: เสียงฟังดูไม่ธรรมชาติมากนัก และมีเสียงรบกวนคล้ายเสียงไฟฟ้า.
- ผลลัพธ์ของงาน
- ผลลัพธ์แรกนี้บรรลุเป้าหมายบางส่วนแล้ว.
- ข้อจำกัด
- การสังเกตนี้ใช้ได้เฉพาะกับผลลัพธ์แรกนี้เท่านั้น; ยังไม่มีการทดสอบความเสถียร.
การทดสอบการฟัง C1
ฟังสัญญาณออกแรกจาก C1
เล่นผลลัพธ์ที่ถูกต้องแรกจากส่วนแสดงตัวอย่างแบบเดียวนี้.
Eleven Music v2
eleven-music-v2สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
C1 ได้ปฏิบัติตามสัญญาบางส่วน ผู้ฟังรู้สึกว่าเสียงฟังดูไม่ธรรมชาติมากนัก และได้ยินเสียงรบกวนคล้ายเสียงไฟฟ้า ซึ่งเป็นการสังเกตเฉพาะตัวอย่างนั้น ไม่ใช่ข้อร้องเรียนเกี่ยวกับข้อบกพร่องทั่วไป.
C3: Seed Audio 1.0 ฉากสถานีรถไฟแบบครบถ้วน
C3: ฉากสถานีรถไฟที่สมบูรณ์
ฉากสถานีรถไฟริมชายหาดความยาว 20 วินาที ที่ผสมผสานระหว่างเสียงบรรยากาศ รถไฟที่กำลังเคลื่อนที่ เสียงระฆัง และการประกาศที่แม่นยำ.
แสดงข้อความคำสั่งที่ถูกแช่แข็งไว้อย่างแม่นยำ
สร้างฉากสถานีรถไฟชายฝั่งที่สมบูรณ์แบบยาว 20 วินาทีในช่วงรุ่งเช้า เริ่มด้วยลมทะเลที่อ่อนโยนและเสียงนกนางนวลจากไกลๆ รถไฟกำลังเคลื่อนเข้ามาจากทางซ้ายและหยุดลงที่ชานชาลา ผู้ประกาศหญิงของสถานีด้วยน้ำเสียงสงบกล่าวอย่างชัดเจนว่า: ‘รถไฟสายชายฝั่งเวลา 7:15 กำลังเข้าจอดที่ชานชาลา 2’ เพิ่มเสียงระฆังดนตรีเบาๆ สั้นๆ ก่อนการประกาศ แล้วปล่อยให้เสียงรถไฟและบรรยากาศค่อยๆ จางหายไปอย่างเป็นธรรมชาติ รักษาให้คำพูดฟังชัดเจนและฉากมีความสอดคล้องทางพื้นที่.
| แบบจำลอง | เส้นทางที่แม่นยำ | สถานะ | ระยะเวลาจริง | รูปแบบ | ต้นทุนที่บันทึกไว้ |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | ครั้งแรกที่ถูกต้อง | 20,000s | PCM WAV, สเตอริโอ 40 kHz | $0.0466667 |
- การตรวจสอบอย่างเป็นกลาง
- ไฟล์ WAV ได้รับการถอดรหัสอย่างถูกต้อง ไม่มีอาการตัดสัญญาณที่ใกล้จะเกิดขึ้น และในระดับทางเทคนิคแล้ว มีโครงสร้างฉากหลายส่วนตามที่ขอไว้.
- การตัดสินของผู้ฟัง
- ผู้ฟังให้คะแนนว่าตรงตามเกณฑ์บางส่วน เนื่องจากเสียงการเบรกและหยุดของรถไฟฟังดูค่อนข้างไม่เป็นธรรมชาติ.
- ผลลัพธ์ของงาน
- ผลลัพธ์แรกนี้บรรลุเป้าหมายบางส่วนแล้ว.
- ข้อจำกัด
- ข้อความประกาศดังกล่าวไม่ได้ถูกบันทึกไว้อย่างอิสระ; ยังไม่มีการทดสอบความเสถียร.
การทดสอบการฟัง C3
ฟังสัญญาณออกแรกจาก C3
เล่นผลลัพธ์ที่ถูกต้องแรกจากส่วนแสดงตัวอย่างแบบเดียวนี้.
Seed Audio 1.0
seed-audio-1.0สร้างขึ้นผ่านเส้นทาง Anywhere ที่ผ่านการทดสอบเมื่อวันที่ 6 สิงหาคม 2026 ผลลัพธ์ที่ถูกต้องแรกหนึ่งรายการ; ยังไม่ผ่านการทดสอบความเสถียร.
C3 ยังได้ปฏิบัติตามสัญญาบางส่วนด้วย: ผู้ฟังรู้สึกว่าเสียงเบรกและเสียงหยุดของรถไฟฟังดูไม่เป็นธรรมชาติมากนัก ผู้สร้างวิดีโอที่ผสมผสานเสียงพูดที่สร้างขึ้นด้วยระบบคอมพิวเตอร์กับภาพอาจพบปัญหาเดียวกันนี้ด้วย คู่มือการสนทนา เสียง และการซิงค์ริมฝีปาก มีประโยชน์ แม้ว่าการซิงค์ริมฝีปากยังไม่ได้รับการทดสอบในที่นี้.
ค่าใช้จ่าย ความยาวผลลัพธ์ และพฤติกรรมของเส้นทาง
ค่าประจุที่วัดได้และระยะเวลาการทำงานจริง
ผลลัพธ์ที่ถูกต้องครั้งแรกต่อแต่ละงานผ่าน Anywhere ในวันที่ 6 สิงหาคม 2026 ค่าที่แสดงเป็นการสังเกตการณ์ในเซสชัน ไม่ใช่ตารางราคาอย่างเป็นทางการ มินิบาร์ทั้งสองใช้สเกลภาพที่แยกกัน ไม่มีการใช้แกนคู่หรือคะแนนรวม.
ค่าใช้จ่ายที่วัดได้มีช่วงตั้งแต่ $0.00513 สำหรับ Qwen B1 ไปจนถึง $0.075 สำหรับแต่ละผลลัพธ์ของ Eleven ระยะเวลาจริงมีช่วงตั้งแต่ 9.180 วินาที สำหรับ Seed B2 ไปจนถึง 30.041 วินาที สำหรับผลลัพธ์เพลงของ Eleven ทั้งหมด นี่เป็นผลการวัดจากเซสชันจริง ไม่ใช่ราคาตามรายการหรือคะแนนคุณภาพ.
ทำไมจึงควรลองใช้โมเดลเสียงเหล่านี้บน GlobalGPT?
การสร้างดนตรี ระบบ TTS ที่แสดงอารมณ์ได้ และเสียงบรรยากาศที่ครบถ้วน เป็นงานที่แตกต่างกัน ดังนั้นจึงไม่มีโมเดลเดียวที่เหมาะสำหรับทุกงานในที่นี้ GlobalGPT ทำให้การแยกประเภทนี้ใช้งานได้จริง: คุณสามารถเริ่มต้นด้วย Eleven Music สำหรับเพลงหนึ่งเพลง เปลี่ยนไปใช้ Qwen Audio สำหรับการบรรยาย หรือใช้ Seed Audio สำหรับฉากที่แต่งขึ้น โดยไม่ต้องรักษาแพลตฟอร์มแยกต่างหากสำหรับทุกขั้นตอนการทำงานด้านเสียง.
เนื่องจาก GlobalGPT เป็นพื้นที่ทำงานแบบหลายโมเดล ไม่ใช่เพียงเครื่องมือสำหรับเสียงเท่านั้น ดังนั้นงานจึงไม่จำเป็นต้องจบลงที่ไฟล์เสียงเท่านั้น คุณสามารถใช้โมเดล AI อื่นๆ บนแพลตฟอร์มนี้เพื่อร่างหรือปรับปรุงบทเขียน วิจัยหัวข้อ สร้างภาพประกอบ และพัฒนาเนื้อหาวิดีโอที่เกี่ยวข้องกับเสียงที่เสร็จสมบูรณ์แล้ว.
เมื่อวันที่ 10 สิงหาคม 2569, หน้าราคาของ GlobalGPT แสดงค่าเทียบเท่าต่อเดือนเป็น $5.8 สำหรับ BASIC, $10.8 สำหรับ PRO และ $25.0 สำหรับ UNLIMITED โดยมีการเลือก "รายปี" และแสดง "เรียกเก็บเงินรายปี" นี่คือตัวเลขการเรียกเก็บเงินรายปีของหน้านี้; การเข้าถึงแบบจำลองจะแตกต่างกันไปตามแผนบริการ.

คุณควรเลือกรุ่นไหนดี?
แมทริกซ์ผลลัพธ์ครั้งแรกของหกงาน
| กระบวนการทำงาน | รุ่นที่ได้รับการทดสอบ | ผลลัพธ์ | เหตุผลที่สังเกตได้ | ประเภทหลักฐาน | ข้อจำกัด |
|---|---|---|---|---|---|
| A1 · ดนตรี | Eleven vs Seed | สิบเอ็ดเป็นตัวเลือกที่นิยมที่สุด | การพัฒนาที่ดูเป็นธรรมชาติมากขึ้น และการใช้เครื่องดนตรีที่กลมกลืนกัน | การวัดความชอบของผู้ฟังแบบไม่เปิดเผยตัวตน | ผลลัพธ์แรกอย่างละหนึ่ง |
| A2 · ดนตรี | Eleven vs Seed | ควรใช้เมล็ด | ส่วนนำที่ชัดเจนขึ้นและชั้นเสียงที่อุดมสมบูรณ์ยิ่งขึ้น | การวัดความชอบของผู้ฟังแบบไม่เปิดเผยตัวตน | Seed ใช้เวลา 27.704 วินาที |
| B1 · การพูด | Qwen vs Seed | Qwen เป็นตัวเลือกที่แนะนำ | สไตล์การเล่าเรื่องแบบสารคดีที่ดูเป็นธรรมชาติมากขึ้น | การวัดความชอบของผู้ฟังแบบไม่เปิดเผยตัวตน | ข้อความนี้ยังไม่ได้รับการตรวจสอบคำต่อคำ |
| B2 · การพูด | Qwen vs Seed | Qwen เป็นตัวเลือกที่แนะนำ | เสียงกระซิบที่ชัดเจนยิ่งขึ้น และบรรยากาศการเล่าเรื่องที่เข้มข้นขึ้น | การวัดความชอบของผู้ฟังแบบไม่เปิดเผยตัวตน | ข้อความนี้ยังไม่ได้รับการตรวจสอบคำต่อคำ |
| C1 · เพลงร้อง | สิบเอ็ดเท่านั้น | บรรลุบางส่วน | เสียงฟังดูไม่เป็นธรรมชาติ และมีเสียงรบกวนเหมือนเสียงไฟฟ้า | การตรวจสอบความหมายโดยผู้ใช้ | การสังเกตเฉพาะตัวอย่าง |
| C3 · ภูมิทัศน์เสียง | เฉพาะเมล็ดเท่านั้น | บรรลุบางส่วน | เสียงการเบรกและการหยุดของรถไฟฟังดูไม่เป็นธรรมชาติ | การตรวจสอบความหมายโดยผู้ใช้ | ประกาศนี้ยังไม่ถูกถอดความ |
ไม่มีแถวใดที่ถูกแปลงเป็นคะแนนรวมหรือผู้ชนะโดยรวม.
- เลือก Eleven Music v2 เมื่องานนั้นเกี่ยวข้องกับดนตรีเป็นหลัก: เพลงบรรเลงที่มีโครงสร้างชัดเจน, เพลงร้อง, หรือการแก้ไขดนตรีในระดับส่วน.
- เลือก Qwen Audio 3.0 TTS Flash เมื่องานนั้นเป็นการบรรยายหรือการพูดที่ควบคุมการแสดงออก.
- เลือก Seed Audio 1.0 เมื่อผลลัพธ์ต้องทำงานเหมือนฉากที่สมบูรณ์ ซึ่งรวมบรรยากาศ เสียงเอฟเฟกต์ และเสียงพูดเข้าด้วยกัน.
คำแนะนำเหล่านี้สรุปความเหมาะสมของกระบวนการทำงาน พร้อมทั้งการประเมินผลเบื้องต้นหกประการ โดยไม่ได้กำหนดผู้ชนะเพียงหนึ่งราย.
ข้อจำกัดของการเปรียบเทียบนี้
- ผลลัพธ์ที่ถูกต้องเพียงหนึ่งครั้งต่อโมเดลและงาน; ไม่มีการซ้ำกันในผลลัพธ์ที่เสถียร.
- B1 และ B2 ไม่ได้ถูกคัดลอกหรือตรวจสอบคำต่อคำ.
- การตัดสินจากการฟังเป็นเรื่องที่ขึ้นอยู่กับความเห็นส่วนตัวและขึ้นอยู่กับตัวอย่างที่นำมาใช้.
- เส้นทาง Anywhere ไม่ใช่ผลิตภัณฑ์ต้นทางทั้งหมด.
- ไม่มีตารางอันดับอิสระที่ยุติธรรมใดที่รวมเส้นทางทั้งสามนี้ไว้ภายใต้วิธีการเดียว.
- รูปแบบไฟล์ อัตราตัวอย่าง จำนวนช่องสัญญาณ ขนาดไฟล์ และระดับความดังในการเล่นกลับ ไม่ถูกนับเป็นปัจจัยที่วัดคุณภาพ.
คำถามที่มักถูกถาม
01Eleven Music v2, Qwen Audio 3.0 และ Seed Audio 1.0 เป็นแบบจำลองประเภทเดียวกันหรือไม่?
No. Eleven Music v2 เป็นระบบงานดนตรีที่ออกแบบมาโดยเฉพาะ Qwen Audio 3.0 TTS Flash เป็นระบบแปลงข้อความเป็นเสียงที่ได้รับการทดสอบในที่นี้ ส่วน Seed Audio 1.0 ถูกออกแบบมาเพื่อสร้างเสียงสำหรับฉากทั้งฉาก ดังนั้น การเปรียบเทียบนี้จึงแนะนำตามแต่ละงาน แทนที่จะกำหนดอันดับเดียวที่ใช้ได้กับทุกกรณี.
02รุ่นใดที่ออกแบบมาเพื่อสร้างเพลงด้วย AI?
Eleven Music v2 เป็นตัวเลือกซอฟต์แวร์เฉพาะทางสำหรับเพลงที่ชัดเจนที่สุดในการเปรียบเทียบครั้งนี้ เอกสารอย่างเป็นทางการของโปรแกรมนี้อธิบายถึงความสามารถในการควบคุมประเภทเพลง สไตล์ โครงสร้าง การเลือกให้ออกเสียงร้องหรือเครื่องดนตรี การรองรับหลายภาษา รวมถึงการแก้ไขระดับส่วนหรือทั้งเพลง.
03เส้นทางใดที่ผ่านการทดสอบแล้วเหมาะสมกับการเล่าเรื่องและการพูดที่แสดงอารมณ์?
Qwen Audio 3.0 TTS Flash ซึ่งระบุในที่นี้ด้วยเส้นทาง Anywhere ที่แม่นยำคือ qwen-audio-3.0-tts-flash ได้ผลดีที่สุดในการทดสอบการบรรยายและการพูดที่แสดงอารมณ์ ผู้ฟังชอบผลลัพธ์แรกของมันทั้งใน B1 และ B2 แต่ความเสถียรและความแม่นยำของคำที่ออกเสียงยังไม่ได้รับการทดสอบ.
04รุ่นใดสามารถสร้างบรรยากาศเสียงที่สมบูรณ์พร้อมด้วยเสียงพูดและเอฟเฟกต์ได้?
Seed Audio 1.0 เป็นระบบการทำงานที่เหมาะสมที่สุดสำหรับการสร้างเสียงบรรยากาศที่จัดแต่งอย่างลงตัว การกำหนดตำแหน่งอย่างเป็นทางการของระบบนี้ครอบคลุมเสียงพูด เสียงเอฟเฟกต์ เสียงบรรยากาศ และการจัดแต่งเสียงแบบบูรณาการ ส่วนการทดสอบ C3 ได้รวมเสียงประกาศสถานี เสียงรถไฟเคลื่อนที่ เสียงระฆัง และเสียงบรรยากาศชายฝั่งไว้ในผลลัพธ์เดียว.
05ผมสามารถใช้ทั้งสามตัวผ่าน GlobalGPT ได้ไหมครับ?
ใช่ครับ คุณสามารถลองใช้ Eleven Music สำหรับเพลง Seed Audio 1.0 สำหรับฉากเสียงครบวงจร และ Qwen Audio 3.0 สำหรับเสียงพูด ในพื้นที่ทำงานด้านเสียงของ GlobalGPT ได้ นอกจากนี้ GlobalGPT ยังนำกระบวนการทำงานด้านการเขียน การวิจัย ภาพ และวิดีโอ มารวมไว้ในแพลตฟอร์มหลายโมเดลเดียวกัน ความพร้อมใช้งานของโมเดลแตกต่างกันตามแผนบริการ.
06การเปรียบเทียบนี้สามารถชี้ให้เห็นผู้ชนะโดยรวมได้หรือไม่?
ไม่ครับ แบบจำลองเหล่านี้ถูกออกแบบมาเพื่อรองรับกระบวนการทำงานที่แตกต่างกัน และข้อมูลจากการทดลองจริงครอบคลุมผลลัพธ์ที่ถูกต้องครั้งแรกสำหรับแต่ละแบบจำลองและแต่ละงาน โดยไม่มีการทำซ้ำเพื่อความเสถียร ข้อสรุปที่มีประโยชน์นี้ขึ้นอยู่กับเงื่อนไข: Eleven สำหรับเพลงเฉพาะทาง, Qwen TTS Flash สำหรับเสียงพูด, และ Seed สำหรับฉากเสียงที่ครบถ้วน.
ลองใช้ขั้นตอนการทำงานด้านเสียงของคุณเอง
นำบทสรุปเพลง บทบรรยาย หรือคำชี้แนะสำหรับเสียงบรรยากาศของคุณมาที่ เครื่องสร้างเสียง GlobalGPT และเปรียบเทียบผลลัพธ์กับงานที่คุณต้องทำให้เสร็จจริง ๆ ให้ใส่ใจถึงโครงสร้างทางดนตรี การถ่ายทอดเสียงร้อง ความสอดคล้องของฉาก และการปฏิบัติตามคำสั่งอย่างทันท่วงที แทนที่จะเลือกโมเดลเพียงเพราะชื่อเท่านั้น.
เมื่อทิศทางเสียงทำงานได้แล้ว คุณสามารถดำเนินโครงการต่อไปโดยใช้โมเดล AI อื่นๆ ของ GlobalGPT สำหรับการพัฒนาบทเขียน การวิจัย การสร้างภาพประกอบ และแนวคิดวิดีโอ ซึ่งจะทำให้การทดสอบนี้กลายเป็นกระบวนการทำงานเนื้อหาที่ใช้งานได้จริง แทนที่จะเป็นเพียงการสาธิตเสียงแบบแยกส่วน; ให้สร้างผลลัพธ์ซ้ำเฉพาะเมื่อต้องการหลักฐานความเสถียรเท่านั้น.