
Claude Sonnet 5.5 vs Opus 5.5: ราคา, ผลทดสอบประสิทธิภาพ, และการทดสอบจริง
Sonnet 5.5 และ Opus 5.5 เป็นผลิตภัณฑ์ในรุ่น Claude 5.5 แต่มีราคาและตำแหน่งทางการตลาดที่แตกต่างกัน การเปรียบเทียบนี้จะนำทั้งสองผลิตภัณฑ์มาทดสอบด้วยคำสั่งเดียวกันทั้งห้าข้อ และรายงานผลลัพธ์ที่ระบบส่งกลับมาจริง.
ช่องว่างที่วัดได้นั้นส่วนใหญ่เกี่ยวข้องกับค่าใช้จ่ายและความเร็ว. ในชุดคำสั่ง 5 ข้อนี้ Sonnet 5.5 เสร็จเร็วกว่า ใช้โทเคนผลลัพธ์น้อยลง และให้ค่าประมาณการค่าใช้จ่ายทางคณิตศาสตร์ของคำขอที่ต่ำกว่า ส่วน Opus 5.5 ใช้โทเคนและเวลามากขึ้น แต่คำตอบของมันมักมีความยาวมากกว่า บัตรงานแสดงให้เห็นว่าข้อความเพิ่มเติมนั้นส่งผลต่อผลลัพธ์ที่มีประโยชน์ในส่วนใด และในส่วนใดที่ทั้งสองโมเดลผ่านได้โดยไม่มีปัญหา.
คำสั่ง, ขีดจำกัดการร้องขอ, การตั้งค่าความพยายาม, จุดสิ้นสุด และการออกแบบให้รันหนึ่งครั้งต่อโมเดล ยังคงสอดคล้องกับเวอร์ชันก่อนหน้า รีวิว Claude Opus 5.5.
คำตอบสั้นๆ
- ความเร็วในการแข่งขันครั้งนี้: Sonnet 5.5 ดำเนินการเสร็จสิ้นคำขอ 5 ครั้งติดต่อกันภายใน 31.930 วินาทีในระบบท้องถิ่น ส่วน Opus 5.5 ใช้เวลา 47.725 วินาที.
- โทเค็นผลลัพธ์ที่รายงานจากเส้นทาง: Sonnet 5.5 ใช้ 2,686; Opus 5.5 ใช้ 3,952. จำนวนพื้นที่คิดมี 987 และ 2,214 ตามลำดับ.
- การประมาณราคาตามรายการแบบคณิตศาสตร์: คำขอ Sonnet ทั้ง 5 รายการมีมูลค่ารวมประมาณ $0.02826; ส่วนคำขอ Opus ทั้ง 5 รายการมีมูลค่ารวมประมาณ $0.08184 โดยใช้อัตราโทเคนมาตรฐานอย่างเป็นทางการ และไม่รวมค่าแคช เครดิต ภาษี และค่าเพิ่ม.
- ผลลัพธ์ของงาน: ทั้งสองโมเดลผ่านการทดสอบในส่วนการสกัดข้อมูล JSON และโจทย์คณิตศาสตร์ Sonnet รักษารูปแบบภาษาจีนสองย่อหน้าที่ถูกขอไว้ได้อย่างชัดเจนยิ่งขึ้น ส่วนผลลัพธ์การเขียนโค้ดของทั้งสองโมเดลสามารถใช้งานได้ แต่มีความแตกต่างในด้านความลึกของเนื้อหาและการอธิบายกรณีพิเศษ.
- การย้าย API: การคิดไม่สามารถถูกปิดได้; การบังคับเลือกเครื่องมือจะถูกปฏิเสธ และงบประมาณโทเคนรวมถึงการคิดด้วย ตรวจสอบ ข้อควรระวังเกี่ยวกับการย้ายข้อมูล ก่อนที่จะเปลี่ยน.
- ขอบเขตการตัดสินใจ: นี่คือการทดสอบหนึ่งครั้งต่อแต่ละงานผ่านเส้นทางของฝ่ายที่สาม ซึ่งวัดผลจากเวลาตอบสนองของพรอมต์ที่สังเกตได้ เวลาทำงานจริงในระบบท้องถิ่น และข้อมูลการใช้งานที่รายงานจากเส้นทาง — ไม่ใช่คะแนนความสามารถแบบรวม.
ราคาอย่างเป็นทางการและข้อมูลจำเพาะของรุ่น
ในบัตรรุ่นปัจจุบันของ Anthropic ระบุไว้ว่าทั้งสองรุ่นมีหน้าต่างบริบทขนาด 1M โทเคน และปริมาณข้อมูลออกสูงสุด 128K ส่วน Sonnet 5.5 ถูกระบุไว้ว่า รวดเร็ว ด้วยความพยายามในการตั้งค่าเริ่มต้นที่สูง; Opus 5.5 ถูกระบุไว้ว่า ปานกลาง ด้วยระดับความพยายามมาตรฐานระดับกลาง อัตราโทเคนมาตรฐานทำให้ Sonnet 5.5 มีราคาเข้าและออกเป็นครึ่งหนึ่งของ Opus 5.5.
| แบบจำลอง | ID API | ป้ายความล่าช้าอย่างเป็นทางการ | ข้อมูลเข้า / ข้อมูลออก | บริบท / กำลังสูงสุด | ความพยายามตามค่าเริ่มต้น | การอ่านแคช |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 | กำลังทำงาน · เร็ว | $2 / $10 ต่อ MTok | 1M / 128K | สูง | $0.20 / MTok |
| Claude Opus 5.5 | claude-opus-5-5 | ระดับสูง · ระดับปานกลาง | $4 / $20 ต่อ MTok | 1M / 128K | ระดับกลาง | $0.20 / MTok |
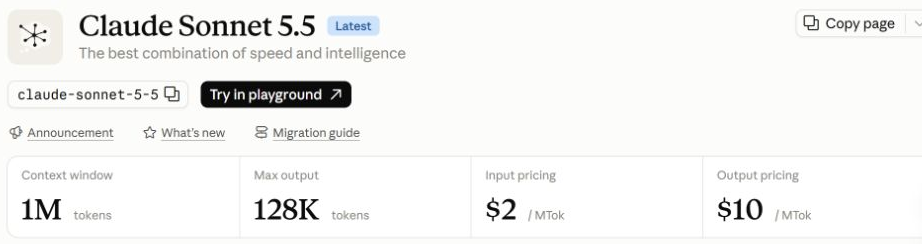
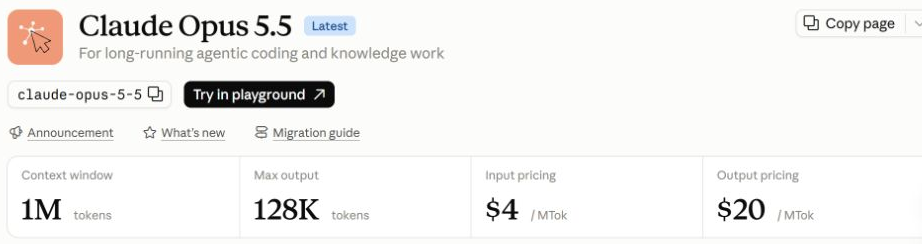
สำหรับตัวอย่างง่ายๆ ที่ไม่ใช้แคช ซึ่งมีโทเคนอินพุต 100,000 โทเคน และโทเคนเอาต์พุต 20,000 โทเคน อัตราโทเคนที่ระบุไว้จะอยู่ที่ประมาณ $0.40 สำหรับ Sonnet 5.5 และ $0.80 สำหรับ Opus 5.5 ดู คู่มือราคาและข้อจำกัดของ Claude เพื่อบริบทของแผน.
บริบทการทดสอบประสิทธิภาพอย่างเป็นทางการ
Anthropic’s ประกาศ Sonnet 5.5 จัดวางทั้งสองโมเดลไว้ในตารางเดียวที่รายงานโดยผู้ให้บริการ รูปแบบแถวถูกผสมผสานตามเกณฑ์มาตรฐานและการตั้งค่าความพยายาม.
| เกณฑ์มาตรฐานที่รายงานโดย Anthropic | Sonnet 5.5 | Opus 5.5 | วัด |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%¹ | การเข้ารหัสปลายทางแบบเอเจนติก |
| FrontierCode v1.1 (หลัก) | 46.2% Max² / 52.1% Xhigh | 54.4% | การเปลี่ยนแปลงโค้ดจะถูกรวมเข้าหรือไม่ |
| CursorBench 4.0 | 55.5% | 57.8% | งานการเข้ารหัสหลายไฟล์ที่มีความคลุมเครือ |
| GDPval-AA v2.1 | 1844 | 1846 | งานด้านความรู้ในทุกอาชีพ |
| การสอบครั้งสุดท้ายของมนุษยชาติ | 64.5% พร้อมเครื่องมือ | 67.7% พร้อมเครื่องมือ | การคิดวิเคราะห์แบบสหสาขาวิชา |
| OSWorld 2.1 | 80.1% ส่วนหนึ่ง | 81.8% ส่วนหนึ่ง | งานที่เกี่ยวข้องกับการใช้คอมพิวเตอร์ |
| แผนภูมิศาสตร์ | 61.6% ไม่ต้องการเครื่องมือ | 64.4% ไม่ใช้เครื่องมือ | การจดจำแผนภูมิแบบภาพ |
¹ Opus 5.5 Terminal-Bench ใช้ระดับความพยายาม xhigh; ² Sonnet 5.5 FrontierCode มีค่า 46.2% ที่ระดับความพยายาม Max และ 52.1% ที่ระดับความพยายาม Xhigh. ค่า OSWorld ถูกระบุว่าเป็นค่าบางส่วน นี่เป็นบริบทของผู้ให้บริการ ไม่ใช่การรันใหม่แบบอิสระที่ใช้ระดับความพยายามเท่ากัน.
วิธีใช้ API ด้วยคำสั่งเดียวกัน
แต่ละโมเดลได้รับคำสั่งทั้งห้าข้อเดียวกันผ่าน โพสต์https://anywhere.broly.ai/v1/messages. ลูกค้าได้ส่งข้อความไปยังผู้ใช้หนึ่งคน, max_tokens: 8192, output_config.effort: สูง, และไม่ใช้เครื่องมือใดๆ ทุกคำขอได้รับรหัสตอบกลับ HTTP 200 และ จบเทิร์น.
วิธีการทดสอบนี้สอดคล้องกับกรอบงานที่กว้างขึ้น ขั้นตอนการทำงานในการทดสอบแบบจำลอง GlobalGPT. แยกต่างหาก คู่มือ API Claude ครอบคลุมการตั้งค่าคำขอและการจัดการโทเค็น.
เวลา, โทเคน และค่าใช้จ่ายคาดการณ์
| เส้นทาง | เวลาท้องถิ่น 5:00 | โทเค็นอินพุต | โทเค็นผลลัพธ์ | ความคิดที่ถูกรายงาน | ค่าใช้จ่ายที่คาดการณ์สำหรับคำขอ* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 31.930 วินาที | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5 | 47.725 วินาที | 700 | 3,952 | 2,214 | $0.08184 |
* คำนวณจากโทเคนที่รายงานตามเส้นทางและอัตราค่ามาตรฐานอย่างเป็นทางการ Sonnet 5.5 มีค่าต่ำกว่า 33.1% ในด้านเวลาที่ผ่านไปจริง และต่ำกว่า 32.0% ในด้านจำนวนโทเคนผลลัพธ์ ในแพ็กนี้.
บัตรงาน 5 ใบที่ตรงกัน
แต่ละบัตรจะเก็บข้อมูลเกี่ยวกับงาน การสังเกต เวลาท้องถิ่น โทเค็นที่รายงานจากเส้นทาง สถานะ และขอบเขตไว้ด้วยกัน.
โมเดลเหล่านี้สามารถแก้ไขฟังก์ชันการลบข้อมูลซ้ำแบบผสมได้หรือไม่?
การตั้งค่างาน: ข้อความคำสั่งที่ถูกต้องได้คัดลอกมาจากข้อความก่อนหน้านี้ รีวิว Claude Opus 5.5 ชุดทดลอง.
| แบบจำลอง | เวลา / การใช้เส้นทาง | ชื่อผลลัพธ์แบบสั้น |
|---|---|---|
| Claude Sonnet 5.5 | 8.679 วินาที 145 เข้า / 830 ออก 0 การคิด HTTP 200 · end_turn | ฟังก์ชันที่แก้ไขแล้ว พร้อมด้วยสองข้อสอบ; คำอธิบายที่สั้นลง. |
| Claude Opus 5.5 | 15.844 วินาที 145 เข้า / 1478 ออก 700 ความคิด HTTP 200 · end_turn | ฟังก์ชันที่แก้ไขแล้ว พร้อมด้วยสองการทดสอบ; มีการอภิปรายเพิ่มเติมเกี่ยวกับกรณีขอบเขต. |
การเปรียบเทียบที่สังเกตได้: ทั้งสองล้วนส่งคืนฟังก์ชันที่ได้รับการแก้ไขและสองการทดสอบ Sonnet 5.5 ใช้คีย์ที่มีแท็กประเภท, casefold(), และใช้รายการสำรองในคำตอบที่สั้นกว่า; Opus 5.5 ใช้โทเคนผลลัพธ์มากขึ้นเพื่ออธิบายกรณีขอบเพิ่มเติม ทั้งสองการทดสอบไม่สามารถกำหนดผู้ชนะในการเขียนโค้ดโดยทั่วไปได้.
ขอบเขต: การแก้ไข Python เล็กๆ เพียงครั้งเดียวจะตรวจสอบกรณีขอบเขตที่เฉพาะเจาะจงเท่านั้น ไม่ใช่ความน่าเชื่อถือในทุกที่เก็บโค้ดหรือการเขียนโค้ดที่ขับเคลื่อนด้วยเครื่องมือ.
แบบจำลองเหล่านี้สามารถรักษาข้อมูลทั้งห้าข้อที่ให้ไว้ได้หรือไม่ โดยไม่เพิ่มข้ออ้างใดๆ?
การตั้งค่างาน: ข้อความคำสั่งที่ถูกต้องได้คัดลอกมาจากข้อความก่อนหน้านี้ รีวิว Claude Opus 5.5 ชุดทดลอง.
| แบบจำลอง | เวลา / การใช้เส้นทาง | ชื่อผลลัพธ์แบบสั้น |
|---|---|---|
| Claude Sonnet 5.5 | 3.569 วินาที 210 เข้า / 209 ออก 0 การคิด HTTP 200 · end_turn | ห้าข้อที่มีหมายเลข; ข้อมูลที่ให้ไว้ยังคงอยู่. |
| Claude Opus 5.5 | 4.374 วินาที 210 ช่องเข้า / 312 ช่องออก 101 วิธีคิด HTTP 200 · end_turn | ห้าข้อที่มีหมายเลข; ข้อมูลที่ให้ไว้ยังคงอยู่. |
การเปรียบเทียบที่สังเกตได้: ทั้งสองระบบได้ส่งคืนข้อความที่มีหมายเลขทั้งหมดห้าข้อความอย่างแม่นยำ และยังคงอยู่ในขอบเขตของข้อมูลที่ให้ไว้ Sonnet 5.5 ใช้โทเคนผลลัพธ์ 209 โทเคน ในขณะที่ Opus 5.5 ใช้ 312 โทเคน แต่คำสั่งนั้นเป็นข้อความสั้นๆ ไม่ใช่ข้อมูลที่มีบริบทกว้าง.
ขอบเขต: นี่คือการตรวจสอบการสกัดข้อมูลและการจัดรูปแบบที่อิงตามข้อมูลจริง; ไม่ใช่หลักฐานแสดงประสิทธิภาพในการประมวลผลบริบทที่มีโทเคนนับล้าน.
โมเดลสามารถคืนโครงสร้างที่ตรงกับที่ขอมาได้หรือไม่?
การตั้งค่างาน: ข้อความคำสั่งที่ถูกต้องได้คัดลอกมาจากข้อความก่อนหน้านี้ รีวิว Claude Opus 5.5 ชุดทดลอง.
| แบบจำลอง | เวลา / การใช้เส้นทาง | ชื่อผลลัพธ์แบบสั้น |
|---|---|---|
| Claude Sonnet 5.5 | 5.052 วินาที 128 ช่องเข้า / 260 ช่องออก 0 การคิด HTTP 200 · end_turn | JSON ที่สามารถวิเคราะห์ได้; คีย์ที่ขอและจำนวนรายการ. |
| Claude Opus 5.5 | 8.276 วินาที 128 ช่องเข้า / 622 ช่องออก 390 ความคิด HTTP 200 · end_turn | JSON ที่สามารถวิเคราะห์ได้; คีย์ที่ขอและจำนวนรายการ. |
การเปรียบเทียบที่สังเกตได้: ทั้งสองผลลัพธ์ต่างให้ JSON ที่สามารถวิเคราะห์ได้ พร้อมด้วยคีย์ที่ร้องขอ และข้อดี/ข้อเสียอย่างละสองข้อ Sonnet 5.5 มีรูปแบบที่กระชับกว่า ด้วยจำนวนโทเคนผลลัพธ์ 260 โทเคน; ข้อความเหล่านี้อธิบายถึงการจัดทำรีวิวสมมติ และไม่ใช่ข้อมูลจริงของผลิตภัณฑ์.
ขอบเขต: การทดสอบสคีมาครั้งนี้เพียงครั้งเดียว ไม่สามารถวัดความน่าเชื่อถือของผลลัพธ์ที่มีโครงสร้างได้ เมื่อมีการเรียกใช้เครื่องมือหรือในการสนทนาที่ยาวนาน.
แบบจำลองเหล่านี้สามารถนำลำดับชุดข้อมูลที่กลมกลืนไปจนถึงคำตอบสุดท้ายได้หรือไม่?
การตั้งค่างาน: ข้อความคำสั่งที่ถูกต้องได้คัดลอกมาจากข้อความก่อนหน้านี้ รีวิว Claude Opus 5.5 ชุดทดลอง.
| แบบจำลอง | เวลา / การใช้เส้นทาง | ชื่อผลลัพธ์แบบสั้น |
|---|---|---|
| Claude Sonnet 5.5 | 2.947 วินาที 89 ช่องเข้า / 163 ช่องออก 0 การคิด HTTP 200 · end_turn | คำตอบที่ถูกต้อง: 67; เขียนคำตอบสุดท้ายในบรรทัดแยกต่างหาก. |
| Claude Opus 5.5 | 3.830 วินาที 89 ช่องเข้า / 257 ช่องออก 74 ความคิด HTTP 200 · end_turn | คำตอบที่ถูกต้อง: 67; เขียนคำตอบสุดท้ายในบรรทัดแยกต่างหาก. |
การเปรียบเทียบที่สังเกตได้: ทั้งสองระบบได้คำนวณผลเป็น 67 และวางคำตอบสุดท้ายลงในบรรทัดแยกต่างหาก Sonnet 5.5 ใช้โทเคนผลลัพธ์ 163 ตัว ในขณะที่ Opus 5.5 ใช้ 257 ตัว โดยไม่พบความแตกต่างด้านความถูกต้องในคำสั่งนี้.
ขอบเขต: ลำดับเลขคณิตเพียงลำดับเดียวไม่สามารถประเมินความน่าเชื่อถือของการให้เหตุผลในภาพรวมได้.
เส้นทางนี้สามารถรักษาโครงสร้างสองย่อหน้าที่กำหนดไว้ได้หรือไม่?
การตั้งค่างาน: ข้อความคำสั่งที่ถูกต้องได้คัดลอกมาจากข้อความก่อนหน้านี้ รีวิว Claude Opus 5.5 ชุดทดลอง.
| แบบจำลอง | เวลา / การใช้เส้นทาง | ชื่อผลลัพธ์แบบสั้น |
|---|---|---|
| Claude Sonnet 5.5 | 11.683 วินาที 128 ช่องเข้า / 1224 ช่องออก 987 ความคิด HTTP 200 · end_turn | สองย่อหน้าภาษาจีน; ไม่มีกรอบเพิ่มเติม. |
| Claude Opus 5.5 | 15.401 วินาที 128 ช่องเข้า / 1283 ช่องออก 949 ความคิด HTTP 200 · end_turn | ได้ครอบคลุมประเด็นทั้งหมดแล้ว; ได้เพิ่ม Markdown และหมายเหตุภาษาอังกฤษ. |
การเปรียบเทียบที่สังเกตได้: Sonnet 5.5 ได้ส่งคืนสองย่อหน้าภาษาจีนตามที่ขอมาโดยไม่มีการจัดรูปแบบเพิ่มเติม ส่วน Opus 5.5 ก็ครอบคลุมประเด็นที่ขอมาเช่นกัน แต่เพิ่มการจัดรูปแบบ Markdown และหมายเหตุภาษาอังกฤษด้วย การบันทึกนี้แสดงรูปแบบการจัดรูปแบบในหนึ่งรอบการทำงานเท่านั้น ไม่ใช่คุณภาพภาษาจีนโดยรวม.
ขอบเขต: คำสั่งนี้ขอให้เขียนส่วนเปิดเรื่อง Opus 5.5 ดังนั้นข้อความนี้เองจึงไม่ใช่มาตรฐานภาษาที่เป็นกลาง.
ข้อควรระวังเกี่ยวกับ API และการย้ายระบบ
Sonnet 5.5 ทำงานด้วยโหมดการคิดแบบปรับตัวตามค่าเริ่มต้น; หากตั้งค่า thinking: disabled จะเกิดข้อผิดพลาด 400 และ max_tokens ครอบคลุมทั้งการคิดและข้อความตอบกลับ การตั้งค่า tool_choice เป็น any/tool แบบบังคับจะถูกปฏิเสธ ให้แยกบล็อกเนื้อหาตามประเภทและปรับงบประมาณโทเคนให้สอดคล้องกับค่าเริ่มต้นใหม่ก่อนที่จะเปลี่ยนโหมด.
สิ่งที่หลักฐานสนับสนุน
คำตัดสินระดับงาน
Sonnet 5.5: ค่าใช้จ่ายและเวลาที่วัดได้บนเส้นทางนี้ลดลง พร้อมทั้งการปฏิบัติตามรูปแบบที่กำหนดอย่างถูกต้องสำหรับงานของจีน.
Opus 5.5: ที่นี่มีราคาแพงกว่าและใช้พื้นที่มากกว่า; แต่ในหลายงานที่ไม่มีข้อจำกัด ผลวัดประสิทธิภาพอย่างเป็นทางการยังคงนำอยู่.
ใช้ข้อมูลระดับงานเพื่อเลือกจุดเริ่มต้น แล้วตรวจสอบปริมาณงานที่สำคัญต่อคุณ.
สำหรับบริบทที่เกี่ยวข้อง โปรดดู การเปรียบเทียบตระกูล Claude, บทวิจารณ์ Opus 5, และ บทวิจารณ์ Fable 5.1.
คำถามที่พบบ่อย
รุ่นไหนมีความเร็วกว่าในการทดสอบเปรียบเทียบ?
Sonnet 5.5 มีเวลารวมในท้องถิ่นที่ต่ำกว่า: 31.930 วินาที เทียบกับ 47.725 วินาที ของ Opus 5.5 สำหรับคำขอ 5 ครั้งติดต่อกัน ซึ่งรวมถึงเส้นทางและเส้นทางเครือข่ายที่ใช้ในที่นี้ ดังนั้นจึงไม่ใช่ความล่าช้าจากฝั่งผู้ให้บริการ.
รุ่นใดใช้โทเคนผลลัพธ์น้อยกว่า?
Sonnet 5.5 ใช้โทเคนผลลัพธ์ที่รายงานจากเส้นทางจำนวน 2,686 โทเคนในทั้งห้าภารกิจ ส่วน Opus 5.5 ใช้ 3,952 โทเคน การนับจำนวนโทเคนเพียงอย่างเดียวไม่สามารถพิสูจน์คุณภาพของคำตอบได้.
รุ่นไหนมีราคาถูกกว่าในรอบนี้?
เมื่อใช้อัตรา API มาตรฐานอย่างเป็นทางการและจำนวนข้อมูลเข้า/ออกที่ได้รับกลับมา คำขอ 5 ครั้งของ Sonnet 5.5 มีค่าประมาณ $0.02826 ส่วน Opus 5.5 มีค่าประมาณ $0.08184 การคำนวณนี้ไม่รวมค่าแคช เครดิตแพลตฟอร์ม ภาษี และค่าเพิ่ม.
Sonnet 5.5 สามารถเอาชนะ Opus 5.5 ในทุกการทดสอบประสิทธิภาพได้หรือไม่?
ตารางของ No. Anthropic เองถูกจัดเรียงตามผลการทดสอบประสิทธิภาพและระดับความยาก: Sonnet 5.5 มีคะแนนสูงกว่าใน Terminal-Bench 4.0 ส่วน Opus 5.5 มีคะแนนสูงกว่าใน FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld และ Chartography ผลลัพธ์เหล่านี้เป็นข้อมูลที่ผู้ให้บริการรายงานมา ไม่ใช่ผลการทดสอบซ้ำโดยอิสระ.
Sonnet 5.5 เป็น API ที่สามารถใช้แทนได้ทันทีหรือไม่?
ไม่ครับ คู่มือการย้ายระบบระบุว่า "thinking" ทำงานตามค่าเริ่มต้น การตั้งค่า "thinking: disabled" จะส่งผลให้เกิดข้อผิดพลาด 400 การบังคับเลือกเครื่องมือเป็น "any/tool" จะถูกปฏิเสธ และลูกค้าควรวิเคราะห์บล็อกเนื้อหาตามประเภท ให้ปรับงบประมาณโทเคนและวงจรการทำงานของเครื่องมือให้สอดคล้องกับค่าเริ่มต้นใหม่ก่อนที่จะเปลี่ยนระบบ.
นี่เป็นการทดสอบประสิทธิภาพในบริบทที่กว้างหรือไม่?
ไม่ครับ ข้อความที่แสดงในการสกัดข้อมูลประกอบด้วยข้อความสั้นๆ ระบบจะตรวจสอบความถูกต้องของข้อมูลและรูปแบบการจัดรูปแบบที่ถูกต้อง แต่ไม่วัดพฤติกรรมในบริเวณใกล้เคียงกับหน้าต่างบริบท 1 ล้านโทเคนที่บันทึกไว้.









