Muse Spark 1.3 — самая мощная на сегодняшний день версия Muse Spark от Meta: общедоступная модель xhigh набрала 61 балл по индексу искусственного интеллекта (Artificial Analysis Intelligence Index), поддерживает контекстное окно объемом 1 млн токенов и успешно выполнила все три задачи по программированию средней сложности в рамках нашего теста API на первый ответ. Важное замечание: в основной сравнительной таблице Meta используется версия «max reasoning», однако на момент подготовки данного обзора версия «max» все еще ожидала более широкого выпуска после проведения дополнительных испытаний на безопасность.

Обзор Muse Spark 1.3: краткий вывод
Наш вердикт
Muse Spark 1.3 стоит опробовать для агентов, занимающихся программированием, работы с длинными контекстами и автоматизации, где важна экономичность. Его публичный результат на уровне xhigh уже сопоставим с передовыми показателями, но не стоит ссылаться на максимальные результаты Meta, как будто каждый пользователь API может их воспроизвести уже сегодня.
2 сентября 2026 года компания Meta выпустила версию Muse Spark 1.3, что позволяет использовать его в рабочих процессах с участием агентов, ориентированных на долгосрочную перспективу, для получения более лаконичного кода и обеспечения более надёжного совместного работы. Это является продолжением перехода к ИИ-агенты, построенные на основе моделей использования инструментов. В Meta заявляют, что система задает уточняющие вопросы в случае неоднозначности требований, сигнализирует о затруднениях и запрашивает подтверждение перед выполнением важных действий. При внутреннем сравнении с версией 1.2 инженеры Meta зафиксировали сокращение количества вызовов инструментов примерно на 20% и количества токенов — на 25%. Это данные, предоставленные разработчиками, а не результаты нашего тестирования.
Что изменилось по сравнению с Muse Spark 1.2?
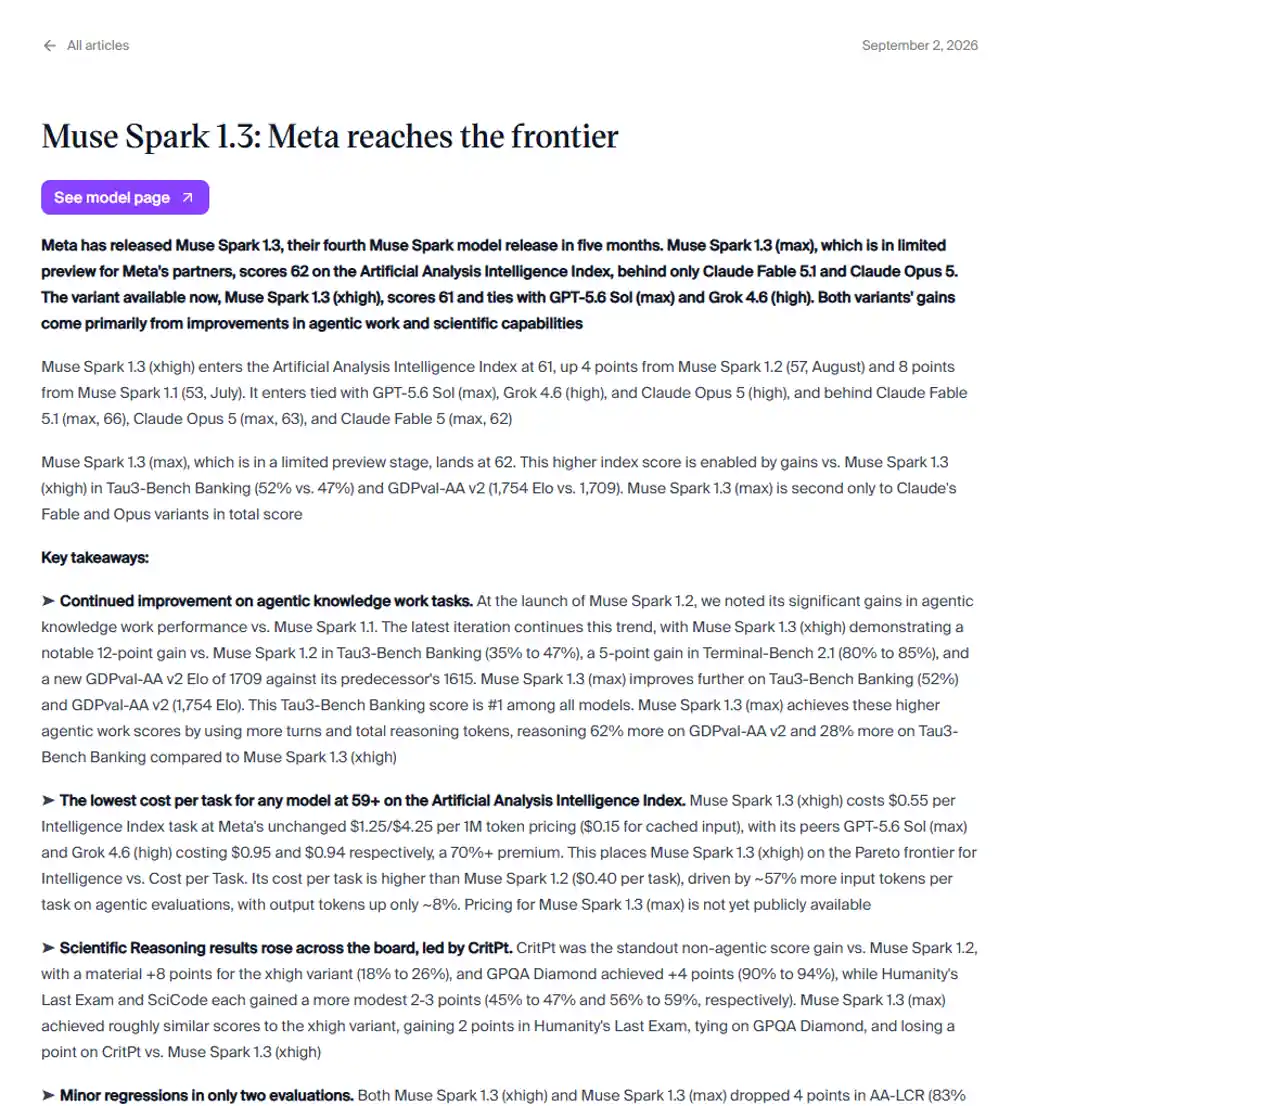
Анализ искусственного интеллекта: от 57 до 61 на xhigh.
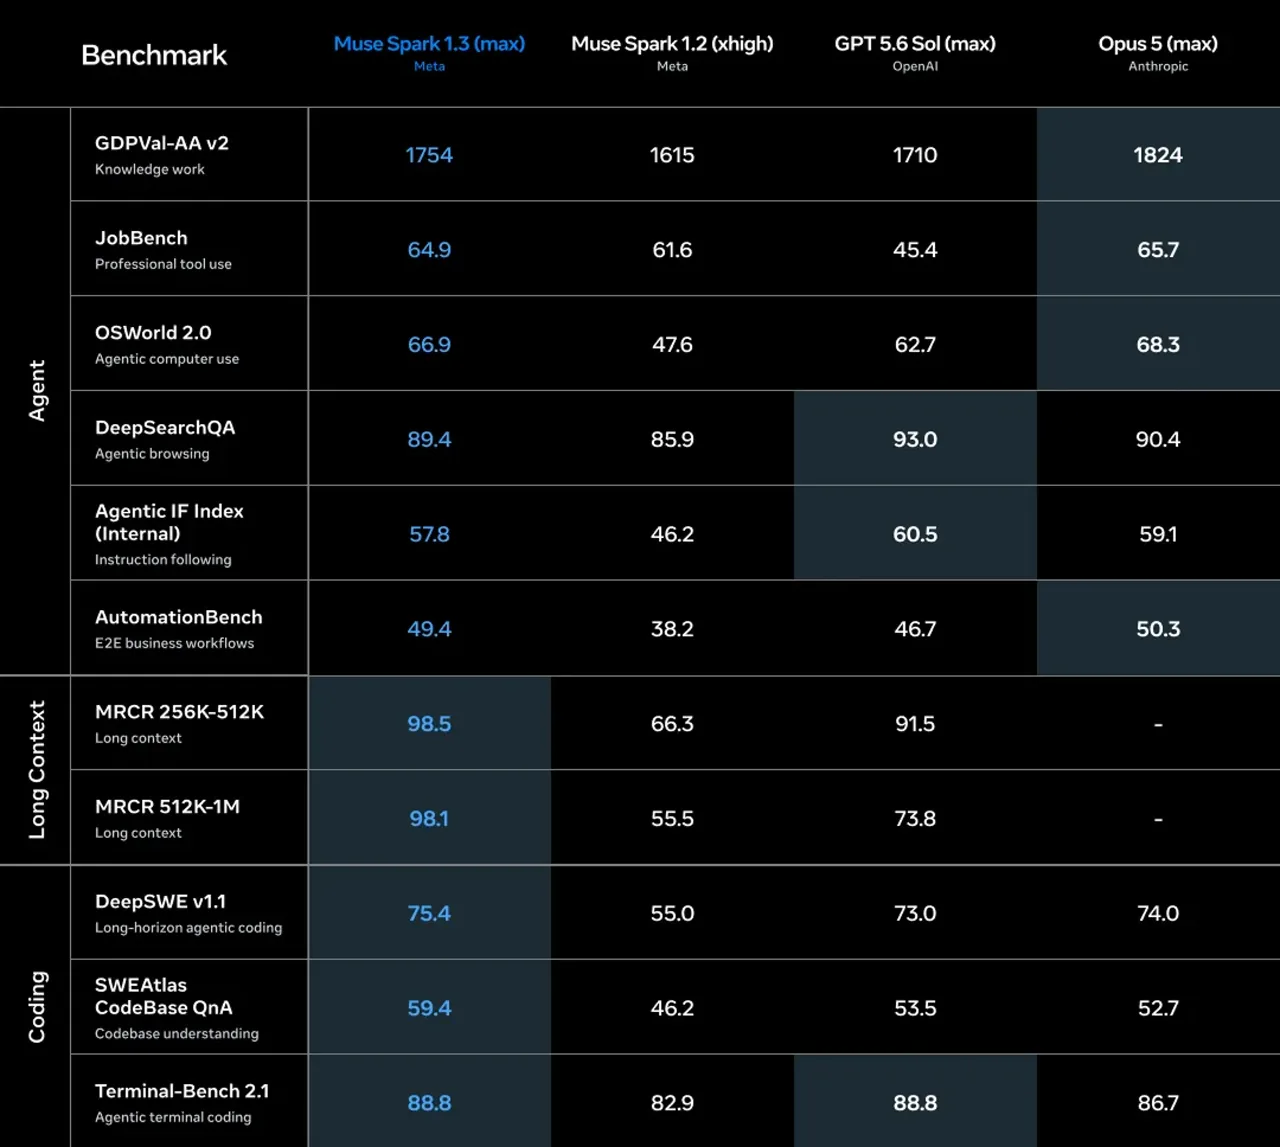
Meta сообщает результаты 75,4 против 55,0 на DeepSWE, но сравнивает максимальное значение 1,3 с xhigh равным 1,2.
Окно в 1 млн сохраняется; показатели MRCR в верхнем диапазоне резко растут на графике Meta.
Показатели токенов остаются неизменными, при этом показатель AA составил $0,55 против $0,40 на каждую оцениваемую задачу.
Тесты Muse Spark 1.3: настройки «Max» и «Xhigh» — это не одно и то же
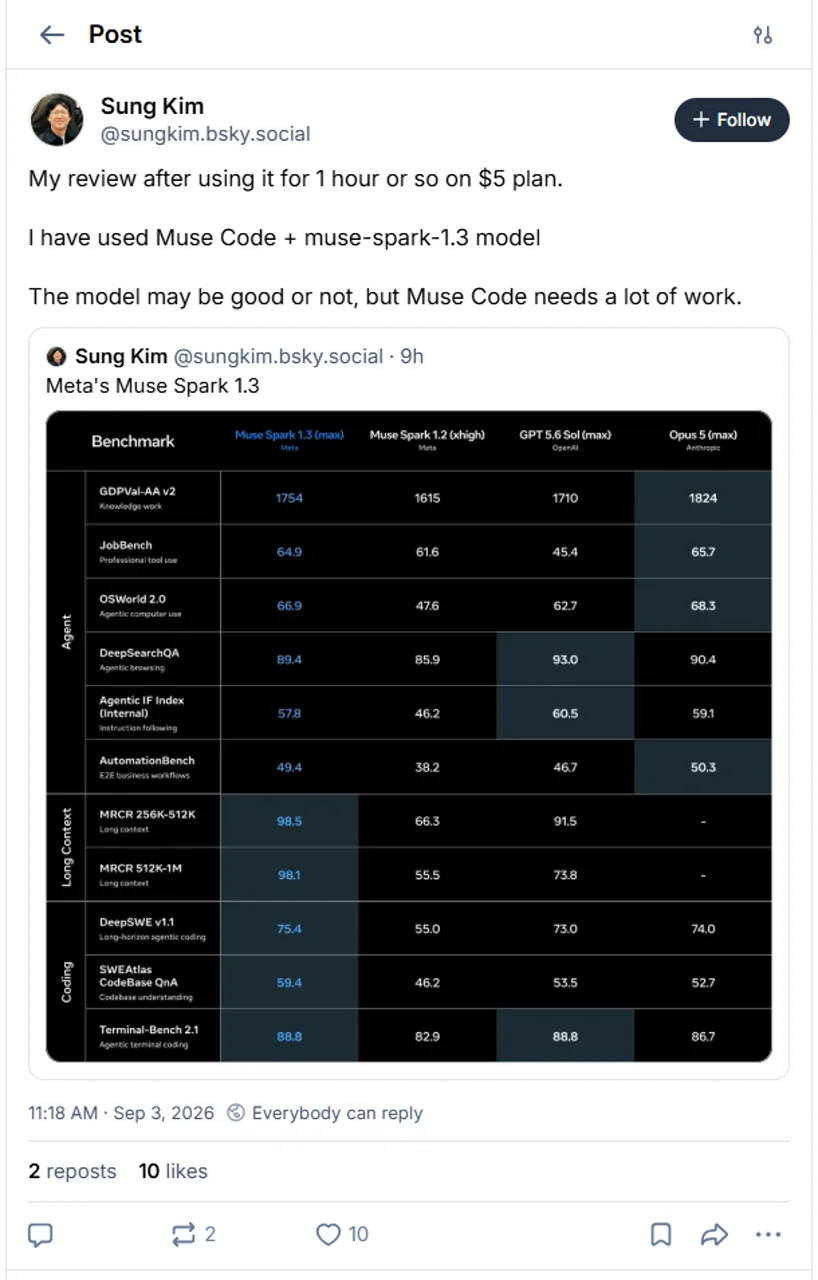
Официальный график Meta Впечатляет. Muse Spark 1.3 набрал максимальные результаты: 88,8 в Terminal-Bench 2.1, 75,4 в DeepSWE v1.1, 98,1 в MRCR 512K-1M и 66,9 в OSWorld 2.0. Он делит первое место с GPT-5.6 Sol по результатам теста Terminal-Bench и опережает указанных конкурентов в двух диапазонах MRCR с длинным контекстом. Разработчики, сравнивающие продукты на более широком рынке, могут воспользоваться нашим Обзор Coding-Agent в качестве дополнительной информации.
МЕТА-ОТЧЁТ, МАКСИМАЛЬНОЕ РАЗУМОВОДСТВО
| Эталон | не более 1,3 | 1,2 x высота | GPT-5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE версии 1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | Неприменимо |
Различные настройки нагрузки, комплекты ремней для агентов и версии OSWorld ограничивают возможность прямой сопоставимости. В Meta также описывается индекс Agentic IF как внутренний совокупный показатель.
Как читать график
В версиях 1.3, GPT-5.6 Sol и Opus 5 используется параметр max; в версии 1.2 — xhigh.
Имена агентов и фиксированные наборы параметров варьируются в зависимости от оценки.
В прогонах 1.3 и 1.2 используются разные версии среды.
Индекс Agentic IF — это совокупный показатель компании Meta, а не отдельный общедоступный бенчмарк.
«Искусственный анализ» обеспечивает более четкое представление из того, к чему пользователи имеют доступ в настоящее время. Muse Spark 1.3 xhigh набрала 61 балл, что выше 57 баллов версии 1.2. Её результат в Terminal-Bench составляет 85%, в GDPval-AA v2 — 1709 Elo, а в Tau3-Bench Banking — 47%. Максимальный вариант в ограниченной предварительной версии достигает 62 в общем зачёте. Есть и регрессии: AA-LCR падает с 83% до 79%, а точность AA-Omniscience снижается с 45% до 42% в режиме xhigh.
Цены на Muse Spark 1.3
Автор
muse-spark-1.3-автор
$0.10 вход / $0.002 кэшированный / $0.20 выход на миллион токенов.
Подсказки могут использоваться для улучшения продуктов Meta.
Стандарт
muse-spark-1.3
$1.25 — вход / $0.15 — кэш / $4.25 — выход на миллион токенов.
В компании Meta заявляют, что этот уровень не используется для улучшения её продуктов.
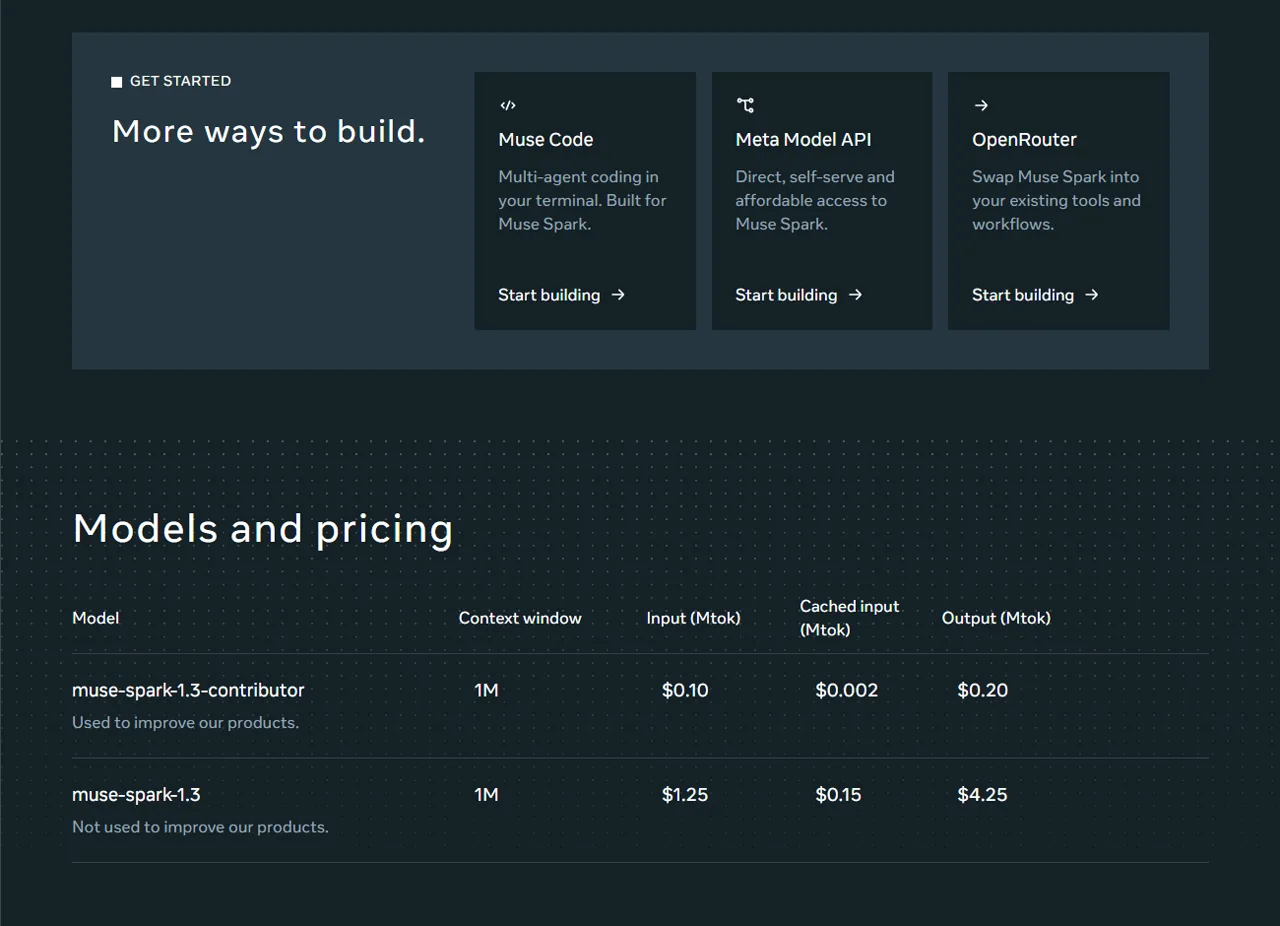
Сайт официальные цены на токены остались неизменными по сравнению с версией 1.2, но стоимость одной задачи изменилась. Наши Обзор универсальной платформы искусственного интеллекта объясняет, почему стоимость доступа и затраты на рабочий процесс следует оценивать отдельно. По данным Artificial Analysis, показатель $0,55 на одну задачу Intelligence Index для версии 1.3 xhigh по сравнению с $0,40 для версии 1.2 обусловлен главным образом примерно на 57% большим количеством входных токенов при оценках агентичности. Уровень «Contributor» исключительно дешёв, но его условие об использовании данных является реальным фактором при выборе продукта, а не просто сноской.
Доступ к API Muse Spark 1.3
Meta’s официальная кулинарная книга теперь использует muse-spark-1.3 в качестве значения по умолчанию и поддерживает контекстное окно размером 1 048 576 токенов. API совместим с SDK OpenAI. Muse Code и Meta Model API являются подтвержденными способами доступа на данный момент. На странице модели Meta также указан OpenRouter, хотя при нажатии на его кнопку по-прежнему открывается URL-адрес версии 1.2, поэтому перед развертыванием следует проверить путь доступа. Для получения дополнительной информации о взаимодействии агентов см. наше руководство по MCP и инструменты искусственного интеллекта.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "Проверьте этот патч на наличие регрессий."}],
)

print(response.choices[0].message.content)
Практические тесты по программированию: 3 из 3 сданы
Мы протестировали три задачи средней сложности, связанные с репозиторием, через API при температуре нуль, используя по одному ответу на каждую задачу. Каждый ответ должен был возвращать полные файлы в структурированном формате JSON. Затем мы поместили эти файлы в одноразовые каталоги и провели проверки как открытых, так и скрытых ресурсов. Это небольшие контролируемые тесты, которые не заменяют Terminal-Bench или испытания на производственном репозитории.
5 из 5 тестов; 18,4 с; 2 473 токена; $0.00905. Модель обнаружила набор неиспользуемых обработанных идентификаторов, добавила проверку на ранние дубликаты и написала регрессионный тест.
Пройдены проверка типов и две проверки во время выполнения; 47,6 с; 4 945 токенов; $0.01661. Проверка достоверности, сохранение данных и ведение журнала аудита были разделены без нарушения границ транзакции.
9 из 9 тестов; 20,3 с; 3 789 токенов; $0.01446. Все тесты на совместимость с CSV, ошибки с указанием номера строки, атомарный вывод, безопасность в режиме прогона, справку и документацию прошли успешно.
Всего: 11 207 токенов и $0.04013. Указанные значения времени отражают время обработки запроса от начала до конца, а не задержку собственного API Meta или TTFT.
Результат оказался лучше, чем можно было бы предположить, судя по простой оценке “3/3”: все три первых ответа поддавались проверке и учитывали ограничения. Такая же строгость в оценке доказательств важна при чтении нашей Обзор GPT-5. Тем не менее, данный пример не позволяет оценить надежность многократного вызова инструментов, навигацию по большим репозиториям или уровень оркестрации Muse Code. Читатели, рассматривающие бюджетные альтернативы, также могут найти нашу Сравнение моделей бюджетной кодификации полезно.
Первые отзывы разработчиков
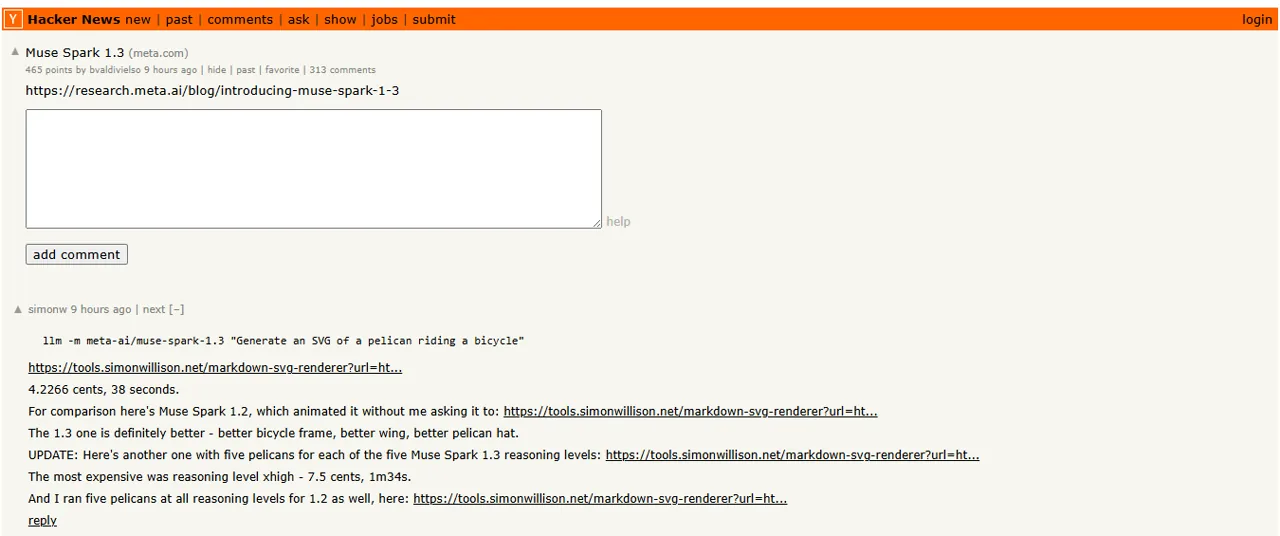
Первые отзывы носят неоднозначный характер и слишком единичны, чтобы говорить о консенсусе. В Тест на Hacker News, Саймон Уиллисон сообщил о прохождении трассы SVG за 38 секунд с результатом 4,2266 цента и оценил результат версии 1.3 как “несомненно лучший” по сравнению с версией 1.2. Dax рассказал об этом релизе в качестве напоминания о том, как сильно он скучал по стройным моделям. Сунг Ким, проведя примерно час с Muse Code, отметил, что модель, возможно, и хороша, но продукт Muse Code “требует значительной доработки”. Этот последний комментарий касается опыта взаимодействия с агентом, а не чистого тестирования самой модели.
Плюсы и минусы
Что сработало
- Высокий рейтинг среди пользователей xhigh
- Контекстное окно токена 1M
- API, совместимый с OpenAI
- Все три задачи по программированию были выполнены с первого раза
- Очень низкие ставки по токенам для участников с низким уровнем вклада
Что посмотреть
- Результаты с максимальным количеством просмотров в заголовках не являются стандартным публичным интерфейсом
- Стоимость независимых задач выросла по сравнению с показателем 1,2
- Проведена регрессионная анализ двух независимых показателей
- Данные участников могут способствовать улучшению продуктов Meta
- Первые отзывы о «Early Muse Code» неоднозначны
Кому рекомендуется использовать Muse Spark 1.3?
ИСПОЛЬЗУЙТЕ ЭТО ДЛЯ
Оценка кодирующих агентов, работа с репозиториями с обширным контекстом, автоматизация с использованием инструментов, а также эксперименты с учетом затрат, в которых политика обращения с данными является приемлемой.
ПРОПУСТИТЬ ИЛИ ПОДОЖДАТЬ, КОГДА
Вам требуется проверенная долгосрочная надежность производства, вам нужен максимальный объем уже сегодня, либо вы не готовы мириться с ограничениями на использование данных на уровне «contributor» и считаете стандартные цены неконкурентоспособными.
Итоги обзора Muse Spark 1.3
Muse Spark 1.3 заслуживает рекомендации к тестированию. Он сочетает в себе передовую производительность при выполнении общедоступных задач, высокие результаты при обработке длинных контекстов, удобный и привычный интерфейс API, а также привлекательную цену. Наши три тестовые задачи по кодированию подтверждают, что система способна соблюдать ограничения, связанные с несколькими файлами, и генерировать тестируемые исправления.
Для конфиденциального кода выберите стандартный уровень защиты. Еще одно сравнение с Frontier см. в GPT-5 против Claude 4. Рассматривайте максимальные результаты тестов как предварительные данные до тех пор, пока этот уровень рассуждений не станет широко доступным. И оценивайте Muse Code отдельно от API модели: пользовательский интерфейс агента, цикл работы инструментов и управление репозиторием могут работать успешно или давать сбои независимо от базовой модели.
Часто задаваемые вопросы по Muse Spark 1.3
Что такое Muse Spark 1.3?
Muse Spark 1.3 — это модель Meta для программирования и управления агентами, выпущенная 2 сентября 2026 года, с контекстным окном объемом 1 млн токенов и встроенными возможностями распознавания изображений, видео и документов.
Сколько стоит Muse Spark 1.3?
Стандартная модель стоит $1.25 за миллион входных токенов, $0.15 за кэшированные входные данные и $4.25 за выходные данные. Стоимость модели «контрибьютор» составляет $0,10, $0,002 и $0,20 соответственно, но её данные могут использоваться для улучшения продуктов Meta.
Доступна ли функция «Максимальное рассуждение»?
В компании Meta сообщили, что на момент запуска будут доступны существующие режимы рассуждений, а режим «max» появится после проведения дополнительных испытаний на безопасность. Прежде чем считать, что функция доступна для всех, ознакомьтесь с актуальной документацией по API.
Прошла ли Muse Spark 1.3 тесты на корректность кода?
Да. Первые результаты прошли все проверки исполняемых файлов в рамках наших тестов по исправлению ошибок в Python, рефакторингу TypeScript и тестов функциональности JSONL. Данный пример содержит лишь три контролируемых задачи и не отражает общий показатель надежности.
Версия Muse Spark 1.3 лучше, чем 1.2?
В основном, исходя из имеющихся данных. Уровень общего интеллекта xhigh вырос с 57 до 61, а Meta сообщает о значительном улучшении агентных способностей и работы с длинными контекстами, однако Artificial Analysis также выявила более высокую затратность задач и незначительные ухудшения в извлечении информации из длинных контекстов и калибровке фактов.
Какую модель использовать: «авторскую» или «стандартную»?
Используйте стандартные подсказки для конфиденциальной или закрытой информации, поскольку Meta заявляет, что эти данные не используются для улучшения её продуктов. Услуга «Contributor» обходится гораздо дешевле, но её подсказки могут использоваться для улучшения продуктов.