Сравнение моделей серии Claude: Haiku, Sonnet и Opus, а также место модели Fable в этой линейке
Ариетт Уинн
Последнее обновление: 09.09.2026
Практическое руководство 2026 года по выбору с учетом скорости, стоимости API, контекста, сложности задачи и стоимости неправильного ответа.
Для большинства повседневных задач, таких как написание текстов, анализ, программирование и работа с инструментами, начинайте с Claude Sonnet 5. Выбирайте Haiku 4.5, когда низкая задержка и высокая пропускная способность важнее, чем обработка сложных крайних случаев. Выбирайте Opus 5, если задача сложна, её трудно проверить или ошибка может дорого обойтись. Fable 5.1 стоит выше Opus как специализированный вариант для сложных случаев, а не как вариант по умолчанию.
Эти рекомендации относятся к типичным смешанным рабочим нагрузкам. В руководстве по эксплуатации Anthropic указано, что для большинства рабочих нагрузок следует начинать с Opus 5, в то время как в прилагаемой матрице задач модель Sonnet отдельно выделена для повседневных задач, требующих высокой скорости и производительности. Таким образом, выбор подходящей отправной точки зависит от вашей готовности к риску и процесса оценки, а не только от названия модели.
GlobalGPT расширяет рабочий процесс Практичное решение с одной доступной подпиской: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 и множество функций искусственного интеллекта объединены в единую панель управления для исследований, написания текстов, анализа, программирования и доработки. Её командная строка (CLI) также позволяет интегрировать доступ к этим моделям в ваш терминал, рабочий процесс разработки и существующие инструменты для производственной среды. Сравнение результатов — одна из полезных частей рабочего процесса; для более широкого выбора на уровне семейств моделей см. наш Сравнение моделей ChatGPT, Claude и Gemini. Остальная часть данного руководства посвящена выбору вариантов в рамках Claude.
Четыре существующих уровня позволяют решать разные экономические задачи. Самый дешевый вызов не всегда означает самую дешевую выполненную задачу, а самая мощная модель не всегда является оптимальным вариантом использования бюджета.
Руководство по выбору модели Claude
Выбирайте с учетом рабочей нагрузки и стоимости сбоев
Используйте Sonnet для сбалансированной повседневной работы, переходите на более низкий уровень для повышения эффективности и переходите на более высокий уровень, когда верификация затруднена или ошибки обходятся дорого.
Хайку 4.5
Эффективность превыше всего
Начните с этого варианта для задач с большим объемом данных, чувствительных к задержкам и имеющих четко очерченные границы, при которых обнаружение и исправление ошибок обходятся недорого.
Переходите на следующий уровень, когдаКрайние случаи или время, затрачиваемое рецензентами на исправления, нивелируют преимущество, связанное с ценой токена.
Сонет № 5
Ежедневный баланс
Используйте для заданий, сочетающих письменные работы, анализ, программирование, визуальное восприятие и работу с инструментами, которые по-прежнему подлежат обычной проверке.
Переходите на следующий уровень, когдаОграничивающим фактором становится прогнозирование на длительный срок, проверка или затраты, связанные с неудачей.
Опус № 5
В первую очередь — возможности
Начните с этого, если речь идет о сложном агентивном кодировании, работе на предприятии, сложной диагностике или решениях, ошибки в которых обходятся дорого.
Переместитесь вниз, когдаБолее дешевая модель неоднократно проходит одни и те же приемочные испытания.
Fable 5.1
Путь исключения
Переходите на более высокий уровень только в случае сложных рассуждений или длительной работы агента, если даже более ресурсоемкий вариант Opus по-прежнему не соответствует вашим критериям оценки.
Не делайте поспешных выводовБолее высокий уровень автоматически обходится дешевле с учётом качества, времени проверки и количества повторных попыток.
Практическое правило
Зафиксируйте одну типовую задачу и критерии её приемки. Выберите наименее затратную модель, которая стабильно проходит тестирование, а затем подсчитайте время на исправления и верификацию, прежде чем называть её самым экономичным вариантом.
Текущий модельный ряд Claude
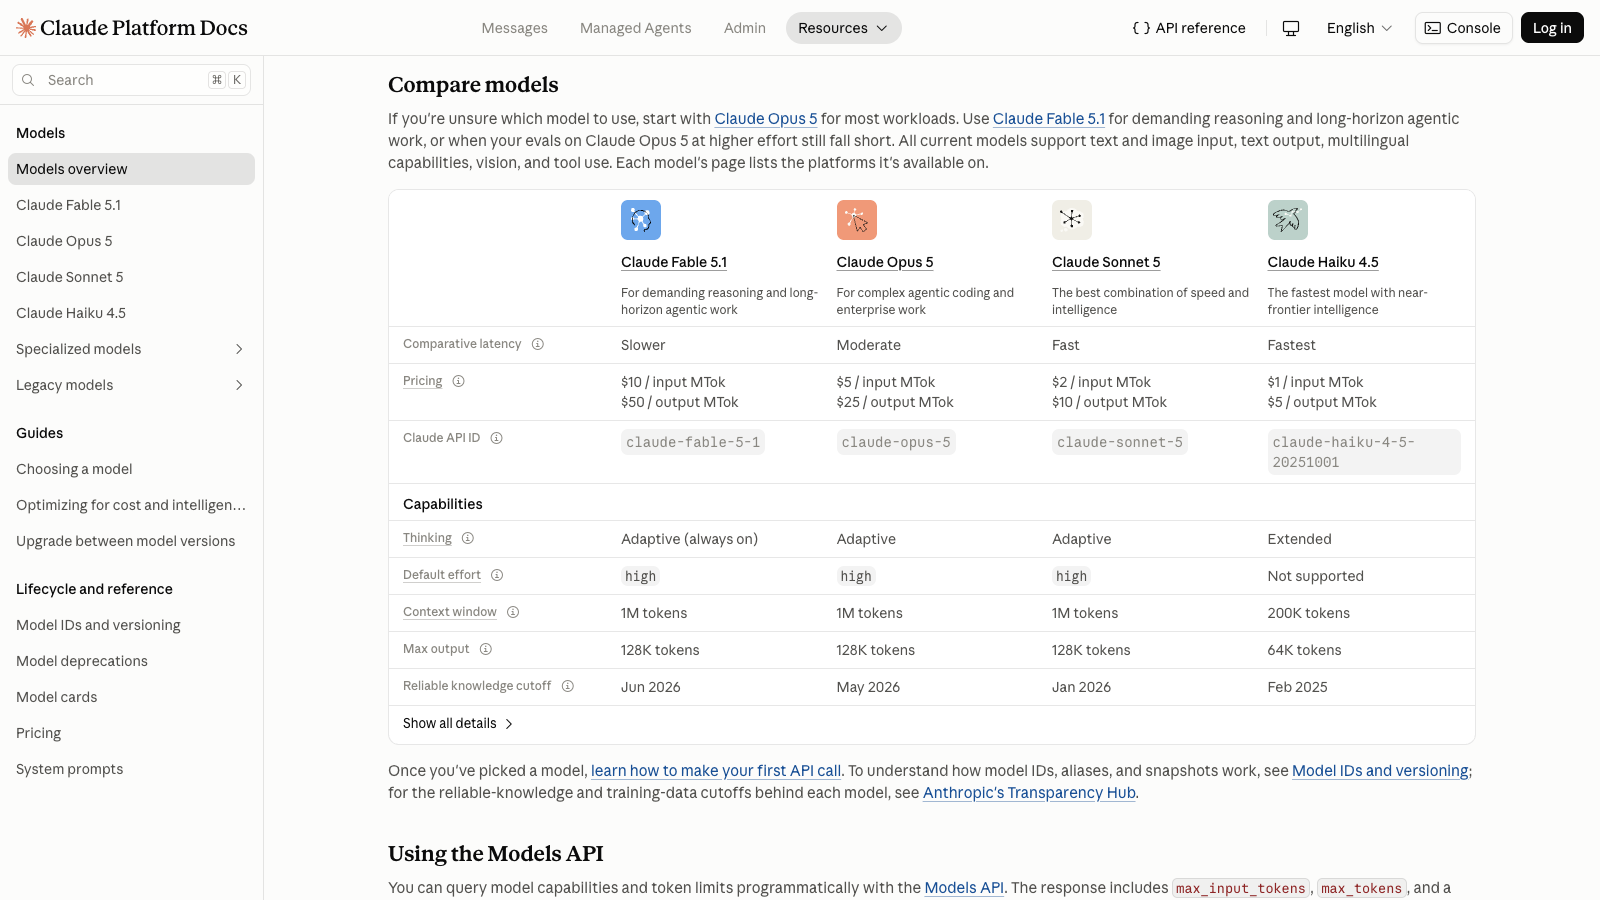
По состоянию на 8 сентября 2026 года в активную линейку Anthropic входят модели Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 и Claude Fable 5.1. Haiku, Sonnet и Opus — это постоянные названия семейств, но версии, относящиеся к каждому из них, со временем меняются. Укажите точный идентификатор модели, которую вы тестировали в производственной среде, вместо того чтобы предполагать, что название семейства всегда будет соотноситься с одним и тем же снэпшотом.
Текущая модель
Официальная маркировка скорости
Контекст API
Максимальная мощность
Входные и выходные данные базового API
Хайку 4.5
Самый быстрый
200 тысяч
64K
$1 / $5 на MTok
Сонет № 5
Быстрый
1M
128K
$2 / $10 на MTok
Опус № 5
Умеренный
1M
128K
$5 / $25 на MTok
Fable 5.1
Медленнее
1M
128K
$10 / $50 на MTok
В обзоре моделей Anthropic перечислены Haiku 4.5, Sonnet 5, Opus 5 и Fable 5.1 в качестве актуальной линейки по состоянию на 8 сентября 2026 года.
Доступ к Claude.ai — это не то же самое, что спецификации API
В таблице тарифных планов Claude.ai описаны условия доступа для потребителей; в настоящее время для отдельных тарифных планов указано контекстное окно объемом 200K. В документации по API приведены ограничения на контекст и объем вывода для конкретных моделей, в том числе контекст объемом 1M для моделей Sonnet 5, Opus 5 и Fable 5.1. Не следует использовать таблицу API для определения того, что включает в себя конкретный план Claude.ai, а также использовать таблицу потребительских планов для определения ограничений модели API. См. Руководство по тарифам и тарифным планам Claude для разграничения на уровне плана.
Claude Haiku, Sonnet и Opus: основные различия
Основной компромисс заключается не в простом ранжировании по качеству. Переход на более высокий уровень обеспечивает больше возможностей для выполнения сложных задач, но при этом увеличивает базовую стоимость токенов и, как правило, снижает скорость. Также различаются ограничения по контексту и параметры управления процессом рассуждений.
Практические компромиссы
Официальные обозначения и базовые спецификации API в сочетании с практическими рекомендациями по настройке для типичных рабочих нагрузок.
Размер
Хайку 4.5
Сонет № 5
Опус № 5
Лучшая отправная точка
Быстрая, повторяющаяся, ограниченная работа
Комплексная повседневная интеллектуальная работа
Сложная работа, имеющая серьезные последствия
Официальная маркировка скорости
Самый быстрый
Быстрый
Умеренный
Контекст API / Вывод
200K / 64K
1 М / 128 К
1 М / 128 К
Контроль логических выводов
Расширенное мышление с использованием руководства
Адаптивное мышление и усилия
Адаптивное мышление и усилия
Базовая цена API
Вход $1 / выход $5
Вход $2 / выход $10
Вход $5 / выход $25
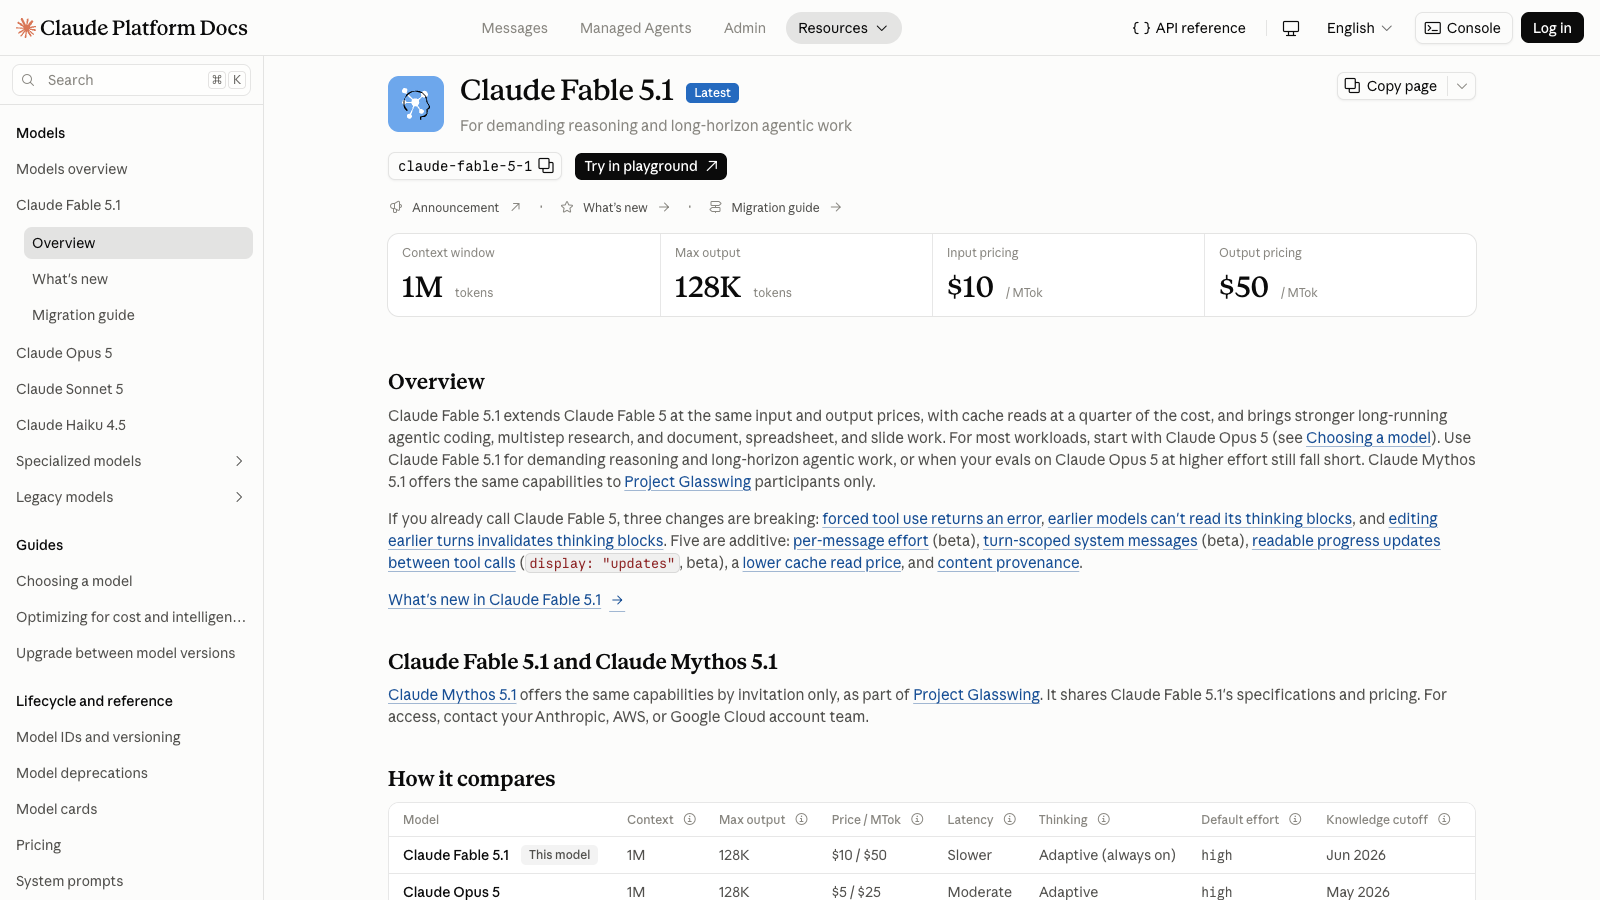
Где уместна игра «Fable»: Fable 5.1 официально обозначен как «Slower» (более медленный) с контекстом 1M, максимальной производительностью 128K и базовой стоимостью ввода-вывода $10 / $50 за миллион токенов. Рассматривайте его как следующий уровень, если вариант Opus с более высокими затратами по-прежнему не соответствует вашим требованиям.
Скорость и задержка
В таблице Anthropic версия Haiku 4.5 обозначена как “Самая быстрая”, Sonnet 5 — как “Быстрая”, Opus 5 — как “Средняя”, а Fable 5.1 — как “Медленная”. Это качественные обозначения продуктов, а не измеренные значения в миллисекундах или токенах в секунду. Фактическая задержка зависит от размера запроса, настроек вывода заключений, используемых инструментов, нагрузки и режима обслуживания.
Параметры контекста, вывода и логического вывода
Меньший контекст API Haiku (200K) и максимальный объем вывода (64K) по-прежнему являются достаточными для многих задач с ограниченными параметрами. Sonnet и Opus расширяют оба предела до 1 млн и 128 КБ соответственно. Haiku 4.5 использует ручное расширенное мышление, тогда как Sonnet 5 и Opus 5 поддерживают адаптивное мышление и управление затратами ресурсов. Это различие является одной из причин, по которой единая идентичная настройка логического вывода не позволяет создать абсолютно эквивалентные тесты для всех моделей.
Какую модель Claude следует использовать для каждой задачи?
Рабочая нагрузка
Начните с
Почему
Обновляйтесь, когда
Классификация, извлечение, маршрутизация, сортировка по степени тяжести
Хайку 4.5
Низкая задержка и низкая базовая стоимость токена подходят для четких, повторяемых задач.
Крайние случаи или время, необходимое для исправления ошибок, сводят сбережения на нет.
Важнее не самая низкая цена за один токен, а функциональные возможности.
Даже более сложная версия Opus по-прежнему не выдерживает строгой репрезентативной оценки.
Работы, отличающиеся исключительной продолжительностью или высокой степенью аналитичности
Fable 5.1
Это текущий маршрут эскалации выше уровня «Opus».
Используйте только в тех случаях, когда измеряемая выгода оправдывает более высокую стоимость.
Это лишь отправные точки, а не универсальные решения. Например, небольшое, но ответственное изменение кода может оправдать использование Opus, в то время как длительная, но четко структурированная задача по извлечению данных может по-прежнему подходить для Haiku. Примеры практических рабочих процессов см. в нашем руководстве по с использованием кодировки Claude.
Если ваш список кандидатов выходит за рамки Claude, GlobalGPT позволяет запустить один и тот же репрезентативный запрос на Claude, GPT-5.6 Sol, Gemini 3 Pro и Kimi K3 в одном рабочем пространстве. Обеспечьте постоянство проверки приемлемости: при повторяющейся работе важна скорость, а качество ответов и время корректировки определяют, действительно ли более дешевый результат обходится дешевле.
Выбирайте, ориентируясь на стоимость неудачи, а не только на тип задачи
Обозначения задач скрывают самую важную переменную: что происходит, если ответ неверный? Приведенная ниже схема представляет собой инструмент для принятия редакционных решений, основанный на рекомендациях Anthropic, в которых на первое место ставятся эффективность и возможности. Это не критерий оценки Anthropic.
Шкала затрат, связанных с отказом
Начинайте с более низкого уровня, когда выявление ошибок обходится недорого; начинайте с более высокого уровня, когда проверка неполная или дорогостоящая.
Эскалировать Когда время на исправления сводит на нет прирост эффективности
Материал
Примеры Черновые версии, предназначенные для клиентов; прошедший экспертизу анализ; протестированный рабочий код
Начало Сонет № 5
Эскалировать Когда тестирование не позволяет достоверно выявить важные сбои
Дорогой
Примеры Изменения, требующие высокой самостоятельности, сложная диагностика, ответственные решения
Начало Опус № 5
Эскалировать В «Fable» только после того, как «Opus» с более высоким уровнем сложности не проходит оценку «замороженного» состояния
Когда следует перейти на более новую или более старую версию модели Claude
Переходите на следующий уровень только при появлении заданного предела
От хайку к сонету
Проведите модернизацию, если количество пограничных случаев, пропусков инструкций или время, затрачиваемое рецензентами на исправления, превышает экономию.
Соннет «Опусу»
Переходите на более высокий уровень, когда ограничивающими факторами становятся длительность выполнения, сложность рассуждений, проверка или затраты в случае сбоя.
Opus при более интенсивной работе
Перед переходом на верхний уровень протестируйте ресурс в условиях интенсивной нагрузки с помощью предварительных приемочных испытаний.
От «Опуса» к «Сказке»
Переходите на более высокий уровень только в том случае, если даже более трудоемкий вариант Opus по-прежнему не проходит репрезентативную оценку, и при этом выгода оправдывает затраты.
Правило понижения рейтинга: Вернитесь к предыдущему уровню, если более дешевая модель неоднократно проходит те же приемочные испытания с требуемыми показателями задержки и надежности.
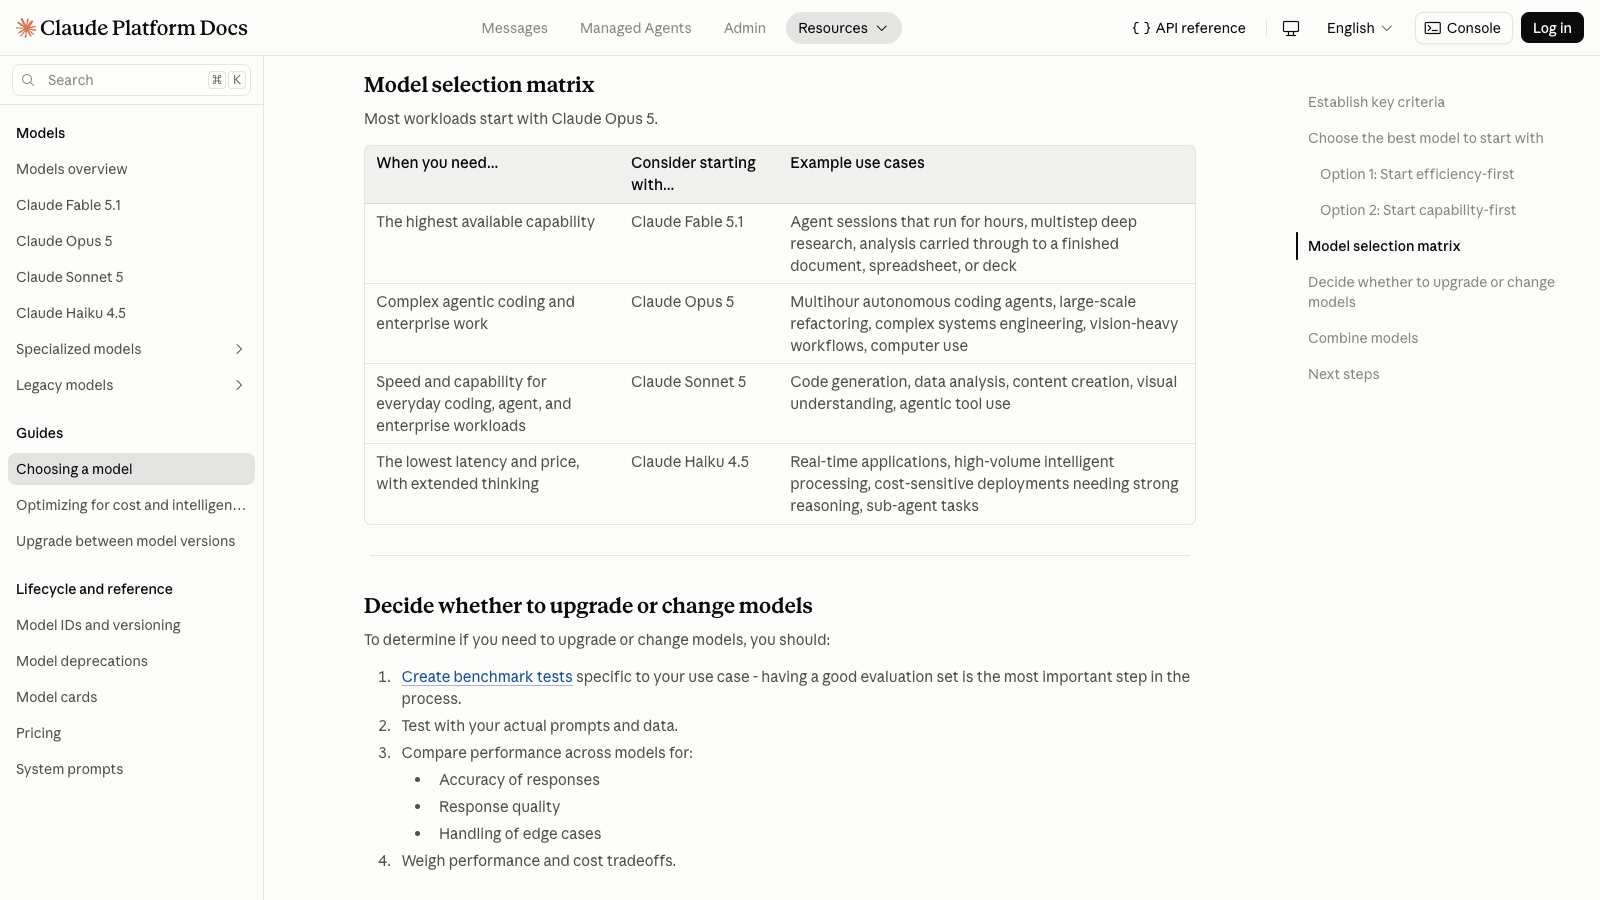
Матрица Anthropic соотносит четыре текущие модели Claude с различными требованиями к функциональным возможностям, скорости и рабочей нагрузке.
Пример фиксированной стоимости API Claude
При фиксированной совокупной нагрузке, составляющей 1 миллион входных токенов плюс 100 000 выходных токенов, распределенной по нескольким стандартным запросам API, базовая стоимость токена колеблется от $1,50 в Haiku 4.5 до $15,00 в Fable 5.1. Речь идет не об одном запросе, и это не отменяет ограничения на вывод данных для каждого отдельного запроса.
Одна рабочая нагрузка, четыре модели Claude
Объем того же токена стоит в 2, 5 или 10 раз больше общей суммы Haiku по мере перехода на более высокие уровни.
Рабочая нагрузка 1,0 млн на входе + 0,1 млн на выходе по нескольким запросам
Хайку 4.5
$1.50
Сонет № 5
$3.00
Опус № 5
$7.50
Fable 5.1
$15.00
Модель
Расчет входных данных
Расчет выходных данных
Всего
Хайку 4.5
1,0 × $1
0,1 × $5
$1.50
Сонет № 5
1,0 × $2
0,1 × $10
$3.00
Опус № 5
1,0 × $5
0,1 × $25
$7.50
Fable 5.1
1,0 × $10
0,1 × $50
$15.00
В комплект входит: Стандартные базовые ставки по токенам входа и выхода, рассчитанные на основе одного моментального снимка цены Anthropic.
Исключаются: Кэширование запросов, пакетный API, быстрый режим, географические настройки, комиссии за использование инструментов, налоги, скидки и кредиты GlobalGPT.
В таблице цен указана стоимость токенов, а не стоимость готового результата. Более дешевая модель может оказаться дороже, если повторные попытки, исправления и проверка займут у персонала больше времени, чем позволит сэкономить снижение стоимости токенов.
Практический тест модели Claude: одни и те же вводные данные, разные режимы отказа
9 сентября 2026 года мы отправили те же три запроса через API Anywhere в модели Claude Haiku 4.5, Sonnet 5, Opus 5 и Fable 5.1. Задачи включали структурированную сортировку запросов на поддержку, написание текстов на основе доказательств и отлажку кода JavaScript с возможностью аудита. Мы сохранили первый корректный вывод каждой модели и оценили его в соответствии с правилами, зафиксированными до начала проверки ответов.
В результате получился не просто рейтинг. Sonnet, Opus и Fable набрали по 26,5 баллов из 30, при этом их сильные и слабые стороны резко различались. Haiku возвращал HTTP-код 503 при обеих разрешённых попытках выполнения каждой задачи, поэтому качество его результатов в рамках данного теста остаётся неизвестным.
Конфигурация испытаний и общие результаты
Три фиксированных запроса, те же ограничения на количество токенов на уровне задачи, отсутствие инструментов и поиска, а также сохранение первого допустимого результата для каждой модели.
Место проведенияAPI «Anywhere»
Дата9 сентября 2026 года
ЗадачиСтруктурированная сортировка пациентов, заметка о запуске, отладка JavaScript
Правило повторной попыткиОшибка «Once for transport», «429/5xx», «empty content» или «malformed response»
Модель
Выполненные задачи
Общий показатель качества
Наиболее полезный сигнал
Клод Хайку 4.5
0/3
Без оценки
Все шесть разрешенных запросов завершились кодом 503; проверялась только доступность маршрута.
Клод, сонет № 5
3/3
26.5/30
Единственная модель, отвечающая всем требованиям, указанным в инструкции по запуску.
Claude Opus 5
3/3
26.5/30
Высокая глубина отладки; пропущено ограничение на длину записи.
Claude Fable 5.1
3/3
26.5/30
Чистые структурированные результаты; записка о запуске была обрезана после одного пустого ответа.
Структурированный вывод
Тест 1: Первичная сортировка заявок в службу поддержки
Результат задания: Fable 5.1, 10/10
Fable оказалась единственной моделью, которая вернула JSON-данные, готовые к непосредственному анализу, с правильными всеми шестью метками и действиями. Opus и Sonnet правильно определили метки, но добавили разделители Markdown; обе модели также усилили один из заданных сроков, а Sonnet преждевременно пообещала исправление или возмещение средств.
Модель
Статус
Счет
Задержка в любой точке
Зарегистрированные токены
Что произошло
Клод Хайку 4.5
Маршрут недоступен
Без оценки
Нет в наличии
Нет в наличии
Два ответа с кодом 503; показатель качества отсутствует.
Клод, сонет № 5
Вывод сохранен
7.5/10
10,39 с
1005
Правильные метки, но JSON в кавычках и вымышленный результат возврата/исправления.
Claude Opus 5
Вывод сохранен
8.5/10
11,87 с
1051
Правильные обозначения и решительные меры, но с ограниченным объемом JSON и более жестким сроком.
Claude Fable 5.1
Вывод сохранен
10/10
8,55 с
680
JSON, подходящий для прямого синтаксического анализа; все проверки «frozen» пройдено.
Полный тестовый входной сигнал
Вы управляете почтовым ящиком службы поддержки SaaS. Классифицируйте каждый из приведенных ниже тикетов. Верните JSON-объект, содержащий только одно поле верхнего уровня с именем tickets. Поле tickets должно представлять собой массив в исходном порядке, и каждый элемент должен содержать ровно следующие поля: ticket_id, category, urgency и action. Значение поля category должно быть одним из следующих: billing, access, bug, feature. Значение поля urgency должно быть одним из следующих: low, medium, high. Используйте только текст заявки; не придумывайте результаты применения политик или факты, касающиеся клиентов.

#481: С нас дважды списали плату за одно и то же годовое продление. Закрытие бухгалтерского учета запланировано на пятницу, и мне нужно, чтобы этот вопрос был расследован до этого.
#482: При сбросе пароля указано, что письмо отправлено, но я его не получил. Я проверил папку «Спам» и повторил попытку один раз.
#483: При экспорте в формат CSV все суммы в валюте округляются до целых долларов, тогда как на панели инструментов по-прежнему отображаются центы.
#484: Пожалуйста, добавьте тёмный режим в аналитическую панель управления.
#485: После того как сегодня утром изменился домен нашей компании, каждый сотрудник получает сообщение об отказе в доступе по SSO.
#486: Не могли бы вы прислать мне копию счёта за прошлый месяц?
Claude Haiku 4.5: полные операционные результаты
Результаты моделирования не были получены. Обе разрешенные попытки вызова API Anywhere завершились кодом HTTP 503, поэтому этот маршрут был помечен как недоступный и исключен из оценки качества.
Claude Sonnet 5: полная мощность
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "billing",
 "urgency": "high",
 "action": "Расследовать случай двойного списания платы за годовое продление и произвести корректировку/возврат средств до закрытия расчета заработной платы клиента в пятницу."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "Проверить адрес электронной почты учетной записи и возможность доставки писем, затем вручную инициировать или повторно отправить письмо для сброса пароля."
    },
    {
 "ticket_id": "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "Передать в отдел разработки для исправления округления при экспорте в CSV, чтобы значения валют соответствовали точности до центов, отображаемой на панели управления."
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "Зарегистрировать запрос на реализацию тёмного режима для аналитической панели инструментов и добавить его в список ожидающих реализации функций продукта."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "Немедленно проверить настройки SSO, связанные с измененным доменом компании, и восстановить доступ для всех затронутых сотрудников."
    },
    {
      "ticket_id": "#486",
 "category": "биллинг",
 "urgency": "low",
 "action": "Найти счёт за прошлый месяц и отправить его копию клиенту."
    }
  ]
}
```
Claude Opus 5: полная мощность
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "billing",
 "urgency": "high",
 "action": "Передать в отдел биллинга для проверки дублирующейся годовой платы за продление подписки и подтверждения решения до закрытия расчета заработной платы клиента в пятницу."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "Проверить журналы доставки электронной почты на наличие сообщения о сбросе пароля на этот адрес и, если оно не было доставлено, запустить проверенный процесс сброса пароля для пользователя."
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "Зарегистрировать ошибку, связанную с округлением валюты при экспорте в CSV, указав несоответствие значениям на панели инструментов, и запросить инструкции по воспроизведению ошибки или образец экспорта."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "Зарегистрировать как запрос на добавление функции темного режима для аналитической панели инструментов и подтвердить получение, не беря на себя обязательств по срокам."
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "Передайте на более высокий уровень как сбой SSO в масштабах всей организации, связанный со сменой домена; попросите отдел идентификации/аутентификации немедленно проверить конфигурацию домена SSO."
    },
    {
      "ticket_id": "486",
 "category": "billing",
 "urgency": "low",
 "action": "Отправить запрошенную копию счета за предыдущий месяц подтвержденному контактному лицу учетной записи."
    }
  ]
}
```
Claude Fable 5.1: полная мощность
{"tickets":[{"ticket_id":"481","category":"billing","urgency":"high","action":"Расследовать поступившее сообщение о двойном списании платы за годовое продление и ответить до крайнего срока выплаты заработной платы клиенту в пятницу."},{"ticket_id":"482","category":"access","urgency":"medium","action":"Проверить журналы доставки писем о сбросе пароля на адрес пользователя и повторно отправить письмо или предложить альтернативный способ сброса."},{"ticket_id":"483","category":"ошибка","urgency":"средняя","action":"Воспроизвести округление сумм в валюте до целых долларов при экспорте в CSV и передать проблему в инженерный отдел для исправления."},{"ticket_id":"484","category":"функция","urgency":"low","action":"Зарегистрировать запрос на реализацию темного режима для аналитической панели у команды по продукту и подтвердить получение."},{"ticket_id":"485","category":"access","urgency":"high","action":"Передать на рассмотрение команде разработчиков ошибки отказа в доступе по SSO, возникающие по всей компании после смены домена, и проверить настройки домена SSO."},{"ticket_id":"486","category":"billing","urgency":"low","action":"Найти и отправить клиенту копию счета за прошлый месяц."}]}
Политика «первого действительного вывода». Задержка измеряется в реальных часах при прохождении через Anywhere, а не как собственная задержка Anthropic. Данные о количестве токенов предоставляются провайдером; прямые затраты на API по данному маршруту не рассчитываются.
Соблюдение ограничений
Тест 2: Заметка о запуске, основанная на фактах
Результат задания: Sonnet 5, 10/10
Sonnet оказался единственной моделью, которая удовлетворила все заданные требования. Opus сгенерировал убедительное сообщение, но превысил ограничение по количеству слов и сделал вывод, что все, кто не ответил, являются зачисленными студентами. Первый ответ Fable был пустым; при повторной попытке система вернула заметно урезанное сообщение без рекомендаций или предостережений.
Модель
Статус
Счет
Задержка в любой точке
Зарегистрированные токены
Что произошло
Клод Хайку 4.5
Маршрут недоступен
Без оценки
Нет в наличии
Нет в наличии
Два ответа с кодом 503; показатель качества отсутствует.
Клод, сонет № 5
Вывод сохранен
10/10
9,94 с
796
Выполнены требования в отношении объёма текста, структуры, приведённых доказательств, рекомендаций и оговорок.
Claude Opus 5
Вывод сохранен
8/10
9,49 с
826
Хороший анализ, но по методу «замороженного подсчёта» не хватает 223 слов, а также есть одно необоснованное предположение.
Claude Fable 5.1
Вывод сохранен
6.5/10
19,27 с
1685
Первый ответ пустой; сохраненная попытка повтора была обрезана до рекомендации и предостережения.
Полный тестовый входной сигнал
Напишите внутреннюю записку о запуске продукта объемом 180–220 слов для директора по продукту, используя исключительно приведенные ниже факты. Включите в текст: тему письма, короткий вступительный абзац, ровно три пункта, рекомендацию и одно четко обозначенное предостережение. Не придумывайте решения по бюджету, процентные показатели, статистическую значимость или причинно-следственные связи.

Факты:
- В пилотном проекте приняли участие 120 студентов.
- По состоянию на 31 марта 96 студентов посетили как минимум три занятия.
- Средний балл по опросу составил 4,3 из 5 по результатам 71 респондента.
- В операционном листе программы указан бюджет в размере $18 000.
- В записке об утверждении финансирования указана сумма $20 000. В ней не указано, является ли разница результатом корректировки или ошибкой в учете.
- Участники не распределялись случайным образом, и исходные оценки не собирались.
- Решение касается того, запускать ли второй пилотный проект, а не того, вводить ли программу на постоянной основе.
Claude Haiku 4.5: полные операционные результаты
Результаты моделирования не были получены. Обе разрешенные попытки вызова API Anywhere завершились кодом HTTP 503, поэтому этот маршрут был помечен как недоступный и исключен из оценки качества.
Claude Sonnet 5: полная мощность
**Тема: Результаты пилотной программы — рекомендация о проведении второй пилотной программы**

Первая пилотная программа завершила первый контрольный период, и предварительные показатели вовлеченности и удовлетворённости выглядят обнадёживающе. Прежде чем принять решение о проведении второй пилотной программы, команде следует совместно проанализировать ряд данных и нерешённых вопросов.

- Из 120 зачисленных студентов 96 посетили не менее трёх занятий по состоянию на контрольный срок 31 марта.
- Опрос после занятий, в котором приняли участие 71 респондент, показал средний балл 4,3 из 5.
- Цифры бюджета в разных документах не совпадают: в отчете об операциях программы указана сумма $18 000, а в записке об утверждении финансирования — $20 000; неясно, является ли это результатом корректировки или ошибкой при вводе данных.

**Рекомендация:** Учитывая результаты посещаемости и опроса, мы рекомендуем провести второй пилотный проект для сбора более структурированных данных — в идеале с определённой контрольной группой и исходными показателями — прежде чем принимать решение о более широком внедрении. Этот второй пилотный проект также должен послужить возможностью урегулировать расхождения в бюджете с финансовым отделом до окончательного утверждения финансирования.

**Предостережение:** К этим результатам следует относиться с осторожностью. Участники не распределялись случайным образом, и исходные показатели не собирались, поэтому мы не можем связывать результаты опроса или динамику посещаемости непосредственно с самой программой. Речь идет о решении относительно масштаба второго пилотного проекта, а не о решении о постоянном внедрении.
Claude Opus 5: полная мощность
**Тема: Результаты пилотного проекта и рекомендации по второй пилотной группе**

Первый пилотный проект прошел промежуточную оценку по состоянию на 31 марта, и теперь у нас имеется достаточно информации для принятия решения о целесообразности проведения второго пилотного проекта. В данном сообщении обобщены наши наблюдения, рекомендации и основные ограничения при интерпретации результатов. На данном этапе решение о постоянном внедрении программы не рассматривается.

- **Набор участников и вовлеченность:** В программу записались 120 студентов. По состоянию на контрольный этап 31 марта 96 из них посетили как минимум три занятия.
- **Отзывы участников:** по результатам опроса после участия средняя оценка составила 4,3 из 5 по данным 71 респондента. Остальные зарегистрированные студенты не ответили, поэтому оценка отражает мнение только этой подгруппы.
- **Расхождение в бюджете:** в отчете об операциях программы указан бюджет в размере $18 000, тогда как в записке об утверждении финансирования указана сумма $20 000. В финансовой записке не указано, является ли эта разница результатом корректировки или ошибки в учете, и мы пока не определили, какая из цифр является определяющей.

**Рекомендация:** Приступить к планированию второго пилотного проекта при условии, что отдел финансов и отдел операционной деятельности программы согласуют две бюджетные цифры и подтвердят единую определяющую цифру до того, как мы утвердим расходы. В рамках второго пилотного проекта также следует собрать исходные оценки при наборе участников.

**ПРЕДОСТЕРЕЖЕНИЕ:** Участники не распределялись случайным образом, и исходные оценки не собирались. Поэтому данные об участии и результаты опроса описывают то, что делала и о чём сообщала данная группа; они не могут сказать нам, к каким результатам привела программа или как она будет работать с другой группой населения.
Claude Fable 5.1: полная мощность
**Тема:** Итоги промежуточного отчета по пилотному проекту и рекомендация относительно второго этапа пилотного проекта

Здравствуйте, [директор],

Ниже приводится краткая информация о ходе реализации пилотного проекта по состоянию на 31 марта, а также рекомендация относительно целесообразности перехода ко второму этапу пилотного проекта. Настоящее письмо касается исключительно решения о втором этапе пилотного проекта, а не его постоянного внедрения.

- **Набор и посещаемость:** Зарегистрировалось 120 студентов. По состоянию на контрольный этап 31 марта 96 из них посетили как минимум три занятия.
- **Отзывы участников:** По результатам опроса 71 респондент поставил среднюю оценку 4,3 из 5.
- **Данные о бюджете:** В отчёте о ходе реализации программы указан бюджет в размере $18 000, тогда как в приказе об утверждении финансирования указана сумма $20 000. В приказе об утверждении финансирования не указано, является ли эта разница результатом корректировки или ошибкой в учёте.

**
Политика «первого действительного вывода». Задержка измеряется в реальных часах при прохождении через Anywhere, а не как собственная задержка Anthropic. Данные о количестве токенов предоставляются провайдером; прямые затраты на API по данному маршруту не рассчитываются.
Правильность кода
Тест 3: Отлажка JavaScript с возможностью аудита
Результат задания: «Opus 5» и «Fable 5.1» набрали одинаковое количество баллов, 10 из 10
Все три доступные модели обнаружили дефекты и сгенерировали замены, которые прошли тестирование на восьми исполняемых тестовых случаях. Opus и Fable вернули корректный JSON и поделили первое место с результатом 10 из 10. Код Sonnet также прошел тестирование, однако окружающие его ограничительные теги Markdown нарушили требование о прямом JSON.
Модель
Статус
Счет
Задержка в любой точке
Зарегистрированные токены
Что произошло
Клод Хайку 4.5
Маршрут недоступен
Без оценки
Нет в наличии
Нет в наличии
Два ответа с кодом 503; показатель качества отсутствует.
Клод, сонет № 5
Вывод сохранен
9/10
13,17 с
1471
Замена прошла 8 из 8 тестов; в ограниченном выводе не был соблюден формат JSON.
Claude Opus 5
Вывод сохранен
10/10
20,17 с
1826
Действительный JSON, обнаружены оба дефекта, а также успешно выполнены 8 из 8 тестовых случаев.
Claude Fable 5.1
Вывод сохранен
10/10
15,89 с
1409
Допустимый JSON, лаконичная диагностика и 8 из 8 тестовых примеров выполнены успешно.
Полный тестовый входной сигнал
Продиагностируйте и исправьте эту функцию JavaScript. Верните JSON, содержащий ровно четыре поля: root_cause (строка), replacement (строка, содержащая полный код функции-замены), tests (массив строк с тестовыми примерами) и remaining_risk (строка). Не указывайте, что тесты были выполнены. Сделайте минимальное понятное исправление, удовлетворяющее условиям контракта.

Условия:
- `tasks` — массив функций без аргументов, возвращающих обещания.
- Возвращайте первое выполненное значение в порядке ввода, даже если это значение равно 0, false или пустой строке.
- Игнорируйте отклоненные задачи.
- Возвращайте `null`, если все задачи отклонены или массив пуст.

Текущий код:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: полные операционные результаты
Результаты моделирования не были получены. Обе разрешенные попытки вызова API Anywhere завершились кодом HTTP 503, поэтому этот маршрут был помечен как недоступный и исключен из оценки качества.
Claude Sonnet 5: полная мощность
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: полная мощность
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: полная мощность
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Политика «первого действительного вывода». Задержка измеряется в реальных часах при прохождении через Anywhere, а не как собственная задержка Anthropic. Данные о количестве токенов предоставляются провайдером; прямые затраты на API по данному маршруту не рассчитываются.
Эти результаты Anywhere демонстрируют, почему выбор модели должен зависеть от конкретной задачи, а не от позиции в рейтинге. В GlobalGPT вы можете применить тот же метод сравнения к своему собственному промпту при работе с Claude и другими ведущими моделями, а затем выбрать результат, который наилучшим образом соответствует вашим требованиям к качеству, скорости и объёму работы по проверке.
Как провести объективное сравнение
Зафиксируйте типовую задачу. Используйте те же самые намерения, исходные материалы, средства доступа и проверки соответствия целям.
Запишите первый допустимый результат вывода. Не следует незаметно предоставлять одной из моделей дополнительные попытки при первичном сравнении.
Не следует путать качество и доступность. Сбои аутентификации, пропускной способности и маршрутизации следует отражать в примечании о доступности, а не в показателе качества.
Оцените весь рабочий процесс. Учитывайте затраченное время, трудозатраты рецензента, время на исправление ошибок и восстановление невыполненных задач.
Выберите самую недорогую модель с проходной схемой. Проведите повторное тестирование при изменении подсказок, инструментов, версий моделей или затрат, связанных с отказами.
Где находит применение GlobalGPT
Модель Anthropic предназначена для выполнения сложных задач в тех случаях, когда даже более мощные системы оценки Opus 5 не справляются с ними.
Какие модели Claude выпускаются в настоящее время?
По состоянию на 8 сентября 2026 года в активный ассортимент Anthropic входят модели Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 и Claude Fable 5.1. Точные версии и идентификаторы моделей могут измениться, поэтому перед развертыванием рекомендуется еще раз проверить официальный обзор моделей.
В чём разница между Claude Haiku, Sonnet и Opus?
Haiku ориентирован на скорость и низкую базовую стоимость токенов, Sonnet обеспечивает баланс между скоростью и функциональными возможностями для повседневной работы, а Opus ориентирован на функциональные возможности для выполнения сложных задач или задач с серьезными последствиями. Правильный выбор зависит от вашей рабочей нагрузки и затрат на верификацию, а не от абсолютного рейтинга.
Какую модель Claude лучше всего использовать для большинства задач?
Для большинства повседневных задач — написания текстов, анализа, программирования, визуального восприятия и работы с инструментами — начинайте с Sonnet 5. Вместо этого используйте Opus 5, если последствия неудачи будут серьезными или работа требует более глубокого логического мышления и тщательной проверки.
Какая модель Claude лучше всего подходит для программирования?
Sonnet 5 — это практическая отправная точка для повседневного программирования с регулярными проверками и тестированием. Используйте Opus 5 для сложных диагностических задач, комплексного агентного программирования, выполнения задач с длительным горизонтом или изменений, ошибки при реализации которых обходятся дорого.
Какая модель Claude лучше всего подходит для печати?
Sonnet 5 — это оптимальная отправная точка для большинства задач по составлению и редактированию текстов. Haiku 4.5 подходит для обработки объёмных и чётко структурированных текстов, а Opus 5 стоит опробовать при работе со сложными синтетическими текстами или материалами, от которых зависит многое и которые трудно проверить.
Claude Sonnet лучше, чем Opus?
Не во всех случаях. Модель Sonnet 5 работает быстрее и обходится дешевле при базовых тарифах API, тогда как модель Anthropic позволяет Opus 5 выполнять более сложные задачи. Лучшая модель — это самый недорогой вариант, который надежно проходит ваши собственные приемочные испытания.
Claude Fable заменит Opus?
В документе № Anthropic позиция Fable 5.1 позиционируется как уровень эскалации для сложных логических выводов или длительных задач агента в тех случаях, когда даже более ресурсоемкий Opus 5 оказывается недостаточным, а не как универсальная замена Opus.
Имеют ли Claude.ai и API Claude одинаковое окно контекста?
Ограничения тарифного плана № Claude.ai и спецификации моделей API указаны отдельно. В таблице тарифных планов Anthropic в настоящее время указано контекстное окно размером 200K, тогда как в документации по API для тарифных планов Sonnet 5, Opus 5 и Fable 5.1 указано контекстное окно размером 1M.
Когда следует перейти с Haiku на Sonnet или Opus?
Переходите на более сложную модель, если неудачные приемочные проверки, сложные пограничные случаи, время на исправление, трудозатраты на верификацию или стоимость ошибки перевешивают преимущества более простой модели в виде скорости и стоимости токена. Возвращайтесь к более простой модели, если более дешевая модель неоднократно успешно проходит одни и те же зафиксированные проверки.
Сколько стоят услуги Claude Haiku, Sonnet и Opus при использовании API?
Согласно базовым ставкам Anthropic, подтвержденным 8 сентября 2026 года, Haiku 4.5 обходится в $1 на входе и $5 на выходе, Sonnet 5 — в $2 и $10, а Opus 5 — $5 и $25 за миллион токенов. См. Anthropic’s официальная страница с ценами чтобы ознакомиться с актуальными тарифами и дополнительными вариантами расчета стоимости.
Окончательный вердикт: начинайте с самой дешёвой модели, которая прошла тестирование
Для общего смешанного режима работы Sonnet 5 по-прежнему остается наиболее практичным вариантом по умолчанию, и это была единственная модель, которая в ходе нашего тестирования выдержала все ограничения, указанные в инструкциях по запуску. Opus 5 и Fable 5.1 достигли того же общего результата, что и Sonnet (26,5/30), за счет разных сильных сторон, тогда как Haiku 4.5 не удалось оценить, поскольку маршрут Anywhere возвращал код ошибки 503 при каждой разрешённой попытке. Рассматривайте эти результаты как свидетельство эффективности при выполнении рабочих нагрузок, а не как постоянный универсальный рейтинг.
Следующий шаг прост: выберите одну реальную задачу, определите, как должен выглядеть успешный результат, протестируйте каждую серьезную модель в сопоставимых условиях и включите время на исправление ошибок в итоговую стоимость. Победителем станет самая недорогая модель, которая надежно справляется с задачей, а не та, у которой самая низкая стоимость токена или самое громкое название.
GlobalGPT позволяет интегрировать этот метод в более широкий и доступный рабочий процесс с использованием ИИ. Используйте Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 и другие ведущие модели с множеством функций искусственного интеллекта в единой панели управления, а затем перенесите результаты работы в свой терминал, рабочий процесс разработки и существующие производственные инструменты через командную строку GlobalGPT. Сравнительное тестирование поможет вам сделать выбор; главным преимуществом является обеспечение связности всего рабочего процесса.
Узнайте, что означает ключевое слово «AI Motion Designer for After Effects GPT» и как GLBGPT использует Юки, видеоредактор, подсказки, эффекты, субтитры, аудио и сгенерированные клипы.
Узнайте, как создавать изображения для блога с помощью ИИ, используя актуальные источники, практические тесты, четкие ограничения и более безопасный путь от первой попытки до запуска в производство.
Узнайте о годовых тарифах с неограниченным доступом к видео с ИИ, включающих актуальные источники, практические тесты, четкие ограничения и более надежный путь от первых проб до запуска в производство.
Узнайте об альтернативах GPT Live 1 с использованием актуальных источников, практических тестов, четких ограничений и более надежного пути от первой пробной версии до запуска в производство.