
Обзор Claude Opus 5.5: цена, тесты производительности и тесты с реальными API
Claude Opus 5.5 сочетает в себе контекстное окно длиной 1 млн токенов со стоимостью API $4 / $20 за миллион токенов. В данном обзоре представлены опубликованные заявления Anthropic, независимые результаты тестирования, а также пять прямых запусков задач через интерфейс Messages API.
Результат измерения является конкретным. Три задачи дали чистые, пригодные для использования ответы; задача по программированию дала полезный ответ, но достигла первого ограничения в 1 024 токена; при выполнении задачи по написанию текста на китайском языке на тестируемом маршруте был получен искаженный текст. Данный пример демонстрирует конкретное поведение и ограничения маршрута, а не универсальный показатель успешности.
Краткий ответ
- Производительность: По результатам теста Anthropic, по большинству заданий наблюдались показатели уровня Fable 5.1, тогда как по результатам теста «Искусственный анализ» при максимальном усилии был зафиксирован показатель интеллекта 58. Более узкие данные теста METR, оценивающие навыки суждения, не продемонстрировали значительного улучшения по сравнению с результатами Fable 5.1.
- Цена: официальный курс API составляет $4 на миллион входных токенов и $20 на миллион выходных токенов. Стоимость операций чтения из кэша составляет $0,20 за миллион; стоимость операций записи в кэш за 5 минут составляет $5 за миллион.
- Практический результат: В записанных прогонах были успешно выполнены задачи по извлечению длинных текстов, строгому JSON и арифметическому выводу. Кодирование оказалось полезным, но было прервано при достижении начального предела. Результат по китайскому языку зафиксирован как проблема, связанная с маршрутом или кодировкой, а не как оценка языка на уровне модели.
- Предупреждение API: мышление нельзя отключить, при попытке принудительного использования инструмента возникает ошибка, блоки мышления привязаны к модели и диалогу, а более старые
компьютер_20251124Этот инструмент не поддерживается в API Claude и в Google Cloud.

Что говорится в официальной документации
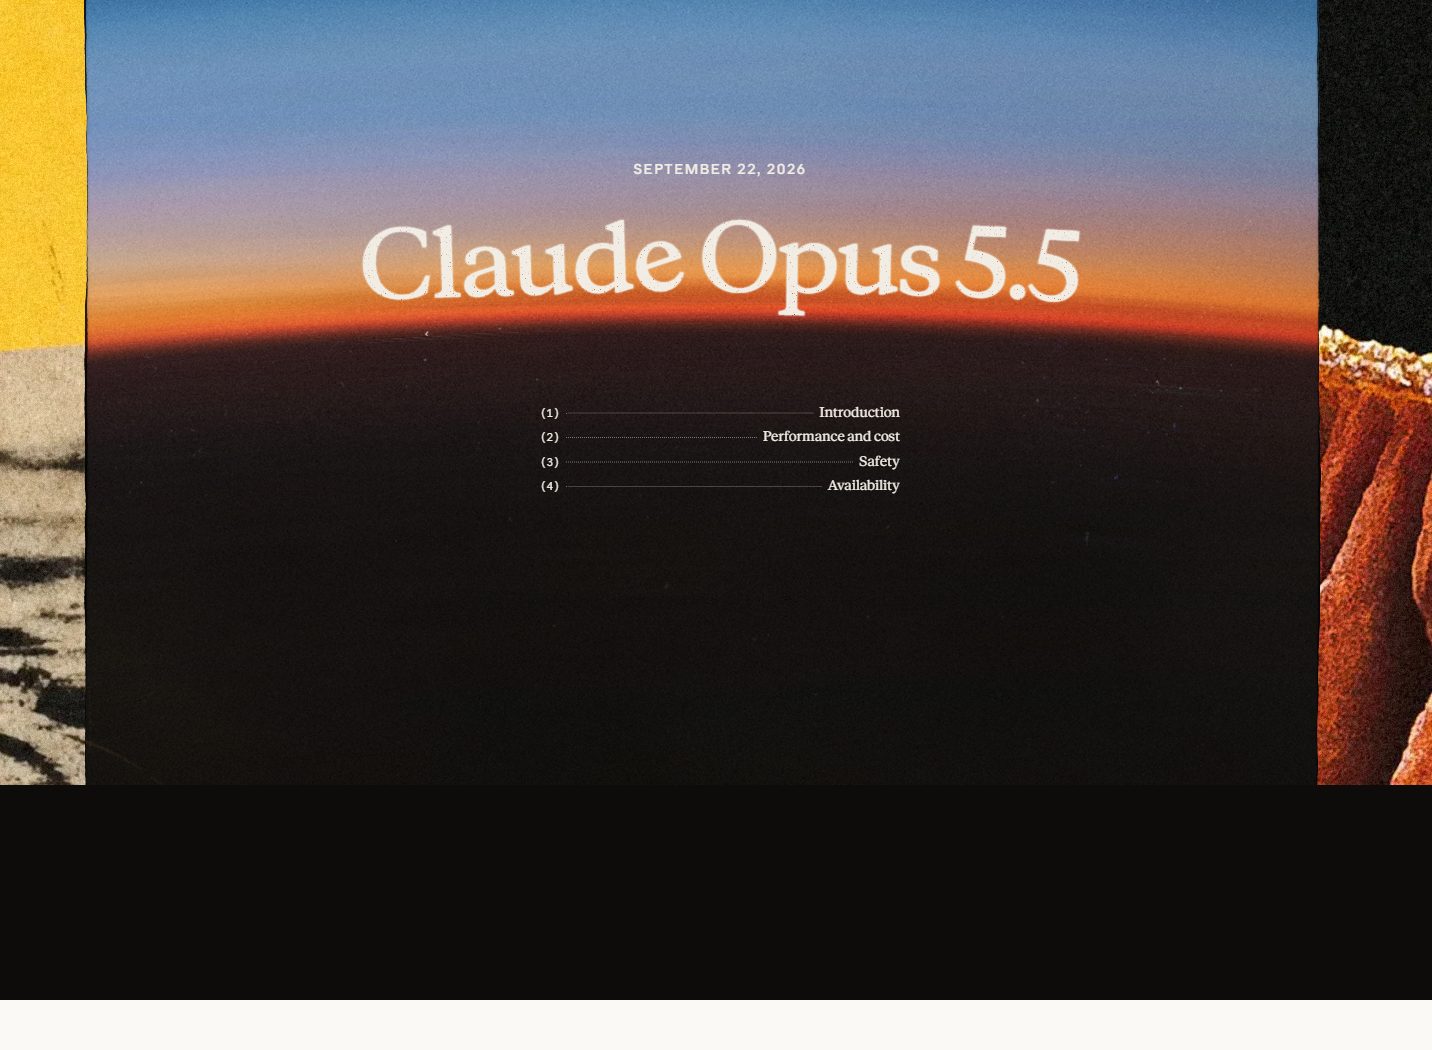
На странице, посвящённой выпуску Anthropic, дата выпуска Claude Opus 5.5 указана как 22 сентября 2026 года, и эта модель описывается как первая в семействе Claude 5.5. В анонсе утверждается, что при выполнении большинства задач производительность находится на уровне Claude Fable 5.1, типичная стоимость обработки нагрузки на 40% ниже, чем у Opus 5, а скорость вывода результатов превышает скорость Opus 5 более чем на 30%. Это заявления поставщика, поэтому они приводятся отдельно от независимых данных и результатов практических испытаний, представленных ниже.
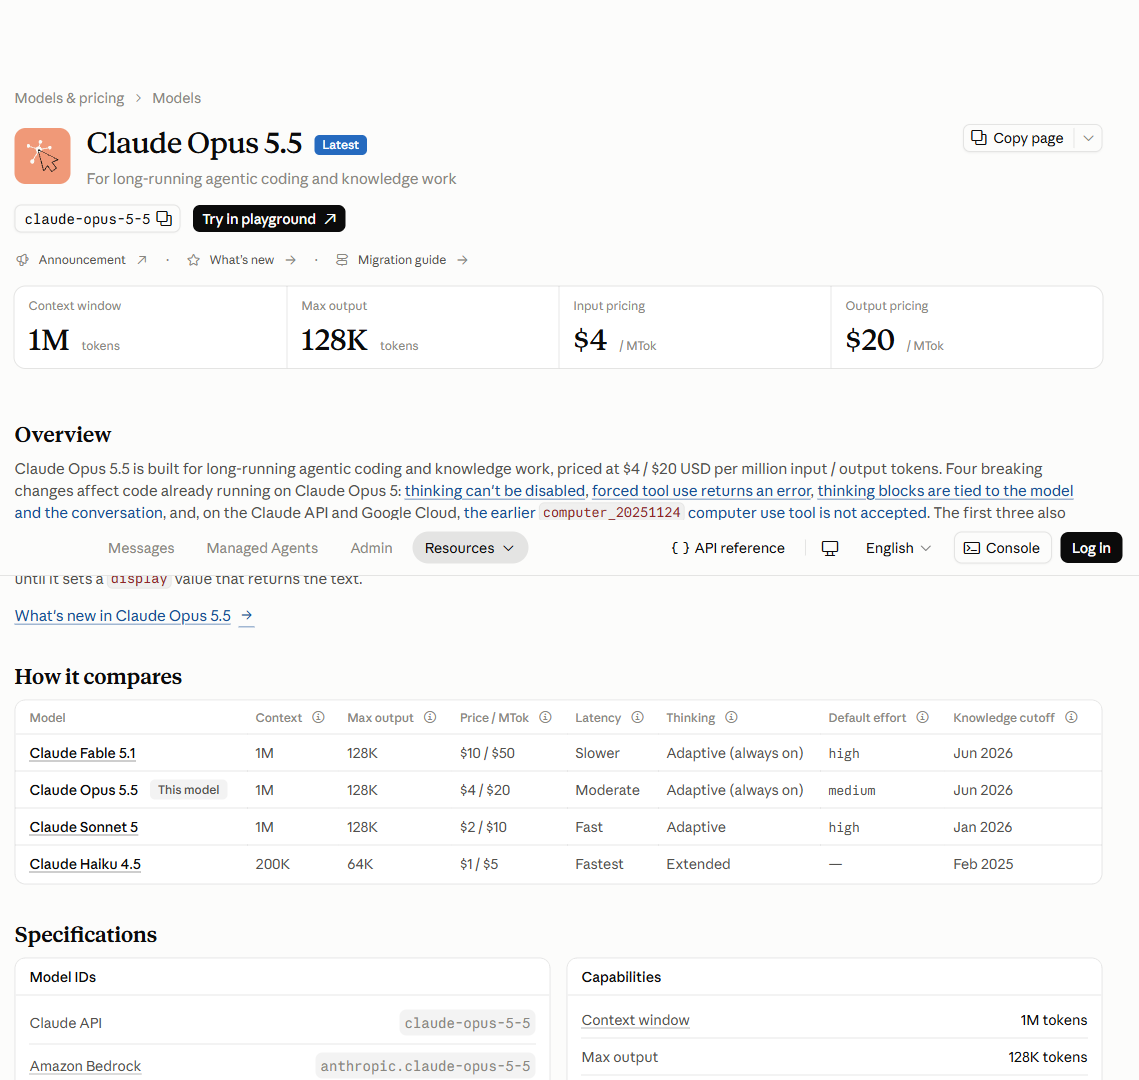
Сайт Документация по платформе Claude укажите идентификатор модели API в виде Клод, опус 5, № 5, контекстное окно объемом 1 млн токенов, максимальный объем вывода 128 тыс. и адаптивный режим работы, который всегда включен. В документации также перечислены изменения, затрагивающие существующие интеграции Opus 5; они рассмотрены в разделе «Миграция» ниже.
Данные о результативности
Здесь нет единого показателя “производительности”. Три открытых источника измеряют разные параметры, поэтому для каждой карты четко обозначены соответствующие метрики и границы достоверности данных.
Объявление о Anthropic
Опубликованный сигнал: Согласно данным Anthropic, Opus 5.5 демонстрирует производительность на уровне Claude Fable 5.1 при выполнении большинства задач, обходится на 40% дешевле, чем Opus 5, при типичных нагрузках и генерирует результаты более чем на 30% быстрее.
Граница: Приведенные данные о производительности и примеры тестов опубликованы поставщиком; это не является результатами независимого тестирования.
Искусственный анализ
Опубликованный сигнал: В отчете о результатах теста «max-effort» указаны следующие показатели: 59,61 TP40T в тесте Terminal-Bench 4.0, 61,41 TP40T в тесте «Humanity’s Last Exam» и 66,91 TP40T в тесте SciCode.
Граница: Результаты зависят от приложенных усилий, используемого инструментария, даты и определения метрики. Они не позволяют предсказать каждый запрос API.
Оценка METR перед развертыванием
Опубликованный сигнал: Компания METR заявляет, что полученные ею данные не свидетельствуют о значительном превосходстве над Fable 5.1 по исследуемым ею навыкам принятия решений, хотя при этом она по-прежнему ожидает существенного ускорения некоторых научно-исследовательских и опытно-конструкторских работ.
Граница: Это более узкая оценка оперативности принятия решений и выполнения задач, а не полный рейтинг качества.
В совокупности эти данные позволяют сделать ограниченный вывод: модель Opus 5.5 занимает лидирующие позиции по результатам ряда устаревших публичных оценок, однако степень её преимущества зависит от конкретной задачи, уровня затруднения и структуры оценки. Эти данные не позволяют определить универсальную “лучшую модель”.
Claude Opus 5.5: единицы цены и выставления счетов
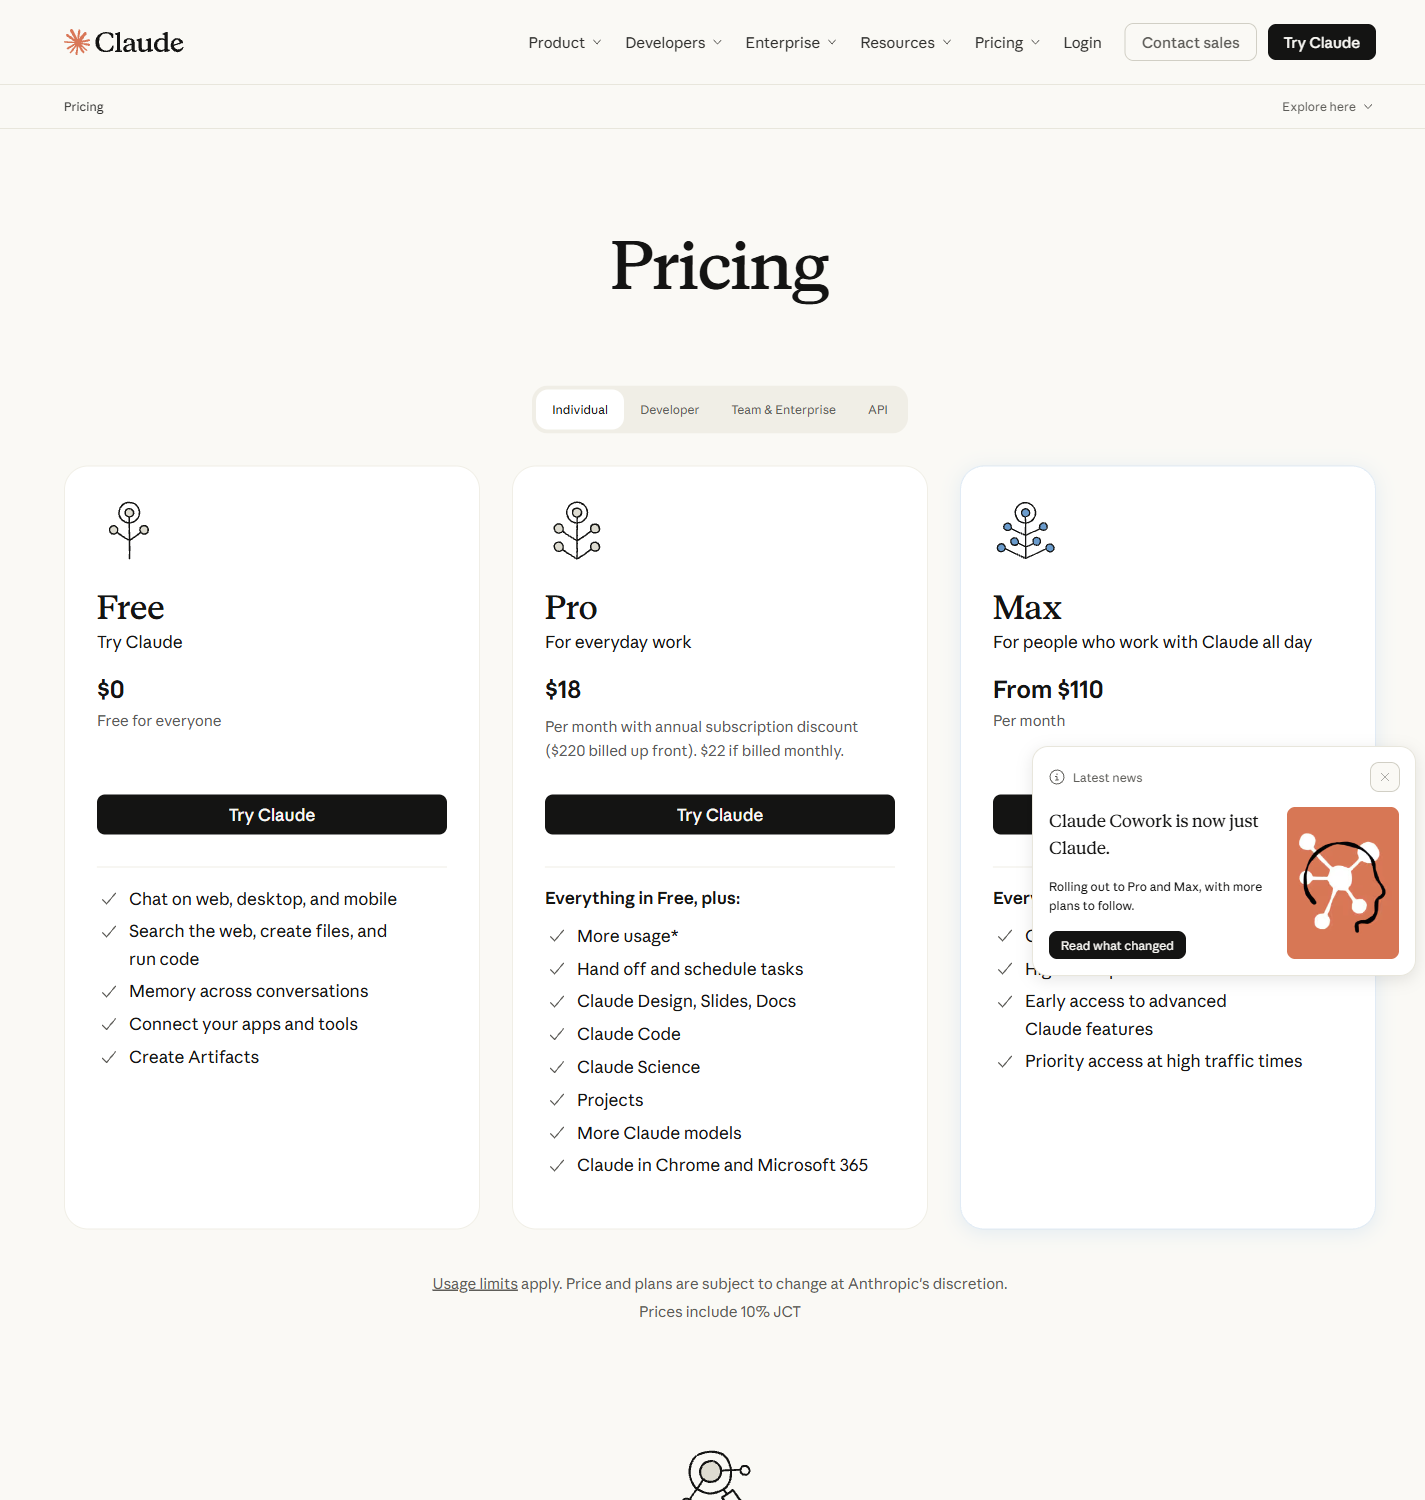
Цена API и цена подписки для потребителей — это разные продукты. Приведенные ниже данные по API представляют собой цены за единицу, используемые для планирования бюджета на токены; данные по потребителям — это карточки тарифных планов, отображаемые в выделенной области браузера.
Официальные цены на API
Простой расчет: 10 000 входных токенов плюс 2 000 выходных токенов — это примерно $0,08 по стандартным тарифам, без учета кэша, пакетной обработки, налогов и наценки платформы.
Скриншот тарифного плана для частных клиентов
На скриншоте также видна отметка «10% JCT». Это значения, отображаемые с учетом региональных особенностей, а не глобальное ценовое обязательство.
Отдельное объяснение принципов токенового биллинга и стоимости контекстного окна см. в Руководство по ценообразованию и контексту GPT-5.5. Расходы на API-интерфейс поставщика, стоимость подписки и остаток средств на счете платформы с поддержкой нескольких моделей должны учитываться в вашем бюджете отдельно.
Практическое тестирование: пять карточек с результатами выполнения заданий
23 сентября 2026 года мы отправили пять независимых запросов через один и тот же контролируемый маршрут API «Сообщения» с идентификатором модели Клод, опус 5, № 5. На первом этапе использовался max_tokens: 1024. Мы фиксировали локальное время выполнения, количество токенов ввода/вывода, причину остановки, правильность результата и соответствие формату литерала. Задача по написанию китайских иероглифов была повторена с ограничением в 4 096 токенов после того, как в ходе первого прогона была выявлена проблема с выводом маршрута. Это выборка из пяти задач, а не оценка надёжности.
Может ли он восстановить функцию дедупликации смешанного типа?
Настройка задачи
Найдите ошибку в коде на Python дедупликация функцию, обрабатывать значения, не являющиеся строками и не поддающиеся хешированию, сохранять первоначальное написание и предоставить тесты.
В ответе были указаны .lower() ошибка при работе со значениями, не являющимися строками, поэтому строки были заменены на casefold(), добавил резервный вариант, который нельзя преобразовать в хеш, и вернул исправленный код вместе с тестовыми примерами.
Ответ не прошел из-за ограничения в 1 024 токена. Исправление оказалось полезным, но объем конфигурации был слишком мал для полноценного анализа кода.
Вердикт по карте: Получен технически корректный ответ; данный прогон не позволяет подтвердить утверждение о задержке или полноте, поскольку ограничение на количество токенов привело к его обрезанию.
Может ли он сохранять факты и проверять ограничения?
Настройка задачи
Выделите пять пронумерованных выводов из краткой оценочной записки, включая описание метода и то, что не было оценено в ходе следующего раунда.
Было получено ровно пять пронумерованных пунктов. В отчете были сохранены сравнения с помощниками, метод с 20 подсказками, а также пробелы в области долгосрочного запоминания и конверсии клиентов.
Это был небольшой набор исходных данных, поэтому в нём не проверяется контекстное окно размером 1 Мб.
Вердикт по карте: чистая экстракция с заданным количеством и сохранением границ доказательств исходной заметки.
Может ли он выдать машиночитаемый результат без дополнительной обработки?
Настройка задачи
Верните фиксированный объект JSON, содержащий заголовок, целевую аудиторию, два плюса, два минуса и заключение. Использование ограждающих тегов Markdown не допускалось.
Был возвращён JSON, пригодный для синтаксического анализа, содержащий запрошенные ключи, два плюса, два минуса и лаконичную рекомендацию. Оболочка Markdown отсутствовала.
Один корректный ответ не доказывает надежность схемы при работе с более крупными или вложенными объектами.
Вердикт по карте: В ходе данного запуска проверка на точное соответствие стандарту JSON прошла успешно.
Может ли он правильно применять правило повторного округления?
Настройка задачи
Начните с 12 единиц, умножайте каждую следующую партию на 1,25, после каждой партии округляйте в меньшую сторону и укажите итоговое количество по четырём партиям.
Получены значения 12, 15, 18 и 22, после чего их суммировали, чтобы получить 67. Были видны промежуточные арифметические вычисления.
Задача носит детерминированный характер и является несложной; она не отражает способности к широкому мышлению.
Вердикт по карте: правильный результат и наглядные промежуточные шаги.
Вернул ли протестированный маршрут пригодный для использования текст на китайском языке?
Настройка задачи
Составьте вступительную часть обзора по китайскому продукту, в которой будут четко разграничены официальные заявления производителя, цена, данные сравнительных тестов и результаты практических испытаний.
Структура ответа присутствовала, но в сохраненном результате китайские иероглифы, полученные по тестируемому маршруту, отображались искаженно.
Данные не позволяют отделить качество языка модели от поведения по маршруту или кодирования. Оценка качества китайского языка не присваивается.
Вердикт по карте: На этом маршруте возвращается непригодный для использования текст; перед тем как делать выводы о качестве языковой локализации, запустите тест с проверенным путем в формате UTF-8.
По результатам четырёх тестовых прогонов (с нейтральным языком или на английском языке) среднее значение по локальной сети составило 6,24 секунды. Это значение отражает пять последовательных запросов по одному маршруту и не является задержкой на стороне провайдера. Наиболее выраженными наблюдаемыми характеристиками были лаконичность извлечения данных, точное соответствие стандарту JSON и корректность арифметических вычислений; двумя нерешенными проблемами стали ограничения по объему вывода, влияющие на кодирование, и искажённый вывод на китайском языке на тестируемом маршруте.
Особенности API и миграции
В кратком ответе упоминаются именно эти факторы, поскольку они могут повлиять на результаты интеграции даже в тех случаях, когда качество текста модели выглядит хорошим.
- Мышление никогда не прекращается. Используйте параметр «документированные затраты» для управления глубиной, задержкой и стоимостью; переключателя «выключить» нет.
- Принудительное использование инструмента приводит к появлению ошибки. Существующий код, в котором предусмотрен принудительный выбор инструмента, требует проведения отдельного теста на совместимость.
- Мыслительные блоки неразрывно связаны с моделированием и общением. Не следует полагать, что блок «thinking» можно повторно использовать после смены модели.
компьютер_20251124не принимается по API Claude и маршруту Google Cloud, указанному в документации.- Предельные значения объёма производства имеют значение. На карте кодирования показано, что даже небольшой сигнал может прервать полезный ответ
max_tokensзначение. - Пакетный и быстрый режимы представляют собой отдельные пути выставления счетов. Указывайте их скидки или надбавки отдельно от стандартных цен на токены.
Вердикт, основанный на доказательствах
Claude Opus 5.5 обладает убедительными данными публичных тестов, а его опубликованная стандартная скорость API ниже, чем показатели Opus 5, указанные в анонсе Anthropic. В пяти зафиксированных прогонах задач система обеспечила чистую экстракцию данных, строгий формат JSON и арифметические вычисления; ответ в виде кода был полезным, но был усечён из-за установленного начального ограничения; а китайский вывод оказался непригодным для использования в рамках тестируемого сценария.
Таким образом, обоснованный вывод носит ограниченный характер: модель продемонстрировала высокую степень следования инструкциям при выполнении нескольких небольших задач, в то время как маршрут и конфигурация наложили заметные ограничения. При принятии любого решения о миграции следует повторить те же самые запросы с учетом соответствующего бюджета на вывод данных, проверить вызовы инструментов и отдельно учитывать официальные тарифы на токены от кредитов по подписке или платформы.
Если вам нужен второй маршрут для сравнения, то Сравнение форматов тестирования DeepSeek V4 Pro и Flash показывает, как выводы на уровне задач могут оставаться отдельными от утверждений, касающихся всей модели. Это Руководство по сценариям использования GPT-5.5 добавляет ориентированную на задачу точку отсчёта, в то время как Примечания по тесту производительности Flash Gemini и Руководство по сравнению моделей искусственного интеллекта предоставить контекст ближайшей модели. Информацию о доступе к нескольким моделям см. в комплексные подписки на ИИ и сравнение мультимодельных платформ.
Часто задаваемые вопросы
Сколько стоит модель Claude Opus 5.5?
Официальная ставка API составляет $4 на миллион входных токенов и $20 на миллион выходных токенов. Стоимость чтения из кэша составляет $0.20 на миллион токенов, а стоимость записи в кэш с 5-минутным интервалом — $5 на миллион токенов.
Что такое контекстное окно Claude Opus 5.5?
В документации по платформе Claude указано, что размер контекстного окна составляет 1 миллион токенов, а максимальный объем выходных данных — 128 тысяч токенов. Отдельный задокументированный бета-вариант поддерживает объем выходных данных до 300 тысяч токенов для пакетных запросов.
Является ли Claude Opus 5.5 лучшей моделью, чем Opus 5?
Anthropic демонстрирует более низкую типичную стоимость обработки задачи и более высокую скорость вывода результатов, в то время как независимые оценки показывают высокие результаты при решении ряда устаревших задач. Степень повышения качества зависит от теста, настроек трудоемкости, подсказки и алгоритма.
Можно ли «выключить» мышление?
Нет. В текущей документации по модели указано, что адаптивное мышление всегда включено. Для управления глубиной мышления, задержкой и затратами используйте параметр «effort».
Доказали ли пять задач API свою надёжность?
Нет. На карточках показаны конкретные примеры поведения и ограничения конфигурации, но на основе пяти задач невозможно оценить общий показатель успешности. Проблема «потолка кодирования» и проблема «китайского маршрута» рассматриваются отдельно.
Подтвердил ли этот обзор качество китайской продукции?
Нет. Проверенный маршрут вернул искажённый китайский текст, поэтому результат зафиксирован как проблема с кодировкой или маршрутом до тех пор, пока не будет выполнено повторное тестирование с подтверждённой кодировкой UTF-8.









