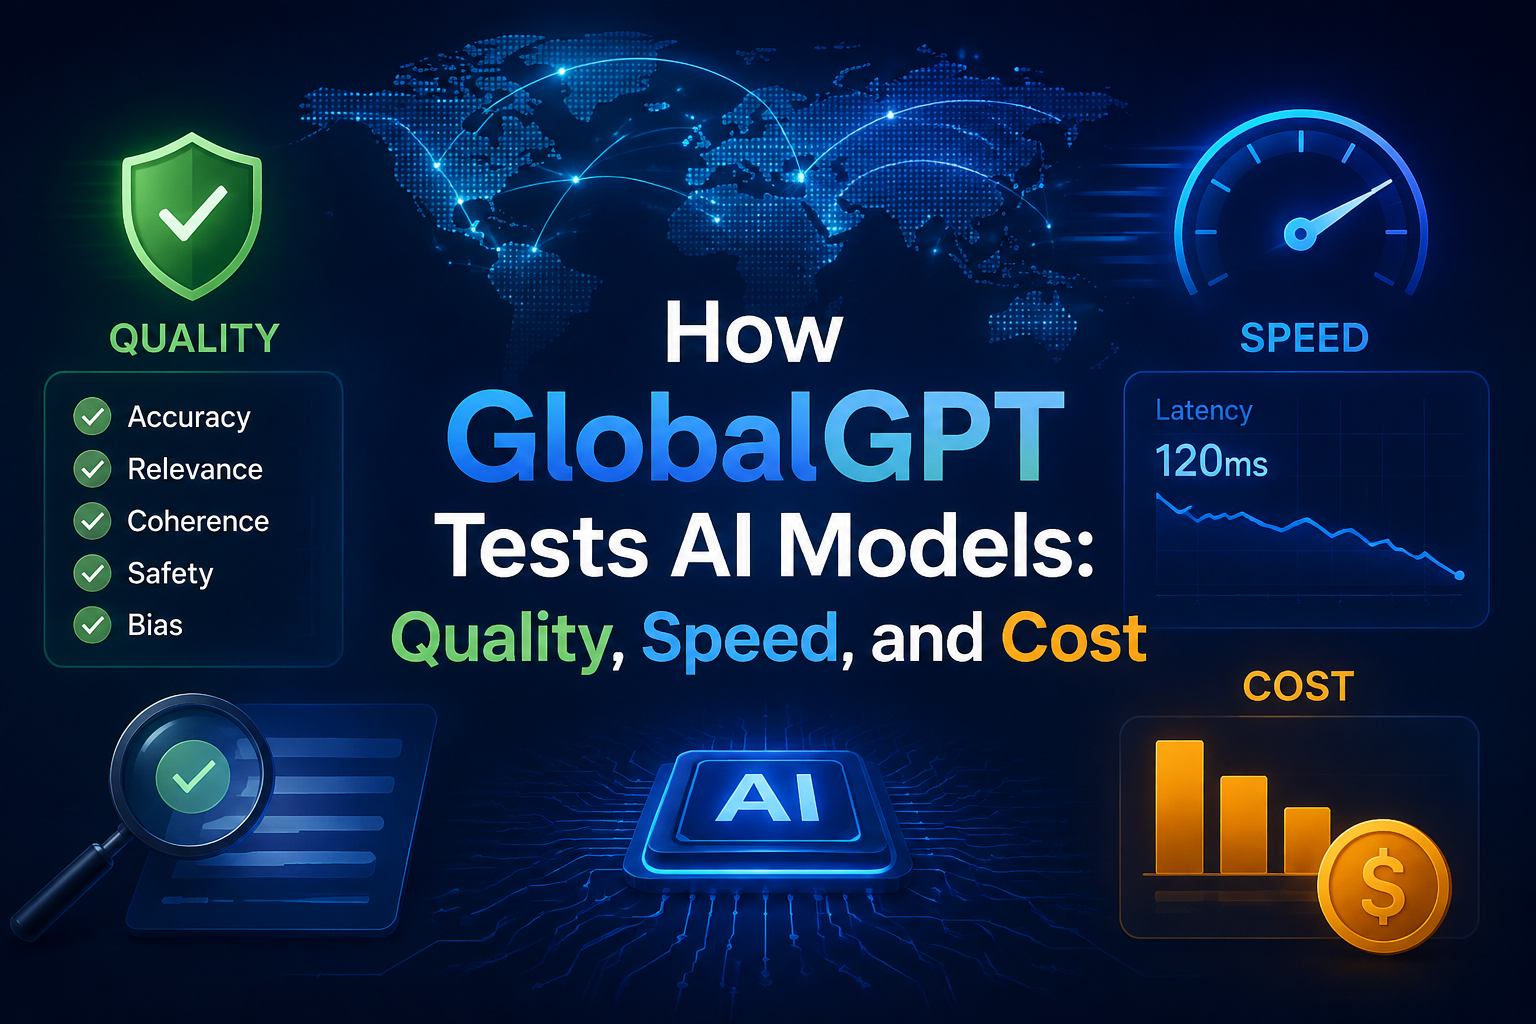
A comparação de modelos começa com uma tarefa específica: o que solicitamos e o resultado atendeu aos requisitos? Testamos modelos de IA no GlobalGPT utilizando a CLI do GlobalGPT. As exceções são identificadas no artigo correspondente.
A IA verifica se as respostas apresentam erros e se seguem as instruções. Quando as respostas são aprovadas nessas verificações, comparamos a velocidade, o preço e o uso de tokens, quando aplicável. Os autores também avaliam qualidades subjetivas, como o estilo de redação e o apelo visual. A avaliação de áudio é realizada inteiramente pela IA, utilizando o Gemini 3.6 Flash.
Nós somos o Equipe de Revisão do GlobalGPT, parte do GlobalGPT. Essa metodologia abrange os testes que publicamos no blog quando novos modelos são lançados, juntamente com comparações entre modelos. Relatórios de pesquisa baseados nos dados dos usuários do GlobalGPT explicam seus próprios conjuntos de dados e métodos de análise.
Nosso ambiente de teste: GlobalGPT CLI
A CLI GlobalGPT é nosso ambiente de teste padrão. Um teste que utilize uma interface, rota de API ou ferramenta de programação nativa diferente deve ser interpretado nesse contexto. Os nomes dos modelos, as configurações disponíveis, as ferramentas e o acesso podem variar entre os ambientes.
O modelo que gera uma saída e a IA que a avalia têm funções diferentes. O julgamento de um avaliador constitui uma evidência sobre a saída retornada; ele não determina como o modelo testado funciona internamente.
Projeto da tarefa: instruções, dados de entrada e requisitos
Atribuímos aos modelos tarefas concretas com requisitos identificáveis. Uma tarefa de redação pode exigir um resumo baseado apenas nas anotações fornecidas. Uma tarefa de programação pode exigir uma função capaz de lidar com uma entrada vazia. Uma tarefa relacionada a imagens pode exigir o texto exato a ser usado em um cartaz.
Para fins de comparação, o prompt e os materiais de entrada definem o que se espera que cada modelo faça. As diferenças nos formatos suportados, nas configurações ou nas ferramentas disponíveis são importantes na interpretação dos resultados. Uma comparação de prompts fixos e um tutorial que aprimora um prompt ao longo de várias tentativas respondem a questões diferentes.
Avaliação da saída: erros, instruções e eficiência
Erros e adesão imediata
A IA avalia se o resultado está de acordo com a tarefa e se contém erros identificáveis. As verificações relevantes podem abranger cálculos incorretos, afirmações sem fundamento, campos ausentes ou o não cumprimento de um formato exigido.
A aprovação significa que nenhuma falha foi identificada pelas verificações realizadas. Isso não garante que o resultado esteja isento de todos os erros possíveis. Os avaliadores de IA podem deixar passar erros ou fazer julgamentos incorretos.
As evidências de execução constituem uma parte distinta da avaliação. Em nosso Teste do plano de programação do Kimi, o código gerado foi seguido por cinco verificações locais. Ler o código, pedir a um modelo para inspecionar sua própria resposta e executar testes fornecem evidências diferentes.
Velocidade, preço e uso do token
Uma vez que um resultado atenda aos requisitos da tarefa, a eficiência ajuda a distinguir as opções úteis. Uma resposta rápida que omita um cálculo necessário não cumpriu a mesma função que uma resposta correta.
| Medida | Como ler |
|---|---|
| Tempo | Verifique a janela de medição. O tempo entre a solicitação e a conclusão inclui o trajeto e o processamento envolvidos; não se trata necessariamente da latência do modelo do provedor. |
| Uso do token | Utilize as categorias retornadas pelo serviço. A ausência de dados de entrada, saída, em cache ou de tokens de raciocínio não significa que o uso seja nulo. |
| Custo | Distinguir cobranças ou créditos registrados no formato GlobalGPT das estimativas baseadas nos preços da API do provedor. As taxas de assinatura são outro indicador. |
| Geração de mídia | Leve em consideração as configurações de saída e os créditos aplicáveis ou as taxas por saída. A contagem de tokens pode não estar disponível ou não ser relevante. |
Uma estimativa de preço precisa ter uma base de cálculo declarada. Os créditos não podem ser convertidos em dólares sem uma regra de conversão verificada, e um campo de resposta com valor zero, por si só, não comprova que uma solicitação tenha sido gratuita.
Avaliação do autor em tarefas subjetivas
Os autores também comparam os resultados quando a preferência influencia a utilidade. No caso de textos ou imagens, isso pode significar explicar qual resultado apresenta uma linguagem mais clara, um layout mais legível ou uma composição que se adapta melhor ao briefing.
Nosso Comparação entre o Seedream 5.0 Pro e a imagem GPT 2 apresenta imagens emparelhadas relacionadas a tarefas específicas. O texto e o layout visíveis oferecem aos leitores elementos para análise, além da preferência do autor. Uma preferência estética permanece distinta de um requisito verificado objetivamente.
Avaliação de áudio com IA usando o Gemini 3.6 Flash
Nossas avaliações auditivas são realizadas inteiramente por IA. Utilizamos o Gemini 3.6 Flash para interpretar o áudio real. Trata-se de avaliações feitas por IA, e não de resultados obtidos por um painel de avaliação humano.
A avaliação depende da tarefa: fala solicitada, linguagem, eventos sonoros, tempo ou estrutura musical. Nossa Análise do Seed Audio 1.0 inclui áudio gerado e análise por IA de conteúdo, eventos, tempo e artefatos.
As propriedades do arquivo, como formato e duração, são independentes das avaliações de conteúdo. A presença de uma faixa de áudio não comprova que as palavras ou sons solicitados estejam corretos. Qualquer partitura publicada deve ser lida em conjunto com os critérios de avaliação e o áudio que ela descreve.
Como interpretar datas de testes, configurações e resultados
É no artigo em si que devem constar os resultados detalhados dos testes. Alguns elementos de contexto úteis incluem:
- A data do teste, o identificador do modelo e o ambiente.
- A tarefa, a orientação, os materiais de apoio e o resultado esperado.
- Configurações disponíveis, número de tentativas e alterações relevantes.
- O avaliador, as verificações realizadas e os motivos para qualquer preferência do autor.
- Resultados reais ou trechos, capturas de tela ou arquivos de mídia, além de registros disponíveis sobre prazos, uso e custos.
Os registros variam entre os artigos e os testes mais antigos. As medições ausentes não podem ser reconstruídas como fatos observados. A seção “Blog e Guias” da página de uma coleção de modelos contém links para as revisões relevantes e para esta metodologia; as instruções completas e as evidências dos resultados permanecem nos artigos do blog.
Interpretação de novas tentativas, solicitações com falha e revisões
Uma primeira resposta, um resultado selecionado e uma tentativa revisada transmitem mensagens diferentes aos leitores. O histórico de tentativas do artigo é importante, incluindo falhas técnicas, respostas vazias, respostas truncadas e alterações nas instruções ou configurações.
Uma solicitação concluída ainda pode retornar uma resposta inutilizável. Uma solicitação com falha pode revelar um problema na rota testada, sem que isso signifique uma deficiência geral do modelo. Nossos artigos utilizam diferentes escopos de teste; não há um número universal de execuções nem um procedimento de teste cego por trás de cada resultado.
O que os resultados das tarefas podem e não podem revelar
Um resultado corrobora uma conclusão sobre a tarefa testada, o modelo, a data e o ambiente. Conjuntos pequenos de tarefas e medições individuais de tempo não permitem estabelecer uma classificação universal de desempenho. Se apenas um dos lados de uma comparação foi testado, essa evidência não pode servir de base para determinar um vencedor entre os dois modelos.
Especificações oficiais, testes de desempenho externos, testes anteriores e os próprios resultados de um artigo fornecem diferentes tipos de evidências. Qualquer pontuação depende da escala declarada, da ponderação e das exclusões. Os leitores devem ser capazes de relacionar a conclusão às evidências, incluindo resultados parciais ou malsucedidos.
Como as atualizações de artigos diferem do reteste de modelos
Geralmente, revisamos os artigos a cada duas a quatro semanas, conforme descrito em nosso Padrões editoriais. Uma verificação de conteúdo não significa que todos os testes de modelo tenham sido executados novamente.
Atualizar um preço, corrigir uma avaliação de um resultado existente e gerar um novo resultado são ações distintas. Os resultados históricos permanecem vinculados ao seu contexto de teste original; o simples fato de um artigo ter uma data de atualização mais recente não o transforma em um novo resultado de teste.