Análise de modelos · Testes de desempenho · Testes reais de API
O Gemini 3.7 Flash é apresentado como um modelo rápido e capaz de raciocínio para programação, tarefas de agência, entradas multimodais e tarefas de produção do dia a dia. A questão mais relevante é mais complexa: ele produz resultados finais melhores do que o Gemini 3.6 Flash quando ambos os modelos recebem o mesmo prompt?
Esta análise do Gemini 3.7 Flash distingue três tipos de evidências. A documentação do Google comprova os dados do modelo, os preços e as alegações oficiais de desempenho. A Artificial Analysis fornece um contexto independente de testes de desempenho realizados por terceiros. Nossa comparação prática utiliza sete tarefas de API equivalentes, com as mesmas configurações de prompt e geração para ambos os modelos.
O Gemini 3.7 Flash está listado para testes por meio do GlobalGPT Gemini 3.7 Página do modelo Flash. Isso permite que você execute o mesmo prompt em vários modelos, incluindo o modelo de referência utilizado nesta análise, tudo em um único lugar. Para mais informações sobre o contexto, consulte nosso Gemini 3.6 Resenha rápida e o Comparação entre o Gemini 3.6 Flash e o Gemini 3.1 Pro.
Análise rápida do Gemini 3.7: A resposta curta
Gemini 3.7 O Flash produziu a resposta com melhor acabamento em três dos seis pares de tarefas concluídas, em comparação com duas vitórias do Gemini 3.6 Flash e um empate. Suas vantagens ficaram evidentes na codificação, no raciocínio sobre dados e na edição de SEO segura em termos de afirmações. O Gemini 3.6 Flash elaborou o plano de front-end textual mais claro e a extração de status mais cuidadosa, enquanto o planejamento baseado em agentes resultou em um empate.
Resumo da avaliação
| Medida | Resultado observado | O que isso significa |
|---|---|---|
| Qualidade de impressão | 3,7 vitórias; 3,6 vitórias; 1 empate | Os julgamentos são baseados no trabalho finalizado apresentado em cada cartão. |
| Velocidade | Misto | A versão 3.7 concluiu mais rapidamente quatro tarefas, mas a versão 3.6 apresentou uma média ligeiramente menor nas seis tarefas. |
| Eficiência do token | A versão 3.7 utilizou 7.948 tokens de saída; a versão 3.6 utilizou 10.058 | Entre as tarefas concluídas, o 3.7 gerou 21% a menos de tokens de saída. |
| O melhor resultado de 3,7 | Edição de SEO sem riscos de reclamações | Seguiu os fatos estabelecidos sem acrescentar nenhum descritor sem fundamento. |
Trata-se de seis pequenas tarefas de texto controladas, e não de uma classificação universal dos modelos. O T01 foi excluído porque nenhum dos modelos completou a resposta solicitada dentro do limite máximo de saída estabelecido.
O que é o Gemini 3.7 Flash?
O Gemini 3.7 Flash é o modelo estável de alto rendimento do Google para tarefas que ainda se beneficiam do raciocínio. O Google lista entradas de texto, imagem, vídeo, áudio e PDF; os recursos suportados incluem chamada de funções, execução de código, baseamento em pesquisa, busca de arquivos, saídas estruturadas e uso do computador (Pré-visualização). A questão prática é como esses controles se traduzem em um trabalho finalizado.
Data de lançamento e disponibilidade
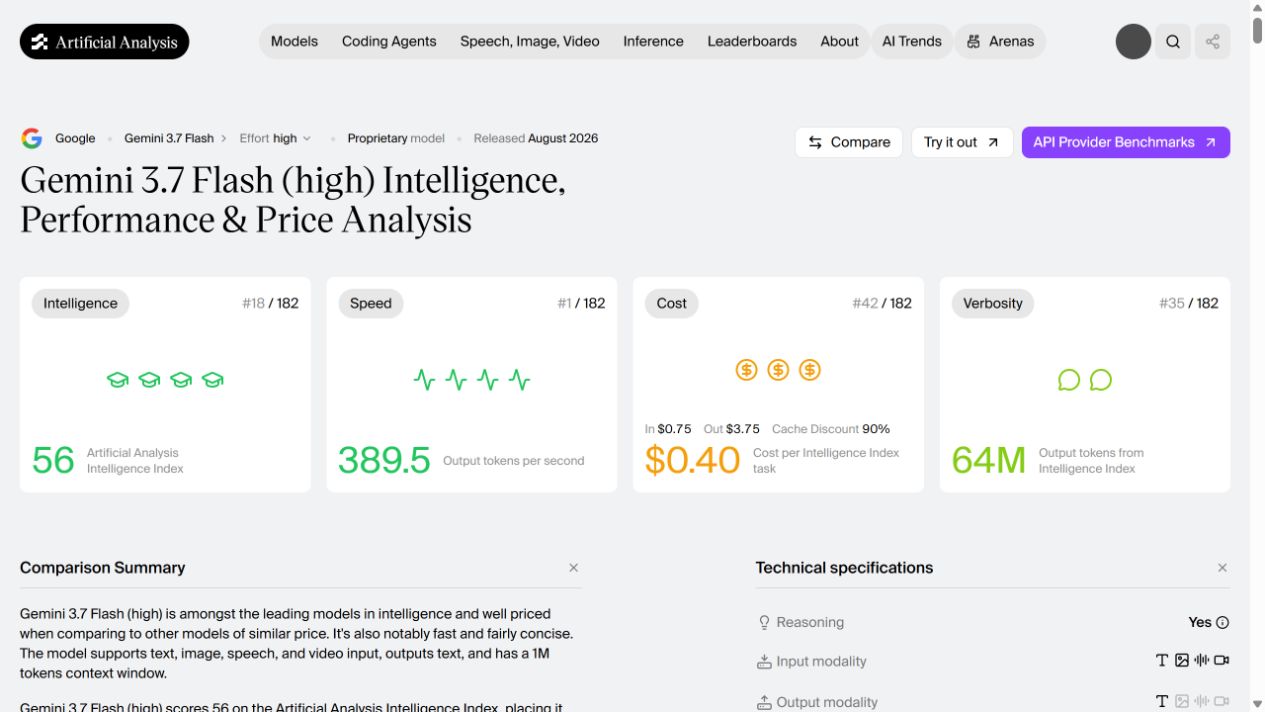
A página “Análise Artificial” capturada identifica o Gemini 3.7 Flash (alto) com uma data de lançamento prevista para agosto de 2026. Para obter informações oficiais sobre o status, o ID do modelo, os recursos compatíveis e os detalhes da implementação, consulte o site do Google Cartão oficial do modelo Gemini 3.7 Flash e a documentação da API relacionada. A disponibilidade pode variar de acordo com o produto, a região, a conta e o nível do modelo; portanto, uma página que liste um modelo não constitui, por si só, prova de acesso universal.
O que mudou em relação ao Flash Gemini 3.6?
A mudança não se resume apenas a um número de benchmark mais alto. O Google descreve o Gemini 3.7 Flash como uma iteração do Gemini 3.6 Flash, com melhorias em sua base de raciocínio e no pensamento personalizável. Em nossos pares concluídos, isso se traduziu em um melhor tratamento de restrições em três tarefas, mas não em uma vitória esmagadora.
| Área de comparação | Gemini 3.7 Flash | Gemini 3,6 Flash | Evidências observadas |
|---|---|---|---|
| Correção de bug de programação | Correto, com testes mais precisos | Correto, mas mais longo | 3,7 vitória por uma pequena margem |
| Plano de interface textual | Aceptável, com duas falhas editoriais | Mais claro e com maior coerência interna | 3,6 vitória por uma pequena margem |
| Extração sensível ao status | Lembrança completa, mas um rótulo de sucesso exagerado | Linguagem mais precisa para descrever o status | 3,6 vitória por uma pequena margem |
| Raciocínio com dados | Correto, com uma divisão padrão mais clara | Correto, com mais detalhes sobre as condições | 3,7 vitória por uma pequena margem |
| Planejamento agênico | Portas de contenção resistentes | Detalhes mais específicos sobre a chamada de ferramentas | Empate |
| Edição para SEO | Preservou todas as reivindicações bloqueadas | Adicionou-se um adjetivo não suportado | 3,7 vitória por uma pequena margem |
Gemini 3.7 Especificações do Flash e janela de contexto
As especificações são importantes porque definem as condições nas quais uma comparação é justa. Se você estiver comparando os limites dos planos, em vez do comportamento dos modelos, nosso Guia de limites e cotas do Gemini é a análise mais detalhada. Um número de janela de contexto não significa automaticamente que um modelo irá resumir com precisão todos os documentos longos; ele apenas indica o que a API foi projetada para aceitar. O teste de extração a seguir analisará separadamente a recuperação, o tratamento de contradições e os elementos desconhecidos.
| Especificação | Gemini 3.7 Flash | Gemini 3,6 Flash | Fonte |
|---|---|---|---|
| ID do modelo da API retornado | gemini-3.7-flash | gemini-3.6-flash | Respostas da API registradas |
| Contexto de entrada | Até 1 milhão de tokens | Até 1 milhão de tokens | Cartão de modelo do Google |
| Quantidade máxima de texto | 64 mil tokens | 64 mil tokens | Cartões de modelo do Google |
| Entradas documentadas | Texto, imagens, áudio, vídeo | Texto, imagens, áudio, vídeo | Cartões de modelo do Google |
Gemini 3.7 Preços do Flash e custo da API
A definição de preços requer uma separação clara entre a tarifa publicada e o custo de uma resposta específica. O resumo da Análise Artificial capturado mostra $0,75 por 1 milhão de tokens de entrada e $3,75 por 1 milhão de tokens emitidos para a listagem selecionada do Gemini 3.7 Flash (alto). Esses valores são dados de páginas de terceiros, não substituem a tabela oficial de preços do Google e não representam uma afirmação sobre todas as vias de acesso.
Contexto de preços de terceiros coletado
Apenas para referência visual. As barras não substituem a unidade de cobrança oficial, o nível, a região ou as regras de cache/lote.
O Cartão de modelo do Google apresenta uma tarifa inicial da API de $0,75 por 1 milhão de tokens de entrada e $3,75 por 1 milhão de tokens de saída para ambos os modelos Flash até 31 de dezembro de 2026. As estimativas por cartão apresentadas a seguir aplicam essa tarifa aos tokens registrados; elas excluem novas tentativas, armazenamento em cache, impostos e cobranças específicas da rota.
| Item de custo | Gemini 3.7 Flash | Gemini 3,6 Flash | Limite da evidência |
|---|---|---|---|
| Preço inicial dos insumos | $0,75 / 1M | $0,75 / 1M | Cartão de modelo do Google; validade até 31 de dezembro de 2026 |
| Preço inicial de venda | $3,75 / 1M | $3,75 / 1M | O faturamento específico por rota pode variar |
| Seis pares de testes concluídos | Sobre o $0.0303 | Sobre $0.0382 | Derivado de tokens registrados; T01 excluído |
Gemini 3.7 Flash: Testes de desempenho oficiais
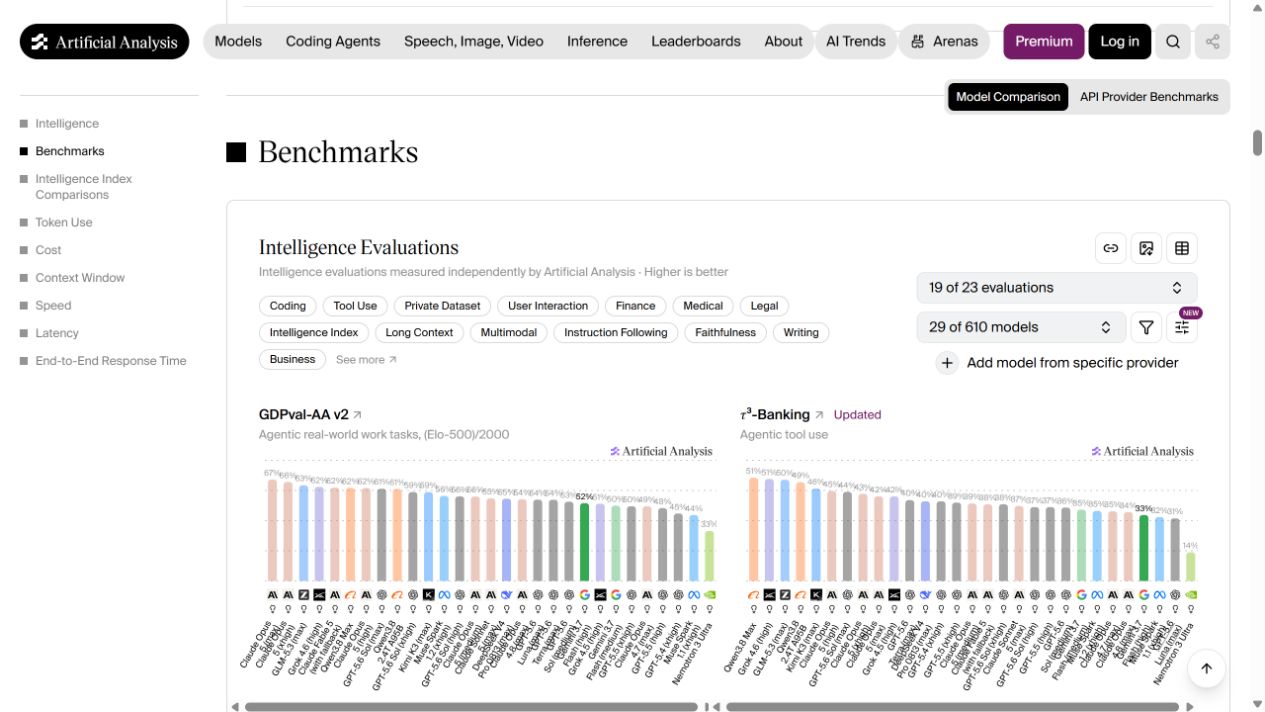
Os benchmarks oficiais respondem a uma questão específica: qual foi o desempenho do modelo em uma avaliação publicada, de acordo com as condições definidas para essa avaliação. Eles fornecem um contexto útil, mas não substituem a comparação de resultados com o mesmo prompt apresentada nesta análise.
Testes de desempenho em programação, agentes e raciocínio
A ficha técnica do modelo do Google e a documentação oficial são as fontes a serem utilizadas para as afirmações da própria Google sobre os resultados de benchmark. A versão final indicará a métrica, a data, a variante do modelo, o modelo de comparação e a configuração do teste para cada valor. Um resultado de 3,7 em comparação com um modelo mais antigo não será apresentado implicitamente como um resultado de 3,7 contra 3,6.
O que os ganhos nos testes de desempenho não comprovam
- Uma pontuação mais alta na avaliação de código não significa necessariamente que o primeiro patch seja mais limpo em todos os repositórios.
- Uma pontuação em raciocínio não comprova que a edição de conteúdo para SEO ou a interpretação de capturas de tela sejam melhores.
- Um índice de inteligência elaborado por terceiros não substitui as evidências específicas da tarefa nesta revisão.
- A incerteza decorrente de sobreposições ou configurações diferentes nos testes não deve ser transformada em uma classificação decisiva.
Como testamos o Gemini 3.7 Flash
Este foi um teste de API comparativo, e não uma coleção de demonstrações não relacionadas entre si. Ambos os modelos receberam o mesmo prompt, o mesmo material de origem, temperatura de 0, limite máximo de tokens de saída e tratamento de apresentação. O T05 foi avaliado a partir de uma repetição compartilhada de 5.000 tokens, após ambas as primeiras tentativas terem atingido o limite mínimo. O T01 permaneceu incompleto para ambos os modelos, mesmo após a mesma repetição.
| Campo registrado | Por que é importante |
|---|---|
| ID do modelo e ID do modelo retornado | Confirma se o modelo solicitado é o mesmo que respondeu. |
| Segundos decorridos | Mede o tempo de resposta de ponta a ponta na mesma rota. |
| Tokens de entrada e saída | Apoia uma estimativa de custo comparável. |
| Conformidade com o formato | Distingue uma resposta correta de uma resposta que ainda precisa de ajustes estruturais. |
| Qualidade editorial | Verifica a exatidão, a integridade, a especificidade, a apresentação e a segurança das alegações. |
Uma solicitação cobrada sem resultado utilizável será identificada como um problema de execução e não será considerada como perda de qualidade.
Gemini 3.7 Resultados dos testes práticos do Flash
Cada cartão mostra a descrição da tarefa, um trecho fiel de cada resposta salva e um veredicto com base no trabalho concluído. O tempo decorrido é o tempo total, do início ao fim. O custo é calculado com base na tarifa inicial do Google descrita acima.
Teste 1 — Síntese de pesquisa
Entrada da tarefa: Escreva uma recomendação de compra com 180 palavras, utilizando apenas quatro fatos fornecidos, com uma recomendação, três motivos, duas incógnitas e um plano de teste.
Gemini 3.7 Flash
33,427 s · 85 tokens de entrada / 4.996 tokens de saída · estim. $0,01880
A segunda execução correspondente parou no limite máximo de 5.000 tokens antes de gerar uma recomendação utilizável de 180 palavras.
Gemini 3,6 Flash
28,706 s · 85 tokens de entrada / 4.996 tokens de saída · estim. $0,01880
Ele retornou a mesma contagem de tokens de conclusão e o mesmo comprimento motivo da conclusão.
O que os resultados mostram
Ambos os modelos atingiram inicialmente 2.400 tokens e, em seguida, repetiram o comportamento ao chegar a 5.000. Texto parcial não é considerado evidência de qualidade.
Teste 2 — Correção de erro de programação
Entrada da tarefa: Corrigir top_paid(registros) retornar os três registros pagos com os valores mais altos, preservar a ordem de entrada em caso de empate, manter a assinatura, lidar com entradas vazias, explicar a causa e adicionar dois testes.
Gemini 3.7 Flash
11,379 s · 90 tokens de entrada / 1.431 tokens de saída · estim. $0,00543
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]O sistema identificou a ordenação ascendente como a causa e testou a filtragem, a classificação, os empates e a entrada vazia.
Gemini 3,6 Flash
13,984 s · 90 tokens de entrada / 2.273 tokens de saída · est. $0,00859
paid.sort(key=lambda r: r["amount"], reverse=True); return paid[:3]Ele criou o mesmo patch correto e atendeu aos mesmos critérios de aceitação, mas levou mais tempo para responder.
O que os resultados mostram
Ambas utilizam corretamente a função `sort` estável do Python para valores empatados. A solução da versão 3.7 é mais curta, mas o código final e a cobertura são equivalentes.
Teste 3 — Plano de implementação da interface textual
Entrada da tarefa: Planeje correções para um processo de finalização de compra de duas colunas, conforme descrito, que apresenta espaço em branco excessivo, hierarquia pouco clara, um rótulo “Pagar agora” muito pequeno, uma nota de confiança de baixa visibilidade, um aviso sobre desconto, totais e empilhamento em dispositivos móveis. Não foi fornecida nenhuma captura de tela.
Gemini 3.7 Flash
15,009 s · 86 tokens de entrada / 1.591 tokens de saída · estim. $0,00603
A proposta incluía uma grade 58/42, um CTA de 48–56 px, um selo de confiança próximo, um aviso em tom âmbar, empilhamento para dispositivos móveis, estados de foco e alvos de toque de 44 px.
Gemini 3,6 Flash
15,254 s · 86 tokens de entrada / 1.767 tokens de saída · estim. $0,00669
O resultado foi um layout consistente de 60/40, tamanhos de fonte explicitados, um CTA de 48–52 px, conteúdo ordenado na coluna direita, pontos de quebra e verificações de acessibilidade.
O que os resultados mostram
Ambas apresentam erros que podem ser corrigidos. A resposta 3.7 diz “click affordability”, aparentemente referindo-se a “affordance”, e chama uma grade assimétrica de “simétrica”. A versão 3.6 precisa de menos correções.
Teste 4 — Extração com reconhecimento de estado
Entrada da tarefa: Resuma nove fatos sobre o Orion em 120 palavras e inclua uma tabela, mantendo os status “confirmado”, “planejado”, “pendente”, “desconhecido” e “não verificado”.
Gemini 3.7 Flash
13,681 s · 117 tokens de entrada / 1.064 tokens de saída · estim. $0,00408
A empresa manteve em aberto o resultado do projeto 18%, que envolve muitas imagens, mas descreveu o resultado do projeto-piloto 82% como “bem-sucedido” e classificou o segundo projeto-piloto como “Confirmado / Planejado”.”
Gemini 3,6 Flash
9,270 s · 117 tokens de entrada / 1.454 tokens de saída · estim. $0,00554
O documento descreveu o projeto-piloto de forma neutra, indicando que ele lidava com 82% de casos, e classificou o segundo projeto-piloto como “Aprovado (em tramitação jurídica)”.”
O que os resultados mostram
Ambos mantiveram todos os fatos relevantes. O Gemini 3.6 Flash manteve os estados “aprovado”, “pendente” e “desconhecido” de forma mais precisa, enquanto a versão 3.7 exagerou ligeiramente o primeiro piloto.
Teste 5 — Raciocínio com dados
Entrada da tarefa: A partir dos gastos, cliques, conversões pagas e receita de quatro canais, apresente cálculos aritméticos, classifique o ROAS e a taxa de conversão mensuráveis, considere os gastos nulos como não mensuráveis e recomende uma divisão condicional $300.
Gemini 3.7 Flash
16,540 s · 137 tokens de entrada / 1.981 tokens de saída · estim. $0,00753
ROAS: E-mail 7,00×, Busca 3,00×, Redes sociais 2,60×; Parceiro não mensurável. Conversão: E-mail 12,5%, Busca e Parceiro 10%, Redes sociais 5%. A campanha ofereceu três divisões condicionais.
Gemini 3,6 Flash
18,096 s · 137 tokens de entrada / 2.403 tokens de saída · estim. $0,00911
O sistema gerou as mesmas classificações e o mesmo tratamento para casos-limite e, em seguida, ofereceu eficiência, diversificação e alocações para testes de parceiros.
O que os resultados mostram
Ambos os cálculos estão corretos e ambos tornam a recomendação condicional. Cada um deles acrescenta um contexto especulativo em torno do gasto zero da Partner; portanto, essa frase precisa de confirmação da fonte ou ser removida.
Teste 6 — Planejamento agênico e uso de ferramentas
Entrada da tarefa: Elabore um plano com menos de 220 palavras utilizando apenas quatro ferramentas específicas. Interrompa o processo se a página estiver indisponível, não for oficial ou for ambígua, e não afirme que as ferramentas foram executadas.
Gemini 3.7 Flash
10,787 s · 100 tokens de entrada / 1.174 tokens de saída · estim. $0,00448
Suas quatro etapas correspondem, uma a uma, às ferramentas fornecidas, seguidas por verificações de domínio oficial, disponibilidade e clareza. A conclusão requer exatamente um registro CSV validado.
Gemini 3,6 Flash
9,702 s · 100 tokens de entrada / 1.328 tokens de saída · estim. $0,00506
O plano é viável, mas acrescenta “ou analisar o corpo do HTML”, uma operação que não faz parte do conjunto de ferramentas fornecido.
O que os resultados mostram
Ambos respeitam a regra de interrupção baseada em fontes oficiais e evitam simular a execução de ferramentas. O plano 3.7 mantém-se mais restrito às funções disponíveis.
Teste 7 — Redação e edição para SEO
Entrada da tarefa: Retorne um HTML contendo apenas um parágrafo e uma lista curta, use a palavra-chave exata uma vez e mantenha quatro fatos fixos, sem inventar nenhum resultado, preço, data de lançamento ou afirmação sobre disponibilidade.
Gemini 3.7 Flash
7,263 s · 125 tokens de entrada / 707 tokens de saída · estim. $0,00275
<p>Nesta próxima análise do Gemini 3.7 Flash, examinamos o modelo do Google comparando os resultados oficiais dos benchmarks com testes de API realizados com o mesmo prompt; os resultados práticos ainda estão pendentes.</p>Ele seguiu a estrutura do HTML, utilizou a palavra-chave uma vez e manteve as reivindicações bloqueadas.
Gemini 3,6 Flash
7,542 s · 125 tokens de entrada / 833 tokens de saída · estim. $0,00322
<p>Esta análise preliminar do Gemini 3.7 Flash avalia o novo modelo do Google... embora os resultados detalhados dos testes práticos ainda estejam pendentes.</p>A estrutura está correta, mas “novo modelo” acrescenta uma afirmação que vai além dos fatos estabelecidos.
O que os resultados mostram
A diferença decisiva está na segurança da validação: a versão 3.7 se recusou a incluir o descritor não suportado, ao mesmo tempo em que retornou um HTML compacto válido.
Gemini 3.7 Quadro de resultados do teste “Flash” e conclusões
A comparação favorece o Gemini 3.7 Flash em termos de qualidade da saída final, mas a vantagem decorre da disciplina de instruções, e não de uma diferença drástica de capacidade. O Gemini 3.6 Flash manteve-se competitivo em código e aritmética, além de ter gerado o melhor plano de front-end.
Tabela de pontuação do teste comparativo
| Medida | Gemini 3.7 Flash | Gemini 3,6 Flash |
|---|---|---|
| Vitórias em tarefas | 3 | 2 |
| Gravatas de qualidade | 1 | 1 |
| Tarefas inconclusivas | 1 | 1 |
| Tarefas concluídas que podem ser utilizadas | 6 de 7 | 6 de 7 |
| Tokens de saída de tarefas concluídas | 7,948 | 10,058 |
| Melhor resultado observado | Plano agênico limitado | Plano de interface textual |
Gemini 3.7 Limitações do Flash
A maior limitação observada foi comum a ambos: os dois modelos esgotaram o orçamento total de saída duas vezes em uma simples solicitação de síntese de pesquisa de 180 palavras. O T01 é inutilizável na configuração testada.
O Gemini 3.7 Flash não se mostrou uniformemente melhor. Seu plano inicial continha um erro de redação e uma incompatibilidade entre o layout e a descrição interna, enquanto ambas as respostas de dados introduziram um contexto especulativo em torno de um canal sem gastos. O pacote utilizou apenas entradas textuais, portanto, não avalia a qualidade de imagem, áudio, vídeo ou contexto realmente extenso.
Vale a pena comprar o Gemini 3.7 Flash?
Sim, vale a pena testar o Gemini 3.7 Flash quando a conformidade exata com as instruções é importante. Ele venceu em três tarefas concluídas e utilizou menos tokens de saída nos seis pares analisados. O argumento é menos convincente no caso de correções simples de código, operações aritméticas ou planejamento de interface do usuário, onde o Gemini 3.6 Flash venceu a tarefa de front-end ou ficou próximo do resultado.
Você pode executar o mesmo comando em GlobalGPT e compare-o com o Gemini 3.6 Flash no mesmo espaço de trabalho. Use sua tarefa recorrente como teste decisivo.
Análise rápida do Gemini 3.7: Veredicto final
Esta análise do Gemini 3.7 Flash chega a uma conclusão um tanto restrita, mas justificável: O Gemini 3.7 Flash venceu três tarefas concluídas, o Gemini 3.6 Flash venceu duas e houve um empate. Uma tarefa de pesquisa não foi conclusiva porque ambos os modelos atingiram o limite máximo de saída compartilhado duas vezes.
A versão Gemini 3.6 Flash não está obsoleta. Ela produziu o melhor plano de interface textual e a tabela de status mais precisa, enquanto a versão 3.7 se destacou em codificação, raciocínio de dados e edição de SEO com fatos fixos. A tarefa de planejamento agênico ficou empatada, portanto, a atualização é seletiva, e não absoluta.
Gemini 3.7 Perguntas frequentes sobre o Flash
Quando foi lançada a versão Gemini 3.7 Flash?
O Google lista o Gemini 3.7 Flash como um modelo estável, com a documentação do modelo atualizada pela última vez em 13 de agosto de 2026.
O Gemini 3.7 Flash é uma versão estável ou de pré-visualização?
Ela está listada como estável na documentação do modelo da API Gemini do Google. O AI Studio, os produtos de consumo Gemini e as rotas de terceiros ainda podem apresentar disponibilidade ou cotas diferentes.
Qual é o ID do modelo da API Flash Gemini 3.7?
A comparação solicitada utiliza o `gemini-3.7-flash`, mas o ID do modelo retornado deve ser registrado a partir da resposta da API antes que o artigo final o declare como verificado.
Quanto custa o Gemini 3.7 Flash?
A tarifa do plano pago do Google é de $0,75 por 1 milhão de tokens de entrada e $3,75 por 1 milhão de tokens de saída até 31 de dezembro de 2026; a partir de 1º de janeiro de 2027, a taxa listada passa a ser de $1,50/$7,50.
O Gemini 3.7 Flash é gratuito?
A disponibilidade para consumidores ou terceiros não significa acesso gratuito e ilimitado à API. Verifique a rota, a cota, os limites de taxa e as condições de cobrança do método de acesso que você pretende utilizar.
O que é a janela de contexto do Gemini 3.7 Flash?
O resumo da Análise Artificial capturado mostra uma lista de contextos de 1 milhão de tokens. Verifique o limite oficial exato de contexto e quaisquer restrições de preço ou de recursos para contextos longos na documentação do Google.
O Gemini 3.7 Flash é compatível com imagens, áudio, vídeo e PDFs?
Verifique os tipos de entrada compatíveis com o ID exato do modelo da API. A análise considerará cada modalidade compatível como um recurso documentado, e não como prova de qualidade equivalente em todos os tipos de entrada.
O que são os níveis de raciocínio Gemini 3.7 Flash?
O Gemini 3.7 Flash é configurado por meio de controles de lógica configuráveis. Os níveis exatos, os valores padrão, o comportamento dos tokens e as implicações de cobrança devem ser consultados na documentação oficial da API.
O Gemini 3.7 Flash é melhor do que o Gemini 3.6 Flash?
Neste teste comparativo de API, o Gemini 3.7 Flash venceu em três tarefas concluídas, o Gemini 3.6 Flash venceu em duas, houve um empate e um resultado foi inconclusivo. Isso confirma uma vantagem mínima do 3.7, e não uma vitória generalizada.
O Gemini 3.7 Flash é melhor do que o Gemini 3.1 Pro?
Este rascunho não faz essa afirmação. O Gemini 3.1 Pro é uma linha de base de comparação diferente; portanto, requer seu próprio conjunto de prompts correspondentes e evidências, em vez de uma inferência a partir da comparação do Gemini 3.6 Flash.
O Gemini 3.7 Flash é bom para programação?
Sim, na tarefa específica de correção de bug testada aqui. Ambos os modelos aplicaram o patch mínimo correto, mas o Gemini 3.7 Flash obteve uma ligeira vantagem por apresentar uma cobertura de teste mais limpa, com menos tokens de conclusão.
O Gemini 3.7 Flash pode utilizar ferramentas e executar fluxos de trabalho de agentes?
Consulte a documentação oficial da ferramenta e das chamadas de função para conhecer o caminho exato. O teste de agência nesta análise avalia o planejamento e a percepção de limites; ele não afirma que um plano, por si só, garanta o sucesso na execução da ferramenta.
Onde posso acessar o Gemini 3.7 Flash?
Use os pontos de acesso oficiais do Google, quando disponíveis, ou tente o Página do modelo GlobalGPT quando o modelo estiver habilitado para a sua conta e região.
Os testes de desempenho oficiais correspondem aos resultados na prática?
Não automaticamente. Os benchmarks oficiais e as avaliações de terceiros fornecem um contexto útil, enquanto os testes com o mesmo prompt mostram como um modelo lida com a tarefa específica que está sendo avaliada. Esta análise mantém esses tipos de evidência separados.