
Um provedor de IA utilizará o documento do seu cliente, a foto do produto, a gravação de voz ou o projeto 3D para treinar seus modelos? A resposta depende do contrato de prestação de serviços e das configurações de dados associadas à solicitação. O fato de pagar pelo acesso, por si só, não resolve essa questão.
Resposta rápida: Várias APIs oficiais e serviços corporativos prometem não utilizar o conteúdo dos clientes para treinamento, às vezes com exceções relacionadas ao consentimento ou ao feedback. Outros serviços permitem o treinamento, oferecem a opção de recusa ou deixam partes de sua política pouco claras. A promessa de não utilizar o conteúdo para treinamento não significa automaticamente que não haja armazenamento, revisão humana ou resultados privados.
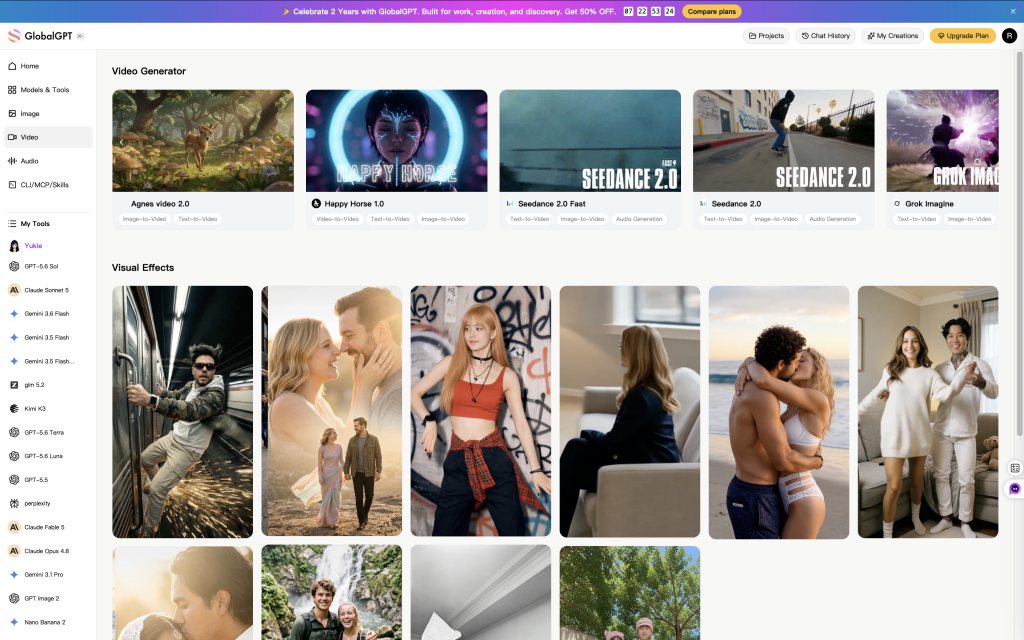
Esta comparação abrange 121 registros de modelos e versões do diretório de modelos e da página inicial do GlobalGPT: 64 itens de texto e multimídia, 21 de imagem, 24 de vídeo, sete de áudio e música e cinco itens 3D. Os modelos que compartilham uma mesma política estão agrupados nas tabelas; use o cartão de pesquisa para localizar qualquer versão específica. Os nomes refletem o catálogo da plataforma; eles não constituem uma verificação independente da identidade ou do contrato de cada modelo de origem.
Se você usar um assinatura de IA com tudo incluído, a política da própria plataforma é outro fator que influencia a decisão. GlobalGPT reúne essas categorias em uma única conta. As políticas dos provedores abaixo continuam vinculadas aos serviços especificados; isso não significa que todos os modelos GlobalGPT ofereçam o mesmo nível de proteção corporativa.
Análise de políticas e resumo do catálogo: 11 de setembro de 2026. Esta é uma comparação de termos publicados, não uma auditoria do comportamento do back-end. O serviço, o contrato e as configurações reais do upstream para cada entrada do GlobalGPT não foram verificados. “Todos os modelos” significa todas as entradas neste instantâneo do catálogo, e não todos os modelos de IA do mundo.
Todos os 121 modelos: comparação de privacidade
Leia o resultado do treinamento juntamente com o escopo do serviço. Sem treinamento por padrão podem incluir exceções relacionadas à adesão voluntária ou ao feedback. Treinamento permitido descreve a permissão, e não a prova de que esse arquivo específico foi utilizado. Desconhecido significa que as evidências aplicáveis estão ausentes ou incompletas. Quando há diferenças entre os serviços comuns e os empresariais, ambos são identificados, em vez de se atribuir ao modelo um único veredicto incondicional.
As tabelas agrupam versões dentro de cada categoria quando elas compartilham as mesmas evidências de política. Expanda uma família para ver todos os nomes do catálogo ou pesquise um modelo específico acima das tabelas. Nenhuma linha confirma que a GlobalGPT tenha assinado o acordo empresarial mencionado.
Verifique a política de privacidade de uma modelo
Pesquise todas as 121 entradas do catálogo. Experimente Claude, DeepSeek, Seedance ou Meshy.
Digite um nome para localizar a política correspondente. Nenhuma consulta é enviada a um servidor.
| Família de modelos / versões | Vaga de treinamento publicada | Escopo do serviço — aplicabilidade do GlobalGPT não verificada |
|---|---|---|
| OpenAI GPT e raciocínio | Sem treinamento por padrão | API oficial OpenAI; o serviço ChatGPT para consumidores e outros serviços de hospedagem têm políticas distintas. |
| Claude | Sem treinamento por padrão | Produtos comerciais Anthropic e API; os serviços pessoais Claude não fazem parte desta comparação. |
| Gêmeos | Depende do serviço do Google | Serviços pagos ou gratuitos da API Gemini e, separadamente, o Google Cloud Vertex AI; o Gemini para consumidores não está coberto. |
| Grok | Não é permitido treinar sem autorização | API oficial do xAI, incluindo controles de mídia documentados; o consumidor Grok possui políticas distintas. |
| DeepSeek | Treinamento permitido; direito de recusa | Política de privacidade do serviço oficial DeepSeek; os aplicativos de desenvolvedores terceirizados e seus contratos são independentes. |
GLM / Z.ai4 modelos | Por padrão, a API exclui melhorias | A API empresarial/para desenvolvedores da Z.ai e, separadamente, os serviços pessoais da Z.ai; outros provedores de GLM não estão sujeitos a estes termos. |
Kimi / Moonshot4 modelos | O treinamento é permitido, salvo acordo em contrário | Termos padrão da API da Kimi OpenPlatform; acordos empresariais ou por escrito podem restringir o uso. |
| Qwen | Depende do serviço e do plano | Termos do Alibaba Cloud Bailian na China continental; o Model Studio internacional e os serviços de API de terceiros exigem uma avaliação separada. |
Muse Spark2 modelos | Desconhecido | Listagens da plataforma Muse Spark; o mapeamento exato dos provedores e o contrato de serviço hospedado ainda não foram definidos. |
| Família de modelos / versões | Vaga de treinamento publicada | Escopo do serviço — aplicabilidade do GlobalGPT não verificada |
|---|---|---|
Imagem GPT2 modelos | Sem treinamento por padrão | API oficial de imagens OpenAI; o modelo exato e o endpoint são importantes |
| Nano Banana | Proteção condicional sem treinamento | Modelos de imagem Gemini e rótulos Nano Banana; a cobertura paga da API Gemini ou do Vertex AI requer confirmação. |
| Seedream | Restrição padrão no treinamento de modelos de base | Os serviços BytePlus AI e Model; o roteamento do Ark continental e do Seed Audio não são regidos por estes termos. |
| Ideograma | Proteção dependente do plano | Serviços do Ideogram para usuários comuns e para empresas; a cobertura do contrato de API pode variar |
| Imagens do FLUX | É permitido treinar; os controles variam | Serviços padrão do BFL, API oficial do FLUX e acordos corporativos |
Agnes1 modelo | Desconhecido | Rótulo da plataforma Agnes; a identidade do serviço de origem e o contrato aplicável ainda não foram confirmados. |
| Midjourney | Compromisso de não treinar não está claro | Termos de Serviço da Midjourney; acordos de acesso de terceiros exigem confirmação separada |
| Família de modelos / versões | Vaga de treinamento publicada | Escopo do serviço — aplicabilidade do GlobalGPT não verificada |
|---|---|---|
Sora1 modelo | Configuração padrão da API sem treinamento | Política de dados OpenAI /v1/videos; esta entrada não fornece nenhuma informação sobre a disponibilidade atual do serviço. |
| Veo | Proteção condicional sem treinamento | Veo por meio de um serviço identificado do Google; o acesso de consumidores e de terceiros requer avaliação separada. |
| Seedance | Restrição padrão no treinamento de modelos de base | Os serviços BytePlus AI e Model; o roteamento do Ark continental e do Seed Audio não são regidos por estes termos. |
| Kling | Treinamento permitido; possibilidade de revogação | Condições de serviço padrão Kling; a cobertura de APIs corporativas e de plataforma requer confirmação separada. |
Wan4 modelos | Depende do serviço e do plano | Termos do Alibaba Cloud Bailian na China continental; o Model Studio internacional e os serviços de API de terceiros exigem uma avaliação separada. |
Passarela1 modelo | Dependente do contrato | Serviços comuns do Runway em comparação com os Serviços Empresariais do Runway. |
Luma1 modelo | API/Empresa – sem treinamento | Serviços da web comuns da Luma versus contratos de API e empresariais |
MiniMax1 modelo | Escopo do treinamento não definido | Termos da plataforma API MiniMax; o tratamento de serviços ao consumidor Hailuo não está definido aqui. |
Grok Imagine2 modelos | Não é permitido treinar sem autorização | API oficial do xAI, incluindo controles de mídia documentados; o consumidor Grok possui políticas distintas. |
Cavalo Feliz1 modelo | Desconhecido | Inscrição na plataforma Happy Horse; a identidade do remetente e os termos aplicáveis ao tratamento de dados ainda não foram confirmados. |
Vídeo do FLUX 31 modelo | Desconhecido | Inscrição na plataforma de vídeo FLUX 3; o mapeamento de fornecedores e serviços ainda não foi confirmado. |
| Agnes | Desconhecido | Rótulo da plataforma Agnes; a identidade do serviço de origem e o contrato aplicável ainda não foram confirmados. |
| Família de modelos / versões | Vaga de treinamento publicada | Escopo do serviço — aplicabilidade do GlobalGPT não verificada |
|---|---|---|
Qwen1 modelo | Depende do serviço e do plano | Termos do Alibaba Cloud Bailian na China continental; o Model Studio internacional e os serviços de API de terceiros exigem uma avaliação separada. |
Seed Audio1 modelo | Restrição padrão no treinamento de modelos de base | Os serviços BytePlus AI e Model; o roteamento do Ark continental e do Seed Audio não são regidos por estes termos. |
| ElevenLabs | Treinamento permitido; opção de não participação disponível | Serviços padrão ElevenLabs; o processamento corporativo/comercial é regulamentado separadamente. |
Mureka1 modelo | Desconhecido, de acordo com os termos vigentes | Inclusão da plataforma Mureka v9; os termos atuais do serviço de controle e o contrato de API ainda não foram confirmados. |
Lyria1 modelo | Proteção por serviço pago com exceção de segurança | Lyria por meio da API Gemini; o selo Lyria 3 da plataforma exige um mapeamento exato de modelos e serviços. |
| Família de modelos / versões | Vaga de treinamento publicada | Escopo do serviço — aplicabilidade do GlobalGPT não verificada |
|---|---|---|
Hunyuan3D1 modelo | Proteção de entrada; saída pouco clara | A API Hunyuan3D da Tencent Cloud e seus termos relativos a modelos de grande porte incorporados |
Meshy1 modelo | É permitido o treinamento para não funcionários da empresa | Serviços Meshy comuns, API e Enterprise; exceções específicas de pedidos |
Tripo1 modelo | Serviço pago, sem treinamento | Seção de usuários pagos do Tripo; os serviços gratuitos e as configurações de acesso variam |
Rodin1 modelo | Proteção da produção do setor privado; ainda há lacunas | Termos do Hyper3D, política de privacidade e armazenamento de recursos gerados pela API |
TRELLIS1 modelo | Política de hospedagem desconhecida | O projeto-modelo TRELLIS versus o serviço que o executa |
Políticas de privacidade para modelos de IA de texto e multimodais
Para modelos de chat e raciocínio, verifique a conversa completa e os anexos, não apenas a última solicitação. Um documento enviado para resumo pode conter nomes de clientes, contratos, códigos ou registros financeiros. As permissões de feedback podem abranger uma conversa mesmo nos casos em que solicitações comuns de API sejam excluídas do treinamento.
Modelos de texto OpenAI: a configuração padrão da API exclui o treinamento
Itens do catálogo: GPT-6 Astra; GPT-5.6 Sol; GPT-5.6 Terra; GPT-5.6 Luna; GPT-5.5; GPT-5.4; GPT-5.4 mini; GPT-5.4 nano; GPT-5.3; GPT-5.2; GPT-5.1; GPT-5; GPT-5 mini; GPT-5 nano; GPT-4o; o1; o1 mini; o3; o3 mini; o3 Mini High; o4 mini; o4 Mini High.
Âmbito: API oficial OpenAI; o serviço ChatGPT para consumidores e outros serviços de hospedagem têm políticas distintas.
Treinamento: As entradas e saídas oficiais da API do OpenAI não são utilizadas para treinar ou aprimorar modelos do OpenAI, a menos que o cliente opte explicitamente por compartilhá-las.
Para modelos de texto acessados por meio da API oficial do OpenAI, as entradas e saídas dos clientes são excluídas do treinamento do modelo por padrão. A adesão explícita ao compartilhamento de dados constitui uma exceção. Trata-se de uma política do serviço da API, e não de uma prova de que todos os clientes tenham negociado um contrato Enterprise, de acordo com Documentação sobre controles de dados do OpenAI.
As diretrizes analisadas em 11 de setembro de 2026 distinguem entre treinamento e armazenamento. Os registros de monitoramento de abusos geralmente permanecem por até 30 dias, salvo exceções documentadas. O estado das conversas, os objetos enviados e alguns recursos de cache podem seguir regras de retenção diferentes. Uma configuração de “sem treinamento”, portanto, não significa que todas as solicitações desapareçam imediatamente.
Ainda podem ser aplicáveis medidas de segurança e procedimentos legais. A “Retenção Zero de Dados” e o “Monitoramento Modificado de Abuso” têm requisitos de elegibilidade e limitações de terminais; não são garantias universais de que ninguém possa acessar o conteúdo enviado. Esses controles devem ser avaliados em relação ao recurso específico responsável pelo processamento do comando ou do arquivo.
As informações enviadas a ferramentas externas ou serviços MCP remotos também estão sujeitas às políticas desses destinatários. O compromisso da API da OpenAI não abrange o armazenamento próprio da GlobalGPT, links públicos ou compartilhamento com terceiros. Os contratos específicos com fornecedores e o roteamento da GlobalGPT não foram verificados aqui, e esta comparação de políticas não faz nenhuma afirmação sobre a disponibilidade atual dos modelos.
Verificação a ser realizada: Verifique as permissões de compartilhamento de dados e o endpoint real. Os recursos “Monitoramento de Abuso Modificado” e “Retenção Zero de Dados” exigem qualificação e aprovação; nenhum deles se aplica automaticamente a todos os recursos.
Claude: a proteção de treinamento comercial possui exceções de permissão
Itens do catálogo: Claude Fable 5,1; Claude Fable 5; Claude Opus 5; Claude Opus 4,8; Claude Opus 4,7; Claude Opus 4,6; Claude Opus 4,5; Claude Sonnet 5; Claude Sonnet 4,6; Claude Sonnet 4,5; Claude Sonnet 4; Claude Haiku 4,5.
Âmbito: Produtos comerciais Anthropic e API; os serviços pessoais Claude não fazem parte desta comparação.
Treinamento: Por padrão, o Anthropic não é treinado com entradas ou saídas de produtos comerciais. Uma permissão explícita ou um feedback enviado podem criar exceções de acordo com a política aplicável.
A política de produtos comerciais da Anthropic estabelece que, por padrão, os dados de entrada e saída não são utilizados para treinar seus modelos. Isso se aplica aos serviços comerciais abrangidos pela política, incluindo o uso da API. O compromisso está descrito em Perguntas frequentes sobre o treinamento de modelos do Anthropic e não deve ser generalizado para todas as contas pessoais Claude.
A questão da permissão é importante. Os clientes podem autorizar usos adicionais, e os comentários enviados explicitamente podem incluir uma conversa relacionada. Uma empresa que esteja avaliando o modelo Claude deve, portanto, levar em consideração tanto os termos comerciais subjacentes quanto quaisquer comentários ou opções de compartilhamento que possam alterar a forma como uma determinada interação é tratada.
As políticas analisadas para esta entrada não estabelecem um período fixo de retenção, um cronograma de exclusão nem condições detalhadas para a revisão humana. Essas questões exigem os termos aplicáveis ao tratamento de dados. A exclusão do treinamento, por si só, não significa que o conteúdo nunca seja armazenado, inspecionado por motivos de segurança ou retido para outra finalidade permitida.
A visibilidade pública e o compartilhamento posterior também são questões distintas. O FAQ de treinamento citado não esclarece se outra plataforma armazena uma conversa, disponibiliza um arquivo enviado por meio de um link ou envia material para uma ferramenta separada. Para o GlobalGPT, a proteção comercial depende do contrato efetivo com o fornecedor e do serviço utilizado; o nome do modelo Claude, por si só, não confirma esses aspectos.
Verificação a ser realizada: Confirme a cobertura do serviço comercial e quaisquer permissões relacionadas a comentários ou compartilhamento de dados. As configurações do Claude do consumidor não determinam os controles aplicados à conta de API de um desenvolvedor.
Gemini: a API paga, a API gratuita e o Vertex AI apresentam diferenças
Itens do catálogo: Gemini 3.8 Flash; Gemini 3.7 Flash; Gemini 3.6 Flash; Gemini 3.5 Flash; Gemini 3.5 Flash Lite; Gemini 3.1 Pro; Gemini 3.1 Flash Lite; Gemini 3 Pro; Gemini 3 Flash; Gemini 2.5 Pro; Gemini 2.5 Flash; Gemini Omni Flash.
Âmbito: Serviços pagos ou gratuitos da API Gemini e, separadamente, o Google Cloud Vertex AI; o Gemini para consumidores não está coberto.
Treinamento: A API Gemini paga exclui prompts e respostas do processo de aprimoramento do produto; as regras para a versão gratuita são diferentes. O Vertex AI exige permissão prévia ou instruções para o treinamento ou ajuste fino do modelo.
A classificação de privacidade do Google depende do serviço. De acordo com Termos da API Gemini, Os Serviços Pagos excluem prompts e respostas para fins de aprimoramento do produto. Os Serviços Não Pagos geralmente permitem o uso para aprimoramento e a revisão humana, com disposições regionais específicas para o EEE, a Suíça e o Reino Unido. O status de “Pago” segue as definições de serviço e cobrança do Google.
Governança de dados do Vertex AI Afirma, separadamente, que o Google não treinará nem aperfeiçoará modelos de IA ou de aprendizado de máquina utilizando dados de clientes sem permissão ou instrução prévia. Esse é um compromisso do Google Cloud. Ele não deve ser substituído silenciosamente por serviços não remunerados para desenvolvedores ou pelo aplicativo Gemini para consumidores.
O Política de monitoramento de abuso da API Gemini estabelece um prazo de 55 dias para prompts, contexto e resultados. Funcionários autorizados podem analisar conteúdos sinalizados ou projetos suspeitos. Os registros de abuso são excluídos do treinamento geral de IA, com exceção dos modelos utilizados especificamente para a aplicação de políticas. O prazo de 55 dias refere-se à API Gemini, e não ao Vertex AI.
Nenhuma dessas declarações define as configurações de links públicos, o armazenamento de arquivos ou o repasse de uma plataforma. Uma assinatura GlobalGPT também não identifica o projeto ou contrato pago subjacente do Google. Para cada entrada Gemini, as questões relevantes são: qual serviço do Google a processa, se a definição de serviço pago se aplica e quais recursos adicionais de retenção são utilizados.
Verificação a ser realizada: Verifique o serviço do Google, o status de cobrança do projeto e as exceções regionais. Os dados de monitoramento de abusos podem servir de base para modelos de aplicação de políticas; uma assinatura paga não garante retenção zero universal.
API Grok: sem treinamento por padrão, com controles de retenção separados
Itens do catálogo: Grok 4,6; Grok 4,3.
Âmbito: API oficial do xAI, incluindo controles de mídia documentados; o consumidor Grok possui políticas distintas.
Treinamento: A xAI afirma que nunca realiza treinamento com entradas ou saídas da API sem permissão explícita. Esse compromisso da API não define a política do consumidor comum Grok.
Para a API oficial, Perguntas frequentes sobre segurança da xAI afirma que nunca realiza treinamento com entradas ou saídas de clientes sem permissão explícita. Isso estabelece uma configuração padrão de “sem treinamento” para esse serviço. No entanto, isso não define as regras para uma conversa pessoal no Grok ou para um modelo hospedado de forma independente.
Por padrão, as solicitações e respostas são criptografadas em repouso e armazenadas por 30 dias para viabilizar a auditoria de suspeitas de abuso ou uso indevido; em seguida, são excluídas automaticamente. Contratos corporativos negociados podem especificar prazos de retenção diferentes. A política não oferece uma garantia universal de que nenhum ser humano jamais poderá acessar o conteúdo da API.
As equipes podem ativar a Retenção Zero de Dados (ZDR), o que impede que as entradas e saídas das solicitações sejam armazenadas em disco. Há algumas restrições ao recurso: as imagens devem usar saída em base64, enquanto a entrega de vídeos requer o destino de upload do cliente, em vez do armazenamento de saída hospedado pelo xAI. O cabeçalho de resposta documentado pode confirmar se a ZDR está ativa para uma equipe específica.
A retenção zero na xAI não determina o armazenamento nem a visibilidade dos links em uma plataforma separada, em um destino externo de upload ou nos próprios sistemas do cliente. As configurações da rota xAI e da equipe da GlobalGPT não foram verificadas. Portanto, cada listagem no Grok ou no Imagine precisa do contrato de API aplicável e de controles efetivos antes de poder oferecer uma garantia de privacidade mais robusta.
Verificação a ser realizada: As equipes podem ativar a Retenção Zero de Dados, sujeito a restrições do recurso. Verifique a configuração atual da equipe; os controles de armazenamento de imagens e vídeos exigem métodos específicos de exportação.
DeepSeek: a permissão para treinamento não significa que não haja direito de recusa
Itens do catálogo: DeepSeek V4.1 Flash; DeepSeek V4 Pro; DeepSeek V4 Flash.
Âmbito: Política de privacidade do serviço oficial DeepSeek; os aplicativos de desenvolvedores terceirizados e seus contratos são independentes.
Treinamento: A política de serviços oficiais da DeepSeek permite o treinamento e o aprimoramento, ao mesmo tempo em que reconhece o direito de recusar o uso de dados pessoais para o treinamento de modelos ou a otimização técnica dentro de seu escopo.
O Política de privacidade do serviço oficial DeepSeek permite o uso para fins de treinamento e aprimoramento, ao mesmo tempo em que reconhece o direito de recusar o uso de dados pessoais para treinamento de modelos ou otimização técnica. Essa distinção é importante: a permissão para usar os dados e a possibilidade de o usuário se opor são aspectos distintos da política.
O direito de recusa identificado diz respeito aos dados pessoais. Ele não deve ser ampliado para se tornar uma garantia incondicional que abranja todos os documentos enviados, respostas geradas ou informações não pessoais. As políticas analisadas não estabelecem um botão específico para desativação do produto, nem a implementação técnica de uma solicitação e seu efeito sobre os dados já utilizados para treinamento.
Também não foram estabelecidos, para esta entrada, um período de retenção fixo, um cronograma detalhado de exclusão e condições específicas para revisão humana. A recusa em realizar o treinamento não implica necessariamente a remoção de registros necessários para operar um serviço, lidar com questões de segurança ou cumprir as obrigações aplicáveis. A exclusão de uma conversa não constitui prova de que um modelo já treinado tenha sido alterado.
Essas evidências dizem respeito ao escopo da política oficial do DeepSeek, que exclui aplicativos de desenvolvedores de nível inferior. Elas não definem o contrato do GlobalGPT com o DeepSeek, as configurações de compartilhamento público nem as práticas de armazenamento. A comparação adequada é, portanto, o treinamento permitido com um direito de recusa ao tratamento de dados pessoais documentado, enquanto o contrato de serviço de terceiros aplicável e os demais detalhes sobre o tratamento de dados ainda precisam ser confirmados.
Verificação a ser realizada: O direito de recusa em relação aos dados pessoais está documentado. Um botão específico, sua implementação técnica e seu efeito sobre treinamentos anteriores não estão estabelecidos nas políticas analisadas.
GLM por meio do Z.ai: a proteção de conteúdo por API difere dos serviços pessoais
Itens do catálogo: GLM-5.3; GLM-5.3 Flash; GLM-5.2; GLM-5.1.
Âmbito: A API empresarial/para desenvolvedores da Z.ai e, separadamente, os serviços pessoais da Z.ai; outros provedores de GLM não estão sujeitos a estes termos.
Treinamento: As solicitações e respostas da API do Z.ai estão excluídas do desenvolvimento ou aprimoramento do serviço, a menos que haja acordo explícito. Os termos do serviço pessoal permitem um uso mais amplo do conteúdo para fins de aprimoramento.
Os termos da Z.ai definem o Conteúdo do Usuário como prompts e resultados. Para empresas e desenvolvedores que utilizam sua API, seção IV.7 exclui esse conteúdo do desenvolvimento ou aprimoramento de serviços, a menos que o cliente concorde explicitamente. As disposições relativas a serviços personalizados, por outro lado, permitem o uso para fins de aprimoramento, incluindo conteúdo não pessoal para o aprendizado de máquina e o desenvolvimento de IA.
A API acordo de tratamento de dados, seção 4(b), afirma que o conteúdo fornecido e gerado é processado em tempo real e não é salvo nos servidores. A Seção 4(c) trata outros dados dos clientes separadamente: eles podem ser armazenados para fins de prestação de serviços ou por motivos legais e excluídos após o término do contrato, sujeito aos requisitos legais.
Essa garantia relativa ao armazenamento de conteúdo não significa que os detalhes da conta, as informações de pagamento ou os registros técnicos nunca sejam coletados. As políticas analisadas não estabelecem condições detalhadas para a revisão humana. O DPA descreve o tratamento de dados de maneira geral em Cingapura; essa declaração refere-se ao serviço abrangido, e não a todas as implantações do GLM em todo o mundo.
Verificação a ser realizada: Confirme se os termos específicos da API e o DPA se aplicam. Os direitos de oposição ou revogação relativos a dados pessoais não estabelecem um mecanismo específico de treinamento do consumidor nem a proteção oferecida por outro provedor.
Kimi OpenPlatform: o acesso padrão à API permite o uso para treinamento
Itens do catálogo: Kimi K3; Kimi K2.6; Kimi K2.5; Moonshot v1.
Âmbito: Termos padrão da API da Kimi OpenPlatform; acordos empresariais ou por escrito podem restringir o uso.
Treinamento: A Kimi OpenPlatform permite que o Conteúdo do Cliente seja utilizado para treinamento ou aprimoramento dos modelos da Moonshot AI, a menos que um contrato escrito separado disponha expressamente o contrário.
Kimi ilustra por que o acesso à API não é uma categoria universal de privacidade. Seu Termos da OpenPlatform, datadas de 30 de julho de 2026, permitem que o Conteúdo do Cliente seja utilizado para apoiar o desenvolvimento e o aprimoramento do serviço. Elas orientam explicitamente os clientes que desejam impor restrições ao treinamento ou ao aprimoramento do modelo a discutirem acordos corporativos ou um contrato escrito separado.
A menos que expressamente acordado de outra forma por escrito, os termos permitem os usos indicados. Isso estabelece uma permissão contratual, e não uma prova de que um determinado prompt tenha realmente sido incluído em um conjunto de dados de treinamento. Uma conta padrão de API não deve, portanto, ser classificada como protegida contra o treinamento simplesmente porque um desenvolvedor paga pelas solicitações.
O Política de privacidade da OpenPlatform, datada de 30 de abril de 2025, estabelece que as informações relativas à conta, aos dados inseridos e aos pagamentos são mantidas enquanto a conta permanecer ativa. Ela permite que determinados funcionários acessem as informações relevantes quando necessário para fins comerciais. Essas disposições não estabelecem um prazo uniforme para a exclusão nem garantem que não haja acesso humano a esses dados.
Não há definição de um mecanismo específico de treinamento para contas comuns nas políticas analisadas; o procedimento documentado é uma negociação contratual. A visibilidade pública e o repasse de dados por uma plataforma de terceiros exigem uma avaliação separada. O contrato de fornecimento da GlobalGPT pode ser diferente, mas sua cobertura não foi verificada neste contexto; portanto, a regra geral da OpenPlatform não pode estabelecer uma isenção para a empresa.
Verificação a ser realizada: Os clientes que desejarem restrições ao treinamento podem entrar em contato com a Moonshot para discutir acordos corporativos ou um contrato por escrito específico. O acesso comum à API não concede automaticamente uma isenção de treinamento.
Qwen e Wan: a Bailian do continente apresenta importantes exceções ao plano
Itens do catálogo: Qwen3.8 Max; Qwen3.8 Flash; Qwen3-30B-A3B.
Âmbito: Termos do Alibaba Cloud Bailian na China continental; o Model Studio internacional e os serviços de API de terceiros exigem uma avaliação separada.
Treinamento: A Bailian do continente exclui o treinamento de conversação sem autorização, mas o Plano Token Pessoal e o Plano de Codificação autorizam explicitamente o uso de entradas e saídas para aprimoramento do serviço e otimização do modelo.
Bailian do continente’s documentação sobre privacidade descreve a proteção contra o uso para fins de treinamento. O link relacionado contrato de prestação de serviços apresenta o detalhe essencial: a seção 6.2.5 exclui os dados de conversas do treinamento do modelo sem a autorização do cliente. Essa informação se refere à Bailian na China continental, e não, automaticamente, ao Alibaba Cloud Model Studio internacional.
A Seção 5.2.2 estabelece uma exceção importante. O Plano Token Pessoal e o Plano de Codificação autorizam o armazenamento e o uso de entradas e saídas para o aprimoramento do serviço e a otimização do modelo. A equipe do Plano Token está excluída dessa disposição. A interrupção do serviço abrangido encerra a autorização futura, mas não revoga a autorização para o conteúdo já abrangido.
A proteção de treinamento não significa retenção zero. Os dados do modelo e das chamadas do aplicativo podem ser armazenados, sendo que a retenção das conversas é limitada ao período mínimo necessário, de acordo com as obrigações aplicáveis. Não há um número universal de dias estabelecido. A seção 4.3.1 também permite a revisão técnica ou humana do conteúdo enviado e dos resultados gerados.
As APIs de terceiros apresentam outra restrição: a seção 6.2.9 submete o armazenamento, a exclusão e a filtragem de conteúdo aos termos do contrato de serviço de terceiros. Essas cláusulas não definem as configurações de links públicos nem a rota efetiva de hospedagem de áudio, Wan ou Qwen da GlobalGPT. O serviço específico, a assinatura e o contrato com o fornecedor devem ser identificados antes de atribuir ao modelo correspondente um status definitivo de “sem treinamento”.
Verificação a ser realizada: No caso de exceção ao plano, a interrupção do uso encerra a autorização futura, mas não afeta o uso de dados autorizado anteriormente. O tratamento de APIs de terceiros segue seu próprio contrato; os termos internacionais permanecem separados.
Muse Spark: a política aplicável aos serviços hospedados ainda é desconhecida
Itens do catálogo: Muse Spark 1.3; Muse Spark 1.2.
Âmbito: Listagens da plataforma Muse Spark; o mapeamento exato dos provedores e o contrato de serviço hospedado ainda não foram definidos.
Treinamento: Nas políticas analisadas, não está estabelecida uma regra de treinamento aplicável ao serviço hospedado Muse Spark mencionado; isso não indica que o treinamento ocorra.
Para as entradas do Muse Spark nesta comparação, o mapeamento exato do provedor e o contrato de serviço hospedado aplicável não estão definidos. A classificação do treinamento, portanto, é desconhecida. Trata-se de uma observação sobre as evidências de política disponíveis, e não de uma alegação de que o modelo seja treinado com prompts enviados ou respostas geradas.
Também não foram estabelecidos, nas políticas analisadas para este serviço hospedado, um período de retenção, um cronograma de exclusão e uma política detalhada de revisão humana. O nome do modelo, por si só, não permite determinar se as instruções, os arquivos enviados, os resultados e os registros técnicos recebem tratamento diferenciado, nem se há exceções aplicáveis a investigações de segurança e obrigações legais.
A mesma incerteza se aplica à visibilidade pública e ao compartilhamento posterior. A presença em uma plataforma não determina se os arquivos são privados, se os links de saída estão acessíveis a terceiros ou quais parceiros de processamento recebem o material enviado. Esses detalhes devem constar no contrato de hospedagem e na documentação do serviço aplicáveis, em vez de serem inferidos a partir da marca.
A licença de peso aberto, quando aplicável a outro modelo, rege o uso do software ou dos pesos; ela não define como uma empresa de hospedagem lida com os dados dos clientes. Para essas listagens do Muse Spark, nem um compromisso empresarial de não treinamento nem uma opção de recusa dedicada estão estabelecidos nas políticas analisadas. A classificação apropriada permanece desconhecida até que o serviço hospedado específico e seus termos sejam identificados.
Verificação a ser realizada: As políticas analisadas não estabelecem disposições relativas à exclusão de treinamento, cobertura corporativa e controles de compartilhamento público. Uma licença de uso livre não pode garantir a proteção de dados por parte de um provedor de hospedagem.
Antes de escolher um ChatGPT Plano de negócios Para uma equipe, avalie o contrato comercial aplicável e os controles administrativos, juntamente com os recursos de assinatura. Esses controles não são transferidos automaticamente para uma conta em outra plataforma.
Políticas de Privacidade do Gerador de Imagens por IA
A privacidade das imagens abrange sua solicitação, as fotos de referência enviadas, os arquivos de origem utilizados para edição e as imagens geradas. A configuração de galeria privada pode impedir que outros usuários vejam uma imagem, sem impedir que o provedor a utilize para treinamento.
Modelos de imagem OpenAI: sem treinamento por padrão por meio da API
Itens do catálogo: GPT Image 2.5; GPT Image 2.
Âmbito: API oficial de imagens OpenAI; o modelo exato e o endpoint são importantes
Treinamento: O OpenAI não utiliza prompts oficiais da API, imagens de referência ou resultados gerados para o treinamento do modelo, a menos que o cliente opte explicitamente por compartilhar os dados.
A API de imagens da OpenAI segue a política padrão aplicada a todas as suas APIs: os dados dos clientes não são utilizados para treinar ou aprimorar os modelos da OpenAI, a menos que o cliente conceda consentimento explícito. Essa distinção é importante ao enviar fotografias de referência, designs de produtos ou imagens para edição. A proteção decorre da Política de dados da API, em vez do nome de exibição do modelo de imagem.
O fato de não utilizar uma imagem para treinamento não significa que ela seja excluída imediatamente. A mesma documentação indica um período de retenção de 30 dias para monitoramento de abusos em endpoints de imagem e ausência de estado de aplicativo, sujeito às exceções listadas. Uma plataforma de terceiros também pode reter seus próprios arquivos enviados, imagens geradas ou cópias de entrega de acordo com uma programação separada.
As entradas de imagens e arquivos passam por uma triagem de segurança. Materiais que possam constituir abuso sexual infantil podem ser retidos para análise de acordo com a exceção documentada, inclusive quando a opção “Retenção Zero de Dados” estiver ativada. Consequentemente, a promessa de “sem treinamento” não significa que ninguém jamais poderá analisar o material enviado.
A “Retenção Zero de Dados” é um controle independente, baseado em aprovação, com critérios de elegibilidade específicos para cada modelo. Para um modelo de imagem oferecido por meio do GlobalGPT, o modelo específico de origem, o endpoint e os controles de conta aplicáveis determinam se essa opção se aplica. O nome por si só não é suficiente para determinar a aprovação, o desativamento do compartilhamento de dados ou o tempo de vida dos arquivos de imagem hospedados na plataforma.
Verificação a ser realizada: A retenção zero de dados requer aprovação e modelos compatíveis. Verifique o endpoint exato da imagem, as permissões de compartilhamento e o armazenamento da plataforma antes de tratar um fluxo de trabalho de imagens como retenção zero.
Modelos de imagem do Google: o serviço determina a proteção
Itens do catálogo: Nano Banana; Nano Banana 2; Nano Banana Pro.
Âmbito: Modelos de imagem Gemini e rótulos Nano Banana; a cobertura paga da API Gemini ou do Vertex AI requer confirmação.
Treinamento: A API paga Gemini exclui prompts e respostas do processo de aprimoramento do produto; o Vertex AI restringe o treinamento sem autorização. Serviços gratuitos e produtos de consumo seguem regras diferentes.
Uma foto de referência, uma instrução de edição e uma imagem gerada podem estar sujeitas às regras de conteúdo do mesmo serviço, mas o nome do modelo de imagem não identifica essas regras. As etiquetas Nano Banana precisam primeiro ser associadas a um modelo e a um serviço do Google específicos. A assinatura de outra plataforma, por si só, não determina qual contrato do Google se aplica à solicitação.
Para serviços da API Gemini pagos, O Google afirma que não utiliza prompts nem respostas para aprimorar seus produtos. Os termos abrangem arquivos enviados, como imagens. Os serviços gratuitos geralmente permitem o uso para aprimoramento e a revisão humana, com exceções regionais. Por outro lado, Governança de dados do Vertex AI restringe o treinamento ou o ajuste fino sem permissão ou instrução prévia.
Essas proteções não garantem que as imagens desapareçam imediatamente, que ninguém possa revisar o conteúdo sinalizado ou que os links gerados sejam privados. Verifique separadamente o armazenamento de arquivos enviados, o processamento de segurança e as cópias de imagem da própria plataforma. A rota exata das imagens da GlobalGPT e a cobertura contratual não foram confirmadas aqui; portanto, a proteção permanece condicional, e não uma garantia válida para todo o modelo.
Verificação a ser realizada: Confirme o modelo exato da imagem, o serviço do Google e o escopo de cobrança. Um nome Nano Banana ou uma assinatura paga do GlobalGPT, por si só, não garante a proteção aplicável.
Seedream e Seedance: a proteção BytePlus é específica para cada serviço
Itens do catálogo: Seedream 5.0 Pro; Seedream 5.0 Lite; Seedream 4.5.
Âmbito: Os serviços BytePlus AI e Model; o roteamento do Ark continental e do Seed Audio não são regidos por estes termos.
Treinamento: A BytePlus exclui os Dados do Cliente do treinamento do modelo de base, exceto no caso de feedback voluntário para melhorias, consentimento específico ou acordo por escrito. Isso não constitui automaticamente uma política da Ark.
O Termos Gerais da BytePlus para Serviços de IA contém uma restrição concreta ao treinamento com modelos de fundação. A Seção 3.3 exclui os Dados do Cliente desse treinamento, a menos que o cliente forneça voluntariamente feedback para aprimoramento ou dê consentimento ou concorde separadamente por escrito. Trata-se de um compromisso condicionado, e não de uma promessa que abranja todos os usos possíveis para sempre.
A Seção 3.1 trata os dados fornecidos aos Serviços do Modelo BytePlus como Informações Confidenciais nos termos do contrato. A Seção 3.2, no entanto, permite a retenção necessária para fins de serviço e segurança, sem estabelecer um número fixo de dias. A Seção 3.4 permite o uso de sistemas automatizados e outras medidas razoáveis para detectar e analisar abusos; ela não garante que o acesso humano seja impossível.
Para a Seedream e a Seedance, a questão relevante é se a geração realmente utiliza os serviços BytePlus abrangidos. Esses termos não podem ser automaticamente transferidos para o Volcengine Ark do continente. O mapeamento específico dos serviços da Seed Audio também permanece sem confirmação. A Seção 4 reconhece, além disso, termos distintos para componentes de terceiros. A rota da GlobalGPT, as permissões de feedback e a cobertura contratual precisam ser confirmadas antes que essa política de fornecedores se torne uma declaração sobre um modelo de plataforma específico.
Verificação a ser realizada: Confirme a cobertura do BytePlus, as permissões de feedback e quaisquer termos de terceiros. O mapeamento do serviço da Seed Audio ainda não foi confirmado; não transfira essa proteção para o Ark continental com base na associação de marcas.
Ideograma: Treinamento em serviços comuns e proteção de dados empresariais
Itens do catálogo: Ideogram 4.0; Ideogram 4.0 Turbo; Ideogram 4.0 Quality; Ideogram 3.0; Ideogram 3.0 Turbo; Ideogram 3.0 Quality.
Âmbito: Serviços do Ideogram para usuários comuns e para empresas; a cobertura do contrato de API pode variar
Treinamento: A política padrão do Ideogram permite o treinamento de modelos. Sua página “Enterprise” exclui os dados corporativos do treinamento de modelos compartilhados, enquanto o treinamento personalizado requer uma adesão voluntária; os resultados exigem confirmação separada.
O comum do Ideogram política de privacidade inclui prompts, imagens enviadas e interações entre as informações que coleta. Permite o uso dessas informações para treinar os modelos que alimentam seus serviços. Uma conta paga ou a configuração de imagem privada, portanto, não garante, por si só, que o conteúdo enviado seja excluído do treinamento.
O Oferta corporativa apresenta uma declaração mais específica: os dados de entrada da empresa não são utilizados para treinar os modelos compartilhados da Ideogram, e o treinamento personalizado com dados do cliente é opcional. Essa formulação menciona expressamente os dados de entrada. Não se trata de uma promessa igualmente explícita que abranja todos os resultados gerados ou todas as contas de API.
Para serviços comuns, a retenção dura pelo tempo que for razoavelmente necessário para os fins da apólice. Os clientes corporativos podem configurar a retenção para um período mínimo de 30 minutos, de acordo com a página corporativa. Isso se refere a uma configuração disponível, e não à exclusão automática após 30 minutos para todos os clientes, conjuntos de dados ou contas.
A visibilidade é outra configuração. A termos distinguir o conteúdo privado do conteúdo disponível para outros usuários para remixagem. A visibilidade privada não implica uma exclusão do treinamento nem proíbe totalmente o acesso do provedor. Para uso por meio do GlobalGPT, o contrato de fornecimento relevante e a configuração efetiva determinam quais proteções corporativas se aplicam.
Verificação a ser realizada: As configurações de conteúdo privado controlam a visibilidade para outros usuários. As proteções relacionadas a treinamentos corporativos e retenção de dados dependem do acordo aplicável; não há, neste caso, a opção de recusa de treinamento como parte do serviço padrão.
FLUX, da Black Forest Labs: Permissão para treinamento e controles específicos para contratos
Itens do catálogo: FLUX; FLUX 1.1 Pro; FLUX 1.1 Ultra; FLUX 1 Kontext; FLUX 2 Pro.
Âmbito: Serviços padrão do BFL, API oficial do FLUX e acordos corporativos
Treinamento: Tanto os termos padrão do BFL quanto os termos da API do FLUX permitem o treinamento de entrada/saída. As opções corporativas variam, e não se pode presumir automaticamente que a opção de exclusão do serviço padrão se aplique aos contratos da API.
A Black Forest Labs não oferece uma política padrão de exclusão de treinamento em todos os seus serviços. Sua termos comuns permitir o treinamento e o aprimoramento por meio de entradas, saídas e tarefas. O separado Termos da API FLUX também permitem expressamente o uso de entradas e saídas para treinar e aprimorar modelos de IA.
De acordo com as condições gerais, os clientes podem enviar um e-mail para legal@blackforestlabs.ai para cancelar a inscrição em futuros treinamentos da FLUX. O política de privacidade Além disso, inclui o endereço privacy@blackforestlabs.ai com o assunto “Training Opt Out”. Os usuários da API devem verificar como esse controle se relaciona com os termos e as condições de uso da API; as condições de versões beta ou de programas especiais podem variar.
A opção de exclusão tem efeito prospectivo. Ela não anula o treinamento realizado anteriormente, e os termos prevêem exceções relacionadas à segurança, conformidade legal e feedback. A retenção, por outro lado, segue os fins necessários do serviço e os objetivos comerciais legítimos, em vez de um prazo fixo de exclusão. O prazo para recuperação de um arquivo não equivale ao prazo para exclusão de todas as cópias de dados associadas.
BFL’s oferta corporativa anuncia a não retenção de dados e opções de implantação dedicadas. Essas opções exigem um acordo específico; elas não definem a configuração de uma conta de API comum. Da mesma forma, nem a etiqueta “FLUX” no GlobalGPT nem uma alegação de marketing sobre implantação privada identificam o contrato que rege uma solicitação específica.
Verificação a ser realizada: Os termos gerais oferecem a opção de cancelamento do treinamento do FLUX por e-mail. Verifique se isso está previsto nos termos específicos da API, nas condições da versão beta e nos pedidos antes de utilizá-lo para o tráfego da API.
Agnes: ainda é necessária uma política bem definida
Itens do catálogo: Agnes Image 2.1 Flash.
Âmbito: Rótulo da plataforma Agnes; a identidade do serviço de origem e o contrato aplicável ainda não foram confirmados.
Treinamento: Não foi estabelecida nenhuma política de processamento de dados específica para o modelo Agnes. Trata-se de uma lacuna nas evidências, e não de uma prova de que ocorra treinamento ou de que o conteúdo esteja protegido.
A Agnes é uma marca de modelos de plataforma, mas ainda não foi estabelecida uma política de processamento de dados específica para esses modelos. O nome, por si só, não identifica a entidade jurídica responsável, o acordo de hospedagem ou o contrato que rege o conteúdo enviado.
Portanto, as condições relativas à permissão para treinamento, aos controles de exclusão, à retenção e à revisão humana permanecem desconhecidas. Isso não significa que o treinamento ocorra ou que a exclusão seja impossível. Antes de enviar material confidencial, o que falta são evidências concretas sobre a identidade do serviço e sua política aplicável, e não uma promessa de privacidade extraída de um modelo com nome semelhante ou de um suposto fornecedor.
Verificação a ser realizada: Confirme a identidade jurídica do fornecedor anterior, o contrato de prestação de serviços e quaisquer configurações de treinamento. Não atribua à Agnes os controles de exclusão, proteção corporativa ou retenção de dados de outro provedor.
Midjourney: A visibilidade pública e a discrição são aspectos distintos do treinamento
Itens do catálogo: Midjourney (versão não especificada).
Âmbito: Termos de Serviço da Midjourney; acordos de acesso de terceiros exigem confirmação separada
Treinamento: Os termos da Midjourney concedem uma ampla licença de uso contínuo do conteúdo, mas não estabelecem, neste caso, uma promessa explícita de não uso para fins de treinamento. Essa licença, por si só, não comprova o uso efetivo para fins de treinamento.
A distinção mais clara do modelo Midjourney em matéria de privacidade diz respeito à publicação. Sua Termos de Serviço definir que o conteúdo seja, por padrão, visível ao público e possa ser reutilizado. Isso é importante para projetos de produtos ainda não lançados, fotografias de clientes e ativos da marca, mesmo antes de se considerar se algum conteúdo pode ser usado para treinar modelos.
Os termos concedem à Midjourney uma licença ampla e contínua sobre o conteúdo enviado e os ativos gerados. Eles não estabelecem um compromisso explícito de não uso para treinamento nesta comparação. Da mesma forma, uma licença ampla de conteúdo não constitui prova de que uma determinada imagem tenha realmente sido incluída no treinamento. O status do treinamento, portanto, requer uma garantia mais específica.
Os clientes dos planos Pro e Mega podem usar o recurso Stealth, pelo qual a Midjourney se compromete a envidar todos os esforços para não publicar ativos criados com esse recurso ativado. O Stealth não torna uma sala compartilhada do Discord privada: as pessoas nessa sala ainda podem visualizar o conteúdo. Os controles de publicação e os controles de treinamento respondem a questões diferentes.
Os termos citados não estabelecem um prazo único de retenção, e a licença de conteúdo permanece válida após a rescisão. A exclusão de uma conta não deve ser interpretada como a revogação automática de todos os direitos concedidos. No caso de um fluxo de trabalho Midjourney oferecido por meio de outra plataforma, é necessário analisar separadamente as condições de acesso, o comportamento de publicação e a política de armazenamento antes de enviar material confidencial.
Verificação a ser realizada: Os planos Pro e Mega Stealth oferecem o melhor esforço possível para evitar a publicação, mas não uma opção de exclusão do treinamento. O conteúdo criado em espaços compartilhados do Discord permanece visível para as pessoas com acesso a esses espaços.
A Prompt do Seedream utilizando referências a produtos pode trabalhar com uma foto pública do produto ou com um projeto confidencial pré-lançamento. A técnica de geração pode ser idêntica, mas a permissão para enviar esses arquivos não é.
Políticas de Privacidade do Gerador de Vídeos com IA
As solicitações de vídeo podem incluir o primeiro e o último quadro, imagens de rostos, filmagens de referência, fala e outros tipos de áudio. Uma declaração de retenção relativa ao clipe finalizado pode não abranger esses dados de entrada, registros de segurança ou cópias armazenadas em outros locais.
API Sora: a ausência de treinamento não significa retenção zero
Itens do catálogo: Sora 2.
Âmbito: Política de dados OpenAI /v1/videos; esta entrada não fornece nenhuma informação sobre a disponibilidade atual do serviço.
Treinamento: A tabela oficial de controles de dados da API de vídeo exclui o treinamento, sujeita à exceção geral da API para consentimento explícito de compartilhamento de dados. O Consumer Sora requer uma avaliação de política separada.
A Documentação sobre controles de dados da API indica que o endpoint de vídeo não é utilizado para treinamento, sujeito à exceção geral para clientes que optem explicitamente pelo compartilhamento de dados. Trata-se de uma constatação da política da API, e não de uma declaração sobre o Sora para consumidores nem de uma confirmação de que algum serviço esteja disponível no momento.
A mesma documentação distingue o armazenamento de vídeo do treinamento. Seu fluxo de trabalho de vídeo descreve um período de 48 horas para o download do vídeo produzido, seguido por 30 dias de retenção para monitoramento de abusos. Ela também identifica o endpoint de vídeo como inelegível para a Retenção Zero de Dados e bloqueado para solicitações de Monitoramento de Abusos Modificado ou Retenção Zero de Dados. Os controles disponíveis para terminais de texto não podem ser simplesmente considerados válidos para vídeo.
Uma marcação “Sora” em outra plataforma não revela o endpoint, a conta ou o contrato utilizado. Também não fornece nenhuma informação sobre os próprios arquivos de referência enviados pela plataforma, cópias de vídeo ou links para download. A rota da GlobalGPT permanece não confirmada; portanto, a classificação prática é de proteção condicional por API sem treinamento, com retenção documentada, em vez de uma promessa universal de que os dados de vídeo nunca são armazenados ou revisados.
Verificação a ser realizada: O endpoint de vídeo documentado não é elegível para a Retenção Zero de Dados e está bloqueado para solicitações de MAM/ZDR. Confirme a rota real, em vez de herdar os controles da API de texto.
Veo: distinguir o Vertex AI de outras vias de acesso
Itens do catálogo: Veo 3; Veo 3.1.
Âmbito: Veo por meio de um serviço identificado do Google; o acesso de consumidores e de terceiros requer avaliação separada.
Treinamento: O Vertex AI restringe o treinamento e o ajuste fino sem permissão ou instrução prévia. Essa garantia não abrange automaticamente todos os produtos de consumo Veo nem todas as formas de acesso de terceiros.
Uma geração Veo pode conter mais do que apenas um prompt de texto: imagens de referência, pessoas que aparecem nessas imagens e arquivos de vídeo gerados — todos esses elementos são relevantes para uma avaliação de privacidade. A questão prática é: qual serviço os processa e qual contrato abrange esse processamento? Um rótulo de versão Veo, por si só, não pode responder a essa pergunta.
O Google Documentação sobre governança de dados do Vertex AI afirma que os dados dos clientes não serão utilizados para treinar ou ajustar modelos de IA/ML sem permissão ou instrução prévia. Isso corrobora uma classificação condicional de “sem treinamento” para o acesso abrangido. Não estabelece tratamento idêntico em um produto de vídeo para consumidores, um provedor não relacionado ou uma plataforma que utilize uma rota de origem não confirmada.
O armazenamento de vídeos requer uma verificação específica, mesmo quando o treinamento é restrito. O prazo para download de um clipe gerado, o tempo de vida útil da mídia de referência enviada e os registros de segurança podem apresentar dados diferentes. Nenhum deles especifica por quanto tempo o GlobalGPT mantém suas próprias cópias. Antes de considerar um fluxo de trabalho Veo adequado para imagens confidenciais, verifique o serviço, o contrato e os controles de vídeo relevantes; não há aqui nenhuma garantia universal de retenção zero ou de ausência de revisão humana.
Verificação a ser realizada: Identifique o serviço, a conta e o contrato exatos antes de contar com a proteção do Vertex AI. Confirme os controles de retenção específicos para vídeos, em vez de utilizar configurações de um modelo de texto.
Seedance 1.0 Pro, Seedance 2.0, Seedance 2.0 Fast, Seedance 2.5
Para esses registros, o compromisso público relevante continua sendo a cláusula do modelo de base da BytePlus. Os quadros enviados, o áudio de referência e a mídia gerada exigem uma avaliação de armazenamento específica. O mapeamento de serviços da Seed Audio ainda não foi confirmado; não se deve presumir que a cobertura da BytePlus se aplique apenas por causa do nome “Seed”.
Veja Seedream e Seedance: a proteção BytePlus é específica para cada serviço para os termos publicados aplicáveis e os campos não preenchidos.
Kling: permissão de treinamento com rota de revogação
Itens do catálogo: Kling 2,6; Kling 3,0; Kling O1.
Âmbito: Condições de serviço padrão Kling; a cobertura de APIs corporativas e de plataforma requer confirmação separada.
Treinamento: Os termos gerais do Kling permitem o uso do conteúdo coberto para criar, testar, aprimorar e treinar modelos de IA/ML. A permissão não comprova que um determinado clipe tenha sido utilizado.
O Kling se enquadra em uma categoria que reconhece tanto a permissão para treinamento quanto uma forma de revogar a autorização. A seção 4.7.3 do seu condições de serviço ordinário permite o uso de material coberto para apoiar a criação, o teste, o aprimoramento e o treinamento de modelos de IA/ML. Isso se refere à permissão contratual; não significa que uma determinada imagem enviada ou um clipe gerado tenha sido incluído no treinamento.
A Seção 4.7.4 estabelece que os usuários que não desejarem que todo ou parte de seu Conteúdo continue sendo utilizado poderão revogar a autorização enviando um e-mail para support@kling.ai. Afirmar que é impossível cancelar a adesão ao Kling omitiria, portanto, um caminho documentado. A cláusula não estabelece um controle da conta com um único clique, um prazo de processamento garantido nem a reversão do treinamento de modelos anteriores.
A revogação e a exclusão devem continuar sendo questões distintas. Essas cláusulas não estabelecem um período comum de retenção nem garantem a remoção de todas as cópias armazenadas. Os serviços corporativos podem ter regras adicionais, e o contrato de acesso efetivo da GlobalGPT não está confirmado. Aplique a conclusão relativa a serviços comuns apenas quando esses termos regerem a geração, em vez de atribuir um único veredicto de privacidade a todas as versões do modelo Kling.
Verificação a ser realizada: A Seção 4.7.4 permite a revogação da autorização por meio de e-mail enviado para support@kling.ai. Não se trata de uma opção de revogação instantânea e verificada; os termos corporativos exigem uma confirmação separada para o serviço em questão.
Wan 2.6, Wan 2.7, Wan 3.0, Wan 3.0 Prime
Para essas entradas de mídia, confirme primeiro se a solicitação utiliza o serviço Bailian abrangido, um contrato de API separado ou outro provedor. O rótulo do catálogo não determina a cobertura contratual. Mídias de referência, scripts e arquivos gerados também necessitam de controles de armazenamento e acesso além da cláusula geral relativa aos dados de conversas.
Veja Qwen e Wan: a Bailian do continente apresenta importantes exceções ao plano para os termos publicados aplicáveis e os campos não preenchidos.
Runway: os termos do idioma comum e do idioma empresarial levam a resultados diferentes
Itens do catálogo: Runway Gen-4 Turbo.
Âmbito: Serviços comuns do Runway em comparação com os Serviços Empresariais do Runway.
Treinamento: Os termos padrão do Runway permitem o treinamento e o aprimoramento de entrada/saída. Os termos corporativos proíbem expressamente o uso do Conteúdo do Cliente como dados de treinamento para os Serviços quando esse contrato for aplicável.
O Runway ilustra por que uma resposta simples de “sim” ou “não” no nível do modelo pode induzir a erro. Seu termos comuns Permite que as entradas e saídas sejam utilizadas para treinar e aprimorar modelos de IA e tecnologias relacionadas. O pagamento pelo acesso, por si só, não substitui esse acordo pela proteção do Enterprise.
O separado Termos dos Serviços Empresariais afirma: “O Runway não pode utilizar o Conteúdo do Cliente como dados de treinamento para os Serviços.” Trata-se de uma restrição contratual explícita, com uma categoria de conteúdo e um escopo de serviço definidos. Um nome de modelo, como Gen-4 Turbo, não determina se a solicitação está abrangida por essa restrição.
As restrições ao treinamento também deixam outras questões de privacidade em aberto. As cláusulas citadas não estabelecem um prazo universal de retenção de conteúdo, não garantem nenhuma avaliação de segurança nem determinam como outra plataforma armazena os vídeos gerados. Não foi estabelecida aqui uma opção de exclusão do treinamento no serviço padrão. Para o GlobalGPT, o detalhe decisivo que falta é o serviço Runway efetivamente contratado e sua cobertura, seguido pelas configurações aplicáveis de armazenamento e exclusão.
Verificação a ser realizada: Verifique se o contrato corporativo realmente abrange a solicitação. O acesso pago comum não é equivalente, e não foi estabelecida, neste caso, uma opção de exclusão do treinamento do serviço padrão.
Luma: Compromissos relativos à API e à solução empresarial sem necessidade de treinamento
Itens do catálogo: Flash Luma Ray 2.
Âmbito: Serviços da web comuns da Luma versus contratos de API e empresariais
Treinamento: Os termos de uso padrão da Luma para a versão gratuita e paga da web permitem o treinamento. Os termos de uso da API excluem o treinamento de entrada/saída da API, enquanto a versão Enterprise oferece uma “Garantia de Não Treinamento” separada.
A Luma estabelece uma distinção significativa entre o uso comum da web e o acesso protegido por API ou empresarial. Sua termos comuns conceder direitos de treinamento sobre os dados de entrada e saída, tanto do uso gratuito quanto do pago da web. A aquisição de uma assinatura comum, portanto, não estabelece as mesmas condições de privacidade que um contrato corporativo.
Seção 10 da Termos da API exclui as entradas e saídas da API do treinamento, do ajuste fino ou de qualquer outro tipo de desenvolvimento dos modelos da Luma. Esse compromisso se aplica especificamente ao acesso à API regido por esses termos. O Acordo empresarial inclui, separadamente, uma Garantia de Ausência de Trens para entradas e saídas.
Nenhuma dessas disposições implica que todo o conteúdo desapareça imediatamente. O prazo de 30 dias após o término do contrato para exportação de dados não constitui um prazo para exclusão automática. Clientes corporativos podem solicitar a exclusão de conteúdo por escrito, enquanto cópias de backup padrão podem continuar sujeitas a obrigações de confidencialidade. O política de privacidade também descreve exceções legais e outras exceções relacionadas à retenção.
Os termos comuns de uso livre incluem direitos mais amplos de exibição pública e distribuição. A exclusão de uma conta comum não revoga as licenças relativas a materiais já incorporados em modelos, sistemas ou dados agregados. O nome de um modelo do Ray, por si só, não permite identificar o contrato aplicável nem determinar como uma plataforma independente, incluindo a GlobalGPT, armazena as mídias enviadas e os clipes gerados.
Verificação a ser realizada: Confirme a cobertura do plano API ou Enterprise para proteção sem treinamento. A exclusão normal da conta não revoga os direitos sobre o conteúdo já incorporado a modelos, sistemas ou dados agregados.
API MiniMax: a melhoria do serviço é explícita, mas o escopo do treinamento ainda não foi definido
Itens do catálogo: MiniMax-H3.
Âmbito: Termos da plataforma API MiniMax; o tratamento de serviços ao consumidor Hailuo não está definido aqui.
Treinamento: Os termos da API MiniMax permitem o uso de conteúdo de entrada e gerado para o desenvolvimento e aprimoramento do serviço. Eles não estabelecem, neste contexto, uma proibição geral de treinamento nem um escopo preciso para o treinamento.
O Termos da API MiniMax permitir que as entradas e o conteúdo gerado sejam utilizados para fornecer, manter, desenvolver e aprimorar os serviços, além de fins de segurança e legais. Trata-se de uma autorização explícita para aprimoramento. Não é prova suficiente afirmar que toda solicitação treina um modelo, e isso não constitui uma promessa geral de que não haverá treinamento.
O Política de privacidade da API limita o uso de dados pessoais para treinamento com o objetivo de criar perfis ou direcionar anúncios aos consumidores. A limitação da finalidade é importante: resumir essa regra para “MiniMax não utiliza dados pessoais para treinamento” alteraria seu significado. A mesma política utiliza critérios de finalidade necessária e de retenção legal, em vez de um prazo fixo de vida útil de entrada/saída.
Nenhum mecanismo específico de exclusão do treinamento, nenhum compromisso universal de não revisão humana e nenhum acordo comercial separado de não treinamento foram estabelecidos neste caso. A exclusão de dados pessoais ou a revogação do consentimento não devem substituir um controle de treinamento. Essas conclusões dizem respeito à plataforma de API, e não ao serviço ao consumidor Hailuo. As etiquetas de áudio ou vídeo MiniMax da GlobalGPT ainda precisam de um caminho exato e de um acordo antes que uma classificação de privacidade mais rigorosa seja justificada.
Verificação a ser realizada: Não foi estabelecida uma opção de exclusão específica para treinamento. Os direitos de exclusão ou revogação de dados pessoais são controles distintos, e quaisquer restrições comerciais específicas exigem confirmação para esta conta.
Grok Imagine, Grok Imagine 1,5
Para o Grok Imagine, o compromisso oficial com a API da xAI depende da cobertura da API. A distribuição de mídia e as restrições de retenção zero exigem atenção especial: os links de imagens ou vídeos gerados podem ter um tempo de vida diferente do dos registros de solicitações.
Veja API Grok: sem treinamento por padrão, com controles de retenção separados para os termos publicados aplicáveis e os campos não preenchidos.
Happy Horse: o acordo de acesso ainda não foi confirmado
Itens do catálogo: Happy Horse 1.0.
Âmbito: Inscrição na plataforma Happy Horse; a identidade do remetente e os termos aplicáveis ao tratamento de dados ainda não foram confirmados.
Treinamento: Ainda não foi estabelecida uma política de treinamento específica para o modelo Happy Horse. Não se deve inferir nem permissão nem proibição com base apenas no rótulo do modelo.
A Happy Horse continua sendo um caso de política indeterminada, pois os termos específicos do modelo aplicáveis ao processamento de dados ainda não foram estabelecidos. O nome da plataforma não é suficiente para identificar o provedor responsável nem para determinar o contrato que rege uma solicitação de vídeo.
Isso deixa sem resposta as questões relacionadas ao tratamento de mídia de referência, permissão para treinamento, disponibilidade de opção de exclusão, condições de retenção e revisão. O fato de um clipe gerado estar disponível para download não indica se outras cópias ou registros permanecem. A evidência correta a ser considerada em seguida é o próprio serviço de origem e o contrato correspondente; nem uma garantia de ausência de treinamento nem uma alegação de treinamento inevitável se justificam com base nas informações atuais.
Verificação a ser realizada: O contrato efetivo com o prestador de serviços, os controles de treinamento e as exceções corporativas precisam ser confirmados. Não atribua uma identidade de fornecedor nem herde os controles de privacidade de outro modelo sem comprovação.
Vídeo do FLUX 3: não herdar termos do modelo de imagem
Itens do catálogo: Vídeo do FLUX 3.
Âmbito: Inscrição na plataforma de vídeo FLUX 3; o mapeamento de fornecedores e serviços ainda não foi confirmado.
Treinamento: Não há nenhuma política de treinamento específica para o modelo FLUX 3 Video. O fato de a marca ser semelhante não justifica a aplicação dos termos de serviço de imagens da Black Forest Labs a esta entrada.
O FLUX 3 Video precisa de sua própria identificação de serviço e de uma política de tratamento de dados aplicável. O fato de haver uma palavra em comum no nome não prova que o conteúdo seja fornecido pela Black Forest Labs ou regido pelos termos de uso da imagem do FLUX.
A permissão para treinamento, os controles de exclusão, a retenção e a revisão humana continuam sem confirmação para essa rota de vídeo. Nenhum desses aspectos deve ser extraído de um endpoint de imagem ou inferido a partir da marca do modelo. A falta de evidências sustenta uma classificação “desconhecida”, e não uma afirmação de que o conteúdo deva ser usado para treinamento ou de que o serviço ofereça proteção corporativa sem treinamento.
Verificação a ser realizada: Identifique o fornecedor efetivo e o contrato de vídeo antes de atribuir a opção de exclusão do treinamento ou a cobertura corporativa. O uso compartilhado de uma marca não constitui prova suficiente de proteção contratual.
Agnes Video 2.0, Agnes Video 2.5, Agnes Video 2.5 Flash
Os vídeos inscritos compartilham a questão ainda não resolvida sobre a identidade do serviço descrita para o Agnes Image. Não foram estabelecidas, para essas versões em vídeo, nenhuma permissão de treinamento específica para o modelo, nenhum cronograma de retenção nem nenhuma opção de recusa.
Veja Agnes: ainda é necessária uma política bem definida para os termos publicados aplicáveis e os campos não preenchidos.
Quando você reutiliza material de referência para personagens de vídeo gerados por IA consistentes, o mesmo rosto ou produto identificável pode ser enviado em várias solicitações. Verifique a política de cada serviço envolvido, incluindo ferramentas separadas de voz ou sincronização labial.
Políticas de Privacidade de Áudio, Música e Fala com IA
A privacidade do áudio abrange mais do que apenas o arquivo MP3 final. Letras de músicas, roteiros, gravações de referência, amostras de voz e transcrições podem ter diferentes usos e períodos de retenção. O consentimento para clonar a voz de alguém também é distinto da permissão para usar essa gravação no treinamento de modelos.
Qwen Áudio 3.0
Para essas entradas de mídia, confirme primeiro se a solicitação utiliza o serviço Bailian abrangido, um contrato de API separado ou outro provedor. O rótulo do catálogo não determina a cobertura contratual. Mídias de referência, scripts e arquivos gerados também necessitam de controles de armazenamento e acesso além da cláusula geral relativa aos dados de conversas.
Veja Qwen e Wan: a Bailian do continente apresenta importantes exceções ao plano para os termos publicados aplicáveis e os campos não preenchidos.
Seed Audio 1.0
Para esses registros, o compromisso público relevante continua sendo a cláusula do modelo de base da BytePlus. Os quadros enviados, o áudio de referência e a mídia gerada exigem uma avaliação de armazenamento específica. O mapeamento de serviços da Seed Audio ainda não foi confirmado; não se deve presumir que a cobertura da BytePlus se aplique apenas por causa do nome “Seed”.
Veja Seedream e Seedance: a proteção BytePlus é específica para cada serviço para os termos publicados aplicáveis e os campos não preenchidos.
ElevenLabs: uma opção de exclusão de treinamento prospectiva
Itens do catálogo: Eleven Music; Eleven Multilingual v2; Eleven v3.
Âmbito: Serviços padrão ElevenLabs; o processamento corporativo/comercial é regulamentado separadamente.
Treinamento: Os termos padrão do ElevenLabs permitem o uso de conteúdo relacionado a treinamento e oferecem a opção de recusa. O tratamento de dados para clientes corporativos ou empresariais depende do contrato aplicável e do Adendo de Tratamento de Dados.
O ElevenLabs oferece uma opção documentada, em vez de uma configuração padrão incondicional que exclui o treinamento, para seus serviços padrão. Seu termos permite que os usuários optem por não permitir o uso de seu conteúdo para treinamento por meio do menu “Uso de dados”, na seção “Termos e Privacidade”. A alteração não anula usos anteriores nem os materiais resultantes desses usos.
O política de privacidade explica separadamente que o tratamento de dados pessoais em nome de clientes corporativos ou empresariais é regido pelo contrato entre as partes e pelo Adendo de Tratamento de Dados. Consequentemente, uma conta padrão, um contrato corporativo e uma integração por API não devem ser tratados como intercambiáveis simplesmente porque utilizam o mesmo modelo de voz ou música.
Para entradas relacionadas ao Eleven Music, Eleven Multilingual ou Eleven v3, verifique o produto original, a conta e a opção de treinamento. A configuração do GlobalGPT não foi confirmada aqui. A opção de recusa não implica retenção zero, links de saída privados ou a ausência de revisão de segurança. A permissão para clonar ou reproduzir a voz de alguém também é independente da possibilidade de o provedor usar o conteúdo enviado para aprimorar seus modelos.
Verificação a ser realizada: O menu “Termos e Privacidade > Uso de dados” da conta oferece a opção de recusa do treinamento. Verifique se a configuração está ativa e qual é o seu escopo; o consentimento para a clonagem de voz é um requisito à parte.
Mureka: os termos atuais do acordo de controle ainda precisam ser confirmados
Itens do catálogo: Mureka v9.
Âmbito: Inclusão da plataforma Mureka v9; os termos atuais do serviço de controle e o contrato de API ainda não foram confirmados.
Treinamento: Os termos de controle atuais não foram verificados para este modelo e serviço. Não se deve invocar, com base em evidências incompletas, nem uma garantia de ausência de treinamento nem a necessidade inevitável de treinamento.
O Mureka v9 deve permanecer sem classificação para treinamento até que o atual acordo de controle seja confirmado. O Mureka publica termos de serviço e um política de privacidade, mas as evidências disponíveis para essa comparação não determinam qual versão atual rege a rota de acesso efetiva desse modelo. O texto da apólice mais antigo não deve ser apresentado como uma promessa ou permissão atual.
Essa incerteza vai além de uma simples resposta de “sim” ou “não” em relação ao treinamento. O tratamento dado às letras enviadas, aos áudios de referência, às músicas geradas e às informações da conta pode variar, assim como os contratos de serviços comuns e de API. Um direito geral de revogar o uso do conteúdo não significa automaticamente uma opção de exclusão específica do treinamento, e uma solicitação de exclusão não garante que todas as categorias de dados sigam o mesmo prazo.
Por enquanto, a conclusão relevante é específica: a permissão atual para treinamento, os controles de treinamento, os períodos de retenção e as exceções comerciais permanecem sem confirmação. Isso não prova que a Mureka realize treinamento com material do cliente, nem que garanta a ausência de treinamento. É necessário o mapeamento exato do modelo da GlobalGPT e o contrato aplicável antes que qualquer afirmação possa ser feita sobre sua entrada na Mureka.
Verificação a ser realizada: A opção de exclusão específica para treinamento e quaisquer exceções relacionadas à API ou à empresa continuam sem confirmação. Uma licença geral e revogável de conteúdo não estabelece um controle eficaz sobre o treinamento.
Lyria: o aprimoramento do produto e o treinamento sobre modelos de segurança são diferentes
Itens do catálogo: Google Lyria 3 (página inicial).
Âmbito: Lyria por meio da API Gemini; o selo Lyria 3 da plataforma exige um mapeamento exato de modelos e serviços.
Treinamento: A API Gemini paga exclui o uso de prompts e respostas para fins de aprimoramento de produtos. Os dados de monitoramento de abusos incluem uma exceção para modelos de treinamento utilizados especificamente para a aplicação de políticas.
Documentos do Google Prévia do Lyria 3 Pro na API Gemini. Isso define um contexto oficial de serviço, mas não comprova que uma marca de plataforma chamada Lyria 3 utilize exatamente esse modelo ou conta. A categoria de serviço aplicável — paga ou gratuita — continua sendo relevante.
Sob o termos do serviço pago, O Google não utiliza prompts nem respostas para aprimorar seus produtos. Os serviços não pagos geralmente permitem o uso para fins de aprimoramento e revisão humana, sujeito a exceções regionais. Essas categorias não devem ser combinadas com o aplicativo Gemini para consumidores nem com outros serviços do Google Cloud.
O política de monitoramento de abusos especifica um período de retenção de 55 dias para prompts, contexto e resultados, e permite que pessoal autorizado analise o conteúdo sinalizado. Os dados registrados não são utilizados para treinamento de IA/ML, exceto no caso de modelos especificamente utilizados para a aplicação de políticas. Portanto, uma promessa de que nenhum modelo de IA jamais aprenda com os dados seria muito ampla. A elegibilidade para retenção zero específica da Lyria e as configurações de upstream do GlobalGPT permanecem não confirmadas.
Verificação a ser realizada: Confirme o status de projeto pago e o serviço específico da Lyria. Não descreva a política como uma proibição total do treinamento de IA, pois os modelos de aplicação de políticas estão expressamente isentos.
Os dados de entrada em geração musical com ElevenLabs diferenciam-se dos roteiros de narração utilizados em Qwen conversão de texto em fala. Leve em consideração a letra da música, o roteiro confidencial ou a voz reconhecível que você está enviando antes de escolher qualquer um dos serviços.
Políticas de Privacidade de Modelos 3D de IA
Uma solicitação 3D pode apresentar um produto sob vários ângulos e gerar geometria, texturas e materiais reutilizáveis. A privacidade das fotos enviadas, as permissões para treinamento de modelos, a visibilidade da galeria de recursos e a retenção de malhas são questões distintas.
Hunyuan3D: A Tencent Cloud protege os dados de entrada contra o aprimoramento não autorizado de modelos
Itens do catálogo: Hunyuan 3D 3.1.
Âmbito: A API Hunyuan3D da Tencent Cloud e seus termos relativos a modelos de grande porte incorporados
Treinamento: A Tencent Cloud exclui o conteúdo de entrada do desenvolvimento e aprimoramento de algoritmos ou modelos sem consentimento específico. A cláusula citada não prevê expressamente a mesma proibição para os resultados.
Da Tencent Cloud Termos do produto Hunyuan3D incorporar explicitamente os termos de serviço relativos aos modelos de grande porte. A cláusula 4.2 desses termos de serviço afirma que o conteúdo inserido não será utilizado para desenvolver ou aprimorar algoritmos ou modelos do serviço sem autorização específica. Trata-se de uma proteção específica para os dados inseridos no serviço em nuvem.
A redação do texto é importante para fluxos de trabalho de conversão de imagem para 3D: uma imagem de referência enviada é diferente da malha ou textura resultante. A cláusula abrange expressamente as entradas. Ela não estabelece uma proibição igualmente explícita quanto ao treinamento com saídas; portanto, os clientes que precisarem de proteção para todos os ativos gerados devem obter uma confirmação que abranja também essa categoria.
A cláusula 2.13 descreve o tratamento de dados na China continental e a retenção pelo período necessário para a prestação do serviço. Após o término do tratamento, o uso dos dados é interrompido, ou os dados são devolvidos ou excluídos de acordo com as instruções, sujeito a exceções legais e técnicas. Não há um número fixo de dias de retenção nesta disposição.
A cláusula 2.9 permite a análise de segurança dos dados de entrada e dos resultados gerados. A restrição ao uso dos dados de entrada, portanto, não significa que o conteúdo seja isento de análise ou que todo o acesso do provedor seja impedido. Esses compromissos da Tencent Cloud também não abrangem automaticamente o site de consumidores da Hunyuan, um modelo auto-hospedado ou a implantação de outro provedor. Um selo do modelo GlobalGPT não identifica qual acordo se aplica.
Verificação a ser realizada: A autorização separada constitui a exceção declarada ao uso de dados de entrada. Confirme a cobertura do contrato da Tencent Cloud; o site de consumidores da Hunyuan, os modelos abertos e outros servidores não compartilham automaticamente esses termos.
Meshy: Direitos de treinamento e regras distintas para retenção de ativos 3D
Itens do catálogo: Meshy 7.
Âmbito: Serviços Meshy comuns, API e Enterprise; exceções específicas de pedidos
Treinamento: O Meshy permite o uso de entradas e saídas que não sejam da Enterprise para treinar, validar, testar ou aprimorar serviços, a menos que o pedido indique o contrário. A exclusão da Enterprise exige a verificação da proteção contratual efetiva.
Meshy’s termos permitir o uso de entradas e saídas de clientes que não sejam do Enterprise para treinar, validar, testar ou aprimorar seus serviços, a menos que a ordem disponha de outra forma. No caso da geração 3D, isso pode abranger o material de referência enviado e os ativos gerados. Clientes pagantes comuns não são automaticamente excluídos dessa permissão.
A cláusula relativa à permissão para treinamento exclui os clientes Enterprise. Isso é significativo, mas a exclusão, por si só, não constitui uma garantia de que nenhuma categoria de dados corporativos será utilizada para qualquer tipo de treinamento. Um contrato Enterprise deve estabelecer a restrição específica, seu escopo e quaisquer condições de tratamento acordadas separadamente.
A retenção possui regras de ativos excepcionalmente concretas: as saídas da API que não sejam da versão Enterprise são excluídas três dias após a geração. As saídas da versão Enterprise são retidas indefinidamente por padrão, com exclusão automática configurável de um a 30 dias ou um período diferente. Essas regras se referem aos objetos de saída; elas não determinam a exclusão correspondente de entradas, registros ou cópias de treinamento.
Usuários pagantes comuns podem manter o conteúdo privado sem cancelar a permissão de treinamento. Os limites de armazenamento do aplicativo web e a limpeza de contas inativas voltaram a ser tratados separadamente. Os termos também excluem as entradas e saídas dos clientes das Estatísticas Agregadas. Para projetos confidenciais, avalie a autorização de treinamento, a visibilidade das saídas e cada categoria de armazenamento de forma independente, em vez de considerar um download que desaparece como um apagamento completo dos dados.
Verificação a ser realizada: A opção de conteúdo privado pago não cancela a permissão de treinamento. Verifique as restrições corporativas ou específicas do pedido e as configurações de retenção de resultados separadamente da visibilidade e da exclusão geral da conta.
Tripo: As entradas e saídas dos usuários pagantes têm uma restrição explícita de treinamento
Itens do catálogo: Tripo h3.1.
Âmbito: Seção de usuários pagos do Tripo; os serviços gratuitos e as configurações de acesso variam
Treinamento: Os termos de uso para usuários pagos da Tripo excluem explicitamente as entradas e saídas relacionadas ao treinamento, à validação, aos testes ou ao aprimoramento da tecnologia de IA. Essa proteção não deve ser automaticamente estendida aos usuários gratuitos.
Tripo’s Termos para usuários pagos declarar expressamente que os dados de entrada e saída não serão utilizados como dados de treinamento para treinar, validar, testar ou aprimorar a tecnologia de IA. Essa é uma garantia mais específica do que simplesmente afirmar que os usuários são proprietários dos modelos gerados, pois aborda diretamente o uso permitido pelo provedor.
A declaração aparece na seção destinada a usuários pagantes. Os usuários gratuitos têm disposições distintas e mais amplas sobre direitos de conteúdo; portanto, uma conta gratuita não deve herdar essa conclusão relativa ao serviço pago. Da mesma forma, o pagamento do GlobalGPT, por si só, não determina qual conta Tripo, acordo de API ou contrato posterior rege uma determinada solicitação de modelo.
O armazenamento e a publicação continuam sendo questões distintas. O Tripo não se compromete a preservar as entradas e saídas por um período fixo comum. O encerramento da conta pode remover o conteúdo da conta, mas o material anteriormente publicado em áreas públicas pode ser mantido permanentemente. O política de privacidade também oferece uma opção para solicitar o cancelamento da conta.
Os usuários são responsáveis por selecionar um nível adequado de acesso ao conteúdo, e os termos alertam que, caso nenhum nível seja selecionado, a configuração padrão poderá ser a mais permissiva. Portanto, um compromisso pago sem treinamento não torna automaticamente privada uma imagem de referência ou um recurso 3D. Os clientes que precisarem de confidencialidade devem confirmar tanto a cobertura contratual quanto as configurações reais de acesso.
Verificação a ser realizada: Verifique se os termos do serviço pago aplicáveis abrangem a conta e a rota da API. Selecione as configurações de acesso ao conteúdo separadamente; a proteção paga contra treinamento não torna automaticamente os ativos privados.
Rodin e Hyper3D: a proteção de dados privados tem um escopo definido
Itens do catálogo: Rodin Gen-2.
Âmbito: Termos do Hyper3D, política de privacidade e armazenamento de recursos gerados pela API
Treinamento: A Hyper3D restringe a exibição de resultados privados do Rodin à conta do usuário, de acordo com seus termos. Essa proteção limitada não estabelece uma proibição abrangente de treinamento que inclua prompts, resultados comuns e o uso da API.
Da Hyper3D termos oferecem uma proteção específica para os resultados do Rodin marcados como “privados”: outros usuários não podem acessá-los, a menos que sejam compartilhados, e a Hyper3D afirma que não utilizará esses resultados, exceto para exibi-los na conta. Essa declaração se refere especificamente aos resultados privados, e não a todo o conteúdo enviado.
Consequentemente, a cláusula de resultados privados não estabelece um acordo abrangente de proibição de treinamento que cubra prompts, referências enviadas, resultados comuns ou todos os fluxos de trabalho da API. Um cliente que deseje proteger um produto ainda não lançado deve buscar uma solução tanto para as imagens de referência quanto para a malha gerada. A situação de uma categoria não resolve a da outra.
O política de privacidade relaciona a retenção de dados inseridos, comentários e reações à retirada, exclusão ou desativação da conta, seguida de exclusão ou anonimização, sujeita a exceções. Por outro lado, o Oferta de API anuncia a retenção por tempo indeterminado de ativos gerados por API. Essas declarações descrevem diferentes categorias de dados e devem ser lidas em conjunto.
As disposições de moderação de conteúdo ainda permitem o acesso a prompts e resultados; portanto, a visibilidade privada não garante que não haja revisão. Para um modelo Rodin acessado por meio do GlobalGPT, é necessário confirmar separadamente o contrato de API aplicável, as configurações de resultados privados e as práticas de armazenamento da plataforma antes de considerar todo o fluxo de trabalho protegido contra o treinamento.
Verificação a ser realizada: Marcar o conteúdo de Rodin como privado restringe o acesso de outros usuários e limita o uso especificado desse conteúdo. Confirme separadamente o tratamento de solicitações, os termos de treinamento da API e qualquer proteção empresarial antes de enviar referências confidenciais.
TRELLIS: O provedor de hospedagem determina o tratamento dos dados
Itens do catálogo: TRELLIS 3D.
Âmbito: O projeto-modelo TRELLIS versus o serviço que o executa
Treinamento: O projeto TRELLIS não estabelece uma política comum de proibição de treinamento para todas as implantações hospedadas. A permissão para treinamento depende do serviço que processa as imagens de referência e os ativos gerados.
O TRELLIS é um projeto-modelo, e não um serviço de hospedagem administrado de forma centralizada. O página oficial do projeto da Microsoft links para o código e uma demonstração. Esses recursos explicam a tecnologia e como acessá-la, mas não estabelecem um contrato de privacidade comum para todas as empresas que utilizam o modelo.
Em um fluxo de trabalho hospedado de conversão de imagem para 3D, os dados relevantes podem incluir imagens de referência, geometria gerada, texturas e metadados da solicitação. O fato de o provedor utilizar esses materiais para treinamento depende dos termos de serviço da própria empresa e de qualquer contrato com o cliente. O licenciamento de código aberto controla o uso do software ou do modelo; ele não responde a essa questão relacionada ao tratamento de dados.
Consequentemente, não há um período de retenção ou controle de exclusão universal no TRELLIS. O anfitrião pode aplicar regras diferentes a imagens enviadas, ativos finalizados, registros e cópias de entrega. A remoção de um link de download não significa que todos os registros associados tenham sido apagados, e a propriedade da malha resultante não garante a confidencialidade.
No caso do TRELLIS por meio do GlobalGPT ou de outra plataforma, a garantia necessária é uma política do provedor que abranja treinamento, armazenamento, acesso e exclusão. A hospedagem própria também exige o entendimento dos registros e das conexões externas da implantação. Até que esses detalhes sejam estabelecidos, o status de privacidade do fluxo de trabalho hospedado permanece desconhecido; essa incerteza não constitui evidência de que o treinamento realmente ocorra.
Verificação a ser realizada: Identifique o provedor de hospedagem e o contrato aplicável e, em seguida, confirme os controles de uso, exclusão e acesso. A disponibilidade de código aberto, por si só, não oferece nenhuma garantia quanto à privacidade de um serviço hospedado.
Para Geração de imagens em 3D com o Hunyuan3D, comece verificando quem hospeda o modelo e o que acontece com a foto enviada. O acesso a uma malha para download não significa necessariamente que a imagem original tenha sido excluída.
O que a Política de Privacidade da GlobalGPT abrange
O política de privacidade afirma: Não utilizamos o conteúdo dos usuários para treinar modelos de IA, a menos que isso seja explicitamente divulgado e autorizado.
Essa é uma declaração com ressalvas sobre o próprio uso de conteúdo pela plataforma, e não uma promessa incondicional de que nenhum dado será, em hipótese alguma, retido ou analisado.
A mesma política descreve o compartilhamento com prestadores de serviços e a retenção de informações pessoais para os fins para os quais foram coletadas e para o cumprimento das exigências legais aplicáveis. Sua seção relacionada à IA permite a revisão humana quando necessário por motivos de segurança, prevenção de abusos ou conformidade legal.
O aviso público não fornece uma lista modelo a modelo dos contratos corporativos de fornecedores assinados, configurações de retenção ou permissões de treinamento. Por esse motivo, este artigo não indica que nenhum modelo específico tenha um contrato corporativo específico confirmado no GlobalGPT. As proteções aos provedores descritas acima se aplicam apenas quando o serviço e o contrato relevantes regem a solicitação.
Para trabalhos confidenciais, solicite a confirmação do provedor ou host do modelo específico, a cláusula de proibição de treinamento aplicável, quaisquer exceções relativas ao feedback, os períodos de retenção para entradas e saídas e o processo de exclusão. O histórico da conta, os ativos gerados e os registros de auditoria de origem podem ser tratados separadamente.
As ferramentas podem envolver processadores de dados adicionais
O AI Note Taker, o ChatPDF, os assistentes de pesquisa, a tradução de vídeos, a sincronização labial e as ferramentas de edição de imagens podem envolver mais de um modelo ou serviço. No caso de notas de reuniões, por exemplo, um serviço pode transcrever o áudio e outro pode resumir a transcrição. Ambos precisam de uma política de dados aplicável.
A comparação, que inclui 121 itens, abrange os modelos citados no instantâneo do catálogo, em vez de considerar essas ferramentas como modelos básicos adicionais. Nesta análise, não foi estabelecida uma lista específica de processadores e regras de retenção para cada ferramenta.
Como gerenciar a privacidade dos seus dados de IA
A privacidade de dados na IA generativa envolve permissões de treinamento, retenção, acesso e compartilhamento em todo o fluxo de trabalho. Utilize as verificações a seguir ao escolher um serviço ou ao analisar uma conta existente.
Verifique a permissão de treinamento separadamente da permissão de armazenamento
Procure uma cláusula que abranja tanto as entradas quanto as saídas. Anote se ela exclui o treinamento de modelos-base, todo o treinamento de modelos ou apenas uma finalidade mais restrita. Uma exceção para classificadores de segurança é diferente da permissão para treinar um modelo de uso geral.
Utilize o procedimento de recusa documentado antes de enviar novos trabalhos
Caso o serviço ofereça uma configuração de uso de dados, desative a permissão relevante e verifique quando ela entrará em vigor. Caso os termos exijam um e-mail ou contrato, utilize esse mecanismo. O cancelamento de assinatura de comunicações de marketing ou a configuração “Não rastrear” do navegador não constituem uma opção de exclusão do treinamento do modelo.
Definir a visibilidade da saída de forma independente
Confira galerias, links de compartilhamento, espaços de trabalho públicos e salas de colaboração. As configurações “Privado” ou “Discreto” dizem respeito à visibilidade; elas não alteram automaticamente a licença de treinamento do provedor nem o acesso à moderação.
Exclua os objetos de dados corretos
Um bate-papo, um arquivo enviado, um recurso gerado, um perfil de voz e uma conta podem ter controles de exclusão diferentes. Pergunte o que permanece nos backups, nos registros de auditoria e em sistemas de terceiros. Um link de download expirado não garante que todas as cópias tenham sido apagadas.
Reduza o nível de confidencialidade do que você enviar
Utilize um contrato com informações ocultadas, uma fotografia pública do produto, um exemplo fictício de cliente ou uma amostra de gravação autorizada quando isso for suficiente para a tarefa. Remova nomes desnecessários, números de conta, metadados ocultos e detalhes confidenciais do projeto antes do envio.
Perguntas frequentes sobre privacidade de dados em IA
Quais modelos de IA não são treinados com seus dados?
Várias APIs oficiais e serviços corporativos oferecem proteções contra o treinamento, incluindo a API do OpenAI e os produtos comerciais do Anthropic, com as exceções indicadas. O serviço, o contrato e as configurações aplicáveis determinam a proteção; o nome do modelo, por si só, não é determinante.
O fato de pagar pela IA interrompe automaticamente o treinamento com meus dados?
Não. Alguns serviços pagos comuns ainda permitem o treinamento. Outros provedores distinguem entre acesso pago, por API e corporativo. Verifique a cláusula de treinamento associada ao serviço que você utiliza, em vez de tratar qualquer assinatura como um contrato corporativo.
O DeepSeek utiliza meus dados para treinamento, e eu posso optar por não participar?
A política de privacidade DeepSeek analisada permite o treinamento ou o aprimoramento de modelos e reconhece o direito de recusar o uso de dados pessoais para o treinamento de modelos ou a otimização técnica. Isso não estabelece uma opção de ativação com um clique nem os termos de um aplicativo separado a jusante.
Todas as APIs de IA são privadas por padrão?
Não. Os termos gerais da Kimi OpenPlatform permitem que o conteúdo do cliente seja utilizado para fins de treinamento, a menos que seja acordado de outra forma por escrito. Outras APIs têm configurações padrão que proíbem o uso para treinamento. O armazenamento, o acesso por pessoas e o processamento por terceiros exigem verificações específicas em ambos os casos.
A ausência de treinamento significa que não há retenção de dados?
Não. Um serviço pode excluir conteúdo do treinamento, mantendo-o, no entanto, para fins de geração, histórico da conta, segurança ou requisitos legais. Controles de retenção zero podem exigir aprovação e podem excluir modelos, endpoints ou recursos específicos.
A geração de imagens ou vídeos privados impede o treinamento?
Não necessariamente. Uma configuração privada pode limitar o que outros usuários veem, sem alterar as permissões de treinamento. Verifique separadamente a visibilidade dos resultados e os termos de treinamento do modelo, incluindo quaisquer restrições no Stealth ou em espaços de trabalho compartilhados.
Os serviços de voz e música podem usar minhas gravações para treinamento?
Isso depende do serviço. O ElevenLabs oferece a opção de recusa do treinamento em seus termos padrão, enquanto outros serviços podem utilizar acordos diferentes. Verifique os scripts, as gravações de referência, as amostras de voz e os resultados separadamente; o consentimento do proprietário da voz continua sendo um requisito à parte.
Os geradores 3D de IA podem ser treinados com os designs dos meus produtos?
Alguns termos permitem esse uso. A cláusula de treinamento não voltada para o setor empresarial da Meshy abrange entradas e saídas, a menos que o Pedido indique o contrário. Os termos para usuários pagos da Tripo contêm uma cláusula explícita de proibição de treinamento. Nenhuma dessas disposições estabelece a cobertura contratual específica da GlobalGPT.
A exclusão do meu chat remove os dados já utilizados para treinamento?
A exclusão de um bate-papo visível não implica, por si só, a remoção de treinamentos anteriores, backups ou registros de segurança. Várias opções de exclusão são prospectivas. Leia as disposições do provedor relativas à exclusão e ao consentimento para os dados e serviços específicos em questão.
Todos os modelos da série GlobalGPT contam com as mesmas proteções de privacidade?
A GlobalGPT publica sua própria política de privacidade, mas seu aviso público não estabelece um único contrato corporativo de fornecimento para todos os modelos. Verifique o provedor específico, o contrato, as permissões de treinamento e as configurações de retenção do modelo que você pretende utilizar.
O que significa um status de privacidade desconhecido?
Isso significa que os termos aplicáveis, o mapeamento entre modelo e serviço ou o campo específico da política não foram definidos nesta análise. Isso não comprova que o provedor ofereça treinamento com base no seu conteúdo, nem constitui uma garantia de que não haverá treinamento. Trate o campo sem resposta como um ponto de decisão em aberto.





