Snel antwoord: Investeer in AI die het werk dat je elke week herhaalt op betrouwbare wijze verbetert. Onderzoek in de stijl van Perplexity is de investering waard wanneer bronnen van belang zijn. Een krachtig algemeen model is het waard om voor te betalen wanneer je de hele dag bezig bent met het herzien van strategieën, analyses en teksten. Een programmeermodel is het waard om voor te betalen wanneer het past in de cyclus van bewerken, testen en beoordelen. Beeld- en videomodellen zijn het waard om voor te betalen wanneer hun output productietijd bespaart.
Deze gids combineert officiële productreferenties, een beoordeling door een onafhankelijke ontwikkelaarsmedia en kleine praktische vergelijkingen die op 1 september 2026 zijn uitgevoerd. De tests zijn bewust beperkt gehouden: één gemeenschappelijke prompt en één uitvoer per model, zodat ze nuttige verschillen in de workflow aan het licht brengen, maar wel niet een universele rangorde aantonen. Openbaarmaking: GlobalGPT is de uitgever van deze publicatie.
Koop bronvermeldingen en actuele bronnen.
Koop revisies die je kunt aanvechten.
Verwerk feedback in je eigen cyclus.
Koop output die de productie vervangt.

Waar je eigenlijk voor betaalt als je AI koopt
Gratis toegang is voldoende voor incidenteel werk. Met een betaald abonnement verdien je geld wanneer het de exploitatiekosten voordelen: minder browsertabbladen, minder handgeschreven eerste versies, een snellere feedbackcyclus, betere toegang tot actuele informatie, of een eindresultaat dat al dichter bij de uiteindelijke kwaliteitsnorm ligt. De dure fout is om te betalen voor toegang en de dienst vervolgens te gebruiken als een soort nieuwigheidje, zoals een zoekvak.
Hoe bepaal je welke AI het waard is om voor te betalen?
De verkeerde vraag is: “Welk model is het slimst?” De nuttige vraag is: “Welk abonnement lost mijn terugkerende knelpunt op met zo min mogelijk administratieve rompslomp?” Een oprichter die onderbouwd concurrentieonderzoek nodig heeft, heeft andere aankoopcriteria dan een engineer die een repository debugt of een marketeer die wekelijks productmateriaal produceert. Begin met het opschrijven van je drie terugkerende taken en toets vervolgens elke kandidaat aan de hand van dezelfde concrete opdracht.
Het lost minstens één keer per week een opdracht op.
Je kunt een beter resultaat van een slechter resultaat onderscheiden.
De tijdwinst is groter dan de tijd die nodig is voor het omschakelen en controleren.
Onderzoek: Is Perplexity het geld waard?
Als het gaat om actuele marktvragen, geef dan de voorkeur aan onderzoeksvermogen boven fraai geformuleerde teksten. Perplexity is een dienst waarbij onderzoek voorop staat: de meerwaarde ligt in een traceerbaar antwoord met bronnen die je kunt controleren, in plaats van een zelfverzekerde samenvatting zonder bronvermelding. Dat maakt het een betrouwbare betaalde optie voor analisten, inkopers, schrijvers en teams die brongevoelige rapporten opstellen. Vergelijk de rol ervan met die van Gemini in dit Vergelijking van functies tussen Gemini en Perplexity, en gebruik deze lijst met Perplexiteit alternatieven wanneer je een andere onderzoeksworkflow nodig hebt.
Koop geen onderzoeksplan alleen maar om e-mails te schrijven of aantekeningen samen te vatten die al op je laptop staan. Het rendement ervan stijgt naarmate de kosten van een achterhaalde of ongefundeerde bewering toenemen. Gebruik onderzoek in de praktijk om bronnen te verzamelen en te verifiëren, en geef het bewijsmateriaal vervolgens door aan een redeneringsmodel voor een beslissingsnota. Door die scheiding zijn fouten gemakkelijker op te sporen.
GPT, Claude en Gemini: wat de strategietest daadwerkelijk aan het licht bracht
We gaven GPT-5.6 Sol, Claude Sonnet 5 en Gemini 3.6 Flash dezelfde opdracht met strikte randvoorwaarden: lanceer binnen zes weken een B2B-analysefunctie met twee ontwikkelaars, een vast budget, een verzoek van de verkoopafdeling voor SSO en een gebrekkig onboardingproces. Elk antwoord moest aannames aan het licht brengen, een plan voor zes weken opstellen, verborgen risico’s benoemen en een update voor het management schrijven. Dit was een eenmalige werkopdracht, geen benchmark.
“Bepaal de kleinste bruikbare analyseworkflow” en beslis of SSO binnen de scope valt, alleen in de pilotfase wordt toegepast of wordt uitgesteld, voordat je het team hieraan verbindt.
“Je kunt niet in één keer een nieuwe analysefunctie ontwikkelen, een nog niet vastgesteld onboardingprobleem oplossen en een enterprise-SSO-oplossing implementeren, en dat allemaal met volledige kwaliteit.”
Verdeel de twee ontwikkelaars: de ene houdt zich bezig met het stabiliseren van het onboardingproces en de andere met het opzetten van de basis voor de analysegegevens; integreer deze vervolgens in de komende weken.
Er is een zo uitgebreid mogelijke lijst met aannames opgesteld, waaronder nalevingsvereisten, lanceringscriteria en maatstaven voor succes. Er zijn geen prestatiemaatstaven bedacht.
Heeft de duidelijkste afweging gemaakt wat betreft de capaciteit: dwing geen aangepaste SSO, analytics en nog niet afgeronde onboarding af in één lancering door twee ontwikkelaars.
Dit bood de duidelijkste uitsplitsing per week per ontwikkelaar, maar ging uit van kant-en-klare dashboards en gegevensisolatie die niet in de opdrachtomschrijving waren opgenomen.
Gevolgen voor de aankoop: GPT is een uitstekende eerste keuze als je waarde hecht aan een brede toetsing van aannames; Claude als scherp redactioneel inzicht voorop staat; Gemini als gestructureerde uitvoeringsplannen belangrijk zijn. Bekijk je eigen opdrachten nog eens goed voordat je een beslissing neemt. Zie de Prijsgids GPT-5.6 en de Vergelijking van het GPT-5.6-model.
De officiële productpagina's blijven de beste plek om de actuele details over abonnementen en functies te bekijken: ChatGPT, Claude, en Tweelingen. Op de productpagina’s wordt uitgelegd wat elke aanbieder momenteel te bieden heeft; de bovenstaande test geeft alleen weer wat deze drie testruns hebben opgeleverd met deze specifieke, beperkte prompt.
Hoe de belangrijkste modelfamilies geschikt zijn voor verschillende soorten werk
Het beste eerste plan voor mensen die zich bezighouden met analyse, het opstellen van ontwerpen, gegevensinterpretatie, planning en het oplossen van problemen. Beoordeel of het aannames aan het licht brengt en of het na directe kritiek wordt verbeterd.
Let op: gepolijste antwoorden die nog moeten worden gecontroleerd op bronvermelding of vakkennis.
Dit is vaak een uitstekende keuze wanneer het eindresultaat een betoog, een rapport, een herschrijving, een beleidsdocument of een redactionele beslissing is, waarbij nuance en een duidelijke afweging belangrijker zijn dan een zo uitgebreid mogelijke takenlijst.
Let op: welsprekende proza beschouwen als feitelijk onderzoek zonder de bronnen te controleren.
Een handige oplossing voor mensen die op zoek zijn naar plannen, tabellen en taakindeling, vooral wanneer het werk al grotendeels via Google-diensten verloopt. Test hoe het systeem omgaat met ontbrekende informatie, in plaats van uit te gaan van implementatiedetails.
Let op: een helder plan dat is gebaseerd op onbevestigde aannames.
Het loont de moeite om te vergelijken op het gebied van technisch werk, programmeren, tweetalig gebruik en experimenteren waarbij de waarde een rol speelt. De juiste keuze hangt af van je taal, de interface en of de respons je testsuite kan doorstaan.
Let op: besparing op abonnementskosten, maar tijdverlies door extra controle of een tool die niet goed aansluit.
Betaal zodra de opdracht van start gaat met een actueel, onderbouwd antwoord. Het voordeel hiervan is niet dat ze het denkwerk vervangen, maar dat ze het verzamelen van bewijsmateriaal en het controleren van bronnen versnellen.
Let op: een bronvermelding accepteren zonder de onderliggende bron te openen.
Specialisten zijn pas de moeite waard als je te maken hebt met terugkerende opdrachten, merkrichtlijnen en een revisieproces. Hun eerste resultaat is meestal een richting, geen creatief ontwerp dat direct ter goedkeuring klaar is.
Let op: betalen voor een model wanneer eenmalige projecten de kosten van herhaling niet rechtvaardigen.
Voor technisch werk geldt een soortgelijke regel. Voer eerst een kleine, representatieve taak uit voordat je aan een grote, autonome taak begint: vraag om een diagnose, een minimale wijziging, een testplan en de risico’s die nog niet zijn opgelost. Sterk modelgedrag houdt niet alleen in dat er code wordt gegenereerd; het laat ook zien waar nog productbeleid of repositorycontext nodig is. Daarom is de Recensie van de DeepSeek V4 Pro en Beoordeling van het GLM-coderingsplan zijn nuttige aanvullende artikelen, in plaats van één algemene bewering over de “beste programmeer-AI”.
Codering: Investeer in het model dat de beoordelingscyclus verbetert
Bij het programmeren is de interface bijna net zo belangrijk als het model. We hebben GPT-5.6 Sol en DeepSeek V4 Pro gevraagd om een JavaScript-fout te diagnosticeren en minimaal te verhelpen totaal(items) functie, met duidelijke foutmeldingen bij ontbrekende, ongeldige of niet-positieve prijzen en hoeveelheden, drie controles en een risicowaarschuwing. GPT-5.6 Sol leverde een compacte implementatie met behulp van Number.isFinite, geïndexeerde foutmeldingen, Node-asserties en een nuttige opmerking over breuken. DeepSeek V4 Pro heeft de NaN valkuil, corrigeerde zijn eigen aanvankelijk zwakkere verdediging om Number.isFinite, en wees bovendien op de ontbrekende validatie van de array.
GPT-5.6 Sol: validatiecorrectie met uitvoerbare tests
Opdracht voor een gezamenlijke taak
Teruggegeven implementatie
Opgemerkt op GlobalGPT: de uitvoer behield expliciet breuken, aangezien hierover nog geen definitief besluit is genomen. Test dit in je eigen repository voordat je het vrijgeeft.
Dat maakt geen van beide tot een universele winnaar op het gebied van codering. Het geeft aan dat een goede, betaalde codeerassistent de validatielimieten moet uitleggen, uitvoerbare tests moet aanleveren en de resterende beleidsbeslissing moet benoemen in plaats van deze te verbergen. Lees het Recensie van de DeepSeek V4 Pro en Beoordeling van het GLM-coderingsplan voor routespecifieke context. Kimi Code’s officiële coderingspagina is een andere werkwijze die het overwegen waard is wanneer het gebruik van de CLI centraal staat.
Hoe ontwikkelaars een betaalde AI voor het programmeren moeten beoordelen
Beoordeel AI voor het programmeren niet aan de hand van een “greenfield”-opdracht als ‘bouw een to-do-app’. Gebruik een afgebakende taak uit een repository die je goed kent: een test die mislukt, een specifieke bug, een onvolledige validatieregel of een documentatie-update die verband houdt met echte code. Vraag de assistent om het gedrag dat volgens hem vereist is nog eens te herhalen, voordat hij iets wijzigt. Zo wordt duidelijk of hij de taak zorgvuldig heeft gelezen of dat hij een bekend sjabloon toepast.
Controleer vervolgens vier zaken. Ten eerste: wordt er onderscheid gemaakt tussen een symptoom en de onderliggende oorzaak? Ten tweede: wordt er de kleinst mogelijke, samenhangende oplossing voorgesteld, in plaats van het herstructureren van modules die hier niets mee te maken hebben? Ten derde: levert het tests op die mislukken voor de oorspronkelijke bug en slagen voor de oplossing? Ten vierde: worden de nog niet genomen productbeslissingen vermeld, zoals afronding, autorisatie, achterwaartse compatibiliteit of het beleid inzake foutmeldingen? Deze vragen zijn nuttiger dan een algemene “kan het coderen?”-score, omdat ze rechtstreeks verband houden met de beoordelingstijd.
De manier van presenteren beïnvloedt de economische aspecten. Een chatvenster volstaat voor diagnose, uitleg over code en korte codefragmenten. Een editor, CLI of een met MCP gekoppelde workflow wordt waardevoller wanneer context veilig moet worden uitgewisseld tussen bestanden, commando’s en tests. Maar diepere toegang legt ook de lat voor beoordelingen hoger: schakel nooit normale tests, machtigingen of codebeoordelingen uit, louter omdat een assistent de juiste terminologie gebruikte. Voor veel teams is de meest rendabele opzet een model dat goed ontwerpt en uitlegt, in combinatie met de bestaande technische controles die bepalen of een wijziging wordt doorgevoerd.
GPT Image 2 versus Nano Banana 2: één product-afbeeldingstest
Voor beide modellen hebben we dezelfde opdracht gebruikt: “strakke e-commerce-hero voor een mat marineblauwe herbruikbare roestvrijstalen fles, lichte steen, daglicht, subtiele condensatie, geen tekst of logo’s.” GPT Image 2 behield de marineblauwe fles, de eis dat er geen logo’s op mochten staan en de condensatie, maar neigde meer naar een achtergrond die deed denken aan een buiten- of zeelifestyle in plaats van een strakke catalogusopname. Nano Banana 2 behield eveneens de marineblauwe fles zonder logo’s, met een meer binnenachtige productopname, maar geen van beide resultaten leverde strikt genomen het gevraagde lichtsteenachtige oppervlak op.
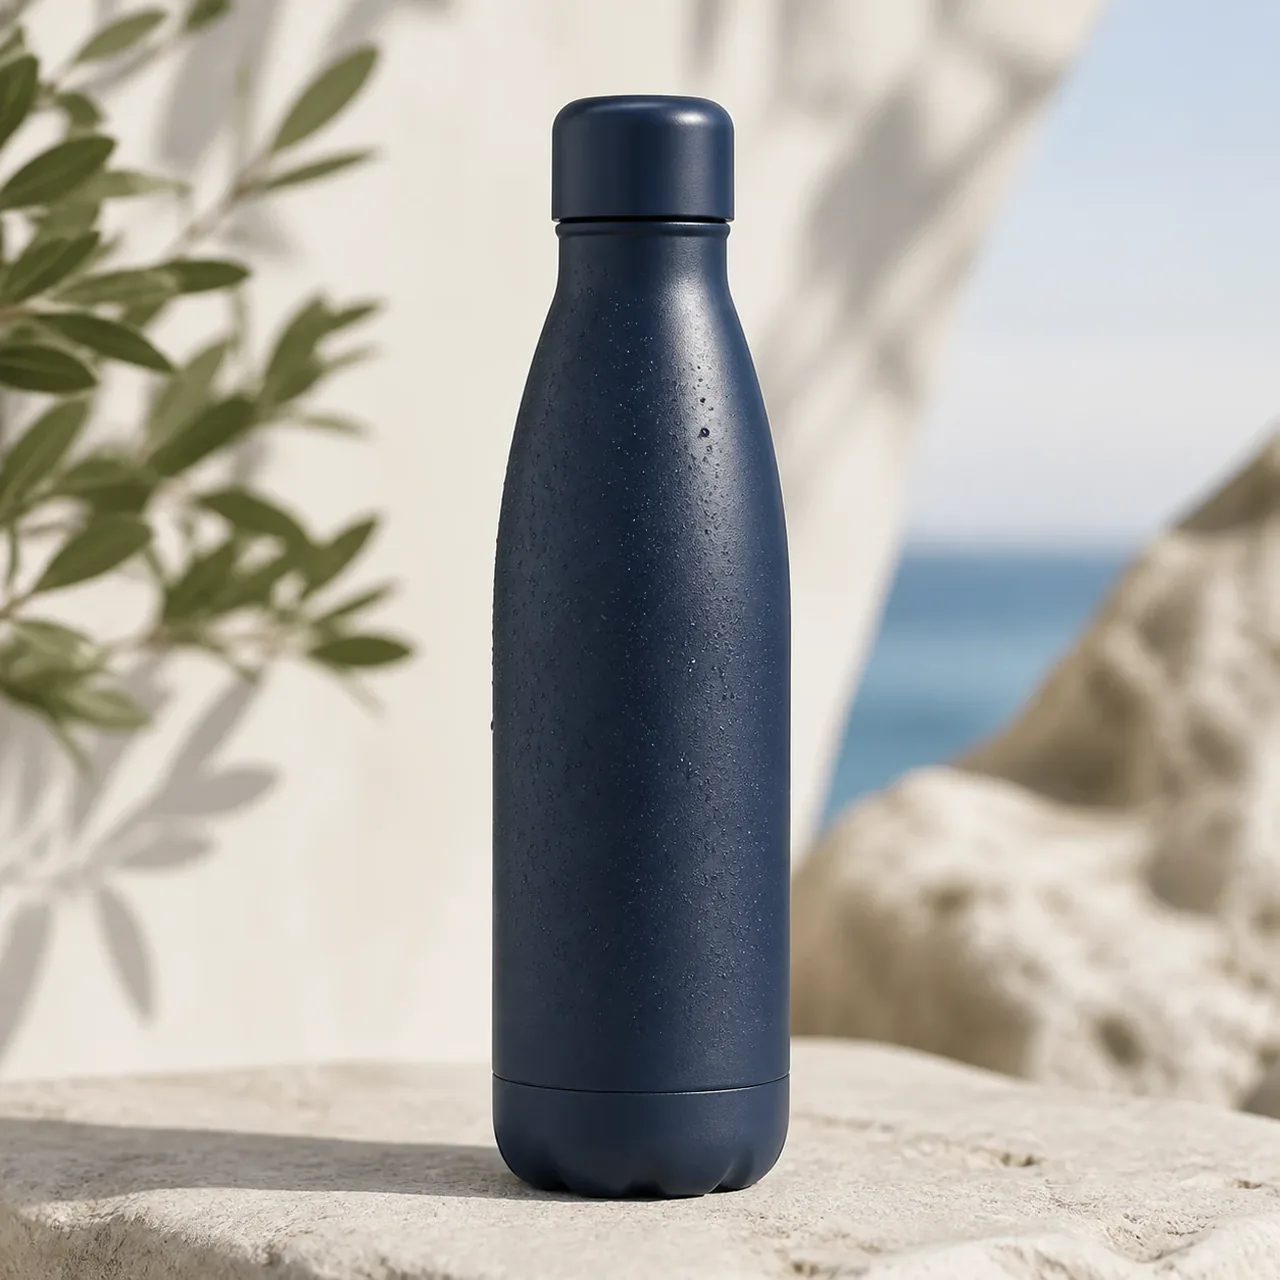
De details van de condensatie kwamen beter tot hun recht; de sfeer neigde meer naar lifestyle dan naar een catalogus.
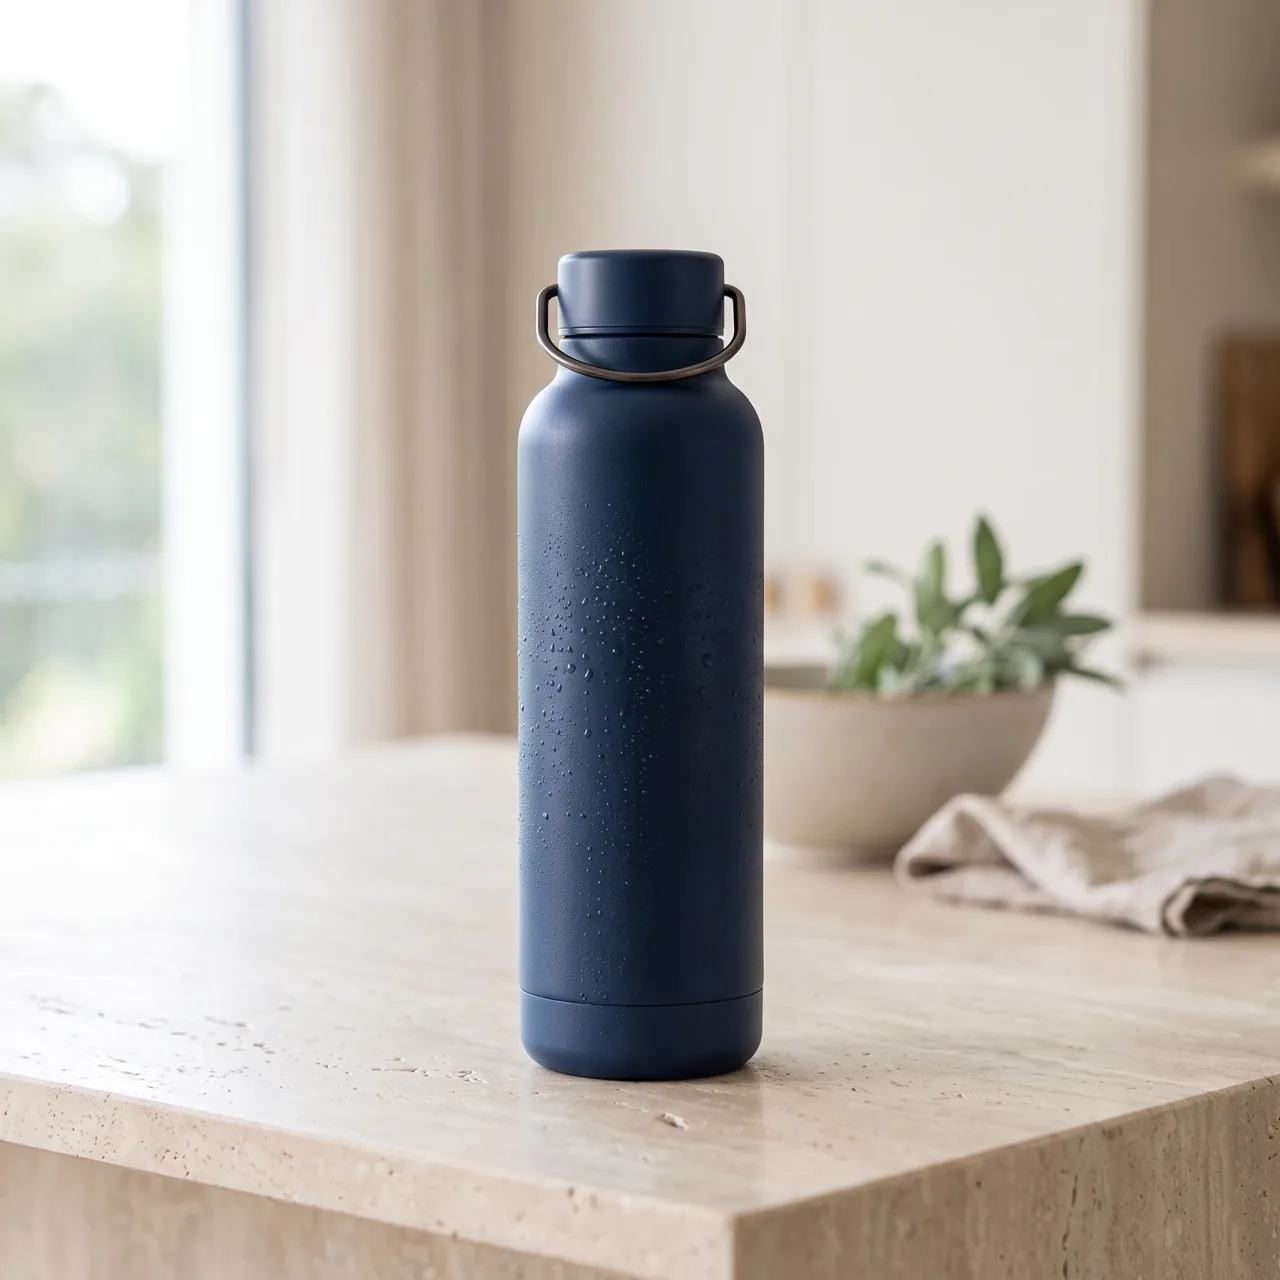
Meer composities van productfoto’s; de instructie over de lichte steen heb ik nog steeds over het hoofd gezien.
De praktische les is dat je moet kiezen voor het beeldmodel waarvan je eventuele fouten snel kunt corrigeren. Voor deze ene prompt was geen van beide resultaten klaar om te publiceren zonder eerst te worden aangepast. Test je eigen merkkleuren, tekst, referentieafbeeldingen en bewerkingsinstructies voordat je een abonnement kiest.
Wat je moet controleren voordat je een fotomodel betaalt
Een creatieve beoordeling moet verder gaan dan alleen de vraag of de afbeelding op zichzelf er goed uitziet. Aan een commerciële afbeelding worden eisen gesteld die in een feed gemakkelijk over het hoofd worden gezien: het silhouet van het product, de nauwkeurigheid van het etiket, de merkkleuren, de lichtval, de lege ruimte voor tekst, de beeldverhouding van de campagne en de mogelijkheid om een gecontroleerde wijziging aan te brengen zonder alles wat al goed werkte teniet te doen. Stel een klein testpakket samen met één strakke productfoto, één lifestylefoto, één afbeelding met typografische of verpakkingsbeperkingen en één bewerking van een bestaand beeldmateriaal.
Veo 3.1 versus Seedance 2.0: een test met productvideo's
Vervolgens vroegen we om een reclamespot van vijf seconden voor een premiumproduct: een mat marineblauwe fles, gecentreerd op een lichte steen, met een langzame inzoom, condensatie en zonder logo, tekst of mensen. De Veo 3.1-uitvoer duurde acht seconden; vanaf de tweede seconde toonde deze overtuigende productdetails van dichtbij en condensatie, maar de camera was te dichtbij gekomen om te voldoen aan de gevraagde compositie met de fles volledig gecentreerd. Seedance 2.0 leverde 5,04 seconden op en hield een vollere, rechtopstaande fles op een steenachtig oppervlak in beeld, hoewel de bovenkant van de fles was afgekapt en de condensatie veel minder zichtbaar was.
Gedeelde prompt die voor beide gegenereerde resultaten wordt gebruikt
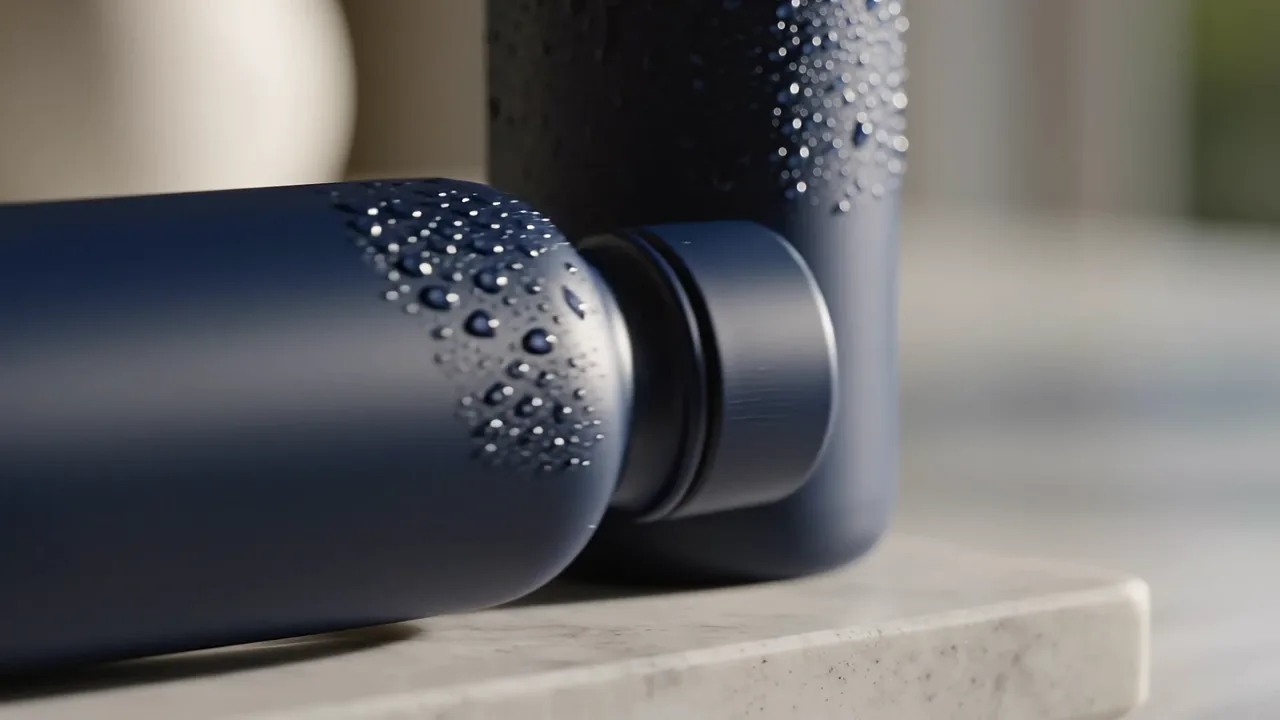
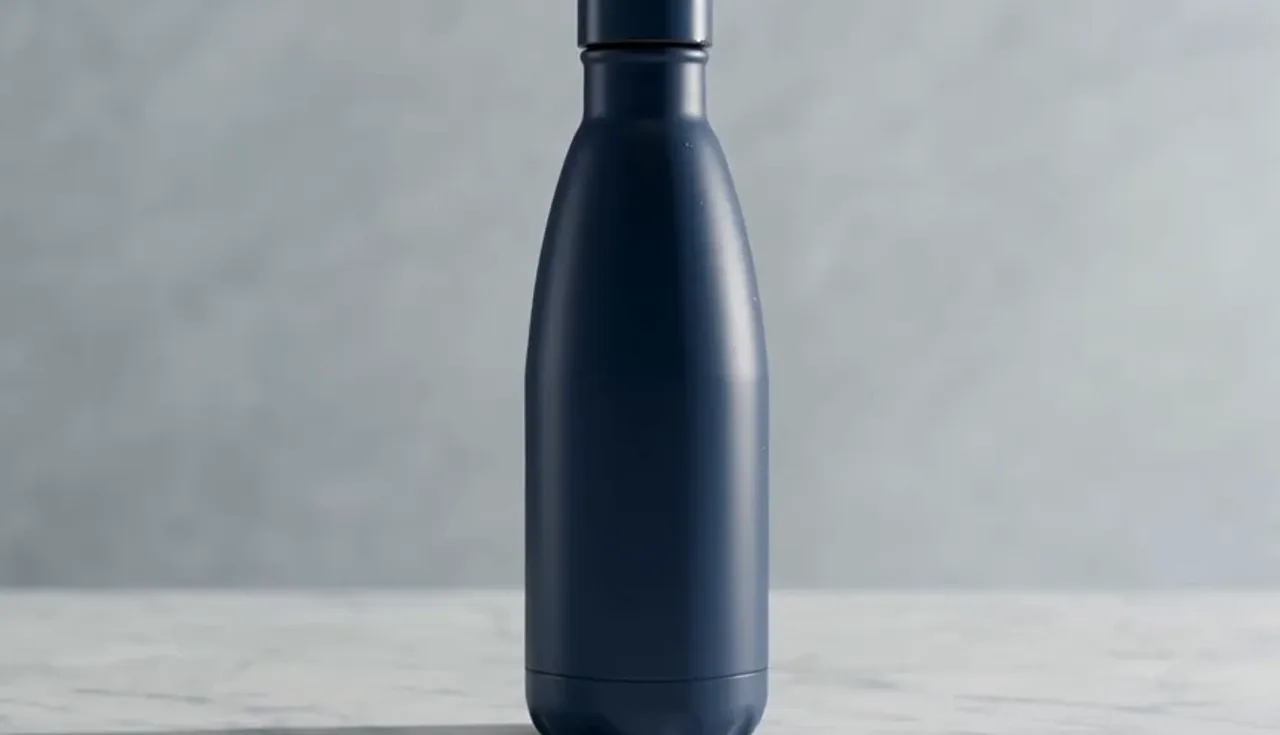
Kies video-AI op basis van hoe snel deze voldoet aan je eisen op het gebied van beeldcompositie, beweging en revisiebeheer, en niet op basis van één enkel aantrekkelijk beeld. Controleer de huidige rechten en toegangsvereisten in de Veo 3.1 handleiding voor commercieel gebruik en de Gebruikershandleiding Seedance 2.0. Agnes Video heeft ook officiële productdocumentatie; controleer de voorwaarden van de verzekering vlak voordat u de polis afsluit.
Hoe stel je een AI-budget op zonder twee keer voor hetzelfde werk te betalen?
De meeste mensen hebben niet voor elke modelcategorie een abonnement nodig. Een verstandige begroting begint bij de ene taak die de meeste kostbare aandacht vergt. Voor een consultant kan dat onderzoek en schrijven zijn. Voor een ontwikkelaar kan het repository-bewuste beoordeling en foutopsporing zijn. Voor een creatief team kan het de mogelijkheid zijn om campagne-assets te produceren en te herzien. Investeer eerst in die primaire bottleneck en voeg pas een tweede route toe als een concrete taak een tekortkoming aan het licht brengt.
Denk in niveaus. Het eerste niveau bestaat uit een kernassistent die je vaak gebruikt. Het tweede niveau bestaat uit een specialist voor een duidelijk andere taak, zoals onderzoek op basis van bronnen of het maken van video’s. Het derde niveau biedt flexibele toegang voor experimenten, extra werk en second opinions. Wat je moet vermijden, zijn drie algemene chatabonnementen die allemaal ongeveer hetzelfde eerste concept opleveren. De extra maandelijkse kosten liggen voor de hand; de schadelijkere kosten zijn dat niemand weet welk antwoord hij moet vertrouwen of waar de definitieve versie thuishoort.
Eén sterke algemene/redeneringslijn, plus toegang tot onderzoeksmateriaal wanneer het werk bronnen vereist. Voeg alleen afbeeldingen of video’s toe voor actieve productiecycli.
Geschikt voor: schrijvers, analisten, oprichters, consultants.
Een programmeerbare methode die geschikt is voor de editor of de CLI, een tweede model voor lastige toetsvragen, en bestaande toetsen als laatste toetssteen.
Geschikt voor: individuele ontwikkelaars en kleine productteams.
Eén beeld-/videostrategie met voldoende ruimte voor aanpassingen, een algemeen model voor concepten en opdrachten, en een herhaalbare goedkeuringschecklist.
Geschikt voor: marketeers, e-commerceteams en bureaus.
Bepaal voor teams wie de verantwoordelijkheid draagt voordat je licenties aanschaft. Wie mag live webonderzoek gebruiken voor een klantclaim? Wie controleert de gegenereerde code? Wie keurt visuele elementen goed? Waar worden de prompts en goedgekeurde resultaten opgeslagen? Dit zijn geen bureaucratische vragen. Ze bepalen of AI het team sneller maakt of juist meer onvindbare concepten oplevert. Een bescheiden plan met een duidelijk omschreven workflow is waardevoller dan premiumtoegang zonder beoordelingsnorm.
De vragen die je moet stellen voordat AI bij belangrijk werk wordt ingezet
“De moeite waard om voor te betalen” is niet alleen een kwestie van prijs. Hoe groter de gevolgen van een fout, hoe belangrijker het is dat het abonnement duidelijke gebruiksgrenzen heeft. Een conceptproductbeschrijving en een financieel advies voor klanten mogen niet via hetzelfde, niet-gecontroleerde proces verlopen. Voordat u een model in een serieuze workflow opneemt, moet u vaststellen welke informatie het mag ontvangen, wie de output controleert, welke gegevens moeten worden ingewonnen en wat er nooit mag worden gepubliceerd zonder dat er een menselijke verantwoordelijke is.
- Welke concrete taak zal deze dienst op zich nemen of aanzienlijk versnellen?
- Welke bron, test of beoordelaar garandeert dat het eindproduct veilig genoeg is om te gebruiken?
- Wat moet het model weten, en is het gepast om die informatie te delen?
- Kan een ander teamlid de workflow nabootsen zonder een privé-chathistorie te kopiëren?
- Wat zou ervoor zorgen dat we dit abonnement binnen 30 dagen opzeggen?
Wanneer één werkruimte voor meerdere modellen meer waard is dan afzonderlijke abonnementen
Een rechtstreeks abonnement kan voordelig zijn wanneer je de nieuwste eigen functies, bedrijfsbrede beheeropties of diep geïntegreerde workflows van één leverancier nodig hebt. Maar afzonderlijke abonnementen worden duur en lastig wanneer je taken in dezelfde week variëren van het raadplegen van onderzoek tot het beoordelen van code en het maken van productafbeeldingen. Volgens de huidige homepage van GlobalGPT biedt één account toegang tot meer dan 100 AI-modellen vanaf $5,80 per maand, samen met Perplexity, Deep Research, Yukie, web- en CLI-toegang, en een MCP-server voor Claude Code, Codex en Cursor.
Een praktische reeks met meerdere modellen ziet er als volgt uit: begin met Perplexity of Deep Research voor actueel bewijsmateriaal; gebruik een algemeen model om de memo vorm te geven; vraag een tweede model om de aannames te toetsen; stuur specifieke implementatievragen via CLI of MCP als dat je bestaande ontwikkelingsworkflow is; ga vervolgens pas over op beeld of video als de campagne visuele productie vereist. Deze volgorde maakt de keuze voor een tool transparant. Het is ook goedkoper dan reflexmatig het duurste pakket van elke leverancier aan te schaffen, voordat je weet welke stap het budget verdient.
Betaal niet langer apart als de opdracht steeds weer verandert
Doe eerst onderzoek voordat je een concept opstelt, schakel over naar andere modellen als er voor een strategisch antwoord een second opinion nodig is, voer codewerk uit via CLI of MCP en maak vervolgens afbeeldingen en video’s vanuit hetzelfde account.
Probeer de werkruimte voor meerdere modellen van GlobalGPT eens uitDe belangrijkste reden om te betalen is niet de toegang tot een bekende modelnaam. Het is het feit dat je op het moment dat de taak verandert over de juiste route beschikt, zonder dat je je abonnementsstack opnieuw hoeft op te bouwen. Voor een algemeen model-instappunt is de geverifieerde GPT-5.6 Sol-route van GlobalGPT hier beschikbaar.
FAQ
Voor welke AI is het het meest de moeite waard om te betalen?
De meest rendabele AI is degene die je herhaaldelijk tijd bespaart bij je kernwerkzaamheden. Bij onderzoekintensief werk is een geciteerde zoekfunctie het meest geschikt; bij analyse is een sterk algemeen model het meest geschikt; bij ontwikkeling zijn een model en een interface die de beoordelingscyclus verbeteren het meest geschikt; en bij beeld- en videotools moet de AI daadwerkelijke productietijd vervangen.
Is ChatGPT het geld waard?
ChatGPT kan de investering waard zijn als het je belangrijkste omgeving is voor het opstellen van concepten, analyses en iteratieve probleemoplossing. Voer je eigen terugkerende opdrachten door dit model en een tweede model, en vergelijk vervolgens zowel de beoordelingstijd als het eerste antwoord.
Is Perplexity het geld waard?
Perplexity is vooral van belang wanneer informatiebronnen en controleerbare bronvermeldingen een wezenlijke invloed hebben op de kwaliteit van je onderzoek. Het is minder essentieel wanneer je werk voornamelijk bestaat uit offline schrijven, programmeren of het maken van materiaal.
Welke AI is het beste voor coderen?
De beste AI voor het schrijven van code is degene die de context van de relevante repository begrijpt, een wijziging voorstelt die kan worden beoordeeld, uitvoerbare tests genereert en aansluit bij je editor of CLI. Beschouw autonome code als een concept totdat je normale tests en beoordeling zijn geslaagd.
Moet ik betalen voor een AI-programma voor afbeeldingen of video’s?
Betaal wanneer het model regelmatig ontwerpen aanlevert die de tijd voor fotoshoots, ontwerp, bewerking of bemiddeling door het bureau vervangen. Vergelijk dezelfde merkgerichte opdracht bij meer dan één dienstverlener en houd rekening met herhalingen in je begroting, omdat bij de eerste resultaten mogelijk details met betrekking tot de compositie of het materiaal ontbreken.
Is een abonnement op AI met meerdere modellen de moeite waard?
Een abonnement op meerdere modellen is handig als je afwisselend bezig bent met onderzoek, schrijven, programmeren, afbeeldingen en video, of als je een tweede model nodig hebt om een belangrijk antwoord te toetsen. Een abonnement rechtstreeks bij de aanbieder kan nog steeds de betere keuze zijn als volledige controle door de aanbieder zelf een absolute voorwaarde is.
Kan ik GPT-5.6 Sol gebruiken op GlobalGPT?
GlobalGPT vermeldt de GPT-5.6 Sol in zijn huidige modelcatalogus. Volg de route voor de GlobalGPT die in dit artikel wordt beschreven om te controleren welke interface momenteel beschikbaar is en kies de toegangsoptie die het beste bij uw workflow past.