De GLM-5.3 Flash is het model waar ik naar zou kijken als je waarde hecht aan programmeerprestaties, maar niet bij elke API-aanroep de prijs van een topmodel wilt betalen. Z.AI positioneert het als een native multimodaal model uit de GLM-5-serie, en het officiële prijsverschil is niet onopvallend: het huidige promotietarief bedraagt $0,075 per 1 miljoen invoertokens en $0,25 per 1 miljoen uitvoertokens, terwijl GLM-5.3 en GLM-5.2 op dezelfde prijspagina van Z.AI worden vermeld tegen $1,40 voor invoer en $4,40 voor uitvoer per 1 miljoen tokens.
Dat betekent niet dat GLM-5.3 Flash voor elke taak een vanzelfsprekende keuze is. In onze gecontroleerde API-tests leek het goedkoop, maar het bleek ook gevoelig voor redenerings- en uitvoerinstellingen. Verschillende standaard OpenAI-compatibele verzoeken leverden een HTTP 200-status op, terwijl de meeste voltooiingstokens werden besteed aan redeneren en er weinig of geen zichtbaar antwoord werd geproduceerd. Na het overschakelen naar GLM-achtige denkinstellingen en een hoger outputplafond werd de coderings- en debugtaak bruikbaar.
Deze gids geeft een overzicht van GLM-5.3 Flash-prijs, API-toegang, officiële specificaties, benchmarksignalen en resultaten van praktijktests. Als je modellen wilt vergelijken voordat je een keuze maakt voor één stack, GLBGPT is de eenvoudigste manier om de output van verschillende modellen met elkaar te vergelijken, terwijl de eigen documentatie en de prijspagina van Z.AI de betrouwbaarste bron blijven voor officiële details over de GLM-5.3 Flash API.
Kort antwoord: Wat is GLM-5.3 Flash?
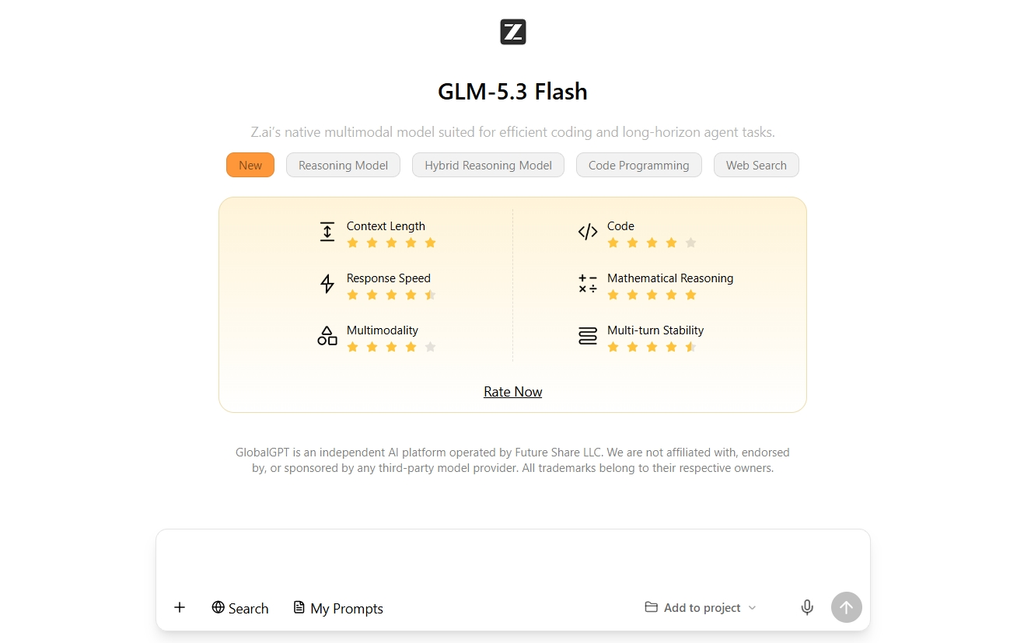
GLM-5.3 Flash is het kostenefficiënte GLM-5-model van Z.AI voor codering, agenttaken, werkzaamheden met een lange context en multimodale invoer. De officiële GLM-5.3-Flash-documentatie geeft de API-modelcode weer als glm-5.3-flash, ondersteunt een contextvenster van 1 miljoen tokens en beschrijft de invoer van afbeeldingen via image_url inhoudsblokken.
Het belangrijkste is de afweging. GLM-5.3 Flash is niet zomaar een kleiner label op dezelfde modelpagina. Z.AI beschrijft het als het eerste native multimodale model in de GLM-5-serie, met in totaal 320 miljard parameters en 18 miljard geactiveerde parameters. Het is gebouwd rond een hybride architectuur die bedoeld is om de servicekosten te verlagen en tegelijkertijd het gedrag bij lange contexten bruikbaar te houden.
Mijn praktische conclusie: GLM-5.3 Flash is vooral interessant voor kostengevoelige coderingstaken en agent-workloads waarbij je het model mogelijk vaak moet aanroepen. Het is minder overtuigend als model voor informeel schrijven, tenzij je API-route en redeneringsinstellingen goed zijn afgestemd, omdat zichtbare output achter het gebruik van redeneringstokens kan verdwijnen wanneer het outputplafond te laag is.
GLM-5.3 Flash-prijs
De officiële Prijspagina van Z.AI is de meest betrouwbare bron voor GLM-5.3 Flash-prijs. Op 27 augustus 2026 vermeldt Z.AI GLM-5.3-Flash met een promotiekorting van 50%. De kortingsprijzen bedragen $0,075 per 1 miljoen invoertokens en $0,25 per 1 miljoen uitvoertokens. De doorgestreepte catalogusprijzen bedragen $0,15 voor invoer en $0,50 voor uitvoer per 1 miljoen tokens.
Z.AI vermeldt tevens dat de actie op 9 september 2026 om 24:00 uur, UTC+8 (Singapore-tijd), afloopt. Dit is van belang voor lezers die de kosten op lange termijn vergelijken: de introductiekorting is reëel, maar mag niet als een permanent uitgangspunt worden beschouwd, tenzij Z.AI deze verlengt.
| Model | Invoer / 1 miljoen tokens | In cache opgeslagen invoer | Opbrengst / 1 miljoen tokens | Opmerking over de prijzen |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 promotieprijs; $0.15 catalogusprijs | $0.015 promotie; $0.03 catalogus | $0.25 actieprijs; $0.50 catalogusprijs | Korting op 50% tot en met 9 september 2026 (UTC+8) |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | Vlaggenschip GLM-5.3-rij in de prijslijst van Z.AI |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Vorige rij van het GLM-model over de prijsstelling van Z.AI |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | Vermeld onder de tekstmodellen van Z.AI |
Officiële prijsvergelijking van Z.AI
Bron: officiële prijspagina van Z.AI, geraadpleegd op 27 augustus 2026. Actieprijzen gelden voor een beperkte periode.
Dus ja, GLM-5.3 Flash is goedkoop in vergelijking met GLM-5.3 en GLM-5.2, als we uitgaan van de officiële tokenprijzen. De vraag is echter of het ook nog steeds goedkoop blijft als je prompts, redeneringsinstellingen, toolaanroepen en herpogingen meerekent. In ons praktijkgedeelte gaan we daar dieper op in.
Als je meer wilt weten over de prijsontwikkeling van de vorige generatie, raadpleeg dan ons aparte artikel Prijs van de GLM-5.2 gids. Ik zou die pagina gericht houden op GLM-5.2 en in dit artikel de aandacht richten op de prijs, API en benchmarkdoelstellingen van GLM-5.3 Flash.
GLM-5.3 Toegang tot de Flash-API
De officiële API-modelcode is glm-5.3-flash. Z.AI geeft aan dat de tekstparameters in overeenstemming zijn met GLM-5.3, dat het een contextvenster van 1 miljoen tokens ondersteunt en dat het afbeeldingen als invoer ondersteunt via image_url blokken binnenin berichten[].inhoud[]. Daardoor is GLM-5.3 Flash meer dan alleen een coderingsmodel dat uitsluitend op tekst is gebaseerd.
De opmerking over de instellingen is geen onbelangrijk detail. In de documentatie wordt aanbevolen om temperatuur: 1, top_p: 0,95, en redeneringsinspanning: max. Ze zeggen ook thinking.type ondersteunt ingeschakeld, en raden aan thinking.clear_thinking: false. Uit onze eigen tests bleek dat dit soort configuraties wel degelijk van belang was.
| API-item | Wat moet je gebruiken? | Waarom het belangrijk is |
|---|---|---|
| Modelcode | glm-5.3-flash |
Gebruik de exacte model-ID in plaats van een variantnaam te raden. |
| Context | 1 miljoen tokens | Handig voor grote codebases, lange documenten en het geheugen van agents, maar nog steeds kostengevoelig. |
| Afbeelding invoeren | image_url inhoudsblokken |
Ondersteunt workflows voor het omzetten van schermafbeeldingen naar code en visuele foutopsporing. |
| Denken | thinking.type: ingeschakeld |
Redenering mag niet worden beschouwd als een onbeduidend, verborgen detail; het kan het gebruik van symbolen zelfs volledig bepalen. |
Voor mensen die geen ontwikkelaars zijn, kan een platform dat meerdere modellen ondersteunt hierbij uitkomst bieden. Je kunt gebruikmaken van GLBGPT om het gedrag van modellen te vergelijken voordat je tijd steekt in het opzetten van de API van één bepaalde aanbieder. Raadpleeg voor officiële tarieven voor tokens en modelparameters altijd de prijslijst en documentatie van Z.AI zelf.
GLM-5.3 Flash-benchmarks en signalen over de prestatiemogelijkheden
Benchmarks zijn hier nuttig, maar alleen als je de bron vermeldt. In de documentatie van Z.AI vind je officiële uitspraken over het model en details over de architectuur. Kunstmatige analyse biedt benchmarkgegevens van derden. OpenRouter biedt gegevens over het aanbod van zorgverleners. Dat zijn drie verschillende soorten bewijsmateriaal.
Artificial Analysis rapporteert voor GLM-5.3-Flash een intelligentie-index van 57, een rangschikking van #3 op 110 in de weergegeven groep, een contextvenster van 1M en 50,2 output-tokens per seconde. Ook wordt aangegeven dat de invoermodaliteit bestaat uit tekst en afbeeldingen, met tekst als uitvoer. Dat is een sterk signaal voor de prestaties van een model met Flash-prijszetting, maar het blijft een benchmark van een derde partij en geen officiële snelheidsgarantie van Z.AI.
Overzicht van prijzen en mogelijkheden
| Model | Officiële prijs | Referentiesignaal | Context | Brongrens |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 input / $0.25 output promotie per 1 miljoen tokens | 57 Intelligentie-index; 50,2 output-tokens/s | 1 miljoen tokens | Prijs afkomstig van Z.AI; benchmark afkomstig van Artificial Analysis |
OpenRouter is handig om de beschikbaarheid op marktplaatsen en providerspecifieke cijfers te controleren, maar ik zou die waarden niet in een tabel met officiële prijzen opnemen. Als een OpenRouter-provider een andere doorvoersnelheid of een ander tijdelijk tarief aangeeft, geef dan aan dat het om marktplaatsgegevens van de provider gaat.
Praktische API-test: prompts, gebruik van tokens en resultaten
We hebben een gecontroleerde API-test uitgevoerd op vijf beschikbare modellen: glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, en kimi-k3. Dit was geen officiële benchmark en mag niet worden opgevat als een wereldwijde ranglijst van modellen. Het doel was beperkter en relevanter voor dit artikel: leverde GLM-5.3 Flash bij dezelfde prompts bruikbare resultaten op, hoe gedroegen de redeneringstokens zich, en welke kostenvelden werden in het API-antwoord teruggegeven?
Het testontwerp was bewust eenvoudig gehouden. We hebben één programmeertaak, één taak met strikt gestructureerde uitvoer en één korte schrijfopdracht gebruikt. Die combinatie is van belang, omdat een model uitstekend kan presteren bij het programmeren, maar toch lastig kan zijn bij strikte JSON-uitvoer of korte teksten, als het tijdens het proces het uitvoerbudget verspilt aan verborgen redeneringen.
Hoe lees je de testkaarten?
- Sla over betekent dat het model een zichtbare uitvoer heeft geleverd die een antwoord gaf op de opdracht.
- Fout in de opmaak betekent dat de inhoud nuttig was, maar geen strikt machinaal leesbare uitvoer.
- Geen eenduidige conclusie betekent dat het verzoek technisch gezien is geslaagd, maar dat de geteste route weinig of geen zichtbaar antwoord heeft opgeleverd.
- Kostenvelden dit zijn door de gebruikers gerapporteerde waarden uit deze gecontroleerde API-run, en geen officiële prijsbeloften van de aanbieder.
De standaarduitvoering die werd gebruikt temperatuur: 0,2 en een maximum voor de output op taakniveau. Elk model/elke taak werd één keer uitgevoerd, zonder automatische herhaling. Vervolgens hebben we alleen voor GLM-5.3 Flash een vervolgonderzoek uitgevoerd op de codeer- en schrijfopdrachten met GLM-achtige denkinstellingen, omdat de standaard Flash-reacties een intensief gebruik van redeneringstokens lieten zien en een grondigere configuratiecontrole vereisten.
Opdracht A
Foutopsporing in de code: heeft het model de fout in de klantgroepering opgespoord?
Opdracht: Zoek de fout in een TypeScript-functie, leg uit waarom deze ontstaat en geef een gecorrigeerde implementatie.
Exacte opdracht
Je bent bezig met het controleren van een TypeScript-functie die bestellingen op klant-id moet groeperen en de totale uitgaven per klant moet berekenen. Zoek de fout, leg uit waarom deze optreedt en geef een gecorrigeerde implementatie. Code: type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const order of orders) { if (!result[order.id]) result[order.id] = { count: 0, total: 0 }; result[order.id].count += 1; result[order.id].total += order.total; } return result; }
| Model | Overzicht van de output | Token / kostenopmerking | Resultaat |
|---|---|---|---|
glm-5.3-flash |
De standaardrun leverde een HTTP 200-status op, maar er was geen zichtbaar antwoord van de assistent omdat het redeneringsproces 1196 van de 1200 voltooiingstokens had gebruikt. In de vervolgstap met de aanbevolen instellingen werd correct vastgesteld dat order.id zou moeten zijn order.klant-ID en gaf een gecorrigeerde implementatie. |
Standaard: 1348 tokens in totaal, kostenveld $0.0003111. Vervolg: 2584 tokens in totaal, kostenveld $0.00124007598. | Doorgeven na herhaling |
glm-5.3 |
De fout in de groeperingssleutel is opgespoord en er is uitgelegd waarom unieke bestelnummers aggregatie op klantniveau verhinderen. De gecorrigeerde code die werd gebruikt klant-id als object-sleutel. |
1348 tokens in totaal, kostenveld $0.00534128. | Sla over |
glm-5.2 |
Ik heb ook de order.id versus klant-id het probleem aangepakt en een bruikbare, gecorrigeerde implementatie opgesteld. |
1304 tokens in totaal. De kosten in USD werden niet in hetzelfde antwoordveld weergegeven. | Sla over |
gpt-5.6-luna |
Gaf de duidelijkste en beknopte uitleg: de accumulator was geïndexeerd op bestelnummer, waardoor elke bestelling een eigen bucket vormde. Het leverde gecorrigeerde TypeScript-code op. | 509 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Sla over |
kimi-k3 |
Ik heb dezelfde bug ontdekt en een gedetailleerde uitleg gegeven, plus een gecorrigeerde implementatie. Het antwoord was bruikbaar, maar langer dan dat van GPT. | 1423 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Sla over |
Meenemen: Wat het opsporen van fouten in de code betreft, presteerde GLM-5.3 Flash pas goed na aanpassingen aan de instellingen volgens de GLM-aanpak en een hogere outputlimiet. GLM-5.3, GLM-5.2, GPT-5.6 Luna en Kimi K3 leverden allemaal al bij de eerste run bruikbare, zichtbare antwoorden op.
Opdracht B
Strikte JSON: voldeed het model aan een machinaal leesbaar formaat?
Opdracht: Geef uitsluitend strikte JSON terug, met vaste sleutels en zonder Markdown-opmaak.
Exacte opdracht
Geef uitsluitend strikte JSON-gegevens weer. Vergelijk de vlaggenschipmodellen GLM-5.3-Flash, GLM-5.3 en GPT-stijl voor een ontwikkelaar die een codeerassistent zoekt. Gebruik de volgende sleutelwoorden: best_for, tradeoffs, cost_warning, recommendation. Gebruik geen Markdown.
| Model | Overzicht van de output | Token / kostenopmerking | Resultaat |
|---|---|---|---|
glm-5.3-flash |
Er werd gedeeltelijke JSON-achtige inhoud geretourneerd, maar zonder opschoning was dit geen strikt parseerbare JSON. Dit is bruikbaar voor een menselijke lezer, maar niet voor directe automatisering. | 1267 tokens in totaal, kostenveld $0.000305025. | Fout in de opmaak |
glm-5.3 |
Er werd geen zichtbare assistentinhoud geretourneerd onder de geteste outputlimiet, waarbij bijna alle voltooiingstokens werden verbruikt door het redeneringsproces. | 1267 tokens in totaal, kostenveld $0.00530084. | Geen eenduidige conclusie |
glm-5.2 |
Er werd een JSON-achtig antwoord teruggegeven, maar dit was onvolledig en kon niet worden geparseerd zonder eerst te worden opgeschoond. | 1268 tokens in totaal. De kosten in USD werden niet in hetzelfde antwoordveld weergegeven. | Fout in de opmaak |
gpt-5.6-luna |
Er werd parseerbare JSON teruggestuurd met de gevraagde sleutels en zonder Markdown-omkasting. | 541 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Sla over |
kimi-k3 |
Er werd JSON-achtige inhoud met nuttige informatie teruggegeven, maar zonder opschoning was het geen strikt parseerbare JSON. | 1339 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Fout in de opmaak |
Meenemen: Wat betreft strikt gestructureerde uitvoer was GPT-5.6 Luna de meest zuivere in deze kleine testreeks. GLM-5.3 Flash werkt wellicht nog wel met strengere instellingen voor het antwoordformaat, maar dit standaardverzoek was niet geschikt voor automatisering.
Opdracht C
Korte productopmerking: leverde het model bruikbare tekst op?
Opdracht: Schrijf een specifieke, niet-promotionele tekst van 120 woorden waarin je uitlegt wanneer de GLM-5.3 Flash de voorkeur verdient boven een zwaarder topmodel.
Exacte opdracht
Schrijf een productbeschrijving van 120 woorden waarin je uitlegt wanneer de GLM-5.3-Flash een betere keuze is dan een zwaarder topmodel. Wees daarbij concreet en houd het niet te promotioneel.
| Model | Overzicht van de output | Token / kostenopmerking | Resultaat |
|---|---|---|---|
glm-5.3-flash |
De standaarduitvoering leverde geen zichtbare inhoud op nadat het redeneringsproces 895 van de 900 voltooiingstokens had verbruikt. Ook de vervolguitvoering met de aanbevolen instellingen leverde geen zichtbare inhoud op nadat het redeneringsproces 1798 van de 1800 voltooiingstokens had verbruikt. | Standaard: 946 tokens in totaal, kostenveld $0.00022845. Vervolg: 1846 tokens in totaal, kostenveld $0.00045345. | Geen eenduidige conclusie |
glm-5.3 |
Er werd geen zichtbare inhoud weergegeven onder de geteste uitvoerlimiet. | 946 tokens in totaal, kostenveld $0.0040244. | Geen eenduidige conclusie |
glm-5.2 |
Er werd geen zichtbare inhoud weergegeven onder de geteste route. | 947 tokens in totaal. De kosten in USD werden niet in hetzelfde antwoordveld weergegeven. | Geen eenduidige conclusie |
gpt-5.6-luna |
Er werd een praktisch verslag ingediend met concrete voorbeelden, zoals het genereren van grote hoeveelheden gegevens, voorspelbare latentie, ondersteuningsoverzichten, extractie, classificatie en routering. Het verslag kwam bijna uit op de gevraagde lengte van 120 woorden. | 983 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Sla over |
kimi-k3 |
Er werd geen zichtbare inhoud weergegeven onder de geteste route. | 1019 tokens in totaal. Kosten in USD nog niet bekend/niet terugbetaald. | Geen eenduidige conclusie |
Meenemen: Bij het schrijven van korte teksten in deze route leverde de GLM-5.3 Flash geen bruikbaar, leesbaar resultaat op, hoewel de kosten hiervoor verwaarloosbaar waren. Alleen op basis van de prijstabel zou ik er niet voor kiezen; ik zou eerst de exacte instellingen testen.
Wat uit de tests daadwerkelijk bleek
- GLM-5.3 Flash is echt interessant wat betreft de ontwikkelingskosten. De codeertaak werkte na het toepassen van GLM-achtige instellingen, en de geregistreerde kosten bleven voor deze run nog steeds verwaarloosbaar.
- De standaardroute werkte niet volgens het plug-and-play-principe. Verschillende Flash-reacties gaven een HTTP 200-status terug, terwijl bijna het volledige voltooiingsbudget werd gebruikt voor redeneringstokens.
- Strikte JSON vereist extra validatie. Een antwoord dat eruitziet als JSON is niet hetzelfde als JSON dat kan worden geparseerd, vooral als de uitvoer in een automatisering wordt gebruikt.
- Korte verhalen zijn niet het eerste waar ik Flash op zou beoordelen. Bij deze test werd er geen zichtbaar Flash-antwoord op de schrijfopdracht gegeven, zelfs niet na het aanpassen van de instellingen.
Mijn conclusie is simpel: GLM-3.3 Flash is veelbelovend voor kostenbewuste codering, maar je moet het niet beschouwen als een ‘plug-and-play’-oplossing voor elke OpenAI-compatibele route. Stel voldoende outputbudget in, controleer het gedrag van de reasoning-tokens en test het exacte taaktype dat je van plan bent uit te voeren, voordat je er daadwerkelijk grote volumes naar verplaatst.
De beste toepassingen voor de GLM-5.3 Flash
GLM-5.3 Flash is het meest geschikt wanneer de taak baat heeft bij multimodale invoer, een lange context en veel herhaalde aanroepen. Het is niet het model dat ik zou kiezen alleen omdat de prijstabel er goed uitziet. Ik zou ervoor kiezen wanneer de aard van de taak aansluit bij het model.
- Programmeermiddelen met veel aanroepen van hulpprogramma’s: Lagere prijzen voor tokens zijn handig wanneer het model de cyclus van planning, bewerking, testen en corrigeren doorloopt.
- Frontend-werk aan de hand van schermafbeeldingen: Dankzij de focus op beeldinvoer en codering is het een voor de hand liggende keuze voor het opsporen van fouten in gebruikersinterfaces en voor het omzetten van schermafbeeldingen naar code.
- Code-review met uitgebreide context: Het 1M-contextvenster is handig wanneer je meer projectcontext in één verzoek wilt opnemen.
- Professioneel werk waarbij veel documenten worden gebruikt: Z.AI beschrijft toepassingsvoorbeelden op het gebied van Office-bestanden, financieel onderzoek en de verwerking van professionele documenten.
- Kostenefficiënte API-experimenten: Door het prijsverschil is de Flash een verstandige keuze als eerste model om mee te beginnen, voordat je overstapt op een zwaarder model.
Als je voornamelijk korte marketingteksten schrijft, ga er dan niet zomaar vanuit dat Flash de beste standaardkeuze is, alleen omdat het goedkoper is. Onze schrijftest leverde geen eenduidige uitslag op, zowel bij de standaardinstellingen als bij de aanbevolen instellingen van Flash, omdat de zichtbare inhoud niet netjes werd weergegeven binnen de gekozen uitvoerlimiet. Ik zou eerst codering en gestructureerde technische taken testen en daarna beslissen of Flash ook een plaats verdient in je schrijfstack.
Kostentriggers en API-instellingen om in de gaten te houden
Het grootste risico van GLM-5.3 Flash ligt niet in de officiële tokenprijs. De officiële prijs is laag. Het risico zit hem in de kloof tussen een goedkope aanvraag en een bruikbaar antwoord.
- Redeneringstokens: In onze tests namen de redeneringstokens bij verschillende testruns het grootste deel van het voltooiingsbudget in beslag.
- Maximale output: Een laag plafond kan ervoor zorgen dat er geen zichtbare inhoud wordt teruggestuurd, zelfs als het HTTP-verzoek slaagt.
- Agent-lussen: Elke cyclus van ontwerpen-bewerken-testen kan het aantal context- en uitvoertoken vermenigvuldigen.
- Algemene context: 1 miljoen tokens is handig, maar het verzenden van meer context dan nodig is, heeft nog steeds invloed op de kosten en de vertraging.
- Herpogingen: Het opnieuw uitvoeren van een mislukte of geen uitvoer opleverende configuratie wijzigt de werkelijke kosten per bruikbaar resultaat.
Bij programmeertaken zou mijn uitgangspunt zijn: gebruik de officiële modelcode, hanteer de denkwijze van GLM, geef het model voldoende ruimte voor zichtbare output en log redeneringstokens apart van de tokens met het definitieve antwoord. Als je verschillende routes vergelijkt, meet dan de kosten per voltooide taak in plaats van de kosten per verzoek.
Is de GLM-5.3 Flash de moeite waard?
GLM-5.3 Flash is het overwegen waard als uw workload veel programmeerwerk vereist, kostengevoelig is en op API’s is gebaseerd. De officiële prijs is aantrekkelijk, de benchmarkresultaten van externe partijen zijn indrukwekkend en het model beschikt over nuttige specificaties: native multimodale invoer, 1 miljoen contextwoorden en een GLM-5-seriearchitectuur die is ontworpen voor efficiënte serving.
Ik zou extra voorzichtig zijn als je het vooral gebruikt voor algemeen schrijven, strikt gestructureerde uitvoer of een workflow waarbij onzichtbare redeneringen een ernstig probleem zouden vormen. Test in die gevallen eerst de exacte route en instellingen voordat je grote hoeveelheden gegevens naar Flash verplaatst. Een model kan goedkoop zijn, maar toch een strakke configuratie vereisen.
Voor lezers die het gedrag van modellen willen verkennen voordat ze een API-stack kiezen, GLBGPT biedt je een handige manier om de resultaten van verschillende modellen te vergelijken zonder voor elke aanbieder een apart tabblad te hoeven openen. Zodra je weet welk model geschikt is voor jouw taak, kun je de officiële API- en prijsdocumentatie gemakkelijker beoordelen.
FAQ
Wat is GLM-5.3 Flash?
GLM-5.3 Flash is een model uit de Z.AI GLM-5-serie met de API-modelcode glm-5.3-flash. Z.AI omschrijft het als een native multimodaal model met ondersteuning voor een context van 1 miljoen tokens en een kostenefficiënte architectuur.
Hoeveel kost de GLM-5.3 Flash?
Volgens de gegevens van 27 augustus 2026 vermeldt Z.AI voor GLM-5.3 Flash een prijs van $0,075 per 1 miljoen invoertokens en $0,25 per 1 miljoen uitvoertokens tijdens een 50%-actie. De vermelde reguliere prijzen bedragen $0,15 voor input en $0,50 voor output per 1 miljoen tokens.
Is GLM-5.3 Flash gratis?
Op de officiële prijspagina staan de prijzen voor betaalde API-tokens vermeld. Er wordt ook een tijdelijke korting aangeboden; het gaat dus niet om een permanent gratis model. Voor sommige routes of abonnementen gelden mogelijk afwijkende quotumregels, maar die moet je controleren op het toegangsplatform dat je daadwerkelijk gebruikt.
Wat is de modelcode van de GLM-5.3 Flash API?
De officiële modelcode luidt als volgt: glm-5.3-flash.
Ondersteunt GLM-5.3 Flash het invoeren van afbeeldingen?
Ja. In de documentatie van Z.AI wordt de invoer van afbeeldingen beschreven via image_url inhoudsblokken in de inhoudsarray van de chatberichten.
Wat is het contextvenster van GLM-5.3 Flash?
In de documentatie van Z.AI wordt ondersteuning beschreven voor een contextvenster van 1 miljoen tokens. OpenRouter en Artificial Analysis geven ook ongeveer 1 miljoen tokens aan, maar dat zijn aparte pagina’s van derden.
Is GLM-5.3 Flash beter dan GLM-5.3?
Dat geldt niet in alle gevallen. GLM-5.3 is het zwaardere model voor complexe codering en taken met een lange looptijd, terwijl GLM-5.3 Flash veel goedkoper is en native multimodale positionering biedt. Maak je keuze op basis van het type taak en je kostentolerantie.
Is GLM-5.3 Flash geschikt om te programmeren?
Het lijkt veelbelovend voor codering, met name voor kostengevoelige codering. In onze gecontroleerde API-vervolgtest met instellingen in GLM-stijl en een hogere tokenlimiet heeft het een groeperingsfout in TypeScript correct verholpen. Bij lagere standaarduitvoerlimieten leverden verschillende testruns geen eenduidige resultaten op, omdat de respons weinig of geen zichtbare inhoud bevatte.
Hoe presteert GLM-5.3 Flash in vergelijking met GPT-modellen?
GLM-5.3 Flash is op basis van de officiële tokenprijs aanzienlijk goedkoper dan veel toonaangevende coderingsoplossingen, maar de prijs is niet de enige factor. In onze kleine test met standaardinstellingen leverde GPT-5.6 Luna voor alle drie de taken bruikbare resultaten op, terwijl GLM-5.3 Flash voor de coderingstaak een vervolgtest met de aanbevolen instellingen nodig had.
Hoe verhoudt de GLM-5.3 Flash zich tot de Kimi?
Kimi K3 slaagde voor de coderings- en foutopsporingstaak in onze test, maar voldeed niet aan de strikte JSON-normen zonder opschoning en leverde geen zichtbare inhoud op voor de korte schrijfopdracht onder de geteste route. Dat betekent niet dat Kimi over het algemeen slechter presteert; het geeft alleen een beeld van deze reeks taken en configuratie.
Waar kan ik GLM-5.3 Flash uitproberen?
Voor officiële API-toegang kun je de documentatie- en prijspagina's van Z.AI's GLM-5.3 Flash raadplegen. Als je, voordat je een keuze maakt, modellen uitgebreider wilt vergelijken, kun je een platform voor meerdere modellen zoals GLBGPT gebruiken om de resultaten van verschillende modellen op één plek naast elkaar te zetten.
Moet ik GLM-5.3 Flash gebruiken voor de productie?
Gebruik het pas in de productieomgeving nadat u uw specifieke taak, route, instellingen, uitvoerlimieten en kostenregistratie hebt getest. De prijs is aantrekkelijk, maar uit onze tests is gebleken dat configuratiedetails bepalend kunnen zijn voor de bruikbaarheid van de resultaten.
Laatste conclusie
GLM-5.3 Flash is niet zomaar een goedkope bijzaak van GLM-5.3. Het is een serieuze nieuwe optie voor kostenbewuste codering, multimodale invoer en API-werk met een lange context. De officiële prijs is aantrekkelijk en de benchmarkresultaten zijn sterk genoeg om het testen te rechtvaardigen.
Mijn belangrijkste waarschuwing is van praktische aard: beoordeel het niet alleen op basis van een HTTP 200-statuscode. Controleer de zichtbare uitvoer, het gebruik van redeneringstokens en de kosten per bruikbaar antwoord. Als die aspecten bij je daadwerkelijke taken goed uitpakken, zou GLM-5.3 Flash wel eens een van de interessantere modellen met een goede prijs-prestatieverhouding in de huidige coderingsstack kunnen zijn.