
Claude Sonnet 5.5 versus Opus 5.5: prijs, benchmarks en praktijktests
De Sonnet 5.5 en de Opus 5.5 behoren beide tot de Claude 5.5-generatie, maar verschillen qua prijs en marktpositionering. In deze vergelijking worden beide apparaten aan dezelfde vijf opdrachten onderworpen en wordt weergegeven wat de route daadwerkelijk heeft opgeleverd.
Het verschil zit vooral in de kosten en de snelheid. In dit pakket met vijf opdrachten was Sonnet 5.5.5 sneller klaar, verbruikte het minder output-tokens en leverde het de lagere schatting van de rekenkosten op. Opus 5.5 verbruikte meer tokens en tijd, terwijl de antwoorden vaak uitgebreider waren. Op de taakkaarten is te zien waar die extra tekst het bruikbare resultaat beïnvloedde en waar beide modellen de opdracht gewoon haalden.
De prompts, het verzoekplafond, de inspanningsinstelling, het eindpunt en het ontwerp met één run per model werden in lijn gehouden met de vorige Claude Opus 5.5 recensie.
Kort antwoord
- Snelheid tijdens deze vergelijkende rit: Sonnet 5.5 voltooide vijf opeenvolgende verzoeken lokaal in 31,930 seconden; Opus 5.5 deed daar 47,725 seconden over.
- Door de route gerapporteerde uitvoertokens: Sonnet 5.5 gebruikte 2.686; Opus 5.5 gebruikte 3.952. Het aantal denkvelden bedroeg respectievelijk 987 en 2.214.
- Rekenkundige schatting van de catalogusprijs: De vijf Sonnet-bestellingen kwamen uit op ongeveer $0.02826; de vijf Opus-bestellingen kwamen uit op ongeveer $0.08184, op basis van de officiële standaardtarieven per token en exclusief cache, credits, belasting en opslag.
- Resultaat van de taak: Beide modellen slaagden voor de opdrachten op het gebied van gegevensontsluiting, JSON en wiskunde. Sonnet hield zich beter aan de gevraagde Chinese opmaak met twee alinea’s; de code-uitvoer van beide modellen was bruikbaar, maar verschilde qua diepgang en uitleg van uitzonderingsgevallen.
- API-migratie: Het denkproces kan niet worden uitgeschakeld; een gedwongen keuze van hulpmiddelen wordt afgewezen, en de tokenbudgetten houden rekening met het denkproces. Bekijk de aandachtspunten bij migratie voordat je overschakelt.
- Beslissingsgrens: Dit betreft één doorloop per taak via een route van een derde partij. Hierbij worden de waargenomen reactietijden op prompts, de lokale kloktijd en het door de route gerapporteerde verbruik gemeten – het is geen algemene prestatiescore.
Officiële prijs en technische specificaties van het model
In de huidige modelkaarten van Anthropic staan beide modellen vermeld met een contextvenster van 1 miljoen tokens en een maximale output van 128K. Sonnet 5.5 wordt aangeduid als Snel met een hoge standaardinspanning; Opus 5.5 wordt aangeduid als Matig bij een gemiddelde standaardinspanning. De standaardtokenkoersen zorgen ervoor dat Sonnet 5.5 de helft bedraagt van de aankoop- en verkoopprijs van Opus 5.5.
| Model | API-ID | Officieel label voor latentie | Invoer / uitvoer | Context / maximaal vermogen | Standaardinspanning | Cache lezen |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-sonnet-5-5 | Actief · Snel | $2 / $10 per MTok | 1M / 128K | Hoog | $0.20 / MTok |
| Claude Opus 5,5 | claude-opus-5-5 | Actief · Matig | $4 / $20 per MTok | 1M / 128K | Medium | $0.20 / MTok |
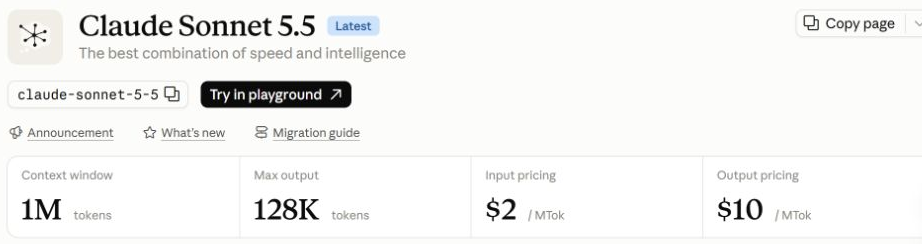
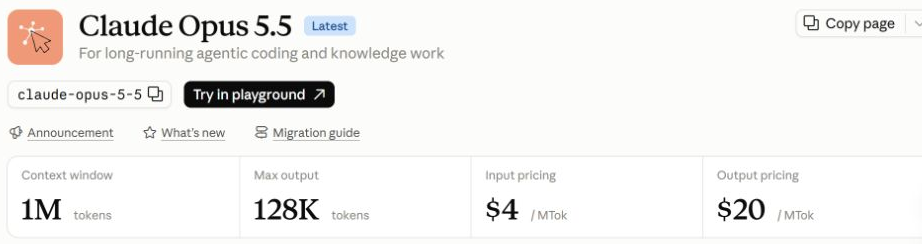
Voor een eenvoudig voorbeeld zonder caching met 100.000 invoertokens en 20.000 uitvoertokens komen de vermelde tokensnelheden neer op ongeveer $0,40 op Sonnet 5,5 en $0,80 op Opus 5,5. Zie de Gids voor prijzen en limieten van Claude voor de context van het plan.
Officiële benchmarkcontext
Anthropic’s Aankondiging Sonnet 5.5 zet beide modellen in één door de zorgverlener ingevulde tabel. De indeling van de rijen varieert per benchmark en inspanningsniveau.
| Door Anthropic gerapporteerde benchmark | Sonnet 5.5 | Opus 5.5 | Maat |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,4%¹ | Agentische terminale codering |
| FrontierCode v1.1 (Hoofdversie) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Of wijzigingen in de code zouden worden samengevoegd |
| CursorBench 4.0 | 55.5% | 57.8% | Dubbelzinnige codeertaken met meerdere bestanden |
| GDPval-AA v2.1 | 1844 | 1846 | Kenniswerk in verschillende beroepen |
| Het laatste examen van de mensheid | 64.5% met gereedschap | 67,71 TP40T inclusief gereedschap | Multidisciplinair redeneren |
| OSWorld 2.1 | 80.1% gedeeltelijk | 81,81 TP40T gedeeltelijk | Taken waarbij een computer wordt gebruikt |
| Kartografie | 61,61 TP40T zonder gereedschap | 64,41 TP40T zonder gereedschap | Herkenning van visuele grafieken |
¹ Opus 5.5 Terminal-Bench maakt gebruik van de instelling ‘xhigh effort’; ² Sonnet 5.5 FrontierCode heeft een waarde van 46,2% bij ‘Max’ en 52,1% bij ‘Xhigh effort’. De waarden van OSWorld zijn gemarkeerd als ‘gedeeltelijk’. Dit zijn waarden in de context van de provider, geen onafhankelijke herhaling bij gelijke inspanning.
API-methode met dezelfde prompt
Elk model kreeg dezelfde vijf prompts via POST-https://anywhere.broly.ai/v1/messages. De klant heeft één gebruikersbericht verzonden, max_tokens: 8192, output_config.effort: hoog, en geen tools. Elk verzoek leverde een HTTP 200-statuscode op en einde beurt.
De testaanpak sluit aan bij de bredere GlobalGPT-workflow voor het testen van modellen. Een aparte Claude API-handleiding behandelt het instellen van verzoeken en het bijhouden van tokens.
Tijd, tokens en geschatte kosten
| Route | Vijf uur lokale tijd | Invoertokens | Uitgangstokens | Gerapporteerde gedachten | Geschatte kosten van de aanvraag* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 s | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 s | 700 | 3,952 | 2,214 | $0.08184 |
* Schatting op basis van de door de route gerapporteerde tokens en officiële standaardtarieven. Sonnet 5.5 lag in deze groep 33,1% lager wat betreft de lokale verstreken tijd en 32,0% lager wat betreft het aantal output-tokens.
Vijf bij elkaar horende taakkaarten
Op elke kaart staan de taak, de waarneming, de lokale tijd, de gerapporteerde routetokens, de status en de grens bij elkaar vermeld.
Kunnen de modellen een gedupliceerde functie van gemengd type herstellen?
Opzet van de taak: De exacte opdracht is overgenomen uit de eerdere Claude Opus 5.5 recensie proefpakket.
| Model | Tijd / routegebruik | Korte resultaatbenaming |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 s 145 ingangen / 830 uitgangen 0 gedachten HTTP 200 · einde beurt | Gecorrigeerde opgave plus twee toetsen; kortere uitleg. |
| Claude Opus 5,5 | 15,844 s 145 invoer / 1478 uitvoer 700 gedachten HTTP 200 · einde beurt | De functie is gecorrigeerd en er zijn twee toetsen toegevoegd; er is meer aandacht besteed aan randgevallen. |
Geconstateerde vergelijking: Beide leverden een gecorrigeerde functie en twee tests op. Sonnet 5.5 maakte gebruik van sleutels met typetags, casefold(), en een terugvaloptie in de vorm van een lijst in een korter antwoord; Opus 5.5 besteedde meer uitvoertokens aan het toelichten van aanvullende randgevallen. Bij geen van beide tests komt er een algemene winnaar uit de bus wat betreft de codering.
Grens: Een enkele kleine aanpassing in Python controleert specifieke randgevallen, maar zegt niets over de betrouwbaarheid in verschillende repositories of bij het coderen met behulp van tools.
Kunnen de modellen de vijf opgegeven feiten behouden zonder beweringen toe te voegen?
Opzet van de taak: De exacte opdracht is overgenomen uit de eerdere Claude Opus 5.5 recensie proefpakket.
| Model | Tijd / routegebruik | Korte resultaatbenaming |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 s 210 ingang / 209 uitgang 0 gedachten HTTP 200 · einde beurt | Vijf genummerde opsommingstekens; de verstrekte feiten zijn behouden. |
| Claude Opus 5,5 | 4,374 s 210 ingangen / 312 uitgangen 101 manieren van denken HTTP 200 · einde beurt | Vijf genummerde opsommingstekens; de verstrekte feiten zijn behouden. |
Geconstateerde vergelijking: Beide leverden precies vijf genummerde punten op en bleven binnen de gegeven feiten. Sonnet 5.5 gebruikte 209 output-tokens, tegenover 312 bij Opus 5.5, maar de prompt was een kort bericht in plaats van een invoer met een brede context.
Grens: Dit is een grondige controle van de extractie en opmaak; het is geen bewijs van de prestaties in een context van miljoenen tokens.
Kunnen de modellen de exact gevraagde structuur weergeven?
Opzet van de taak: De exacte opdracht is overgenomen uit de eerdere Claude Opus 5.5 recensie proefpakket.
| Model | Tijd / routegebruik | Korte resultaatbenaming |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 s 128 ingangen / 260 uitgangen 0 gedachten HTTP 200 · einde beurt | Parseerbare JSON; gevraagde sleutels en het aantal items. |
| Claude Opus 5,5 | 8,276 s 128 ingangen / 622 uitgangen 390 gedachten HTTP 200 · einde beurt | Parseerbare JSON; gevraagde sleutels en het aantal items. |
Geconstateerde vergelijking: Beide leverden parseerbare JSON op met de gevraagde sleutels en twee voor- en twee nadelen. Sonnet 5.5 was met 260 uitvoertokens beknopter; de teksten beschrijven een fictieve recensieopzet en zijn geen productgegevens.
Grens: Het eenmalig doorlopen van dit schema geeft geen beeld van de betrouwbaarheid van gestructureerde output bij het gebruik van tools of tijdens lange gesprekken.
Kunnen de modellen de afgeronde reeks stappen doorvoeren tot aan het uiteindelijke antwoord?
Opzet van de taak: De exacte opdracht is overgenomen uit de eerdere Claude Opus 5.5 recensie proefpakket.
| Model | Tijd / routegebruik | Korte resultaatbenaming |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 s 89 ingangen / 163 uitgangen 0 gedachten HTTP 200 · einde beurt | Juiste uitkomst: 67; het definitieve antwoord op een aparte regel. |
| Claude Opus 5,5 | 3,830 s 89 ingangen / 257 uitgangen 74 gedachten HTTP 200 · einde beurt | Juiste uitkomst: 67; het definitieve antwoord op een aparte regel. |
Geconstateerde vergelijking: Beide berekenden 67 en plaatsten het definitieve antwoord op een aparte regel. Sonnet 5.5 gebruikte 163 uitvoertokens, tegenover 257 bij Opus 5.5, zonder dat er bij deze prompt een verschil in juistheid werd waargenomen.
Grens: Eén rekenreeks volstaat niet om de betrouwbaarheid van breed redeneren in te schatten.
Kan de route de gevraagde indeling in twee alinea’s behouden?
Opzet van de taak: De exacte opdracht is overgenomen uit de eerdere Claude Opus 5.5 recensie proefpakket.
| Model | Tijd / routegebruik | Korte resultaatbenaming |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 s 128 ingangen / 1224 uitgangen 987 gedachten HTTP 200 · einde beurt | Twee Chinese alinea’s; geen extra opmaak. |
| Claude Opus 5,5 | 15,401 s 128 ingangen / 1283 uitgangen 949 gedachten HTTP 200 · einde beurt | De punten zijn behandeld; Markdown en een opmerking in het Engels toegevoegd. |
Geconstateerde vergelijking: Sonnet 5.5 leverde de gevraagde twee Chinese alinea’s op zonder extra opmaak. Opus 5.5 behandelde eveneens de gevraagde punten, maar voegde Markdown-opmaak en een Engelse opmerking toe. Dit verslag heeft betrekking op de opmaak in één doorloop, niet op de algehele kwaliteit van het Chinees.
Grens: De opdracht vraagt om een inleiding over Opus 5.5, dus de tekst zelf is geen neutrale taalbenchmark.
Aandachtspunten met betrekking tot API’s en migratie
Sonnet 5.5 gebruikt standaard adaptief denken; de instelling ‘thinking: disabled’ levert een 400-fout op, en max_tokens omvat zowel het denken als de responstekst. Een geforceerde tool_choice met de waarde ‘any/tool’ wordt afgewezen. Analyseer inhoudsblokken op type en stel de tokenbudgetten opnieuw in op de basiswaarde voordat je overschakelt.
Wat uit de bewijzen blijkt
Oordeel op taakniveau
Sonnet 5.5: lagere gemeten kosten en tijd op deze route, waarbij de Chinese opdracht strikt volgens de opgestelde richtlijnen is uitgevoerd.
Opus 5.5: hier duurder en uitgebreider; officiële benchmark-reeksen blijven bij verschillende taken met een open einde voorop lopen.
Gebruik de gegevens op taakniveau om een startpunt te kiezen en bepaal vervolgens welke werklast voor jou van belang is.
Zie voor de aanverwante context de Vergelijking van de Claude-serie, Recensie van Opus 5, en Recensie van Fable 5.1.
FAQ
Welk model was sneller in de vergelijkende test?
Sonnet 5.5 had de laagste lokale totale tijd: 31,930 seconden tegenover 47,725 seconden voor Opus 5.5 bij vijf opeenvolgende verzoeken. Hierin zijn de hier gebruikte route en het netwerkpad meegerekend, dus het gaat niet om latentie aan de kant van de provider.
Welk model gebruikte minder output-tokens?
Sonnet 5.5 gebruikte 2.686 door de route gerapporteerde output-tokens bij de vijf taken, tegenover 3.952 voor Opus 5.5. Het aantal tokens op zich zegt niets over de kwaliteit van de antwoorden.
Welk model was in deze test goedkoper?
Op basis van de officiële standaard API-tarieven en het aantal geretourneerde invoer- en uitvoergegevens, komen de vijf Sonnet 5.5-verzoeken uit op een geschatte waarde van $0.02826, tegenover $0.08184 voor Opus 5.5. Bij deze berekening is geen rekening gehouden met cachekosten, platformkredieten, belasting en opslag.
Presteert de Sonnet 5.5 in elke benchmark beter dan de Opus 5.5?
De eigen tabel van nr. Anthropic is een mix van benchmark- en inspanningsinstellingen: Sonnet 5.5 scoort hoger op Terminal-Bench 4.0, terwijl Opus 5.5 hoger scoort op FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld en Chartography. Dit zijn door de leverancier gerapporteerde resultaten, geen onafhankelijke herhalingstest.
Is Sonnet 5.5 een directe vervanging voor de API?
Nee. In de migratiegids staat dat ‘thinking’ standaard wordt uitgevoerd, dat ‘thinking: disabled’ een 400-foutmelding oplevert, dat de gedwongen toolkeuze ‘any/tool’ wordt afgewezen en dat clients inhoudsblokken op type moeten parseren. Stel de tokenbudgetten en tool-loops opnieuw in op de basiswaarden voordat je overschakelt.
Was dit een benchmark met een lange context?
Nee. De extractieopdracht bevat een korte tekst. Er wordt gecontroleerd of de inhoud feitelijk klopt en of de opmaak correct is; er wordt niet gekeken naar gedrag in de buurt van het gedocumenteerde contextvenster van 1 miljoen tokens.



