Zal een AI-aanbieder uw klantdocument, productfoto, spraakopname of 3D-ontwerp gebruiken om zijn modellen te trainen? Het antwoord hangt af van de serviceovereenkomst en de gegevensinstellingen die bij het verzoek horen. Het feit dat u voor toegang betaalt, geeft op zich nog geen uitsluitsel over deze vraag.
Snel antwoord: Verschillende officiële API’s en bedrijfsdiensten beloven dat ze niet trainen op basis van klantcontent, soms met uitzonderingen op basis van toestemming of feedback. Andere diensten staan training wel toe, bieden een opt-out-mogelijkheid of laten delen van hun beleid onduidelijk. Een belofte om niet te trainen betekent niet automatisch dat er geen opslag plaatsvindt, dat er geen menselijke beoordeling plaatsvindt of dat de output privé blijft.
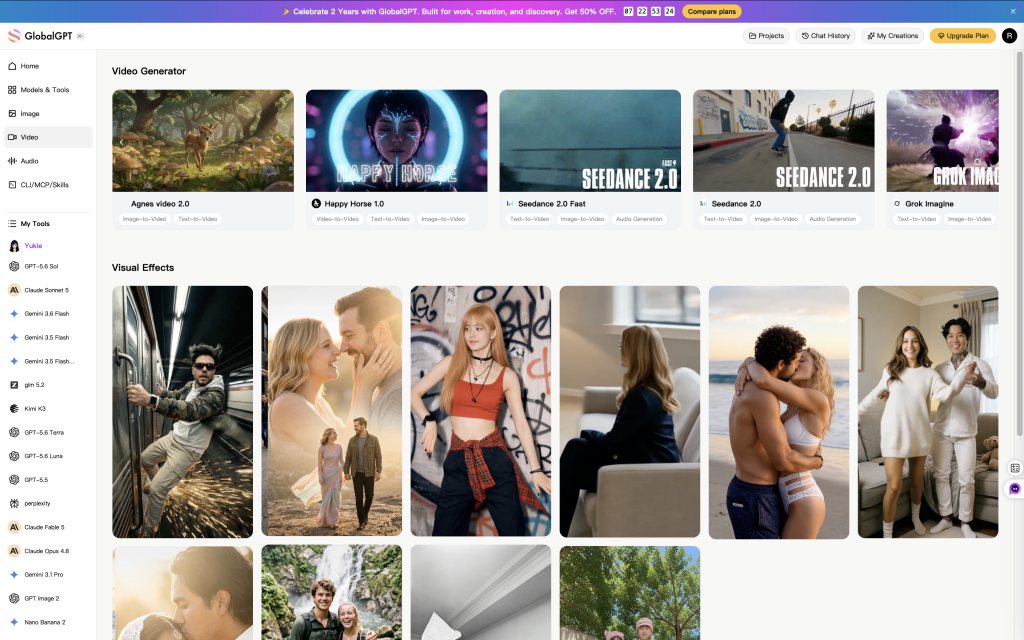
Deze vergelijking heeft betrekking op 121 vermeldingen van modellen en versies uit de modelcatalogus en de startpagina van GlobalGPT: 64 tekst- en multimodale modellen, 21 afbeeldingen, 24 video’s, zeven audio- en muziekmodellen en vijf 3D-modellen. Modellen die onder hetzelfde beleid vallen, zijn in de tabellen gegroepeerd; gebruik de zoekkaart om een specifieke versie op te zoeken. De namen zijn afkomstig uit de catalogus van het platform; ze vormen geen onafhankelijke verificatie van de identiteit of het contract van elk upstream-model.
Als je een alles-in-één AI-abonnement, het eigen beleid van het platform speelt ook een rol bij deze beslissing. GlobalGPT brengt deze categorieën samen in één account. Het onderstaande beleid van de aanbieder blijft gekoppeld aan de genoemde diensten; dit betekent niet dat elk GlobalGPT-model dezelfde bedrijfsbescherming biedt.
Overzicht van het beleid en momentopname van de catalogus: 11 september 2026. Dit is een vergelijking van gepubliceerde voorwaarden, geen controle van het gedrag van de backend. De daadwerkelijke upstream-service, het contract en de instellingen voor elke GlobalGPT-vermelding zijn niet geverifieerd. Met “alle modellen” worden alle vermeldingen in deze momentopname van de catalogus bedoeld, niet alle AI-modellen wereldwijd.
Alle 121 modellen: vergelijking van de privacyfuncties
Lees het trainingsresultaat samen met de omvang van de dienstverlening. Standaard geen training kunnen uitzonderingen op basis van opt-in of feedback bevatten. Training toegestaan geeft aan dat toestemming is verleend, maar vormt geen bewijs dat juist jouw bestand is gebruikt. Onbekend betekent dat het relevante bewijsmateriaal ontbreekt of onvolledig is. Wanneer er verschillen bestaan tussen gewone en zakelijke diensten, worden beide onderscheiden in plaats van het model één onvoorwaardelijk oordeel toe te kennen.
In de tabellen worden versies binnen elke categorie gegroepeerd wanneer ze dezelfde beleidsgegevens delen. Vouw een productfamilie uit om alle catalogusnamen te bekijken, of zoek boven de tabellen naar een specifiek model. Er is geen rij die bevestigt dat GlobalGPT de genoemde bedrijfsovereenkomst heeft ondertekend.
Bekijk het privacybeleid van een model
Zoek in alle 121 catalogusvermeldingen. Probeer eens Claude, DeepSeek, Seedance of Meshy.
Voer een naam in om de bijbehorende policy te zoeken. Er wordt geen zoekopdracht naar een server verzonden.
| Modellenreeks / uitvoeringen | Gepubliceerde vacature voor een opleidingsfunctie | Omvang van de dienstverlening — Toepasselijkheid van GlobalGPT niet geverifieerd |
|---|---|---|
| OpenAI GPT & redeneren | Standaard geen training | Officiële OpenAI-API; voor ChatGPT voor consumenten en andere hostingdiensten gelden afzonderlijke beleidsregels. |
| Claude | Standaard geen training | Commerciële producten en API’s van het type Anthropic; persoonlijke diensten van het type Claude vallen buiten deze vergelijking. |
| Tweelingen | Hangt af van de Google-dienst | Gemini API (betaalde of onbetaalde diensten), en afzonderlijk Google Cloud Vertex AI; Gemini voor consumenten valt hier niet onder. |
| Grok | Geen training zonder toestemming | Officiële xAI-API, inclusief gedocumenteerde mediabedieningsfuncties; voor consumenten (Grok) gelden aparte beleidsregels. |
| DeepSeek | Training toegestaan; recht op weigering | Privacybeleid van DeepSeek Official Service; toepassingen van downstream-ontwikkelaars en de bijbehorende contracten staan hier los van. |
GLM / Z.ai4 modellen | API sluit verbeteringen standaard uit | De Z.ai-API voor bedrijven en ontwikkelaars en, afzonderlijk, de persoonlijke diensten van Z.ai; andere GLM-hosts vallen buiten deze voorwaarden. |
Kimi / Moonshot4 modellen | Training is toegestaan, tenzij anders overeengekomen | De algemene API-voorwaarden van Kimi OpenPlatform; afzonderlijke bedrijfsovereenkomsten of schriftelijke overeenkomsten kunnen het gebruik beperken. |
Qwen3 modellen | Hangt af van de dienst en het abonnement | Voorwaarden van Alibaba Cloud Bailian op het vasteland; voor internationale Model Studio en API-diensten van derden is een afzonderlijke beoordeling vereist. |
Muse Spark2 modellen | Onbekend | Vermeldingen op het Muse Spark-platform; de exacte koppeling met de aanbieder en de overeenkomst inzake gehoste diensten zijn nog niet vastgelegd. |
| Modellenreeks / uitvoeringen | Gepubliceerde vacature voor een opleidingsfunctie | Omvang van de dienstverlening — Toepasselijkheid van GlobalGPT niet geverifieerd |
|---|---|---|
GPT-afbeelding2 modellen | Standaard geen training | Officiële OpenAI-beeld-API; het exacte model en eindpunt zijn van belang |
Nano banaan3 modellen | Voorwaardelijke bescherming zonder training | Gemini-beeldmodellen en Nano Banana-labels; voor een betaald Gemini API- of Vertex AI-abonnement is bevestiging vereist. |
| Seedream | Standaardbeperking bij het trainen van fundatiemodellen | BytePlus AI- en modeldiensten; de routing van Ark en Seed Audio op het vasteland valt niet onder deze voorwaarden. |
| Ideogram | Van het plan afhankelijke bescherming | Standaard Ideogram-diensten en Enterprise; de dekking van het API-contract kan verschillen |
| FLUX-afbeeldingen | Training is toegestaan; de regels variëren | Standaarddiensten van BFL, de officiële FLUX-API en Enterprise-overeenkomsten |
Agnes1 model | Onbekend | Agnes-platformlabel; de identiteit van de dienstverlener en de toepasselijke overeenkomst zijn nog niet bevestigd. |
| Reis halverwege | Onduidelijkheid over de verplichting tot het volgen van een opleiding | Midjourney-gebruiksvoorwaarden; toegangsregelingen voor derden vereisen een afzonderlijke bevestiging |
| Modellenreeks / uitvoeringen | Gepubliceerde vacature voor een opleidingsfunctie | Omvang van de dienstverlening — Toepasselijkheid van GlobalGPT niet geverifieerd |
|---|---|---|
Sora1 model | API-standaardinstelling zonder training | OpenAI /v1/videos-gegevensbeleid; deze vermelding zegt niets over de huidige beschikbaarheid van de dienst. |
| Veo | Voorwaardelijke bescherming zonder training | Veo via een geïdentificeerde Google-dienst; de toegang door consumenten en derden moet afzonderlijk worden beoordeeld. |
| Seedance | Standaardbeperking bij het trainen van fundatiemodellen | BytePlus AI- en modeldiensten; de routing van Ark en Seed Audio op het vasteland valt niet onder deze voorwaarden. |
| Kling | Training toegestaan; intrekking mogelijk | Kling: algemene servicevoorwaarden; voor de dekking van bedrijfs- en platform-API’s is een afzonderlijke bevestiging vereist. |
Wan4 modellen | Hangt af van de dienst en het abonnement | Voorwaarden van Alibaba Cloud Bailian op het vasteland; voor internationale Model Studio en API-diensten van derden is een afzonderlijke beoordeling vereist. |
Startbaan1 model | Afhankelijk van het contract | Runway standaarddiensten vergeleken met Runway Enterprise Services. |
Luma1 model | API/Enterprise: geen training | Standaard Luma-webservices versus API- en Enterprise-overeenkomsten |
MiniMax1 model | Omvang van de opleiding niet vastgesteld | Voorwaarden voor het MiniMax API-platform; de afhandeling van consumentendiensten via Hailuo is hier niet vastgelegd. |
Grok Verbeelden2 modellen | Geen training zonder toestemming | Officiële xAI-API, inclusief gedocumenteerde mediabedieningsfuncties; voor consumenten (Grok) gelden aparte beleidsregels. |
Happy Horse1 model | Onbekend | Toetreding tot het Happy Horse-platform; de identiteit van de opdrachtgever en de toepasselijke voorwaarden voor gegevensverwerking zijn nog niet bevestigd. |
FLUX 3-video1 model | Onbekend | FLUX 3: aanmelding voor het videoplatform; leveranciers en diensten zijn nog niet bevestigd. |
| Agnes | Onbekend | Agnes-platformlabel; de identiteit van de dienstverlener en de toepasselijke overeenkomst zijn nog niet bevestigd. |
| Modellenreeks / uitvoeringen | Gepubliceerde vacature voor een opleidingsfunctie | Omvang van de dienstverlening — Toepasselijkheid van GlobalGPT niet geverifieerd |
|---|---|---|
Qwen1 model | Hangt af van de dienst en het abonnement | Voorwaarden van Alibaba Cloud Bailian op het vasteland; voor internationale Model Studio en API-diensten van derden is een afzonderlijke beoordeling vereist. |
Seed Audio1 model | Standaardbeperking bij het trainen van fundatiemodellen | BytePlus AI- en modeldiensten; de routing van Ark en Seed Audio op het vasteland valt niet onder deze voorwaarden. |
ElevenLabs3 modellen | Opleiding toegestaan; mogelijkheid tot afzien van deelname | Standaard ElevenLabs-diensten; bedrijfs- en zakelijke processen worden apart geregeld. |
Mureka1 model | Onbekend volgens de huidige geldende voorwaarden | Toetreding tot het Mureka v9-platform; de huidige voorwaarden voor de beheersdienst en de API-overeenkomst zijn nog niet bevestigd. |
Lyria1 model | Bescherming via een betaalde dienst met een veiligheidsuitzondering | Lyria via de Gemini-API; het Lyria 3-label van het platform vereist een exacte koppeling tussen modellen en diensten. |
| Modellenreeks / uitvoeringen | Gepubliceerde vacature voor een opleidingsfunctie | Omvang van de dienstverlening — Toepasselijkheid van GlobalGPT niet geverifieerd |
|---|---|---|
Hunyuan3D1 model | Ingangsbeveiliging; uitgang onduidelijk | De Tencent Cloud Hunyuan3D API en de bijbehorende voorwaarden voor grote modellen |
Meshy1 model | Opleidingen buiten het kader van de onderneming zijn toegestaan | Standaard-, API- en Enterprise-services; orderspecifieke uitzonderingen |
Tripo1 model | Betaalde dienst, geen training | Sectie ‘Tripo-betalende gebruikers’; gratis diensten en toegangsinstellingen verschillen |
Rodin1 model | Bescherming van privégegevens; er blijven nog hiaten | Hyper3D-voorwaarden, privacybeleid en opslag van door de API gegenereerde assets |
TRELLIS1 model | Hostingbeleid onbekend | Het TRELLIS-modelproject versus de dienst die het uitvoert |
Privacyverklaringen voor tekst- en multimodale AI-modellen
Controleer bij chat- en redeneringsmodellen het volledige gesprek en de bijlagen, en niet alleen de laatste prompt. Een document dat is geüpload om te worden samengevat, kan namen van klanten, contracten, code of financiële gegevens bevatten. Toestemmingen voor feedback kunnen betrekking hebben op een gesprek, zelfs als gewone API-verzoeken zijn uitgesloten van de training.
OpenAI-tekstmodellen: de API-standaardinstelling sluit training uit
Catalogusvermeldingen: GPT-6 Astra; GPT-5.6 Sol; GPT-5.6 Terra; GPT-5.6 Luna; GPT-5.5; GPT-5.4; GPT-5.4 mini; GPT-5.4 nano; GPT-5.3; GPT-5.2; GPT-5.1; GPT-5; GPT-5 mini; GPT-5 nano; GPT-4o; o1; o1 mini; o3; o3 mini; o3 Mini High; o4 mini; o4 Mini High.
Toepassingsgebied: Officiële OpenAI-API; voor ChatGPT voor consumenten en andere hostingdiensten gelden afzonderlijke beleidsregels.
Opleiding: De officiële invoer- en uitvoergegevens van de OpenAI-API worden niet gebruikt om OpenAI-modellen te trainen of te verbeteren, tenzij de klant er uitdrukkelijk voor kiest deze te delen.
Voor tekstmodellen die via de officiële OpenAI-API worden benaderd, worden de invoer- en uitvoergegevens van klanten standaard uitgesloten van de modeltraining. Als u expliciet instemt met het delen van gegevens, geldt hiervoor een uitzondering. Dit is een beleid van de API-dienst en geen bewijs dat elke klant een Enterprise-overeenkomst heeft gesloten, volgens Documentatie over gegevensbeheer van OpenAI.
Uit de op 11 september 2026 onderzochte beleidsdocumentatie blijkt dat er een onderscheid wordt gemaakt tussen training en opslag. Logbestanden voor misbruikmonitoring worden doorgaans maximaal 30 dagen bewaard, behoudens gedocumenteerde uitzonderingen. Voor de status van gesprekken, geüploade objecten en bepaalde cachingfuncties kunnen andere bewaartermijnen gelden. Een instelling waarbij geen training plaatsvindt, houdt daarom niet in dat elk verzoek onmiddellijk verdwijnt.
Veiligheids- en juridische procedures kunnen nog steeds van toepassing zijn. ‘Zero Data Retention’ en ‘Modified Abuse Monitoring’ kennen toelatingsvoorwaarden en beperkingen per eindpunt; het zijn geen algemene garanties dat niemand toegang heeft tot ingediende inhoud. Deze maatregelen moeten worden beoordeeld aan de hand van de specifieke functie die de prompt of het bestand verwerkt.
Informatie die naar externe tools of MCP-diensten op afstand wordt verzonden, valt eveneens onder het beleid van die ontvangers. De API-verplichting van OpenAI heeft geen invloed op de eigen opslag, openbare links of het delen met derden door GlobalGPT. De specifieke leverancierscontracten en routering van GlobalGPT zijn hier niet geverifieerd, en deze beleidsvergelijking doet geen uitspraken over de huidige beschikbaarheid van modellen.
Te controleren: Controleer de machtigingen voor het delen van gegevens en het daadwerkelijke eindpunt. Voor de aangepaste misbruikmonitoring en ‘Zero Data Retention’ gelden toelatingsvoorwaarden en is goedkeuring vereist; geen van beide is automatisch van toepassing op elke functie.
Claude: de beveiliging voor commerciële trainingen kent uitzonderingen op de machtigingen
Catalogusvermeldingen: Claude Fable 5,1; Claude Fable 5; Claude Opus 5; Claude Opus 4,8; Claude Opus 4,7; Claude Opus 4,6; Claude Opus 4,5; Claude Sonnet 5; Claude Sonnet 4,6; Claude Sonnet 4,5; Claude Sonnet 4; Claude Haiku 4,5.
Toepassingsgebied: Commerciële producten en API’s van het type Anthropic; persoonlijke diensten van het type Claude vallen buiten deze vergelijking.
Opleiding: Anthropic wordt standaard niet getraind op basis van invoer of uitvoer van commerciële producten. Op grond van het geldende beleid kunnen uitzonderingen worden gemaakt op basis van uitdrukkelijke toestemming of ingediende feedback.
Volgens het beleid inzake commerciële producten van Anthropic worden input- en outputgegevens standaard niet gebruikt om de modellen te trainen. Dit geldt voor de commerciële diensten waarop het beleid van toepassing is, inclusief het gebruik van API’s. Deze toezegging wordt beschreven in Veelgestelde vragen over het trainen van modellen bij Anthropic en mag niet worden veralgemeend naar elk persoonlijk Claude-account.
Toestemming is belangrijk. Klanten kunnen toestemming geven voor aanvullend gebruik, en expliciet ingediende feedback kan een gerelateerd gesprek bevatten. Een bedrijf dat Claude overweegt, moet daarom zowel rekening houden met de onderliggende commerciële voorwaarden als met eventuele feedback of keuzes inzake het delen van gegevens die van invloed kunnen zijn op de manier waarop een bepaalde interactie wordt afgehandeld.
In het beleid dat voor dit artikel is onderzocht, zijn geen vaste bewaartermijn, geen tijdschema voor verwijdering en geen gedetailleerde voorwaarden voor menselijke controle vastgelegd. Voor die kwesties gelden de toepasselijke voorwaarden voor gegevensverwerking. Het feit dat trainingen zijn uitgesloten, betekent op zich niet dat inhoud nooit wordt opgeslagen, op veiligheid wordt gecontroleerd of voor een ander toegestaan doel wordt bewaard.
Openbare zichtbaarheid en het verder delen zijn eveneens aparte kwesties. Uit de aangehaalde FAQ over trainingen blijkt niet of een ander platform een gesprek opslaat, een geüpload bestand via een link beschikbaar stelt of materiaal naar een aparte tool verstuurt. Voor GlobalGPT hangt de commerciële bescherming af van de daadwerkelijke leveranciersovereenkomst en de gebruikte dienst; een Claude-modelnummer alleen is hiervoor geen bevestiging.
Te controleren: Controleer of het gebruik voor commerciële doeleinden is toegestaan en of er toestemming is gegeven voor feedback of het delen van gegevens. De Claude-instellingen voor consumenten zijn niet bepalend voor de beperkingen die van toepassing zijn op het API-account van een ontwikkelaar.
Gemini: er is een verschil tussen de betaalde API, de gratis API en Vertex AI
Catalogusvermeldingen: Gemini 3.8 Flash; Gemini 3.7 Flash; Gemini 3.6 Flash; Gemini 3.5 Flash; Gemini 3.5 Flash Lite; Gemini 3.1 Pro; Gemini 3.1 Flash Lite; Gemini 3 Pro; Gemini 3 Flash; Gemini 2.5 Pro; Gemini 2.5 Flash; Gemini Omni Flash.
Toepassingsgebied: Gemini API (betaalde of onbetaalde diensten), en afzonderlijk Google Cloud Vertex AI; Gemini voor consumenten valt hier niet onder.
Opleiding: Bij de betaalde Gemini-API worden prompts en antwoorden uitgesloten van productverbetering; voor de gratis versie gelden andere regels. Voor het trainen of finetunen van modellen met Vertex AI is voorafgaande toestemming of instructie vereist.
De privacyclassificatie van Google hangt af van de dienst. Onder Gemini API-voorwaarden, Bij betaalde diensten worden prompts en reacties niet meegenomen bij productverbetering. Bij onbetaalde diensten is gebruik voor verbeteringsdoeleinden en beoordeling door mensen over het algemeen toegestaan, met specifieke regionale bepalingen voor de EER, Zwitserland en het Verenigd Koninkrijk. De status ‘betaald’ volgt de definities van Google met betrekking tot diensten en facturering.
Vertex AI-gegevensbeheer Daarnaast wordt uitdrukkelijk vermeld dat Google geen AI- of machine learning-modellen zal trainen of verfijnen met behulp van klantgegevens zonder voorafgaande toestemming of instructie. Dit is een toezegging van Google Cloud. Deze toezegging mag niet stilletjes worden vervangen door onbetaalde ontwikkelaarsdiensten of de Gemini-app voor consumenten.
De Gemini-beleid inzake het toezicht op API-misbruik bepaalt een termijn van 55 dagen voor prompts, context en uitvoer. Bevoegde medewerkers mogen gemarkeerde inhoud of verdachte projecten beoordelen. Misbruiklogboeken worden uitgesloten van algemene AI-training, met uitzondering van modellen die specifiek worden gebruikt voor de handhaving van beleid. De termijn van 55 dagen geldt voor de Gemini-API, niet voor Vertex AI.
Geen van deze verklaringen geeft uitsluitsel over de instellingen voor openbare links, de bestandsopslag of het verder delen van gegevens op een platform. Een GlobalGPT-abonnement geeft evenmin inzicht in het onderliggende betaalde project of contract van Google. Voor elke Gemini-vermelding zijn de relevante vragen welke Google-dienst deze verwerkt, of de definitie van een betaalde dienst van toepassing is en welke aanvullende bewaarfuncties worden gebruikt.
Te controleren: Controleer de Google-service, de factureringsstatus van het project en regionale uitzonderingen. Gegevens uit misbruikmonitoring kunnen modellen voor beleidshandhaving ondersteunen; een betaald abonnement houdt niet in dat er in alle gevallen geen gegevens worden bewaard.
Grok API: standaard geen training, met afzonderlijke instellingen voor het bewaren van gegevens
Catalogusvermeldingen: Grok 4,6; Grok 4,3.
Toepassingsgebied: Officiële xAI-API, inclusief gedocumenteerde mediabedieningsfuncties; voor consumenten (Grok) gelden aparte beleidsregels.
Opleiding: xAI verklaart dat het nooit zonder uitdrukkelijke toestemming modellen traint op basis van API-invoer of -uitvoer. Deze toezegging met betrekking tot de API vormt geen beleid voor de gewone consument Grok.
Voor de officiële API, Veelgestelde vragen over beveiliging bij xAI verklaart dat er nooit wordt getraind op basis van invoer of uitvoer van klanten zonder uitdrukkelijke toestemming. Hiermee wordt voor die dienst een standaardinstelling van ‘geen training’ vastgesteld. Dit geldt echter niet voor de regels met betrekking tot een persoonlijk Grok-gesprek of een onafhankelijk gehost model.
Standaard worden verzoeken en antwoorden in rust versleuteld en 30 dagen bewaard om onderzoek naar vermoedelijk misbruik of oneigenlijk gebruik mogelijk te maken; daarna worden ze automatisch verwijderd. In onderhandelde bedrijfsovereenkomsten kunnen andere bewaartermijnen worden vastgelegd. Het beleid biedt geen algemene garantie dat niemand ooit toegang kan krijgen tot de inhoud van de API.
Teams kunnen ‘Zero Data Retention’ (ZDR) inschakelen, waardoor wordt voorkomen dat invoer- en uitvoergegevens van verzoeken op schijf worden opgeslagen. Er gelden enkele beperkingen voor deze functie: afbeeldingen moeten in base64-formaat worden uitgevoerd, terwijl voor de levering van video’s de uploadbestemming van de klant moet worden gebruikt in plaats van de door xAI gehoste opslag voor uitvoergegevens. Aan de hand van de gedocumenteerde responsheader kan worden gecontroleerd of ZDR voor een bepaald team actief is.
Het feit dat xAI geen gegevens bewaart, heeft geen invloed op de opslag of de zichtbaarheid van links op een afzonderlijk platform, een externe uploadbestemming of de eigen systemen van een klant. De xAI-route en teaminstellingen van GlobalGPT zijn niet geverifieerd. Elke Grok- of Imagine-vermelding vereist daarom de toepasselijke API-overeenkomst en daadwerkelijke controles voordat deze een sterkere privacygarantie kan bieden.
Te controleren: Teams kunnen ‘Zero Data Retention’ inschakelen, mits er geen beperkingen gelden voor deze functie. Controleer de daadwerkelijke teaminstelling; voor de opslag van afbeeldingen en video’s zijn specifieke uitvoermethoden vereist.
DeepSeek: toestemming voor een opleiding betekent niet dat er geen recht op weigering bestaat
Catalogusvermeldingen: DeepSeek V4.1 Flash; DeepSeek V4 Pro; DeepSeek V4 Flash.
Toepassingsgebied: Privacybeleid van DeepSeek Official Service; toepassingen van downstream-ontwikkelaars en de bijbehorende contracten staan hier los van.
Opleiding: Het officiële dienstverleningsbeleid van DeepSeek staat training en verbetering toe, maar erkent tegelijkertijd het recht om het gebruik van persoonsgegevens voor het trainen van modellen of technische optimalisatie binnen het toepassingsgebied daarvan te weigeren.
De Privacybeleid van DeepSeek Official Service maakt het gebruik van gegevens voor trainings- en verbeteringsdoeleinden mogelijk, terwijl tegelijkertijd het recht wordt erkend om het gebruik van persoonsgegevens voor het trainen van modellen of technische optimalisatie te weigeren. Dat onderscheid is belangrijk: toestemming voor het gebruik van gegevens en de mogelijkheid voor een gebruiker om bezwaar te maken, zijn afzonderlijke onderdelen van het beleid.
Het vastgestelde recht op weigering heeft betrekking op persoonsgegevens. Dit recht mag niet worden uitgebreid tot een onvoorwaardelijke garantie die geldt voor elk geüpload document, elke gegenereerde reactie of elke niet-persoonlijke invoer. In de onderzochte beleidsdocumenten wordt geen melding gemaakt van een specifieke productschakelaar, de technische uitvoering van een verzoek en het effect daarvan op gegevens die al voor training zijn gebruikt.
Ook voor dit item zijn geen vaste bewaartermijn, gedetailleerd verwijderingsschema en specifieke voorwaarden voor menselijke controle vastgesteld. Het weigeren van training leidt niet noodzakelijkerwijs tot het verwijderen van gegevens die nodig zijn voor het beheer van een dienst, het afhandelen van beveiligingskwesties of het nakomen van toepasselijke verplichtingen. Het verwijderen van een gesprek is geen bewijs dat een reeds getraind model is gewijzigd.
Dit bewijs heeft betrekking op het officiële beleidsbereik van DeepSeek, waarin toepassingen van downstream-ontwikkelaars zijn uitgesloten. Het biedt geen uitsluitsel over het contract tussen GlobalGPT en DeepSeek, de instellingen voor het openbaar delen van gegevens of de opslagpraktijken. De juiste vergelijking is daarom training die is toegestaan met een gedocumenteerd recht op weigering van persoonsgegevens, terwijl de toepasselijke overeenkomst met een derde partij en de overige details inzake gegevensverwerking nog moeten worden bevestigd.
Te controleren: Het recht om de verwerking van persoonsgegevens te weigeren is vastgelegd. Een specifieke schakelaar, de technische uitvoering daarvan en het effect ervan op eerdere trainingen komen in de onderzochte beleidsdocumenten niet aan de orde.
GLM via Z.ai: de bescherming van API-inhoud verschilt van die van persoonlijke diensten
Catalogusvermeldingen: GLM-5.3; GLM-5.3 Flash; GLM-5.2; GLM-5.1.
Toepassingsgebied: De Z.ai-API voor bedrijven en ontwikkelaars en, afzonderlijk, de persoonlijke diensten van Z.ai; andere GLM-hosts vallen buiten deze voorwaarden.
Opleiding: Z.ai API-prompts en -uitvoer worden niet meegenomen bij de ontwikkeling of verbetering van de dienst, tenzij dit uitdrukkelijk is overeengekomen. De voorwaarden voor persoonlijke diensten staan een ruimer gebruik van de inhoud toe met het oog op verbetering.
In de voorwaarden van Z.ai wordt ‘gebruikerscontent’ gedefinieerd als prompts en output. Voor bedrijven en ontwikkelaars die gebruikmaken van de API, paragraaf IV.7 sluit het gebruik van die inhoud voor het ontwikkelen of verbeteren van diensten uit, tenzij de klant hiermee uitdrukkelijk instemt. Bepalingen inzake persoonlijke diensten staan daarentegen wel gebruik ten behoeve van verbetering toe, met inbegrip van niet-persoonlijke inhoud voor machine learning en de ontwikkeling van kunstmatige intelligentie.
De API overeenkomst inzake gegevensverwerking, artikel 4, onder b), stelt dat aangeleverde en gegenereerde inhoud in realtime wordt verwerkt en niet op servers wordt opgeslagen. In artikel 4, onder c), worden andere klantgegevens apart behandeld: deze mogen worden opgeslagen voor dienstverleningsdoeleinden of wettelijke doeleinden en worden na beëindiging verwijderd, met inachtneming van de wettelijke voorschriften.
Deze toezegging inzake de opslag van inhoud houdt niet in dat accountgegevens, betalingsinformatie of technische gegevens nooit worden verzameld. In de onderzochte beleidsdocumenten zijn geen gedetailleerde voorwaarden voor menselijke controle vastgelegd. De DPA beschrijft de verwerking in het algemeen in Singapore; die verklaring heeft betrekking op de betreffende dienst en niet op elke GLM-implementatie wereldwijd.
Te controleren: Bevestig dat de API-specifieke voorwaarden en de DPA van toepassing zijn. Het recht op bezwaar of het recht op intrekking met betrekking tot persoonsgegevens houdt geen specifieke schakelaar voor consumententraining in, noch biedt het bescherming door een andere host.
Kimi OpenPlatform: via de standaard API-toegang kan het platform voor trainingsdoeleinden worden gebruikt
Catalogusvermeldingen: Kimi K3; Kimi K2.6; Kimi K2.5; Moonshot v1.
Toepassingsgebied: De algemene API-voorwaarden van Kimi OpenPlatform; afzonderlijke bedrijfsovereenkomsten of schriftelijke overeenkomsten kunnen het gebruik beperken.
Opleiding: Met Kimi OpenPlatform mag Klantcontent worden gebruikt voor het trainen of verbeteren van Moonshot AI-modellen, tenzij in een afzonderlijke schriftelijke overeenkomst uitdrukkelijk anders is bepaald.
Kimi laat zien waarom toegang tot API’s geen algemene privacecategorie is. Het Voorwaarden van OpenPlatform, gedateerd 30 juli 2026, staan toe dat Klantcontent wordt gebruikt ter ondersteuning van de ontwikkeling en verbetering van de dienst. Daarin wordt klanten die beperkingen willen opleggen aan het trainen of verbeteren van modellen uitdrukkelijk verzocht om bedrijfsafspraken of een afzonderlijke schriftelijke overeenkomst te bespreken.
Tenzij uitdrukkelijk schriftelijk anders is overeengekomen, staan de voorwaarden het genoemde gebruik toe. Dit houdt een contractuele toestemming in, maar vormt geen bewijs dat een bepaalde prompt daadwerkelijk in een trainingsdataset is opgenomen. Een standaard API-account mag daarom niet worden aangemerkt als beschermd tegen training, louter omdat een ontwikkelaar voor verzoeken betaalt.
De Privacybeleid van OpenPlatform, gedateerd 30 april 2025, bepaalt dat account-, invoer- en betalingsgegevens worden bewaard zolang het account actief blijft. Het biedt bepaalde medewerkers toegang tot relevante informatie wanneer dat nodig is voor zakelijke doeleinden. In deze bepalingen zijn geen uniforme termijn voor verwijdering en geen garantie dat er geen menselijke toegang plaatsvindt vastgelegd.
In de onderzochte beleidsregels is geen specifieke overgangsregeling voor gewone accounts vastgelegd; de vastgelegde procedure is een contractueel overleg. De openbare zichtbaarheid en het verder delen van gegevens door een platform van een derde partij vereisen een afzonderlijke beoordeling. De leveranciersovereenkomst van GlobalGPT kan afwijken, maar de reikwijdte daarvan is hier niet geverifieerd, zodat de algemene OpenPlatform-regel geen uitzondering voor ondernemingen kan vaststellen.
Te controleren: Klanten die op zoek zijn naar beperkingen op het gebied van training, kunnen contact opnemen met Moonshot voor zakelijke afspraken of een afzonderlijke schriftelijke overeenkomst. Gewone API-toegang houdt niet automatisch een vrijstelling van de trainingsverplichting in.
Qwen en Wan: voor Bailian op het vasteland gelden belangrijke uitzonderingen op het plan
Catalogusvermeldingen: Qwen3.8 Max; Qwen3.8 Flash; Qwen3-30B-A3B.
Toepassingsgebied: Voorwaarden van Alibaba Cloud Bailian op het vasteland; voor internationale Model Studio en API-diensten van derden is een afzonderlijke beoordeling vereist.
Opleiding: Mainland Bailian verbiedt het zonder toestemming trainen van gesprekken, maar het Token Plan (persoonlijk) en het Coding Plan staan het gebruik van input/output uitdrukkelijk toe met het oog op verbetering van de dienstverlening en modeloptimalisatie.
Bailian op het vasteland’s documentatie inzake privacy beschrijft de beveiliging tegen gebruik tijdens trainingen. De bijbehorende serviceovereenkomst geeft de essentiële informatie: paragraaf 6.2.5 sluit het gebruik van gespreksgegevens bij het trainen van modellen uit zonder toestemming van de klant. Dit betreft het vasteland van Bailian, en niet automatisch de internationale versie van Alibaba Cloud Model Studio.
In paragraaf 5.2.2 wordt een belangrijke uitzondering gemaakt. Het Token Plan (persoonlijk) en het Coding Plan staan de opslag en het gebruik van invoer- en uitvoergegevens toe met het oog op verbetering van de dienstverlening en optimalisatie van het model. Het Token Plan-team valt buiten het toepassingsgebied van die zin. Het beëindigen van de betreffende dienst maakt een einde aan de toekomstige toestemming, maar trekt de toestemming voor reeds verwerkte inhoud niet in.
Trainingsbescherming betekent niet dat er geen gegevens worden bewaard. Model- en applicatiegegevens kunnen worden opgeslagen, waarbij de bewaartermijn voor gesprekken beperkt blijft tot de kortst mogelijke periode die vereist is op grond van de toepasselijke verplichtingen. Er is geen algemeen aantal dagen vastgesteld. Paragraaf 4.3.1 staat ook technische of menselijke controle toe van ingediende inhoud en gegenereerde resultaten.
API’s van derden kennen nog een andere beperking: in paragraaf 6.2.9 vallen opslag, verwijdering en inhoudsfiltering onder de overeenkomst voor diensten van derden. Deze bepalingen hebben geen betrekking op instellingen voor openbare links of de daadwerkelijke GlobalGPT-, Qwen-, Wan- of audiohostingroute van GlobalGPT. De specifieke dienst, het abonnement en het contract met de leverancier moeten worden geïdentificeerd voordat aan het betreffende model definitief de status ‘geen training’ kan worden toegekend.
Te controleren: Wat de uitzondering op het abonnement betreft: het beëindigen van het gebruik maakt een einde aan toekomstige toestemming, niet aan eerder toegestaan gegevensgebruik. Voor de omgang met API’s van derden geldt een aparte overeenkomst; de internationale voorwaarden blijven los daarvan staan.
Muse Spark: het geldende beleid inzake gehoste diensten is nog onbekend
Catalogusvermeldingen: Muse Spark 1.3; Muse Spark 1.2.
Toepassingsgebied: Vermeldingen op het Muse Spark-platform; de exacte koppeling met de aanbieder en de overeenkomst inzake gehoste diensten zijn nog niet vastgelegd.
Opleiding: In het onderzochte beleid is geen toepasselijke opleidingsregel vastgelegd voor de genoemde door Muse Spark gehoste dienst; hieruit blijkt niet dat er opleidingen plaatsvinden.
Voor de Muse Spark-bijdragen in deze vergelijking zijn de exacte koppeling aan een aanbieder en de toepasselijke overeenkomst voor gehoste diensten niet vastgesteld. De classificatie van de training is daarom onbekend. Dit is een constatering met betrekking tot het beschikbare beleidsmateriaal, en geen bewering dat het model is getraind op ingediende prompts of gegenereerde antwoorden.
In het beleid dat voor deze gehoste dienst is beoordeeld, zijn evenmin een bewaartermijn, een tijdschema voor verwijdering en een gedetailleerd beleid inzake menselijke controle vastgelegd. Uit de modelnaam alleen kan niet worden afgeleid of prompts, geüploade bestanden, uitvoer en technische logbestanden verschillend worden behandeld, of dat er uitzonderingen gelden voor beveiligingsonderzoeken en wettelijke verplichtingen.
Dezelfde onzekerheid geldt voor de zichtbaarheid voor het publiek en het verder delen van gegevens. Uit een vermelding op het platform blijkt niet of bestanden privé zijn, of dat links naar de output voor anderen toegankelijk zijn, of welke verwerkingspartners het ingediende materiaal ontvangen. Die details horen thuis in de betreffende hostingovereenkomst en de servicedocumentatie, en mogen niet worden afgeleid uit de merknaam.
De licentievoorwaarden voor open gewichten, voor zover deze van toepassing zijn op een ander model, regelen het gebruik van software of gewichten; ze bepalen niet hoe een hostingbedrijf met klantgegevens omgaat. Voor deze Muse Spark-vermeldingen is in de onderzochte beleidsregels noch een verbintenis tot het niet geven van training aan ondernemingen, noch een specifieke opt-out vastgelegd. De juiste classificatie blijft onbekend totdat de specifieke gehoste dienst en de bijbehorende voorwaarden zijn vastgesteld.
Te controleren: In de onderzochte beleidsregels zijn geen bepalingen opgenomen met betrekking tot het afzien van trainingen, de dekking voor ondernemingen en controles op het openbaar delen van gegevens. Een open-weight-licentie biedt geen garantie voor de gegevensbescherming door een hostingprovider.
Voordat je een ChatGPT Bedrijfsplan Beoordeel voor een team de geldende zakelijke overeenkomst en administratieve controles, naast de abonnementsfuncties. Die controles worden niet automatisch overgedragen naar een account op een ander platform.
Privacybeleid van AI-beeldgeneratoren
Beeldprivacy heeft betrekking op je prompt, geüploade referentiefoto’s, bronbestanden die voor bewerking zijn gebruikt en gegenereerde afbeeldingen. Met de instelling ‘privé-galerij’ kun je voorkomen dat andere gebruikers een afbeelding zien, zonder dat dit de aanbieder belet deze te gebruiken voor trainingsdoeleinden.
OpenAI-beeldmodellen: standaard geen training via de API
Catalogusvermeldingen: GPT Image 2.5; GPT Image 2.
Toepassingsgebied: Officiële OpenAI-beeld-API; het exacte model en eindpunt zijn van belang
Opleiding: OpenAI maakt bij het trainen van modellen geen gebruik van officiële API-prompts, referentieafbeeldingen of gegenereerde output, tenzij de klant er uitdrukkelijk voor kiest om gegevens te delen.
De beeld-API van OpenAI volgt de standaardregel die voor alle API’s geldt: klantgegevens worden niet gebruikt om OpenAI-modellen te trainen of te verbeteren, tenzij de klant hier uitdrukkelijk toestemming voor geeft. Dit onderscheid is van belang bij het uploaden van referentiefoto’s, productontwerpen of afbeeldingen die bewerkt moeten worden. De bescherming vloeit voort uit de toepasselijke Beleid inzake API-gegevens, in plaats van de weergavenaam van het afbeeldingsmodel.
Het feit dat een afbeelding niet wordt gebruikt voor training, betekent niet dat deze onmiddellijk wordt verwijderd. In dezelfde documentatie wordt vermeld dat afbeeldings-endpoints 30 dagen worden bewaard voor misbruikcontrole en dat er geen applicatiestatus wordt bijgehouden, behoudens de genoemde uitzonderingen. Een platform van een derde partij kan ook zijn eigen uploads, gegenereerde afbeeldingen of leveringskopieën volgens een afzonderlijk schema bewaren.
Afbeeldingen en bestanden die worden geüpload, worden aan een veiligheidscontrole onderworpen. Materiaal dat mogelijk seksueel misbruik van kinderen bevat, kan worden bewaard voor beoordeling op grond van de gedocumenteerde uitzondering, ook wanneer ‘Zero Data Retention’ is ingeschakeld. Een belofte dat er geen training plaatsvindt, houdt dan ook niet in dat niemand het ingezonden materiaal ooit kan beoordelen.
‘Zero Data Retention’ is een afzonderlijke, op goedkeuring gebaseerde controle met modelspecifieke toelatingsvoorwaarden. Voor een beeldmodel dat via GlobalGPT wordt aangeboden, bepalen het exacte upstream-model, het eindpunt en de toepasselijke accountcontroles of die optie van toepassing is. De naam alleen is niet voldoende om goedkeuring, uitgeschakelde gegevensuitwisseling of de levensduur van door het platform gehoste beeldbestanden vast te stellen.
Te controleren: Voor ‘Zero Data Retention’ zijn goedkeuring en compatibele modellen vereist. Controleer het exacte eindpunt van de afbeelding, de machtigingen voor het delen en de opslag op het platform voordat u een afbeeldingsworkflow als ‘zero retention’ behandelt.
Google-beeldmodellen: de dienst bepaalt de bescherming
Catalogusvermeldingen: Nano Banana; Nano Banana 2; Nano Banana Pro.
Toepassingsgebied: Gemini-beeldmodellen en Nano Banana-labels; voor een betaald Gemini API- of Vertex AI-abonnement is bevestiging vereist.
Opleiding: Bij de betaalde Gemini API worden prompts en antwoorden uitgesloten van productverbetering; Vertex AI beperkt het trainen zonder toestemming. Voor gratis diensten en consumentenproducten gelden andere regels.
Een referentiefoto, een bewerkingsinstructie en een gegenereerde afbeelding kunnen onder de inhoudsregels van dezelfde dienst vallen, maar de naam van het afbeeldingsmodel geeft geen uitsluitsel over welke regels dat zijn. Nano Banana-labels moeten eerst worden gekoppeld aan een specifiek model en een specifieke Google-dienst. Een abonnement op een ander platform bepaalt op zichzelf nog niet welke Google-overeenkomst van toepassing is op het verzoek.
Voor betaalde Gemini API-diensten, Google stelt dat het geen prompts of reacties gebruikt om zijn producten te verbeteren. Onder deze voorwaarden vallen ook ingediende bestanden, zoals afbeeldingen. Bij onbetaalde diensten is het gebruik voor verbeteringsdoeleinden en menselijke beoordeling over het algemeen toegestaan, met regionale uitzonderingen. Daarnaast, Vertex AI-gegevensbeheer beperkt het trainen of afstemmen zonder voorafgaande toestemming of instructie.
Deze beveiligingsmaatregelen houden niet in dat afbeeldingen onmiddellijk verdwijnen, dat niemand gemarkeerde inhoud kan bekijken of dat gegenereerde links privé zijn. Controleer de opslag van geüploade bestanden, de veilige verwerking en de eigen afbeeldingskopieën van het platform afzonderlijk. De exacte afbeeldingsroute en contractuele dekking van GlobalGPT zijn hier niet bevestigd, dus de bescherming blijft voorwaardelijk in plaats van een garantie voor het hele model.
Te controleren: Controleer het exacte beeldmodel, de Google-dienst en de factureringsomvang. Een Nano Banana-naam of een betaald GlobalGPT-abonnement op zich is geen garantie voor de toepasselijke bescherming.
Seedream en Seedance: De BytePlus-beveiliging is dienstspecifiek
Catalogusvermeldingen: Seedream 5.0 Pro; Seedream 5.0 Lite; Seedream 4.5.
Toepassingsgebied: BytePlus AI- en modeldiensten; de routing van Ark en Seed Audio op het vasteland valt niet onder deze voorwaarden.
Opleiding: BytePlus sluit klantgegevens uit van de training van het onderliggende basismodel, tenzij er sprake is van vrijwillige feedback ter verbetering of een afzonderlijke toestemming of schriftelijke overeenkomst. Dit is niet automatisch een beleid van Ark.
De Algemene voorwaarden van BytePlus voor AI-diensten bevatten een specifieke beperking met betrekking tot het trainingsmodel. In paragraaf 3.3 worden klantgegevens van die training uitgesloten, tenzij de klant vrijwillig feedback ter verbetering geeft of afzonderlijk schriftelijk toestemming verleent of hiermee instemt. Dit is een voorwaardelijke toezegging, geen belofte die voor altijd elk mogelijk gebruik dekt.
In artikel 3.1 worden gegevens die aan BytePlus Model Services worden verstrekt, beschouwd als vertrouwelijke informatie in de zin van de overeenkomst. Artikel 3.2 staat niettemin toe dat gegevens worden bewaard voor zover dat nodig is voor de dienstverlening en de beveiliging, zonder dat daarbij een vast aantal dagen wordt genoemd. Artikel 3.4 staat het gebruik van geautomatiseerde systemen en andere redelijke maatregelen toe om misbruik op te sporen en te onderzoeken; het belooft niet dat menselijke toegang onmogelijk is.
Voor Seedream en Seedance is de relevante vraag of de generatie daadwerkelijk gebruikmaakt van de onder deze regeling vallende BytePlus-diensten. Deze voorwaarden kunnen niet automatisch worden overgedragen naar Volcengine Ark op het vasteland. Ook de specifieke dienstentoewijzing van Seed Audio is nog niet bevestigd. In paragraaf 4 worden bovendien afzonderlijke voorwaarden voor componenten van derden erkend. De route, feedbackrechten en contractuele dekking van GlobalGPT moeten worden bevestigd voordat dit leveranciersbeleid een verklaring over een individueel platformmodel wordt.
Te controleren: Controleer de dekking van BytePlus, de toestemmingen voor feedback en eventuele voorwaarden van derden. De dienstverlening van Seed Audio is nog niet bevestigd; draag deze bescherming niet over naar Ark op het vasteland op basis van merkassociatie.
Ideogram: Opleiding voor reguliere dienstverlening en bescherming van bedrijfsinformatie
Catalogusvermeldingen: Ideogram 4.0; Ideogram 4.0 Turbo; Ideogram 4.0 Quality; Ideogram 3.0; Ideogram 3.0 Turbo; Ideogram 3.0 Quality.
Toepassingsgebied: Standaard Ideogram-diensten en Enterprise; de dekking van het API-contract kan verschillen
Opleiding: Het standaardbeleid van Ideogram staat het trainen van modellen toe. Op de Enterprise-pagina wordt vermeld dat bedrijfsgegevens worden uitgesloten van het trainen van gedeelde modellen, terwijl voor aangepaste training een opt-in vereist is; voor de resultaten is een afzonderlijke bevestiging nodig.
Het gewone van Ideogram privacybeleid omvat onder meer prompts, geüploade afbeeldingen en interacties tussen de verzamelde gegevens. Het maakt het mogelijk om deze gegevens te gebruiken voor het trainen van de modellen die ten grondslag liggen aan de diensten. Een betaald account of een instelling voor privé-afbeeldingen betekent daarom op zich nog niet dat ingezonden inhoud wordt uitgesloten van het trainingsproces.
De Bedrijfsaanbod geeft een meer specifieke toelichting: bedrijfsgegevens worden niet gebruikt om de gedeelde modellen van Ideogram te trainen, en het op maat trainen met klantgegevens is alleen mogelijk als de klant daar zelf voor kiest. In deze formulering worden de invoergegevens uitdrukkelijk genoemd. Het is geen even expliciete toezegging die betrekking heeft op elke gegenereerde uitvoer of elk API-account.
Voor standaarddiensten duurt de bewaartermijn zo lang als redelijkerwijs nodig is voor de doeleinden van de polis. Zakelijke klanten kunnen de bewaartermijn volgens de pagina voor zakelijke klanten instellen tot 30 minuten. Dit beschrijft een beschikbare configuratie, en niet dat er voor elke klant, dataset of account automatisch na 30 minuten wordt gewist.
De zichtbaarheid is een andere instelling. De voorwaarden Maak een onderscheid tussen privé-inhoud en inhoud die voor andere gebruikers beschikbaar is om te hergebruiken. Privé-zichtbaarheid houdt geen uitsluiting van training in en verbiedt ook niet alle toegang door de aanbieder. Voor gebruik via GlobalGPT bepalen de relevante overeenkomst met de upstream-partner en de daadwerkelijke configuratie welke bedrijfsbeveiligingsmaatregelen van toepassing zijn.
Te controleren: De instellingen voor privé-inhoud bepalen of deze zichtbaar is voor andere gebruikers. De beschermingsmaatregelen met betrekking tot bedrijfsopleidingen en het behoud van gegevens zijn afhankelijk van de geldende overeenkomst; er is hier geen mogelijkheid om je af te melden voor opleidingen in het kader van de standaarddienstverlening.
FLUX van Black Forest Labs: Toestemming voor training en contractspecifieke controles
Catalogusvermeldingen: FLUX; FLUX 1.1 Pro; FLUX 1.1 Ultra; FLUX 1 Kontext; FLUX 2 Pro.
Toepassingsgebied: Standaarddiensten van BFL, de officiële FLUX-API en Enterprise-overeenkomsten
Opleiding: Zowel de standaard BFL-voorwaarden als de FLUX API-voorwaarden staan training met invoer- en uitvoergegevens toe. De voorwaarden voor zakelijke klanten verschillen, en er kan niet automatisch worden aangenomen dat de opt-out-bepaling voor de standaarddienst ook van toepassing is op API-contracten.
Black Forest Labs hanteert geen algemeen standaardbeleid waarbij training standaard wordt uitgesloten voor al zijn diensten. Het gebruikelijke voorwaarden het mogelijk maken van training en verbetering aan de hand van inputs, outputs en taken. De afzonderlijke Voorwaarden voor de FLUX API staan ook uitdrukkelijk toe dat inputs en outputs worden gebruikt om AI-modellen te trainen en te verbeteren.
Volgens de algemene voorwaarden kunnen klanten een e-mail sturen naar legal@blackforestlabs.ai om zich af te melden voor toekomstige FLUX-trainingen. De privacybeleid vermeldt bovendien privacy@blackforestlabs.ai met als onderwerp ‘Training Opt Out’. API-klanten dienen te verifiëren hoe deze regeling zich verhoudt tot hun API-voorwaarden en -overeenkomst; voorwaarden voor bètaversies of speciale programma’s kunnen afwijken.
De opt-out geldt voor de toekomst. Eerdere trainingen worden hierdoor niet ongedaan gemaakt, en de voorwaarden voorzien in uitzonderingen op het gebied van veiligheid, naleving van wet- en regelgeving en feedback. De bewaartermijn is verder afgestemd op noodzakelijke dienstverlening en legitieme zakelijke doeleinden, in plaats van op één vaste verwijderingstermijn. Een uiterste datum voor het opvragen van een bestand is niet gelijk aan een uiterste datum voor het verwijderen van alle bijbehorende kopieën van de gegevens.
BFL’s bedrijfsaanbod adverteert met ‘geen gegevensbewaring’ en specifieke implementatieopties. Voor die opties is een overeenkomst vereist; ze vormen geen onderdeel van de configuratie van een standaard API-account. Evenzo geeft noch een FLUX-label in GlobalGPT, noch een marketingclaim over een privé-implementatie aan welke overeenkomst van toepassing is op een bepaald verzoek.
Te controleren: In de standaardvoorwaarden wordt potentiële gebruikers van de FLUX-training de mogelijkheid geboden om zich per e-mail af te melden. Controleer of dit ook geldt onder API-specifieke voorwaarden, bèta-voorwaarden en bestellingen voordat u erop vertrouwt voor API-verkeer.
Agnes: er is nog steeds behoefte aan een duidelijk beleid
Catalogusvermeldingen: Agnes Image 2.1 Flash.
Toepassingsgebied: Agnes-platformlabel; de identiteit van de dienstverlener en de toepasselijke overeenkomst zijn nog niet bevestigd.
Opleiding: Er is voor Agnes geen toepasselijk, modelspecifiek beleid voor gegevensverwerking vastgesteld. Dit is een lacune in het bewijsmateriaal, en geen bewijs dat er training plaatsvindt of dat de inhoud wordt beschermd.
Agnes is een platform voor modellen, maar er is nog geen specifiek beleid voor de verwerking van modelgegevens vastgesteld. Aan de hand van de naam alleen kan niet worden vastgesteld welke rechtspersoon de verantwoordelijke is, welke hostingregeling van toepassing is of welke overeenkomst van toepassing is op geüploade inhoud.
De voorwaarden voor het trainen van het model, de opt-out-mogelijkheden, de bewaartermijnen en de voorwaarden voor menselijke controle blijven daarom onbekend. Dit betekent niet dat er daadwerkelijk wordt getraind of dat het onmogelijk is om je af te melden. Voordat vertrouwelijk materiaal wordt ingediend, ontbreekt het bewijs van de daadwerkelijke identiteit van de dienst en het bijbehorende beleid, in plaats van een privacybelofte die is overgenomen van een model met een vergelijkbare naam of een veronderstelde leverancier.
Te controleren: Controleer de juridische identiteit van de bovenliggende partij, de serviceovereenkomst en eventuele trainingsinstellingen. Schrijf de opt-out-, bedrijfsbeschermings- of bewaartermijnmaatregelen van een andere aanbieder niet toe aan Agnes.
Midjourney: Zichtbaarheid in het openbaar en onopvallendheid staan los van de training
Catalogusvermeldingen: Midjourney (versie niet gespecificeerd).
Toepassingsgebied: Midjourney-gebruiksvoorwaarden; toegangsregelingen voor derden vereisen een afzonderlijke bevestiging
Opleiding: De voorwaarden van Midjourney verlenen een ruime, doorlopende licentie voor de inhoud, maar bevatten in dit geval geen expliciete toezegging dat de inhoud niet voor trainingsdoeleinden mag worden gebruikt. Die licentie op zich vormt geen bewijs van daadwerkelijk gebruik voor trainingsdoeleinden.
Het duidelijkste verschil in het privacybeleid van Midjourney betreft publicatie. Het Servicevoorwaarden Geef aan dat inhoud standaard openbaar zichtbaar is en hergebruikt mag worden. Dit is van belang voor nog niet vrijgegeven productontwerpen, foto’s van klanten en merkmateriaal, nog afgezien van de vraag of bepaalde inhoud kan worden gebruikt om modellen te trainen.
De voorwaarden verlenen Midjourney een ruime, doorlopende licentie voor ingediende inhoud en gegenereerde assets. Ze bevatten in dit verband geen expliciete verbintenis om bepaalde inhoud niet te gebruiken voor training. Evenmin is een ruime inhoudslicentie op zich een bewijs dat een bepaalde afbeelding daadwerkelijk in de training is opgenomen. Er is daarom behoefte aan een meer specifieke garantie met betrekking tot de trainingsstatus.
Pro- en Mega-klanten kunnen gebruikmaken van Stealth. Midjourney doet daarbij zijn uiterste best om geen content te publiceren die is gemaakt terwijl deze functie was ingeschakeld. Stealth maakt een gedeelde Discord-kamer niet privé: mensen in die kamer kunnen de inhoud nog steeds bekijken. Publicatie-instellingen en trainingsinstellingen hebben betrekking op verschillende zaken.
De genoemde bepalingen leggen geen enkele bewaartermijn vast, en de inhoudslicentie blijft ook na beëindiging van kracht. Het verwijderen van een account mag niet worden beschouwd als een automatische intrekking van alle verleende rechten. Bij een Midjourney-workflow die via een ander platform wordt aangeboden, moet apart aandacht worden besteed aan de toegangsregeling, het publicatiegedrag en het opslagbeleid alvorens vertrouwelijk materiaal in te dienen.
Te controleren: Pro en Mega Stealth bieden een ‘best-efforts’-garantie dat inhoud niet wordt gepubliceerd, maar geen mogelijkheid om je af te melden voor trainingen. Inhoud die in gedeelde Discord-ruimtes wordt gemaakt, blijft zichtbaar voor mensen die toegang hebben tot die ruimtes.
A Seedream-prompt met productverwijzingen kan zowel met een openbare productfoto als met een vertrouwelijk ontwerp vóór de lancering werken. De techniek waarmee ze worden gegenereerd is misschien wel hetzelfde, maar de toestemming om die bestanden te uploaden is dat niet.
Privacybeleid van AI Video Generator
Videoverzoeken kunnen het eerste en laatste beeld, gezichtsbeelden, referentiemateriaal, spraak en andere audio omvatten. Een bewaartermijnverklaring met betrekking tot de voltooide clip heeft mogelijk geen betrekking op deze inputgegevens, veiligheidslogboeken of elders opgeslagen kopieën.
Sora API: ‘no-training’ betekent niet dat er geen retentie is
Catalogusvermeldingen: Sora 2.
Toepassingsgebied: OpenAI /v1/videos-gegevensbeleid; deze vermelding zegt niets over de huidige beschikbaarheid van de dienst.
Opleiding: De officiële tabel met gegevenscontroles voor de video-API sluit training uit, met inachtneming van de algemene API-uitzondering voor expliciete toestemming voor het delen van gegevens. Voor Consumer Sora is een afzonderlijke beleidsbeoordeling vereist.
OpenAI's Documentatie over API-gegevensbesturingselementen geeft aan dat het video-eindpunt niet wordt gebruikt voor training, met inachtneming van de algemene uitzondering voor klanten die expliciet instemmen met het delen van gegevens. Dit is een bevinding met betrekking tot het API-beleid, geen uitspraak over Sora voor consumenten of een bevestiging dat een bepaalde dienst momenteel beschikbaar is.
In dezelfde documentatie wordt een onderscheid gemaakt tussen video-opslag en training. De beschreven videoworkflow voorziet in een periode van 48 uur voor het downloaden van de geproduceerde video, gevolgd door een bewaartermijn van 30 dagen voor misbruikmonitoring. Ook wordt aangegeven dat het video-eindpunt niet in aanmerking komt voor ‘Zero Data Retention’ en dat het geblokkeerd is voor verzoeken om ‘Modified Abuse Monitoring’ of ‘Zero Data Retention’. De controles die beschikbaar zijn voor teksteindpunten kunnen niet zomaar worden verondersteld voor video.
Een Sora-label op een ander platform geeft geen informatie over het gebruikte eindpunt, account of de overeenkomst. Het zegt ook niets over de door dat platform zelf geüploade referentiebestanden, videokopieën of downloadlinks. De werkwijze van GlobalGPT is nog niet bevestigd, dus de praktische classificatie is voorwaardelijke API-bescherming zonder training met gedocumenteerde bewaring, in plaats van een universele belofte dat videogegevens nooit worden opgeslagen of bekeken.
Te controleren: Het gedocumenteerde video-eindpunt komt niet in aanmerking voor Zero Data Retention en wordt geblokkeerd voor MAM/ZDR-verzoeken. Controleer de daadwerkelijke route in plaats van de instellingen van de tekst-API over te nemen.
Veo: Vertex AI onderscheiden van andere toegangswegen
Catalogusvermeldingen: Veo 3; Veo 3.1.
Toepassingsgebied: Veo via een geïdentificeerde Google-dienst; de toegang door consumenten en derden moet afzonderlijk worden beoordeeld.
Opleiding: Vertex AI beperkt het trainen en finetunen zonder voorafgaande toestemming of instructies. Die toezegging geldt niet automatisch voor elk Veo-consumentenproduct of elke toegangsroute van derden.
Een Veo-generatie kan meer bevatten dan alleen een tekstprompt: referentieafbeeldingen, personen die op die afbeeldingen voorkomen en gegenereerde videobestanden zijn allemaal van belang voor een privacybeoordeling. De praktische vraag is welke dienst deze gegevens verwerkt en onder welke overeenkomst die verwerking valt. Een Veo-versielabel kan die vraag op zichzelf niet beantwoorden.
Google's Documentatie over gegevensbeheer bij Vertex AI stelt dat klantgegevens niet zullen worden gebruikt om AI/ML-modellen te trainen of te verfijnen zonder voorafgaande toestemming of instructie. Dit ondersteunt een voorwaardelijke „no-training”-classificatie voor de betreffende toegang. Het houdt geen gelijke behandeling in voor een videoproduct voor consumenten, een niet-gerelateerde host of een platform dat gebruikmaakt van een niet-bevestigde upstream-route.
De opslag van videobeelden vereist een aparte controle, zelfs wanneer de training beperkt is. De downloadperiode van een gegenereerde clip, de bewaartermijn van geüploade referentiemedia en de veiligheidsgegevens kunnen uiteenlopende informatie bevatten. Nergens wordt vermeld hoe lang GlobalGPT zijn eigen kopieën bewaart. Voordat u een Veo-workflow als geschikt beschouwt voor vertrouwelijk beeldmateriaal, dient u de dienst, de overeenkomst en de relevante videocontroles te verifiëren; er wordt hier geen algemene garantie gegeven met betrekking tot het volledig verwijderen van gegevens of het ontbreken van menselijke beoordeling.
Te controleren: Stel vast om welke dienst, account en overeenkomst het precies gaat voordat u vertrouwt op de bescherming van Vertex AI. Controleer de bewaartermijnen die specifiek voor video’s gelden, in plaats van instellingen uit een tekstmodel over te nemen.
Seedance 1.0 Pro, Seedance 2.0, Seedance 2.0 Fast, Seedance 2.5
Voor deze vermeldingen geldt nog steeds de clausule inzake het stichtingsmodel van BytePlus als relevante publieke toezegging. Voor geüploade frames, referentie-audio en gegenereerde media moet een afzonderlijke opslagbeoordeling worden uitgevoerd. De dienstomschrijving van Seed Audio is nog niet bevestigd; er mag niet worden aangenomen dat BytePlus-dekking geldt op basis van de naam „Seed“.
Zie Seedream en Seedance: De BytePlus-beveiliging is dienstspecifiek voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
Kling: opleidingsmachtiging met een intrekkingsprocedure
Catalogusvermeldingen: Kling 2.6; Kling 3.0; Kling O1.
Toepassingsgebied: Kling: algemene servicevoorwaarden; voor de dekking van bedrijfs- en platform-API’s is een afzonderlijke bevestiging vereist.
Opleiding: Volgens de algemene voorwaarden van Kling is het toegestaan om de betreffende inhoud te gebruiken voor het maken, testen, verbeteren en trainen van AI/ML-modellen. Deze toestemming houdt niet in dat er daadwerkelijk gebruik is gemaakt van een specifieke clip.
Kling valt onder een categorie waarin zowel toestemming voor training als een manier om die toestemming in te trekken worden erkend. Paragraaf 4.7.3 van de algemene servicevoorwaarden maakt het mogelijk om het betreffende materiaal te gebruiken ter ondersteuning van het ontwikkelen, testen, verbeteren en trainen van AI/ML-modellen. Dit betreft een contractuele toestemming; hiermee wordt niet vastgesteld dat een bepaalde geüploade afbeelding of gegenereerde clip daadwerkelijk in de training is opgenomen.
In paragraaf 4.7.4 staat dat gebruikers die niet willen dat hun Inhoud geheel of gedeeltelijk verder wordt gebruikt, de toestemming kunnen intrekken door een e-mail te sturen naar support@kling.ai. Als men zou stellen dat het onmogelijk is om zich bij Kling af te melden, zou daarmee een gedocumenteerde procedure worden weggelaten. De clausule voorziet niet in een accountbeheer met één muisklik, een gegarandeerde verwerkingstijd of het ongedaan maken van eerdere modeltrainingen.
Intrekking en verwijdering moeten twee afzonderlijke kwesties blijven. Deze bepalingen leggen geen gemeenschappelijke bewaartermijn vast en garanderen evenmin dat elk opgeslagen exemplaar wordt verwijderd. Er kunnen aanvullende regels gelden voor zakelijke diensten, en de daadwerkelijke toegangsovereenkomst van GlobalGPT is niet bevestigd. Pas de conclusie voor gewone diensten alleen toe wanneer die voorwaarden van toepassing zijn op het genereren van gegevens, in plaats van één privacybeoordeling toe te kennen aan elke modelversie van Kling.
Te controleren: In paragraaf 4.7.4 wordt bepaald dat de machtiging kan worden ingetrokken door een e-mail te sturen naar support@kling.ai. Dit is geen geverifieerde ‘één-klik’-schakelaar, en volgens de bedrijfsvoorwaarden is een afzonderlijke bevestiging vereist voor de daadwerkelijke dienst.
Wan 2.6, Wan 2.7, Wan 3.0, Wan 3.0 Prime
Controleer voor deze media-items eerst of het verzoek gebruikmaakt van de betreffende Bailian-dienst, een afzonderlijk API-contract of een andere host. Het cataloguslabel is geen bepalende factor voor de contractuele dekking. Referentiemedia, scripts en gegenereerde bestanden vereisen bovendien opslag- en toegangsbeperkingen die verder gaan dan de algemene bepaling inzake gespreksgegevens.
Zie Qwen en Wan: voor Bailian op het vasteland gelden belangrijke uitzonderingen op het plan voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
Runway: de standaardvoorwaarden en de Enterprise-voorwaarden leiden tot verschillende resultaten
Catalogusvermeldingen: Runway Gen-4 Turbo.
Toepassingsgebied: Runway standaarddiensten vergeleken met Runway Enterprise Services.
Opleiding: De standaardvoorwaarden van Runway staan training en verbetering op basis van invoer- en uitvoergegevens toe. De bedrijfsvoorwaarden verbieden uitdrukkelijk het gebruik van Klantinhoud als trainingsgegevens voor de Diensten wanneer die overeenkomst van toepassing is.
Runway laat zien waarom een enkel ‘ja’ of ‘nee’ op modelniveau misleidend kan zijn. Het gebruikelijke voorwaarden het mogelijk maken dat invoer- en uitvoergegevens worden gebruikt om AI-modellen en aanverwante technologie te trainen en te verbeteren. Het betalen voor toegang vervangt op zich die overeenkomst niet door de Enterprise-bescherming.
De afzonderlijke Voorwaarden voor zakelijke diensten luidt als volgt: “Runway mag Klantinhoud niet gebruiken als trainingsgegevens voor de Diensten.” Dit is een expliciete contractuele beperking met een welomschreven inhoudscategorie en dienstomvang. Een modelnaam zoals Gen-4 Turbo geeft niet aan of het verzoek hieronder valt.
De beperkingen op het gebied van training laten ook andere privacykwesties open. De aangehaalde bepalingen leggen geen algemene bewaartermijn voor inhoud vast, garanderen geen veiligheidscontrole en bepalen niet hoe een ander platform gegenereerde video’s opslaat. Er is hier geen opt-out voor standaardtraining vastgesteld. Voor GlobalGPT is het doorslaggevende ontbrekende detail de daadwerkelijk gecontracteerde Runway-dienst en de reikwijdte daarvan, gevolgd door de toepasselijke instellingen voor opslag en verwijdering.
Te controleren: Controleer of het Enterprise-contract daadwerkelijk van toepassing is op het verzoek. Gewone betaalde toegang is niet hetzelfde, en er is hier geen opt-out voor standaardtrainingen vastgesteld.
Luma: API en toezeggingen op het gebied van ‘Enterprise No-Training’
Catalogusvermeldingen: Luma Ray 2-flitser.
Toepassingsgebied: Standaard Luma-webservices versus API- en Enterprise-overeenkomsten
Opleiding: De standaardvoorwaarden voor gratis en betaalde webdiensten van Luma staan training toe. De API-voorwaarden sluiten training met API-input/output uit, terwijl Enterprise een afzonderlijke ‘No Train’-garantie biedt.
Luma maakt een duidelijk onderscheid tussen gewoon internetgebruik en beveiligde API- of Enterprise-toegang. Het gebruikelijke voorwaarden verleent gebruiksrechten met betrekking tot input en output van zowel gratis als betaald internetgebruik. Het afsluiten van een standaardabonnement leidt daarom niet tot dezelfde privacyvoorwaarden als een zakelijke overeenkomst.
Artikel 10 van de API-voorwaarden sluit API-invoer en -uitvoer uit van het trainen, verfijnen of anderszins ontwikkelen van de modellen van Luma. Deze toezegging geldt specifiek voor API-toegang waarop deze voorwaarden van toepassing zijn. De Bedrijfsovereenkomst bevat bovendien een ‘No Train’-garantie voor invoer en uitvoer.
Geen van beide toezeggingen houdt in dat alle inhoud onmiddellijk verdwijnt. De periode van 30 dagen na beëindiging waarin gegevens kunnen worden geïmporteerd of geëxporteerd, is geen automatische deadline voor verwijdering. Zakelijke klanten kunnen schriftelijk verzoeken om verwijdering van inhoud, terwijl standaard back-ups mogelijk nog steeds onderworpen zijn aan geheimhoudingsverplichtingen. De privacybeleid beschrijft ook juridische en andere uitzonderingen op de bewaartermijn.
De standaardvoorwaarden voor vrij gebruik omvatten ruimere rechten inzake openbare vertoning en verspreiding. Het verwijderen van een standaardaccount maakt licenties voor materiaal dat al in modellen, systemen of geaggregeerde gegevens is verwerkt, niet ongedaan. Aan de hand van de naam van een Ray-model alleen kan niet worden vastgesteld welk contract van toepassing is, noch hoe een afzonderlijk platform, waaronder GlobalGPT, ingezonden media en gegenereerde clips opslaat.
Te controleren: Controleer of u onder de API- of Enterprise-dekking valt voor bescherming zonder training. Het gewoonweg verwijderen van een account heeft geen invloed op de rechten met betrekking tot inhoud die al is verwerkt in modellen, systemen of geaggregeerde gegevens.
MiniMax API: de verbetering van de dienstverlening is duidelijk, maar de omvang van de opleiding is nog niet vastgesteld
Catalogusvermeldingen: MiniMax-H3.
Toepassingsgebied: Voorwaarden voor het MiniMax API-platform; de afhandeling van consumentendiensten via Hailuo is hier niet vastgelegd.
Opleiding: De voorwaarden van de MiniMax API staan het invoeren en genereren van inhoud toe ten behoeve van de ontwikkeling en verbetering van de dienst. Ze leggen hier geen algemeen verbod op trainingen op, noch wordt er een precieze reikwijdte voor trainingen vastgesteld.
De MiniMax API-voorwaarden toestaan dat ingevoerde en gegenereerde inhoud wordt gebruikt voor het aanbieden, onderhouden, ontwikkelen en verbeteren van diensten, naast veiligheids- en juridische doeleinden. Dat is een expliciete toestemming voor verbetering. Het is geen voldoende bewijs om te stellen dat elk verzoek een model traint, en het is geen algemene belofte dat er geen training plaatsvindt.
De Privacybeleid van de API beperkt het gebruik van persoonsgegevens voor training met het oog op het profileren of gericht benaderen van consumenten. De doelbinding is van belang: het inkorten ervan tot “MiniMax traint niet op basis van persoonsgegevens” zou de betekenis ervan veranderen. In hetzelfde beleid wordt uitgegaan van criteria inzake noodzakelijkheid en wettelijke bewaartermijnen, in plaats van één vaste levensduur voor input en output.
Er is hier geen specifieke opt-out voor training, geen algemene toezegging dat er geen menselijke beoordeling plaatsvindt en geen afzonderlijke commerciële regeling waarbij geen training plaatsvindt, vastgesteld. Het verwijderen van persoonsgegevens of het intrekken van toestemming mag niet in de plaats komen van een controle op training. Deze bevindingen hebben betrekking op het API-platform, niet op de Hailuo-consumentendienst. De MiniMax-audio- of videolabels van GlobalGPT vereisen nog steeds een exacte route en overeenkomst voordat een strengere privacyclassificatie gerechtvaardigd is.
Te controleren: Er is geen specifieke opt-out-mogelijkheid voor trainingen ingesteld. Het recht op verwijdering van persoonsgegevens en het recht op intrekking zijn afzonderlijke maatregelen, en eventuele afzonderlijke commerciële beperkingen moeten voor dit account worden bevestigd.
Grok Imagine, Grok Imagine 1.5
Voor Grok Imagine hangt de officiële xAI API-verplichting af van de dekking van de API. Er moet bijzondere aandacht worden besteed aan mediatoeverlevering en beperkingen inzake nulbewaring: gegenereerde afbeeldings- of videolinks kunnen een andere levensduur hebben dan verzoeklogboeken.
Zie Grok API: standaard geen training, met afzonderlijke instellingen voor het bewaren van gegevens voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
Happy Horse: de toegangsovereenkomst is nog niet bevestigd
Catalogusvermeldingen: Happy Horse 1.0.
Toepassingsgebied: Toetreding tot het Happy Horse-platform; de identiteit van de opdrachtgever en de toepasselijke voorwaarden voor gegevensverwerking zijn nog niet bevestigd.
Opleiding: Er is voor Happy Horse nog geen specifiek trainingsbeleid voor dit model vastgesteld. Trek uit het modellabel alleen geen conclusies over toestemming of verbod.
Happy Horse blijft een vermelding met onbekende voorwaarden, omdat de toepasselijke modelspecifieke voorwaarden voor gegevensverwerking nog niet zijn vastgesteld. De naam van het platform volstaat niet om de verantwoordelijke aanbieder te identificeren of om vast te stellen welke overeenkomst van toepassing is op een videoverzoek.
Daarmee blijven de omgang met referentiemedia, toestemming voor training, de mogelijkheid tot afmelding, en de voorwaarden voor bewaring en beoordeling onopgelost. Het feit dat een gegenereerde clip kan worden gedownload, zegt niets over de vraag of er nog andere kopieën of logbestanden bestaan. Het juiste volgende bewijs is de daadwerkelijke upstream-dienst en de bijbehorende overeenkomst; op basis van de huidige informatie is noch een garantie dat er geen training plaatsvindt, noch een bewering dat training onvermijdelijk is, gerechtvaardigd.
Te controleren: De daadwerkelijke leveranciersovereenkomst, opleidingsmaatregelen en bedrijfsspecifieke uitzonderingen moeten worden bevestigd. Wijs geen leveranciersidentiteit toe en neem geen privacymaatregelen van een ander model over zonder bewijs.
FLUX 3 Video: termen uit het beeldmodel worden niet overgenomen
Catalogusvermeldingen: FLUX 3-video.
Toepassingsgebied: FLUX 3: aanmelding voor het videoplatform; leveranciers en diensten zijn nog niet bevestigd.
Opleiding: Er is geen toepasselijk modelspecifiek opleidingsbeleid vastgesteld voor FLUX 3 Video. Het feit dat de merknaam overeenkomt, vormt geen rechtvaardiging om de voorwaarden voor beelddiensten van Black Forest Labs op dit item toe te passen.
FLUX 3 Video heeft een eigen dienstidentificatie en een toepasselijk beleid inzake gegevensverwerking nodig. Het feit dat de naam een gemeenschappelijk woord bevat, betekent niet dat het item door Black Forest Labs wordt aangeboden of onder de FLUX-beeldvoorwaarden valt.
Toestemming voor training, opt-out-instellingen, bewaring en menselijke beoordeling zijn voor deze videoroute nog niet bevestigd. Er mag niets worden overgenomen van een beeld-eindpunt of worden afgeleid uit de merknaam van het model. Het gebrek aan bewijs pleit voor een onbekende classificatie, en niet voor de bewering dat de inhoud voor training moet worden gebruikt of dat de dienst bescherming biedt tegen gebruik zonder training binnen ondernemingen.
Te controleren: Stel vast wie de daadwerkelijke leverancier is en welke video-overeenkomst er geldt, voordat u een opt-out voor trainingen of bedrijfsdekking toekent. Een gedeeld merknaam is onvoldoende bewijs voor contractuele bescherming.
Agnes Video 2.0, Agnes Video 2.5, Agnes Video 2.5 Flash
De videobijdragen hebben te maken met dezelfde onopgeloste kwestie rond de identiteit van de dienst als beschreven voor Agnes Image. Voor deze videoversies zijn geen modelspecifieke toestemming voor training, bewaartermijn of opt-out vastgesteld.
Zie Agnes: er is nog steeds behoefte aan een duidelijk beleid voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
Wanneer je referentiemateriaal hergebruikt voor consistente AI-videokarakters, kan hetzelfde herkenbare gezicht of product in meerdere verzoeken worden ingediend. Raadpleeg het beleid van elke betrokken dienst, inclusief afzonderlijke tools voor stem- of lipsynchronisatie.
Privacybeleid inzake AI, audio, muziek en spraak
Audioprivacy omvat meer dan alleen het uiteindelijke MP3-bestand. Songteksten, scripts, referentieopnames, stemfragmenten en transcripties kunnen verschillende doeleinden en bewaartermijnen hebben. Toestemming om iemands stem te klonen staat ook los van toestemming om die opname te gebruiken voor het trainen van modellen.
Qwen Audio 3.0
Controleer voor deze media-items eerst of het verzoek gebruikmaakt van de betreffende Bailian-dienst, een afzonderlijk API-contract of een andere host. Het cataloguslabel is geen bepalende factor voor de contractuele dekking. Referentiemedia, scripts en gegenereerde bestanden vereisen bovendien opslag- en toegangsbeperkingen die verder gaan dan de algemene bepaling inzake gespreksgegevens.
Zie Qwen en Wan: voor Bailian op het vasteland gelden belangrijke uitzonderingen op het plan voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
Seed Audio 1.0
Voor deze vermeldingen geldt nog steeds de clausule inzake het stichtingsmodel van BytePlus als relevante publieke toezegging. Voor geüploade frames, referentie-audio en gegenereerde media moet een afzonderlijke opslagbeoordeling worden uitgevoerd. De dienstomschrijving van Seed Audio is nog niet bevestigd; er mag niet worden aangenomen dat BytePlus-dekking geldt op basis van de naam „Seed“.
Zie Seedream en Seedance: De BytePlus-beveiliging is dienstspecifiek voor de geldende gepubliceerde voorwaarden en de nog onduidelijke punten.
ElevenLabs: een prospectieve opt-out-regeling voor opleidingen
Catalogusvermeldingen: Eleven Music; Eleven Multilingual v2; Eleven v3.
Toepassingsgebied: Standaard ElevenLabs-diensten; bedrijfs- en zakelijke processen worden apart geregeld.
Opleiding: De standaardvoorwaarden van ElevenLabs staan het gebruik van inhoud voor opleidingsdoeleinden toe en bieden de mogelijkheid om hiervan af te zien. De verwerking voor zakelijke klanten of ondernemingen is afhankelijk van de toepasselijke overeenkomst en het aanvullende akkoord inzake gegevensverwerking.
ElevenLabs biedt voor zijn standaarddiensten een gedocumenteerde keuze in plaats van een onvoorwaardelijke standaardinstelling waarbij geen training plaatsvindt. Zijn voorwaarden gebruikers kunnen via het menu ‘Gegevensgebruik’ onder ‘Voorwaarden en privacy’ aangeven dat ze het gebruik van hun gegevens voor trainingsdoeleinden willen weigeren. Deze wijziging heeft geen invloed op eerder gebruik of op materiaal dat uit dat gebruik is voortgekomen.
De privacybeleid wordt afzonderlijk uitgelegd dat de verwerking van persoonsgegevens in opdracht van zakelijke of bedrijfscliënten wordt geregeld door hun overeenkomst en het aanvullende akkoord inzake gegevensverwerking. Bijgevolg mogen een standaardaccount, een zakelijke overeenkomst en een API-integratie niet als onderling uitwisselbaar worden beschouwd, louter omdat ze gebruikmaken van hetzelfde spraak- of muziekmodel.
Voor inzendingen met de naam Eleven Music, Eleven Multilingual of Eleven v3 dient u het daadwerkelijke upstream-product, het account en de trainingskeuze te controleren. De configuratie van GlobalGPT is hier niet bevestigd. Een opt-out houdt niet in dat er geen gegevens worden bewaard, dat er privé-uitvoerkoppelingen zijn of dat er geen veiligheidsbeoordeling plaatsvindt. Toestemming om iemands stem te klonen of te reproduceren staat ook los van de vraag of de aanbieder ingediende inhoud mag gebruiken om zijn modellen te verbeteren.
Te controleren: Via het menu ‘Gebruiksvoorwaarden en privacy > Gegevensgebruik’ van het account kun je je afmelden voor trainingen. Controleer of de instelling correct is en welke gegevens hieronder vallen; toestemming voor stemklonen is een aparte vereiste.
Mureka: de huidige bepalingen inzake zeggenschap moeten nog worden bevestigd
Catalogusvermeldingen: Mureka v9.
Toepassingsgebied: Toetreding tot het Mureka v9-platform; de huidige voorwaarden voor de beheersdienst en de API-overeenkomst zijn nog niet bevestigd.
Opleiding: De huidige gebruiksvoorwaarden zijn voor dit model en deze dienst niet geverifieerd. Op basis van onvolledige gegevens mag noch een ‘geen training’-garantie, noch onvermijdelijke training worden ingeroepen.
Mureka v9 moet voor trainingsdoeleinden ongeklasseerd blijven totdat de huidige beheersovereenkomst is bevestigd. Mureka publiceert servicevoorwaarden en een privacybeleid, maar uit de beschikbare gegevens voor deze vergelijking blijkt niet welke huidige versie bepalend is voor de daadwerkelijke toegangswijze van dit model. Oudere beleidsformuleringen mogen niet worden gepresenteerd als een huidige toezegging of toestemming.
Deze onzekerheid heeft gevolgen die verder reiken dan een simpel ‘ja’ of ‘nee’ als antwoord op een trainingsvraag. De manier waarop ingezonden songteksten, referentie-audio, gegenereerde nummers en accountgegevens worden behandeld, kan verschillen, evenals de voorwaarden voor reguliere diensten en API-contracten. Een algemeen recht om het gebruik van inhoud in te trekken, houdt niet automatisch in dat men zich specifiek kan afmelden voor training, en een verzoek tot verwijdering betekent niet dat voor elke categorie gegevens hetzelfde tijdschema geldt.
Voorlopig is de bruikbare conclusie concreet: de huidige toestemming voor training, de controles op trainingen, de bewaartermijnen en de commerciële uitzonderingen blijven onbevestigd. Dat bewijst niet dat Mureka traint op materiaal van klanten, noch dat het garandeert dat er geen training plaatsvindt. De exacte modeltoewijzing van GlobalGPT en de toepasselijke overeenkomst zijn nodig voordat er uitspraken kunnen worden gedaan over de Mureka-vermelding.
Te controleren: Of er een specifieke opt-out voor trainingsdoeleinden is en of er sprake is van een API- of bedrijfsspecifieke uitzondering, is nog niet bevestigd. Een algemene, herroepbare inhoudslicentie vormt geen effectieve controle op het gebruik voor trainingsdoeleinden.
Lyria: er is een verschil tussen productverbetering en training in veiligheidsmodellen
Catalogusvermeldingen: Google Lyria 3 (startpagina).
Toepassingsgebied: Lyria via de Gemini-API; het Lyria 3-label van het platform vereist een exacte koppeling tussen modellen en diensten.
Opleiding: De betaalde Gemini API sluit het gebruik van prompts en antwoorden voor productverbetering uit. In de gegevens voor misbruikmonitoring geldt een uitzondering voor trainingsmodellen die specifiek worden gebruikt voor de handhaving van het beleid.
Google-documenten Voorbeeld van Lyria 3 Pro binnen de Gemini API. Daarmee wordt weliswaar een officiële dienstcontext vastgesteld, maar dat bewijst nog niet dat een platformlabel met de naam Lyria 3 precies dat model of die account gebruikt. De toepasselijke categorie van betaalde of onbetaalde diensten blijft van belang.
Onder de voorwaarden voor betaalde diensten, Google gebruikt geen prompts of reacties om zijn producten te verbeteren. Bij gratis diensten is het doorgaans toegestaan om deze te gebruiken voor verbeteringsdoeleinden en menselijke beoordeling, behoudens regionale uitzonderingen. Deze categorieën mogen niet worden samengevoegd met de Gemini-app voor consumenten of andere Google Cloud-diensten.
De beleid inzake het toezicht op misbruik schrijft een bewaartermijn van 55 dagen voor prompts, context en output voor, en biedt bevoegd personeel de mogelijkheid om gemarkeerde inhoud te beoordelen. De geregistreerde gegevens worden niet gebruikt voor AI/ML-training, met uitzondering van modellen die specifiek worden ingezet voor de handhaving van het beleid. Daarom zou een belofte dat geen enkel AI-model ooit van de gegevens leert, te ruim zijn. Of Lyria in aanmerking komt voor zero-retention en de upstream-instellingen van GlobalGPT zijn nog niet bevestigd.
Te controleren: Bevestig de status van het betaalde project en de exacte Lyria-dienst. Beschrijf het beleid niet als een verbod op alle AI-training, aangezien modellen voor beleidshandhaving uitdrukkelijk zijn uitgezonderd.
De invoergegevens in muziekgeneratie met ElevenLabs verschillen van de vertelscripts die worden gebruikt in Qwen tekst-naar-spraak. Houd rekening met de songtekst, het vertrouwelijke script of de herkenbare stem die je wilt indienen, voordat je een van beide diensten kiest.
Privacybeleid voor AI-3D-modellen
Een 3D-aanvraag kan een product vanuit meerdere hoeken weergeven en herbruikbare geometrie, texturen en materialen genereren. De privacy van ingevoerde foto’s, machtigingen voor het trainen van modellen, de zichtbaarheid van de assetgalerij en het behoud van meshes zijn afzonderlijke kwesties.
Hunyuan3D: Tencent Cloud beschermt invoergegevens tegen modelverbetering zonder toestemming
Catalogusvermeldingen: Hunyuan 3D 3.1.
Toepassingsgebied: De Tencent Cloud Hunyuan3D API en de bijbehorende voorwaarden voor grote modellen
Opleiding: Tencent Cloud neemt invoergegevens niet mee bij de ontwikkeling en verbetering van algoritmen of modellen zonder afzonderlijke toestemming. De aangehaalde clausule bevat geen uitdrukkelijk verbod met betrekking tot uitvoergegevens.
Tencent Cloud’s Productvoorwaarden van Hunyuan3D de voorwaarden voor de dienst met grote modellen daar expliciet in opnemen. Artikel 4.2 van die servicevoorwaarden stelt dat de ingevoerde gegevens niet zullen worden gebruikt voor het ontwikkelen of verbeteren van algoritmen of modellen van de dienst zonder afzonderlijke toestemming. Dit is een specifieke bescherming voor de invoergegevens van de clouddienst.
De formulering is van belang voor workflows waarbij afbeeldingen naar 3D worden omgezet: een ingediende referentieafbeelding is iets anders dan het resulterende mesh of de resulterende textuur. De clausule heeft uitdrukkelijk betrekking op invoergegevens. Er wordt geen even expliciet verbod op het trainen met uitvoergegevens vermeld, dus klanten die bescherming nodig hebben voor elk gegenereerd bestand, dienen ook voor die categorie bevestiging te vragen.
In artikel 2.13 wordt de verwerking op het Chinese vasteland beschreven, evenals de bewaartermijn die nodig is om de dienst te verlenen. Nadat de verwerking is beëindigd, wordt het gebruik van de gegevens stopgezet of worden de gegevens teruggegeven of verwijderd overeenkomstig de instructies, behoudens wettelijke en technische uitzonderingen. In deze bepaling wordt geen vast aantal bewaardagen genoemd.
Artikel 2.9 staat een veiligheidsbeoordeling van invoergegevens en gegenereerde resultaten toe. De beperking op het gebruik van invoergegevens betekent daarom niet dat de inhoud niet wordt gescreend of dat de aanbieder er geen toegang toe heeft. Deze toezeggingen van Tencent Cloud hebben ook niet automatisch betrekking op de Hunyuan-consumentenwebsite, een zelfgehost model of de implementatie bij een andere aanbieder. Een GlobalGPT-modellabel geeft niet aan welke regeling van toepassing is.
Te controleren: Een afzonderlijke machtiging vormt de genoemde uitzondering op het gebruik van invoergegevens. Controleer of deze voorwaarden onder de dekking van het Tencent Cloud-contract vallen; de consumentenwebsite van Hunyuan, open modellen en andere hosts delen deze voorwaarden niet automatisch.
Meshy: Opleidingsrechten en afzonderlijke regels voor het behoud van 3D-assets
Catalogusvermeldingen: Meshy 7.
Toepassingsgebied: Standaard-, API- en Enterprise-services; orderspecifieke uitzonderingen
Opleiding: Meshy staat het gebruik van niet-Enterprise-inputs en -outputs toe voor het trainen, valideren, testen of verbeteren van diensten, tenzij in de opdracht anders is bepaald. Om te bepalen of er sprake is van een Enterprise-uitsluiting, moet de daadwerkelijke contractuele bescherming worden gecontroleerd.
Meshy’s voorwaarden het is toegestaan om input en output van niet-Enterprise-klanten te gebruiken voor het trainen, valideren, testen of verbeteren van haar diensten, tenzij in de opdracht anders is bepaald. Voor het genereren van 3D-beelden kan dit betrekking hebben op ingediend referentiemateriaal en gegenereerde elementen. Gewone betalende klanten worden niet automatisch van deze toestemming uitgesloten.
De zin over toestemming voor training geldt niet voor Enterprise-klanten. Dat is belangrijk, maar deze uitsluiting op zich vormt geen op zichzelf staande toezegging dat geen enkele categorie van bedrijfsgegevens ooit voor training zal worden gebruikt. In een Enterprise-overeenkomst moeten de specifieke beperking, de reikwijdte ervan en eventuele afzonderlijk overeengekomen verwerkingsvoorwaarden worden vastgelegd.
Voor het bewaren van gegevens gelden buitengewoon concrete regels: API-uitvoer die niet tot de Enterprise-versie behoort, wordt drie dagen na generatie verwijderd. Enterprise-uitvoer wordt standaard voor onbepaalde tijd bewaard, waarbij een automatische verwijdering kan worden ingesteld van één tot 30 dagen of een andere tijdsregeling. Deze regels hebben betrekking op uitvoerobjecten; ze houden geen overeenkomstige verwijdering van invoer, logbestanden of trainingskopieën in.
Gewone betalende gebruikers kunnen inhoud privé houden zonder de trainingstoestemming in te trekken. De opslaglimieten voor de webapp en het opschonen van inactieve accounts zijn weer gescheiden. De voorwaarden sluiten ook klantinvoer en -uitvoer uit van de geaggregeerde statistieken. Beoordeel bij vertrouwelijke projecten de trainingstoestemming, de zichtbaarheid van de uitvoer en elke opslagcategorie afzonderlijk, in plaats van het verdwijnen van een download te beschouwen als volledige gegevensverwijdering.
Te controleren: Een betaalde optie voor privé-inhoud heeft geen invloed op de toestemming voor trainingen. Controleer de beperkingen op Enterprise- of orderniveau en de instellingen voor het bewaren van uitvoer afzonderlijk van de zichtbaarheid en het algemeen verwijderen van accounts.
Tripo: De invoer en uitvoer van betalende gebruikers hebben een expliciete trainingsbeperking
Catalogusvermeldingen: Tripo h3.1.
Toepassingsgebied: Sectie ‘Tripo-betalende gebruikers’; gratis diensten en toegangsinstellingen verschillen
Opleiding: In de gebruiksvoorwaarden voor betalende gebruikers van Tripo wordt uitdrukkelijk uitgesloten dat gegevens worden gebruikt voor het trainen, valideren, testen of verbeteren van AI-technologie. Die bescherming mag niet automatisch worden uitgebreid naar gratis gebruikers.
Tripo’s voorwaarden voor betalende gebruikers uitdrukkelijk vermelden dat inputs en outputs niet zullen worden gebruikt als trainingsgegevens voor het trainen, valideren, testen of verbeteren van AI-technologie. Dit is een specifiekere garantie dan alleen maar te zeggen dat gebruikers eigenaar zijn van de door hen gegenereerde modellen, omdat hiermee rechtstreeks wordt ingegaan op het toegestane gebruik door de aanbieder.
De verklaring staat vermeld in het gedeelte voor betalende gebruikers. Voor gratis gebruikers gelden afzonderlijke, ruimere bepalingen inzake inhoudsrechten, dus een gratis account zou die conclusie met betrekking tot de betaalde dienst niet moeten overnemen. Evenzo bepaalt het betalen van GlobalGPT op zichzelf niet welk Tripo-account, welke API-overeenkomst of welk downstream-contract van toepassing is op een bepaald modelverzoek.
Opslag en publicatie blijven twee afzonderlijke zaken. Tripo belooft niet dat invoer- en uitvoergegevens gedurende een vaste periode worden bewaard. Bij beëindiging van het account kan de inhoud ervan worden verwijderd, maar materiaal dat eerder in openbare ruimtes is geplaatst, kan permanent bewaard blijven. De privacybeleid biedt ook een manier om het verwijderen van een account aan te vragen.
Gebruikers zijn zelf verantwoordelijk voor het kiezen van een passend toegangsniveau voor de inhoud, en in de voorwaarden wordt gewaarschuwd dat, indien geen niveau wordt geselecteerd, standaard de meest soepele instelling wordt toegepast. Een betaalde verbintenis zonder training zorgt er daarom niet automatisch voor dat een referentieafbeelding of 3D-object privé wordt gemaakt. Klanten die vertrouwelijkheid nodig hebben, dienen zowel de contractuele dekking als de daadwerkelijke toegangsinstellingen te controleren.
Te controleren: Controleer of de betreffende voorwaarden voor betaalde diensten van toepassing zijn op het account en de API-route. Selecteer de instellingen voor toegang tot inhoud afzonderlijk; de betaalde bescherming zonder training maakt assets niet automatisch privé.
Rodin en Hyper3D: de bescherming van privé-output heeft een duidelijk afgebakend toepassingsgebied
Catalogusvermeldingen: Rodin Gen-2.
Toepassingsgebied: Hyper3D-voorwaarden, privacybeleid en opslag van door de API gegenereerde assets
Opleiding: Hyper3D beperkt de weergave van privé-uitvoer van Rodin tot het accountscherm, conform zijn gebruiksvoorwaarden. Die beperkte bescherming houdt geen alomvattend verbod in op training met betrekking tot prompts, gewone uitvoer en het gebruik van de API.
Hyper3D’s voorwaarden bieden specifieke bescherming voor Rodin-uitvoer die als ‘privé’ is gemarkeerd: andere gebruikers hebben er geen toegang toe, tenzij deze wordt gedeeld, en Hyper3D verklaart dat het deze uitvoer niet zal gebruiken, behalve om deze in het account weer te geven. Deze verklaring heeft betrekking op privé-uitvoer, en niet op alle ingezonden inhoud.
Bijgevolg vormt de clausule inzake privé-output geen alomvattende overeenkomst inzake het verbod op training die betrekking heeft op prompts, geüploade referentiematerialen, gewone output of elke API-workflow. Een klant die een nog niet uitgebracht product wil beschermen, dient zowel voor de referentieafbeeldingen als voor de gegenereerde mesh een oplossing te zoeken. De status van de ene categorie is niet bepalend voor die van de andere.
De privacybeleid brengt het bewaren van invoergegevens, feedback en reacties in verband met het intrekken, verwijderen of deactiveren van een account, gevolgd door verwijdering of anonimisering, behoudens uitzonderingen. Daarnaast is de API-aanbod adverteert met het voor onbepaalde tijd bewaren van door API’s gegenereerde assets. Deze verklaringen hebben betrekking op verschillende categorieën gegevens en moeten in samenhang worden gelezen.
De bepalingen inzake inhoudsmoderatie staan nog steeds toegang tot prompts en outputs toe, dus de instelling ‘privé’ is geen garantie dat er geen controle plaatsvindt. Voor een Rodin-model dat via GlobalGPT wordt benaderd, moeten de toepasselijke API-overeenkomst, de instellingen voor privé-outputs en de opslagpraktijken van het platform afzonderlijk worden gecontroleerd, voordat de volledige workflow als beschermd tegen training kan worden beschouwd.
Te controleren: Door Rodin-uitvoer als ’privé’ te markeren, wordt de toegang voor andere gebruikers beperkt en wordt het gebruik van de betreffende uitvoer aan bepaalde voorwaarden onderworpen. Bevestig afzonderlijk de afhandeling van prompts, de voorwaarden voor API-training en eventuele Enterprise-beveiligingsmaatregelen voordat u vertrouwelijke referenties indient.
TRELLIS: De hostingprovider bepaalt hoe met gegevens wordt omgegaan
Catalogusvermeldingen: TRELLIS 3D.
Toepassingsgebied: Het TRELLIS-modelproject versus de dienst die het uitvoert
Opleiding: Het TRELLIS-project stelt geen algemeen beleid vast waarbij training voor alle gehoste implementaties verboden is. Of training is toegestaan, hangt af van de dienst die de referentieafbeeldingen en gegenereerde assets verwerkt.
TRELLIS is een modelproject, geen hostingdienst die onder één overkoepelend beheer valt. Het officiële Microsoft-projectpagina links naar code en een demonstratie. Deze bronnen geven uitleg over de technologie en hoe je er toegang toe krijgt, maar ze zorgen niet voor een gemeenschappelijke privacyovereenkomst voor elk bedrijf dat het model gebruikt.
In een gehoste ‘image-to-3D’-workflow kunnen de relevante gegevens bestaan uit referentieafbeeldingen, gegenereerde geometrie, texturen en metagegevens van verzoeken. Of de aanbieder deze materialen gebruikt voor training, hangt af van zijn eigen servicevoorwaarden en eventuele overeenkomsten met klanten. Open-source-licenties regelen het gebruik van software of modellen; ze geven geen antwoord op die vraag over de omgang met gegevens.
Er is dan ook geen algemene bewaartermijn of verwijderingscontrole voor TRELLIS. De host kan verschillende regels toepassen op geüploade afbeeldingen, voltooide bestanden, logbestanden en leveringsexemplaren. Het verwijderen van een downloadlink betekent niet dat alle bijbehorende gegevens zijn gewist, en het eigendom van het resulterende raster garandeert geen vertrouwelijkheid.
Voor TRELLIS via GlobalGPT of een ander platform is het van belang dat er een toepasselijk beleid van de aanbieder is dat betrekking heeft op training, opslag, toegang en verwijdering. Bij zelfhosting is het bovendien noodzakelijk inzicht te hebben in de logboekregistratie en de externe verbindingen van de implementatie. Zolang deze details niet vaststaan, blijft de privacystatus van de gehoste workflow onbekend; die onzekerheid is geen bewijs dat er daadwerkelijk training plaatsvindt.
Te controleren: Stel vast wie de hostingprovider is en welke overeenkomst van toepassing is, en controleer vervolgens het gebruik voor opleidingsdoeleinden, de verwijderingsprocedures en de toegangscontroles. Het feit dat een dienst open source is, biedt op zichzelf geen garantie voor de privacy van een gehoste dienst.
Voor 3D-weergave op basis van afbeeldingen met Hunyuan3D, kijk eerst na wie het model host en wat er met de geüploade foto gebeurt. Het feit dat er een mesh kan worden gedownload, betekent niet dat de bronafbeelding is verwijderd.
Wat valt er onder het privacybeleid van GlobalGPT?
GlobalGPT's privacybeleid luidt als volgt: We gebruiken geen gebruikerscontent om AI-modellen te trainen, tenzij dit uitdrukkelijk wordt vermeld en toegestaan is.
Dat is een voorbehoudende uitspraak over het eigen gebruik van inhoud door het platform, en geen onvoorwaardelijke belofte dat er nooit gegevens zullen worden bewaard of ingezien.
In datzelfde beleid wordt beschreven hoe persoonsgegevens worden gedeeld met dienstverleners en hoe deze worden bewaard voor de doeleinden waarvoor ze zijn verzameld en om te voldoen aan de toepasselijke wettelijke vereisten. In het gedeelte over kunstmatige intelligentie wordt toegestaan dat gegevens door mensen worden gecontroleerd wanneer dit nodig is omwille van de veiligheid, ter voorkoming van misbruik of om te voldoen aan wettelijke voorschriften.
De openbare kennisgeving bevat geen lijst per model van ondertekende upstream-bedrijfsovereenkomsten, bewaartermijnen of opleidingsrechten. Om die reden wordt in dit artikel bij geen enkel individueel model vermeld dat er voor GlobalGPT een specifieke bedrijfsovereenkomst is bevestigd. De hierboven beschreven beschermingsmaatregelen voor aanbieders zijn alleen van toepassing wanneer de betreffende dienst en overeenkomst bepalend zijn voor het verzoek.
Voor vertrouwelijke werkzaamheden dient u bevestiging te vragen van de aanbieder of host van het betreffende model, de geldende ‘no-training’-clausule, eventuele uitzonderingen op de feedbackregels, de bewaartermijnen voor invoer- en uitvoergegevens, en de verwijderingsprocedure. De accountgeschiedenis, gegenereerde assets en upstream-auditlogs kunnen afzonderlijk worden behandeld.
Bij tools kunnen extra gegevensverwerkers betrokken zijn
AI-notitie-apps, ChatPDF, onderzoeksassistenten, videovertaaldiensten, lipsynchronisatie en tools voor beeldbewerking kunnen gebruikmaken van meer dan één model of dienst. Bij vergadernotulen kan bijvoorbeeld de ene dienst de audio transcriberen en de andere dienst het transcript samenvatten. Voor beide is een passend gegevensbeleid nodig.
De vergelijking met 121 vermeldingen heeft betrekking op de genoemde modellen in het catalogusoverzicht, en houdt geen rekening met deze tools als extra basismodellen. In dit overzicht is geen toolspecifieke lijst met verwerkers en bewaarteregels opgesteld.
Hoe u de privacy van uw AI-gegevens kunt beheren
Bij generatieve AI speelt gegevensprivacy een rol op het gebied van toestemming voor training, bewaartermijnen, toegang en het delen van gegevens gedurende de gehele workflow. Gebruik de volgende controlepunten bij het kiezen van een dienst of het beoordelen van een bestaand account.
Controleer de trainingstoestemming los van de opslag
Zoek naar een clausule die zowel inputs als outputs omvat. Noteer of deze clausule het trainen van basismodellen, het trainen van alle modellen of slechts een beperkter doel uitsluit. Een uitzondering voor veiligheidsclassificatoren is iets anders dan toestemming om een model voor algemeen gebruik te trainen.
Maak gebruik van de beschreven opt-out-mogelijkheid voordat je nieuw werk indient
Als de dienst een instelling voor gegevensgebruik biedt, schakel dan de betreffende toestemming uit en controleer wanneer deze van kracht wordt. Als de voorwaarden een e-mail of contract vereisen, maak dan gebruik van dat mechanisme. Het afmelden voor marketingberichten of de instelling ‘Do Not Track’ in de browser geldt niet als een opt-out voor het trainen van modellen.
De zichtbaarheid van de uitvoer afzonderlijk instellen
Bekijk galerijen, deel links, openbare werkruimten en samenwerkingsruimten. De instellingen ‘Privé’ of ‘Stealth’ hebben betrekking op de zichtbaarheid; ze hebben geen automatische invloed op de trainingslicentie of de moderatietoegang van de aanbieder.
Verwijder de juiste gegevensobjecten
Voor een chatgesprek, een geüpload bestand, een gegenereerd bestand, een stemprofiel en een account kunnen verschillende verwijderingsregels gelden. Vraag na wat er achterblijft in back-ups, auditlogboeken en systemen van derden. Een verlopen downloadlink betekent niet automatisch dat alle kopieën zijn gewist.
Verlaag de gevoeligheid van wat je uploadt
Gebruik een bewerkt contract, een openbare productfoto, een fictief klantvoorbeeld of een goedgekeurde voorbeeldopname wanneer dat voldoende is voor de opdracht. Verwijder onnodige namen, rekeningnummers, verborgen metagegevens en vertrouwelijke ontwerpdetails voordat je het materiaal indient.
Veelgestelde vragen over gegevensprivacy bij AI
Welke AI-modellen worden niet getraind op uw gegevens?
Verschillende officiële API’s en bedrijfsdiensten bieden bescherming tegen gebruik zonder training, waaronder de API van OpenAI en de commerciële producten van Anthropic, met de vermelde uitzonderingen. De bescherming wordt bepaald door de betreffende dienst, overeenkomst en instellingen; de modelnaam alleen is daarvoor niet bepalend.
Wordt het trainen met mijn gegevens automatisch stopgezet als ik voor AI betaal?
Nee. Bij sommige gewone betaalde diensten is training nog steeds toegestaan. Andere aanbieders maken onderscheid tussen betaalde toegang, API-toegang en toegang voor bedrijven. Controleer de trainingsclausule die bij de door u gebruikte dienst hoort, in plaats van elk abonnement als een bedrijfsovereenkomst te beschouwen.
Wordt DeepSeek getraind op basis van mijn gegevens, en kan ik me hiervoor afmelden?
Het hier besproken privacybeleid van DeepSeek staat het trainen of verbeteren van modellen toe en erkent het recht om het gebruik van persoonsgegevens voor het trainen van modellen of technische optimalisatie te weigeren. Dit houdt echter geen ‘één-klik-schakelaar’ in, noch worden hiermee de voorwaarden voor een afzonderlijke, daaropvolgende toepassing vastgelegd.
Zijn alle AI-API’s standaard privé?
Nee. Volgens de algemene voorwaarden van Kimi OpenPlatform mag inhoud van klanten worden gebruikt voor trainingsdoeleinden, tenzij schriftelijk anders is overeengekomen. Bij andere API’s is het standaard niet toegestaan om de inhoud voor trainingsdoeleinden te gebruiken. In beide gevallen moeten de opslag, de toegang door mensen en de verwerking door derden afzonderlijk worden gecontroleerd.
Betekent het ontbreken van training dat er helemaal geen gegevens worden bewaard?
Nee. Een dienst kan inhoud uitsluiten van training, terwijl deze wel wordt bewaard voor generatie, accountgeschiedenis, beveiliging of wettelijke vereisten. Maatregelen voor nulbewaring vereisen mogelijk goedkeuring en kunnen bepaalde modellen, eindpunten of functies uitsluiten.
Belemmert het genereren van afbeeldingen of video’s door particulieren het trainingsproces?
Niet per se. Een privé-instelling kan beperken wat andere gebruikers te zien krijgen, terwijl de toestemmingen voor het trainen van modellen ongewijzigd blijven. Controleer de zichtbaarheid van de uitvoer en de voorwaarden voor het trainen van modellen afzonderlijk, inclusief eventuele beperkingen voor Stealth- of gedeelde werkruimten.
Mogen spraak- en muziekdiensten mijn opnames gebruiken voor trainingsdoeleinden?
Dat hangt af van de dienst. ElevenLabs biedt in zijn standaardvoorwaarden de mogelijkheid om af te zien van training, terwijl andere diensten wellicht andere overeenkomsten hanteren. Controleer scripts, referentieopnames, stemvoorbeelden en uitvoer afzonderlijk; toestemming van de stemhouder blijft een afzonderlijke vereiste.
Kunnen AI-3D-generatoren worden getraind op basis van mijn productontwerpen?
Sommige voorwaarden staan dit gebruik toe. De niet-Enterprise-trainingsclausule van Meshy heeft betrekking op inputs en outputs, tenzij in de Order anders is bepaald. De voorwaarden voor betalende gebruikers van Tripo bevatten een expliciete bepaling waarin training wordt verboden. Geen van beide bepalingen legt de specifieke contractuele dekking van GlobalGPT vast.
Worden de gegevens die al voor de training zijn gebruikt, verwijderd als ik mijn chat verwijder?
Het verwijderen van een zichtbare chat betekent op zich nog niet dat deze uit eerdere trainingen, back-ups of veiligheidslogboeken wordt verwijderd. Verschillende opt-outs gelden pas voor de toekomst. Lees de bepalingen van de aanbieder inzake verwijdering en toestemming voor de betreffende gegevens en dienst.
Hebben alle modellen op GlobalGPT dezelfde privacybescherming?
GlobalGPT publiceert een eigen privacybeleid, maar in de openbare kennisgeving wordt niet voor elk model één enkele overeenkomst met de bovenliggende onderneming vastgelegd. Controleer de specifieke aanbieder, het contract, de toestemmingen voor training en de instellingen voor het bewaren van gegevens voor het model dat u van plan bent te gebruiken.
Wat houdt een onbekende privacystatus in?
Dit betekent dat de toepasselijke voorwaarden, de koppeling tussen model en dienst of het specifieke beleidsgebied in deze beoordeling niet zijn vastgesteld. Het bewijst niet dat de aanbieder op basis van uw inhoud traint, en het is geen garantie dat er geen training plaatsvindt. Beschouw het onbeantwoorde veld als een open beslissingspunt.