
Claude Opus 5.5-recensie: prijs, benchmarks en echte API-tests
Claude Opus 5.5 combineert een contextvenster van 1 miljoen tokens met een API-prijs van $4 / $20 per miljoen tokens. In deze beoordeling worden de gepubliceerde beweringen van Anthropic, onafhankelijke benchmark-momentopnames en vijf directe taakuitvoeringen via de Messages API-route van elkaar gescheiden.
Het meetresultaat is specifiek. Drie taken leverden foutloze, bruikbare antwoorden op; de codeertaak leverde een bruikbaar antwoord op, maar stuitte op de limiet van 1.024 tokens; de Chinese schrijftaak leverde op de geteste route onleesbare tekst op. Het voorbeeld toont concreet gedrag en routebeperkingen, niet een algemeen slagingspercentage.
Kort antwoord
- Prestaties: Anthropic laat bij de meeste taken prestaties op het niveau van Fable 5.1 zien, terwijl Artificial Analysis bij maximale inspanning een score van 58 op de intelligentie-index behaalde. Uit de beperktere gegevens van METR over beoordelingsvaardigheden bleek geen grote verbetering ten opzichte van Fable 5.1.
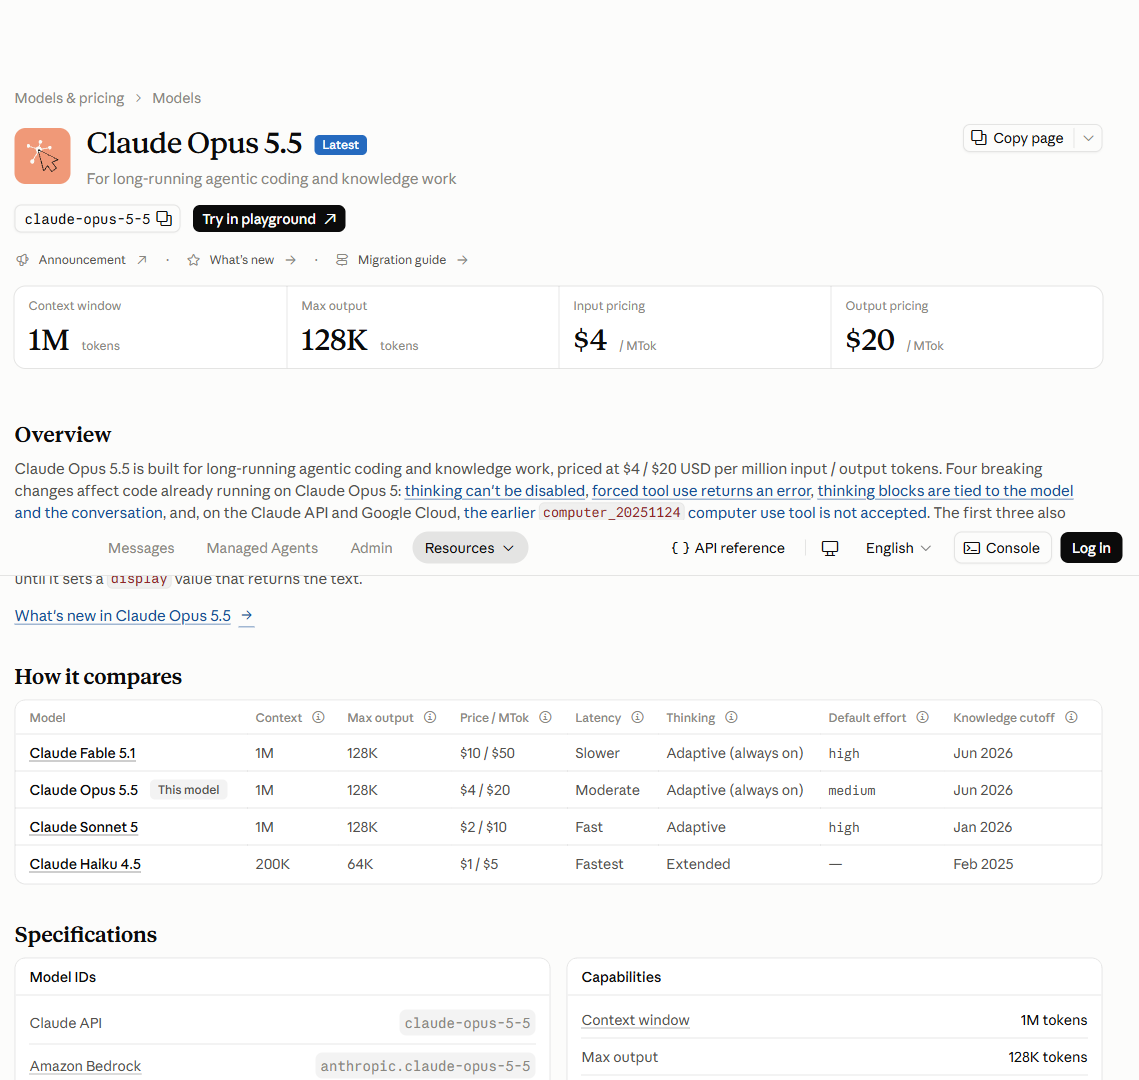
- Prijs: het officiële API-tarief bedraagt $4 per miljoen invoertokens en $20 per miljoen uitvoertokens. Cache-leesbewerkingen kosten $0,20 per miljoen; cache-schrijfbewerkingen van 5 minuten kosten $5 per miljoen.
- Praktisch resultaat: Het extraheren van lange teksten, strikte JSON en rekenkundig redeneren zijn geslaagd in de opgenomen testruns. Het coderen was nuttig, maar werd bij het aanvankelijke maximum afgebroken. Het Chinese resultaat wordt geregistreerd als een probleem met de route of codering, niet als een taalbeoordeling op modelniveau.
- API-waarschuwing: denken kan niet worden uitgeschakeld, het gedwongen gebruik van hulpmiddelen leidt tot een foutmelding, denkblokken zijn gekoppeld aan het model en het gesprek, en de oudere
computer_20251124Dit hulpprogramma wordt niet ondersteund via de Claude-API en de Google Cloud-route.

Wat er in de officiële documentatie staat
Op de productpagina van Anthropic wordt Claude Opus 5.5 gedateerd op 22 september 2026 en wordt het beschreven als het eerste model in de Claude 5.5-serie. Volgens de aankondiging levert het bij de meeste taken prestaties op het niveau van de Claude Fable 5.1, zijn de typische werkbelastingskosten 40% lager dan bij de Opus 5 en is de uitvoersnelheid meer dan 30% hoger dan bij de Opus 5. Dit zijn beweringen van de leverancier, dus ze worden apart weergegeven van het onafhankelijke en praktische bewijs hieronder.
De Documentatie voor het Claude-platform vermeld de API-model-ID als claude-opus-5-5, een contextvenster van 1 miljoen tokens, een maximale uitvoer van 128K en adaptief denken dat altijd actief is. In de documentatie worden ook de wijzigingen vermeld die van invloed zijn op bestaande Opus 5-integraties; deze worden behandeld in het onderstaande gedeelte over migratie.
Bewijs van prestaties
Er is hier geen eenduidig “prestatiecijfer”. De drie openbare bronnen meten verschillende zaken, dus bij elke kaart blijven de meetcriteria en de grenzen van de onderzoeksbasis duidelijk aangegeven.
Aankondiging Anthropic
Gepubliceerd signaal: Volgens Anthropic presteert Opus 5.5 bij de meeste taken op hetzelfde niveau als Claude Fable 5.1, kost het bij typische werklasten 40% minder dan Opus 5 en levert het de resultaten meer dan 30% sneller op.
Grens: door de aanbieder gepubliceerde positionerings- en testresultaten, geen onafhankelijke benchmark.
Kunstmatige analyse
Gepubliceerd signaal: De 'max-effort'-snapshot geeft 59,61 TP40T aan op Terminal-Bench 4.0, 61,41 TP40T op Humanity’s Last Exam en 66,91 TP40T op SciCode.
Grens: De scores zijn afhankelijk van de inspanning, het harnas, de datum en de definitie van de maatstaf. Ze geven geen voorspelling voor elke API-prompt.
METR-evaluatie vóór de inzet
Gepubliceerd signaal: METR stelt dat uit de beschikbare gegevens geen grote verbetering ten opzichte van Fable 5.1 bleek wat betreft de onderzochte beoordelingsvaardigheden, maar verwacht wel een aanzienlijke versnelling bij bepaalde onderzoeks- en ontwikkelingsactiviteiten.
Grens: Dit is een beperktere beoordeling van de beoordelingssnelheid en de taakversnelling, en geen volledige kwaliteitsranglijst.
Als we alle kaarten samen bekijken, laten ze een beperkte conclusie zien: Opus 5.5 komt in verschillende verouderde openbare evaluaties als beste model naar voren, maar de omvang van het voordeel varieert naargelang de taak, de inspanningsgraad en de opzet van de evaluatie. De kaarten leveren geen algemeen geldend resultaat op voor het “beste model”.
Claude Opus 5.5 Prijs- en factureringseenheden
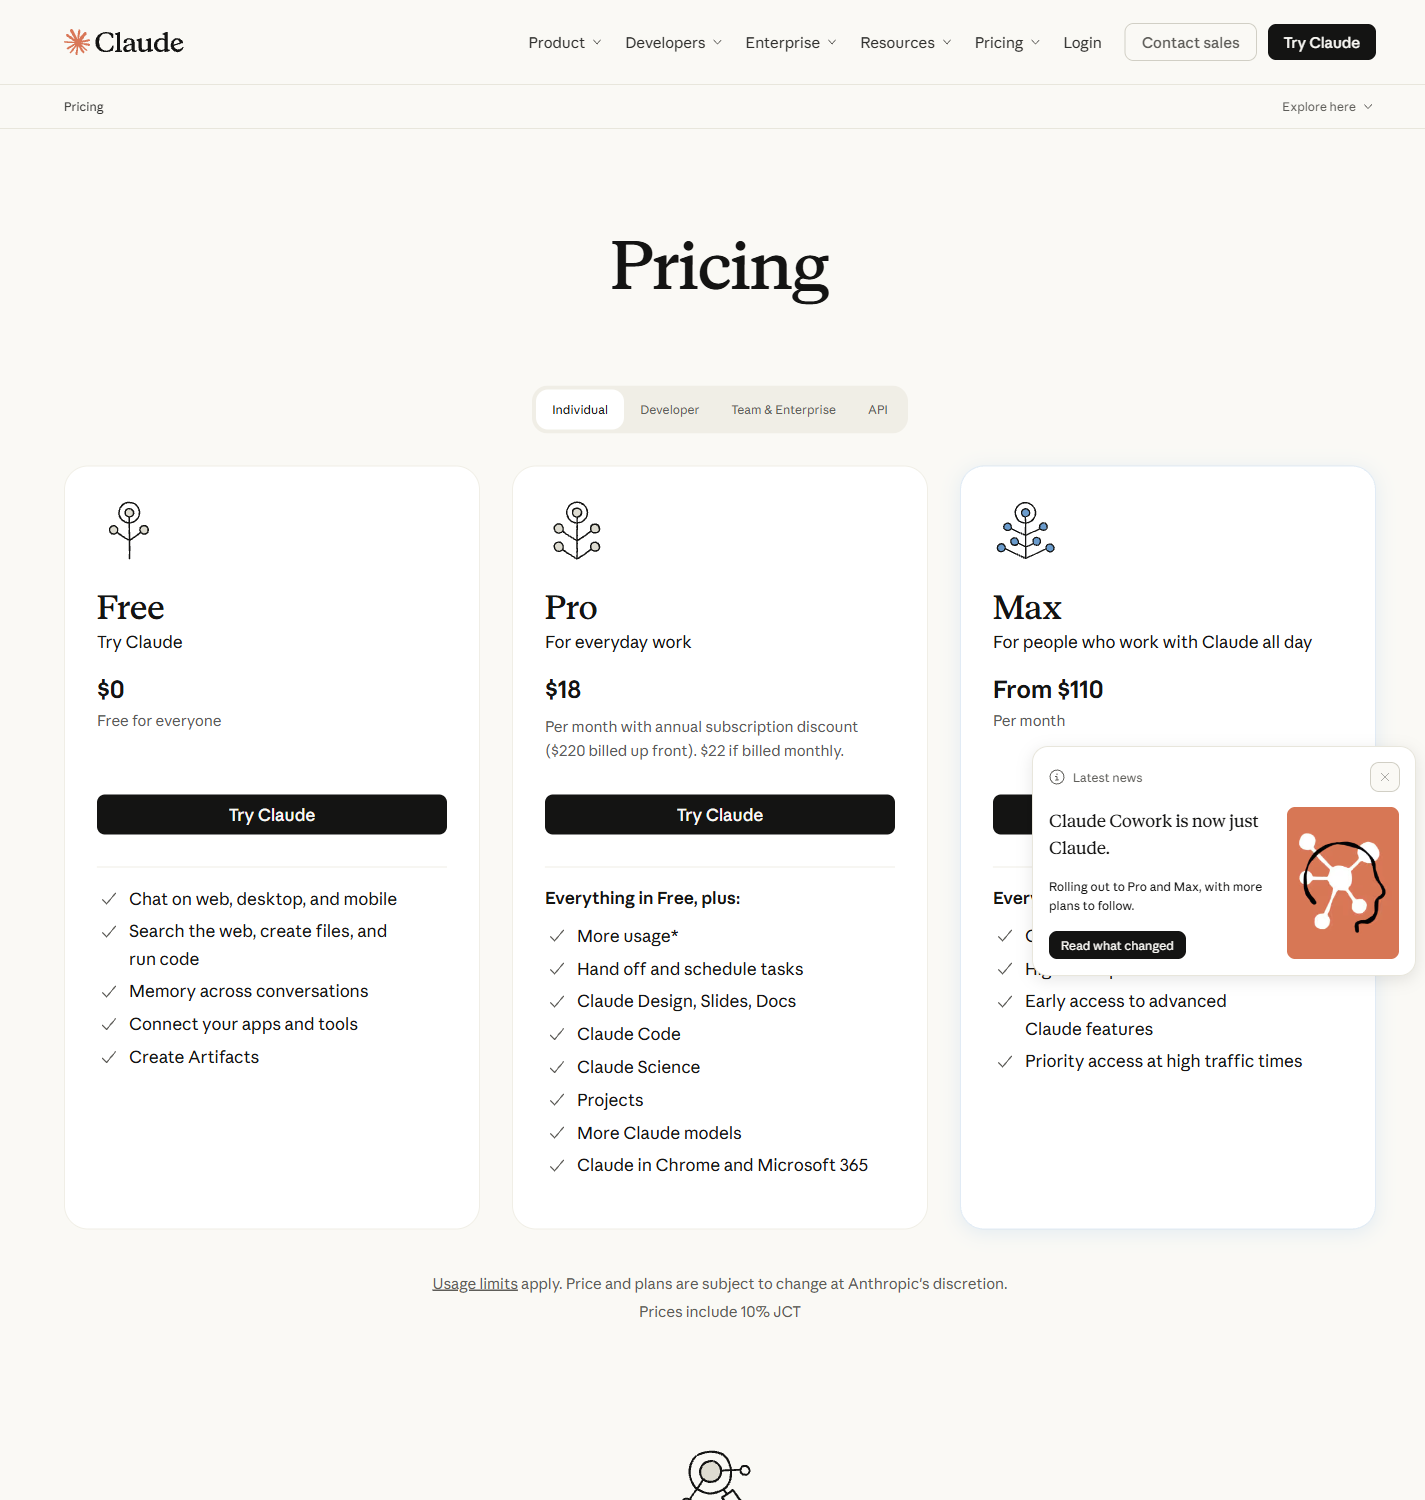
De API-prijs en de abonnementsprijs voor consumenten zijn verschillende producten. De onderstaande API-cijfers zijn de eenheidsprijzen die worden gebruikt voor het opstellen van een tokenbudget; de cijfers voor consumenten zijn de abonnementsoverzichten die zichtbaar zijn in het vastgelegde browsergebied.
Officiële API-prijzen
Eenvoudige schatting: 10.000 invoertokens plus 2.000 uitvoertokens komt neer op ongeveer $0,08 tegen standaardtarieven, exclusief cache, batch, belasting of platformtoeslag.
Screenshot van het consumentenabonnement
Op de schermafbeelding is ook een 10% JCT-notitie te zien. Dit zijn weergavewaarden die afhankelijk zijn van de regio; het gaat hier niet om een algemene prijsgarantie.
Voor een aparte uitleg over tokenfacturering en contextvensterkosten, zie de Prijs- en contextgids voor GPT-5.5. Het API-tarief van de provider, de abonnementskosten en het eventuele creditsaldo op het multimodelplatform moeten in uw begroting apart worden gehouden.
Praktijktest: vijf kaarten met taakresultaten
Op 23 september 2026 hebben we vijf onafhankelijke prompts via dezelfde gecontroleerde Messages API-route verzonden met model-ID claude-opus-5-5. In de eerste doorloop werd gebruikgemaakt van max_tokens: 1024. We hebben de lokale verstreken tijd, het aantal invoer- en uitvoertokens, de reden voor het stoppen, de juistheid en de naleving van de letterlijke opmaak vastgelegd. De taak voor het schrijven in het Chinees werd opnieuw uitgevoerd met een maximum van 4.096 tokens, nadat bij de eerste doorloop het probleem met de uitvoer van de route aan het licht was gekomen. Dit is een steekproef van vijf taken, geen schatting van de betrouwbaarheid.
Kan het een gedupliceerde functie van gemengd type herstellen?
Taak instellen
Zoek de fout in een Python-programma deduplicatie functie, verwerk waarden die geen tekenreeks zijn en niet in een hash kunnen worden opgeslagen, behoud de eerste spelling en zorg voor testcases.
In het antwoord werd het volgende vastgesteld: .lower() fout bij niet-tekenreekswaarden, tekenreeksen gewijzigd in casefold(), heb ik een fallback toegevoegd die niet te hashen is, en heb ik de gecorrigeerde code plus testcases teruggestuurd.
Het antwoord bleef steken bij de limiet van 1.024 tokens. De oplossing was nuttig, maar de configuratie was te klein voor een volledige codereview.
Beoordeling van de kaart: Er is een technisch bruikbaar antwoord teruggegeven; deze run kan geen uitspraak doen over de latentie of volledigheid, omdat de tokenlimiet de uitvoering heeft afgebroken.
Kan het feiten vastleggen en de grenzen van tests vaststellen?
Taak instellen
Haal vijf genummerde bevindingen uit een korte evaluatiememo, waarbij je ook de methode vermeldt en aangeeft wat er in de volgende ronde niet is gemeten.
Er werden precies vijf genummerde punten weergegeven. De vergelijkingen met de assistent, de methode met 20 vragen en de hiaten op het gebied van langetermijnretentie en klantconversie bleven behouden.
Dit was een kort bronpakket, dus het test het contextvenster van 1M niet.
Beoordeling van de kaart: schone extractie waarbij het gevraagde aantal wordt gerespecteerd en de bewijsgrens van de bronmemo behouden blijft.
Kan het zonder opschoning machine-leesbare uitvoer genereren?
Taak instellen
Geef een vast JSON-object terug met een titel, doelgroep, twee voordelen, twee nadelen en een oordeel. Het gebruik van een Markdown-omranding was niet toegestaan.
Er werd een parseerbare JSON teruggestuurd met de gevraagde sleutels, twee voordelen, twee nadelen en een beknopte aanbeveling. Er was geen Markdown-wrapper aanwezig.
Eén geldig antwoord bewijst nog niet dat het schema betrouwbaar is voor grotere of geneste objecten.
Beoordeling van de kaart: De letterlijke JSON-conformiteit is bij deze test geslaagd.
Kan het een regel voor herhaald afronden correct toepassen?
Taak instellen
Begin met 12 stuks, vermenigvuldig elke volgende partij met 1,25, rond na elke partij naar beneden af en geef het totaal over vier partijen weer.
Gaf 12, 15, 18 en 22 terug, en telde deze vervolgens bij elkaar op tot 67. De tussenberekeningen waren zichtbaar.
De taak is deterministisch en beperkt; ze geeft geen beeld van het algemene redeneervermogen.
Beoordeling van de kaart: het juiste resultaat en duidelijke tussenstappen.
Heeft de geteste route bruikbare Chinese tekst opgeleverd?
Taak instellen
Stel een inleiding voor een Chinese recensie op waarin een duidelijk onderscheid wordt gemaakt tussen officiële beweringen, de prijs, vergelijkende gegevens en praktische tests.
De responsstructuur was aanwezig, maar in het opgeslagen resultaat werden de Chinese karakters via de geteste route vervormd weergegeven.
Uit de gegevens blijkt geen verschil tussen de kwaliteit van de modeltaal enerzijds en het route- of coderingsgedrag anderzijds. Er wordt geen score voor de Chinese kwaliteit toegekend.
Beoordeling van de kaart: onbruikbare teruggestuurde tekst op deze route; voer de test opnieuw uit met een geverifieerd UTF-8-pad voordat je uitspraken doet over de kwaliteit van de taal.
Over de vier taalneutrale of Engelstalige tests heen bedroeg het lokale gemiddelde 6,24 seconden. Dit cijfer heeft betrekking op vijf opeenvolgende verzoeken op één route en betreft geen latentie aan de kant van de provider. De meest opvallende kenmerken waren beknopte extractie, letterlijke naleving van JSON en correcte rekenkundige bewerkingen; de twee onopgeloste problemen waren druk op de codering door het outputbudget en vervormde Chinese uitvoer op de geteste route.
Aandachtspunten met betrekking tot API’s en migratie
Het korte antwoord is dat deze factoren hierin worden meegenomen omdat ze een integratie kunnen beïnvloeden, zelfs als de tekstkwaliteit van het model op het eerste gezicht goed lijkt.
- Het denken staat altijd aan. Gebruik de gedocumenteerde inspanningsparameter om de diepte, de latentie en de kosten te regelen; er is geen uitschakelknop.
- Het gebruik van een gedwongen tool leidt tot een foutmelding. Bestaande code waarbij de selectie van een tool verplicht is, vereist een afzonderlijke migratietest.
- Denkblokken zijn onlosmakelijk verbonden met het model en het gesprek. Ga er niet vanuit dat een denkblok na het wijzigen van modellen opnieuw kan worden gebruikt.
computer_20251124wordt niet geaccepteerd volgens de Claude-API en de Google Cloud-route die in de documentatie worden vermeld.- Uitvoerplafonds zijn van belang. De coderingskaart laat zien dat een nuttige reactie nog steeds kan worden onderbroken door een kleine
max_tokenswaarde. - De batch- en snelle modus zijn afzonderlijke factureringstrajecten. Houd hun kortingen of toeslagen apart van de standaardprijzen voor tokens.
Op bewijs gebaseerd vonnis
Claude Opus 5.5 beschikt over solide, gedateerde openbare benchmarkgegevens en een lager gepubliceerd standaard API-tarief dan de Opus 5-cijfers die in de aankondiging van Anthropic worden vermeld. In de vijf geregistreerde taakuitvoeringen leverde het een zuivere extractie, strikte JSON en rekenkundige bewerkingen op; het coderingsantwoord was bruikbaar maar werd afgekapt door de aanvankelijke limiet; en de Chinese uitvoer was via de geteste route niet bruikbaar.
De gerechtvaardigde conclusie is dan ook beperkt: het model bleek bij verschillende kleine taken goed instructies te kunnen volgen, terwijl de route en de configuratie duidelijke beperkingen vertoonden. Bij elke migratiebeslissing moeten dezelfde opdrachten worden herhaald met een passend outputbudget, moeten toolaanroepen worden gecontroleerd en moeten officiële tokentarieven gescheiden worden gehouden van abonnements- of platformtegoed.
Als je ter vergelijking een tweede route wilt, dan is de DeepSeek V4 Pro versus Flash-testformaat laat zien hoe conclusies op taakniveau los kunnen staan van beweringen die betrekking hebben op het gehele model. De Handleiding voor gebruiksscenario’s van GPT-5.5 voegt een taakgericht referentiepunt toe, terwijl Opmerkingen bij de Gemini Flash-benchmark en de Vergelijkingsgids voor AI-modellen geef context over modellen in de omgeving. Zie voor toegang tot meerdere modellen alles-in-één AI-abonnementen en de vergelijking van platforms met meerdere modellen.
Veelgestelde vragen
Hoeveel kost de Claude Opus 5.5?
Het officiële API-tarief bedraagt $4 per miljoen invoertokens en $20 per miljoen uitvoertokens. Het tarief voor het lezen uit de cache bedraagt $0,20 per miljoen tokens, en het tarief voor het schrijven naar de cache per 5 minuten bedraagt $5 per miljoen tokens.
Wat is het Claude Opus 5.5-contextvenster?
In de documentatie van het Claude-platform wordt een contextvenster van 1 miljoen tokens en een maximale uitvoer van 128K tokens vermeld. Een apart gedocumenteerd bètapad ondersteunt tot 300K uitvoertokens voor berichtbatches.
Is de Claude Opus 5.5 beter dan de Opus 5?
Anthropic rapporteert lagere gemiddelde werkbelastingkosten en snellere uitvoer, terwijl onafhankelijke evaluaties sterke resultaten laten zien bij verschillende verouderde taken. De omvang van een eventuele kwaliteitswinst hangt af van de benchmark, de instelling voor de inspanningsgraad, de prompt en de route.
Kan het denken worden uitgeschakeld?
Nee. Volgens de huidige modeldocumentatie staat adaptief denken altijd ingeschakeld. Gebruik de parameter ‘effort’ om de denkdiepte, latentie en kosten te regelen.
Hebben de vijf API-taken hun betrouwbaarheid bewezen?
Nee. De kaarten geven concrete gedrags- en configuratiebeperkingen weer, maar op basis van vijf taken kan geen algemeen slagingspercentage worden geschat. De kwestie van het programmeerplafond en de kwestie van de Chinese route worden afzonderlijk gerapporteerd.
Heeft deze beoordeling de Chinese kwaliteit bevestigd?
Nee. De geteste route leverde vervormde Chinese tekst op, dus het resultaat wordt geregistreerd als een coderings- of routeprobleem in afwachting van een geverifieerde herhaling in UTF-8.









