Muse Spark 1.3은 메타가 지금까지 출시한 Muse Spark 버전 중 가장 강력한 버전입니다. 공개된 xhigh 모델은 인공 분석 지능 지수(Artificial Analysis Intelligence Index)에서 61점을 기록했으며, 100만 토큰 규모의 컨텍스트 윈도우를 유지하고, 당사의 첫 응답 API 테스트에서 중급 난이도의 코딩 과제 3개를 모두 통과했습니다. 한 가지 중요한 점은 메타의 주요 벤치마크 차트가 ‘맥스(max)’를 사용하고 있다는 것인데, 이 리뷰가 작성될 당시 맥스는 추가 안전성 테스트를 거친 후 본격적인 출시를 앞두고 있던 상태였습니다.

Muse Spark 1.3 리뷰: 한 줄 평가
우리의 평가
Muse Spark 1.0.3은 에이전트 코딩, 장문 컨텍스트 작업, 비용 효율성이 중요한 자동화 작업에 대해 테스트해 볼 가치가 있습니다. 이 모델의 공개된 xhigh 결과는 이미 최첨단 수준과 경쟁할 만하지만, 마치 모든 API 사용자가 현재 당장 그 결과를 재현할 수 있는 것처럼 메타(Meta)의 최고 점수를 인용해서는 안 됩니다.
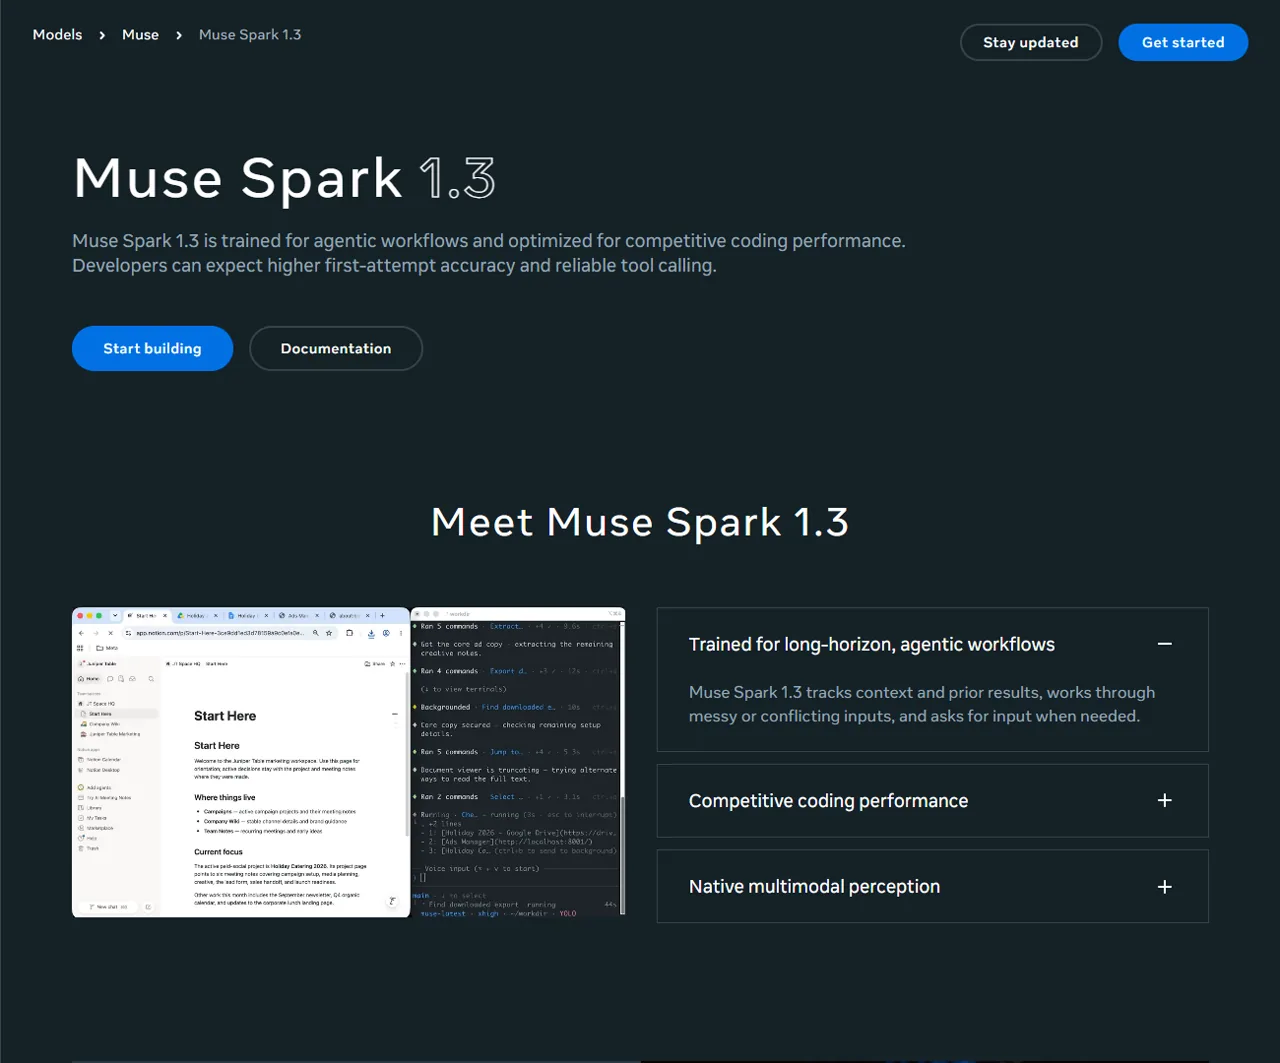
메타는 2026년 9월 2일 ‘뮤즈 스파크 1.3’을 출시했다., 이를 통해 장기적인 에이전트 기반 워크플로우, 더 깔끔한 코딩 결과물, 그리고 보다 안정적인 협업을 가능하게 합니다. 이는 ~로 향하는 변화를 이어가는 것으로, 도구 사용 모델을 기반으로 구축된 AI 에이전트. 메타는 요구 사항이 모호할 경우 명확히 하기 위한 질문을 하고, 처리가 막힐 경우 경고하며, 중대한 조치를 취하기 전에 확인 절차를 거친다고 밝혔습니다. 1.2 버전과의 내부 비교 결과, 메타 엔지니어들은 도구 호출 횟수가 약 20% 감소하고 토큰 수가 25% 줄어든 것을 확인했습니다. 이는 제공업체 측의 주장일 뿐, 당사의 테스트 결과는 아닙니다.
Muse Spark 1.2와 비교해 어떤 점이 달라졌나요?
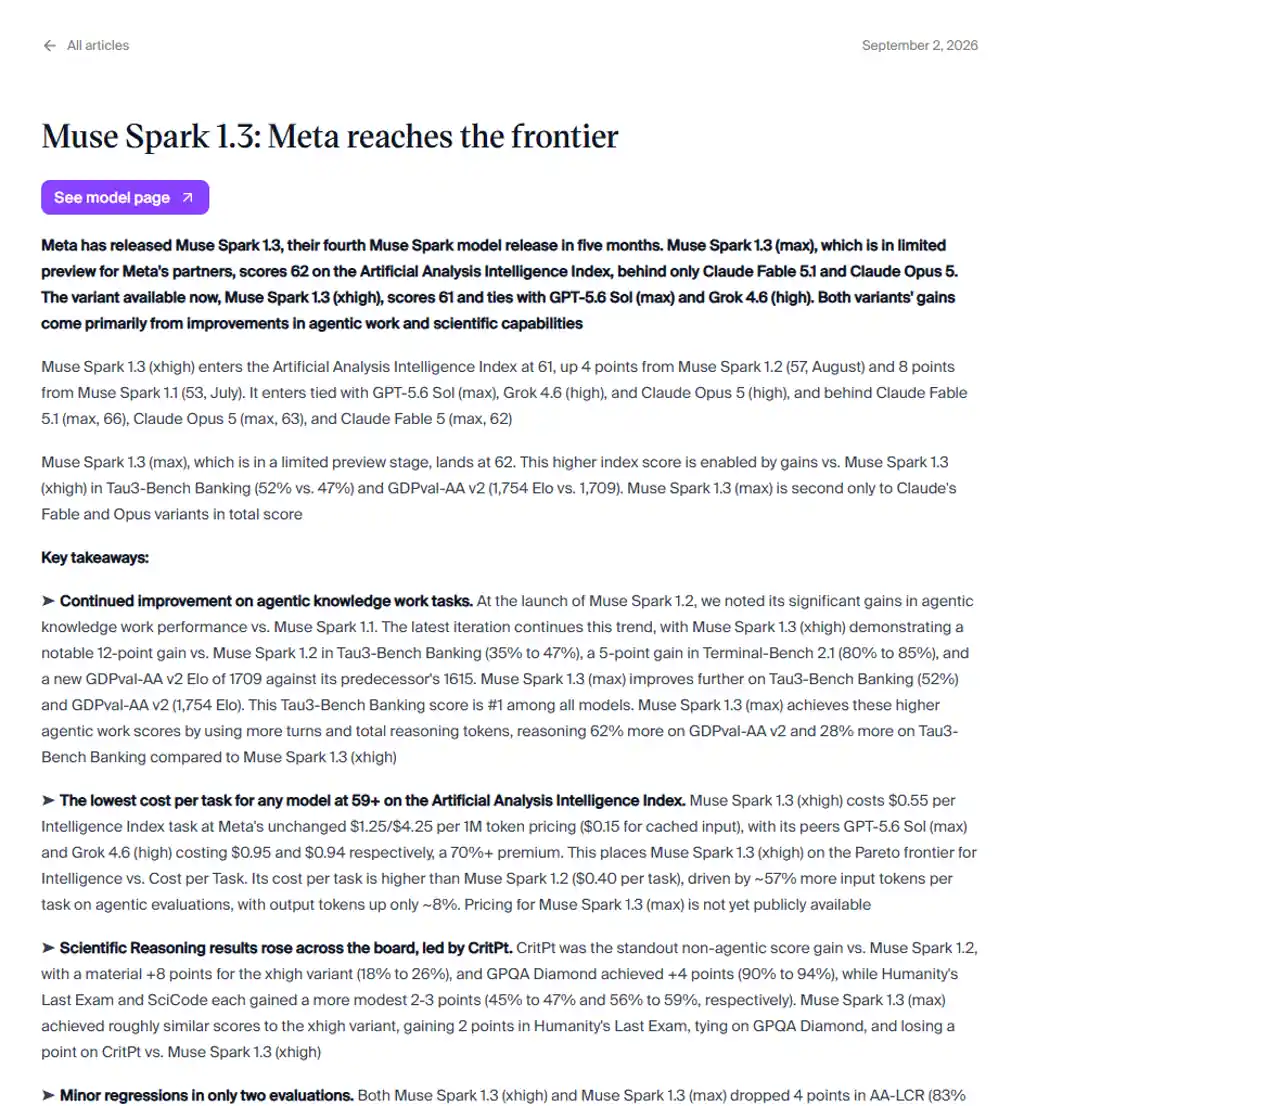
인공 분석: xhigh에서 57~61.
메타는 DeepSWE에서 75.4 대 55.0을 보고했으나, 최대값 1.3과 xhigh 1.2를 비교하고 있다.
1M 창은 여전히 유지되고 있으며, 메타의 차트에서 고대역 MRCR 점수가 급격히 상승하고 있다.
토큰 비율은 변동이 없는 반면, AA의 경우 평가된 작업당 $0.55를 기록한 반면 $0.40을 나타냈다.
Muse Spark 1.3 벤치마크: ‘Max’와 ‘Xhigh’는 동일하지 않다
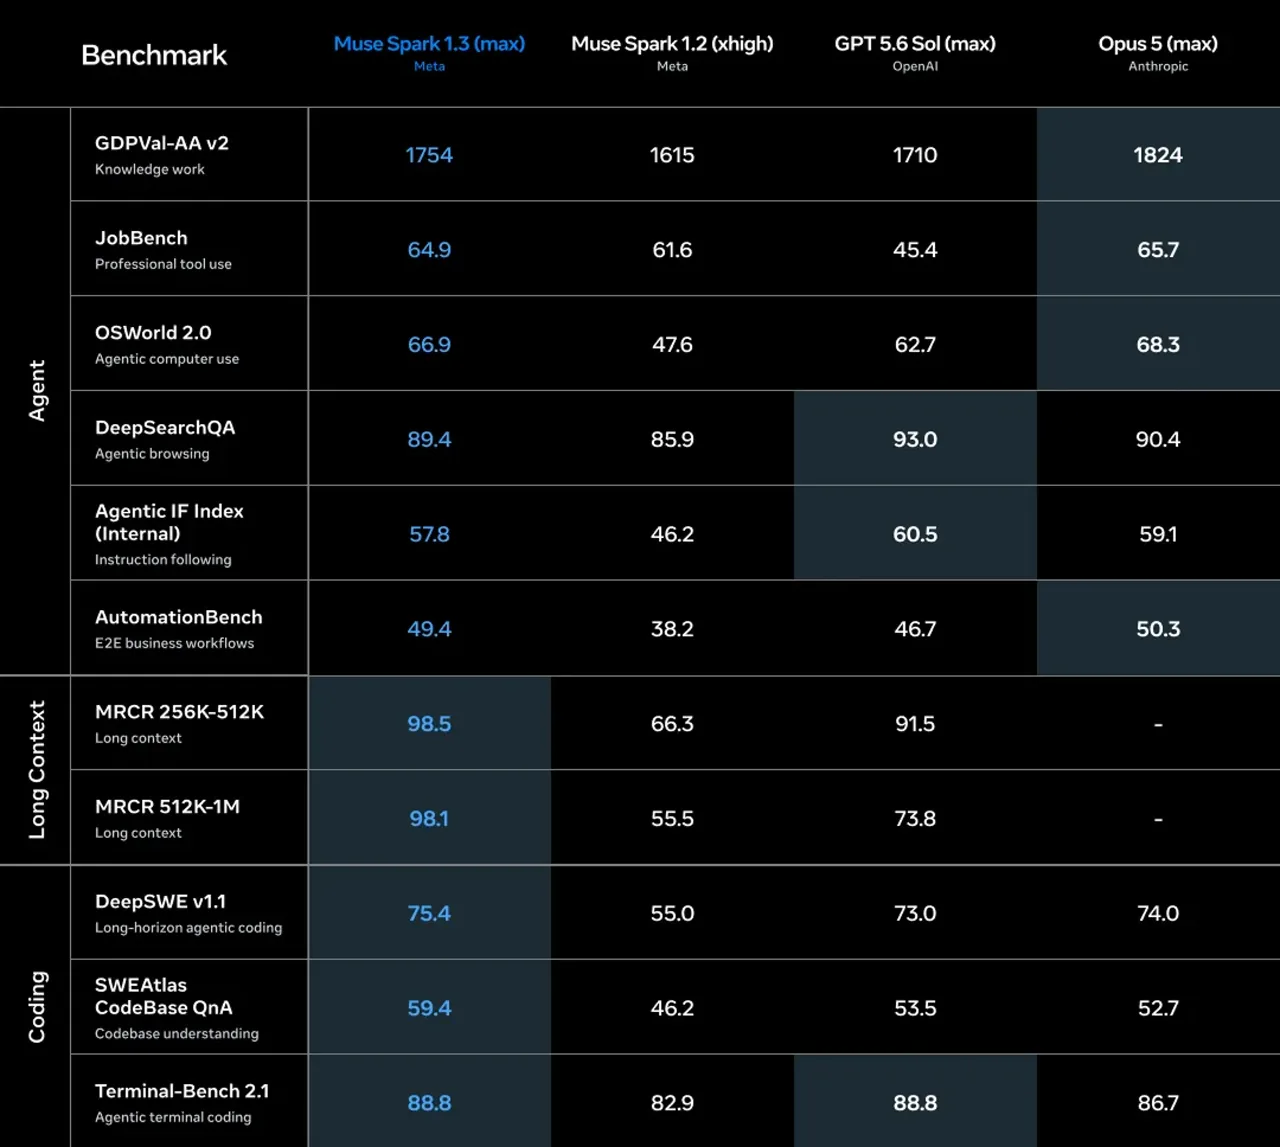
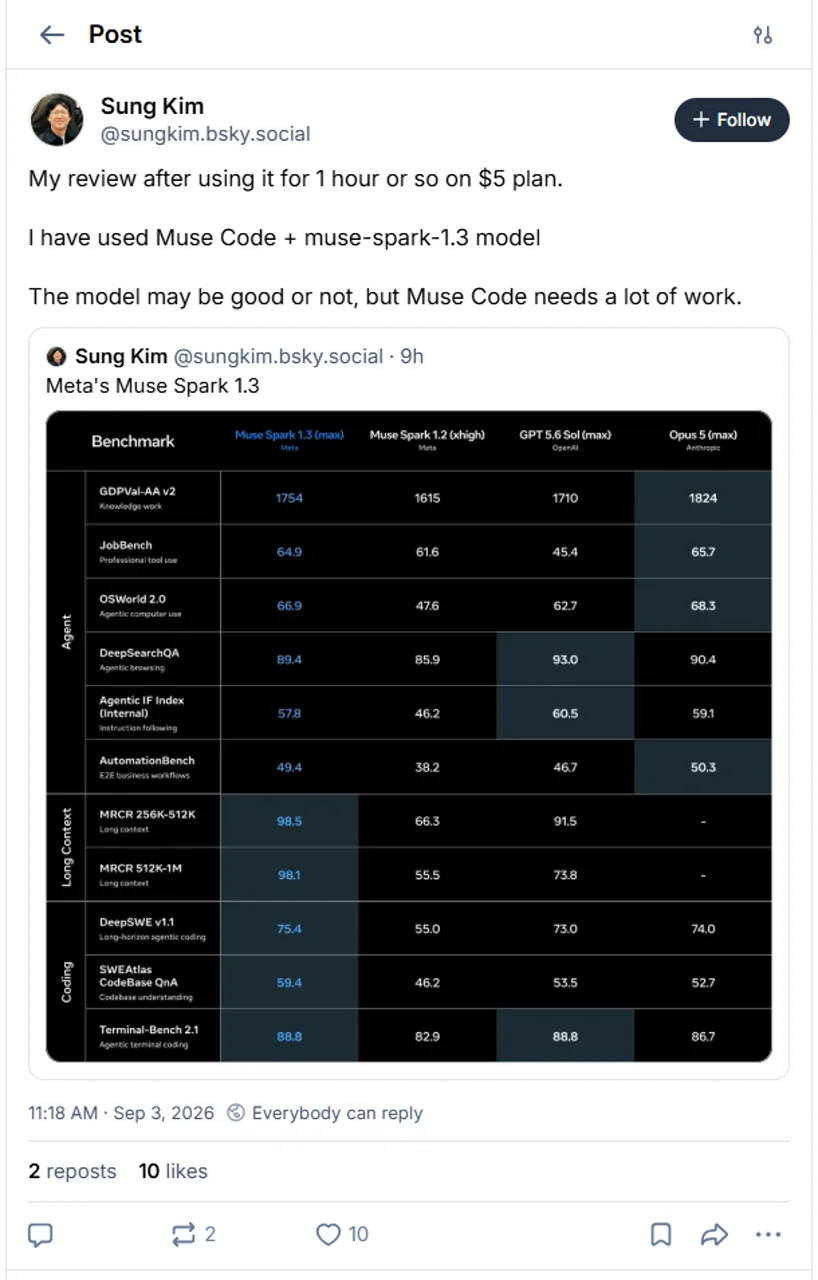
메타의 공식 차트 인상적이다. Muse Spark 1.3은 Terminal-Bench 2.1에서 88.8점, DeepSWE v1.1에서 75.4점, MRCR 512K-1M에서 98.1점, OSWorld 2.0에서 66.9점을 기록했다. Terminal-Bench에서는 GPT-5.6 Sol의 최고 점수와 동률을 기록했으며, 두 개의 장문 맥락 MRCR 대역에서는 제시된 경쟁 모델들을 앞섰습니다. 더 넓은 시장을 비교하려는 개발자들은 당사의 코딩 에이전트 개요 추가적인 맥락으로.
메타 보고, 최대 추론
| 벤치마크 | 1.3 이하 | 1.2 xhigh | GPT-5.6 Sol 최대 | 오푸스 5 맥스 |
|---|---|---|---|---|
| 터미널-벤치 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| DeepSWE v1.1 | 75.4 | 55.0 | 73.0 | 74.0 |
| OSWorld 2.0 | 66.9 | 47.6 | 62.7 | 68.3 |
| MRCR 512K-1M | 98.1 | 55.5 | 73.8 | N/A |
다양한 노력 설정, 에이전트 하네스, OSWorld 버전으로 인해 직접적인 비교가 제한됩니다. 또한 메타는 ‘Agentic IF Index’를 내부 복합 지표로 설명하고 있습니다.
차트 읽는 법
1.3, GPT-5.6 Sol 및 Opus 5는 max를 사용하며, 1.2는 xhigh를 사용합니다.
지정 에이전트와 고정 하네스는 평가에 따라 다릅니다.
1.3 및 1.2 실행은 서로 다른 환경 버전을 사용합니다.
‘Agentic IF 지수’는 메타(Meta)가 개발한 종합 지수이며, 단일 공개 벤치마크가 아닙니다.
Artificial Analysis는 더 깔끔한 화면을 제공합니다 사용자가 현재 이용할 수 있는 기능 중. Muse Spark 1.3 xhigh는 1.2 버전의 57점에서 상승한 61점을 기록했습니다. Terminal-Bench 결과는 85%, GDPval-AA v2는 1709 Elo, Tau3-Bench Banking은 47%입니다. 제한된 미리보기 버전의 max 변종은 전체 점수 62를 기록했습니다. 또한 일부 성능 저하도 나타났습니다. AA-LCR은 83%에서 79%로 떨어졌으며, AA-Omniscience Accuracy는 xhigh 기준 45%에서 42%로 하락했습니다.
Muse Spark 1.3 가격
기여자
muse-spark-1.3-기여자
$0.10 입력 / $0.002 캐시 / $0.20 출력 백만 토큰당.
프롬프트는 메타 제품의 개선을 위해 활용될 수 있습니다.
표준
muse-spark-1.3
$1.25 입력 / $0.15 캐시 / $4.25 출력 백만 토큰당.
메타는 이 등급이 자사 제품을 개선하는 데 사용되지 않는다고 밝혔습니다.
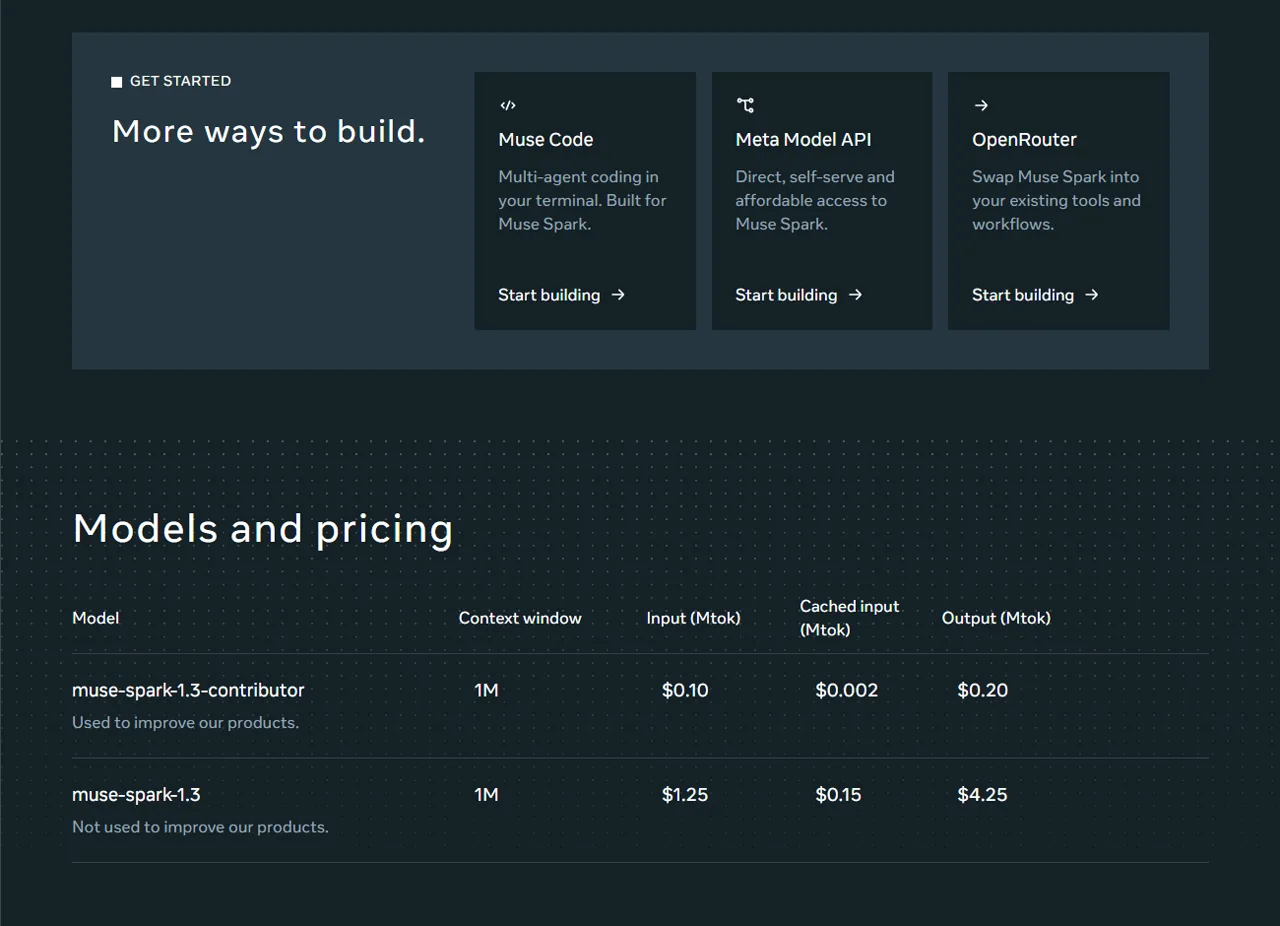
그리고 공식 토큰 가격 1.2 버전과 비교해 변한 점은 없지만, 작업당 비용은 달라졌습니다. 저희의 올인원 AI 플랫폼 리뷰 이는 액세스 가격과 워크플로 비용을 별도로 평가해야 하는 이유를 설명합니다. 인공 분석에 따르면, 인텔리전스 인덱스 작업당 1.3xhigh의 경우 $0.55를 기록한 반면, 1.2의 경우 $0.40을 기록했는데, 이는 주로 에이전트 평가에서 약 57% 더 많은 입력 토큰이 사용된 데 기인합니다. 기여자 등급은 매우 저렴하지만, 해당 등급의 데이터 사용 조건은 단순한 부연 설명이 아닌 실질적인 제품 선택 사항입니다.
Muse Spark 1.3 API 액세스
메타의 공식 요리책 이제 muse-spark-1.3 기본값으로 설정되어 있으며, 1,048,576 토큰의 컨텍스트 윈도우를 지원합니다. 이 API는 OpenAI SDK와 호환됩니다. Muse Code와 Meta Model API가 현재 확인된 접근 경로입니다. Meta의 모델 페이지에는 OpenRouter도 표시되지만, 해당 버튼을 클릭했을 때 여전히 1.2 버전의 URL로 연결되므로 배포 전에 경로를 확인하시기 바랍니다. 에이전트 상호 운용성에 대한 배경 정보는 당사의 가이드를 참조하십시오. MCP 및 AI 도구.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.3",
    messages=[{"role": "user", "content": "이 패치의 회귀 현상을 검토해 주세요."}],
)

print(response.choices[0].message.content)
실습형 코딩 테스트: 3개 중 3개 통과
우리는 온도 0에서 API를 통해 난이도가 중간 수준인 리포지토리 작업 3가지를 테스트했으며, 작업당 하나의 응답을 사용했습니다. 각 응답은 구조화된 JSON 형식의 완전한 파일을 반환해야 했습니다. 그런 다음 해당 파일들을 일회용 디렉터리에 적용하고, 공개 및 숨겨진 검사를 실행했습니다. 이는 소규모의 통제된 테스트일 뿐이며, Terminal-Bench나 실제 리포지토리 시험을 대체할 수 있는 것은 아닙니다.
테스트 5건 중 5건; 18.4초; 2,473개 토큰; $0.00905. 모델은 사용되지 않은 processed-ID 집합을 찾아내고, 초기 중복 방지 로직을 추가했으며, 회귀 테스트를 작성했습니다.
타입 검사 및 두 가지 런타임 검사가 통과됨; 47.6초; 4,945 토큰; $0.01661. 트랜잭션 경계를 훼손하지 않은 채 유효성 검사, 영구 저장 및 감사 로깅을 분리했다.
9/9 테스트; 20.3초; 3,789 토큰; $0.01446. CSV 호환성, 줄 번호 오류, 원자적 출력, 드라이런 안전성, 도움말 및 문서 항목이 모두 통과되었습니다.
합계: 11,207개의 토큰과 $0.04013. 표시된 시간은 엔드투엔드 요청 시간이며, 네이티브 Meta API 지연 시간이나 TTFT는 아닙니다.
결과는 단순히 “3/3”이라는 수치만으로는 알 수 없는 수준이었습니다. 첫 번째 응답 세 가지 모두 검토가 가능했고 제약 조건을 고려하고 있었기 때문입니다. 우리 논문을 읽을 때도 이와 같은 증거에 대한 엄격한 기준이 중요합니다. GPT-5 리뷰. 그럼에도 불구하고, 이 샘플은 도구 호출의 반복적 신뢰성, 대규모 저장소 탐색, 또는 Muse Code의 오케스트레이션 계층을 측정하지는 않습니다. 저예산 대안을 검토 중인 독자분들은 또한 저희의 예산 코딩 모델 비교 유용합니다.
개발자들의 초기 반응
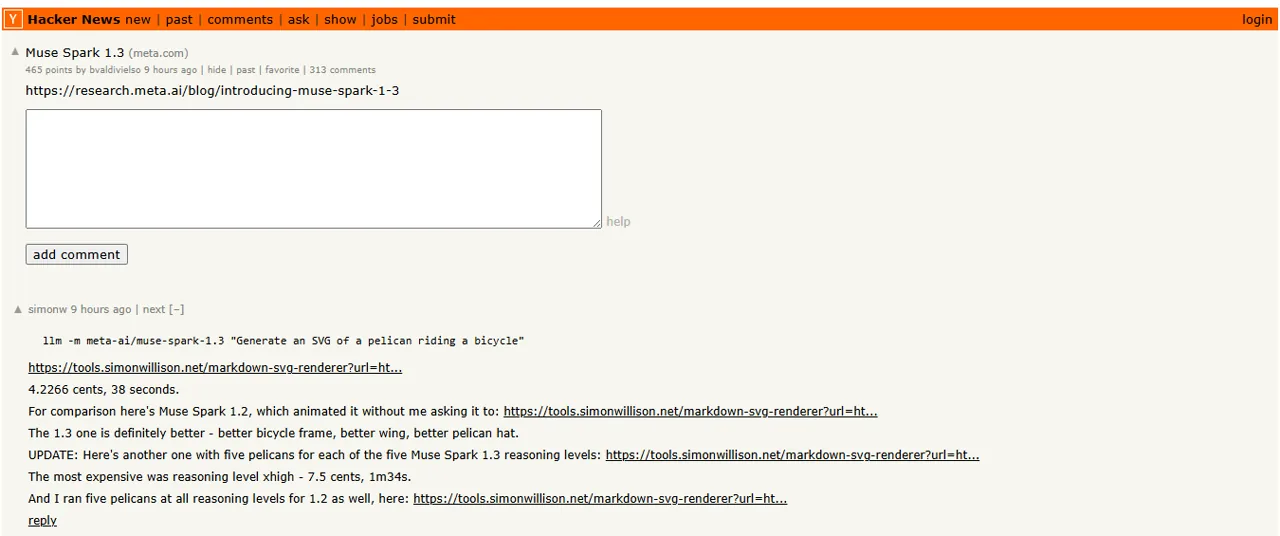
초기 반응은 엇갈리고 있으며, 그 수가 너무 적어 합의가 이루어졌다고 단정하기에는 이르다. 한 해커 뉴스 테스트, 사이먼 윌리슨은 38초, 4.2266센트의 SVG 주행 기록을 보고했으며, 이 1.3 버전의 결과를 1.2 버전과 비교했을 때 “분명히 더 낫다”고 평가했다. Dax는 이번 출시를 다음과 같이 설명했다 그가 날렵한 모델들을 얼마나 그리워했는지를 상기시켜 주기 위해. 김성, 뮤즈 코드(Muse Code)를 약 한 시간 정도 사용해 본 후, 모델 자체는 괜찮을지 모르겠지만 뮤즈 코드 제품에는 “아직 개선할 점이 많다”고 말했다. 이 마지막 언급은 에이전트 사용 경험에 관한 것이지, 순수하게 모델만 테스트한 결과는 아니다.
장점과 단점
효과가 있었던 점
- 높은 대중적 인기도 x최고 점수
- 1M 토큰 컨텍스트 창
- OpenAI 호환 API
- 세 가지 코딩 과제 모두 첫 번째 답변에서 통과했습니다.
- 기여자 등급의 토큰 지급률이 매우 낮음
볼거리
- 헤드라인 최대 결과 수는 기본적으로 사용자에게 공개되는 경험이 아닙니다.
- 독립 작업 비용이 1.2 대비 상승했다
- 두 가지 독립적인 지표가 회귀 분석을 거쳤다
- 기여자 데이터는 메타의 제품 개선에 도움이 될 수 있습니다
- 'Early Muse Code'에 대한 초기 반응은 엇갈리고 있다
Muse Spark 1.3은 어떤 분들이 사용해야 할까요?
다음 용도로 사용하세요
코딩 에이전트 평가, 대규모 컨텍스트 저장소 관련 작업, 도구 기반 자동화, 그리고 데이터 정책이 허용되는 범위 내에서 비용을 고려한 실험.
언제 건너뛰거나 기다려야 할까요?
입증된 장기적인 생산 안정성이 필요하거나, 당장 최대 용량이 필요하거나, 기여자 등급의 데이터 사용 조건을 수용할 수 없어 표준 가격 정책이 경쟁력이 없다고 판단되는 경우입니다.
Muse Spark 1.3 리뷰 결론
Muse Spark 1.3은 평가 대상으로 추천할 만합니다. 이 제품은 최첨단 수준의 공개 고성능, 강력한 장문 컨텍스트 처리 결과, 친숙한 API 사용 편의성, 그리고 경쟁력 있는 가격을 모두 갖추고 있습니다. 당사가 수행한 세 가지 초기 대응 코딩 과제를 통해, 이 제품이 다중 파일 제약 조건을 준수하고 테스트 가능한 패치를 생성할 수 있다는 점이 다시 한번 입증되었습니다.
민감한 코드의 경우 표준 등급을 선택하십시오. 다른 프론티어 비교에 대해서는 다음을 참조하십시오. GPT-5 대 Claude 4. 해당 추론 수준이 널리 보급될 때까지는 최고 벤치마크 결과를 예비적인 증거로만 간주해야 합니다. 또한 뮤즈 코드(Muse Code)는 모델 API와 별도로 평가해야 합니다. 에이전트의 사용자 경험(UX), 툴 루프, 리포지토리 제어는 기본 모델과 무관하게 성공하거나 실패할 수 있기 때문입니다.
Muse Spark 1.3 자주 묻는 질문
Muse Spark 1.3이란 무엇인가요?
Muse Spark 1.3은 2026년 9월 2일에 출시된 메타의 코딩 및 에이전트 기반 워크플로우 모델로, 100만 토큰 규모의 컨텍스트 윈도우와 이미지, 동영상, 문서에 대한 기본 인식 기능을 갖추고 있습니다.
Muse Spark 1.3의 가격은 얼마인가요?
표준 모델의 비용은 입력 토큰 100만 개당 $1.25, 캐시된 입력의 경우 $0.15, 출력의 경우 $4.25입니다. 기여자 모델의 비용은 각각 $0.10, $0.002, $0.20이지만, 이 모델의 데이터는 Meta 제품 개선에 활용될 수 있습니다.
최대 추론 기능을 사용할 수 있나요?
메타는 출시 시점에 기존 추론 모드를 이용할 수 있으며, 추가 안전성 테스트를 거친 후 ‘맥스’ 모드가 제공될 것이라고 밝혔습니다. 일반 공개 여부를 단정하기 전에 현재 API 문서를 확인하시기 바랍니다.
Muse Spark 1.3이 코딩 테스트를 통과했나요?
네. 초기 응답 결과는 Python 버그 수정, TypeScript 리팩토링, JSONL 기능 테스트에 걸친 모든 실행 가능성 검사를 통과했습니다. 이 샘플에는 단 세 가지의 통제된 작업만 포함되어 있으며, 일반적인 신뢰도 수치를 나타내는 것은 아닙니다.
Muse Spark 1.3이 1.2보다 더 나은가요?
대체로, 현재까지 확보된 증거를 바탕으로 볼 때, 공개된 xhigh 지능 점수는 57점에서 61점으로 상승했으며, 메타(Meta)는 높은 행위 능력과 장문 맥락 처리 능력에서 큰 향상을 보고했으나, 인공 분석(Artificial Analysis)에서는 작업 비용이 증가한 것으로 나타났고, 장문 맥락 검색 및 사실적 보정 능력에서 소폭의 퇴보가 확인되기도 했다.
기여자 모델과 표준 모델 중 어떤 것을 사용해야 할까요?
민감하거나 독점적인 프롬프트의 경우 ‘표준’을 사용하세요. 메타 측에 따르면 해당 데이터는 제품 개선에 활용되지 않는다고 합니다. ‘기여자’ 옵션은 훨씬 저렴하지만, 이 옵션의 프롬프트는 제품 개선에 사용될 수 있습니다.