
Claude Sonnet 5.5 대 Opus 5.5: 가격, 벤치마크 및 실제 테스트
Sonnet 5.5와 Opus 5.5는 모두 Claude 5.5 세대에 속하지만, 가격과 시장 포지셔닝은 서로 다릅니다. 이번 비교에서는 두 제품 모두에 동일한 다섯 가지 프롬프트를 입력하고, 해당 루트가 실제로 어떤 결과를 반환했는지 보고합니다.
측정된 격차는 주로 비용과 속도에 관한 것입니다. 이 5개의 프롬프트로 구성된 팩에서, Sonnet 5.5는 더 빠르게 완료되었고, 더 적은 출력 토큰을 사용했으며, 산술 요청 비용 추정치도 더 낮게 산출했습니다. Opus 5.5는 더 많은 토큰과 시간을 사용했으며, 그 답변은 종종 더 장황했습니다. 과제 카드에는 그 추가 텍스트가 유용한 결과에 어떤 변화를 가져왔는지, 그리고 두 모델 모두 단순히 통과한 부분이 어디인지가 표시되어 있습니다.
프롬프트, 요청 상한, 노력 설정, 엔드포인트 및 ‘모델당 1회 실행’ 설계는 이전과 일관되게 유지되었으며 Claude Opus 5.5 리뷰.
간단한 답변
- 이번 매치 런의 속도: Sonnet 5.5는 로컬 환경에서 5개의 연속 요청을 31.930초 만에 완료했으며, Opus 5.5는 47.725초가 소요되었다.
- 경로별로 보고된 출력 토큰: Sonnet 5.5는 2,686을 사용했고, Opus 5.5는 3,952를 사용했습니다. 사고 영역은 각각 987과 2,214였습니다.
- 산술적 정가 추정액: 공식 표준 토큰 요율을 적용하고 캐시, 크레딧, 세금 및 마진을 제외했을 때, 5건의 소네트 요청 비용은 약 $0.02826이었고, 5건의 오푸스 요청 비용은 약 $0.08184였습니다.
- 작업 결과: 두 모델 모두 추출, JSON, 수학 프롬프트를 성공적으로 처리했습니다. Sonnet은 요청된 두 문단 분량의 중국어 형식을 더 깔끔하게 유지했습니다. 코딩 출력물은 둘 다 활용 가능했지만, 설명의 깊이와 예외 사례에 대한 설명 면에서 차이가 있었습니다.
- API 마이그레이션: 사고는 비활성화될 수 없으며, 도구의 강제 선택은 허용되지 않으며, 토큰 할당량에는 사고 과정이 포함됩니다. 다음을 확인하십시오. 마이그레이션 시 유의사항 전환하기 전에.
- 결정 경계: 이는 타사 경로를 통해 작업당 한 번씩 실행되는 테스트입니다. 이 테스트는 관찰된 프롬프트 응답, 로컬 실행 시간, 경로에서 보고된 사용량을 측정하는 것으로, 포괄적인 성능 점수를 나타내는 것은 아닙니다.
공식 가격 및 모델 사양
Anthropic의 현재 모델 카드에는 1M 토큰 컨텍스트 윈도우와 128K 최대 출력을 모두 갖춘 두 모델이 나열되어 있습니다. Sonnet 5.5는 다음과 같이 표기되어 있습니다. 빠른 높은 기본 설정 노력도를 바탕으로; Opus 5.5는 다음과 같이 표기되어 있습니다. 보통 기본적으로 중간 수준의 노력을 기울일 때, 표준 토큰 비율에 따르면 Sonnet 5.5는 Opus 5.5의 입력 및 출력 가격의 절반에 해당합니다.
| 모델 | API ID | 공식 지연 시간 표기 | 입력 / 출력 | 컨텍스트 / 최대 출력 | 기본 노력 | 캐시 읽기 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 클로드-소네트-5-5 | 활발한 · 빠른 | MTok당 $2 / $10 | 1M / 128K | 높음 | $0.20 / MTok |
| Claude Opus 5.5 | 클로드-작품 5-5 | 활동적 · 보통 | MTok당 $4 / $20 | 1M / 128K | Medium | $0.20 / MTok |
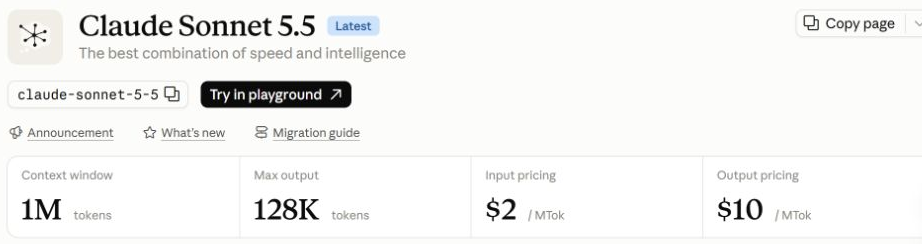
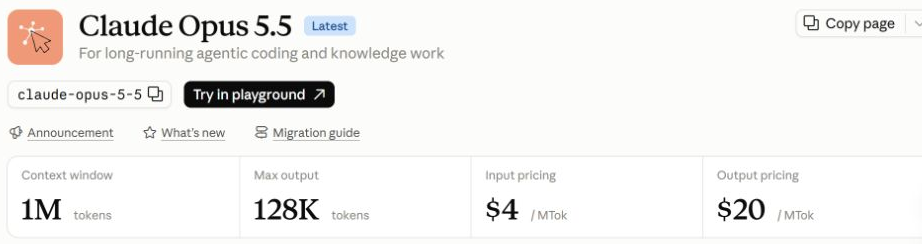
입력 토큰 100,000개와 출력 토큰 20,000개로 구성된 간단한 비캐시 예시의 경우, 명시된 토큰 비율은 Sonnet 5.5에서는 약 $0.40, Opus 5.5에서는 $0.80으로 계산됩니다. 자세한 내용은 Claude 가격 및 한도 안내서 계획의 맥락을 고려하여.
공식 벤치마크 환경
Anthropic의 Sonnet 5.5 공지사항 두 모델을 모두 공급자가 보고한 하나의 표에 포함시킵니다. 행의 구성은 벤치마크와 노력 설정에 따라 혼합되어 있습니다.
| Anthropic가 보고한 벤치마크 | Sonnet 5.5 | 작품 5.5 | 측정 |
|---|---|---|---|
| 터미널-벤치 4.0 | 70.6% | 66.4%¹ | 대리적 말단 코딩 |
| FrontierCode v1.1 (메인) | 46.2% Max² / 52.1% Xhigh | 54.4% | 코드 변경 사항이 병합될지 여부 |
| CursorBench 4.0 | 55.5% | 57.8% | 모호한 다중 파일 코딩 과제 |
| GDPval-AA v2.1 | 1844 | 1846 | 직종별 지식 노동 |
| 인류의 마지막 시험 | 64.5% (공구 포함) | 67.7% (공구 포함) | 다학제적 추론 |
| OSWorld 2.1 | 80.1% 부분 | 81.8% 부분 | 컴퓨터 활용 과제 |
| 지도학 | 61.6%, 공구 불필요 | 64.4%, 공구 불필요 | 시각적 차트 인식 |
¹ Opus 5.5 Terminal-Bench는 xhigh 노력도를 사용합니다. ² Sonnet 5.5 FrontierCode는 최대(Max) 시 46.2%, xhigh 노력도 시 52.1%입니다. OSWorld 수치는 ‘부분적’으로 표시되어 있습니다. 이는 제공업체의 맥락에 따른 것이며, 동일한 노력 수준에서 독립적으로 재실행한 결과가 아닙니다.
동일 프롬프트 API 메서드
각 모델은 다음을 통해 동일한 5개의 프롬프트를 받았습니다. 게시물 https://anywhere.broly.ai/v1/messages. 클라이언트가 한 명의 사용자에게 메시지를 보냈는데, max_tokens: 8192, output_config.effort: high, 그리고 도구가 필요하지 않았습니다. 모든 요청은 HTTP 200을 반환했고 턴 종료.
이 테스트 방식은 보다 광범위한 GlobalGPT 모델 테스트 워크플로우. 별도의 Claude API 가이드 요청 설정 및 토큰 관리에 대해 다룹니다.
시간, 토큰, 예상 비용
| 경로 | 현지 시간으로 5회 | 입력 토큰 | 출력 토큰 | 보고된 사고 과정 | 예상 요청 비용* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 31.930초 | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5 | 47.725초 | 700 | 3,952 | 2,214 | $0.08184 |
* 경로 보고 토큰 및 공식 표준 요율을 바탕으로 추산한 수치입니다. 이 팩에서 Sonnet 5.5는 현지 소요 시간 기준으로 33.1%, 출력 토큰 수 기준으로 32.0% 더 낮았습니다.
일치하는 과제 카드 5장
각 카드에는 작업 내용, 관찰 사항, 현지 시간, 경로 보고 토큰, 상태 및 경계 정보가 함께 기록됩니다.
이 모델들이 혼합형 중복 제거 기능을 복원할 수 있을까요?
작업 설정: 정확한 프롬프트는 앞서 언급된 내용에서 복사한 것입니다. Claude Opus 5.5 리뷰 테스트 팩.
| 모델 | 시간 / 경로 이용 현황 | 짧은 결과 라벨 |
|---|---|---|
| Claude Sonnet 5.5 | 8.679초 입력 145 / 출력 830 0 생각 HTTP 200 · end_turn | 수정된 함수와 두 개의 시험 문제; 설명은 간략하게. |
| Claude Opus 5.5 | 15.844초 입력 145 / 출력 1478 700에 대한 고찰 HTTP 200 · end_turn | 수정된 함수와 두 가지 테스트; 경계 사례에 대한 논의 추가. |
관찰된 비교: 두 경우 모두 수정된 함수와 두 개의 테스트를 반환했습니다. Sonnet 5.5는 타입 태그가 지정된 키를 사용했으며, casefold(), 그리고 더 짧은 응답에서는 목록 형식의 대체 답변을 제시했습니다. Opus 5.5는 추가적인 예외 사례를 설명하는 데 더 많은 출력 토큰을 사용했습니다. 두 실행 결과 모두 코딩 측면에서 명확한 승자를 가릴 수는 없었습니다.
경계: 단 한 번의 사소한 파이썬 수정만으로는 구체적인 경계 사례만 확인할 수 있을 뿐, 여러 저장소 전반에 걸친 안정성이나 도구 기반 코딩은 보장할 수 없습니다.
모델들이 주어진 다섯 가지 사실을 추가 주장을 덧붙이지 않고 그대로 유지할 수 있을까요?
작업 설정: 정확한 프롬프트는 앞서 언급된 내용에서 복사한 것입니다. Claude Opus 5.5 리뷰 테스트 팩.
| 모델 | 시간 / 경로 이용 현황 | 짧은 결과 라벨 |
|---|---|---|
| Claude Sonnet 5.5 | 3.569초 입력 210 / 출력 209 0 생각 HTTP 200 · end_turn | 번호가 매겨진 5개의 글머리 기호; 제시된 사실은 그대로 유지함. |
| Claude Opus 5.5 | 4.374초 입력 210 / 출력 312 101가지 사고방식 HTTP 200 · end_turn | 번호가 매겨진 5개의 글머리 기호; 제시된 사실은 그대로 유지함. |
관찰된 비교: 두 모델 모두 정확히 5개의 번호가 매겨진 글머리 기호를 반환했으며, 제공된 사실의 범위를 벗어나지 않았습니다. Sonnet 5.5는 209개의 출력 토큰을 사용한 반면, Opus 5.5는 312개를 사용했지만, 프롬프트는 방대한 맥락의 입력 자료가 아닌 짧은 메모 형태였습니다.
경계: 이는 실제 환경에서 수행된 추출 및 서식 검사 결과일 뿐, 백만 토큰 규모의 문맥 처리 성능을 입증하는 것은 아닙니다.
모델들이 요청된 구조를 정확히 반환할 수 있나요?
작업 설정: 정확한 프롬프트는 앞서 언급된 내용에서 복사한 것입니다. Claude Opus 5.5 리뷰 테스트 팩.
| 모델 | 시간 / 경로 이용 현황 | 짧은 결과 라벨 |
|---|---|---|
| Claude Sonnet 5.5 | 5.052초 입력 128 / 출력 260 0 생각 HTTP 200 · end_turn | 구문 분석 가능한 JSON; 요청된 키 및 항목 수. |
| Claude Opus 5.5 | 8.276초 입력 128 / 출력 622 390 생각 HTTP 200 · end_turn | 구문 분석 가능한 JSON; 요청된 키 및 항목 수. |
관찰된 비교: 두 결과 모두 요청된 키와 장단점 각 두 가지가 포함된 파싱 가능한 JSON을 반환했습니다. Sonnet 5.5는 출력 토큰 수가 260개로 더 간결했습니다. 이 문자열들은 가상의 리뷰 설정을 묘사한 것이며, 제품에 대한 실제 정보는 아닙니다.
경계: 이 스키마를 한 번만 통과한다고 해서 도구 호출이나 긴 대화 상황에서 구조화된 출력의 신뢰성을 측정할 수는 없습니다.
모델들이 둥근 배치 순서를 최종 답까지 그대로 이어갈 수 있을까요?
작업 설정: 정확한 프롬프트는 앞서 언급된 내용에서 복사한 것입니다. Claude Opus 5.5 리뷰 테스트 팩.
| 모델 | 시간 / 경로 이용 현황 | 짧은 결과 라벨 |
|---|---|---|
| Claude Sonnet 5.5 | 2.947초 입력 89개 / 출력 163개 0 생각 HTTP 200 · end_turn | 정답: 67; 최종 답은 별도의 줄에 적으십시오. |
| Claude Opus 5.5 | 3.830초 입력 89개 / 출력 257개 74가지 생각 HTTP 200 · end_turn | 정답: 67; 최종 답은 별도의 줄에 적으십시오. |
관찰된 비교: 두 모델 모두 67이라는 값을 계산해냈으며, 최종 답을 별도의 줄에 출력했습니다. Sonnet 5.5는 163개의 출력 토큰을 사용한 반면, Opus 5.5는 257개를 사용했으나, 이 프롬프트에서는 정확도에 차이가 관찰되지 않았습니다.
경계: 단 하나의 등차수열만으로는 광범위한 추론의 신뢰성을 평가할 수 없다.
이 경로는 요청된 두 단락 구조를 유지할 수 있을까요?
작업 설정: 정확한 프롬프트는 앞서 언급된 내용에서 복사한 것입니다. Claude Opus 5.5 리뷰 테스트 팩.
| 모델 | 시간 / 경로 이용 현황 | 짧은 결과 라벨 |
|---|---|---|
| Claude Sonnet 5.5 | 11.683초 입력 128 / 출력 1224 987 생각 HTTP 200 · end_turn | 중국어 문단 두 개; 별도의 서식 없음. |
| Claude Opus 5.5 | 15.401초 입력 128 / 출력 1283 949 생각 HTTP 200 · end_turn | 주요 내용을 다뤘으며, 마크다운과 영어 참고 사항을 추가했습니다. |
관찰된 비교: Sonnet 5.5는 요청받은 두 개의 중국어 문단을 별도의 서식 없이 반환했습니다. Opus 5.5 역시 요청받은 내용을 다루었지만, 마크다운 서식과 영어 주석을 추가했습니다. 이는 한 번의 실행 과정에서 확인된 형식 준수 여부를 기록한 것이며, 중국어 품질 전반을 평가한 것은 아닙니다.
경계: 이 프롬프트는 ‘Opus 5.5’에 대한 서두를 요청하고 있으므로, 본문 자체는 중립적인 언어 벤치마크가 아닙니다.
API 및 마이그레이션 시 유의사항
Sonnet 5.5는 기본적으로 적응형 사고 모드를 실행합니다. thinking: disabled를 지정하면 400 오류가 반환되며, max_tokens는 사고 과정과 응답 텍스트를 모두 포함합니다. tool_choice를 any/tool로 강제 지정하는 것은 허용되지 않습니다. 콘텐츠 블록을 유형별로 분석하고, 전환 전에 토큰 할당량을 기준치로 재설정하십시오.
증거가 뒷받침하는 바
작업별 판정
Sonnet 5.5: 이 노선에서 측정된 비용과 소요 시간을 줄였으며, 중국 과제에서는 형식 요건을 완벽하게 준수했습니다.
Opus 5.5: 이곳에서는 가격이 더 비싸고 규모도 더 크지만, 여러 가지 개방형 과제에서 공식 벤치마크 순위는 여전히 앞서고 있다.
작업 단위의 근거를 바탕으로 시작점을 정한 다음, 본인에게 중요한 업무량을 검증하십시오.
관련 내용을 보려면 다음을 참조하십시오. Claude 제품군 비교, 오푸스 5 리뷰, 및 Fable 5.1 리뷰.
자주 묻는 질문
대결 테스트에서 어느 모델이 더 빨랐나요?
Sonnet 5.5는 5개의 연속 요청에 걸쳐 Opus 5.5의 47.725초에 비해 31.930초로 더 낮은 로컬 총 지연 시간을 기록했습니다. 여기에는 여기서 사용된 경로와 네트워크 경로가 포함되어 있으므로, 이는 제공자 측 지연 시간이 아닙니다.
어느 모델이 출력 토큰을 더 적게 사용했나요?
Sonnet 5.5는 5가지 과제에서 총 2,686개의 경로 보고 출력 토큰을 사용한 반면, Opus 5.5는 3,952개를 사용했습니다. 토큰 수만으로는 답변의 품질을 입증할 수 없습니다.
이번 테스트에서 어떤 모델이 더 저렴했나요?
공식 표준 API 요율과 반환된 입출력 횟수를 기준으로 할 때, 5건의 Sonnet 5.5 요청에 대한 예상 비용은 $0.02826인 반면, Opus 5.5의 경우 $0.08184입니다. 이 계산에는 캐시 요금, 플랫폼 크레딧, 세금 및 마크업은 포함되지 않습니다.
Sonnet 5.5가 모든 벤치마크에서 Opus 5.5보다 더 좋은 성능을 보이나요?
Anthropic의 자체 표는 벤치마크와 노력 설정에 따라 결과가 엇갈립니다: Sonnet 5.5는 Terminal-Bench 4.0에서 더 높은 점수를 기록한 반면, Opus 5.5는 FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld 및 Chartography에서 더 높은 점수를 기록했습니다. 이는 제공업체가 보고한 결과이며, 독립적인 재실행 결과는 아닙니다.
Sonnet 5.5는 드롭인 API 대체품인가요?
아닙니다. 마이그레이션 가이드에 따르면 ‘thinking’은 기본적으로 실행되며, ‘thinking: disabled’를 지정하면 400 오류가 발생하고, ‘any/tool’을 강제 지정하면 거부되며, 클라이언트는 콘텐츠 블록을 유형별로 파싱해야 합니다. 전환하기 전에 토큰 할당량과 도구 루프를 다시 기준치로 설정하십시오.
이 벤치마크는 장기간에 걸친 벤치마크였나요?
아닙니다. 추출 프롬프트에는 짧은 문장이 포함되어 있습니다. 이 프롬프트는 사실적 근거와 정확한 서식만 확인하며, 문서화된 100만 토큰 컨텍스트 창 주변의 행동은 측정하지 않습니다.









